course
Introduktion till maskininlärning
2 timmar
307.3K
Har du varit i en situation där din maskininlärningsmodell kan förutsäga vem som kommer att köpa, men inte kan berätta varför de köpte?
Traditionell maskininlärning kan upptäcka mönster och förutsäga utfall. Den talar om att en kund sannolikt kommer att lämna eller att försäljningen minskar nästa kvartal. Men om du frågar om din senaste marknadsföringskampanj faktiskt orsakade mer försäljning, eller om en behandling verkligen förbättrade patientutfall, vet den inte vad den ska göra. Prediktion och kausalitet är två olika saker.
Kausal maskininlärning kombinerar maskininlärning med kausal inferens. Så i stället för att fråga "vad kommer att hända?" frågar den "vad händer om vi ingriper?" – och det är frågan bakom varje affärsbeslut eller medicinsk behandling.
I den här artikeln guidar jag dig genom kärnkoncepten bakom kausal ML, metoderna som används för att uppskatta orsak–verkan och hur du tillämpar dem i Python.
Om du är ny inom maskininlärning, gå vår nybörjarvänliga Machine Learning Fundamentals in Python-track.
Standardmodeller inom ML lär sig mönster från data och använder dem för att göra förutsägelser. De är bra på att svara på "vad kommer att hända?" men de kan inte säga vad som orsakade att det hände.
Kausal maskininlärning ställer en annan fråga. Den kombinerar ML med kausala inferenstekniker för att uppskatta orsak–verkan-relationer från data. Så i stället för att förutsäga ett utfall uppskattar den vad som skulle förändras om du vidtog en specifik åtgärd.
Den åtgärden kallas en intervention och representerar en avsiktlig förändring du gör för att se dess effekt. Drevs köpen faktiskt av rabatten, eller skulle de kunderna ha handlat ändå? Förbättrade den nya medicinen återhämtningen, eller blev patienterna bättre av sig själva?
Det här är frågor som förutsägelser inte kan besvara, men som kausal ML kan.
Traditionell ML lär sig korrelationer. Den hittar att kunder som får rabattmejl tenderar att köpa mer, och använder det mönstret för att förutsäga framtida köp. Men korrelation säger inte om mejlet orsakade köpet. Kanske planerade de kunderna redan att handla.
Kausal ML uppskattar den kausala effekten av mejlet på köp. Den frågar vad som skulle ha hänt om du inte hade skickat det. Skillnaden mellan "de här sakerna tenderar att uppträda tillsammans" och "den här saken orsakade den där saken" är det som skiljer traditionell och kausal ML åt.
Här är ett enkelt sätt att tänka på det:
Det första hjälper dig att förutsäga. Det andra hjälper dig att besluta. Båda är användbara.
De flesta affärs- och policybeslut är kausala till sin natur. Du frågar inte "vad kommer att hända?" – du frågar "vad ska vi göra?"
Här är några konkreta exempel:
Standardmetoder inom maskininlärning kan inte besvara någon av dessa frågor eftersom de behandlar korrelation som en feature. Två variabler som rör sig tillsammans kan dela en gemensam orsak, eller så kan relationen vara ren slump. Kausal ML tvingar dig att tänka på varför saker hänger ihop – och om en förändring i den ena faktiskt förändrar den andra.
Innan du kan uppskatta orsak–verkan behöver du förstå ett par saker som varje kausal analys vilar på.
Varje kausal fråga har två delar: en behandling och ett utfall.
Behandlingen är den åtgärd eller intervention du studerar. Det kan vara ett läkemedel som ges till patienter eller en rabatt som erbjuds kunder. Utfallet är det du mäter, såsom återhämtningstid, köpgrad eller produktivitet.
Målet med kausal ML är att uppskatta hur behandlingen förändrar utfallet. Den uppskattar inte om de två är korrelerade, utan om den ena faktiskt orsakar den andra.
Du kan observera vad som hände efter att en patient tog läkemedlet, men du kan inte observera vad som skulle ha hänt om hen inte hade tagit det. Det oobserverade scenariot kallas ett kontrafaktiskt utfall.
I ett annat domänexempel: en kund fick 20% rabatt och gjorde ett köp. Det kontrafaktiska frågar: skulle hen ha köpt utan rabatten? Du får aldrig veta säkert eftersom du inte kan spola tillbaka tiden och köra båda versionerna på samma person.
Kausal ML uppskattar dessa kontrafaktiska utfall med statistiska tekniker och antaganden. Kvaliteten på din kausala uppskattning beror på hur väl du kan approximera det du inte kan observera direkt.
En störfaktor är en variabel som påverkar både behandling och utfall, vilket skapar ett falskt intryck av kausalitet.
Säg att du studerar om träning minskar hjärtsjukdom. Personer som tränar mer tenderar också att äta hälsosammare. Kosten påverkar både sannolikheten att träna (behandling) och hjärtsjukdom (utfall). Om du ignorerar kost kommer du att överskatta hur mycket enbart träning spelar roll.
Störfaktorer är det största hotet mot kausal analys. Att identifiera och hantera dem är det som gör en kausal uppskattning tillförlitlig – och något som är värt att lägga tid på.
Om du undrar hur du tar reda på vilka variabler som är störfaktorer och vilka som inte är det – du ritar en graf.
Ett directed acyclic graph (DAG) är ett diagram som kartlägger kausala relationer mellan variabler. Varje nod representerar en variabel, och varje pil pekar från en orsak till dess effekt. "Directed" betyder att pilarna har en riktning. "Acyclic" betyder att det inte finns några loopar – en variabel kan inte orsaka sig själv, direkt eller via en kedja.
Ta tränings-exemplet från tidigare. En enkel DAG skulle ha pilar från Kost → Träning och Kost → Hjärtsjukdom, plus en pil från Träning → Hjärtsjukdom. Grafen gör det uppenbart att kost är en störfaktor eftersom den har pilar som pekar mot både behandling och utfall.
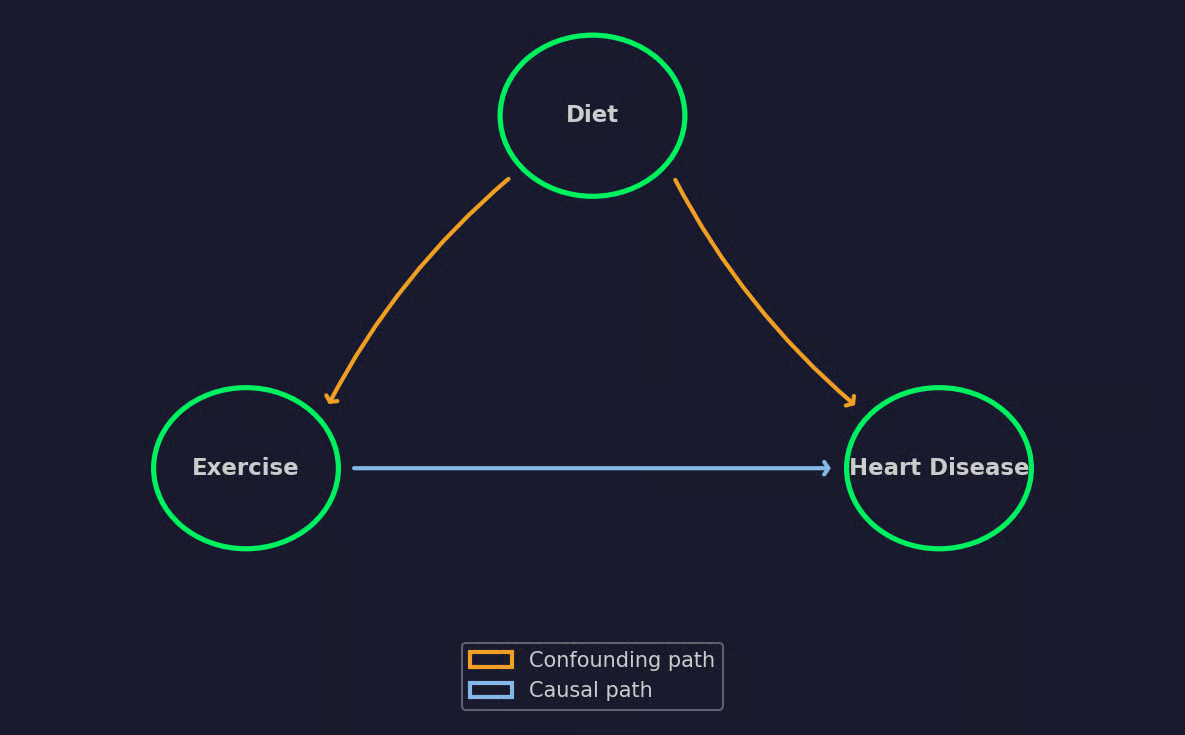
Ett enkelt DAG-exempel
DAG:er talar också om vilka variabler du ska kontrollera för och vilka du ska lämna i fred. Om du kontrollerar för fel variabel kan du faktiskt introducera bias i stället för att ta bort den. Med det i åtanke – tänk på en DAG som en färdplan för hela din kausala analys.
Det bästa?
Du behöver inte matte för att bygga en DAG. Du behöver bara domänkunskap. Grafen kodar dina antaganden om hur världen fungerar, och kvaliteten på dina kausala uppskattningar beror på om de antagandena stämmer.
Kausal ML lånar mycket från statistik och ekonometri, men skalar dessa idéer med maskininlärning. Jag går igenom de fyra vanligaste angreppssätten.
I en ideal värld skulle du köra ett randomiserat experiment för att mäta en behandlings effekt. Men i praktiken är behandlingstilldelningar sällan slumpmässiga. Personer som får behandling skiljer sig ofta från dem som inte får – och dessa skillnader skapar bias.
Propensity score-metoder adresserar detta genom att uppskatta sannolikheten att varje individ får behandlingen, baserat på observerade egenskaper. Den sannolikheten är benägenhetspoängen.
När du har poäng finns två huvudsätt att använda dem:
Båda metoderna försöker simulera hur ett randomiserat experiment skulle ha sett ut, med observationsdata.
Ibland finns inte de störfaktorer du behöver kontrollera för i dina data. Du kan inte mäta dem, så benägenhetspoäng hjälper inte. Här kommer instrumentvariabler (IV) in.
Ett instrument är en variabel som påverkar behandlingen men inte har någon direkt effekt på utfallet. Den påverkar utfallet endast genom behandlingen.
Ett klassiskt exempel är att studera effekten av utbildning på inkomst. Motivation påverkar både hur mycket utbildning någon får och hur mycket hen tjänar – men du kan inte mäta motivation direkt. Avstånd till närmaste högskola fungerar som ett instrument eftersom det påverkar om någon går på högskola, men inte direkt deras framtida lön.
I praktiken är det svårt att hitta ett bra instrument. Metoden är utmärkt när du har ett, men ett svagt eller ogiltigt instrument ger vilseledande resultat.
Kausala skogar utökar random forest-algoritmen för att uppskatta behandlingseffekter i stället för förutsägelser. En vanlig random forest förutsäger ett utfall, medan en kausal skog uppskattar hur mycket behandlingen förändrar det utfallet för olika undergrupper.
Detta är användbart när behandlingseffekten varierar mellan individer. Ett läkemedel kan fungera bra för yngre patienter men inte för äldre. På samma sätt kan en rabatt öka köp för priskänsliga kunder men inte ha någon effekt på lojala köpare. Kausala skogar upptäcker dessa skillnader genom att dela upp data på egenskaper som ger störst variation i behandlingseffekter.
Resultatet är en personlig uppskattning av behandlingseffekten för varje individ i ditt dataset.
Double machine learning (DML) kombinerar ML-modeller med statistisk inferens för att få det bästa av två världar.
Du använder en ML-modell för att förutsäga utfallet och en annan för att förutsäga behandlingstilldelningen. Sedan tittar du på residualerna (delarna som ingen av modellerna kunde förklara), och relationen mellan dem ger dig den kausala effekten.
Om du undrar varför extra steg behövs, är svaret detta: ML-modeller är bra på att fånga mönster, men de introducerar bias när de används för kausal skattning. DML tar bort den biasen genom en teknik som kallas cross-fitting, där du tränar och förutsäger på olika datadelmängder för att undvika överanpassning.
När du har valt en metod behöver du ett sätt att sammanfatta vad den fann. Det är här mått för behandlingseffekt kommer in.
Genomsnittlig behandlingseffekt (ATE) mäter den genomsnittliga kausala effekten av behandlingen över hela din population. Om ATE för en rabattkampanj är 5 USD betyder det att rabatten i genomsnitt ökade utgifterna med 5 USD per kund.
ATE ger dig helhetsbilden, men döljer individuell variation. Ett genomsnitt på 5 USD kan betyda att alla spenderade 5 USD mer, eller att hälften av kunderna spenderade 10 USD mer medan den andra hälften inte ändrades alls.
Villkorad genomsnittlig behandlingseffekt (CATE) uppskattar behandlingseffekten för specifika undergrupper baserat på deras egenskaper. Så i stället för ett tal för alla, talar CATE om att rabatten ökade utgifterna med 8 USD för nya kunder men bara 2 USD för återkommande.
CATE gör kausal ML handlingsbar. ATE säger om en intervention fungerar. CATE säger för vem den fungerar – och det är svaret du behöver för att fatta datadrivna beslut.
Kausal ML dyker upp varhelst du behöver gå från "vad hände?" till "vad ska vi göra?" Här är ett par exempel.
Ett sjukhus vill veta vilken behandling som fungerar bäst för en specifik patientprofil. Standard-ML kan förutsäga vem som är i riskzonen, men kausal ML uppskattar om behandling A eller behandling B ger ett bättre utfall för just den patienten. Detta möjliggör personliga behandlingsbeslut baserade på uppskattade effekter i stället för populationsmedelvärden.
Ett marknadsföringsteam kör en kampanj och ser en spik i försäljningen. Frågan är: orsakade kampanjen spiken, eller drevs den av säsongsefterfrågan? Kausal ML isolerar kampanjens verkliga effekt genom att ta hänsyn till störfaktorer som timing, kunddemografi och tidigare köpbeteende.
Regeringar och institutioner behöver utvärdera om policyer ger avsedda resultat. Minskade ett jobbträningsprogram arbetslösheten? Ökade ett skatteincitament investeringarna? Kausal ML tillhandahåller en ram för policyutvärdering när randomiserade försök inte är praktiska eller ens möjliga.
Ett produktteam lägger till en ny funktion och engagemanget går upp. Kausal ML hjälper till att avgöra om funktionen orsakade ökningen eller om den sammanföll med andra förändringar – som en marknadsföringsinsats eller att en konkurrent gick ner. Att förstå den faktiska effekten av en funktion skiljer datainformerade beslut från en gissning.
Den röda tråden är att beslut beror på att veta varför något hände, inte bara att det hände.
Det finns tre bibliotek som täcker de flesta användningsfall för kausal ML i Python. Jag går igenom vad vart och ett gör och visar ett typiskt arbetsflöde.
Innan vi dyker ner i koden, här är en komplett kodsnutt som täcker alla imports och skapandet av datasetet. Du kan installera eventuella saknade beroenden med pip eller uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
Datasetet definierar 1000 kunder i en e-handelsbutik, och jag försöker uppskatta den kausala effekten av ett rabattmejl i dollar. Den sanna kausala effekten av rabatten är 5 USD, men som du ser av utskriften överskattar en naiv jämförelse den sanna effekten eftersom kunder som fick rabatter redan hade fler tidigare köp:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")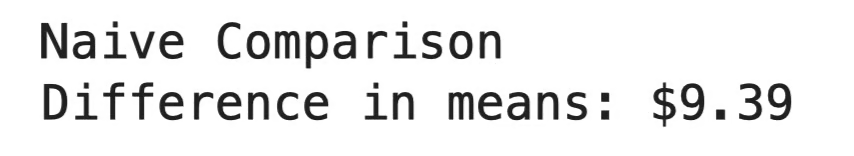
Naiv jämförelse
DoWhy är ett ramverk byggt av Microsoft för end-to-end kausal inferens. Det följer en fyrastegsprocess: modellera problemet som en kausal graf, identifiera den kausala effekten, skatta den och testa sedan om skattningen håller under olika antaganden.
Det som gör DoWhy utmärkande är dess fokus på validering. Efter att ha tagit fram en skattning kör det förvansknings-/refutationstester som utmanar ditt resultat. Om skattningen överlever dessa tester kan du lita mer på den. Om inte vet du att dina antaganden behöver ses över.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")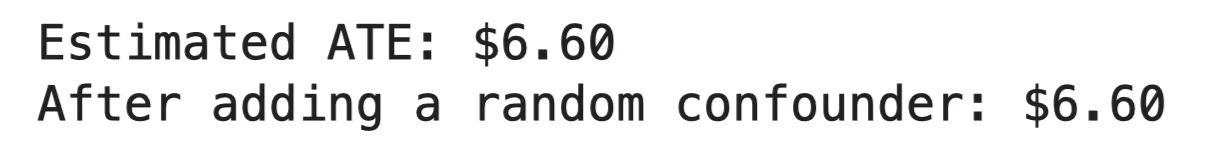
DoWhy-utdata
I genomsnitt ökade rabatten köpesumman med 6,60 USD per kund. Refutationstestet lade till en slumpmässig variabel i modellen, och skattningen förändrades inte alls, vilket betyder att resultatet inte drivs av skensamband. Om skattningen hade flyttat sig mycket hade det varit en varningssignal om att de kausala antagandena var fel.
EconML, också från Microsoft, fokuserar på att skatta heterogena behandlingseffekter. Eller på vanlig svenska: hur effekten varierar mellan olika undergrupper. Det implementerar metoder som Double ML och Causal Forests som jag tog upp tidigare.
EconML följer ett bekant scikit-learn-liknande API med .fit() och .effect()-metoder.
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")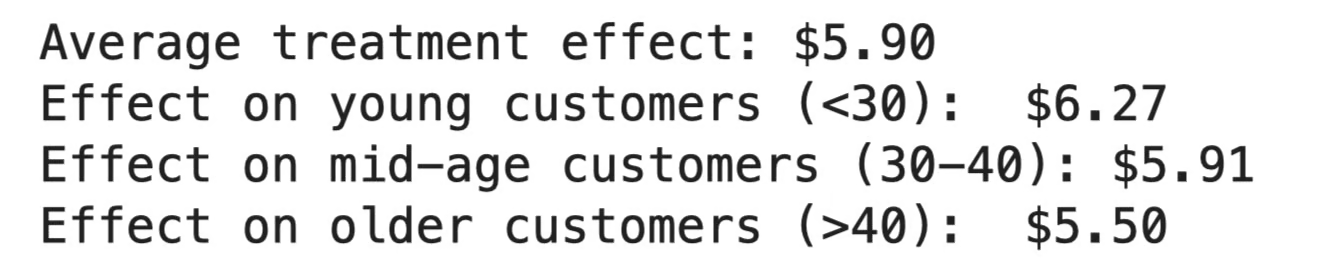
EconML-utdata
Rabatten ökade köpesummorna med 5,90 USD i genomsnitt, men effekten var inte enhetlig. Yngre kunder svarade mest (6,27 USD), medan äldre kunder såg den minsta ökningen (5,50 USD). Om din budget är begränsad visar detta var du bör rikta kampanjen först.
CausalML, byggt av Uber, är utformat för uplift-modellering – att förutsäga vilka individer som svarar mest på en behandling. Det är särskilt populärt inom marknadsföring, där målet är att rikta in sig på kunder som ändrar beteende på grund av en kampanj, inte de som ändå skulle ha konverterat.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())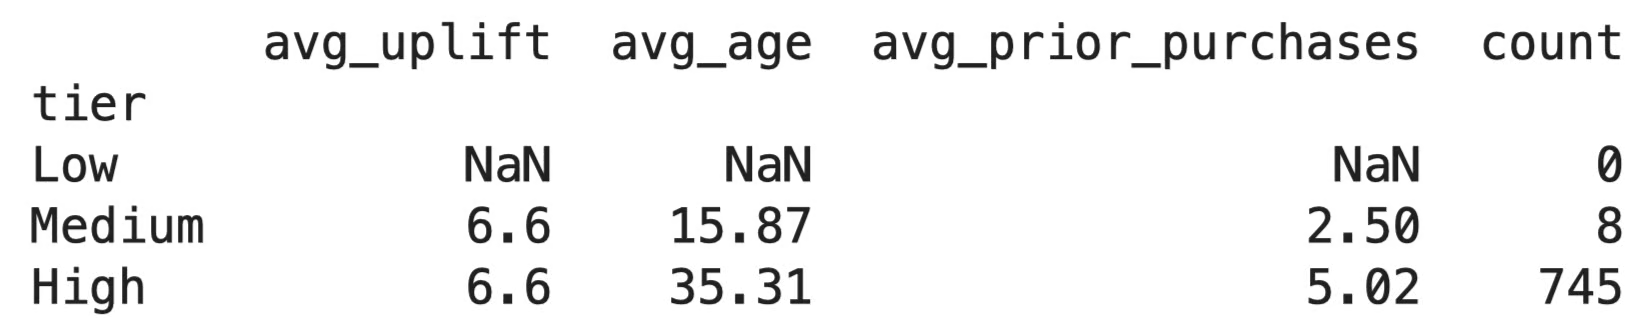
CausalML-utdata
Uplift-poängen är nästan identiska över alla kunder, vilket betyder att rabatten hade ungefär samma effekt på alla – cirka 6,60 USD per person. Det är rimligt för vårt syntetiska dataset, där jag byggde in en platt behandlingseffekt på 5 USD utan variation mellan undergrupper. I verkliga data ser du vanligtvis större spridning, och då blir målgruppsnivåer användbara.
Varje bibliotek har ett idealiskt användningsfall. Använd:
Alla tre fungerar bra tillsammans. Ett vanligt mönster är att definiera din kausala graf i DoWhy, skatta effekter med EconML och använda CausalML för att tolka resultaten.
Kausal ML är ibland lätt att missbruka. Här är misstagen som oftast ställer till det.
Den här är en klassiker. Kunder som använder en funktion mer spenderar också mer, så du drar slutsatsen att funktionen driver spenderandet. Men kanske är högspenderande kunder helt enkelt mer engagerade överlag. Utan en kausal ram gissar du riktningen på relationen.
Varje kausal analys börjar med en fråga: är detta ett mönster, eller är detta en orsak? Om du hoppar över den frågan hjälper ingen mängd modellering.
En störfaktor påverkar både behandling och utfall.
Säg att du mäter effekten av ett träningsprogram på medarbetares prestation. Medarbetare som anmäler sig till träning tenderar att vara mer motiverade. Motivation driver både deltagande (behandling) och prestation (utfall). Om du inte tar hänsyn till det tillskriver du motivationseffekten till träningsprogrammet.
Lösningen är mer strukturell än statistisk. Rita din DAG, kartlägg varje variabel som kan påverka båda sidor och bestäm hur du hanterar var och en innan du tränar en enda modell.
En ATE på 5 USD betyder inte att varje kund tjänade 5 USD. Det är ett genomsnitt, och genomsnitt döljer mycket. Vissa kunder kan ha tjänat 15 USD medan andra förlorade 5 USD.
Det omvända är också farligt. En CATE-skattning för en undergrupp betyder inte att varje individ i den gruppen svarar likadant. Behandlingseffekter är skattningar med osäkerhet, inte garantier. Kontrollera alltid konfidensintervall och basera inte målgruppsurval på enbart punktskattningar.
Siffran som EconML eller DoWhy ger dig är bara så bra som antagandena bakom den. En modell kan inte svara på frågor som dessa:
De kräver någon som förstår problemet. En kausal skog producerar gärna behandlingseffektskattningar från en felaktigt specificerad modell – den talar bara inte om för dig att de är fel.
De bästa kausala analyserna kombinerar ML:s förmåga att hantera komplex data med en människa som vet vilka variabler som spelar roll och varför.
Kausal ML byter frågan från "vad kommer att hända?" till "vad orsakade att det hände?"
Den förskjutningen förändrar hur du fattar beslut. Den får dig att gå från att reagera på mönster till att förstå mekaniken bakom dem. Vissa skulle till och med säga att det är det enda sättet att fatta verkligt datadrivna beslut.
Men verktygen fungerar bara så bra som antagandena du ger dem. En felaktig kausal graf eller en feltolkad behandlingseffekt kan leda dig till slutsatser som känns ”vetenskapliga” och datadrivna men som är fel. Modellen räcker inte upp handen och säger till.
De bästa resultaten kommer från att kombinera ML:s förmåga att hantera komplex data med någon som förstår problemet tillräckligt väl för att ställa rätt kausala frågor. Börja med domänkunskapen och låt sedan modellen göra grovjobbet. Inte svårare än så.
Den första delen är enkel, särskilt med vår kurs Supervised Learning with scikit-learn. Anmäl dig idag för att stärka dina maskininlärningskunskaper med ett oumbärligt Python-bibliotek.
Lär dig med DataCamp
course
course
course