
Last chance! 50% off DataCamp Premium
Sale ends in
Бывали ли у вас ситуации, когда модель машинного обучения умеет предсказывать, кто купит, но не может объяснить, почему они купили?
Традиционное машинное обучение находит закономерности и предсказывает результаты. Оно подскажет, что клиент с высокой вероятностью уйдёт или что продажи снизятся в следующем квартале. Но если спросить, вызвала ли ваша последняя маркетинговая кампания реальный рост продаж или действительно ли лечение улучшило исходы пациентов, оно не знает, что делать. Предсказание и причинность — это разные вещи.
Причинно-следственное машинное обучение сочетает ML с методами причинно-следственного вывода. Вместо вопроса «что произойдёт?» оно задаёт вопрос «что произойдёт, если мы вмешаемся?» — а именно этот вопрос стоит за каждым бизнес-решением или медицинским лечением.
В этой статье мы разберём ключевые концепции причинного ML, методы оценки причинно-следственных связей и то, как применять их на Python.
Если вы новичок в машинном обучении, запишитесь на наш курс Основы машинного обучения на Python.
Стандартные ML-модели учатся на данных и используют закономерности для предсказаний. Они хорошо отвечают на вопрос «что произойдёт?», но не говорят, что стало причиной этого.
Причинно-следственное ML задаёт иной вопрос. Оно комбинирует ML с техниками причинно-следственного вывода, чтобы оценивать причинно-следственные связи по данным. Вместо предсказания исхода оно оценивает, что изменится, если вы предпримете конкретное действие.
Это действие называется вмешательством и представляет собой преднамеренное изменение для оценки его эффекта. Привела ли скидка к реальному росту покупок или эти клиенты всё равно бы купили? Улучшило ли новое лекарство выздоровление или пациенты поправились бы сами?
На эти вопросы предсказания ответить не могут, а причинное ML — может.
Традиционное ML изучает корреляции. Оно находит, что клиенты, получающие письма со скидками, чаще покупают, и использует этот паттерн для предсказания будущих покупок. Но корреляция не говорит, вызвало ли письмо покупку. Возможно, клиенты и так собирались купить.
Причинное ML оценивает причинный эффект письма на покупки. Оно спрашивает, что было бы, если бы вы его не отправили. Разница между «эти вещи часто встречаются вместе» и «эта вещь вызвала ту вещь» — вот что отличает традиционное и причинное ML.
Вот простой способ об этом думать:
Первое помогает предсказывать. Второе помогает принимать решения. Полезны оба подхода.
Большинство бизнес- и управленческих решений по своей природе причинные. Вы спрашиваете не «что будет?», а «что нам делать?»
Вот несколько конкретных примеров:
Стандартные методы ML не отвечают на эти вопросы, потому что воспринимают корреляцию как признак. Две переменные могут меняться вместе из‑за общей причины, а связь может быть и случайной. Причинное ML заставляет задуматься, почему вещи связаны — и приведёт ли изменение одной к реальному изменению другой.
Прежде чем оценивать причинно-следственные эффекты, нужно понять пару вещей, на которых держится любой причинный анализ.
У любого причинного вопроса две части: лечение и исход.
Лечение — это действие или вмешательство, которое вы изучаете. Это может быть лекарство, назначенное пациентам, или скидка, предложенная клиентам. Исход — то, что вы измеряете: время восстановления, частота покупок, производительность и т. п.
Цель причинного ML — оценить, как лечение меняет исход. Речь не о корреляции между двумя величинами, а о том, вызывает ли одна действительно другую.
Вы можете наблюдать, что произошло после приёма лекарства пациентом, но не можете наблюдать, что было бы, если бы он его не принимал. Этот ненаблюдаемый сценарий называется контрфактом.
В другой области: клиент получил скидку 20% и совершил покупку. Контрфактный вопрос: купил бы он без скидки? Вы никогда не узнаете наверняка, потому что нельзя отмотать время и проиграть обе версии с одним и тем же человеком.
Причинное ML оценивает такие контрфакты с помощью статистических методов и предположений. Качество оценки зависит от того, насколько хорошо вы аппроксимируете то, что нельзя напрямую наблюдать.
Конфаундер — это переменная, влияющая и на лечение, и на исход, создавая ложное впечатление причинности.
Например, вы изучаете, снижает ли спорт риск сердечных заболеваний. Люди, кто больше тренируется, чаще и питаются здоровее. Диета влияет и на вероятность занятий (лечение), и на сердечные заболевания (исход). Если игнорировать диету, вы переоцените важность одного лишь спорта.
Конфаундеры — главный риск причинного анализа. Их выявление и учёт делают оценку надёжной — на это стоит потратить время.
Если вы задаётесь вопросом, как определить, какие переменные — конфаундеры, а какие нет, ответ таков: нужно нарисовать граф.
Ориентированный ациклический граф (DAG) — это диаграмма, отображающая причинные связи между переменными. Каждый узел — переменная, а каждая стрелка указывает от причины к следствию. «Ориентированный» означает, что стрелки имеют направление. «Ациклический» — что нет циклов: переменная не может быть причиной самой себя, напрямую или через цепочку.
Возьмём пример со спортом. Простой DAG будет иметь стрелки Диета → Спорт и Диета → Болезни сердца, а также стрелку Спорт → Болезни сердца. Граф наглядно показывает, что Диета — конфаундер, потому что указывает и на лечение, и на исход.
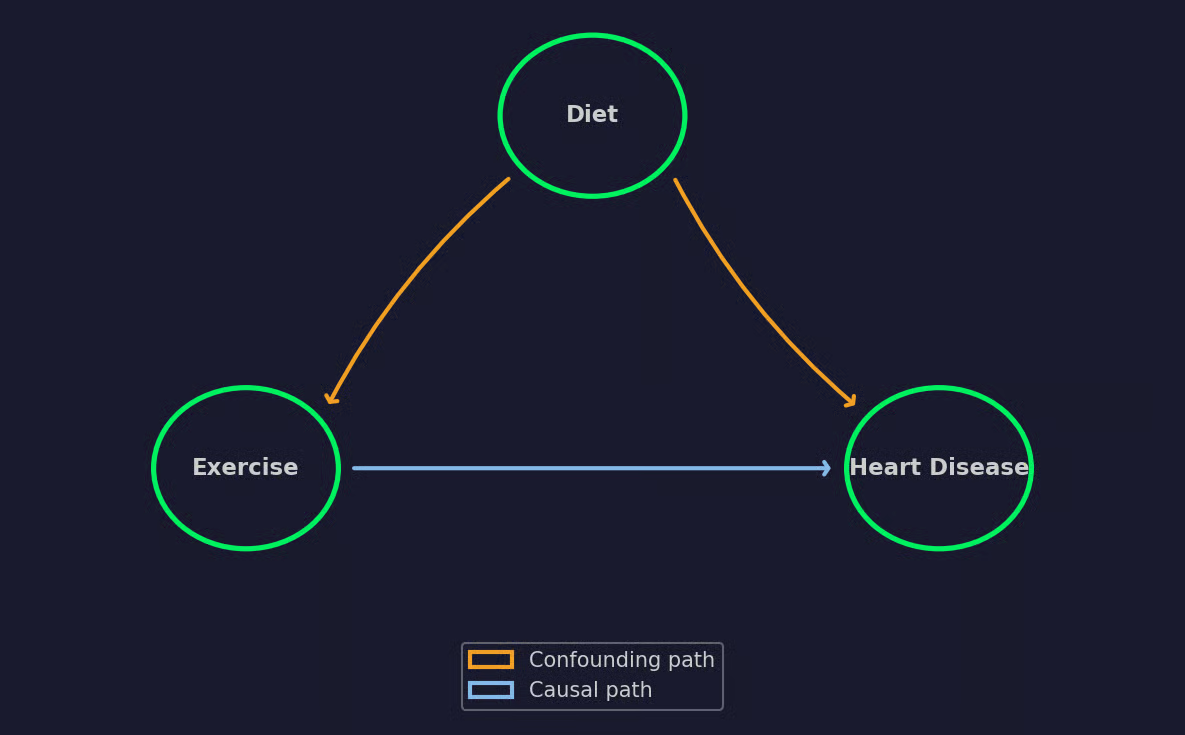
Пример простого DAG
DAG также подсказывают, какие переменные контролировать, а какие оставить. Если контролировать не ту переменную, можно внести смещение вместо того, чтобы его убрать. Думайте о DAG как о дорожной карте всего причинного анализа.
Лучшая часть?
Чтобы построить DAG, математика не нужна. Нужны предметные знания. Граф кодирует ваши предположения о том, как устроен мир, и качество оценок зависит от того, насколько эти предположения верны.
Причинное ML много заимствует из статистики и эконометрики, но масштабирует идеи средствами ML. Рассмотрим четыре самых распространённых подхода.
В идеале вы бы проводили рандомизированный эксперимент для измерения эффекта лечения. Но на практике назначение лечения редко случайно. Получившие лечение часто отличаются от тех, кто не получил, — эти различия вносят смещение.
Методы propensity score оценивают вероятность получения лечения каждым индивидом на основе наблюдаемых характеристик. Эта вероятность и есть propensity score.
Когда у вас есть такие оценки, есть два основных способа их использовать:
Оба метода пытаются смоделировать рандомизированный эксперимент по наблюдательным данным.
Иногда конфаундеры, которые нужно контролировать, отсутствуют в данных. Их нельзя измерить, и propensity score не поможет. Здесь применимы инструментальные переменные (IV).
Инструмент — это переменная, влияющая на лечение, но не имеющая прямого влияния на исход. Она воздействует на исход только через лечение.
Классический пример — изучение влияния образования на доходы. Мотивация влияет и на объём полученного образования, и на заработок — но её нельзя напрямую измерить. Расстояние до ближайшего колледжа может быть инструментом: оно влияет на решение поступать, но не влияет напрямую на будущую зарплату.
На практике найти хороший инструмент сложно. Метод великолепен, когда инструмент есть, но слабый или некорректный инструмент даст вводящие в заблуждение результаты.
Причинные леса расширяют алгоритм случайного леса для оценки эффектов лечения вместо предсказаний. Обычный лес предсказывает исход, а причинный — оценивает, насколько лечение меняет этот исход для разных подгрупп.
Это полезно, когда эффект лечения различается у разных людей. Лекарство может работать лучше у молодых пациентов и хуже — у пожилых. Аналогично, скидка может повысить покупки у чувствительных к цене клиентов и не повлиять на лояльных. Причинные леса выявляют такие различия, разбиениями по признакам, где вариативность эффектов максимальна.
На выходе — персонализированная оценка эффекта лечения для каждого индивида в выборке.
Double Machine Learning (DML) сочетает ML-модели и статистический вывод, чтобы объединить сильные стороны обоих подходов.
Вы используете одну ML-модель для предсказания исхода и другую — для предсказания назначения лечения. Затем смотрите на остатки (то, что модели не объяснили), и связь между ними даёт причинный эффект.
Если вы задаётесь вопросом, зачем все эти шаги, ответ таков. ML-модели отлично ловят паттерны, но вносят смещение при причинной оценке. DML убирает это смещение техникой перекрёстного подбора (cross-fitting), когда обучение и предсказание выполняются на разных разбиениях данных, чтобы избежать переобучения.
Выбрав метод, нужно уметь суммировать результаты. Здесь помогают метрики эффектов лечения.
Средний эффект лечения (ATE) измеряет средний причинный эффект лечения по всей популяции. Если ATE для кампании со скидкой равен $5, это означает, что в среднем скидка увеличила траты на $5 на клиента.
ATE даёт общую картину, но скрывает индивидуальные различия. Среднее $5 может означать, что все потратили на $5 больше, а может — что половина клиентов потратила на $10 больше, а у другой половины изменений нет.
Условный средний эффект лечения (CATE) оценивает эффект лечения для конкретных подгрупп по их характеристикам. Вместо одного числа для всех CATE, например, говорит, что скидка увеличила траты на $8 для новых клиентов и лишь на $2 — для постоянных.
CATE делает причинное ML практически применимым. ATE показывает, работает ли вмешательство. CATE — для кого оно работает, и это то, что нужно для решений на основе данных.
Причинное ML нужно везде, где вы переходите от «что произошло?» к «что нам делать?». Вот несколько примеров.
Больнице нужно понять, какое лечение лучше для конкретного профиля пациента. Стандартный ML предскажет, кто в группе риска, а причинное ML оценит, даст ли Лечение A или Лечение B лучший исход именно для этого пациента. Это позволяет принимать персонализированные решения, основываясь на оценённых эффектах, а не на средних по популяции.
Команда провела промокампанию и видит всплеск продаж. Вопрос: вызвала ли кампания этот всплеск или он связан с сезонным спросом? Причинное ML изолирует реальный эффект кампании, учитывая конфаундеры — время, демографию клиентов и историю покупок.
Государствам и институтам нужно оценивать, достигают ли политики желаемых результатов. Снизила ли программа обучения безработицу? Увеличили ли налоговые льготы инвестиции? Причинное ML даёт каркас для оценки политики, когда рандомизированные эксперименты непрактичны или невозможны.
Команда добавила новую функцию — вовлечённость выросла. Причинное ML помогает понять, вызвала ли функция рост или это совпало с другими изменениями — например, с маркетинговым толчком или сбоем у конкурента. Понимание реального эффекта функции отличает решения на данных от догадок.
Общая мысль: решения зависят от понимания, почему что-то произошло, а не только факта, что это произошло.
Есть три библиотеки, которые покрывают большинство кейсов причинного ML в Python. Рассмотрим, что делает каждая, и типичный рабочий процесс.
Прежде чем перейти к коду, вот полный фрагмент с импортами и созданием набора данных. Установить недостающие зависимости можно с помощью pip или uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
Набор данных описывает 1000 клиентов интернет-магазина, а цель — оценить причинный эффект письма со скидкой в долларах. Истинный причинный эффект скидки равен $5, но, как видно из вывода, наивное сравнение завышает истинный эффект, потому что клиенты со скидкой уже имели больше предыдущих покупок:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")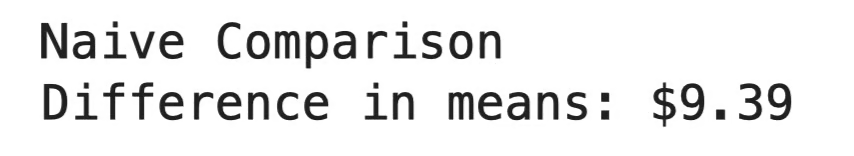
Наивное сравнение
DoWhy — это фреймворк от Microsoft для сквозного причинного вывода. Он следует четырёхшаговому процессу: смоделировать проблему как причинный граф, идентифицировать причинный эффект, оценить его и затем проверить, насколько оценка устойчива к различным допущениям.
Особенность DoWhy — фокус на валидации. Получив оценку, он запускает тесты-«опровержения», которые бросают вызов результату. Если оценка проходит эти тесты, ей можно больше доверять. Если нет — значит, нужно пересмотреть предположения.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")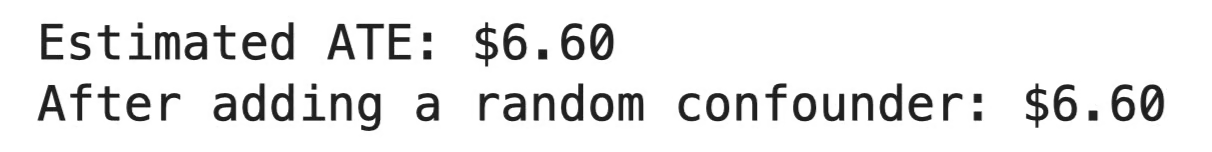
Вывод DoWhy
В среднем скидка увеличила сумму покупки на $6.60 на клиента. В тесте-«опровержении» в модель добавили случайную переменную, и оценка вовсе не изменилась, что означает: результат не обусловлен ложными корреляциями. Если бы оценка сильно сдвинулась, это был бы сигнал, что причинные допущения неверны.
EconML, также от Microsoft, фокусируется на оценке гетерогенных эффектов лечения — проще говоря, как эффект варьируется между подгруппами. Он реализует методы вроде Double ML и причинных лесов, о которых мы говорили выше.
EconML использует знакомый API в стиле scikit-learn с методами .fit() и .effect().
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")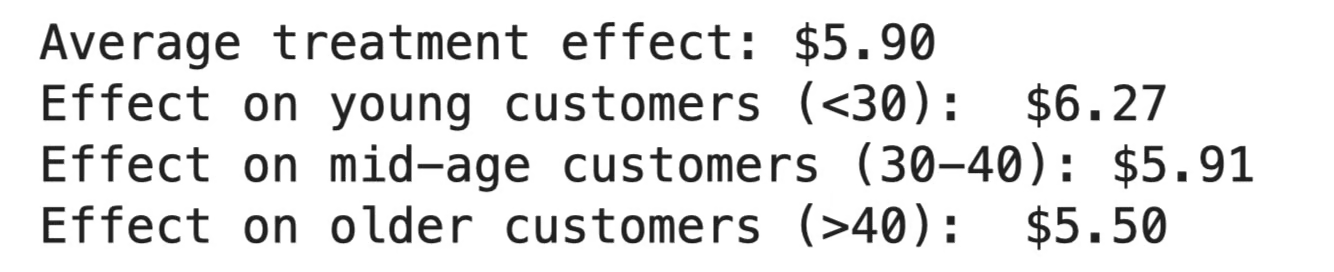
Вывод EconML
Скидка увеличила суммы покупок в среднем на $5.90, но эффект был неодинаков. Молодые клиенты отреагировали сильнее ($6.27), а у пожилых рост был наименьшим ($5.50). Если бюджет ограничен, это подсказывает, куда направить кампанию в первую очередь.
CausalML, созданная в Uber, предназначена для uplift-моделирования — предсказания, кто сильнее всего отреагирует на лечение. Особенно популярна в маркетинге: цель — таргетировать тех, кто изменит поведение из‑за кампании, а не тех, кто и так бы сконвертировался.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())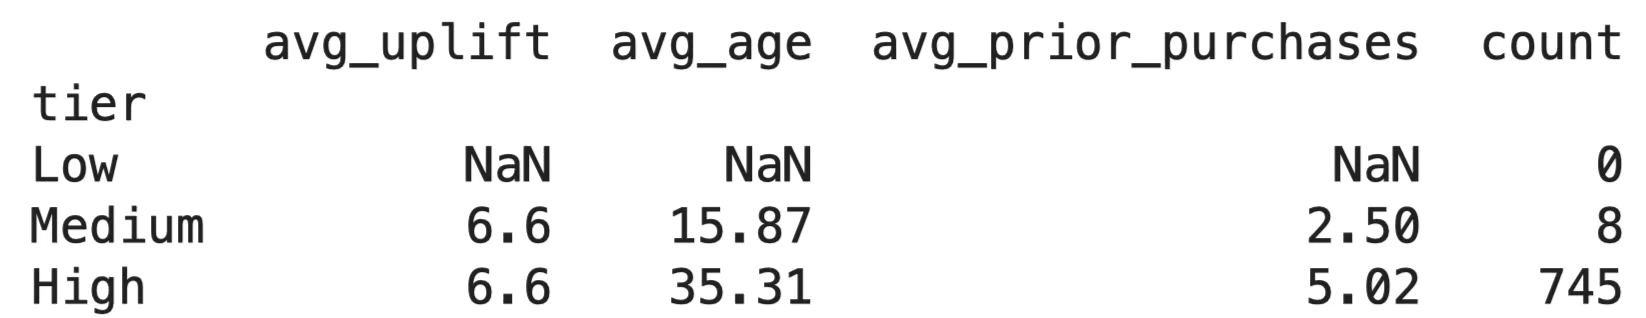
Вывод CausalML
Значения uplift почти одинаковы у всех клиентов, то есть скидка дала примерно одинаковый эффект — около $6.60 на человека. Это логично для синтетических данных, где мы заложили плоский эффект $5 без вариации по подгруппам. В реальных данных разброс обычно больше — там и полезны уровни таргетинга.
У каждой библиотеки своя идеальная область применения. Используйте:
Все три хорошо сочетаются. Типичный паттерн: задать причинный граф в DoWhy, оценить эффекты в EconML и использовать CausalML для интерпретации результатов.
Причинное ML легко использовать неверно. Вот ошибки, которые чаще всего сбивают с толку.
Классика. Клиенты, чаще пользующиеся функцией, больше тратят — вы делаете вывод, что функция увеличивает траты. Но, возможно, клиенты с высокими тратами просто более вовлечены во всём. Без причинного каркаса вы угадываете направление связи.
Любой причинный анализ начинается с вопроса: это паттерн или это причина? Если его пропустить, никакое моделирование не поможет.
Конфаундер влияет и на лечение, и на исход.
Допустим, вы измеряете эффект обучающей программы на эффективность сотрудников. Те, кто записывается на обучение, как правило, более мотивированы. Мотивация влияет и на участие (лечение), и на эффективность (исход). Если её не учесть, вы припишете эффект мотивации программе обучения.
Исправление — скорее структурное, чем статистическое. Нарисуйте DAG, отметьте все переменные, которые могут влиять на обе стороны, и решите, как работать с каждой, прежде чем обучать модель.
ATE = $5 не означает, что каждый клиент получил +$5. Это среднее, а средние многое скрывают. Кто-то мог получить +$15, а кто-то — −$5.
Опасна и обратная крайность. Оценка CATE для подгруппы не означает, что каждый индивидуум в ней отреагирует одинаково. Эффекты лечения — это оценки с неопределённостью, а не гарантии. Всегда проверяйте доверительные интервалы и не принимайте решения по таргетингу только на точечных оценках.
Число, которое выдаёт EconML или DoWhy, ровно настолько хорошо, насколько верны предположения. Модель не ответит на такие вопросы:
На них отвечает тот, кто понимает предметную область. Причинный лес с готовностью выдаст оценки из плохо заданной модели — просто не сообщит, что они неверны.
Лучшие причинные анализы объединяют способность ML работать со сложными данными с экспертом, который понимает, какие переменные важны и почему.
Причинное ML меняет вопрос с «что произойдёт?» на «что это вызвало?»
Этот сдвиг меняет принятие решений. Вы переходите от реакции на паттерны к пониманию механизмов за ними. Некоторые скажут, что это единственный способ принимать по‑настоящему основанные на данных решения.
Но инструменты работают ровно настолько хорошо, насколько верны допущения. Неверный причинный граф или неправильное прочтение эффекта лечения могут привести к выводам, которые кажутся «научными» и основанными на данных, но неверны. Модель не поднимет руку и не предупредит.
Лучшие результаты получаются при сочетании возможностей ML работать со сложными данными с экспертом, который достаточно хорошо понимает проблему, чтобы задавать правильные причинные вопросы. Начните с предметных знаний, а тяжёлую работу поручите модели. Ничего сложного.
С первым пунктом просто — особенно с нашим курсом Supervised Learning with scikit-learn. Запишитесь сегодня, чтобы прокачать навыки ML с обязательной для Python библиотекой.
Учитесь с DataCamp
Курс
Курс
Курс