courses
머신 러닝 이해하기
2
307.3K
머신 러닝 모델이 누가 구매할지는 예측하지만, 왜 구매했는지는 알려주지 못하는 상황을 겪어본 적이 있으신가요?
전통적인 머신 러닝은 패턴을 찾아 결과를 예측합니다. 고객이 이탈할 가능성이 높다거나 다음 분기에 매출이 감소할 것이라 알려줄 수 있죠. 하지만 최신 마케팅 캠페인이 실제로 매출을 늘렸는지, 혹은 어떤 치료가 정말로 환자 결과를 개선했는지를 묻는다면, 어떤 일을 해야 할지 모릅니다. 예측과 인과는 전혀 다른 문제입니다.
인과적 머신 러닝은 머신 러닝에 인과추론 기법을 결합합니다. 그래서 "무슨 일이 일어날까?" 대신 "개입하면 무엇이 일어날까?"를 묻습니다. 이 질문이야말로 모든 비즈니스 의사결정과 의료 처치의 근간입니다.
이 글에서는 인과 ML의 핵심 개념, 인과효과를 추정하는 방법, 그리고 이를 Python에서 적용하는 법을 차근차근 안내합니다.
머신 러닝이 처음이라면, 초보자 친화적인 Python으로 배우는 머신 러닝 기초 트랙에 등록해 보세요.
표준 ML 모델은 데이터에서 패턴을 학습해 예측에 활용합니다. "무슨 일이 일어날까?"에는 능하지만, 왜 그런 일이 일어났는지는 말해주지 못합니다.
인과적 머신 러닝은 다른 질문을 던집니다. ML과 인과추론을 결합해 데이터에서 원인과 결과의 관계를 추정합니다. 그래서 단순히 결과를 예측하는 대신, 특정 조치를 취했을 때 무엇이 달라질지를 추정합니다.
그 조치를 개입이라고 하며, 효과를 보기 위해 의도적으로 가하는 변화입니다. 할인은 실제로 구매를 늘렸을까요, 아니면 어차피 샀을 고객이었을까요? 신약은 회복을 개선했을까요, 아니면 환자가 스스로 나았을까요?
이런 질문은 예측만으로는 답할 수 없지만, 인과 ML이라면 가능합니다.
전통적 ML은 상관관계를 학습합니다. 할인 이메일을 받은 고객이 더 많이 구매하는 경향을 찾아내고, 그 패턴으로 향후 구매를 예측하죠. 하지만 상관관계만으로 이메일이 구매를 유발했는지는 알 수 없습니다. 어쩌면 그 고객들은 원래 살 계획이었을지도 모릅니다.
인과 ML은 이메일이 구매에 미친 인과효과를 추정합니다. 이메일을 보내지 않았다면 어떻게 됐을지를 묻습니다. "함께 나타나는 경향이 있다"와 "이것이 저것을 유발했다"의 차이가 전통적 ML과 인과 ML을 가릅니다.
이렇게 생각해 보세요:
첫 번째는 예측에, 두 번째는 의사결정에 도움을 줍니다. 둘 다 유용합니다.
대부분의 비즈니스와 정책 결정은 본질적으로 인과적입니다. "무슨 일이 일어날까?"가 아니라 "무엇을 해야 할까?"를 묻습니다.
구체적인 예시는 다음과 같습니다.
표준 머신 러닝 방법은 상관관계를 특성으로 다루기 때문에 이런 질문에 답하지 못합니다. 함께 움직이는 두 변수는 공통 원인을 가질 수 있고, 관계가 순전히 우연일 수도 있습니다. 인과 ML은 왜 연결되어 있는지, 하나를 바꾸면 다른 하나가 실제로 달라지는지를 고민하게 만듭니다.
인과효과를 추정하려면, 모든 인과 분석이 의존하는 몇 가지를 먼저 이해해야 합니다.
모든 인과 질문에는 두 부분이 있습니다: 처치와 결과.
처치는 연구하는 행동이나 개입입니다. 환자에게 투여한 약일 수도, 고객에게 제공한 할인일 수도 있습니다. 결과는 측정 대상이며, 예를 들어 회복 시간, 구매율, 생산성 등이 있습니다.
인과 ML의 목적은 처치가 결과를 어떻게 바꾸는지 추정하는 것입니다. 두 변수가 상관관계가 있는지를 보지 않고, 실제로 하나가 다른 하나를 유발하는지를 봅니다.
약을 복용한 뒤에 무슨 일이 일어났는지는 관찰할 수 있지만, 복용하지 않았다면 어떻게 되었을지는 관찰할 수 없습니다. 그 관측 불가능한 시나리오를 반사실이라고 합니다.
다른 예로, 어떤 고객이 20% 할인을 받고 구매했다고 합시다. 반사실은 "할인이 없었어도 구매했을까?"를 묻습니다. 같은 사람에게 시간을 되돌려 두 버전을 동시에 실행할 수 없으니 확실히 알 수는 없습니다.
인과 ML은 통계 기법과 가정을 이용해 이런 반사실을 추정합니다. 직접 관찰할 수 없는 것을 얼마나 잘 근사하느냐가 인과 추정의 품질을 좌우합니다.
혼란변수(confounder)는 처치와 결과 모두에 영향을 주어, 인과처럼 보이는 착시를 일으키는 변수입니다.
예를 들어 운동이 심장병을 줄이는지 연구한다고 합시다. 더 많이 운동하는 사람은 대체로 식습관도 더 건강합니다. 식단은 운동(처치)과 심장병(결과) 모두에 영향을 줍니다. 식단을 무시하면 운동만의 효과를 과대평가하게 됩니다.
혼란변수는 인과 분석에 가장 큰 위협입니다. 이를 식별하고 보정하는 과정이 인과 추정을 신뢰할 수 있게 하며, 충분한 시간을 들일 가치가 있습니다.
무엇이 혼란변수이고 무엇이 아닌지 어떻게 판단할까요? 그래프를 그리면 됩니다.
방향 비순환 그래프(DAG)는 변수 간 인과관계를 도식화한 그림입니다. 각 노드는 변수를, 각 화살표는 원인에서 결과로의 방향을 나타냅니다. "방향"은 화살표에 방향이 있음을, "비순환"은 순환이 없음을 뜻합니다. 즉, 변수는 직접이건 연쇄를 통하건 스스로를 원인으로 만들 수 없습니다.
앞서 예로 든 운동 사례를 보죠. 간단한 DAG는 식단 → 운동, 식단 → 심장병, 그리고 운동 → 심장병의 화살표를 가집니다. 그래프를 보면 식단이 처치와 결과 모두로 향하는 화살표를 가지므로 혼란변수임이 분명해집니다.
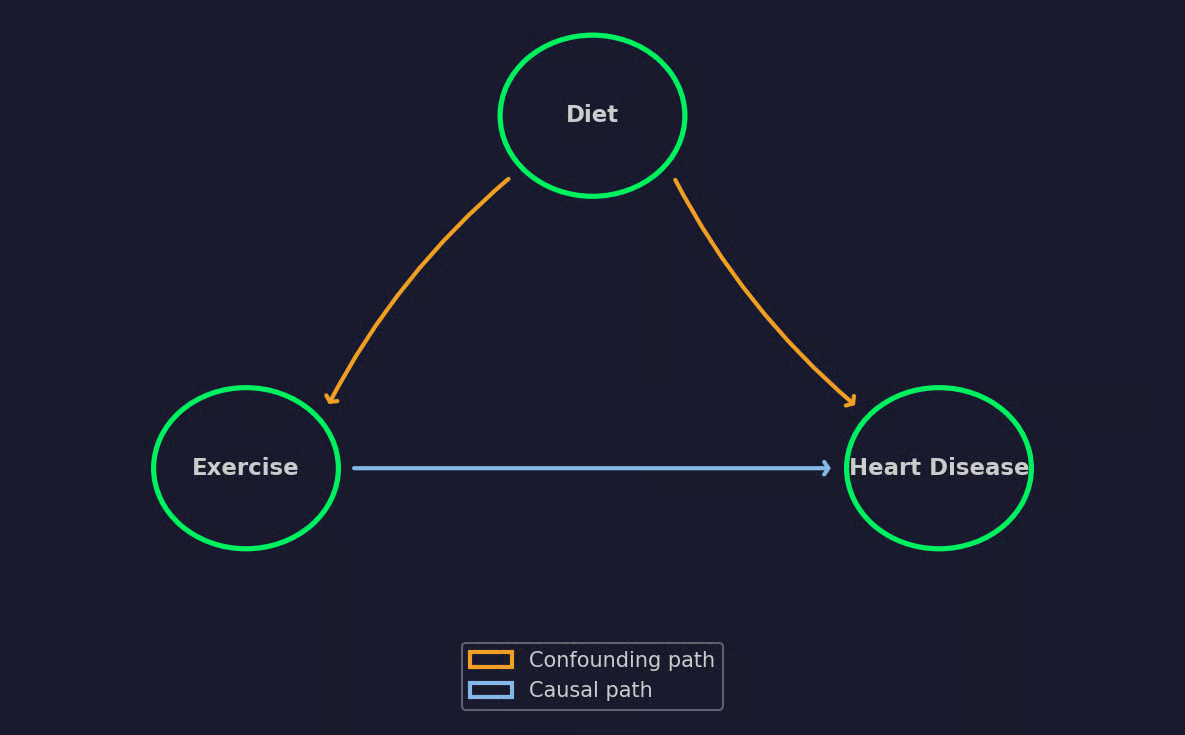
간단한 DAG 예시
DAG는 어떤 변수를 통제하고 어떤 변수는 건드리지 말아야 하는지도 알려줍니다. 잘못된 변수를 통제하면 편향을 제거하기는커녕 오히려 도입할 수도 있습니다. 그런 점에서 DAG는 인과 분석 전체를 위한 로드맵이라 할 수 있습니다.
가장 좋은 점은 뭘까요?
DAG를 만드는 데 수학은 필요 없습니다. 필요한 것은 도메인 지식입니다. 그래프는 세상이 작동하는 방식에 대한 가정을 담고 있으며, 인과 추정의 품질은 그 가정이 얼마나 정확한지에 달려 있습니다.
인과 ML은 통계와 계량경제학에서 많은 것을 차용하면서, 이를 머신 러닝으로 확장합니다. 가장 흔한 네 가지 접근을 살펴보겠습니다.
이상적으로는 무작위 실험을 수행해 처치 효과를 측정합니다. 그러나 실제로 처치 배정은 거의 무작위가 아닙니다. 처치를 받은 사람은 받지 않은 사람과 종종 다르며, 그 차이가 편향을 만듭니다.
성향점수 방법은 관찰된 특성을 바탕으로 각 개인이 처치를 받을 확률을 추정합니다. 그 확률이 곧 성향점수입니다.
점수를 얻으면 사용하는 방법은 두 가지가 있습니다.
두 방법 모두 관찰자료로 무작위 실험을 모사하려는 시도입니다.
때로는 통제해야 할 혼란변수가 데이터에 없습니다. 측정할 수 없으니 성향점수는 도움이 되지 않습니다. 이때 도구변수(IV)가 필요합니다.
도구변수는 처치에는 영향을 주지만 결과에는 직접적인 영향을 주지 않는 변수입니다. 처치를 통해서만 결과에 영향을 미칩니다.
고전적 예시는 교육이 소득에 미치는 효과를 연구하는 경우입니다. 동기부여는 교육 수준과 소득 모두에 영향을 주지만, 직접 측정하기 어렵습니다. 가장 가까운 대학까지의 거리는 대학 진학 여부에는 영향을 주되, 미래 급여에 직접적으로 영향을 주지는 않으므로 도구변수로 작동합니다.
실무에서는 좋은 도구변수를 찾기가 어렵습니다. 적절한 도구가 있다면 훌륭한 방법이지만, 약하거나 타당하지 않은 도구는 오해를 부르는 결과를 낳습니다.
인과 숲(causal forests)은 랜덤 포레스트 알고리즘을 확장해 예측 대신 처치효과를 추정합니다. 표준 랜덤 포레스트가 결과를 예측한다면, 인과 숲은 서로 다른 하위 집단에서 처치가 결과를 얼마나 바꾸는지 추정합니다.
처치효과가 개인에 따라 달라질 때 특히 유용합니다. 어떤 약은 젊은 환자에게는 효과가 크지만 고령층에는 그렇지 않을 수 있습니다. 마찬가지로 할인은 가격에 민감한 고객의 구매를 늘리지만, 충성 고객에게는 영향이 없을 수 있습니다. 인과 숲은 처치효과의 변동이 가장 큰 특성으로 데이터를 분할해 이러한 차이를 포착합니다.
출력은 데이터셋의 각 개인에 대한 개인화된 처치효과 추정치입니다.
더블 머신 러닝(DML)은 ML 모델과 통계적 추론을 결합해 두 세계의 장점을 취합니다.
한 ML 모델로 결과를, 다른 모델로 처치 배정을 예측한 뒤, 두 모델이 설명하지 못한 잔차를 살펴봅니다. 이 잔차 간의 관계가 인과효과를 제공합니다.
왜 이런 추가 단계가 필요할까요? ML 모델은 패턴 포착에는 뛰어나지만, 인과 추정에 사용하면 편향을 초래할 수 있습니다. DML은 교차 적합(cross-fitting)으로 그 편향을 제거합니다. 데이터를 다른 분할로 학습하고 예측해 과적합을 피하는 방식입니다.
방법을 선택했다면, 결과를 요약할 방법이 필요합니다. 여기서 처치효과 지표가 등장합니다.
평균 처치효과(ATE)는 전체 모집단에서 처치의 평균 인과효과를 측정합니다. 할인 캠페인의 ATE가 $5라면, 평균적으로 할인으로 고객당 지출이 $5 증가했다는 뜻입니다.
ATE는 큰 그림을 보여주지만, 개인 간 변이를 숨깁니다. $5 평균은 모두가 $5씩 더 썼다는 의미일 수도, 절반은 $10 늘고 나머지는 변화가 없었다는 의미일 수도 있습니다.
조건부 평균 처치효과(CATE)는 특성에 따라 특정 하위집단의 처치효과를 추정합니다. 모두에게 하나의 수치를 주는 대신, 신규 고객에게는 $8 증가, 재방문 고객에게는 $2 증가와 같이 알려줍니다.
CATE가 인과 ML을 실행 가능하게 만듭니다. ATE는 개입이 효과가 있는지를 알려주고, CATE는 누구에게 효과가 있는지를 알려줍니다. 데이터 기반 의사결정에 필요한 답입니다.
인과 ML은 "무슨 일이 있었나?"에서 "무엇을 해야 하나?"로 전환이 필요할 때 어디서나 등장합니다. 몇 가지 예를 보겠습니다.
병원은 특정 환자 프로파일에 가장 잘 맞는 치료가 무엇인지 알고 싶어합니다. 표준 ML은 누가 위험한지 예측하지만, 인과 ML은 해당 환자에게 치료 A와 치료 B 중 어느 쪽이 더 나은 결과를 낼지 추정합니다. 이는 모집단 평균이 아닌 추정 효과에 기반한 개인 맞춤 치료 결정을 가능하게 합니다.
마케팅 팀이 프로모션을 진행해 매출이 급증했습니다. 질문은, 캠페인이 급증을 야기했는가, 아니면 계절적 수요 때문이었는가입니다. 인과 ML은 시점, 고객 인구통계, 과거 구매행동 같은 혼란변수를 고려해 캠페인의 실제 영향을 분리해 냅니다.
정부와 기관은 정책이 의도한 결과를 내는지 평가해야 합니다. 직업훈련 프로그램이 실업을 줄였는가? 세제 혜택이 투자를 늘렸는가? 무작위 실험이 실용적이지 않거나 불가능한 상황에서 인과 ML은 정책 평가의 틀을 제공합니다.
제품 팀이 새 기능을 추가했고 참여도가 상승했습니다. 인과 ML은 기능이 상승을 유발했는지, 아니면 마케팅 강화나 경쟁사 장애 같은 다른 변화와 동시에 일어난 것인지 판단하는 데 도움을 줍니다. 기능의 실제 영향을 이해해야 데이터에 근거한 결정을 할 수 있습니다.
공통점은, 단지 일어났다는 사실이 아니라 왜 일어났는지를 알아야 의사결정을 할 수 있다는 점입니다.
Python에서 대부분의 인과 ML 사용 사례를 포괄하는 라이브러리가 세 가지 있습니다. 각 라이브러리가 무엇을 하는지 설명하고 일반적인 워크플로를 보여드리겠습니다.
코드로 들어가기 전에, 모든 임포트와 데이터셋 생성을 다루는 전체 코드 스니펫을 보겠습니다. 누락된 의존성은 pip 또는 uv로 설치할 수 있습니다.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
이 데이터셋은 전자상거래 스토어의 고객 1000명을 정의하며, 할인 이메일의 인과효과(달러)를 추정하려 합니다. 할인의 진짜 인과효과는 $5이지만, 출력에서 보듯이 단순 비교는 할인 고객이 이미 과거 구매가 더 많았기 때문에 실제 효과를 과대평가합니다:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")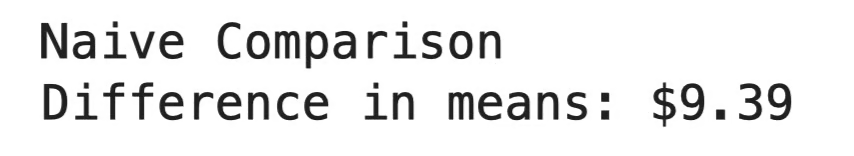
단순 비교
DoWhy는 Microsoft가 구축한 엔드 투 엔드 인과추론 프레임워크입니다. 인과 그래프로 문제를 모델링하고, 인과효과를 식별하고, 추정한 뒤, 다양한 가정하에서 견고한지 검증하는 4단계 과정을 따릅니다.
DoWhy의 강점은 검증에 있습니다. 추정을 마치면 결과에 도전하는 반증(refutation) 테스트를 실행합니다. 그 테스트를 통과하면 결과를 더 신뢰할 수 있습니다. 통과하지 못하면 가정을 재검토해야 한다는 신호입니다.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")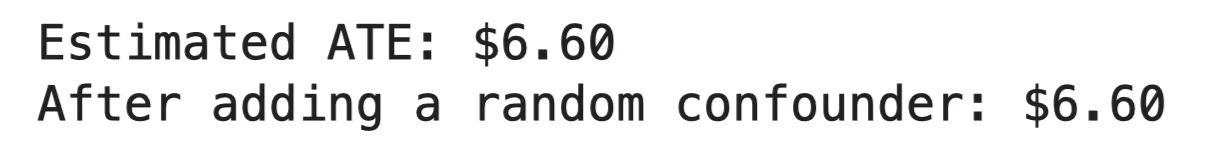
DoWhy 출력
평균적으로 할인은 고객당 구매 금액을 $6.60 늘렸습니다. 반증 테스트는 무작위 변수를 모델에 추가했지만 추정치는 전혀 변하지 않았습니다. 이는 결과가 허위 상관에 의해 좌우되지 않았음을 의미합니다. 만약 추정치가 크게 변했다면, 인과 가정이 빗나갔다는 경고였을 것입니다.
EconML도 Microsoft에서 개발했으며, 이질적 처치효과 추정에 초점을 맞춥니다. 쉽게 말해, 하위집단별로 효과가 어떻게 달라지는지를 파악합니다. 앞서 다룬 더블 ML과 인과 숲 같은 방법을 구현합니다.
EconML은 익숙한 scikit-learn 스타일 API를 따르며 .fit() 및 .effect() 메서드를 제공합니다.
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")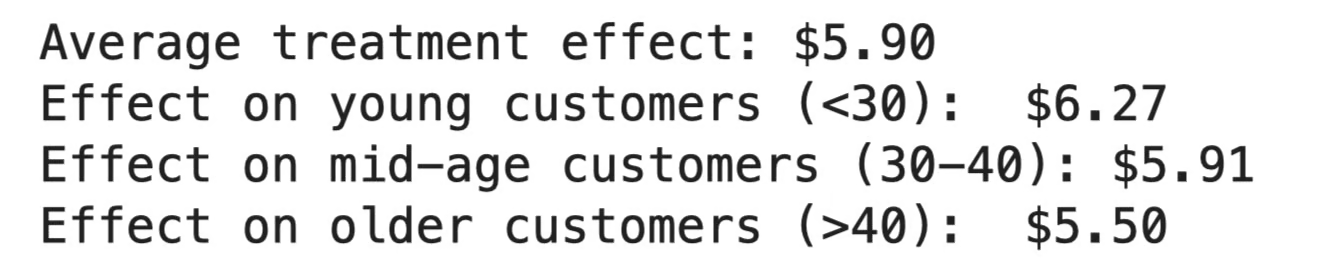
EconML 출력
할인은 평균적으로 구매 금액을 $5.90 늘렸지만, 효과는 균일하지 않았습니다. 젊은 고객의 반응이 가장 컸고($6.27), 고령 고객의 상승폭이 가장 작았습니다($5.50). 예산이 제한적이라면, 캠페인을 어디에 우선 투입해야 할지 시사합니다.
CausalML은 Uber가 구축했으며, 처치에 가장 반응할 개인을 예측하는 업리프트 모델링에 특화되어 있습니다. 캠페인 때문에 행동이 변할 고객을 겨냥하는 것이 목표인 마케팅에서 특히 인기가 높습니다.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())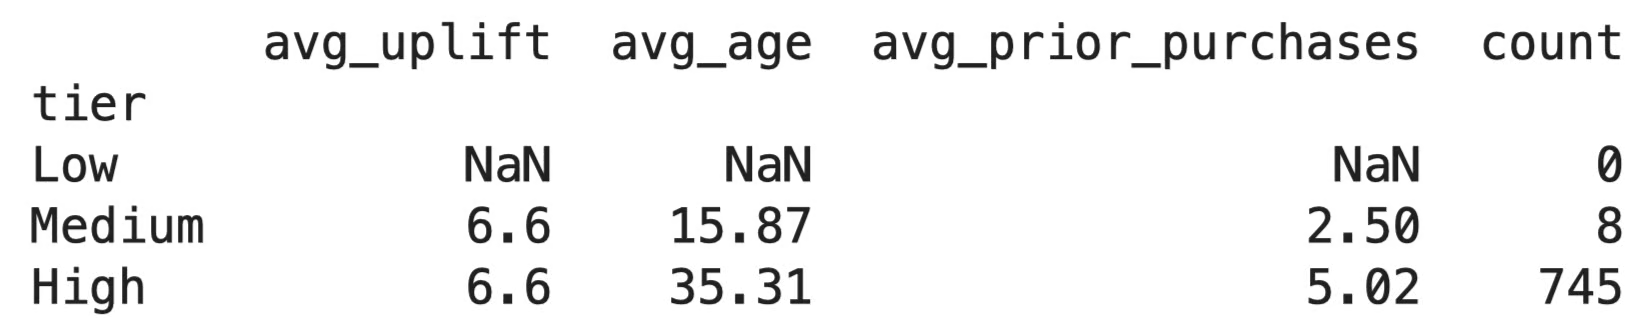
CausalML 출력
업리프트 점수는 거의 모든 고객에서 유사하여, 할인 효과가 대체로 모두에게 비슷했습니다(약 $6.60). 이는 하위집단 변이를 넣지 않은 합성 데이터셋에서 균일한 $5 처치효과를 내장했기 때문입니다. 실제 데이터에서는 보통 분산이 더 크며, 그럴 때 타깃팅 등급이 유용해집니다.
각 라이브러리는 이상적인 사용 사례가 있습니다. 다음과 같이 사용하세요.
세 가지는 함께 사용해도 좋습니다. 일반적인 패턴은 DoWhy로 인과 그래프를 정의하고, EconML로 효과를 추정한 뒤, CausalML로 결과를 해석하는 것입니다.
인과 ML은 때때로 잘못 사용되기 쉽습니다. 사람들이 가장 자주 혼동하는 실수는 다음과 같습니다.
클래식한 실수입니다. 어떤 기능을 더 많이 사용하는 고객이 더 많이 쓴다고 해서, 그 기능이 지출을 늘린다고 결론 내립니다. 하지만 고지출 고객이 전반적으로 더 활발할 수도 있습니다. 인과적 프레임워크 없이 관계의 방향을 짐작만 하는 꼴입니다.
모든 인과 분석은 이 질문에서 시작합니다. 이것이 패턴인가, 원인인가? 이 질문을 건너뛰면 어떤 모델링도 도움이 되지 않습니다.
혼란변수는 처치와 결과 모두에 영향을 줍니다.
직무 교육이 직원 성과에 미치는 영향을 측정한다고 합시다. 교육에 참여하는 직원은 대체로 동기부여가 더 높습니다. 동기는 참여(처치)와 성과(결과) 모두를 끌어올립니다. 이를 고려하지 않으면 동기의 효과를 교육 프로그램의 효과로 착각하게 됩니다.
해결책은 통계라기보다 구조적입니다. DAG를 그리고, 양쪽에 영향을 줄 수 있는 변수를 모두 나열한 뒤, 각 변수를 어떻게 다룰지 모델을 학습하기 전에 결정하세요.
ATE가 $5라고 해서 모든 고객이 $5를 얻었다는 뜻은 아닙니다. 평균은 많은 것을 숨깁니다. 어떤 고객은 $15 늘고, 다른 고객은 $5 줄었을 수도 있습니다.
반대로 CATE를 하위집단에 적용했다고 해서 그 집단의 모든 개인이 똑같이 반응한다는 뜻도 아닙니다. 처치효과는 불확실성을 동반한 추정치이지 보장이 아닙니다. 항상 신뢰구간을 확인하고, 점추정치만으로 타깃팅 결정을 내리지 마세요.
EconML이나 DoWhy가 내놓는 숫자는 그 뒤에 있는 가정만큼만 좋습니다. 모델은 다음과 같은 질문에 답해주지 못합니다.
이들은 문제를 이해하는 사람이 필요합니다. 인과 숲은 잘못 지정된 모델에서도 기꺼이 처치효과를 산출하지만, 그 결과가 틀렸다고 알려주지는 않습니다.
최고의 인과 분석은 복잡한 데이터를 다루는 ML의 능력과, 어떤 변수가 왜 중요한지 아는 사람의 지식을 결합합니다.
인과 ML은 질문을 "무슨 일이 일어날까?"에서 "무엇이 그것을 일어나게 했는가?"로 바꿉니다.
이 전환은 의사결정 방식을 바꿉니다. 패턴에 반응하는 데서, 그 이면의 메커니즘을 이해하는 것으로 옮겨갑니다. 어떤 이들은 이것이야말로 진정한 데이터 기반 의사결정을 하는 유일한 방법이라고 말하기도 합니다.
하지만 도구는 가정만큼만 작동합니다. 잘못된 인과 그래프나 처치효과 오독은 "과학적"이고 데이터 기반처럼 보이지만 틀린 결론으로 이끌 수 있습니다. 모델이 손을 들고 알려주지 않습니다.
최고의 결과는 복잡한 데이터를 다루는 ML의 능력과, 올바른 인과 질문을 던질 만큼 문제를 잘 아는 사람의 결합에서 나옵니다. 도메인 지식에서 출발하고, 무거운 일은 모델에 맡기세요. 그 이상도 이하도 아닙니다.
첫걸음은 쉽습니다. 특히 우리의 scikit-learn으로 배우는 지도학습 코스와 함께라면 더 그렇습니다. 오늘 등록해 꼭 알아야 할 Python 라이브러리로 머신 러닝 실력을 키우세요.
DataCamp로 학습하세요
courses
courses
courses