Kurs
Machine Learning'i Anlamak
2 sa
307.3K
Makine öğrenimi modelinizin kimin satın alacağını tahmin edebildiği, ancak neden satın aldığını söyleyemediği bir durumla karşılaştınız mı?
Geleneksel makine öğrenimi kalıpları tespit edip sonuçları tahmin edebilir. Size bir müşterinin churn etme olasılığının yüksek olduğunu ya da gelecek çeyrekte satışların düşeceğini söyler. Ancak en son pazarlama kampanyanızın gerçekten daha fazla satışa yol açıp açmadığını ya da bir tedavinin hastaların sonuçlarını gerçekten iyileştirip iyileştirmediğini sorarsanız, ne yapacağını bilemez. Tahmin ve nedensellik iki farklı şeydir.
Nedensel makine öğrenimi, makine öğrenimini nedensel çıkarım teknikleriyle birleştirir. Böylece "ne olacak?" yerine "müdahale edersek ne olur?" diye sorar — ve bu, her iş kararının veya tıbbi tedavinin arkasındaki sorudur.
Bu yazıda, nedensel ML’in temel kavramlarını, neden-sonuç ilişkisini tahmin etmek için kullanılan yöntemleri ve bunları Python’da nasıl uygulayacağınızı anlatacağım.
Makine öğreniminde yeniyseniz, başlangıç düzeyine uygun Python ile Makine Öğreniminin Temelleri eğitim yolumuza kaydolun.
Standart ML modelleri verilerden kalıplar öğrenir ve bunları kullanarak tahminler yapar. "Ne olacak?" sorusuna yanıt vermede iyidirler, ancak bunun neden olduğunu söyleyemezler.
Nedensel makine öğrenimi farklı bir soru sorar. ML’i nedensel çıkarım teknikleriyle birleştirerek verilerden neden-sonuç ilişkilerini tahmin eder. Yani bir sonucu tahmin etmek yerine, belirli bir eylemi yaparsanız neyin değişeceğini tahmin eder.
Bu eyleme müdahale denir ve etkisini görmek için kasıtlı olarak yaptığınız bir değişimi ifade eder. İndirim gerçekten daha fazla satın alımı mı tetikledi, yoksa o müşteriler zaten satın alacak mıydı? Yeni ilaç iyileşmeyi artırdı mı, yoksa hastalar kendiliğinden mi iyileşti?
Bunlar, tahminin yanıtlayamayacağı ancak nedensel ML’in yanıtlayabileceği sorulardır.
Geleneksel ML korelasyonları öğrenir. İndirim e-postası alan müşterilerin daha çok satın alma eğiliminde olduğunu bulur ve bu kalıbı gelecekteki satın alımları tahmin etmek için kullanır. Ancak korelasyon, e-postanın satın alıma neden olup olmadığını söylemez. Belki de o müşteriler zaten satın almayı planlıyordu.
Nedensel ML, e-postanın satın alımlar üzerindeki nedensel etkisini tahmin eder. E-postayı göndermemiş olsaydınız ne olurdu diye sorar. "Bu şeyler birlikte görülme eğiliminde" ile "bu şey şuna neden oldu" arasındaki fark, geleneksel ML ile nedensel ML’i ayırır.
Bunu düşünmenin basit bir yolu:
İlki size tahmin yapmada yardımcı olur. İkincisi karar vermenizi sağlar. İkisi de faydalıdır.
Çoğu iş ve politika kararı doğası gereği nedenseldir. "Ne olacak?" diye sormazsınız — "Ne yapmalıyız?" diye sorarsınız.
İşte bazı somut örnekler:
Standart makine öğrenimi yöntemleri bu soruların hiçbirini yanıtlayamaz çünkü korelasyonu bir özellik olarak ele alır. Birlikte hareket eden iki değişken ortak bir nedene sahip olabilir ya da ilişki tamamen tesadüf olabilir. Nedensel ML, şeylerin neden bağlantılı olduğunu ve birini değiştirmek diğerini gerçekten değiştirir mi diye düşünmenizi sağlar.
Neden-sonuç tahmini yapmadan önce, her nedensel analizin dayandığı birkaç şeyi anlamanız gerekir.
Her nedensel sorunun iki parçası vardır: bir tedavi ve bir sonuç.
Tedavi, incelediğiniz eylem veya müdahaledir. Hastalara verilen bir ilaç ya da müşterilere sunulan bir indirim olabilir. Sonuç ise ölçtüğünüz şeydir; iyileşme süresi, satın alma oranı ya da verimlilik gibi.
Nedensel ML’in amacı, tedavinin sonucu nasıl değiştirdiğini tahmin etmektir. İkisinin korele olup olmadığını değil, birinin diğerine gerçekten neden olup olmadığını tahmin eder.
Bir hastanın ilacı aldıktan sonra ne olduğunu gözlemleyebilirsiniz, ancak almasa ne olacağını gözlemleyemezsiniz. Bu gözlemlenmeyen senaryoya kontrafaktüel denir.
Başka bir alanda, diyelim ki bir müşteri %20 indirim aldı ve satın alma yaptı. Kontrafaktüel şunu sorar: İndirim olmadan da satın alır mıydı? Bunu asla kesin olarak bilemezsiniz çünkü zamanı geri sarıp aynı kişi üzerinde iki versiyonu çalıştıramazsınız.
Nedensel ML bu kontrafaktüelleri istatistiksel teknikler ve varsayımlar kullanarak tahmin eder. Nedensel tahmininizin kalitesi, doğrudan gözlemleyemediğinizi ne kadar iyi yaklaştığınıza bağlıdır.
Karıştırıcı, hem tedaviyi hem sonucu etkileyen ve nedensellik izlenimi yaratan bir değişkendir.
Örneğin egzersizin kalp hastalığını azaltıp azaltmadığını inceliyorsunuz. Daha çok egzersiz yapan insanlar genellikle daha sağlıklı beslenir. Beslenme hem egzersiz olasılığını (tedavi) hem de kalp hastalığını (sonuç) etkiler. Beslenmeyi göz ardı ederseniz, tek başına egzersizin önemini olduğundan fazla tahmin edersiniz.
Karıştırıcılar, nedensel analizin en büyük tehdididir. Onları belirlemek ve hesaba katmak, nedensel tahmini güvenilir kılar ve üzerine zaman harcamaya değer bir konudur.
Hangi değişkenlerin karıştırıcı olup olmadığını nasıl anlayacağınızı merak ediyorsanız, bir grafik çizersiniz.
Bir yönlendirilmiş çevrimsiz grafik (DAG) değişkenler arasındaki nedensel ilişkileri haritalayan bir diyagramdır. Her düğüm bir değişkeni temsil eder ve her ok bir nedenden etkisine doğru işaret eder. "Yönlendirilmiş" okların bir yönü olduğu anlamına gelir. "Çevrimsiz" ise döngü olmadığı — bir değişkenin doğrudan ya da dolaylı olarak kendine neden olamayacağı — anlamına gelir.
Önceki egzersiz örneğini ele alalım. Basit bir DAG’de Beslenme - Egzersiz ve Beslenme - Kalp Hastalığı yönünde oklar, ayrıca Egzersiz - Kalp Hastalığı yönünde bir ok olurdu. Grafik, Beslenme’nin hem tedaviye hem sonuca giden okları olduğu için karıştırıcı olduğunu açıkça gösterir.
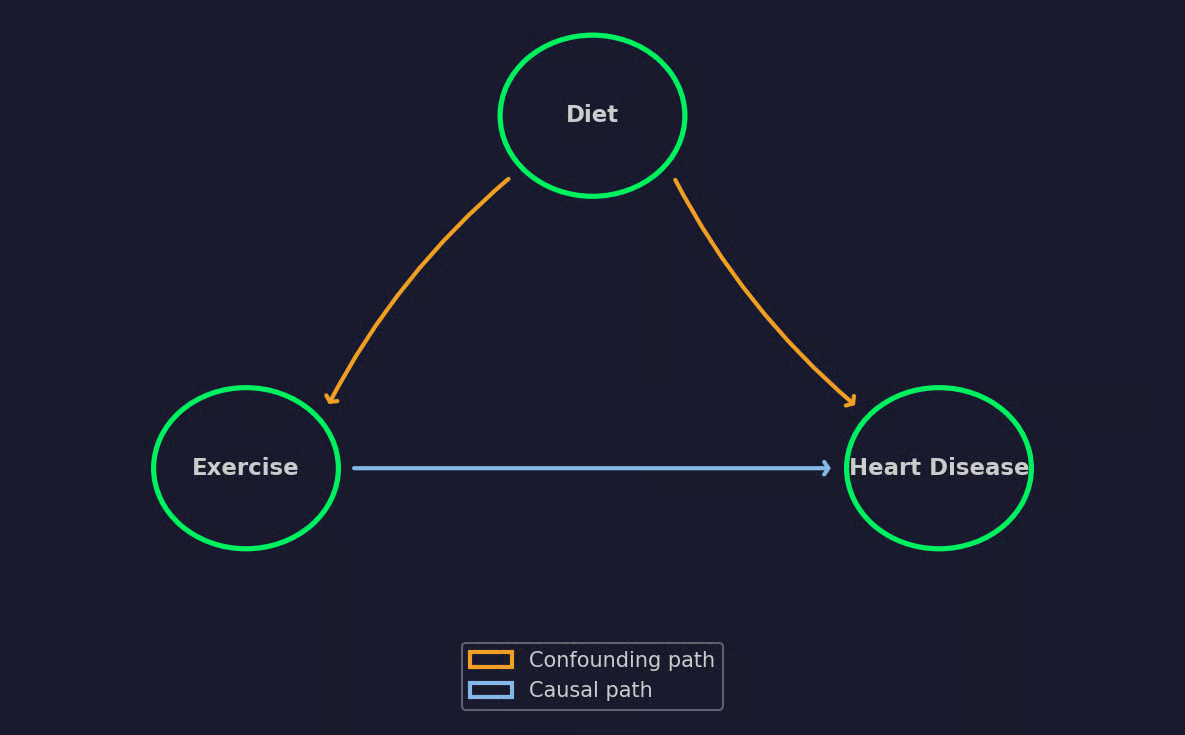
Basit bir DAG örneği
DAG’ler ayrıca hangi değişkenleri kontrol edeceğinizi ve hangilerine dokunmayacağınızı da söyler. Yanlış değişkeni kontrol ederseniz, önyargıyı gidermek yerine aslında önyargı katabilirsiniz. Bunu aklınızda tutarak, bir DAG’i tüm nedensel analiziniz için bir yol haritası olarak düşünün.
En iyi kısmı?
Bir DAG oluşturmak için matematik bilmeniz gerekmez. Alan bilgisinin olması yeterlidir. Grafik, dünyanın nasıl işlediğine dair varsayımlarınızı kodlar ve nedensel tahminlerinizin kalitesi bu varsayımların doğru olup olmamasına bağlıdır.
Nedensel ML, istatistik ve ekonometreden çok şey ödünç alır, ancak bu fikirleri makine öğrenimiyle ölçekler. En yaygın dört yaklaşımı anlatacağım.
İdeal bir dünyada, bir tedavinin etkisini ölçmek için rastgeleleştirilmiş bir deney yürütürdünüz. Ancak pratikte, tedavi atamaları nadiren rastgeledir. Tedavi alan kişiler çoğu zaman almayanlardan farklıdır — ve bu farklılıklar önyargı yaratır.
Eğilim skoru yöntemleri, her bireyin gözlemlenen özelliklerine dayanarak tedaviyi alma olasılığını tahmin ederek bunu ele alır. Bu olasılık, eğilim skorudur.
Skorlar elinizde olduğunda, bunları kullanmanın iki ana yolu vardır:
Her iki yöntem de gözlemsel verilerle rastgeleleştirilmiş bir deneyin nasıl görüneceğini taklit etmeye çalışır.
Bazen kontrol etmeniz gereken karıştırıcılar verinizde yoktur. Onları ölçemezsiniz, dolayısıyla eğilim skorları işe yaramaz. İşte burada araç değişkenleri (IV) devreye girer.
Bir araç, tedaviyi etkileyen ancak sonuç üzerinde doğrudan etkisi olmayan bir değişkendir. Sonucu yalnızca tedavi yoluyla etkiler.
Klasik bir örnek, eğitimin kazanç üzerindeki etkisini incelemektir. Motivasyon, birinin ne kadar eğitim aldığına da ne kadar kazandığına da etki eder — ancak motivasyonu doğrudan ölçemezsiniz. En yakın üniversiteye olan mesafe iyi bir araçtır, çünkü birinin üniversiteye gidip gitmemesini etkiler, ancak gelecekteki maaşını doğrudan etkilemez.
Pratikte iyi bir araç bulmak zordur. Elinizde varsa yöntem harikadır, ancak zayıf veya geçersiz bir araç yanıltıcı sonuçlar üretir.
Nedensel ormanlar, rastgele orman algoritmasını tahmin yerine tedavi etkilerini tahmin edecek şekilde genişletir. Standart bir rastgele orman bir sonucu tahmin ederken, nedensel orman farklı alt gruplar için tedavinin o sonucu ne kadar değiştirdiğini tahmin eder.
Bu, tedavi etkisi bireyler arasında değiştiğinde kullanışlıdır. Bir ilaç genç hastalarda iyi çalışıp yaşlılarda çalışmayabilir. Benzer şekilde, bir indirim fiyat duyarlı müşterilerde satın alımları artırırken, sadık alıcılarda etkisiz olabilir. Nedensel ormanlar, tedavi etkilerindeki en büyük farklılaşmayı üreten özelliklere göre veriyi bölerek bu farklılıkları yakalar.
Çıktı, veri kümenizdaki her birey için kişiselleştirilmiş bir tedavi etkisi tahminidir.
Çift makine öğrenimi (DML), ML modellerini istatistiksel çıkarımla birleştirerek iki dünyanın en iyilerini bir araya getirir.
Bir ML modelini sonucu tahmin etmek, bir diğerini ise tedavi atamasını tahmin etmek için kullanırsınız. Ardından artık değerlere (her iki modelin de açıklayamadığı kısımlar) bakarsınız ve aralarındaki ilişki size nedensel etkiyi verir.
Ek adımların sebebini merak ediyorsanız, cevap şu. ML modelleri kalıpları yakalamakta harikadır, ancak nedensel tahmin için kullanıldıklarında önyargı katabilirler. DML, çapraz uyum adı verilen bir teknikle bu önyargıyı giderir; burada aşırı uyumu önlemek için verinin farklı bölümlerinde eğitip tahmin yaparsınız.
Bir yöntem seçtikten sonra, bulguları özetlemenin bir yoluna ihtiyacınız olur. İşte burada tedavi etkisi metrikleri devreye girer.
Ortalama Tedavi Etkisi (ATE) tedavinin tüm popülasyonunuz genelindeki ortalama nedensel etkisini ölçer. Bir indirim kampanyasının ATE’si 5 $ ise, ortalama olarak indirim kişi başına harcamayı 5 $ artırdı demektir.
ATE size büyük resmi verir, ancak bireysel farklılıkları gizler. 5 $’lık bir ortalama, herkesin 5 $ daha fazla harcadığı anlamına gelebileceği gibi, müşterilerin yarısının 10 $ daha fazla harcayıp diğer yarısının hiç değişim göstermemesi de olabilir.
Koşullu Ortalama Tedavi Etkisi (CATE), özelliklerine göre belirli alt gruplar için tedavi etkisini tahmin eder. Yani herkes için tek bir sayı yerine, CATE size indirimin yeni müşteriler için harcamayı 8 $, geri dönenler içinse yalnızca 2 $ artırdığını söyler.
CATE, nedensel ML’i eyleme dönüştürülebilir kılar. ATE, bir müdahalenin işe yarayıp yaramadığını söyler. CATE ise kimler için işe yaradığını — ve veri odaklı kararlar vermek için ihtiyacınız olan cevabı — verir.
Nedensel ML, "ne oldu?"dan "ne yapmalıyız?"a geçmeniz gereken her yerde karşınıza çıkar. İşte birkaç örnek.
Bir hastane, belirli bir hasta profili için hangi tedavinin en iyi sonucu verdiğini bilmek ister. Standart ML kimin risk altında olduğunu tahmin edebilir, ancak nedensel ML, o hasta için Tedavi A’nın mı yoksa Tedavi B’nin mi daha iyi sonuç üreteceğini tahmin eder. Bu, nüfus ortalamaları yerine tahmini etkilere dayalı kişiselleştirilmiş tedavi kararlarına olanak tanır.
Bir pazarlama ekibi bir promosyon kampanyası yürütür ve satışlarda bir sıçrama görür. Soru şu: Sıçramaya kampanya mı neden oldu, yoksa mevsimsel talep mi tetikledi? Nedensel ML, zamanlama, müşteri demografisi ve önceki satın alma davranışı gibi karıştırıcıları hesaba katarak gerçek kampanya etkisini izole eder.
Hükümetler ve kurumlar, politikaların istenen sonuçları üretip üretmediğini değerlendirmeye ihtiyaç duyar. Bir iş eğitimi programı işsizliği azalttı mı? Bir vergi teşviki yatırımı artırdı mı? Rastgele deneylerin pratik olmadığı veya mümkün olmadığı durumlarda nedensel ML politika değerlendirmesi için bir çerçeve sunar.
Bir ürün ekibi yeni bir özellik ekler ve etkileşim artar. Nedensel ML, artışın özelliğin kendisinden mi kaynaklandığını, yoksa bir pazarlama hamlesi ya da bir rakibin hizmet dışı kalması gibi diğer değişimlerle mi çakıştığını belirlemeye yardımcı olur. Bir özelliğin gerçek etkisini anlamak, veriye dayalı kararları rastgele tahminlerden ayırır.
Ortak nokta, kararların sadece bir şeyin olduğuna değil, neden olduğuna dair bilgiye bağlı olmasıdır.
Python’da çoğu nedensel ML kullanım durumunu kapsayan üç kütüphane vardır. Her birinin ne yaptığını anlatacak ve tipik bir iş akışı göstereceğim.
Koda dalmadan önce, tüm içe aktarmaları ve veri kümesi oluşturmayı kapsayan tam bir kod parçası burada. Eksik bağımlılıkları pip veya uv ile kurabilirsiniz.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
Veri kümesi bir e-ticaret mağazasındaki 1000 müşteriyi tanımlar ve ben indirim e-postasının dolardaki nedensel etkisini tahmin etmeye çalışıyorum. İndirimin gerçek nedensel etkisi 5 $’tır, ancak çıktıda görülebileceği gibi, saf bir karşılaştırma gerçek etkiyi olduğundan fazla tahmin eder; çünkü indirim alan müşterilerin zaten daha fazla önceki satın alımı vardı:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")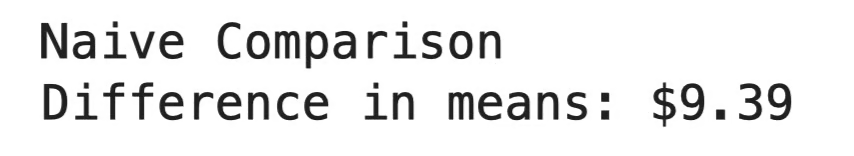
Saf karşılaştırma
DoWhy, Microsoft tarafından uçtan uca nedensel çıkarım için geliştirilmiş bir çerçevedir. Dört adımlı bir süreç izler: problemi bir nedensel grafik olarak modellemek, nedensel etkiyi tanımlamak, tahmin etmek ve ardından tahminin farklı varsayımlar altında ayakta kalıp kalmadığını test etmek.
DoWhy’ı öne çıkaran şey doğrulamaya odaklanmasıdır. Bir tahmin ürettikten sonra, sonucu zorlayan çürütme testleri çalıştırır. Tahmin bu testlerden sağ çıkarsa sonuçlara daha çok güvenebilirsiniz. Çıkmazsa, varsayımlarınızın üzerinde çalışmanız gerektiğini bilirsiniz.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")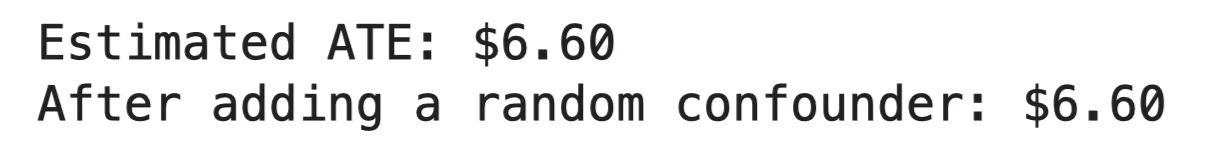
DoWhy çıktısı
Ortalama olarak, indirim kişi başına satın alma tutarını 6,60 $ artırdı. Çürütme testi modele rastgele bir değişken ekledi ve tahmin hiç değişmedi; bu da sonucun sahte korelasyonlardan kaynaklanmadığı anlamına gelir. Tahmin çok değişseydi, nedensel varsayımların hatalı olduğuna dair bir uyarı işareti olurdu.
EconML de Microsoft’tan olup, heterojen tedavi etkilerinin tahminine odaklanır. Yani sade bir ifadeyle, etkinin farklı alt gruplar arasında nasıl değiştiği. Daha önce ele aldığım Çift ML ve Nedensel Ormanlar gibi yöntemleri uygular.
EconML, tanıdık bir scikit-learn tarzı API izler; .fit() ve .effect() metotlarıyla.
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")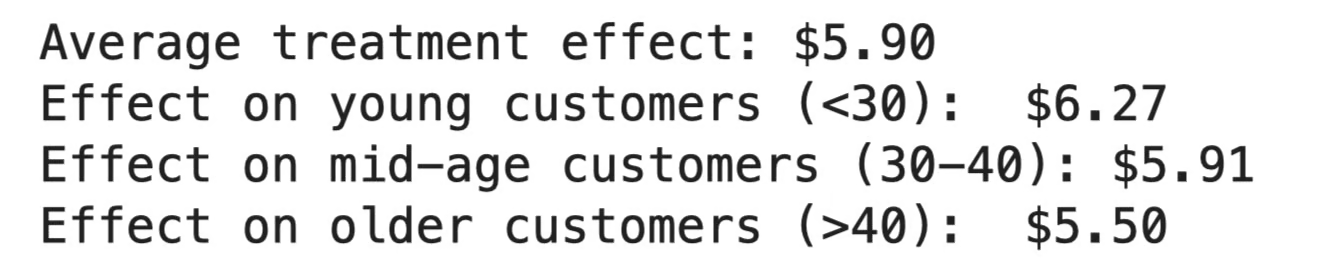
EconML çıktısı
İndirim, ortalama olarak satın alma tutarını 5,90 $ artırdı, ancak etki homojen değildi. Genç müşteriler en çok yanıt verdi (6,27 $), yaşlı müşterilerde ise artış en düşüktü (5,50 $). Bütçeniz sınırlıysa, bu sonuç kampanyayı önce nereye yönlendirmeniz gerektiğini söyler.
CausalML, Uber tarafından geliştirilmiş olup uplift modellemesi için tasarlanmıştır — bir tedaviye en çok kimlerin yanıt vereceğini tahmin etmek. Özellikle, amacın, kampanya nedeniyle davranışını değiştirecek müşterileri hedeflemek olduğu pazarlamada popülerdir; zaten dönüşüm yapacak olanları değil.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())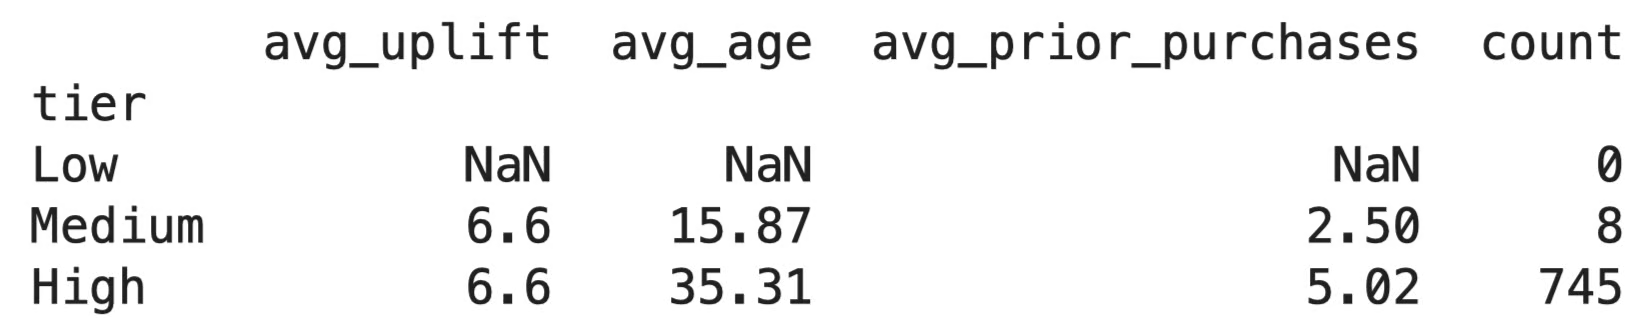
CausalML çıktısı
Uplift skorları tüm müşterilerde neredeyse aynıdır; bu da indirimin herkeste kabaca aynı etkiye sahip olduğu — kişi başı yaklaşık 6,60 $ — anlamına gelir. Bu, alt gruplara göre varyasyon içermeyen düz 5 $’lık bir tedavi etkisi yerleştirdiğim sentetik veri kümesi için mantıklıdır. Gerçek dünya verilerinde genellikle daha fazla yayılım görürsünüz ve hedefleme katmanları burada faydalı hale gelir.
Her kütüphanenin ideal bir kullanım durumu vardır. Şunları kullanın:
Üçü de birlikte iyi çalışır. Yaygın bir örüntü, nedensel grafiğinizi DoWhy ile tanımlamak, etkileri EconML ile tahmin etmek ve sonuçları yorumlamak için CausalML kullanmaktır.
Nedensel ML bazen yanlış kullanılmaya açıktır. İnsanları en çok yanıltan hatalar şunlardır.
Bu klasik bir hatadır. Bir özelliği daha çok kullanan müşteriler daha çok harcıyor, dolayısıyla özelliğin harcamayı artırdığı sonucuna varıyorsunuz. Oysa belki de çok harcayan müşteriler genel olarak daha ilgili. Bir nedensel çerçeve olmadan ilişkinin yönünü tahmin ediyorsunuz demektir.
Her nedensel analiz şu soruyla başlar: Bu bir kalıp mı, yoksa bir neden mi? Bu soruyu atlıyorsanız, ne kadar modelleme yapsanız da fayda etmez.
Bir karıştırıcı, hem tedaviyi hem sonucu etkiler.
Diyelim ki bir eğitim programının çalışan performansı üzerindeki etkisini ölçüyorsunuz. Eğitime kaydolan çalışanlar genellikle daha motive olur. Motivasyon hem katılımı (tedavi) hem performansı (sonuç) etkiler. Bunu hesaba katmazsanız, motivasyon etkisini eğitim programına atfedersiniz.
Çözüm, istatistikten çok yapısaldır. DAG’inizi çizin, iki tarafı da etkileyebilecek her değişkeni haritalayın ve tek bir model kurmadan önce her biriyle nasıl başa çıkacağınıza karar verin.
5 $’lık bir ATE, her müşterinin 5 $ kazandığı anlamına gelmez. Bu bir ortalamadır ve ortalamalar çok şeyi gizler. Bazı müşteriler 15 $ kazanmışken bazıları 5 $ kaybetmiş olabilir.
Tersi de tehlikelidir. Bir alt grup için CATE tahmini, o gruptaki her bireyin aynı şekilde yanıt vereceği anlamına gelmez. Tedavi etkileri belirsizliği olan tahminlerdir, garanti değildir. Her zaman güven aralıklarını kontrol edin ve yalnızca nokta tahminlerine dayanarak hedefleme kararları vermeyin.
EconML veya DoWhy’ın verdiği sayı, yalnızca arkasındaki varsayımlar kadar iyidir. Bir model şu soruları yanıtlayamaz:
Bu sorular, problemi anlayan birini gerektirir. Kötü belirtilmiş bir modelden bir nedensel orman memnuniyetle tedavi etkisi tahminleri üretir — sadece size bunların yanlış olduğunu söylemez.
En iyi nedensel analizler, ML’in karmaşık verilerle başa çıkma yeteneğini, hangi değişkenlerin neden önemli olduğunu bilen bir insanla birleştirir.
Nedensel ML, soruyu "ne olacak?"dan "buna ne neden oldu?"ya çevirir.
Bu değişim, karar verme biçiminizi de değiştirir. Kalıplara tepki vermekten, arkasındaki işleyişi anlamaya geçersiniz. Hatta bazıları bunun gerçek anlamda veri odaklı kararlar vermenin tek yolu olduğunu söyler.
Ancak araçlar, onlara verdiğiniz varsayımlar kadar işe yarar. Yanlış bir nedensel grafik veya yanlış yorumlanmış bir tedavi etkisi, “bilimsel” ve veri odaklı hissettiren ancak yanlış olan sonuçlara götürebilir. Model el kaldırtıp bunu söylemez.
En iyi sonuçlar, ML’in karmaşık verilerle başa çıkma gücünü, doğru nedensel soruları soracak kadar problemi iyi anlayan biriyle birleştirerek elde edilir. Alan bilgisiyle başlayın, sonra ağır işi modele bırakın. Hepsi bu.
İlk adım kolay, özellikle de scikit-learn ile Denetimli Öğrenme kursumuzla. Python’un mutlaka bilinmesi gereken bir kütüphanesiyle makine öğrenimi becerilerinizi geliştirmek için bugün kaydolun.
DataCamp ile Öğrenin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.