Curso
Entendendo Machine Learning
2 h
307.3K
Você já passou pela situação em que seu modelo de machine learning prevê quem vai comprar, mas não consegue explicar por que comprou?
O machine learning tradicional identifica padrões e prevê resultados. Ele indica que um cliente tem grande chance de churn ou que as vendas vão cair no próximo trimestre. Mas se você perguntar se sua última campanha de marketing realmente causou mais vendas, ou se um tratamento de fato melhorou os desfechos dos pacientes, ele não sabe o que fazer. Previsão e causalidade são coisas diferentes.
Causal machine learning combina ML com técnicas de inferência causal. Em vez de perguntar "o que vai acontecer?", a pergunta passa a ser "o que acontece se a gente intervir?" — e essa é a pergunta por trás de toda decisão de negócio ou tratamento médico.
Neste artigo, vou apresentar os conceitos centrais por trás do causal ML, os métodos usados para estimar causa e efeito e como aplicá-los em Python.
Se você está começando em machine learning, inscreva-se na nossa trilha Machine Learning Fundamentals in Python, feita para iniciantes.
Modelos de ML padrão aprendem padrões nos dados e usam isso para fazer previsões. Eles respondem bem a "o que vai acontecer?", mas não conseguem dizer o que causou aquilo.
Causal machine learning faz outra pergunta. Ele combina ML com técnicas de inferência causal para estimar relações de causa e efeito a partir de dados. Em vez de prever um resultado, ele estima o que mudaria se você tomasse uma ação específica.
Essa ação é chamada de intervenção e representa uma mudança deliberada para ver seu efeito. O desconto realmente gerou mais compras, ou esses clientes comprariam de qualquer forma? O novo medicamento melhorou a recuperação, ou os pacientes melhorariam sozinhos?
São perguntas que a previsão não responde — mas o causal ML responde.
O ML tradicional aprende correlações. Ele descobre que clientes que recebem e-mails com desconto tendem a comprar mais e usa esse padrão para prever compras futuras. Mas correlação não diz se o e-mail causou a compra. Talvez esses clientes já planejassem comprar.
O causal ML estima o efeito causal do e-mail nas compras. Ele pergunta o que teria acontecido se você não tivesse enviado. A diferença entre "essas coisas tendem a aparecer juntas" e "isso causou aquilo" é o que separa o ML tradicional do causal ML.
Dá para pensar assim, de forma simples:
A primeira ajuda você a prever. A segunda ajuda você a decidir. As duas são úteis.
A maioria das decisões de negócio e de políticas públicas é causal por natureza. Você não pergunta "o que vai acontecer?" — você pergunta "o que a gente deve fazer?"
Alguns exemplos práticos:
Os métodos padrão de machine learning não respondem a nenhuma dessas perguntas porque tratam correlação como um recurso. Duas variáveis que se movem juntas podem ter uma causa comum, ou a relação pode ser pura coincidência. Causal ML força você a pensar por que as coisas estão conectadas — e se mexer em uma realmente muda a outra.
Antes de estimar causa e efeito, você precisa entender alguns pilares que toda análise causal utiliza.
Toda pergunta causal tem duas partes: um tratamento e um desfecho.
O tratamento é a ação ou intervenção que você está estudando. Pode ser um remédio dado a pacientes ou um desconto oferecido a clientes. O desfecho é o que você mede — como tempo de recuperação, taxa de compra ou produtividade.
O objetivo do causal ML é estimar como o tratamento altera o desfecho. Ele não estima se há correlação, e sim se um realmente causa o outro.
Você consegue observar o que aconteceu depois que um paciente tomou o remédio, mas não consegue observar o que teria acontecido se ele não tivesse tomado. Esse cenário não observado é o contrafactual.
Em outro domínio: um cliente recebeu 20% de desconto e comprou. O contrafactual pergunta: ele teria comprado sem o desconto? Você nunca saberá com certeza, porque não dá para voltar no tempo e rodar as duas versões com a mesma pessoa.
O causal ML estima esses contrafactuais com técnicas estatísticas e suposições. A qualidade da sua estimativa causal depende de quão bem você aproxima o que não pode observar diretamente.
Um confundidor é uma variável que afeta tanto o tratamento quanto o desfecho, criando uma falsa impressão de causalidade.
Por exemplo, suponha que você estude se exercício reduz doenças cardíacas. Pessoas que se exercitam mais também tendem a comer melhor. A dieta afeta tanto a probabilidade de exercício (tratamento) quanto a doença cardíaca (desfecho). Se você ignorar a dieta, vai superestimar a importância do exercício isoladamente.
Confundidores são a maior ameaça à análise causal. Identificá-los e controlá-los é o que torna uma estimativa confiável — vale dedicar tempo a isso.
Se você está se perguntando como descobrir quais variáveis são confundidoras e quais não são, a resposta é: desenhe um grafo.
Um directed acyclic graph (DAG) é um diagrama que mapeia as relações causais entre variáveis. Cada nó representa uma variável, e cada seta aponta de uma causa para seu efeito. "Directed" significa que as setas têm direção. "Acyclic" significa que não há ciclos — uma variável não pode causar a si mesma, direta ou indiretamente.
Pegue o exemplo do exercício. Um DAG simples teria setas de dieta → exercício e dieta → doença cardíaca, além de uma seta de exercício → doença cardíaca. O grafo deixa claro que dieta é um confundidor porque aponta para o tratamento e para o desfecho.
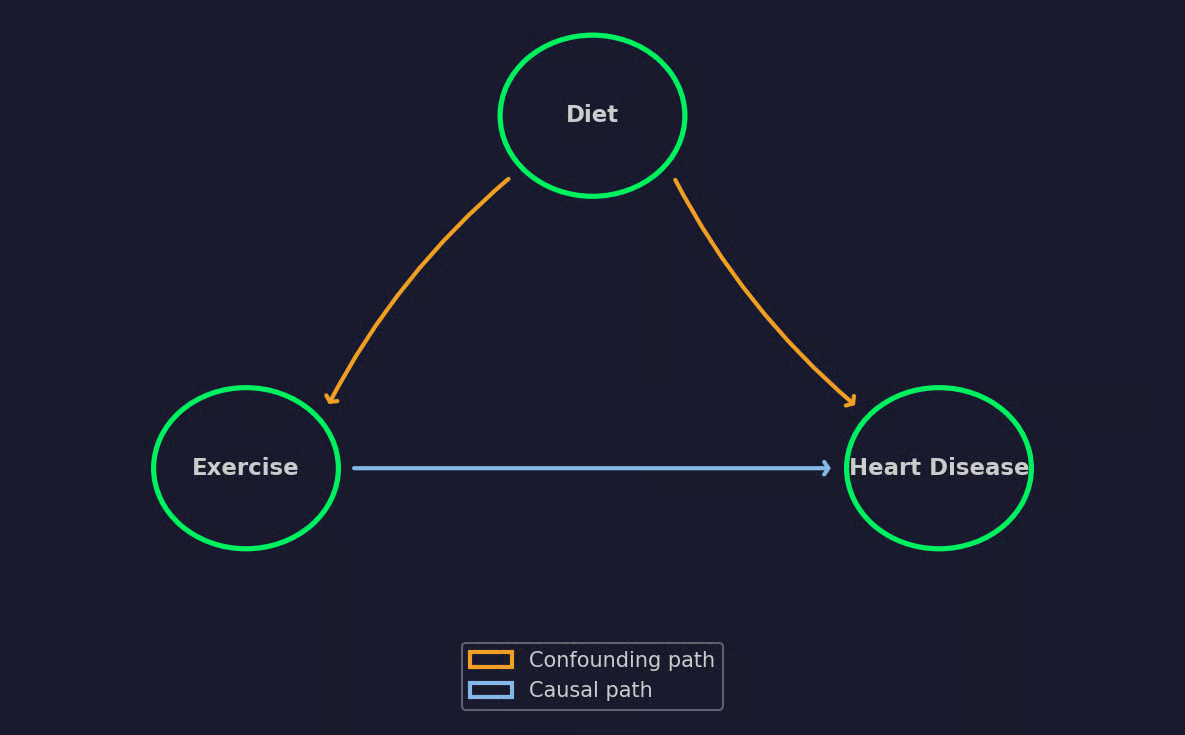
Um exemplo simples de DAG
DAGs também mostram quais variáveis controlar e quais deixar em paz. Se você controlar a variável errada, pode introduzir viés em vez de removê-lo. Pense no DAG como um roadmap de toda a sua análise causal.
A melhor parte?
Você não precisa de matemática para construir um DAG. Precisa de conhecimento de domínio. O grafo codifica suas suposições sobre como o mundo funciona, e a qualidade das estimativas causais depende de essas suposições estarem corretas.
O causal ML empresta muito da estatística e da econometria, mas escala essas ideias com machine learning. Vou passar pelos quatro enfoques mais comuns.
No mundo ideal, você rodaria um experimento randomizado para medir o efeito do tratamento. Na prática, a atribuição de tratamento raramente é aleatória. Quem recebe o tratamento costuma ser diferente de quem não recebe — e essas diferenças geram viés.
Os métodos de propensity score lidam com isso estimando a probabilidade de cada indivíduo receber o tratamento com base em suas características observadas. Essa probabilidade é o propensity score.
Depois de calcular os escores, há duas formas principais de usá-los:
Ambos tentam simular como seria um experimento randomizado usando dados observacionais.
Às vezes, os confundidores que você precisa controlar não estão nos seus dados. Não dá para medi-los, então propensity score não ajuda. É aí que entram as variáveis instrumentais (IV).
Um instrumento é uma variável que afeta o tratamento, mas não tem efeito direto no desfecho. Ela influencia o desfecho apenas por meio do tratamento.
O exemplo clássico é o efeito da educação na renda. Motivação afeta tanto o quanto alguém estuda quanto o quanto ganha — mas não dá para medir motivação diretamente. A distância até a faculdade mais próxima funciona como instrumento porque afeta a chance de alguém cursar a faculdade, mas não afeta diretamente o salário futuro.
Na prática, encontrar um bom instrumento é difícil. Quando você tem um, o método é ótimo — mas um instrumento fraco ou inválido produz resultados enganosos.
Causal forests estendem o algoritmo de random forest para estimar efeitos de tratamento em vez de previsões. Uma random forest padrão prevê um desfecho; uma causal forest estima quanto o tratamento muda esse desfecho em diferentes subgrupos.
Isso é útil quando o efeito do tratamento varia entre indivíduos. Um remédio pode funcionar bem para pacientes mais jovens e não para os mais velhos. Da mesma forma, um desconto pode aumentar compras de clientes sensíveis a preço, mas não ter efeito em clientes fiéis. Causal forests detectam essas diferenças dividindo os dados nas características que mais explicam a variação dos efeitos.
A saída é uma estimativa personalizada de efeito de tratamento para cada indivíduo do seu dataset.
Double machine learning (DML) combina modelos de ML com inferência estatística para ter o melhor dos dois mundos.
Você usa um modelo de ML para prever o desfecho e outro para prever a atribuição do tratamento. Depois, olha para os resíduos (as partes que nenhum dos modelos explicou) e a relação entre eles fornece o efeito causal.
Se você está se perguntando por que tantos passos, aqui vai a razão: modelos de ML capturam padrões muito bem, mas introduzem viés quando usados para estimação causal. O DML remove esse viés com uma técnica chamada cross-fitting, em que você treina e prevê em divisões diferentes dos dados para evitar overfitting.
Depois de escolher um método, você precisa resumir o que ele encontrou. É aqui que entram as métricas de efeito de tratamento.
O Average Treatment Effect (ATE) mede o efeito causal médio do tratamento em toda a população. Se o ATE de uma campanha de desconto é US$ 5, significa que, em média, o desconto aumentou o gasto em US$ 5 por cliente.
O ATE dá a visão geral, mas esconde a variação individual. Uma média de US$ 5 pode significar que todo mundo gastou US$ 5 a mais, ou que metade gastou US$ 10 a mais enquanto a outra metade não mudou nada.
O Conditional Average Treatment Effect (CATE) estima o efeito do tratamento para subgrupos específicos com base em suas características. Em vez de um número para todo mundo, o CATE mostra, por exemplo, que o desconto aumentou o gasto em US$ 8 para clientes novos, mas só em US$ 2 para recorrentes.
É o CATE que torna o causal ML acionável. O ATE diz se uma intervenção funciona. O CATE diz para quem ela funciona — e é isso que você precisa para tomar decisões baseadas em dados.
Causal ML aparece sempre que você precisa sair do "o que aconteceu?" para o "o que devemos fazer?" Aqui vão alguns exemplos.
Um hospital quer saber qual tratamento funciona melhor para um perfil específico de paciente. O ML padrão prevê quem está em risco, mas o causal ML estima se o Tratamento A ou o Tratamento B vai gerar um desfecho melhor para aquele paciente. Isso permite decisões personalizadas com base em efeitos estimados, não em médias da população.
Um time de marketing roda uma campanha e vê um pico nas vendas. A pergunta é: a campanha causou o pico ou foi a sazonalidade? Causal ML isola o impacto real da campanha, considerando confundidores como timing, demografia dos clientes e histórico de compras.
Governos e instituições precisam avaliar se políticas geram os resultados pretendidos. Um programa de qualificação reduziu o desemprego? Um incentivo fiscal aumentou o investimento? Causal ML oferece um framework para avaliação de políticas quando testes randomizados não são práticos ou possíveis.
Um time de produto lança um novo recurso e o engajamento sobe. Causal ML ajuda a determinar se o recurso causou o aumento ou se coincidiu com outras mudanças — como uma ação de marketing ou um concorrente fora do ar. Entender o impacto real de um recurso separa decisões orientadas por dados de puro achismo.
O ponto em comum é que decisões dependem de saber por que algo aconteceu, não só que aconteceu.
Três bibliotecas cobrem a maioria dos casos de uso de causal ML em Python. Vou explicar o que cada uma faz e mostrar um fluxo de trabalho típico.
Antes de ir para o código, aqui está um snippet completo com todos os imports e a criação do dataset. Você pode instalar dependências faltantes com pip ou uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
O dataset define 1000 clientes de um e-commerce, e eu quero estimar o efeito causal de um e-mail de desconto em dólares. O efeito causal verdadeiro do desconto é US$ 5, mas, como dá para ver no output, uma comparação ingênua superestima o efeito real porque os clientes que receberam desconto já tinham mais compras anteriores:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")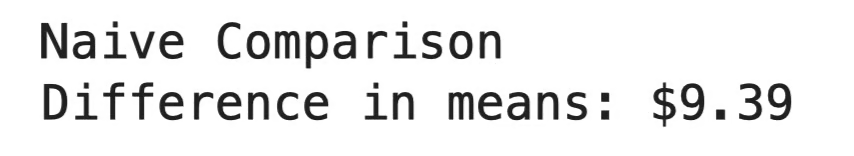
Comparação ingênua
DoWhy é um framework criado pela Microsoft para inferência causal fim a fim. Ele segue quatro etapas: modelar o problema como um grafo causal, identificar o efeito causal, estimá-lo e testar se a estimativa se sustenta sob suposições distintas.
O diferencial do DoWhy é o foco em validação. Depois de estimar, ele roda testes de refutação que desafiam o resultado. Se a estimativa sobrevive a esses testes, você pode confiar mais. Se não, é sinal de que as suposições precisam de ajustes.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")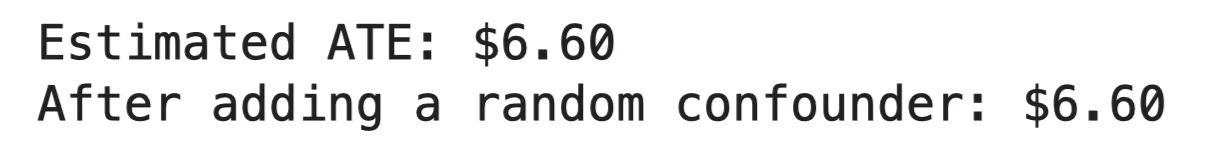
Saída do DoWhy
Em média, o desconto aumentou o valor de compra em US$ 6,60 por cliente. O teste de refutação adicionou uma variável aleatória ao modelo, e a estimativa não mudou nada — sinal de que o resultado não é fruto de correlações espúrias. Se a estimativa tivesse mudado muito, seria um alerta de que as suposições causais estavam erradas.
EconML, também da Microsoft, foca em estimar efeitos de tratamento heterogêneos. Em bom português: como o efeito varia entre subgrupos. Ele implementa métodos como Double ML e Causal Forests, que vimos acima.
O EconML segue uma API no estilo scikit-learn, com métodos .fit() e .effect().
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")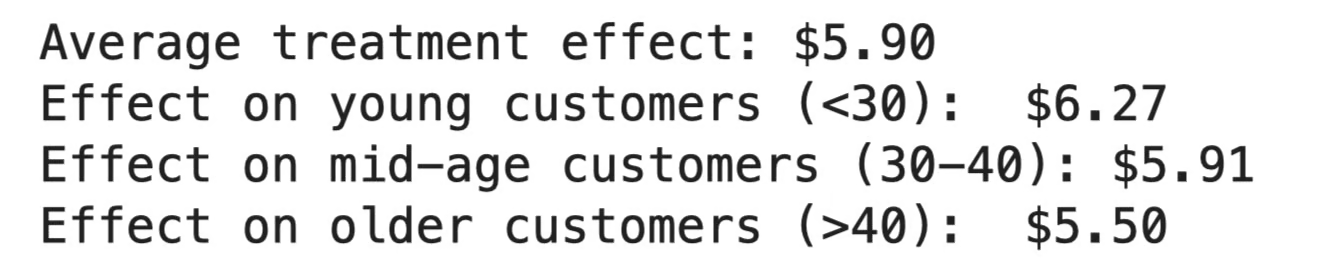
Saída do EconML
O desconto aumentou os valores de compra em US$ 5,90 em média, mas o efeito não foi uniforme. Clientes mais jovens responderam mais (US$ 6,27), enquanto os mais velhos tiveram o menor ganho (US$ 5,50). Se o orçamento é limitado, isso indica onde priorizar a campanha.
CausalML, criado pelo Uber, é voltado para uplift modeling — prever quais indivíduos mais responderão a um tratamento. É especialmente popular em marketing, onde o objetivo é segmentar quem muda de comportamento por causa da campanha, não quem compraria de qualquer jeito.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())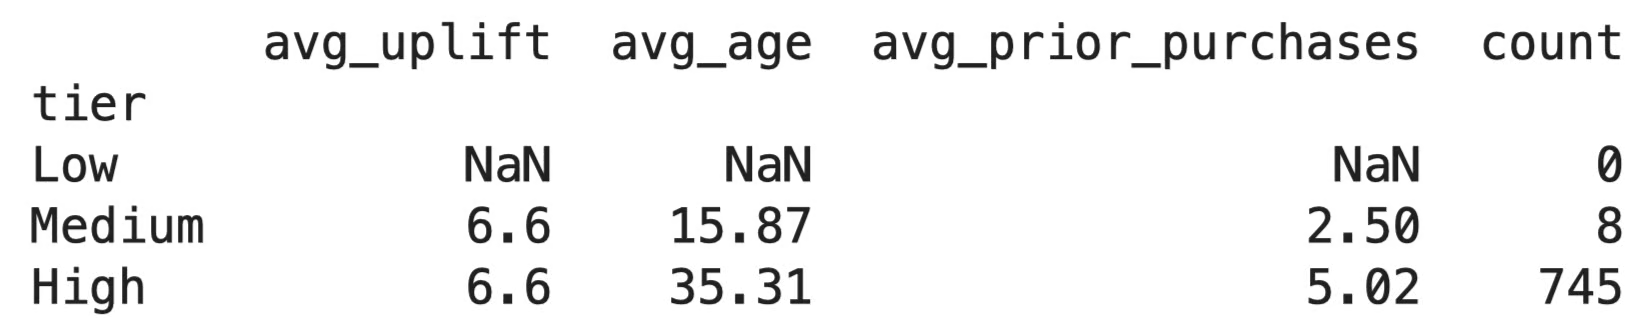
Saída do CausalML
Os scores de uplift estão quase idênticos entre todos os clientes, o que indica que o desconto teve efeito parecido em todo mundo — cerca de US$ 6,60 por pessoa. Isso faz sentido no nosso dataset sintético, onde embuti um efeito fixo de US$ 5 sem variação por subgrupo. Em dados reais, você costuma ver mais dispersão — e é aí que os tiers de segmentação ficam úteis.
Cada biblioteca tem um caso de uso ideal. Use:
As três funcionam bem juntas. Um padrão comum é definir o grafo causal no DoWhy, estimar efeitos com o EconML e usar o CausalML para interpretar os resultados.
Causal ML é fácil de usar errado. Aqui estão os deslizes que mais confundem as pessoas.
Esse é clássico. Clientes que usam mais um recurso também gastam mais, então você conclui que o recurso impulsiona o gasto. Mas talvez clientes que gastam mais sejam, no geral, mais engajados. Sem um framework causal, você está chutando a direção da relação.
Toda análise causal começa com a pergunta: isso é um padrão ou é uma causa? Se você pular essa pergunta, nenhum modelo vai salvar.
Um confundidor afeta tanto o tratamento quanto o desfecho.
Suponha que você meça o efeito de um treinamento no desempenho de funcionários. Quem se inscreve tende a ser mais motivado. Motivação impulsiona tanto a inscrição (tratamento) quanto o desempenho (desfecho). Se você não considerar isso, vai atribuir ao treinamento um efeito que vem da motivação.
A correção é mais estrutural do que estatística. Desenhe seu DAG, mapeie todas as variáveis que podem influenciar os dois lados e decida como lidar com cada uma antes de treinar qualquer modelo.
Um ATE de US$ 5 não significa que todo cliente ganhou US$ 5. É uma média — e médias escondem muita coisa. Alguns podem ter ganhado US$ 15, enquanto outros perderam US$ 5.
O inverso também é perigoso. Uma estimativa de CATE para um subgrupo não significa que todo indivíduo daquele grupo vai responder igual. Efeitos de tratamento são estimativas com incerteza, não garantias. Sempre verifique intervalos de confiança e não tome decisões de segmentação só com base em estimativas pontuais.
O número que o EconML ou o DoWhy fornecem é tão bom quanto as suposições por trás dele. Um modelo não responde a perguntas como:
Elas exigem alguém que entenda do problema. Uma causal forest vai produzir estimativas de efeito a partir de um modelo mal especificado — só não vai avisar que estão erradas.
As melhores análises causais combinam a capacidade do ML de lidar com dados complexos com um humano que sabe quais variáveis importam e por quê.
Causal ML muda a pergunta de "o que vai acontecer?" para "o que fez isso acontecer?"
Essa mudança transforma a tomada de decisão. Você sai de reagir a padrões para entender a mecânica por trás deles. Dá até para dizer que é o único jeito de tomar decisões realmente orientadas por dados.
Mas as ferramentas só funcionam na medida das suposições que você fornece. Um grafo causal errado ou a leitura equivocada de um efeito de tratamento podem levar a conclusões que parecem “científicas” e orientadas por dados, mas estão erradas. O modelo não vai levantar a mão para avisar.
Os melhores resultados vêm de combinar a capacidade do ML de lidar com dados complexos com alguém que entende o problema o suficiente para fazer as perguntas causais certas. Comece pelo conhecimento de domínio e deixe o modelo fazer o pesado. É isso.
A primeira parte é fácil, especialmente com o nosso curso Supervised Learning with scikit-learn. Inscreva-se hoje para desenvolver suas habilidades de machine learning com uma biblioteca essencial de Python.
Aprenda com a DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
5 min
blog
Abid Ali Awan
7 min
Tutorial
Tutorial
Abid Ali Awan
11 min
Tutorial
Moez Ali
14 min
Tutorial
Moez Ali
9 min