Courses
理解机器学习
2小时
307.3K
您是否遇到过这样的情况:机器学习模型能预测谁会购买,却解释不了他们为什么会买?
传统机器学习擅长发现模式并预测结果。它会告诉您某位客户很可能流失,或者下季度销售将下降。但如果您问它,最新的营销活动是否确实带来了更多销售,或某项治疗是否真正改善了患者结局,它就无从下手。预测与因果是两回事。
因果机器学习将机器学习与因果推断技术结合。因此,它不再问“会发生什么?”,而是问“如果我们进行干预,会发生什么?”——这正是每个商业决策或医疗治疗背后的问题。
本文将带您了解因果机器学习的核心概念、用于估计因果效应的方法,以及如何在 Python 中应用它们。
如果您是机器学习新手,欢迎报名我们适合初学者的Python 机器学习基础学习路径。
标准的机器学习模型从数据中学习模式,并据此做出预测。它擅长回答“会发生什么?”,但无法告诉您是什么导致了这种结果。
因果机器学习提出了不同的问题。它将机器学习与因果推断技术结合,从数据中估计因果关系。因此,它不是去预测结果,而是估计当您采取某个具体行动时会发生怎样的变化。
这个行动被称为干预,指您为了观察其影响而进行的有意改变。折扣是否真的带来了更多购买,还是这些客户本来就会买?新药是否改善了康复,还是患者自己就会好转?
这些都是预测无法回答,但因果机器学习可以回答的问题。
传统机器学习学习的是相关性。它会发现,收到折扣邮件的客户往往买得更多,并用这种模式预测未来的购买。但相关性并不能说明邮件是否导致了购买。也许这些客户本来就打算购买。
因果机器学习估计的是邮件对购买的因果效应。它会问:如果您没发这封邮件,会发生什么?“这些事情常常同时出现”与“这个东西导致了那个东西”之间的差别,正是传统机器学习与因果机器学习的分界线。
可以这样简单理解:
前者帮助您预测,后者帮助您决策。两者都很有用。
大多数商业与政策决策本质上都涉及因果。您问的不是“会发生什么?”,而是“我们该怎么做?”
以下是一些具体示例:
标准的机器学习方法无法回答这些问题,因为它把相关性当作特征。两个变量一起变化,可能是共享了共同原因,也可能纯属巧合。因果机器学习迫使您思考连接背后的原因——改变一个是否真的会改变另一个。
在估计因果效应之前,您需要理解每个因果分析都依赖的几个要点。
每个因果问题都有两部分:处理(treatment)与结果(outcome)。
处理是您研究的行动或干预。可以是给患者服用的药物,或给客户提供的折扣。结果是您要衡量的指标,如康复时间、购买率或生产率。
因果机器学习的目标是估计处理如何改变结果。它不估计两者是否相关,而是估计一个是否真正导致了另一个。
您能观察到患者服药后发生了什么,但无法观察到如果没服药会怎样。这个未被观察到的情景称为反事实。
换个领域,假设某位客户获得了 20% 折扣并完成了购买。反事实会问:如果没有折扣,他是否也会购买?您永远无法确定,因为您不能倒回时间,对同一个人同时运行两个版本。
因果机器学习通过统计技术与假设来估计这些反事实。因果估计的质量取决于您对不可直接观察部分的近似程度。
混杂因素是同时影响处理与结果的变量,会制造出虚假的因果印象。
例如,您研究锻炼是否能降低心脏病。更常锻炼的人往往也吃得更健康。饮食同时影响锻炼的可能性(处理)和心脏病(结果)。如果忽略饮食,您会高估单靠锻炼的重要性。
混杂因素是因果分析面临的最大威胁。识别并纳入它们,才能让因果估计可靠,这值得投入时间。
如果您在想如何区分哪些变量是混杂因素、哪些不是——画一张图就行。
一张有向无环图(DAG)是用来描绘变量间因果关系的图。每个节点代表一个变量,每个箭头从原因指向结果。“有向”意味着箭头有方向。“无环”意味着没有回路——变量不能直接或通过链条导致自身。
以之前的锻炼示例为例。一个简单的 DAG 会包含从“饮食→锻炼”和“饮食→心脏病”的箭头,以及“锻炼→心脏病”的箭头。此图使“饮食”是混杂因素这一点一目了然,因为它同时指向处理与结果。
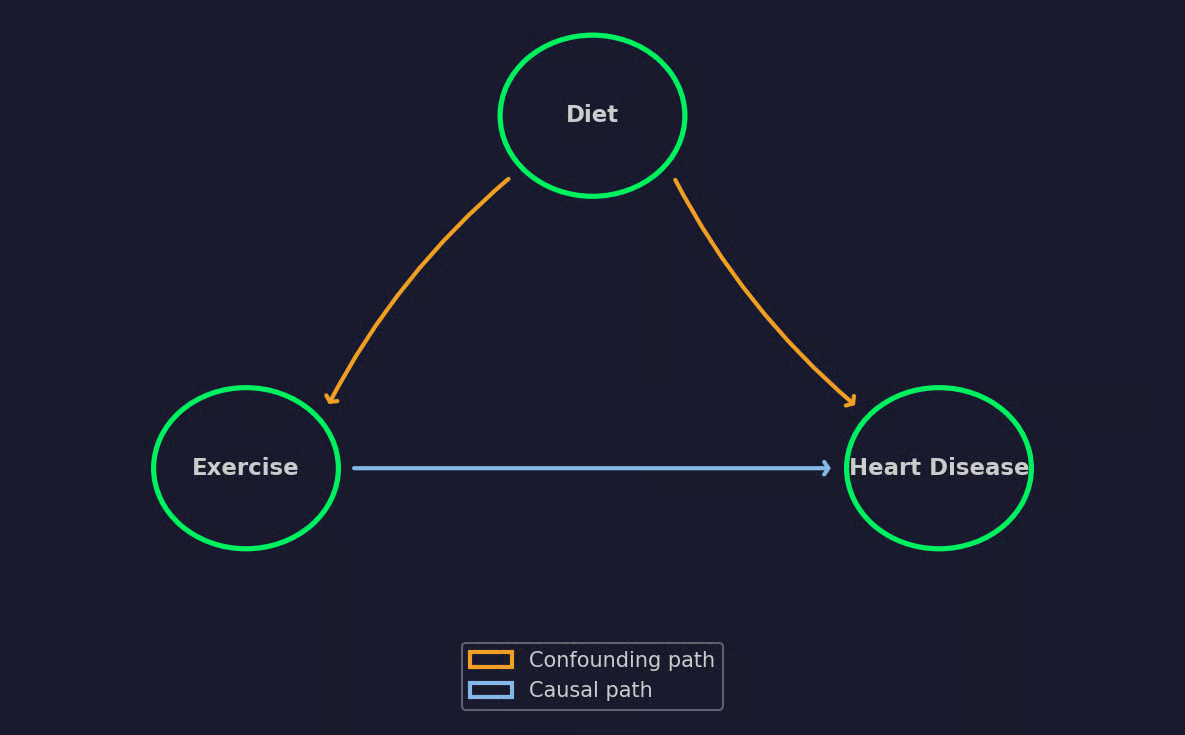
一个简单的 DAG 示例
DAG 还能告诉您该控制哪些变量、哪些该放着不管。如果控制了错误的变量,您实际上可能引入偏差而不是消除它。因此,把 DAG 看作您整个因果分析的路线图。
最棒的部分?
构建 DAG 不需要数学,只需要领域知识。图会编码您对世界如何运作的假设,而因果估计的质量则取决于这些假设是否正确。
因果机器学习大量借鉴统计学与计量经济学,并用机器学习扩展这些思想。接下来介绍四种最常见的方法。
理想情况下,您会运行随机实验来衡量处理效应。但在实践中,处理分配很少是随机的。接受处理的人往往与未接受的人不同——这些差异会带来偏差。
倾向得分方法通过基于已观测特征估计每个个体接受处理的概率来解决这一问题。这个概率就是倾向得分。
得到得分后,有两种主要用法:
两种方法都在用观测数据尽可能模拟随机实验会是什么样子。
有时您需要控制的混杂因素并不在数据中。您无法测量它们,因此倾向得分无济于事。这时就需要工具变量(IV)。
工具是只影响处理、但不直接影响结果的变量。它仅通过处理对结果产生影响。
一个经典例子是研究教育对收入的影响。动机会影响一个人受教育的程度,也影响其收入——但您无法直接测量动机。距离最近大学的远近可作为工具变量,因为它影响是否上大学,但不直接影响未来工资。
在实践中,找到一个好的工具变量并不容易。有了好工具,方法非常有效;但若工具弱或无效,结果就会误导。
因果森林将随机森林算法拓展为估计处理效应而非预测。标准随机森林预测结果,而因果森林估计处理对不同子群体结果的改变量。
当处理效应因人而异时,这很有用。一种药物可能对年轻患者效果好,但对年长患者效果一般。类似地,折扣可能能刺激价格敏感客户购买,却对忠诚用户无影响。因果森林通过在能产生最大效应差异的特征上切分数据来检测这些差异。
输出是数据集中每个个体的个性化处理效应估计。
双重机器学习(DML)将机器学习模型与统计推断结合,取长补短。
您用一个机器学习模型预测结果,用另一个预测处理分配。然后观察残差(两个模型都无法解释的部分),残差之间的关系便给出因果效应。
如果您在想为何要多此一举,原因在于:机器学习模型擅长捕捉模式,但用于因果估计时会引入偏差。DML 通过一种称为交叉拟合的技术消除这种偏差——在不同的数据切分上训练与预测,避免过拟合。
选定方法后,您需要一种方式来总结结果。这就需要处理效应度量。
其中,平均处理效应(ATE)衡量处理在整个总体上的平均因果效应。若某次折扣活动的 ATE 为 5 美元,意味着平均而言,折扣让每位客户的消费增加了 5 美元。
ATE 能给您全局视角,但会掩盖个体差异。平均 5 美元可能意味着人人都多花了 5 美元,也可能意味着一半客户多花了 10 美元、另一半没有变化。
而条件平均处理效应(CATE)则基于特征为特定子群体估计处理效应。因此,CATE 不是给所有人一个数值,而是告诉您折扣使新客户多花了 8 美元、回头客仅多花了 2 美元。
CATE 让因果机器学习更可执行。ATE 告诉您某项干预是否有效,CATE 告诉您它对谁有效——这正是做出数据驱动决策所需的答案。
凡是需要从“发生了什么?”转向“我们该怎么做?”的地方,都会用到因果机器学习。以下是几个示例。
医院想知道对特定患者画像哪种治疗更有效。标准机器学习能预测谁有风险,但因果机器学习会估计对该患者而言,治疗 A 还是治疗 B 能带来更好结果。这样就能基于估计效应而非总体平均值来做个性化治疗决策。
营销团队开展了一次促销活动,销量出现激增。问题在于,激增是活动导致的,还是由季节性需求驱动的?因果机器学习通过考虑时间、客户人口统计特征、既往购买行为等混杂因素,来分离出活动的真实影响。
政府与机构需要评估政策是否产生预期结果。职业培训项目是否降低了失业率?税收激励是否增加了投资?当随机试验不切实际甚至不可能时,因果机器学习为政策评估提供框架。
产品团队上线了新功能,用户参与度上升。因果机器学习有助于判断上升是否由该功能引起,还是与其他变化同步发生——比如营销发力或竞争对手宕机。理解功能的实际影响,能让决策真正以数据为依据,而非碰运气。
这些案例的共同点在于,做决策需要知道“为什么”,而不仅是“发生了什么”。
在 Python 中,有三个库覆盖了大多数因果机器学习用例。下面介绍各自的功能,并展示一个典型工作流。
在动手写代码前,这里有一段完整代码片段,涵盖所有导入与数据集创建。您可以用pip 或 uv 安装缺失依赖。
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
该数据集定义了一家电商中的 1000 位客户,我们要估计折扣邮件以美元计的因果效应。折扣的真实因果效应是 5 美元,但从下面的输出可见,朴素比较会高估真实效应,因为收到折扣的客户原本就有更多既往购买:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")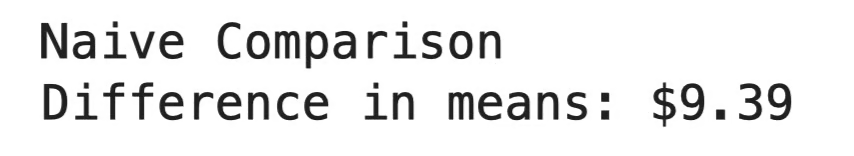
朴素比较
DoWhy 是微软构建的端到端因果推断框架。它遵循四步流程:将问题建模为因果图、识别因果效应、进行估计、然后在不同假设下检验估计是否站得住脚。
DoWhy 的亮点在于强调验证。在给出估计后,它会运行“反驳”测试来挑战结果。如果估计经得起这些测试,可信度更高;如果不行,就说明您的假设需要打磨。
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")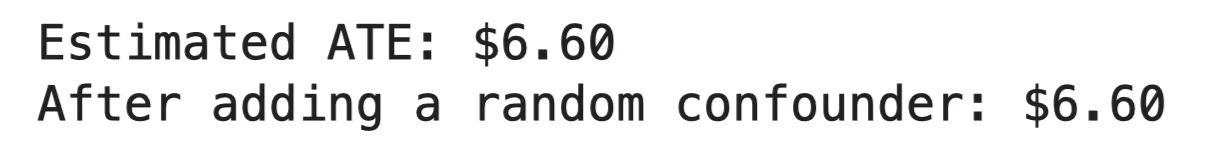
DoWhy 输出
平均来看,折扣让每位客户的购买金额增加了 6.60 美元。反驳测试向模型中加入了一个随机变量,估计值丝毫未变,这意味着结果并非由虚假相关性驱动。若估计发生较大变化,那就是一个红旗,提示因果假设可能有误。
EconML 同样来自微软,专注于估计异质性处理效应。通俗讲,就是效应在不同子群体之间如何变化。它实现了前文提到的双重机器学习与因果森林等方法。
EconML 采用熟悉的 scikit-learn 风格 API,使用 .fit() 与 .effect() 方法。
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")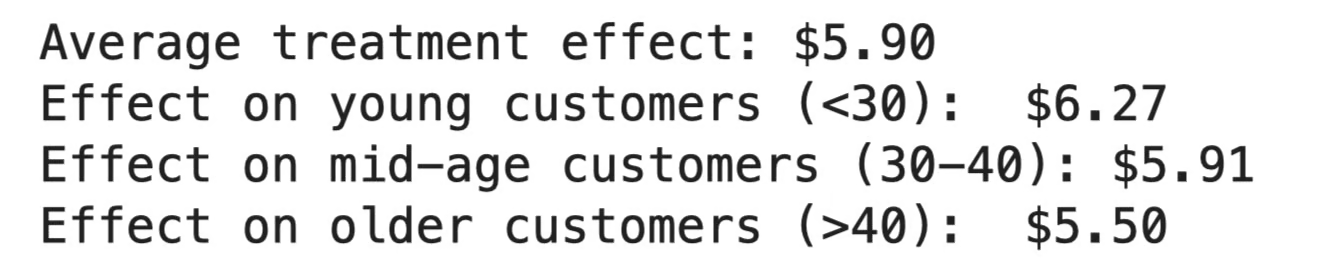
EconML 输出
折扣平均使购买金额增加了 5.90 美元,但效应并不均匀。年轻客户反应最大(6.27 美元),年长客户增幅最小(5.50 美元)。如果预算有限,这能告诉您该先把活动投向哪里。
CausalML由 Uber 构建,专为 uplift 建模——预测哪些个体对处理反应最强。它在营销领域尤其流行,目标是定位那些会因活动而改变行为的客户,而非本来就会转化的人。
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())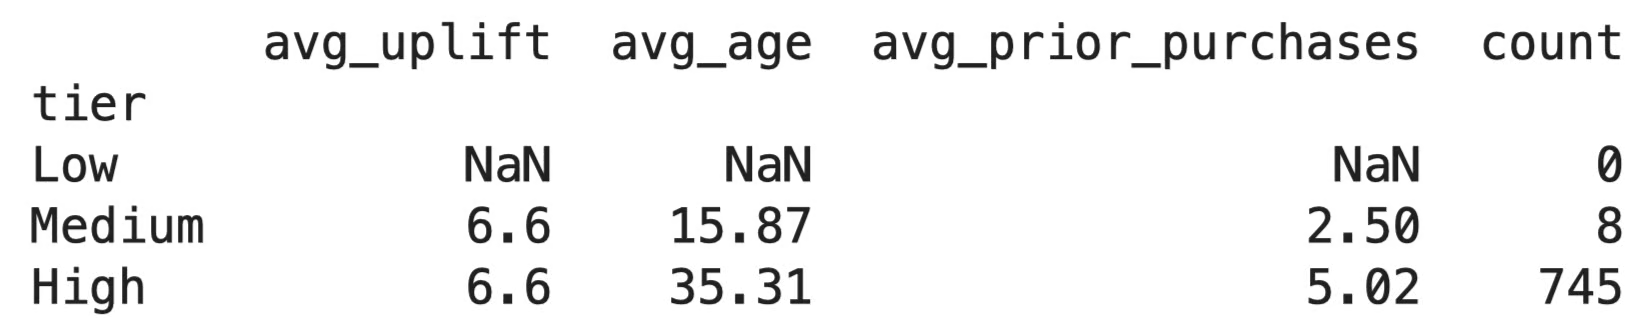
CausalML 输出
所有客户的 uplift 分数几乎一致,意味着折扣对每个人的影响大致相同——约 6.60 美元。这与我们的合成数据集相符,我在其中设定了一个不随子群体变化的固定 5 美元处理效应。在真实世界数据中,您通常会看到更大的分散,这时分层定位就很有用。
每个库都有理想用例。请在以下场景使用:
三者配合也很好。常见做法是:用 DoWhy 定义因果图,用 EconML 估计效应,再用 CausalML 解释结果。
因果机器学习有时容易被误用。以下是最常让人困惑的错误。
这是经典错误。更常使用某功能的客户也花得更多,于是您断定该功能推动了消费。但也许高消费客户只是整体参与度更高。没有因果框架,您只是在猜测关系的方向。
每次因果分析都要从一个问题开始:这是模式,还是原因?如果跳过这个问题,再多建模也帮不了您。
混杂因素会同时影响处理与结果。
比如您衡量培训项目对员工绩效的影响。报名培训的员工往往更有动力。动力既推动报名(处理),也提升绩效(结果)。若不考虑它,您会把动力的作用误记到培训上。
解决方案更多是结构性的而非统计性的。先画 DAG,梳理每个可能同时影响两端的变量,并在拟合任何模型前决定如何处理它们。
ATE 为 5 美元并不意味着每位客户都多了 5 美元。它是平均值,而平均值会隐藏很多信息。有的客户可能多了 15 美元,有的可能少了 5 美元。
反过来也危险。某个子群体的 CATE 估计并不意味着该群体的每个个体都会有相同反应。处理效应是带有不确定性的估计,而非保证。务必检查置信区间,不要只基于点估计做投放决策。
EconML 或 DoWhy 给出的数字,只能与其背后的假设一样好。模型无法回答如下问题:
这些都需要理解问题的人来判断。因果森林会很乐意从一个设定不当的模型里产出处理效应估计——它只是不会告诉您这些结果是错的。
最佳做法是把机器学习处理复杂数据的能力,与懂得哪些变量重要以及原因何在的人结合起来。
因果机器学习把问题从“会发生什么?”转变为“是什么导致了它发生?”
这种转变会改变您的决策方式。它让您从对模式被动反应,转向理解其背后的机制。有人甚至会说,这是做真正数据驱动决策的唯一方式。
但工具能发挥多大作用,取决于您提供的假设是否正确。错误的因果图或误读的处理效应,可能让您得出看上去“科学”“数据驱动”却错误的结论。模型不会举手提醒您。
最佳结果来自将机器学习处理复杂数据的能力,与足够理解问题、能提出正确因果问题的人结合起来。先从领域知识出发,然后让模型去干重活。就是这么简单。
第一步很容易,尤其是配合我们的用 scikit-learn 进行监督学习课程。立即报名,借助这门必会的 Python 库提升您的机器学习技能。
与 DataCamp 一起学习
Courses
Courses
Courses