course
Wprowadzenie do uczenia maszynowego
2 godz.
307.3K
Byłeś kiedyś w sytuacji, gdy twój model uczenia maszynowego potrafił przewidzieć, kto kupi, ale nie potrafił wyjaśnić, dlaczego kupił?
Tradycyjne uczenie maszynowe wykrywa wzorce i przewiduje wyniki. Powie ci, że klient prawdopodobnie odejdzie albo że sprzedaż spadnie w następnym kwartale. Ale jeśli zapytasz, czy twoja najnowsza kampania marketingowa faktycznie spowodowała wzrost sprzedaży albo czy leczenie rzeczywiście poprawiło wyniki pacjentów, nie będzie wiedziało, co zrobić. Predykcja i przyczynowość to dwie różne rzeczy.
Przyczynowe uczenie maszynowe łączy ML z technikami wnioskowania przyczynowego. Zamiast pytać „co się stanie?”, pyta „co się stanie, jeśli zainterweniujemy?” — a to właśnie pytanie stoi za każdą decyzją biznesową czy medycznym leczeniem.
W tym artykule przeprowadzę cię przez kluczowe koncepcje stojące za przyczynowym ML, metody szacowania związków przyczynowo‑skutkowych oraz sposób ich zastosowania w Pythonie.
Jeśli dopiero zaczynasz z uczeniem maszynowym, zapisz się na naszą przyjazną dla początkujących ścieżkę Machine Learning Fundamentals in Python.
Standardowe modele ML uczą się wzorców z danych i wykorzystują je do predykcji. Dobrze odpowiadają na pytanie „co się stanie?”, ale nie powiedzą ci, co spowodowało, że to się stało.
Przyczynowe uczenie maszynowe zadaje inne pytanie. Łączy ML z technikami wnioskowania przyczynowego, aby szacować związki przyczynowo‑skutkowe z danych. Zamiast przewidywać wynik, szacuje, co by się zmieniło, gdybyś podjął konkretną akcję.
Ta akcja to interwencja — celowa zmiana, którą wprowadzasz, by zobaczyć jej efekt. Czy zniżka faktycznie napędziła więcej zakupów, czy ci klienci i tak by kupili? Czy nowy lek poprawił rekonwalescencję, czy pacjenci wyzdrowieliby sami?
To pytania, na które predykcje nie odpowiedzą — ale przyczynowe ML już tak.
Tradycyjne ML uczy się korelacji. Odkrywa, że klienci otrzymujący maile ze zniżką częściej kupują i używa tego wzorca do przewidywania przyszłych zakupów. Ale korelacja nie mówi, czy to e‑mail spowodował zakup. Może ci klienci i tak planowali kupić.
Przyczynowe ML szacuje efekt przyczynowy e‑maila na zakupy. Pyta, co by się stało, gdybyś go nie wysłał. Różnica między „te rzeczy zwykle występują razem” a „ta rzecz spowodowała tamtą” oddziela tradycyjne ML od przyczynowego ML.
Można o tym myśleć prosto:
Pierwsze pomaga przewidywać. Drugie pomaga decydować. Oba są potrzebne.
Większość decyzji biznesowych i publicznych ma z natury charakter przyczynowy. Nie pytasz „co się stanie?”, tylko „co powinniśmy zrobić?”
Oto kilka konkretnych przykładów:
Standardowe metody ML nie odpowiedzą na żadne z tych pytań, bo traktują korelację jak cechę. Dwie zmienne, które poruszają się razem, mogą mieć wspólną przyczynę albo związek może być czystym przypadkiem. Przyczynowe ML zmusza do myślenia, dlaczego rzeczy są połączone — i czy zmiana jednej faktycznie zmieni drugą.
Zanim oszacujesz związek przyczynowo‑skutkowy, musisz zrozumieć kilka rzeczy, na których opiera się każda analiza przyczynowa.
Każde pytanie przyczynowe ma dwie części: leczenie i wynik.
Leczenie to działanie lub interwencja, które analizujesz. Może to być lek podany pacjentom albo zniżka oferowana klientom. Wynik to to, co mierzysz — np. czas rekonwalescencji, odsetek zakupów czy produktywność.
Celem przyczynowego ML jest oszacowanie, jak leczenie zmienia wynik. Nie chodzi o to, czy dwie zmienne są skorelowane, ale czy jedna rzeczywiście powoduje drugą.
Możesz zaobserwować, co stało się po tym, jak pacjent przyjął lek, ale nie możesz zaobserwować, co by się stało, gdyby go nie przyjął. Ten nieobserwowany scenariusz to kontrfaktyczny.
W innej domenie: klient otrzymał 20% zniżki i dokonał zakupu. Kontrfakty pyta: czy kupiłby bez zniżki? Nigdy nie będziesz wiedzieć na pewno, bo nie możesz cofnąć czasu i uruchomić obu wersji na tej samej osobie.
Przyczynowe ML szacuje takie kontrfakty przy użyciu technik statystycznych i założeń. Jakość twojej estymacji przyczynowej zależy od tego, jak dobrze przybliżysz to, czego nie możesz bezpośrednio zaobserwować.
Zakłócacz to zmienna, która wpływa zarówno na leczenie, jak i na wynik, tworząc fałszywe wrażenie przyczynowości.
Na przykład analizujesz, czy ćwiczenia zmniejszają choroby serca. Osoby, które więcej ćwiczą, mają też tendencję do zdrowszej diety. Dieta wpływa zarówno na skłonność do ćwiczeń (leczenie), jak i na choroby serca (wynik). Jeśli zignorujesz dietę, zawyżysz znaczenie samych ćwiczeń.
Zakłócacze to największe zagrożenie dla analizy przyczynowej. Identyfikacja i uwzględnienie ich sprawia, że estymacja przyczynowa jest wiarygodna — warto poświęcić na to czas.
Zastanawiasz się, jak ustalić, które zmienne są zakłócaczami, a które nie? Rysujesz wykres.
Skierowany acykliczny graf (DAG) to diagram mapujący relacje przyczynowe między zmiennymi. Każdy węzeł reprezentuje zmienną, a każda strzałka wskazuje od przyczyny do skutku. „Skierowany” oznacza, że strzałki mają kierunek. „Acykliczny” — że nie ma pętli: zmienna nie może powodować samej siebie, bezpośrednio ani przez łańcuch.
Weź przykład ćwiczeń. Prosty DAG miałby strzałki od Dieta → Ćwiczenia i Dieta → Choroba serca oraz strzałkę od Ćwiczenia → Choroba serca. Wykres jasno pokazuje, że dieta jest zakłócaczem, bo ma strzałki do leczenia i do wyniku.
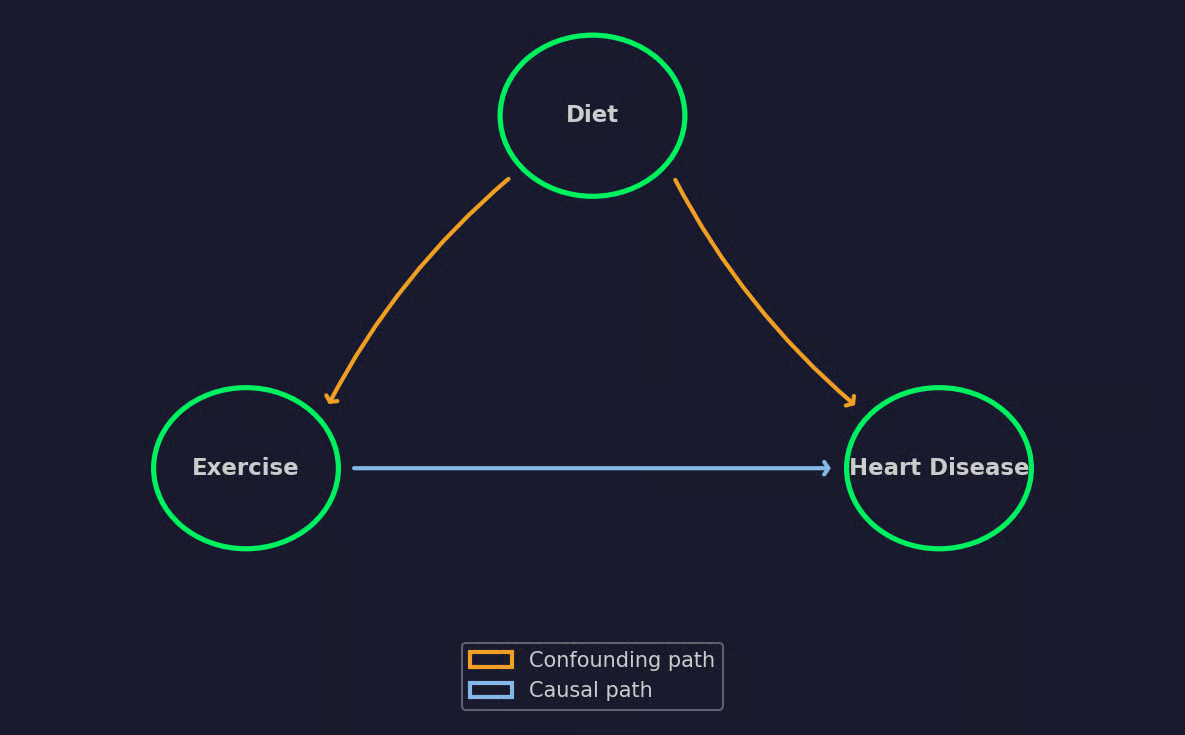
Prosty przykład DAG
DAG‑i mówią też, które zmienne kontrolować, a których nie ruszać. Jeśli skontrolujesz niewłaściwą zmienną, możesz wprowadzić stronniczość zamiast ją usuwać. Traktuj więc DAG jako mapę drogową całej analizy przyczynowej.
Najlepsze w tym jest to, że...
Nie potrzebujesz matematyki, żeby zbudować DAG. Potrzebujesz wiedzy domenowej. Wykres koduje twoje założenia o tym, jak działa świat, a jakość twoich estymacji przyczynowych zależy od tego, czy te założenia są trafne.
Przyczynowe ML czerpie wiele ze statystyki i ekonometrii, ale skaluje te pomysły dzięki uczeniu maszynowemu. Pokażę ci cztery najczęstsze podejścia.
W idealnym świecie uruchamiałbyś losowy eksperyment, aby zmierzyć efekt leczenia. W praktyce przydział leczenia rzadko jest losowy. Osoby otrzymujące leczenie często różnią się od tych, które go nie otrzymują — a te różnice tworzą stronniczość.
Metody oparte na skłonności rozwiązują to, szacując prawdopodobieństwo, że dana osoba otrzyma leczenie na podstawie obserwowanych cech. To prawdopodobieństwo to propensity score.
Gdy masz już te wyniki, są dwa główne sposoby ich użycia:
Obie metody próbują zasymulować losowy eksperyment z danych obserwacyjnych.
Czasem zakłócaczy, które musisz kontrolować, nie ma w twoich danych. Nie możesz ich zmierzyć, więc skłonności nie pomogą. Tu wchodzą zmienne instrumentalne (IV).
Instrument to zmienna, która wpływa na leczenie, ale nie ma bezpośredniego wpływu na wynik. Oddziałuje na wynik tylko poprzez leczenie.
Klasyczny przykład to wpływ edukacji na zarobki. Motywacja wpływa zarówno na poziom edukacji, jak i na zarobki — ale motywacji nie zmierzysz wprost. Odległość do najbliższego college’u działa jako instrument, bo wpływa na to, czy ktoś pójdzie na studia, ale nie wpływa bezpośrednio na przyszłą pensję.
W praktyce znalezienie dobrego instrumentu jest trudne. Metoda świetna, gdy go masz, ale słaby lub nieprawidłowy instrument da mylące wyniki.
Lasy przyczynowe rozszerzają algorytm random forest, aby szacować efekty leczenia zamiast predykcji. Standardowy las losowy przewiduje wynik, a las przyczynowy szacuje, o ile leczenie zmienia ten wynik w różnych podgrupach.
To przydatne, gdy efekt leczenia różni się między osobami. Lek może działać lepiej u młodszych pacjentów niż u starszych. Podobnie zniżka może zwiększać zakupy u wrażliwych na cenę, ale nie działać na lojalnych. Lasy przyczynowe wykrywają te różnice, dzieląc dane po cechach, które dają największą zmienność efektów leczenia.
Wynikiem jest spersonalizowana estymacja efektu leczenia dla każdej osoby w zbiorze.
Double machine learning (DML) łączy modele ML z wnioskowaniem statystycznym, by wziąć z obu światów to, co najlepsze.
Używasz jednego modelu ML do przewidywania wyniku, a drugiego do przewidywania przydziału leczenia. Potem patrzysz na reszty (części, których żaden model nie wyjaśnił), a związek między nimi daje efekt przyczynowy.
Jeśli zastanawiasz się, po co te dodatkowe kroki, oto odpowiedź: modele ML świetnie chwytają wzorce, ale wprowadzają stronniczość przy estymacji przyczynowej. DML usuwa ją dzięki technice zwanej cross‑fittingiem — trenujesz i predykujesz na różnych podziałach danych, by uniknąć przeuczenia.
Gdy wybierzesz metodę, potrzebujesz sposobu na podsumowanie wyników. Tu wchodzą metryki efektu leczenia.
Średni efekt leczenia (ATE) mierzy przeciętny efekt przyczynowy leczenia w całej populacji. Jeśli ATE kampanii zniżkowej wynosi 5$, oznacza to, że średnio zniżka zwiększyła wydatki o 5$ na klienta.
ATE daje ogólny obraz, ale ukrywa indywidualne zróżnicowanie. Średnia 5$ może znaczyć, że każdy wydał o 5$ więcej, albo że połowa wydała o 10$ więcej, a połowa bez zmian.
Warunkowy średni efekt leczenia (CATE) szacuje efekt dla konkretnych podgrup na podstawie ich cech. Zamiast jednej liczby dla wszystkich, CATE powie ci, że zniżka zwiększyła wydatki o 8$ u nowych klientów, ale tylko o 2$ u powracających.
CATE sprawia, że przyczynowe ML staje się użyteczne. ATE mówi, czy interwencja działa. CATE mówi, dla kogo działa — i to ta odpowiedź, której potrzebujesz do decyzji opartych na danych.
Przyczynowe ML przydaje się wszędzie tam, gdzie musisz przejść od „co się stało?” do „co powinniśmy zrobić?”. Oto kilka przykładów.
Szpital chce wiedzieć, które leczenie działa najlepiej dla konkretnego profilu pacjenta. Standardowe ML przewidzi, kto jest ryzykowny, ale przyczynowe ML oszacuje, czy Leczenie A czy Leczenie B da lepszy wynik dla tego pacjenta. To umożliwia spersonalizowane decyzje na podstawie oszacowanych efektów, a nie średnich populacyjnych.
Zespół marketingu prowadzi kampanię promocyjną i widzi skok sprzedaży. Pytanie brzmi: czy kampania go spowodowała, czy to efekt sezonowości? Przyczynowe ML izoluje prawdziwy wpływ kampanii, uwzględniając zakłócacze, takie jak timing, demografia klientów i wcześniejsze zachowania zakupowe.
Rządy i instytucje muszą ocenić, czy polityki dają zamierzone rezultaty. Czy program szkoleniowy obniżył bezrobocie? Czy ulga podatkowa zwiększyła inwestycje? Przyczynowe ML dostarcza ram do oceny polityk, gdy losowe eksperymenty są niepraktyczne lub niemożliwe.
Zespół produktowy dodaje nową funkcję i rośnie zaangażowanie. Przyczynowe ML pomaga ustalić, czy to funkcja spowodowała wzrost, czy zbiegła się z innymi zmianami — jak kampania marketingowa czy awaria konkurenta. Zrozumienie faktycznego wpływu funkcji odróżnia decyzje oparte na danych od zgadywania.
Wspólny mianownik: decyzje zależą od poznania, dlaczego coś się stało, a nie tylko, że się stało.
Są trzy biblioteki, które pokrywają większość zastosowań przyczynowego ML w Pythonie. Przejdę przez to, co robi każda z nich, i pokażę typowy workflow.
Zanim przejdziemy do kodu, oto pełny fragment obejmujący importy i tworzenie zbioru danych. Brakujące zależności zainstalujesz przez pip lub uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
Zbiór danych opisuje 1000 klientów sklepu e‑commerce, a ja próbuję oszacować przyczynowy efekt maila zniżkowego w dolarach. Prawdziwy efekt przyczynowy zniżki to 5$, ale jak widać na wyjściu, naiwny porównanie zawyża prawdziwy efekt, bo klienci, którzy dostali zniżki, mieli już wcześniej więcej zakupów:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")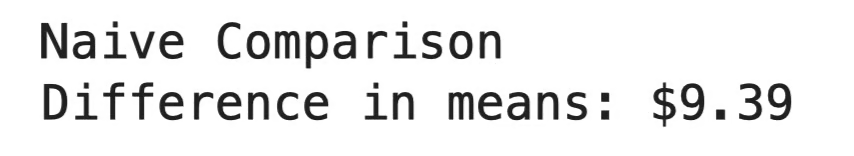
Naiwne porównanie
DoWhy to framework Microsoftu do kompleksowego wnioskowania przyczynowego. Podąża czterema krokami: modeluj problem jako wykres przyczynowy, zidentyfikuj efekt przyczynowy, oszacuj go, a następnie sprawdź, czy estymacja trzyma się pod różnymi założeniami.
To, co wyróżnia DoWhy, to nacisk na walidację. Po wyliczeniu estymacji uruchamia testy refutacji, które kwestionują wynik. Jeśli estymacja je przetrwa, możesz bardziej jej ufać. Jeśli nie — wiesz, że trzeba dopracować założenia.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")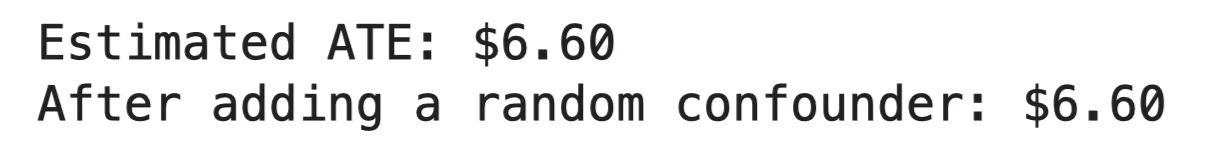
Wynik DoWhy
Średnio zniżka zwiększyła kwotę zakupu o 6,60$ na klienta. Test refutacji dodał do modelu losową zmienną, a estymacja w ogóle się nie zmieniła, co oznacza, że wynik nie jest napędzany fałszywymi korelacjami. Gdyby estymacja mocno się przesunęła, byłby to sygnał ostrzegawczy, że założenia przyczynowe są nietrafione.
EconML, również od Microsoftu, skupia się na szacowaniu heterogenicznych efektów leczenia. Mówiąc prościej — jak efekt różni się między podgrupami. Implementuje metody takie jak Double ML i Causal Forests, o których pisałem wyżej.
EconML ma znany interfejs w stylu scikit‑learn z metodami .fit() i .effect().
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")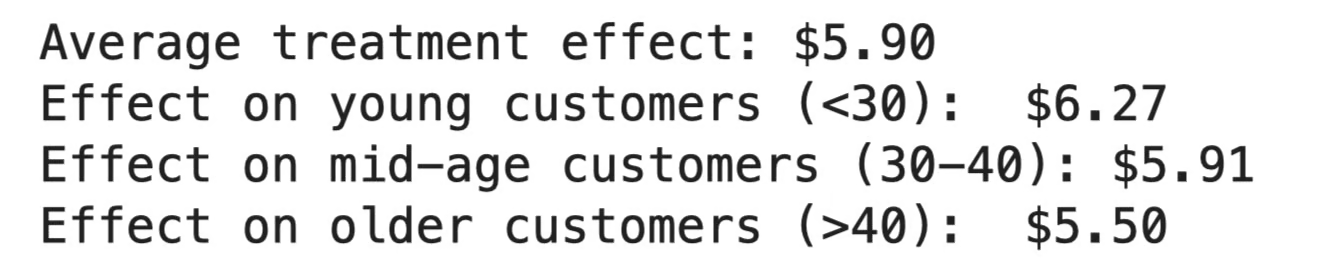
Wynik EconML
Zniżka zwiększyła kwoty zakupów średnio o 5,90$, ale efekt nie był jednolity. Najmocniej zareagowali młodsi klienci (6,27$), a najsłabiej starsi (5,50$). Jeśli budżet jest ograniczony, to podpowiada, gdzie skierować kampanię w pierwszej kolejności.
CausalML, stworzony przez Ubera, jest zaprojektowany do modelowania upliftu — przewidywania, kto najbardziej zareaguje na leczenie. Szczególnie popularny w marketingu, gdzie celem jest kierowanie kampanii do tych, którzy zmienią zachowanie z jej powodu, a nie do tych, którzy i tak by skonwertowali.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())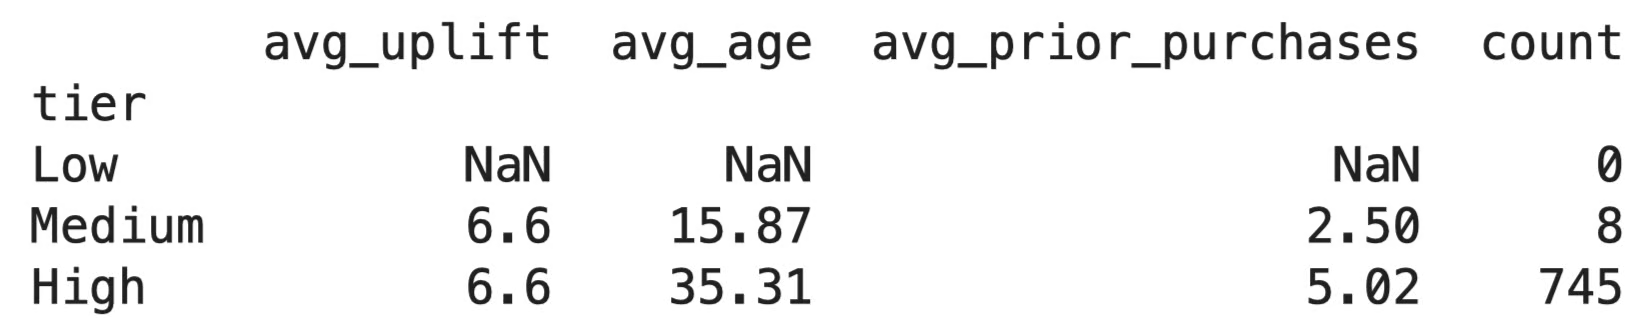
Wynik CausalML
Wyniki upliftu są niemal identyczne dla wszystkich klientów, co oznacza, że zniżka miała z grubsza ten sam efekt u każdego — około 6,60$ na osobę. Ma to sens dla naszego syntetycznego zbioru, w którym wbudowałem stały efekt 5$ bez zróżnicowania między podgrupami. W rzeczywistych danych zwykle zobaczysz większe rozproszenie — i tam przydają się poziomy targetowania.
Każda biblioteka ma idealny przypadek użycia. Używaj:
Wszystkie trzy dobrze współpracują. Częsty wzorzec to zdefiniowanie wykresu przyczynowego w DoWhy, oszacowanie efektów w EconML i użycie CausalML do interpretacji wyników.
Przyczynowe ML łatwo czasem źle użyć. Oto błędy, które najczęściej mylą ludzi.
Klasyk. Klienci, którzy częściej korzystają z funkcji, wydają też więcej, więc wnioskujesz, że funkcja napędza wydatki. A może klienci o wysokich wydatkach po prostu są bardziej zaangażowani we wszystkim. Bez ram przyczynowych zgadujesz kierunek zależności.
Każda analiza przyczynowa zaczyna się od pytania: czy to wzorzec, czy przyczyna? Jeśli je pominiesz, żadne modelowanie ci nie pomoże.
Zakłócacz wpływa na leczenie i na wynik.
Mierzysz wpływ programu szkoleniowego na wyniki pracowników. Ci, którzy zapisują się na szkolenia, zwykle są bardziej zmotywowani. Motywacja napędza i zapis (leczenie), i wyniki (wynik). Jeśli jej nie uwzględnisz, przypiszesz efekt motywacji programowi szkoleniowemu.
Rozwiązanie jest bardziej strukturalne niż statystyczne. Narysuj DAG, wypisz każdą zmienną, która może wpływać na obie strony, i zdecyduj, jak każdą obsłużysz, zanim dopasujesz jakikolwiek model.
ATE = 5$ nie znaczy, że każdy klient zyskał 5$. To średnia, a średnie wiele ukrywają. Niektórzy mogli zyskać 15$, inni stracić 5$.
Odwrotna strona też bywa groźna. Estymacja CATE dla podgrupy nie znaczy, że każdy w tej grupie zareaguje tak samo. Efekty leczenia to estymacje z niepewnością, nie gwarancje. Zawsze sprawdzaj przedziały ufności i nie podejmuj decyzji o targetowaniu wyłącznie na podstawie punktowych estymacji.
Liczba od EconML czy DoWhy jest tak dobra, jak założenia za nią stojące. Model nie odpowie na pytania w rodzaju:
Wymagają kogoś, kto rozumie problem. Las przyczynowy chętnie wyprodukuje estymacje efektów z błędnie określonego modelu — po prostu nie powie ci, że są błędne.
Najlepsze analizy przyczynowe łączą zdolność ML do obchodzenia się złożonymi danymi z człowiekiem, który wie, które zmienne mają znaczenie i dlaczego.
Przyczynowe ML zmienia pytanie z „co się stanie?” na „co spowodowało, że to się stało?”
Ta zmiana zmienia sposób podejmowania decyzji. Przechodzisz od reagowania na wzorce do rozumienia mechaniki, które za nimi stoją. Niektórzy powiedzieliby nawet, że to jedyna droga do naprawdę decyzji opartych na danych.
Ale narzędzia działają tak dobrze, jak założenia, które im dasz. Zły wykres przyczynowy czy błędnie odczytany efekt leczenia mogą zaprowadzić cię do wniosków, które „naukowo” i data‑driven brzmią, ale są błędne. Model nie podniesie ręki, by cię ostrzec.
Najlepsze rezultaty przychodzą z połączenia możliwości ML do pracy ze złożonymi danymi z kimś, kto zna problem na tyle, by zadać właściwe pytania przyczynowe. Zacznij od wiedzy domenowej, a potem pozwól modelowi wykonać ciężką pracę. Nic więcej.
Pierwsza część jest łatwa — zwłaszcza z naszym kursem Supervised Learning with scikit‑learn. Zapisz się dziś i rozwijaj swoje umiejętności ML z niezbędną biblioteką Pythona.
Ucz się z DataCamp
course
course
course