
Curso
Comprender el machine learning
2 h
311.3K
¿Te has visto en la situación de que tu modelo de machine learning predice quién va a comprar, pero no te dice por qué compra?
El machine learning tradicional detecta patrones y predice resultados. Te dirá que un cliente probablemente se dará de baja o que las ventas caerán el próximo trimestre. Pero si le preguntas si tu última campaña de marketing realmente provocó más ventas, o si un tratamiento mejoró de verdad los resultados de los pacientes, no sabe qué hacer. Predicción y causalidad no son lo mismo.
El machine learning causal combina ML con técnicas de inferencia causal. Así, en lugar de preguntar "¿qué va a pasar?", pregunta "¿qué pasa si intervenimos?". Y esa es la pregunta detrás de cualquier decisión de negocio o tratamiento médico.
En este artículo te explico los conceptos clave del ML causal, los métodos para estimar causa y efecto y cómo aplicarlos en Python.
Si estás empezando con machine learning, apúntate a nuestro itinerario de aprendizaje Machine Learning Fundamentals in Python para principiantes.
Los modelos de ML estándar aprenden patrones de los datos y los usan para hacer predicciones. Son buenos respondiendo "¿qué va a pasar?", pero no pueden decirte qué lo causó.
El machine learning causal hace una pregunta distinta. Combina ML con técnicas de inferencia causal para estimar relaciones de causa y efecto a partir de datos. Así, en lugar de predecir un resultado, estima qué cambiaría si tomas una acción concreta.
A esa acción la llamamos intervención y representa un cambio deliberado para observar su efecto. ¿El descuento realmente impulsó más compras o esos clientes habrían comprado de todos modos? ¿El nuevo fármaco mejoró la recuperación o los pacientes se habrían recuperado igual?
Son preguntas que la predicción no resuelve, pero el ML causal sí.
El ML tradicional aprende correlaciones. Detecta que los clientes que reciben emails con descuentos tienden a comprar más y usa ese patrón para predecir compras futuras. Pero la correlación no te dice si el email causó la compra. Puede que esos clientes ya pensaran comprar.
El ML causal estima el efecto causal del email sobre las compras. Pregunta qué habría pasado si no lo hubieras enviado. La diferencia entre "estas cosas suelen darse juntas" y "esto causó aquello" es lo que separa el ML tradicional del causal.
Una forma simple de verlo:
La primera te ayuda a predecir. La segunda te ayuda a decidir. Ambas son útiles.
La mayoría de decisiones empresariales y de políticas públicas son causales por naturaleza. No preguntas "¿qué va a pasar?", sino "¿qué deberíamos hacer?"
Algunos ejemplos concretos:
Los métodos estándar de ML no pueden responder a estas preguntas porque tratan la correlación como una característica. Dos variables que se mueven juntas pueden compartir una causa común, o puede ser pura casualidad. El ML causal te obliga a pensar por qué están conectadas y si cambiar una realmente cambiará la otra.
Antes de estimar causa y efecto, necesitas entender un par de elementos en los que se apoya cualquier análisis causal.
Toda pregunta causal tiene dos partes: un tratamiento y un resultado.
El tratamiento es la acción o intervención que estudias. Puede ser un fármaco administrado a pacientes o un descuento ofrecido a clientes. El resultado es lo que mides, como el tiempo de recuperación, la tasa de compra o la productividad.
El objetivo del ML causal es estimar cómo el tratamiento cambia el resultado. No estima si ambos están correlacionados, sino si uno causa realmente al otro.
Puedes observar qué pasó tras tomar un paciente el fármaco, pero no qué habría pasado si no lo hubiera tomado. Ese escenario no observado es el contrafáctico.
En otro ámbito: imagina que un cliente recibió un 20% de descuento y compró. El contrafáctico pregunta: ¿habría comprado sin el descuento? Nunca lo sabrás con certeza porque no puedes volver atrás y ejecutar ambas versiones sobre la misma persona.
El ML causal estima estos contrafácticos con técnicas estadísticas y supuestos. La calidad de tu estimación causal depende de lo bien que aproximes lo que no puedes observar directamente.
Un factor de confusión es una variable que afecta tanto al tratamiento como al resultado y crea una falsa impresión de causalidad.
Por ejemplo, estudias si el ejercicio reduce las enfermedades cardíacas. Quienes hacen más ejercicio también suelen comer más sano. La dieta afecta tanto a la probabilidad de hacer ejercicio (tratamiento) como a la enfermedad cardíaca (resultado). Si ignoras la dieta, sobrestimarás cuánto importa el ejercicio por sí solo.
Los factores de confusión son la mayor amenaza para el análisis causal. Identificarlos y tenerlos en cuenta es lo que da fiabilidad a una estimación causal, y merece la pena invertir tiempo en ello.
Si te preguntas cómo saber qué variables son de confusión y cuáles no, dibuja un gráfico.
Un grafo acíclico dirigido (DAG) es un diagrama que mapea las relaciones causales entre variables. Cada nodo es una variable y cada flecha va de la causa al efecto. "Dirigido" significa que las flechas tienen dirección. "Acíclico" significa que no hay bucles: una variable no puede causarse a sí misma, ni directa ni indirectamente.
Volvamos al ejemplo del ejercicio. Un DAG simple tendría flechas de dieta → ejercicio y dieta → enfermedad cardíaca, además de una flecha de ejercicio → enfermedad cardíaca. El gráfico deja claro que la dieta es un factor de confusión porque apunta tanto al tratamiento como al resultado.
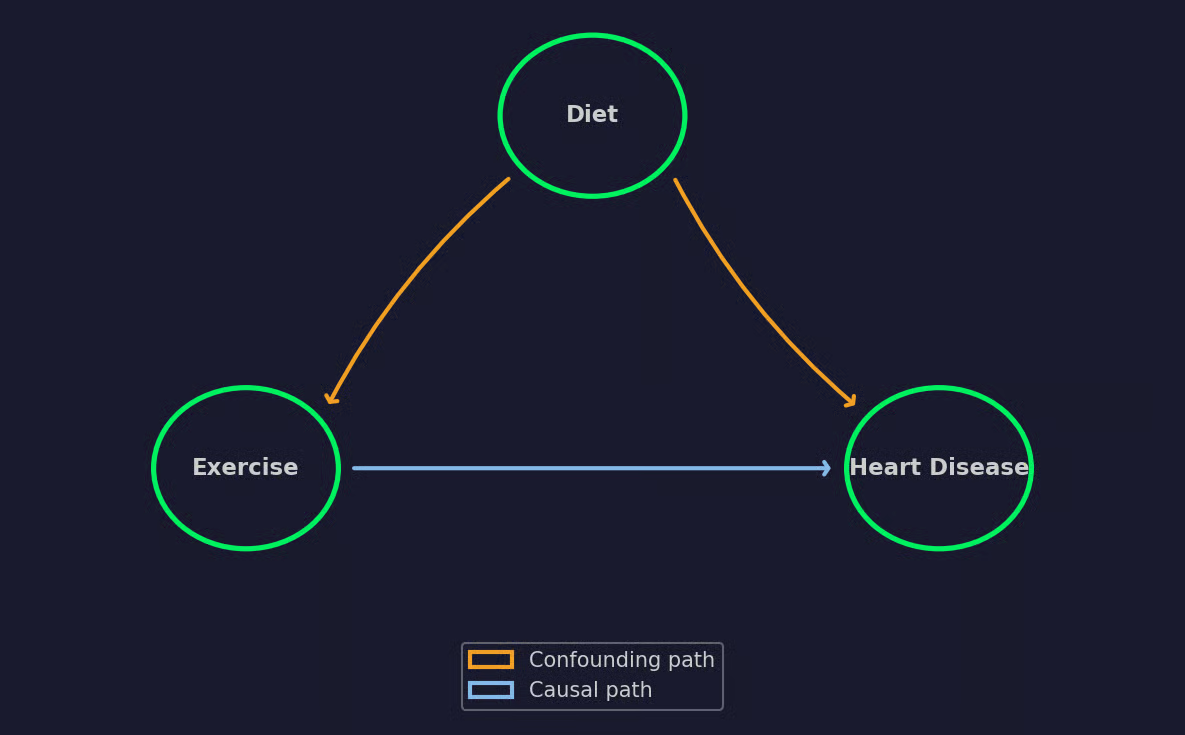
Un ejemplo sencillo de DAG
Los DAGs también te dicen qué variables debes controlar y cuáles no tocar. Si controlas la variable equivocada, puedes introducir sesgo en lugar de eliminarlo. Con esto en mente, piensa en un DAG como la hoja de ruta de todo tu análisis causal.
¿La mejor parte?
No necesitas matemáticas para construir un DAG. Necesitas conocimiento del dominio. El gráfico codifica tus supuestos sobre cómo funciona el mundo, y la calidad de tus estimaciones causales depende de que esos supuestos sean correctos.
El ML causal toma mucho de la estadística y la econometría, y escala estas ideas con ML. Te resumo los cuatro enfoques más comunes.
En un mundo ideal, harías un experimento aleatorizado para medir el efecto de un tratamiento. Pero en la práctica, la asignación a tratamiento rara vez es aleatoria. Quienes reciben el tratamiento suelen diferir de quienes no lo reciben, y esas diferencias introducen sesgo.
Los métodos de puntuación de propensión abordan esto estimando la probabilidad de que cada individuo reciba el tratamiento según sus características observadas. Esa probabilidad es la puntuación de propensión.
Una vez que tienes las puntuaciones, hay dos formas principales de usarlas:
Ambos métodos intentan simular cómo habría sido un experimento aleatorizado usando datos observacionales.
A veces los factores de confusión que necesitas controlar no están en tus datos. No puedes medirlos, así que las puntuaciones de propensión no ayudan. Aquí entran las variables instrumentales (IV).
Un instrumento es una variable que afecta al tratamiento pero no tiene efecto directo sobre el resultado. Solo influye en el resultado a través del tratamiento.
Un ejemplo clásico es estudiar el efecto de la educación en los ingresos. La motivación influye tanto en cuánta educación recibe alguien como en cuánto gana, pero no puedes medirla bien. La distancia a la universidad más cercana sirve como instrumento porque afecta a la probabilidad de asistir, pero no afecta directamente al salario futuro.
En la práctica, encontrar un buen instrumento es difícil. El método es potente cuando lo tienes, pero un instrumento débil o inválido dará resultados engañosos.
Los causal forests amplían el algoritmo de random forest para estimar efectos de tratamiento en lugar de predicciones. Un random forest estándar predice un resultado, mientras que un causal forest estima cuánto cambia ese resultado por el tratamiento en distintos subgrupos.
Esto es útil cuando el efecto del tratamiento varía entre individuos. Un fármaco puede funcionar bien en pacientes jóvenes pero no en mayores. Igual con un descuento: puede aumentar compras en clientes sensibles al precio pero no afectar a los fieles. Los causal forests detectan estas diferencias segmentando los datos por características que maximizan la variación del efecto del tratamiento.
El resultado es una estimación personalizada del efecto del tratamiento para cada individuo del conjunto de datos.
El double machine learning (DML) combina modelos de ML con inferencia estadística para quedarse con lo mejor de ambos mundos.
Usas un modelo de ML para predecir el resultado y otro para predecir la asignación al tratamiento. Luego miras los residuos (lo que ninguno de los modelos explica) y la relación entre ellos te da el efecto causal.
Si te preguntas por qué tantos pasos, aquí va la razón: los modelos de ML capturan bien patrones, pero introducen sesgo cuando se usan para estimación causal. DML elimina ese sesgo con cross-fitting, donde entrenas y predices en particiones distintas de los datos para evitar el overfitting.
Una vez eliges un método, necesitas una forma de resumir lo que ha encontrado. Ahí entran las métricas del efecto del tratamiento.
Average Treatment Effect (ATE) mide el efecto causal medio del tratamiento en toda tu población. Si el ATE de una campaña de descuento es de 5 $, significa que, de media, el descuento aumentó el gasto en 5 $ por cliente.
El ATE te da la visión global, pero oculta la variación individual. Un promedio de 5 $ puede significar que todo el mundo gastó 5 $ más, o que la mitad gastó 10 $ más y la otra mitad no cambió.
Conditional Average Treatment Effect (CATE) estima el efecto del tratamiento para subgrupos concretos según sus características. En lugar de un único número para todos, CATE te dice que el descuento aumentó el gasto en 8 $ para clientes nuevos pero solo en 2 $ para los recurrentes.
CATE es lo que hace accionable el ML causal. ATE te dice si una intervención funciona. CATE te dice para quién funciona, y esa es la respuesta que necesitas para tomar decisiones basadas en datos.
El ML causal aparece siempre que necesitas pasar de "¿qué ha pasado?" a "¿qué debemos hacer?". Aquí van algunos ejemplos.
Un hospital quiere saber qué tratamiento funciona mejor para un perfil concreto de paciente. El ML estándar puede predecir quién está en riesgo, pero el ML causal estima si el tratamiento A o el B dará un mejor resultado para ese paciente en particular. Esto permite decisiones de tratamiento personalizadas basadas en efectos estimados y no en promedios poblacionales.
Un equipo de marketing lanza una campaña y ve un pico en ventas. La pregunta es: ¿la campaña causó el pico o fue la estacionalidad? El ML causal aísla el impacto real de la campaña teniendo en cuenta factores como el momento, la demografía y el historial de compras.
Los gobiernos e instituciones necesitan evaluar si las políticas producen los resultados previstos. ¿Un programa de formación laboral redujo el desempleo? ¿Un incentivo fiscal aumentó la inversión? El ML causal aporta un marco para evaluar políticas cuando los ensayos aleatorizados no son prácticos o posibles.
Un equipo de producto añade una funcionalidad y sube el engagement. El ML causal ayuda a determinar si la funcionalidad causó el aumento o si coincidió con otros cambios, como un empuje de marketing o la caída de un competidor. Entender el impacto real de una funcionalidad separa las decisiones informadas por datos de la pura intuición.
El denominador común es que las decisiones dependen de saber por qué pasó algo, no solo de que pasó.
Hay tres librerías que cubren la mayoría de casos de uso de ML causal en Python. Te cuento qué hace cada una y te muestro un flujo de trabajo típico.
Antes de entrar en código, aquí tienes un snippet completo con los imports y la creación del dataset. Puedes instalar dependencias que falten con pip o uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
El dataset define 1000 clientes de un e-commerce y queremos estimar el efecto causal de un email con descuento, en dólares. El efecto causal real del descuento es de 5 $, pero como verás en la salida, una comparación ingenua lo sobrestima porque quienes recibieron descuentos ya tenían más compras previas:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")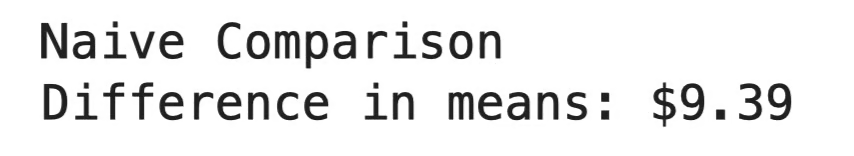
Comparación ingenua
DoWhy es un framework creado por Microsoft para inferencia causal de extremo a extremo. Sigue cuatro pasos: modelar el problema como un gráfico causal, identificar el efecto causal, estimarlo y luego comprobar si se mantiene bajo distintos supuestos.
Lo que diferencia a DoWhy es su foco en la validación. Tras producir una estimación, ejecuta pruebas de refutación que ponen a prueba tu resultado. Si la estimación las supera, puedes confiar más en ella. Si no, sabrás que tus supuestos necesitan revisión.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")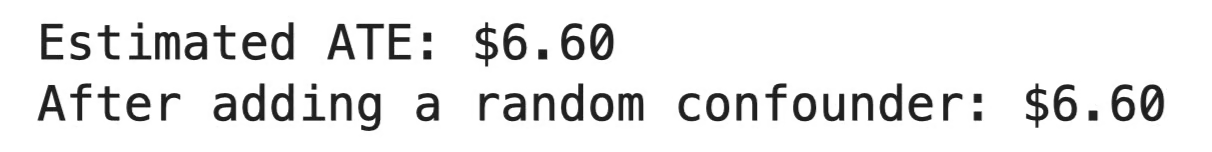
Salida de DoWhy
De media, el descuento aumentó el importe de compra en 6,60 $ por cliente. La prueba de refutación añadió una variable aleatoria al modelo y la estimación no cambió nada, lo que indica que el resultado no se debe a correlaciones espurias. Si hubiera variado mucho, sería una señal de alarma de que los supuestos causales están mal planteados.
EconML, también de Microsoft, se centra en estimar efectos de tratamiento heterogéneos; dicho de otra forma, cómo varía el efecto entre subgrupos. Implementa métodos como Double ML y Causal Forests que vimos antes.
EconML sigue una API estilo scikit-learn con métodos .fit() y .effect().
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")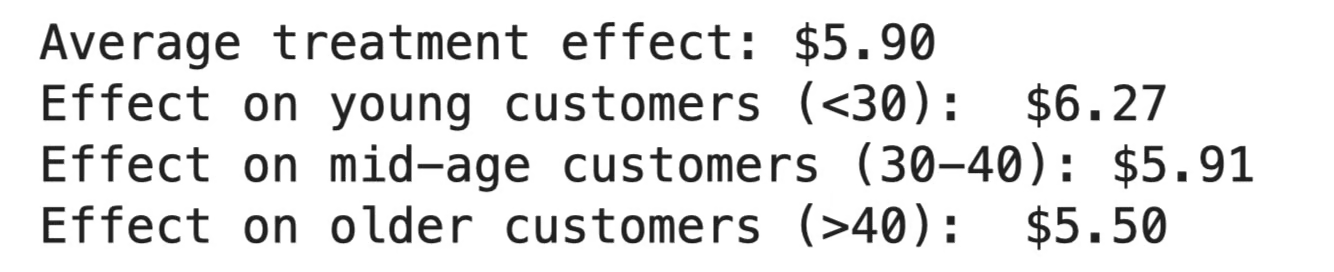
Salida de EconML
El descuento incrementó el importe medio en 5,90 $, pero el efecto no fue uniforme. Los clientes más jóvenes respondieron más (6,27 $), mientras que los mayores tuvieron el menor aumento (5,50 $). Si tu presupuesto es limitado, aquí tienes la pista de a quién dirigir la campaña primero.
CausalML, desarrollado por Uber, está pensado para uplift modeling: predecir qué individuos responderán más a un tratamiento. Es especialmente popular en marketing, donde el objetivo es impactar a clientes que cambiarán su comportamiento por la campaña, no a quienes habrían convertido igual.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())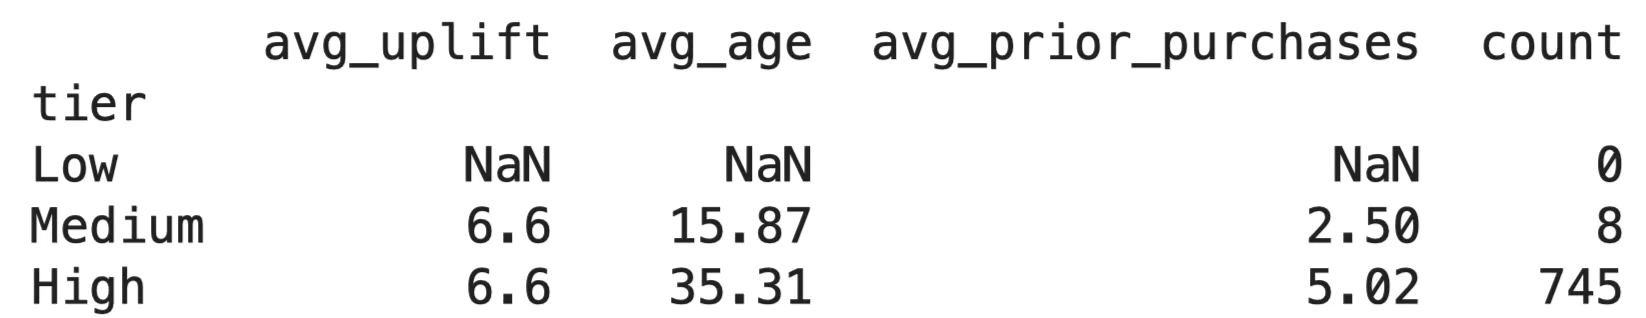
Salida de CausalML
Las puntuaciones de uplift son casi idénticas entre todos los clientes, lo que significa que el descuento tuvo un efecto similar en todos, alrededor de 6,60 $ por persona. Tiene sentido para nuestro dataset sintético, donde incorporé un efecto plano de 5 $ sin variación por subgrupos. En datos reales suele haber más dispersión, y es ahí donde los niveles de targeting son útiles.
Cada librería tiene su mejor caso de uso. Utiliza:
Las tres funcionan bien juntas. Un patrón común es definir tu gráfico causal en DoWhy, estimar efectos con EconML y usar CausalML para interpretar los resultados.
El ML causal a veces se usa mal. Estos son los errores que más confunden.
El clásico. Los clientes que usan más una funcionalidad también gastan más y concluyes que la funcionalidad impulsa el gasto. Pero puede que los clientes de alto gasto estén más implicados en todo. Sin un marco causal, estás adivinando la dirección de la relación.
Todo análisis causal empieza con una pregunta: ¿esto es un patrón o es una causa? Si te saltas esa pregunta, ningún modelado te va a salvar.
Un factor de confusión afecta tanto al tratamiento como al resultado.
Imagina que mides el efecto de un programa de formación en el rendimiento de empleados. Quienes se apuntan suelen estar más motivados. La motivación impulsa tanto la inscripción (tratamiento) como el rendimiento (resultado). Si no la tienes en cuenta, atribuirás a la formación lo que es efecto de la motivación.
La solución es más estructural que estadística. Dibuja tu DAG, mapea cada variable que pueda influir en ambos lados y decide cómo tratar cada una antes de ajustar un solo modelo.
Un ATE de 5 $ no significa que cada cliente ganara 5 $. Es un promedio, y los promedios esconden mucho. Algunos pueden haber ganado 15 $ mientras otros perdieron 5 $.
El peligro inverso también existe. Una estimación CATE para un subgrupo no significa que cada individuo de ese grupo responda igual. Los efectos del tratamiento son estimaciones con incertidumbre, no garantías. Comprueba siempre los intervalos de confianza y no tomes decisiones de targeting solo con estimaciones puntuales.
El número que te den EconML o DoWhy es tan bueno como los supuestos que hay detrás. Un modelo no puede responder a preguntas como:
Requieren a alguien que entienda el problema. Un causal forest producirá estimaciones de efecto aunque el modelo esté mal especificado; simplemente no te avisará de que están mal.
Los mejores análisis causales combinan la capacidad del ML para manejar datos complejos con una persona que sabe qué variables importan y por qué.
El ML causal cambia la pregunta de "¿qué va a pasar?" a "¿qué lo hizo pasar?"
Ese giro cambia cómo tomas decisiones. Pasas de reaccionar a patrones a entender la mecánica que hay detrás. Algunos dirían que es la única forma de tomar decisiones verdaderamente basadas en datos.
Pero las herramientas solo funcionan tan bien como los supuestos que les das. Un gráfico causal equivocado o una mala lectura de un efecto pueden llevarte a conclusiones que parecen “científicas” y basadas en datos, pero están mal. El modelo no levantará la mano para decírtelo.
Los mejores resultados llegan cuando combinas la capacidad del ML para manejar datos complejos con alguien que entiende el problema lo suficiente como para hacer las preguntas causales correctas. Empieza por el conocimiento del dominio y deja que el modelo haga el trabajo duro. No hay más secreto.
La primera parte es fácil, sobre todo con nuestro curso Supervised Learning with scikit-learn. Apúntate hoy y lleva tus habilidades de ML al siguiente nivel con una librería imprescindible de Python.
Aprende con DataCamp
Curso
Curso
Curso