Anthropic merilis Claude Sonnet 5 pada 30 Juni 2026, dan inti pesannya sederhana: ini adalah model Sonnet paling agentik yang pernah mereka luncurkan. Model ini dapat membuat rencana, mengendalikan alat seperti browser dan terminal, serta berjalan secara otonom pada tingkat yang hingga baru-baru ini hanya bisa dicapai oleh model kelas Opus yang lebih besar.
Klaim utama adalah bahwa Sonnet 5 berkinerja mendekati Opus 4.8 dalam penalaran, penggunaan alat, pengkodean, dan pekerjaan berbasis pengetahuan, tetapi dengan harga yang lebih rendah. Pada tolok ukur pengkodean agentik yang dipublikasikan Anthropic, Sonnet 5 meraih 63,2% dibandingkan Opus 4.8 yang 69,2% dan Sonnet 4.6 yang 58,1%. Pada salah satu tolok ukur kerja pengetahuan, Sonnet 5 bahkan sedikit melampaui Opus 4.8.
Dalam artikel ini, saya akan membahas semua hal baru di Claude Sonnet 5, meninjau fitur-fitur baru, mengeksplorasi tolok ukurnya, dan melihat berapa biayanya. Jika Anda ingin konteks Anthropic yang lebih luas, lihat panduan terbaru kami tentang perintah slash Claude Code dan ulasan kami tentang Claude Tag.
Apa Itu Claude Sonnet 5?
Claude Sonnet 5 adalah model kelas menengah Anthropic, berada di bawah lini Opus dan dibangun untuk menangani pekerjaan agentik yang sebelumnya menuntut model Opus yang lebih mahal. Model ini menggantikan Sonnet 4.6 yang diluncurkan pada Februari 2026, dan menggunakan tokenizer yang diperbarui yang mengubah cara model memproses teks.
Bagi banyak pengembang, era agentik dimulai dengan model kelas Sonnet seperti Claude Sonnet 3.5, 3.6, dan 3.7, yang merupakan rilis Claude pertama yang menunjukkan keterampilan nyata dalam pengkodean dan penggunaan alat. Baru-baru ini, peningkatan agentik paling jelas bergeser ke model kelas Opus, dan Sonnet 5 adalah upaya Anthropic untuk mengangkat kembali kelas menengah ke arah garis depan.
Sumber: Anthropic
Angka yang paling menggambarkan adalah gambaran biaya kinerja. Grafik Anthropic menunjukkan bahwa Sonnet 4.6 tertinggal jauh dari Opus 4.8 pada evaluasi penelusuran agentik BrowseComp dan penggunaan komputer OSWorld-Verified. Sonnet 5 dan Opus 4.8 kini mencakup rentang yang sama, dengan Sonnet 5 menawarkan biaya lebih rendah dan Opus 4.8 menawarkan akurasi lebih tinggi dengan harga lebih tinggi.
Apa yang Baru di Claude Sonnet 5?
Peningkatan di Sonnet 5 berpusat pada satu tema: menuntaskan tugas agentik tanpa berhenti di tengah jalan. Berikut kemampuan yang menonjol.
Perubahan praktis terbesar Sonnet 5 adalah ketuntasan tugas. Penguji akses awal Anthropic melaporkan bahwa model ini menyelesaikan tugas kompleks di mana versi Sonnet sebelumnya kerap macet di pertengahan, dan bahwa model ini memeriksa keluarannya sendiri tanpa diminta.
Untuk membayangkannya dalam pekerjaan Anda, misalnya Anda menyerahkan tugas lintas dua sistem: ambil hasil uji yang gagal dari run CI, lalu buka pull request dengan perbaikan. Model Sonnet sebelumnya cenderung berhenti setelah setengah jalan. Contoh Anthropic sendiri melibatkan pembaruan tingkat akun Salesforce dan pengiriman pengumuman peluncuran ke kontak enterprise dalam satu kali proses, alur kerja yang menurut seorang insinyur Zapier dulu sering macet di tengah.
Bagi siapa pun yang membangun agen, ini adalah perbedaan antara model yang menyusun rencana dan yang mengeksekusinya. Hal ini mengurangi frekuensi intervensi manusia untuk mendorong agen maju.
Menyetel tingkat upaya untuk menyeimbangkan biaya dan akurasi
Sonnet 5 mendukung tingkat upaya yang dapat disetel, sehingga Anda dapat menaikkan atau menurunkan kedalaman penalaran sesuai tugas dan anggaran. Anthropic memposisikannya sebagai cara untuk menemukan titik yang tepat antara Sonnet 5 dan Opus 4.8 alih-alih memilih satu model dan pasrah dengannya.
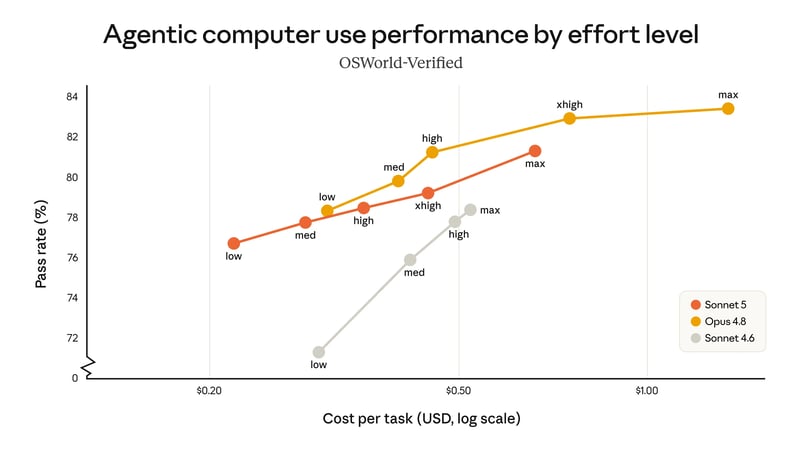
Pada tingkat penalaran Extra High yang dimaksimalkan, Sonnet 5 berkinerja kira-kira selevel dengan pengaturan menengah-ke-tinggi Opus 4.8 pada OSWorld-Verified dan BrowseComp. Namun, menjalankan Sonnet 5 pada tingkat tersebut bisa berbiaya lebih besar daripada Opus 4.8 pada pengaturan penalaran yang sebanding, sehingga Opus 4.8 tetap menjadi pilihan lebih baik untuk beberapa tugas berakurasi tinggi.
Jika Anda sudah menggunakan Claude Code, tingkat upaya ini akan terasa familiar. Kami membahas perintah /effort dan level-levelnya dalam tutorial perintah slash Claude Code.
Menjalankan agen dengan lebih aman di produksi
Sonnet 5 hadir dengan peningkatan keamanan terukur dibandingkan Sonnet 4.6, yang penting ketika agen menyentuh sistem produksi. Evaluasi pra-deploy Anthropic menemukan model ini lebih baik dalam menolak permintaan berbahaya dan lebih tahan terhadap upaya pembajakan dalam serangan prompt injection.
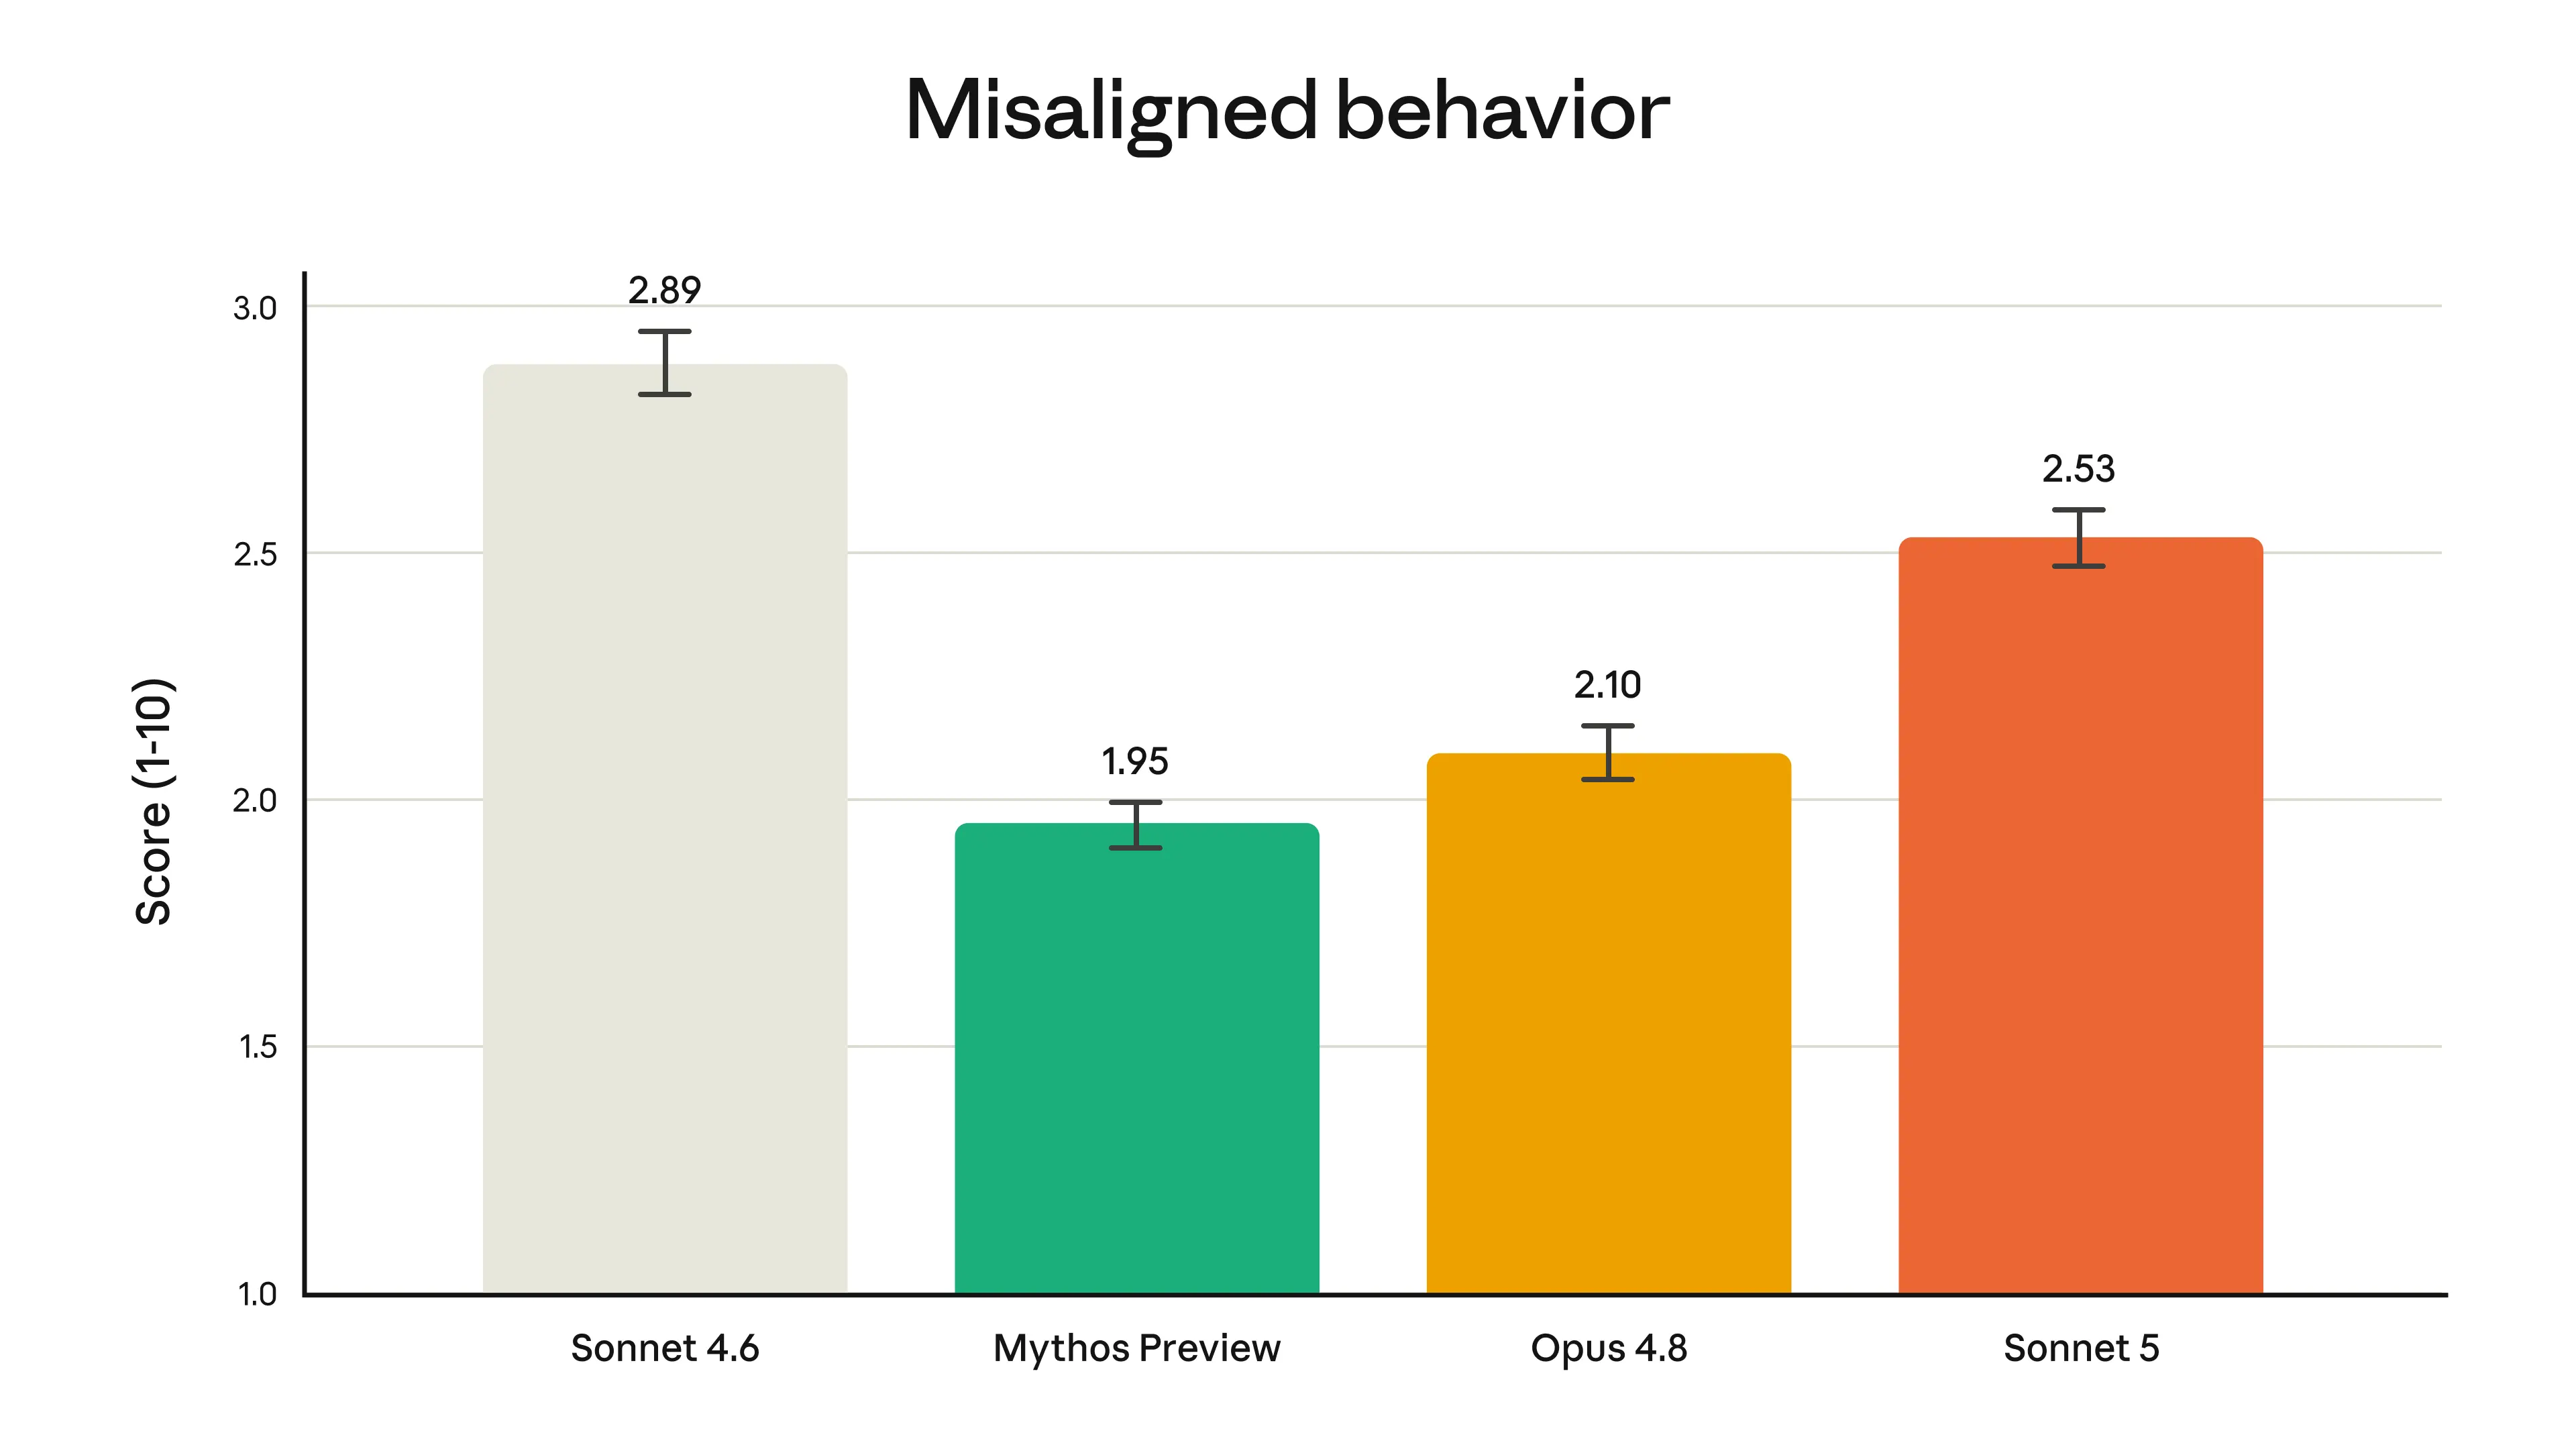
Model ini juga menunjukkan tingkat halusinasi dan sikofansi yang lebih rendah daripada Sonnet 4.6, serta meraih skor lebih rendah (lebih aman) pada audit perilaku otomatis Anthropic yang mencakup perilaku tidak selaras seperti bekerja sama dalam penyalahgunaan dan penipuan. Salah satu pendiri Lovable merumuskannya dengan lugas: model yang tahu kapan harus berkata tidak sama pentingnya dengan yang tahu cara membangun.
Catatannya, Sonnet 5 masih menunjukkan tingkat perilaku tidak selaras yang lebih tinggi dibandingkan Opus 4.8 yang lebih andal dan Claude Mythos Preview, sehingga ia lebih aman daripada pendahulunya tetapi belum menjadi model paling aman dalam lini Anthropic.
Sumber: Anthropic
Berjalan dengan perlindungan siber aktif secara bawaan
Sonnet 5 diluncurkan dengan perlindungan siber waktu nyata yang aktif secara default, sama seperti yang ada di Claude Opus 4.7 dan 4.8. Fitur ini mendeteksi dan memblokir penggunaan siber berbahaya saat terjadi.
Pada evaluasi Anthropic, Sonnet 5 memiliki kemampuan siber-berbahaya yang secara signifikan lebih lemah dibandingkan Opus 4.8 dan Mythos 5. Dalam uji yang dibangun bersama Mozilla untuk mengembangkan eksploit atas kerentanan di Firefox 147, baik Sonnet 5 maupun Sonnet 4.6 tidak pernah menghasilkan eksploit yang berfungsi (keduanya 0,0%), meskipun Sonnet 5 menunjukkan tingkat keberhasilan parsial sedikit lebih tinggi, yang oleh Anthropic diatribusikan pada peningkatan kecerdasan umum, bukan pelatihan siber.
Bagi peneliti keamanan yang membutuhkan pagar pembatas yang lebih longgar, Anthropic merekomendasikan Opus 4.8. Perlindungan pada Sonnet 5 kurang ketat daripada yang dikirim bersama Fable 5, yang memblokir rentang tugas keamanan siber yang lebih luas.
Tolok Ukur Claude Sonnet 5
Narasi tolok ukur Anthropic untuk Sonnet 5 konsisten: ini merupakan peningkatan ketat dibanding Sonnet 4.6 dan berada tepat di bawah Opus 4.8 pada evaluasi yang telah dipublikasikan sejauh ini. Angka-angka di bawah berasal dari materi peluncuran Anthropic. Satu catatan kehati-hatian: peninjau pihak ketiga melaporkan angka berbeda untuk tolok ukur yang sama, kemungkinan karena perbedaan dataset, pengaturan konteks, atau kerangka agen, jadi anggap angka utama bergantung pada konfigurasi.
| | Sonnet 5 | Sonnet 4.6 | Opus 4.8
Sebagai referensi |
|---|
Pengkodean agentik
SWE-bench Pro | 63,2% | 58,1% | 69,2% |
Pengkodean agentik
Terminal-Bench 2.1 | 80,4% | 67,0% | 82,7% |
Penalaran multidisipliner
Humanity's Last Exam | 43,2%
tanpa alat
57,4%
dengan alat | 34,6%
tanpa alat
46,8%
dengan alat | 49,8%
tanpa alat
57,9%
dengan alat |
Penggunaan komputer
OSWorld-Verified | 81,2% | 78,5% | 83,4% |
Pekerjaan pengetahuan
GDPval-AA v2 | 1618 | 1395 | 1615 |
Pengkodean agentik
Pada tolok ukur pengkodean agentik yang dipublikasikan Anthropic, Sonnet 5 meraih 63,2%, dibandingkan Opus 4.8 yang 69,2% dan Sonnet 4.6 yang 58,1%. Tolok ukur ini mengukur apakah model dapat menulis, menjalankan, dan memperbaiki kode melalui beberapa langkah alih-alih menghasilkan satu cuplikan.
Kesenjangan dengan Opus 4.8 sekitar 6 poin, sementara lompatan dibanding Sonnet 4.6 sekitar 5 poin. Bagi pengembang, artinya Sonnet 5 merupakan peningkatan jelas atas model kelas menengah sebelumnya, meski belum menyamai andalan.
Sumber: Anthropic
OSWorld-Verified dan BrowseComp
OSWorld-Verified mengukur kemampuan penggunaan komputer, mengendalikan desktop untuk menyelesaikan tugas nyata, dan BrowseComp mengukur penelusuran web agentik. Anthropic memperbarui metodologi OSWorld-Verified dan kini melaporkan Sonnet 4.6 pada 78,5% dalam setup yang direvisi.
Di kedua evaluasi, Sonnet 5 merupakan peningkatan ketat atas Sonnet 4.6 pada setiap tingkat upaya, sementara Opus 4.8 tetap menjadi pilihan berakurasi lebih tinggi. Pada tingkat Extra High, Sonnet 5 mencapai kira-kira kinerja menengah-ke-tinggi Opus 4.8, namun pada titik itu keunggulan biaya menyempit, itulah sebabnya Anthropic membingkai kedua model sebagai satu rentang biaya-akurasi, bukan peningkatan lurus.
Pekerjaan pengetahuan
Pada salah satu tolok ukur pekerjaan pengetahuan, Sonnet 5 sedikit melampaui Opus 4.8, menurut laporan TechCrunch. Ini patut dicatat karena Opus 4.8 biasanya diasosiasikan dengan keputusan paling sulit dan riset mendalam.
Anthropic juga memperbarui penilai untuk Humanity's Last Exam dan kini melaporkan Sonnet 4.6 pada 34,6% (tanpa alat) dan 46,8% (dengan alat), yang menjelaskan perbedaan angka dari peluncuran awal Sonnet 4.6. Bagi praktisi, hasil kerja-pengetahuan ini menyiratkan Sonnet 5 layak untuk tugas analisis dan riset yang sebelumnya terasa seperti wilayah Opus.
Perbandingannya dengan model Anthropic lain
Untuk konteks lebih luas tentang posisi kelas Sonnet, liputan kami tentang Sakana Fugu vs Claude Fable 5 berguna. Dalam perbandingan itu, Claude Fable 5 yang berkelas lebih tinggi meraih 80,3% pada SWE-Bench Pro dan 59,0% pada Humanity's Last Exam (tanpa alat), jauh di atas angka kelas menengah di sini.
Rentang tersebut memang tujuannya. Lini Anthropic membentang dari Sonnet 5 yang agentik dan berbiaya lebih rendah hingga Opus 4.8 serta kelas Mythos dan Fable, dengan tiap kelas menukar biaya dengan akurasi pada masalah tersulit.
Harga dan Ketersediaan Claude Sonnet 5
Claude Sonnet 5 tersedia di mana-mana sejak hari peluncuran. Ini menjadi model default untuk paket Free dan Pro, serta tersedia bagi pengguna Max, Team, dan Enterprise, juga di Claude Code dan di Claude Platform.
Pengembang dapat memanggilnya melalui Claude API menggunakan ID model claude-sonnet-5. Penetapan harga berlangsung dalam dua fase:
- Harga perkenalan (hingga 31 Agustus 2026): $2 per satu juta token input dan $10 per satu juta token output
- Harga standar (setelah 31 Agustus 2026): $3 per satu juta token input dan $15 per satu juta token output
Satu detail untuk diperhitungkan: Sonnet 5 menggunakan tokenizer yang diperbarui, sehingga input yang sama bisa terpetakan ke lebih banyak token daripada sebelumnya, sekitar 1,0 hingga 1,35 kali tergantung jenis konten. Anthropic menetapkan harga perkenalan agar transisi dari Sonnet 4.6 kira-kira netral biaya. Perusahaan juga menaikkan batas laju di Chat, Cowork, Claude Code, dan Claude Platform untuk menangani penggunaan token yang lebih berat akibat tingkat upaya yang lebih tinggi.
Sekilas: Claude Sonnet 5 vs. Sonnet 4.6 dan Opus 4.8
Bagi pembaca yang menginginkan perbandingan cepat, berikut penyelarasan ketiga model menurut angka yang dipublikasikan Anthropic.
| Model | Pengkodean agentik | OSWorld-Verified | Harga input / output (per 1M token) |
|---|
| Sonnet 5 | 63,2% | Meningkat atas 4.6 di semua tingkat upaya | $2 / $10 (perkenalan), lalu $3 / $15 |
| Sonnet 4.6 | 58,1% | 78,5% (direvisi) | $3 / $15 |
| Opus 4.8 | 69,2% | Pilihan berakurasi lebih tinggi | $5 / $25 |
Penutup
Sonnet 5 adalah pernyataan paling jelas dari Anthropic bahwa kapabilitas agentik kini menjadi ekspektasi dasar di setiap kelas harga, bukan lagi fitur khusus andalan. Pembeda utamanya bukan siapa yang paling hebat dalam kerja agentik, melainkan siapa yang dapat melakukannya dengan murah dan andal tanpa pengawasan manusia.
Yang paling menarik bagi saya adalah harga perkenalannya. Anthropic tampaknya ingin pelanggan menguji Sonnet 5 pada beban kerja nyata dengan biaya serendah mungkin selama masa migrasi, yang tampak seperti dorongan terencana untuk memindahkan pengguna dari Opus 4.8 untuk kerja agentik rutin dan membebaskan kapasitas tersebut. Ini juga menekan harga GPT-5.5 dari OpenAI dan Gemini 3.1 Pro dari Google, meski Gemini 3.5 Flash tetap lebih murah.
Jika Anda membangun agen yang menjalankan tugas berkelanjutan dan multi-langkah, Sonnet 5 tampak seperti default baru yang layak dicoba terlebih dahulu, naik ke Opus 4.8 hanya ketika sebuah tugas benar-benar membutuhkan akurasi ekstra. Catatan jujurnya, beberapa peninjau pihak ketiga melihat Sonnet 5 menukar kedalaman penalaran dengan kecepatan pengkodean, jadi untuk sains setingkat PhD atau pekerjaan yang berat pada penjelajahan web, Opus 4.8 mungkin tetap pilihan lebih aman.
Jika Anda ingin langsung mencoba otomatisasi seperti yang menjadi fokus Sonnet 5, saya merekomendasikan tutorial Claude Code Routines kami, yang memandu Anda menjalankan agen pengkodean sesuai jadwal di cloud.




Anthropic merilis Claude Sonnet 5 pada 30 Juni 2026, dan inti pesannya sederhana: ini adalah model Sonnet paling agentik yang pernah mereka luncurkan. Model ini dapat membuat rencana, mengendalikan alat seperti browser dan terminal, serta berjalan secara otonom pada tingkat yang hingga baru-baru ini hanya bisa dicapai oleh model kelas Opus yang lebih besar.
Klaim utama adalah bahwa Sonnet 5 berkinerja mendekati Opus 4.8 dalam penalaran, penggunaan alat, pengkodean, dan pekerjaan berbasis pengetahuan, tetapi dengan harga yang lebih rendah. Pada tolok ukur pengkodean agentik yang dipublikasikan Anthropic, Sonnet 5 meraih 63,2% dibandingkan Opus 4.8 yang 69,2% dan Sonnet 4.6 yang 58,1%. Pada salah satu tolok ukur kerja pengetahuan, Sonnet 5 bahkan sedikit melampaui Opus 4.8.
Dalam artikel ini, saya akan membahas semua hal baru di Claude Sonnet 5, meninjau fitur-fitur baru, mengeksplorasi tolok ukurnya, dan melihat berapa biayanya. Jika Anda ingin konteks Anthropic yang lebih luas, lihat panduan terbaru kami tentang perintah slash Claude Code dan ulasan kami tentang Claude Tag.
Apa Itu Claude Sonnet 5?
Claude Sonnet 5 adalah model kelas menengah Anthropic, berada di bawah lini Opus dan dibangun untuk menangani pekerjaan agentik yang sebelumnya menuntut model Opus yang lebih mahal. Model ini menggantikan Sonnet 4.6 yang diluncurkan pada Februari 2026, dan menggunakan tokenizer yang diperbarui yang mengubah cara model memproses teks.
Bagi banyak pengembang, era agentik dimulai dengan model kelas Sonnet seperti Claude Sonnet 3.5, 3.6, dan 3.7, yang merupakan rilis Claude pertama yang menunjukkan keterampilan nyata dalam pengkodean dan penggunaan alat. Baru-baru ini, peningkatan agentik paling jelas bergeser ke model kelas Opus, dan Sonnet 5 adalah upaya Anthropic untuk mengangkat kembali kelas menengah ke arah garis depan.
Sumber: Anthropic
Angka yang paling menggambarkan adalah gambaran biaya kinerja. Grafik Anthropic menunjukkan bahwa Sonnet 4.6 tertinggal jauh dari Opus 4.8 pada evaluasi penelusuran agentik BrowseComp dan penggunaan komputer OSWorld-Verified. Sonnet 5 dan Opus 4.8 kini mencakup rentang yang sama, dengan Sonnet 5 menawarkan biaya lebih rendah dan Opus 4.8 menawarkan akurasi lebih tinggi dengan harga lebih tinggi.
Apa yang Baru di Claude Sonnet 5?
Peningkatan di Sonnet 5 berpusat pada satu tema: menuntaskan tugas agentik tanpa berhenti di tengah jalan. Berikut kemampuan yang menonjol.
Menuntaskan tugas multi-langkah dari awal hingga akhir
Perubahan praktis terbesar Sonnet 5 adalah ketuntasan tugas. Penguji akses awal Anthropic melaporkan bahwa model ini menyelesaikan tugas kompleks di mana versi Sonnet sebelumnya kerap macet di pertengahan, dan bahwa model ini memeriksa keluarannya sendiri tanpa diminta.
Untuk membayangkannya dalam pekerjaan Anda, misalnya Anda menyerahkan tugas lintas dua sistem: ambil hasil uji yang gagal dari run CI, lalu buka pull request dengan perbaikan. Model Sonnet sebelumnya cenderung berhenti setelah setengah jalan. Contoh Anthropic sendiri melibatkan pembaruan tingkat akun Salesforce dan pengiriman pengumuman peluncuran ke kontak enterprise dalam satu kali proses, alur kerja yang menurut seorang insinyur Zapier dulu sering macet di tengah.
Bagi siapa pun yang membangun agen, ini adalah perbedaan antara model yang menyusun rencana dan yang mengeksekusinya. Hal ini mengurangi frekuensi intervensi manusia untuk mendorong agen maju.
Menyetel tingkat upaya untuk menyeimbangkan biaya dan akurasi
Sonnet 5 mendukung tingkat upaya yang dapat disetel, sehingga Anda dapat menaikkan atau menurunkan kedalaman penalaran sesuai tugas dan anggaran. Anthropic memposisikannya sebagai cara untuk menemukan titik yang tepat antara Sonnet 5 dan Opus 4.8 alih-alih memilih satu model dan pasrah dengannya.
Pada tingkat penalaran Extra High yang dimaksimalkan, Sonnet 5 berkinerja kira-kira selevel dengan pengaturan menengah-ke-tinggi Opus 4.8 pada OSWorld-Verified dan BrowseComp. Namun, menjalankan Sonnet 5 pada tingkat tersebut bisa berbiaya lebih besar daripada Opus 4.8 pada pengaturan penalaran yang sebanding, sehingga Opus 4.8 tetap menjadi pilihan lebih baik untuk beberapa tugas berakurasi tinggi.
Jika Anda sudah menggunakan Claude Code, tingkat upaya ini akan terasa familiar. Kami membahas perintah
/effortdan level-levelnya dalam tutorial perintah slash Claude Code.Menjalankan agen dengan lebih aman di produksi
Sonnet 5 hadir dengan peningkatan keamanan terukur dibandingkan Sonnet 4.6, yang penting ketika agen menyentuh sistem produksi. Evaluasi pra-deploy Anthropic menemukan model ini lebih baik dalam menolak permintaan berbahaya dan lebih tahan terhadap upaya pembajakan dalam serangan prompt injection.
Model ini juga menunjukkan tingkat halusinasi dan sikofansi yang lebih rendah daripada Sonnet 4.6, serta meraih skor lebih rendah (lebih aman) pada audit perilaku otomatis Anthropic yang mencakup perilaku tidak selaras seperti bekerja sama dalam penyalahgunaan dan penipuan. Salah satu pendiri Lovable merumuskannya dengan lugas: model yang tahu kapan harus berkata tidak sama pentingnya dengan yang tahu cara membangun.
Catatannya, Sonnet 5 masih menunjukkan tingkat perilaku tidak selaras yang lebih tinggi dibandingkan Opus 4.8 yang lebih andal dan Claude Mythos Preview, sehingga ia lebih aman daripada pendahulunya tetapi belum menjadi model paling aman dalam lini Anthropic.
Sumber: Anthropic
Berjalan dengan perlindungan siber aktif secara bawaan
Sonnet 5 diluncurkan dengan perlindungan siber waktu nyata yang aktif secara default, sama seperti yang ada di Claude Opus 4.7 dan 4.8. Fitur ini mendeteksi dan memblokir penggunaan siber berbahaya saat terjadi.
Pada evaluasi Anthropic, Sonnet 5 memiliki kemampuan siber-berbahaya yang secara signifikan lebih lemah dibandingkan Opus 4.8 dan Mythos 5. Dalam uji yang dibangun bersama Mozilla untuk mengembangkan eksploit atas kerentanan di Firefox 147, baik Sonnet 5 maupun Sonnet 4.6 tidak pernah menghasilkan eksploit yang berfungsi (keduanya 0,0%), meskipun Sonnet 5 menunjukkan tingkat keberhasilan parsial sedikit lebih tinggi, yang oleh Anthropic diatribusikan pada peningkatan kecerdasan umum, bukan pelatihan siber.
Bagi peneliti keamanan yang membutuhkan pagar pembatas yang lebih longgar, Anthropic merekomendasikan Opus 4.8. Perlindungan pada Sonnet 5 kurang ketat daripada yang dikirim bersama Fable 5, yang memblokir rentang tugas keamanan siber yang lebih luas.
Tolok Ukur Claude Sonnet 5
Narasi tolok ukur Anthropic untuk Sonnet 5 konsisten: ini merupakan peningkatan ketat dibanding Sonnet 4.6 dan berada tepat di bawah Opus 4.8 pada evaluasi yang telah dipublikasikan sejauh ini. Angka-angka di bawah berasal dari materi peluncuran Anthropic. Satu catatan kehati-hatian: peninjau pihak ketiga melaporkan angka berbeda untuk tolok ukur yang sama, kemungkinan karena perbedaan dataset, pengaturan konteks, atau kerangka agen, jadi anggap angka utama bergantung pada konfigurasi.
Sebagai referensi
SWE-bench Pro
Terminal-Bench 2.1
Humanity's Last Exam
tanpa alat
57,4%
dengan alat
tanpa alat
46,8%
dengan alat
tanpa alat
57,9%
dengan alat
OSWorld-Verified
GDPval-AA v2
Pengkodean agentik
Pada tolok ukur pengkodean agentik yang dipublikasikan Anthropic, Sonnet 5 meraih 63,2%, dibandingkan Opus 4.8 yang 69,2% dan Sonnet 4.6 yang 58,1%. Tolok ukur ini mengukur apakah model dapat menulis, menjalankan, dan memperbaiki kode melalui beberapa langkah alih-alih menghasilkan satu cuplikan.
Kesenjangan dengan Opus 4.8 sekitar 6 poin, sementara lompatan dibanding Sonnet 4.6 sekitar 5 poin. Bagi pengembang, artinya Sonnet 5 merupakan peningkatan jelas atas model kelas menengah sebelumnya, meski belum menyamai andalan.
Sumber: Anthropic
OSWorld-Verified dan BrowseComp
OSWorld-Verified mengukur kemampuan penggunaan komputer, mengendalikan desktop untuk menyelesaikan tugas nyata, dan BrowseComp mengukur penelusuran web agentik. Anthropic memperbarui metodologi OSWorld-Verified dan kini melaporkan Sonnet 4.6 pada 78,5% dalam setup yang direvisi.
Di kedua evaluasi, Sonnet 5 merupakan peningkatan ketat atas Sonnet 4.6 pada setiap tingkat upaya, sementara Opus 4.8 tetap menjadi pilihan berakurasi lebih tinggi. Pada tingkat Extra High, Sonnet 5 mencapai kira-kira kinerja menengah-ke-tinggi Opus 4.8, namun pada titik itu keunggulan biaya menyempit, itulah sebabnya Anthropic membingkai kedua model sebagai satu rentang biaya-akurasi, bukan peningkatan lurus.
Pekerjaan pengetahuan
Pada salah satu tolok ukur pekerjaan pengetahuan, Sonnet 5 sedikit melampaui Opus 4.8, menurut laporan TechCrunch. Ini patut dicatat karena Opus 4.8 biasanya diasosiasikan dengan keputusan paling sulit dan riset mendalam.
Anthropic juga memperbarui penilai untuk Humanity's Last Exam dan kini melaporkan Sonnet 4.6 pada 34,6% (tanpa alat) dan 46,8% (dengan alat), yang menjelaskan perbedaan angka dari peluncuran awal Sonnet 4.6. Bagi praktisi, hasil kerja-pengetahuan ini menyiratkan Sonnet 5 layak untuk tugas analisis dan riset yang sebelumnya terasa seperti wilayah Opus.
Perbandingannya dengan model Anthropic lain
Untuk konteks lebih luas tentang posisi kelas Sonnet, liputan kami tentang Sakana Fugu vs Claude Fable 5 berguna. Dalam perbandingan itu, Claude Fable 5 yang berkelas lebih tinggi meraih 80,3% pada SWE-Bench Pro dan 59,0% pada Humanity's Last Exam (tanpa alat), jauh di atas angka kelas menengah di sini.
Rentang tersebut memang tujuannya. Lini Anthropic membentang dari Sonnet 5 yang agentik dan berbiaya lebih rendah hingga Opus 4.8 serta kelas Mythos dan Fable, dengan tiap kelas menukar biaya dengan akurasi pada masalah tersulit.
Harga dan Ketersediaan Claude Sonnet 5
Claude Sonnet 5 tersedia di mana-mana sejak hari peluncuran. Ini menjadi model default untuk paket Free dan Pro, serta tersedia bagi pengguna Max, Team, dan Enterprise, juga di Claude Code dan di Claude Platform.
Pengembang dapat memanggilnya melalui Claude API menggunakan ID model
claude-sonnet-5. Penetapan harga berlangsung dalam dua fase:Satu detail untuk diperhitungkan: Sonnet 5 menggunakan tokenizer yang diperbarui, sehingga input yang sama bisa terpetakan ke lebih banyak token daripada sebelumnya, sekitar 1,0 hingga 1,35 kali tergantung jenis konten. Anthropic menetapkan harga perkenalan agar transisi dari Sonnet 4.6 kira-kira netral biaya. Perusahaan juga menaikkan batas laju di Chat, Cowork, Claude Code, dan Claude Platform untuk menangani penggunaan token yang lebih berat akibat tingkat upaya yang lebih tinggi.
Sekilas: Claude Sonnet 5 vs. Sonnet 4.6 dan Opus 4.8
Bagi pembaca yang menginginkan perbandingan cepat, berikut penyelarasan ketiga model menurut angka yang dipublikasikan Anthropic.
Penutup
Sonnet 5 adalah pernyataan paling jelas dari Anthropic bahwa kapabilitas agentik kini menjadi ekspektasi dasar di setiap kelas harga, bukan lagi fitur khusus andalan. Pembeda utamanya bukan siapa yang paling hebat dalam kerja agentik, melainkan siapa yang dapat melakukannya dengan murah dan andal tanpa pengawasan manusia.
Yang paling menarik bagi saya adalah harga perkenalannya. Anthropic tampaknya ingin pelanggan menguji Sonnet 5 pada beban kerja nyata dengan biaya serendah mungkin selama masa migrasi, yang tampak seperti dorongan terencana untuk memindahkan pengguna dari Opus 4.8 untuk kerja agentik rutin dan membebaskan kapasitas tersebut. Ini juga menekan harga GPT-5.5 dari OpenAI dan Gemini 3.1 Pro dari Google, meski Gemini 3.5 Flash tetap lebih murah.
Jika Anda membangun agen yang menjalankan tugas berkelanjutan dan multi-langkah, Sonnet 5 tampak seperti default baru yang layak dicoba terlebih dahulu, naik ke Opus 4.8 hanya ketika sebuah tugas benar-benar membutuhkan akurasi ekstra. Catatan jujurnya, beberapa peninjau pihak ketiga melihat Sonnet 5 menukar kedalaman penalaran dengan kecepatan pengkodean, jadi untuk sains setingkat PhD atau pekerjaan yang berat pada penjelajahan web, Opus 4.8 mungkin tetap pilihan lebih aman.
Jika Anda ingin langsung mencoba otomatisasi seperti yang menjadi fokus Sonnet 5, saya merekomendasikan tutorial Claude Code Routines kami, yang memandu Anda menjalankan agen pengkodean sesuai jadwal di cloud.