Kursus
Manipulasi Data di SQL
4 jam
338.8K
Sekarang mari lihat masalah paling umum yang mungkin Anda hadapi jika Anda tidak membersihkan data berantakan (terkait tipe yang disebutkan sebelumnya).
Misalkan Anda memiliki entri null untuk sebuah kolom numerik dan Anda menghitung statistik ringkasan (seperti mean, nilai maksimum, minimum) pada kolom tersebut. Hasilnya tidak akan tersampaikan secara akurat dalam kasus ini. Pertimbangkan lagi dataset Pima Indian Diabetes dengan entri nol yang tidak valid. Jika Anda menghitung statistik ringkasan pada kolom-kolom seperti disebutkan sebelumnya, apakah Anda akan mendapatkan hasil yang benar? Bukankah hasilnya akan keliru? Lalu, bagaimana mengatasinya? Ada beberapa cara:
- Removing the entries containing missing/null values (not recommended)
- Imputing the null entries with a numeric value (typically with mean or median of the respective column)
Sekarang mari praktik langsung dengan masalah ini dan opsi kedua untuk mengatasi nilai null.
Pertimbangkan tabel PostgreSQL berikut bernama entries:
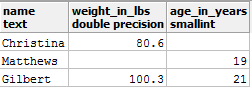
Anda dapat melihat dua entri null pada tabel di atas. Misalkan Anda ingin mendapatkan nilai rata-rata berat dari tabel ini dan Anda mengeksekusi kueri berikut:
select avg(weight_in_lbs) as average_weight_in_lbs from entries;
Anda mendapatkan keluaran 90.45. Apakah ini benar? Lalu, apa yang bisa dilakukan? Mari isi entri null dengan nilai rata-rata ini dengan bantuan fungsi COALESCE().
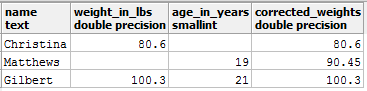
Mari isi nilai yang hilang terlebih dahulu dengan COALESCE() (ingat bahwa COALESCE() tidak mengubah nilai di tabel asli, fungsi ini hanya mengembalikan tampilan sementara dari tabel dengan nilai yang telah diubah):
select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries;
Anda seharusnya mendapatkan keluaran seperti:
Sekarang Anda bisa menerapkan AVG() lagi:
select avg(corrected_weights) from
(select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries) as subquery;
Ini adalah hasil yang jauh lebih akurat daripada sebelumnya. Sekarang mari pelajari masalah lain yang dapat terjadi jika Anda memiliki ketidaksesuaian pada tipe data kolom.
Misalkan Anda bekerja dengan tabel student_metadata dan department_details berikut:
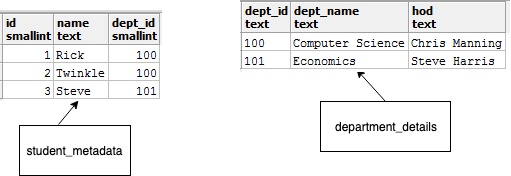
Anda dapat melihat pada tabel student_mtadata, dept_id bertipe integer, dan pada tabel department_details, kolom tersebut bertipe teks. Sekarang, misalkan Anda ingin menggabungkan kedua tabel ini dan membuat laporan yang akan memuat kolom berikut:
Untuk melakukan ini, Anda menjalankan kueri berikut:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = d.dept_id;
Lalu Anda akan menjumpai galat berikut:
ERROR: operator does not exist: smallint = text
Berikut infografik yang sangat bagus yang menggambarkan masalah ini (dari kursus DataCamp Reporting in SQL):
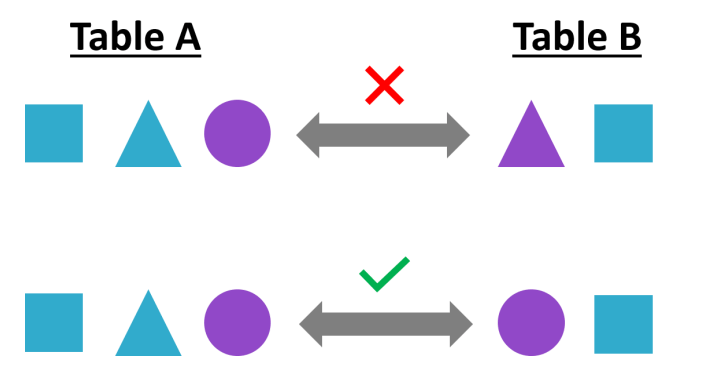
Ini terjadi karena tipe data tidak cocok saat menggabungkan kedua tabel. Di sini, Anda bisa melakukan CAST pada kolom dept_id di tabel department_details menjadi integer saat melakukan join. Berikut caranya:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = cast(d.dept_id as smallint);
Dan Anda mendapatkan laporan yang diinginkan:
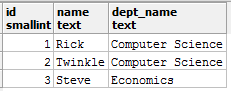
Sekarang mari bahas bagaimana string dapat hadir dalam bentuk berantakan, masalahnya, dan cara menanganinya.
Nilai string juga sangat umum. Mari mulai bagian ini dengan melihat nilai pada kolom dept_name (menunjukkan nama departemen) yang diambil dari tabel bernama student_details:
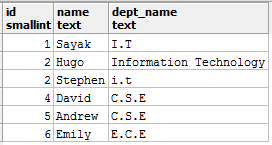
Nilai string seperti di atas dapat menyebabkan banyak masalah tak terduga. I.T, Information Technology, dan i.t semuanya bermakna departemen yang sama, yaitu Information Technology dan misalkan dokumen spesifikasi mengharuskan nilainya hadir sebagai I.T saja. Sekarang, katakanlah Anda ingin menghitung jumlah siswa yang berasal dari departemen I.T., dan Anda menjalankan kueri ini:
select dept_name, count(dept_name) as student_count
from student_details
group by dept_name;
Dan Anda mendapatkan:
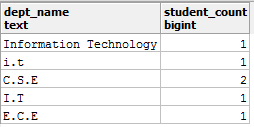
Apakah ini laporan yang akurat? - Tidak! Lalu, bagaimana Anda dapat mengatasi masalah ini?
Mari identifikasi dulu masalahnya secara lebih terperinci:
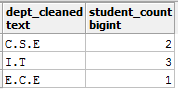
Information Technology sebagai nilai yang harus diubah menjadi I.T dani.t sebagai nilai lain yang harus diubah menjadi I.T.Pada kasus pertama, Anda dapat melakukan REPLACE nilai Information Technology menjadi I.T, dan pada kasus kedua, Anda mengubah karakter menjadi huruf UPPER. Anda dapat menyelesaikan ini dalam satu kueri meski disarankan untuk menangani masalah seperti ini secara bertahap. Berikut kueri untuk mengatasi masalahnya:
select upper(replace(dept_name, 'Information Technology', 'I.T')) as dept_cleaned,
count(dept_name) as student_count
from student_details
group by dept_cleaned;
Dan laporannya:
Anda dapat membaca lebih lanjut tentang fungsi string PostgreSQL di sini.
Sekarang mari bahas beberapa contoh di mana nilai date dapat berantakan dan apa yang bisa Anda lakukan untuk membersihkannya.
Misalkan Anda bekerja dengan tabel bernama employees yang memuat kolom birthdate tetapi bukan dalam tipe tanggal yang sesuai. Sekarang, Anda ingin mengeksekusi kueri dengan fungsi date khusus seperti DATE_PART(). Anda tidak akan bisa melakukannya kecuali Anda melakukan CAST pada kolom birthdate menjadi tipe date. Mari lihat ini secara praktik.
Anggap birthdate berformat YYYY-MM-DD.
Berikut tampilan tabel employees:
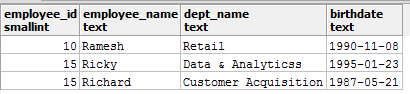
Sekarang, Anda menjalankan kueri berikut untuk mengekstrak bulan dari tanggal lahir:
select date_part('month', birthdate) from employees;
Dan Anda langsung mendapatkan galat ini:
ERROR: function date_part(unknown, text) does not exist
Bersamaan dengan galat tersebut, Anda juga mendapat petunjuk yang sangat bagus:
HINT: No function matches the given name and argument types. You might need to add explicit type casts.
Mari ikuti petunjuknya dan lakukan CAST pada birthdate ke tipe date yang sesuai lalu terapkan DATE_PART():
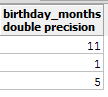
select date_part('month', CAST(birthdate AS date)) as birthday_months from employees;
Anda seharusnya mendapatkan hasil:
Sekarang mari lanjut ke bagian pra-penutup tutorial ini di mana Anda akan mempelajari dampak duplikasi data dan cara mengatasinya.
Pada bagian ini, Anda akan mempelajari beberapa penyebab paling umum yang mengarah ke duplikasi data. Anda juga akan melihat dampaknya dan beberapa cara untuk mencegahnya. Pertimbangkan dua tabel berikut band_details dan some_festival_record:
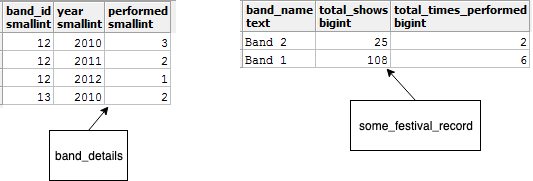
Tabel band_details menyampaikan informasi tentang grup musik; tabel ini berisi pengenal, nama, dan total pertunjukan yang telah mereka lakukan. Di sisi lain, tabel some_festival_record menggambarkan sebuah festival musik hipotetis dan memuat catatan tentang band yang tampil di sana.
Sekarang, misalkan Anda ingin membuat laporan yang memuat nama band, jumlah pertunjukan mereka, dan total berapa kali mereka tampil di festival. Diperlukan INNER join di sini. Anda menjalankan kueri berikut:
select band_name, sum(total_show_count) as total_shows, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name;
Dan kueri tersebut menghasilkan:
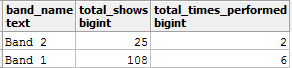
Bukankah nilai total_shows di sini keliru? Karena dari tabel band_details, Anda tahu bahwa Band_1 telah menampilkan total 36 pertunjukan. Lalu apa yang salah di sini? Duplikasi!
Saat menggabungkan kedua tabel, Anda keliru melakukan agregasi pada kolom total_show_count yang menyebabkan duplikasi data pada hasil join perantara. Jika Anda menghapus agregasi dan menyesuaikan kuerinya, Anda akan mendapatkan hasil yang diharapkan:
select band_name, total_show_count, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name, total_show_count;
Sekarang Anda mendapatkan hasil yang diharapkan:
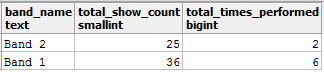
Ada cara lain untuk mencegah duplikasi data, yaitu menambahkan field lain dalam klausa JOIN agar tabel bergabung dengan kondisi yang lebih ketat.
Anda dapat menggunakan berkas .SQL ini untuk menghasilkan tabel yang digunakan di sini beserta nilai yang ditampilkan.
Terima kasih telah membaca tutorial ini. Tutorial ini memperkenalkan Anda pada salah satu langkah paling vital dalam alur analisis data—pembersihan data. Anda melihat berbagai bentuk data berantakan dan cara menanganinya. Namun, ada teknik yang lebih lanjut untuk menangani masalah pembersihan data yang lebih kompleks, dan jika Anda ingin mendalaminya, berikut beberapa kursus DataCamp yang sangat baik untuk Anda ikuti:
Jangan ragu untuk menyampaikan pandangan Anda di bagian Comments.
Kursus SQL
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



