

Dağınık sayılarla ilgili sorunlar ve bunlarla başa çıkma
Şimdi, dağınık verileri temizlemezseniz (yukarıda bahsedilen türler bağlamında) karşılaşabileceğiniz en yaygın sorunlara bakalım.
1. Veri toplulaştırma
Diyelim ki sayısal bir sütunda null kayıtlar var ve bu sütun üzerinde özet istatistikleri (ortalama, maksimum, minimum gibi) hesaplıyorsunuz. Bu durumda sonuçlar doğru şekilde yansıtılmaz. Yine geçersiz sıfır kayıtlarına sahip Pima Indian Diabetes veri kümesini düşünün. Daha önce bahsedilen sütunlarda özet istatistikleri hesaplarsanız doğru sonuçları elde edebilir misiniz? Sonuçlar hatalı olmaz mı? Peki bu sorun nasıl ele alınır? Birkaç yol var:
- Removing the entries containing missing/null values (not recommended)
- Imputing the null entries with a numeric value (typically with mean or median of the respective column)Şimdi bu sorunları ve null değerlerle mücadele için ikinci seçeneği uygulamalı olarak ele alalım.
entries adlı aşağıdaki PostgreSQL tablosunu düşünün:
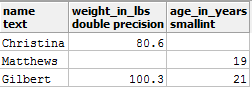
Yukarıdaki tabloda iki null kayıt görebilirsiniz. Diyelim ki bu tablodan ortalama ağırlık değerini almak istiyorsunuz ve aşağıdaki sorguyu çalıştırdınız:
select avg(weight_in_lbs) as average_weight_in_lbs from entries;
Çıktı olarak 90.45 değerini aldınız. Bu doğru mu? Peki ne yapılabilir? COALESCE() fonksiyonundan yararlanarak null kaydı bu ortalama değerle dolduralım.
Önce eksik değerleri COALESCE() ile dolduralım (unutmayın, COALESCE() orijinal tablodaki değerleri değiştirmez, yalnızca değerlerin değiştirilmiş olduğu geçici bir görünüm döndürür):
select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries;
Şu şekilde bir çıktı almalısınız:
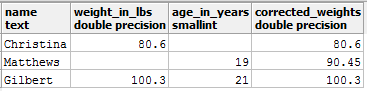
Şimdi tekrar AVG() uygulayabilirsiniz:
select avg(corrected_weights) from
(select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries) as subquery;
Bu sonuç önceki duruma kıyasla çok daha doğrudur. Şimdi, sütun veri türlerindeki uyumsuzluklar varsa ortaya çıkabilecek başka bir sorunu inceleyelim.
2. Tablo birleştirmeleri
student_metadata ve department_details adlı aşağıdaki tablolarla çalıştığınızı düşünün:
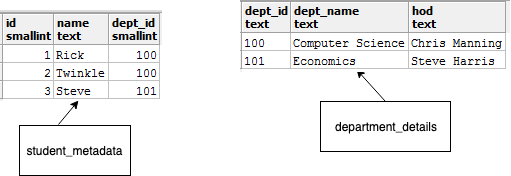
student_mtadata tablosunda dept_id'nin tamsayı türünde, department_details tablosunda ise metin türünde olduğunu görebilirsiniz. Şimdi, bu iki tabloyu birleştirip aşağıdaki sütunları içeren bir rapor üretmek istediğinizi varsayalım:
- id
- name
- dept_name
Bunu yapmak için şu sorguyu çalıştırıyorsunuz:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = d.dept_id;
Ardından şu hatayla karşılaşırsınız:
ERROR: operator does not exist: smallint = text
Bu sorunu betimleyen harika bir infografik (DataCamp'in SQL'de Raporlama kursundan):
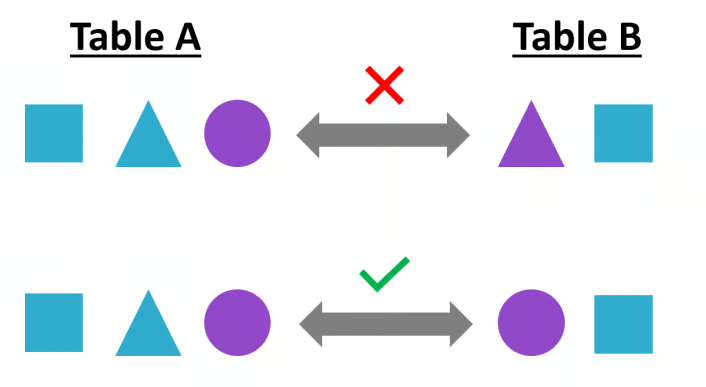
Bu, iki tabloyu birleştirirken veri türleri eşleşmediği için gerçekleşiyor. Burada, tabloları birleştirirken department_details tablosundaki dept_id sütununu tamsayıya CAST edebilirsiniz. Şöyle yapabilirsiniz:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = cast(d.dept_id as smallint);
Ve istediğiniz raporu elde edersiniz:
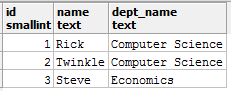
Şimdi, string'lerin nasıl dağınık biçimlerde bulunabileceğini, bunların sorunlarını ve bunlarla başa çıkma yollarını tartışalım.
Dağınık string'ler ve bunları temizleme
String değerler de çok yaygındır. Bu bölüme, student_details adlı bir tablodan alınan, bölüm adlarını ifade eden dept_name sütununun değerlerine bakarak başlayalım:
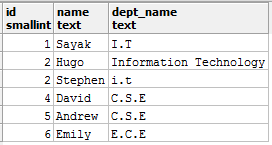
Yukarıdaki gibi string değerler birçok beklenmedik soruna yol açabilir. I.T, Information Technology ve i.t aynı bölümü, yani Information Technology'yi ifade eder ve spesifikasyon belgesinin değerlerin yalnızca I.T olarak bulunmasını gerektirdiğini varsayalım. Şimdi, I.T. bölümüne ait öğrenci sayısını saymak istiyor ve şu sorguyu çalıştırıyorsunuz:
select dept_name, count(dept_name) as student_count
from student_details
group by dept_name;
Ve şu çıktıyı alıyorsunuz:
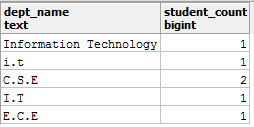
Bu doğru bir rapor mu? - Hayır! Peki bu sorun nasıl giderilir?
Önce sorunu daha ayrıntılı olarak tanımlayalım:
Information Technologydeğeri var ve bununI.T'ye dönüştürülmesi gerekiyor vei.tşeklinde başka bir değer var ve bunun daI.T'ye dönüştürülmesi gerekiyor.
İlk durumda, Information Technology değerini I.T ile REPLACE edebilirsiniz; ikinci durumda ise karakterleri UPPER ile büyük harfe dönüştürürsünüz. Bunu tek bir sorguda başarabilirsiniz; yine de bu tür sorunların adım adım ele alınması tavsiye edilir. Sorunu ele alan sorgu şu şekildedir:
select upper(replace(dept_name, 'Information Technology', 'I.T')) as dept_cleaned,
count(dept_name) as student_count
from student_details
group by dept_cleaned;
Ve rapor:
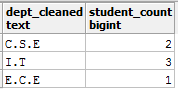
PostgreSQL string fonksiyonları hakkında daha fazlasını buradan okuyabilirsiniz.
Şimdi, date değerlerinin dağınık olabileceği bazı örnekleri ve bunları nasıl temizleyebileceğinizi tartışalım.
Dağınık tarihler ve bunları temizleme
employees adlı bir tabloyla çalıştığınızı ve burada birthdate adlı bir sütun bulunduğunu, ancak uygun bir tarih türünde olmadığını düşünün. Şimdi, DATE_PART() gibi özel date fonksiyonlarıyla sorgular yürütmek istiyorsunuz. birthdate sütununu date türüne CAST etmedikçe bunu yapamazsınız. Bunu uygulamada görelim.
Varsayalım birthdate değerleri YYYY-MM-DD biçimindedir.
employees tablosu şöyle görünüyor:
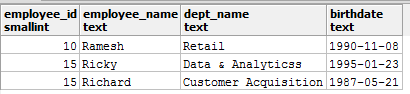
Şimdi, doğum tarihlerinden ayları çıkarmak için aşağıdaki sorguyu çalıştırıyorsunuz:
select date_part('month', birthdate) from employees;
Ve anında şu hatayı alıyorsunuz:
ERROR: function date_part(unknown, text) does not exist
Hatanın yanı sıra çok iyi bir ipucu da alırsınız:
HINT: No function matches the given name and argument types. You might need to add explicit type casts.
İpucunu izleyelim ve doğum tarihini uygun date türüne CAST edip ardından DATE_PART() uygulayalım:
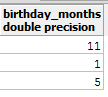
select date_part('month', CAST(birthdate AS date)) as birthday_months from employees;
Şu sonucu almalısınız:
Şimdi bu dersin sonuç bölümünden hemen önce, veri çoğaltmalarının etkilerini ve bunlarla nasıl başa çıkabileceğinizi inceleyeceğiniz bölüme geçelim.
Veri çoğaltmaları: Nedenler, etkiler ve çözümler
Bu bölümde, veri çoğaltmalarına yol açan en yaygın nedenlerden bazılarını inceleyeceksiniz. Ayrıca etkilerini ve bunları önlemek için kullanabileceğiniz bazı yöntemleri göreceksiniz. Aşağıdaki iki tabloyu düşünün: band_details ve some_festival_record:
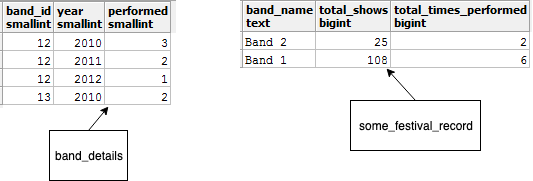
band_details tablosu müzik grupları hakkında bilgi verir; kimliklerini, adlarını ve gerçekleştirdikleri toplam gösteri sayılarını içerir. Öte yandan, some_festival_record tablosu varsayımsal bir müzik festivalini tasvir eder ve orada sahne alan gruplara ilişkin kayıtları içerir.
Şimdi, grup adlarını, gösteri sayılarını ve festivalde kaç kez sahne aldıklarını içeren bir rapor üretmek istediğinizi varsayalım. Burada INNER join gereklidir. Aşağıdaki sorguyu çalıştırıyorsunuz:
select band_name, sum(total_show_count) as total_shows, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name;
Ve sorgu şunu üretir:
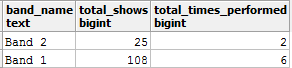
total_shows değerlerinin burada hatalı olduğunu düşünmüyor musunuz? Çünkü band_details tablosundan, Band_1'in toplam 36 gösteri gerçekleştirdiğini biliyorsunuz. Peki burada ne ters gitti? Çoğaltmalar!
İki tabloyu birleştirirken yanlışlıkla total_show_count sütununu toplulaştırdınız ve bu da ara birleştirme sonuçlarında veri çoğaltmasına neden oldu. Toplulaştırmayı kaldırıp sorguyu buna göre düzenlerseniz istenen sonuçları almalısınız:
select band_name, total_show_count, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name, total_show_count;
Beklenen sonuçları şimdi elde edersiniz:
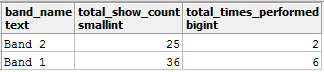
Veri çoğaltmasını önlemenin bir başka yolu da JOIN ifadenize bir başka alan eklemek, böylece tabloların daha sıkı koşullarla birleştirilmesini sağlamaktır.
Burada kullanılan tabloları ve gösterilen değerleri üretmek için bu .SQL dosyasını kullanabilirsiniz.
Daha ileriye taşımak
Bu dersi okuduğunuz için teşekkürler. Derste, veri analizi sürecinin en hayati adımlarından biri olan veri temizleme ile tanıştınız. Farklı türde dağınık veriler ve bunlarla başa çıkma yollarını gördünüz. Ancak, daha karmaşık veri temizleme sorunlarını ele almak için daha gelişmiş teknikler de vardır; bu doğrultuda ilerlemek isterseniz aşağıdaki DataCamp kursları harikadır:
Görüşlerinizi Yorumlar bölümünde paylaşmaktan çekinmeyin.



Gerçek dünya verileri neredeyse her zaman dağınıktır. Bir veri bilimci, veri analisti ya da geliştirici olarak veriler hakkında bilgi edinmeniz gerekiyorsa, bunun için verilerin yeterince derli toplu olmasını sağlamak hayati önem taşır. Aslında derli toplu veri için kapsamlı bir tanım vardır; bununla ilgili daha fazla kaynağı bulmak için şu wiki sayfasına göz atabilirsiniz.
Bu derste, SQL'deki en yaygın veri temizleme tekniklerinden bazılarını uygulayacaksınız. Kendi sahte veri kümenizi oluşturacaksınız, ancak teknikler gerçek dünya verilerine (tablo biçiminde olanlara) da uygulanabilir. Anlatılacak çok şey var. Hadi başlayalım!
Not: Bu derste kullanacağınız RDBMS olan PostgreSQL'de temel SQL sorgularını nasıl yazacağınızı zaten biliyor olmalısınız. Kavramları tazelemeniz gerekiyorsa aşağıdakiler faydalı kaynaklar olabilir:
Farklı veri türleri, dağınık değerleri ve çözümleri
Tablo biçimindeki verilerde en yaygın veri türleri
string,numericveyadate-time'dır. Bu türlerin tümünde dağınık değerlere rastlayabilirsiniz. Şimdi bu türlerin her birini ele alalım ve dağınık değerlere ilişkin örnekler görelim.numerictürüyle başlayalım.Dağınık sayılar
Sayılar çeşitli şekillerde dağınık olabilir. Burada en yaygın olanlarla tanışacaksınız:
İstenmeyen tür/Tür uyumsuzluğu: Üzerinde çalıştığınız bir veri kümesinde
ageadlı bir sütun olduğunu düşünün. Bu sütunda yer alan değerlerinfloattüründe olduğunu görüyorsunuz — örnek değerler 23.0, 45.0, 34.0 vb. Bu durumda,agesütunununfloattüründe olmasına ihtiyacınız yok. Öyle değil mi?Null değerler: Bu, yukarıda belirtilen tüm veri türlerinde yaygın olmakla birlikte, burada null değerlerin anlamı yalnızca değerlerin mevcut olmaması/boş olmasıdır. Ancak null değerler başka biçimlerde de bulunabilir. Örneğin Pima Indian Diabetes veri kümesini ele alın. Veri kümesi, pratikte geçersiz olan
Plasma glucose concentration,Diastolic blood pressuregibi sütunlar için sıfır değerler içerir. Bu geçersiz girdilerle ilgilenmeden veri kümesi üzerinde herhangi bir istatistiksel analiz yaparsanız, analiziniz doğru olmaz.Şimdi bu sorunlardan kaynaklanabilecek problemleri ve bunlarla nasıl başa çıkılacağını inceleyelim.