Kurs
Datenbearbeitung in SQL
4 Std.
335K
Hier sind die häufigsten Probleme, die auftreten, wenn du Daten nicht bereinigst (bezogen auf die oben genannten Typen).
Angenommen, es gibt Null-Einträge in einer numerischen Spalte und du berechnest darauf Kennzahlen wie Mittelwert, Maximum oder Minimum. Die Ergebnisse werden dann nicht korrekt abgebildet. Denke noch einmal an das Pima Indian Diabetes-Dataset mit den ungültigen Nullen. Wenn du Kennzahlen für diese Spalten berechnest, bekommst du dann korrekte Resultate? Sie wären fehlerhaft. Wie gehst du vor? Es gibt mehrere Wege:
- Entfernen der Einträge mit fehlenden/Null-Werten (nicht empfohlen)
- Imputieren der Null-Einträge mit einem numerischen Wert (typischerweise Mittelwert oder Median der jeweiligen Spalte)
Jetzt setzen wir das praktisch um und wählen die zweite Option, um Null-Werte zu behandeln.
Betrachte die folgende PostgreSQL-Tabelle entries:
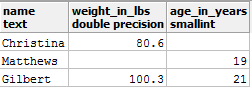
Du siehst zwei Null-Einträge in der Tabelle. Angenommen, du möchtest den durchschnittlichen Wert für das Gewicht berechnen und führst diese Abfrage aus:
select avg(weight_in_lbs) as average_weight_in_lbs from entries;
Als Ergebnis erhältst du 90.45. Ist das korrekt? Was tun? Fülle die Null-Werte mit diesem Durchschnitt – mit der Funktion COALESCE().
Zuerst füllen wir die fehlenden Werte mit COALESCE() (denk daran: COALESCE() ändert die Originaltabelle nicht, sondern liefert nur eine temporäre Sicht mit ersetzten Werten):
select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries;
Du solltest eine Ausgabe wie diese sehen:
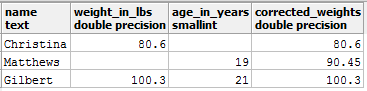
Nun kannst du erneut AVG() anwenden:
select avg(corrected_weights) from
(select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries) as subquery;
Das ist deutlich genauer als zuvor. Als Nächstes sehen wir uns ein Problem an, das durch nicht übereinstimmende Spaltentypen entsteht.
Angenommen, du arbeitest mit den Tabellen student_metadata und department_details:
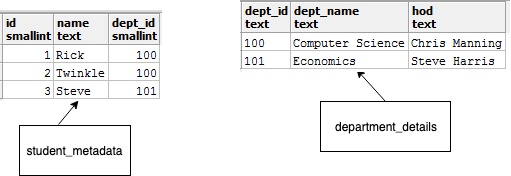
In der Tabelle student_mtadata ist dept_id vom Typ Integer, in department_details hingegen als Text gespeichert. Du möchtest die Tabellen joinen und einen Report mit folgenden Spalten erstellen:
Dazu führst du diese Abfrage aus:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = d.dept_id;
Dann erhältst du diesen Fehler:
ERROR: operator does not exist: smallint = text
Diese Infografik veranschaulicht das Problem perfekt (aus DataCamps Kurs Reporting in SQL):
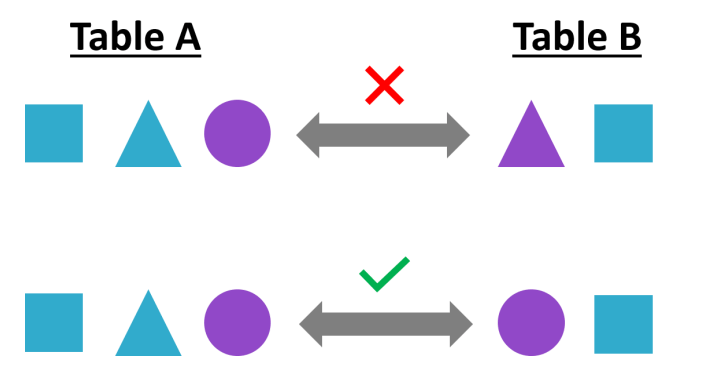
Die Datentypen passen beim Join nicht zusammen. Du kannst die Spalte dept_id in department_details beim Join auf Integer CASTen. So geht’s:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = cast(d.dept_id as smallint);
Und schon bekommst du den gewünschten Report:
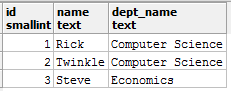
Als Nächstes: Strings – wie sie schmutzig vorliegen können, welche Probleme das macht und wie du sie bereinigst.
Auch String-Werte sind sehr häufig. Schau dir die Werte der Spalte dept_name (Fachbereich) aus der Tabelle student_details an:
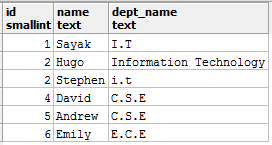
Solche String-Werte sorgen für unerwartete Probleme. I.T, Information Technology und i.t meinen denselben Fachbereich, nämlich Information Technology. Laut Spezifikation sollen die Werte aber als I.T vorliegen. Wenn du nun die Anzahl der Studierenden im Fachbereich I.T. zählen willst und diese Abfrage ausführst:
select dept_name, count(dept_name) as student_count
from student_details
group by dept_name;
Erhältst du Folgendes:
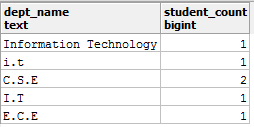
Ist das korrekt? – Nein! Wie behebst du das?
Identifizieren wir das Problem präzise:
Information Technology soll zu I.T werden undi.t soll zu I.T werden.Im ersten Fall kannst du per REPLACE Information Technology durch I.T ersetzen, im zweiten Fall per UPPER großschreiben. Du kannst beides in einer Abfrage erledigen – auch wenn ein schrittweises Vorgehen oft übersichtlicher ist. Hier die kombinierte Variante:
select upper(replace(dept_name, 'Information Technology', 'I.T')) as dept_cleaned,
count(dept_name) as student_count
from student_details
group by dept_cleaned;
Und der Report:
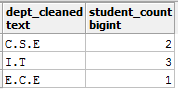
Mehr zu String-Funktionen in PostgreSQL findest du hier.
Nun zu Beispielen, bei denen date-Werte „schmutzig“ sind – und wie du sie bereinigst.
Angenommen, du arbeitest mit einer Tabelle employees, die eine Spalte birthdate enthält, allerdings nicht im passenden Datentyp. Du möchtest Funktionen wie DATE_PART() verwenden. Das geht erst, wenn du birthdate in den Typ date CASTest. Schauen wir es uns an.
Angenommen, die birthdate-Werte liegen im Format YYYY-MM-DD vor.
So sieht die Tabelle employees aus:
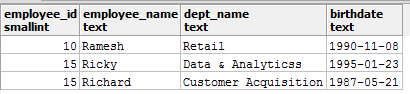
Jetzt extrahierst du die Monate aus den Geburtsdaten:
select date_part('month', birthdate) from employees;
Und erhältst direkt diesen Fehler:
ERROR: function date_part(unknown, text) does not exist
Nützlicher Hinweis inklusive:
HINT: No function matches the given name and argument types. You might need to add explicit type casts.
Folgen wir dem Hinweis und CASTen birthdate zum passenden Typ date, dann wenden wir DATE_PART() an:
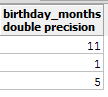
select date_part('month', CAST(birthdate AS date)) as birthday_months from employees;
Das Ergebnis sieht so aus:
Kommen wir zum vorletzten Abschnitt: Duplikate – ihre Ursachen, Auswirkungen und wie du sie in den Griff bekommst.
In diesem Abschnitt siehst du einige häufige Ursachen für Duplikate, ihre Effekte und Strategien zur Vermeidung. Betrachte die Tabellen band_details und some_festival_record:
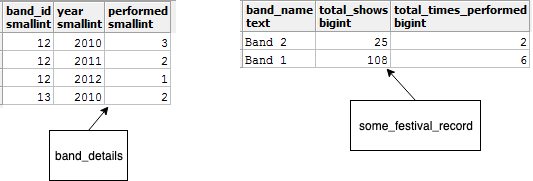
band_details enthält Informationen über Bands: IDs, Namen und die Gesamtzahl ihrer Auftritte. some_festival_record beschreibt ein fiktives Musikfestival und listet, welche Bands dort aufgetreten sind.
Du möchtest nun einen Report mit Bandnamen, ihrer Showanzahl und der Gesamtzahl ihrer Festivalauftritte erstellen. Dafür brauchst du einen INNER Join. Du führst aus:
select band_name, sum(total_show_count) as total_shows, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name;
Die Abfrage liefert:
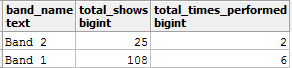
Fallen dir die Werte in total_shows als fehlerhaft auf? In band_details steht, dass Band_1 insgesamt 36 Shows gespielt hat. Was lief schief? Duplikate!
Beim Join hast du versehentlich die Spalte total_show_count aggregiert und dadurch die Werte im Zwischenergebnis dupliziert. Entfernst du die Aggregation und passt die Abfrage an, erhältst du die korrekten Resultate:
select band_name, total_show_count, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name, total_show_count;
Jetzt passt es:
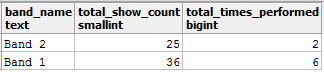
Eine weitere Möglichkeit, Duplikate zu vermeiden: Füge im JOIN eine zusätzliche Bedingung hinzu, damit die Verknüpfung strenger erfolgt.
Mit dieser .SQL-Datei kannst du die hier verwendeten Tabellen samt Beispielwerten erzeugen.
Danke fürs Lesen. Du hast einen der wichtigsten Schritte in der Datenanalyse-Pipeline kennengelernt – die Datenbereinigung. Du hast gesehen, in welchen Formen Daten „schmutzig“ sein können und wie du damit umgehst. Für komplexere Fälle gibt es weiterführende Techniken. Wenn du tiefer einsteigen möchtest, sind das hervorragende DataCamp-Kurse:
Teile gern deine Gedanken im Bereich Comments.
SQL-Kurse
Kurs
Kurs