Curso
Manipulação de dados em SQL
4 h
335.1K
Veja agora os problemas mais comuns que você pode enfrentar se não limpar os dados (considerando os tipos citados acima).
Suponha que você tenha entradas nulas em uma coluna numérica e esteja calculando estatísticas resumidas (média, máximo, mínimo). Os resultados podem não refletir a realidade. Voltando ao dataset Pima Indian Diabetes com zeros inválidos: se você calcular as estatísticas dessas colunas, terá os valores corretos? Os resultados não ficariam errados? Como resolver? Há algumas opções:
- Remover entradas com valores ausentes/nulos (não recomendado)
- Imputar os nulos com um valor numérico (geralmente a média ou mediana da coluna)
Vamos colocar a mão na massa com esses problemas usando a segunda opção para lidar com nulos.
Considere a tabela PostgreSQL chamada entries:
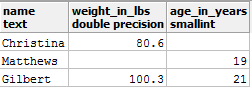
Você vê duas entradas nulas na tabela. Suponha que queira obter o peso médio e execute a consulta:
select avg(weight_in_lbs) as average_weight_in_lbs from entries;
O resultado foi 90.45. Está correto? O que fazer? Vamos preencher os nulos com esse valor médio usando a função COALESCE().
Primeiro, preencha os valores ausentes com COALESCE() (lembre que COALESCE() não altera a tabela original; ele só retorna uma visão temporária com os valores substituídos):
select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries;
Você deve ver algo assim:
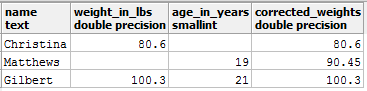
Agora aplique AVG() novamente:
select avg(corrected_weights) from
(select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries) as subquery;
Esse resultado é muito mais fiel do que o anterior. Agora vamos ver outro problema comum quando há incompatibilidades de tipos de dados entre colunas.
Considere as tabelas student_metadata e department_details:
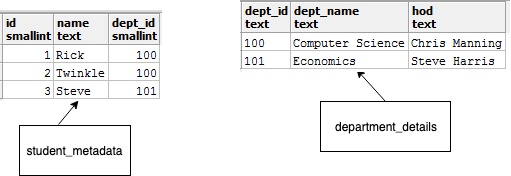
No student_mtadata, dept_id é inteiro; em department_details, é texto. Agora você quer juntar as duas tabelas e gerar um relatório com as colunas:
Para isso, você executa:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = d.dept_id;
Você encontra este erro:
ERROR: operator does not exist: smallint = text
Este infográfico ilustra muito bem o problema (do curso da DataCamp Reporting in SQL):
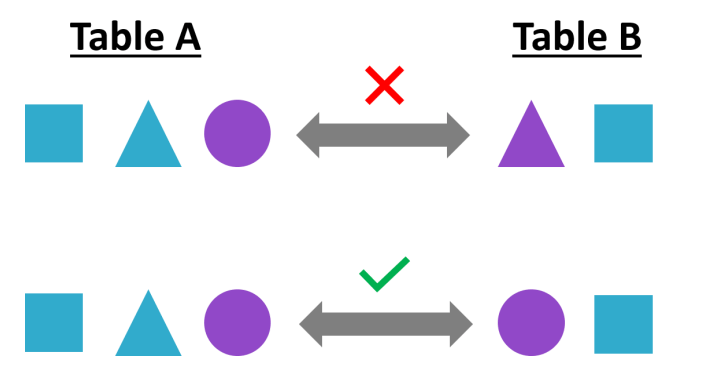
Isso acontece porque os tipos não coincidem na hora da junção. Aqui, você pode fazer CAST da coluna dept_id de department_details para inteiro durante a junção. Assim:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = cast(d.dept_id as smallint);
E você obtém o relatório desejado:
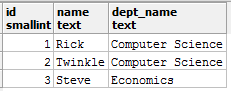
Agora, vamos falar sobre strings em formatos inconsistentes, seus problemas e como tratá-las.
Valores de texto também são muito comuns. Veja os valores da coluna dept_name (nomes de departamentos) de uma tabela chamada student_details:
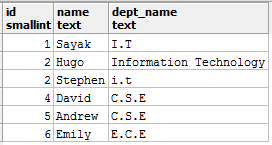
Strings como essas geram vários problemas inesperados. I.T, Information Technology e i.t significam o mesmo departamento, Information Technology, e suponha que a especificação exija o valor como I.T apenas. Agora, se você quiser contar os alunos do departamento I.T. e rodar a consulta:
select dept_name, count(dept_name) as student_count
from student_details
group by dept_name;
Você verá:
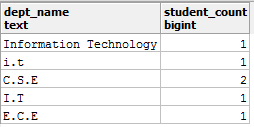
Esse relatório está correto? — Não! Como resolver?
Vamos detalhar o problema:
Information Technology, que deve virar I.T, ei.t, que deve virar I.T.No primeiro caso, use REPLACE para trocar Information Technology por I.T; no segundo, converta para UPPER. Dá para fazer em uma única consulta, embora seja recomendável tratar passo a passo. Veja:
select upper(replace(dept_name, 'Information Technology', 'I.T')) as dept_cleaned,
count(dept_name) as student_count
from student_details
group by dept_cleaned;
E o relatório:
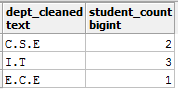
Você pode ler mais sobre funções de strings no PostgreSQL aqui.
Agora, vamos ver exemplos de date problemáticas e como limpá-las.
Imagine uma tabela employees com a coluna birthdate, mas não no tipo de data apropriado. Você quer usar funções de date como DATE_PART(). Não vai conseguir até fazer CAST de birthdate para date. Vamos ver na prática.
Considere birthdate no formato YYYY-MM-DD.
A tabela employees é assim:
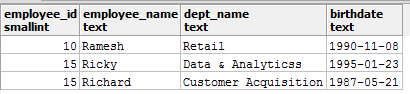
Agora, você executa a consulta para extrair os meses das datas de nascimento:
select date_part('month', birthdate) from employees;
E recebe imediatamente o erro:
ERROR: function date_part(unknown, text) does not exist
Além do erro, vem uma ótima dica:
HINT: No function matches the given name and argument types. You might need to add explicit type casts.
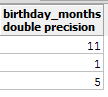
Seguindo a dica, faça CAST de birthdate para date e aplique DATE_PART():
select date_part('month', CAST(birthdate AS date)) as birthday_months from employees;
O resultado será:
Vamos agora para a seção pré-conclusiva, em que você vai estudar os efeitos de duplicações de dados e como evitá-las.
Nesta seção, você verá causas comuns de duplicação de dados, seus efeitos e maneiras de preveni-los. Considere as tabelas band_details e some_festival_record:
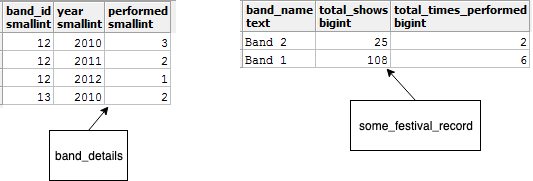
A tabela band_details traz informações sobre bandas: identificadores, nomes e total de shows já realizados. Já some_festival_record representa um festival hipotético e registra as bandas que se apresentaram lá.
Agora, você quer um relatório com os nomes das bandas, seus totais de shows e o número de vezes que tocaram no festival. Aqui é preciso um INNER join. Você roda a consulta:
select band_name, sum(total_show_count) as total_shows, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name;
E obtém:
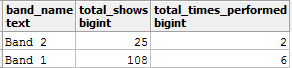
Você não acha que os valores de total_shows estão errados? Pela band_details, Band_1 tem 36 shows no total. O que deu errado? Duplicações!
Ao juntar as tabelas, você somou a coluna total_show_count, o que duplicou dados no resultado intermediário. Removendo essa agregação e ajustando a consulta, você chega ao esperado:
select band_name, total_show_count, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name, total_show_count;
Agora sim, o resultado faz sentido:
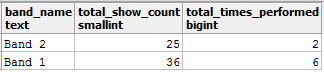
Outra forma de evitar duplicações é adicionar mais um campo na cláusula JOIN, deixando as condições de junção mais restritas.
Você pode usar este arquivo .SQL para gerar as tabelas e valores usados aqui.
Obrigado por acompanhar este tutorial. Aqui você conheceu uma das etapas mais importantes do pipeline de análise de dados: a limpeza de dados. Vimos diferentes formas de dados bagunçados e maneiras de tratá-los. Existem técnicas mais avançadas para problemas mais complexos e, se você quiser se aprofundar, estes cursos da DataCamp são excelentes opções:
Fique à vontade para compartilhar sua opinião na seção de Comentários.
Cursos de SQL
Curso
Curso
Tutorial
DataCamp Team
3 min
Tutorial
Sejal Jaiswal
15 min
Tutorial
DataCamp Team
3 min
Tutorial
Kevin Babitz
13 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
13 min