Cursus
Gegevens manipuleren in SQL
4 uur
338.7K
We bekijken nu de meest voorkomende problemen die je tegenkomt als je rommelige data niet opschoont (m.b.t. de bovengenoemde typen).
Stel dat je null-waarden hebt in een numerieke kolom en je berekent samenvattende statistieken (zoals gemiddelde, maximum, minimum) op die kolom. Dan worden de resultaten niet nauwkeurig weergegeven. Neem opnieuw de dataset Pima Indian Diabetes met ongeldige null-invoer. Als je samenvattende statistieken zou berekenen op de genoemde kolommen, krijg je dan de juiste resultaten? Zullen de uitkomsten niet fout zijn? Hoe pak je dit aan? Er zijn meerdere opties:
- Removing the entries containing missing/null values (not recommended)
- Imputing the null entries with a numeric value (typically with mean or median of the respective column)
Laten we nu praktisch aan de slag gaan met deze problemen en de tweede optie om null-waarden te bestrijden.
Neem de volgende PostgreSQL-tabel entries:
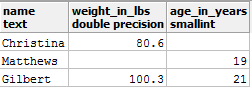
Je ziet twee null-waarden in de tabel hierboven. Stel dat je de gemiddelde waarde van het gewicht uit deze tabel wilt halen en je voert de volgende query uit:
select avg(weight_in_lbs) as average_weight_in_lbs from entries;
Je krijgt 90.45 als output. Klopt dit? Wat kun je doen? Laten we de null-waarde invullen met deze gemiddelde waarde met behulp van de functie COALESCE().
Laten we eerst de missende waarden opvullen met COALESCE() (bedenk dat COALESCE() de waarden in de oorspronkelijke tabel niet wijzigt; het geeft alleen een tijdelijke weergave van de tabel met aangepaste waarden terug):
select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries;
Je zou een output moeten krijgen zoals:
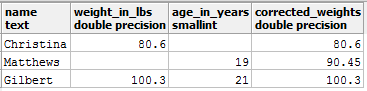
Nu kun je opnieuw AVG() toepassen:
select avg(corrected_weights) from
(select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries) as subquery;
Dit is een veel nauwkeuriger resultaat dan eerder. Laten we nu een ander probleem bekijken dat kan optreden als je kolomdatatypes niet overeenkomen.
Stel dat je werkt met de volgende tabellen student_metadata en department_details:
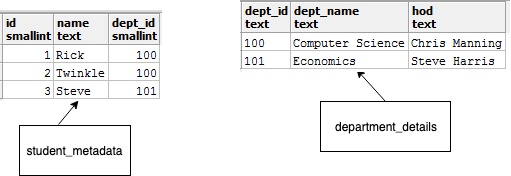
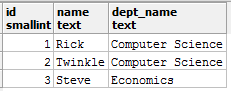
Je ziet dat in de tabel student_mtadata dept_id van het type integer is, en in de tabel department_details is die van het type tekst. Stel nu dat je deze twee tabellen wilt joinen en een rapport wilt maken met de volgende kolommen:
Om dit te doen, voer je deze query uit:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = d.dept_id;
Dan krijg je deze foutmelding:
ERROR: operator does not exist: smallint = text
Hier is een geweldige infographic die dit probleem laat zien (uit DataCamp’s cursus Reporting in SQL):
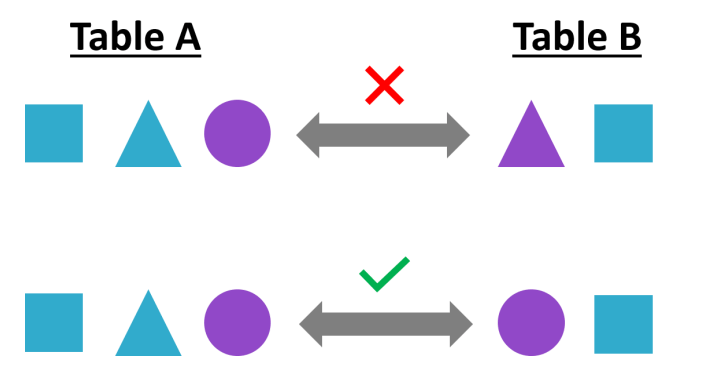
Dit gebeurt omdat de datatypes niet overeenkomen tijdens het joinen van de twee tabellen. Je kunt hier de kolom dept_id in de tabel department_details naar integer CASTen tijdens de join. Zo doe je dat:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = cast(d.dept_id as smallint);
En je krijgt het gewenste rapport:
Laten we nu bespreken hoe strings rommelig kunnen zijn, welke problemen dat geeft en hoe je ze oplost.
Stringwaarden komen ook heel vaak voor. Laten we dit onderdeel beginnen met de waarden van een kolom dept_name (afdelingsnamen) uit een tabel student_details:
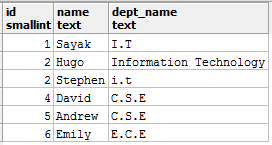
Stringwaarden zoals hierboven kunnen tot allerlei onverwachte problemen leiden. I.T, Information Technology en i.t betekenen allemaal dezelfde afdeling, namelijk Information Technology, en stel dat in de specificatie staat dat de waarden uitsluitend als I.T moeten voorkomen. Stel dat je het aantal studenten in de afdeling I.T. wilt tellen en je voert deze query uit:
select dept_name, count(dept_name) as student_count
from student_details
group by dept_name;
En je krijgt:
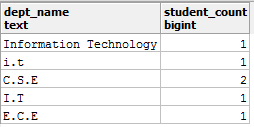
Is dit een nauwkeurig rapport? Nee! Hoe los je dit op?
Laten we het probleem eerst preciezer vaststellen:
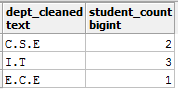
Information Technology als waarde die moet worden omgezet naar I.T eni.t als waarde die moet worden omgezet naar I.T.In het eerste geval kun je de waarde Information Technology REPLACEn door I.T, en in het tweede geval zet je de tekens om naar UPPERcase. Je kunt dit in één query doen, al is het aan te raden dit soort problemen stap voor stap aan te pakken. De query om het op te lossen:
select upper(replace(dept_name, 'Information Technology', 'I.T')) as dept_cleaned,
count(dept_name) as student_count
from student_details
group by dept_cleaned;
En het rapport:
Meer lezen over PostgreSQL-stringfuncties kan hier.
Laten we nu voorbeelden bespreken waarin date-waarden rommelig kunnen zijn en wat je kunt doen om ze op te schonen.
Stel dat je werkt met een tabel employees met een kolom birthdate, maar niet in een geschikt datetype. Je wilt queries draaien met specifieke date-functies zoals DATE_PART(). Dat lukt pas als je de kolom birthdate naar het type date CAST. Laten we dit in de praktijk bekijken.
Ga ervan uit dat de birthdates in het formaat YYYY-MM-DD staan.
Zo ziet de tabel employees eruit:
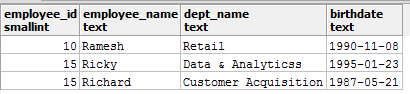
Nu voer je de volgende query uit om de maanden uit de geboortedata te halen:
select date_part('month', birthdate) from employees;
En je krijgt meteen deze foutmelding:
ERROR: function date_part(unknown, text) does not exist
Bij de foutmelding krijg je ook een handige hint:
HINT: No function matches the given name and argument types. You might need to add explicit type casts.
Laten we de hint volgen en birthdate CASTen naar het juiste type date en vervolgens DATE_PART() toepassen:
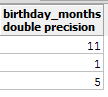
select date_part('month', CAST(birthdate AS date)) as birthday_months from employees;
Je zou dit resultaat moeten krijgen:
Dan nu naar de voorlaatste sectie van deze tutorial, waarin je de effecten van dataduplicatie bestudeert en hoe je die aanpakt.
In deze sectie bekijk je enkele veelvoorkomende oorzaken van dataduplicaties. Je ziet ook de effecten en manieren om ze te voorkomen. Neem de volgende twee tabellen band_details en some_festival_record:
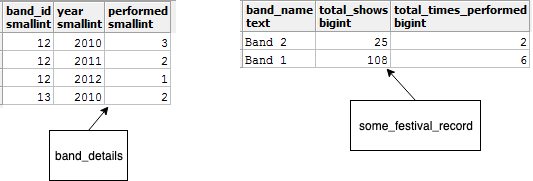
De tabel band_details bevat informatie over bands: hun id’s, namen en het totaal aantal shows dat ze hebben gegeven. De tabel some_festival_record beschrijft een hypothetisch muziekfestival en bevat registraties van bands die daar hebben opgetreden.
Stel nu dat je een rapport wilt maken met bandnaam, hun aantal shows en het aantal keer dat ze op het festival hebben opgetreden. Hier heb je een INNER join nodig. Je draait de volgende query:
select band_name, sum(total_show_count) as total_shows, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name;
En de query levert op:
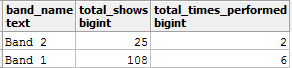
Vind je de waarden van total_shows hier niet foutief? Want uit de tabel band_details weet je dat Band_1 in totaal 36 shows heeft gegeven. Wat ging er mis? Duplicaten!
Tijdens het joinen heb je per ongeluk de kolom total_show_count geaggregeerd, waardoor in de tussenliggende joinresultaten dataduplicatie ontstond. Als je de aggregatie weglaat en de query aanpast, krijg je de gewenste resultaten:
select band_name, total_show_count, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name, total_show_count;
Nu krijg je de verwachte resultaten:
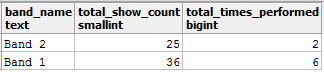
Er is nog een manier om dataduplicatie te voorkomen: voeg een extra veld toe aan je JOIN-clausule zodat de tabellen onder strengere voorwaarden worden gejoined.
Je kunt dit .SQL-bestand gebruiken om de hier gebruikte tabellen en waarden te genereren.
Bedankt voor het lezen van deze tutorial. Je maakte kennis met een van de belangrijkste stappen in de data-analysepipeline: data opschonen. Je zag verschillende vormen van rommelige data en manieren om die aan te pakken. Er zijn echter meer geavanceerde technieken voor complexere problemen. Als je daarmee verder wilt, zijn dit uitstekende DataCamp-cursussen:
Deel gerust je mening in de Comments-sectie.
SQL-cursussen
Cursus
Cursus
blog
Adel Nehme
15 min

