Cours
Manipulation de données en SQL
4 h
335.2K
Voici désormais les problèmes les plus courants si vous ne nettoyez pas les données (selon les cas évoqués plus haut).
Supposons que vous ayez des entrées nulles dans une colonne numérique et que vous calculiez des statistiques descriptives (moyenne, maximum, minimum). Les résultats ne seront pas fidèles. Reprenons le jeu de données Pima Indian Diabetes et ses zéros invalides : si vous calculez des statistiques sur ces colonnes, obtiendrez-vous des résultats corrects ? Ne seront-ils pas erronés ? Comment corriger cela ? Plusieurs approches existent :
- Supprimer les entrées contenant des valeurs manquantes/nulles (déconseillé)
- Imputer les valeurs nulles avec un nombre (typiquement la moyenne ou la médiane de la colonne)
Mettons-nous en pratique avec la seconde option pour gérer les nulls.
Considérez la table PostgreSQL suivante, nommée entries :
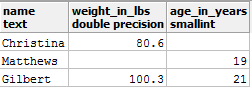
Vous voyez deux valeurs nulles dans la table. Supposons que vous souhaitiez obtenir le poids moyen et que vous exécutiez la requête suivante :
select avg(weight_in_lbs) as average_weight_in_lbs from entries;
Vous obtenez 90.45. Est-ce correct ? Que faire alors ? Remplissons les valeurs nulles avec cette moyenne grâce à la fonction COALESCE().
Commençons par renseigner temporairement les valeurs manquantes avec COALESCE() (rappelez-vous : COALESCE() ne modifie pas la table source, il renvoie une vue temporaire avec les valeurs remplacées) :
select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries;
Vous devriez obtenir :
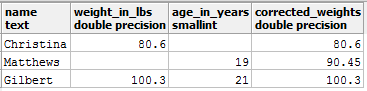
Appliquez maintenant AVG() à ces valeurs corrigées :
select avg(corrected_weights) from
(select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries) as subquery;
Le résultat est bien plus pertinent que le précédent. Passons à un autre problème : les incohérences de types entre colonnes.
Imaginons que vous travailliez avec les tables student_metadata et department_details :
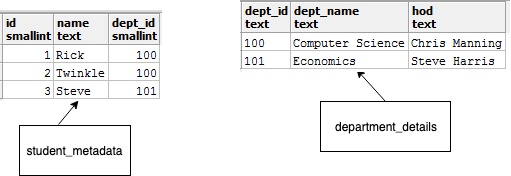
Dans student_mtadata, dept_id est de type entier, tandis que dans department_details il est de type texte. Vous souhaitez joindre ces deux tables pour produire un rapport avec les colonnes suivantes :
Vous lancez :
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = d.dept_id;
Vous obtenez alors l’erreur :
ERROR: operator does not exist: smallint = text
Voici une excellente infographie illustrant ce problème (extrait du cours de DataCamp Reporting in SQL) :
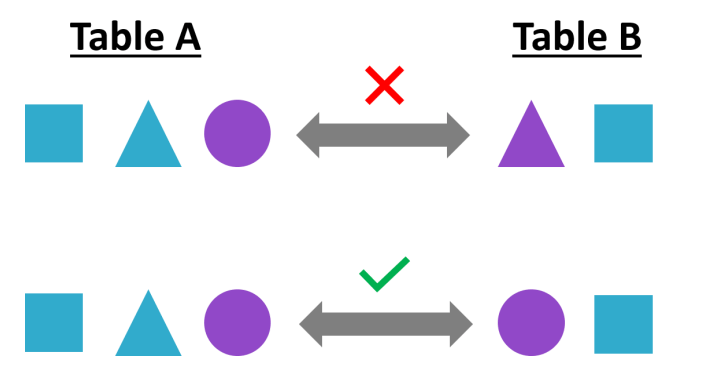
Cela se produit car les types ne correspondent pas lors de la jointure. Ici, vous pouvez CAST la colonne dept_id de department_details en entier au moment de la jointure. Par exemple :
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = cast(d.dept_id as smallint);
Et vous obtenez le rapport attendu :
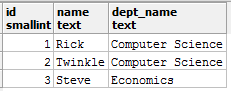
Passons maintenant aux chaînes de caractères : leurs écueils, et comment les nettoyer.
Les chaînes de caractères sont omniprésentes. Observons les valeurs d’une colonne dept_name (noms de départements) dans une table student_details :
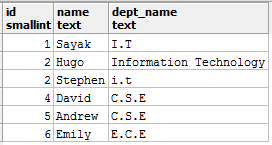
Des valeurs comme ci-dessus peuvent créer de nombreuses surprises. I.T, Information Technology et i.t désignent le même département, à savoir Information Technology. Supposons que le cahier des charges impose le format I.T uniquement. Si vous souhaitez compter le nombre d’étudiants du département I.T. et lancez cette requête :
select dept_name, count(dept_name) as student_count
from student_details
group by dept_name;
Vous obtenez :
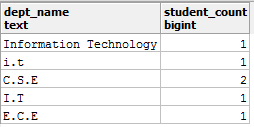
Ce rapport est-il correct ? — Non. Comment corriger ?
Identifions précisément le problème :
Information Technology doit être converti en I.T eti.t doit aussi devenir I.T.Dans le premier cas, utilisez REPLACE pour remplacer Information Technology par I.T, et dans le second, convertissez en UPPER pour uniformiser la casse. Vous pouvez tout faire en une seule requête, même s’il est souvent préférable d’avancer étape par étape. Par exemple :
select upper(replace(dept_name, 'Information Technology', 'I.T')) as dept_cleaned,
count(dept_name) as student_count
from student_details
group by dept_cleaned;
Et le rapport devient :
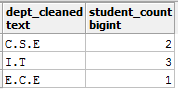
Vous trouverez plus d’informations sur les fonctions de chaînes PostgreSQL ici.
Voyons maintenant des exemples de dates « sales » et comment les nettoyer.
Supposons que vous travailliez avec une table employees contenant une colonne birthdate, mais stockée avec un type inadapté. Vous souhaitez utiliser des fonctions dédiées au type date comme DATE_PART(). Impossible tant que vous n’aurez pas CAST la colonne birthdate en type date. Voyons cela.
Supposons que les birthdate soient au format YYYY-MM-DD.
Voici la table employees :
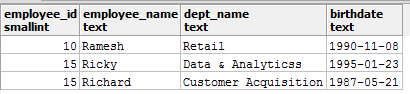
Vous exécutez la requête suivante pour extraire le mois de naissance :
select date_part('month', birthdate) from employees;
Et vous obtenez aussitôt cette erreur :
ERROR: function date_part(unknown, text) does not exist
Avec un indice précieux :
HINT: No function matches the given name and argument types. You might need to add explicit type casts.
Suivons l’indication et CASTons birthdate vers le type date, puis appliquons DATE_PART() :
select date_part('month', CAST(birthdate AS date)) as birthday_months from employees;
Vous devriez obtenir :
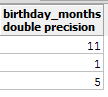
Passons à l’avant-dernière section : l’impact des doublons et comment les éviter.
Vous allez voir des causes fréquentes de duplication de données, leurs effets et des moyens de prévention. Considérez les tables band_details et some_festival_record :
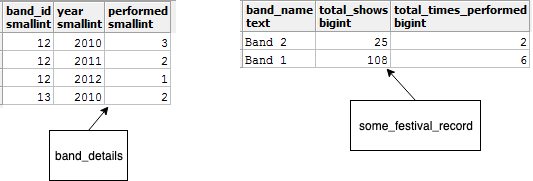
La table band_details décrit des groupes de musique : identifiants, noms, et nombre total de concerts. La table some_festival_record recense les groupes ayant joué lors d’un festival hypothétique.
Vous souhaitez produire un rapport listant le nom des groupes, leur nombre total de concerts et le nombre de fois où ils ont joué au festival. Une jointure INNER est nécessaire. Vous lancez :
select band_name, sum(total_show_count) as total_shows, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name;
La requête renvoie :
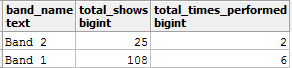
Ne trouvez-vous pas que les valeurs de total_shows sont fausses ? Car d’après band_details, Band_1 a donné 36 concerts au total. Que s’est-il passé ? Des doublons !
En joignant les tables, vous avez agrégé la colonne total_show_count, ce qui a dupliqué la donnée dans le résultat intermédiaire. Supprimez cette agrégation et adaptez la requête pour obtenir le bon résultat :
select band_name, total_show_count, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name, total_show_count;
Vous obtenez maintenant le résultat attendu :
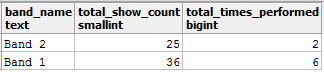
Autre façon d’éviter les duplications : ajouter un critère supplémentaire dans la clause JOIN pour renforcer les conditions de jointure.
Vous pouvez utiliser ce fichier .SQL pour générer les tables et valeurs utilisées ici.
Merci d’avoir suivi ce tutoriel. Vous avez découvert l’une des étapes clés d’un projet d’analyse de données : le nettoyage des données. Vous avez vu plusieurs formes de données « sales » et des façons de les traiter. Il existe toutefois des techniques plus avancées pour des cas plus complexes. Pour progresser, voici d’excellents cours DataCamp :
N’hésitez pas à partager vos avis dans la section Comments.
Cours SQL
Cours
Cours