Corso
Manipolazione dei dati in SQL
4 ore
338.8K
Vediamo ora i problemi più comuni che potresti incontrare se non pulisci i dati disordinati (rispetto ai tipi menzionati sopra).
Supponi di avere voci null per una colonna numerica e di calcolare statistiche descrittive (come media, massimo, minimo) su quella colonna. In questo caso i risultati non verranno rappresentati accuratamente. Considera di nuovo il dataset Pima Indian Diabetes con le voci zero non valide. Se calcolassi le statistiche sulle colonne come detto prima, otterresti i risultati giusti? I risultati non sarebbero errati? Come affrontare questo problema? Ci sono vari modi:
- Removing the entries containing missing/null values (not recommended)
- Imputing the null entries with a numeric value (typically with mean or median of the respective column)
Passiamo ora alla pratica con questi problemi e con la seconda opzione per combattere i valori null.
Considera la seguente tabella PostgreSQL chiamata entries:
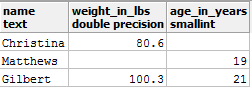
Nel prospetto sopra vedi due voci null. Supponi di voler ottenere il valore medio del peso da questa tabella ed esegui la seguente query:
select avg(weight_in_lbs) as average_weight_in_lbs from entries;
Ottieni 90.45 come output. È corretto? Cosa si può fare? Riempiamo la voce null con questo valore medio usando la funzione COALESCE().
Riempiamo prima i valori mancanti con COALESCE() (ricorda che COALESCE() non modifica i valori nella tabella originale, restituisce solo una vista temporanea della tabella con i valori cambiati):
select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries;
Dovresti ottenere un output come:
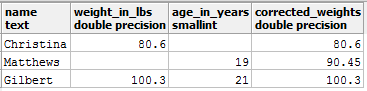
Ora puoi applicare di nuovo AVG():
select avg(corrected_weights) from
(select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries) as subquery;
Questo è un risultato molto più accurato rispetto al precedente. Vediamo ora un altro problema che può verificarsi se ci sono incongruenze nei tipi di dato delle colonne.
Immagina di lavorare con le seguenti tabelle student_metadata e department_details:
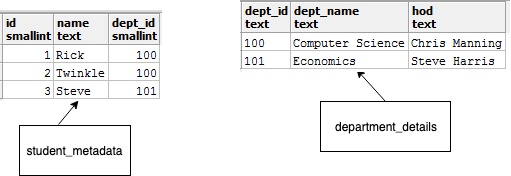
Nella tabella student_mtadata, dept_id è di tipo intero, mentre nella tabella department_details è di tipo testo. Ora, supponi di voler unire queste due tabelle e produrre un report che contenga le seguenti colonne:
Per farlo, esegui questa query:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = d.dept_id;
Incontri quindi questo errore:
ERROR: operator does not exist: smallint = text
Ecco un'infografica molto chiara che illustra il problema (dal corso di DataCamp Reporting in SQL):
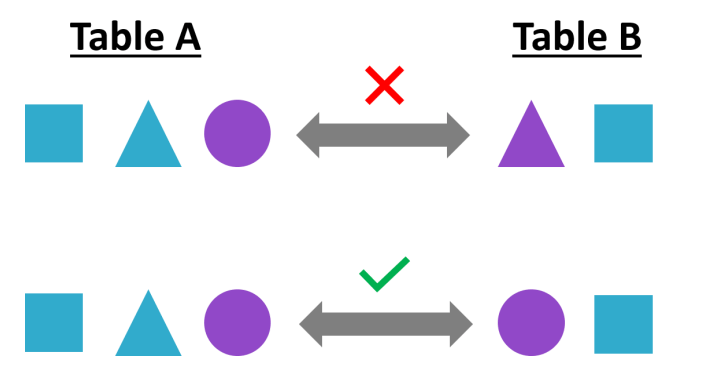
Questo accade perché i tipi di dato non corrispondono durante il join delle due tabelle. Qui puoi fare il CAST della colonna dept_id nella tabella department_details a intero mentre unisci le tabelle. Ecco come farlo:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = cast(d.dept_id as smallint);
E ottieni il report desiderato:
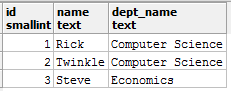
Passiamo ora a come le stringhe possano presentarsi in forme disordinate, ai relativi problemi e a come affrontarli.
I valori di tipo stringa sono anch'essi molto comuni. Iniziamo questa sezione osservando i valori di una colonna dept_name (che indica i nomi dei reparti) tratta da una tabella chiamata student_details:
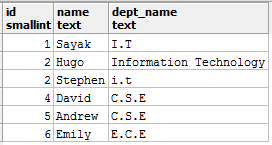
Valori stringa come quelli sopra possono causare molti problemi imprevisti. I.T, Information Technology e i.t indicano tutti lo stesso reparto, cioè Information Technology, e supponi che il documento di specifica richieda che i valori siano presenti solo come I.T. Ora, diciamo che vuoi contare il numero di studenti appartenenti al reparto I.T. ed esegui questa query:
select dept_name, count(dept_name) as student_count
from student_details
group by dept_name;
E ottieni:
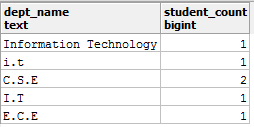
È un report accurato? No! Come puoi risolvere questo problema?
Identifichiamo prima il problema in modo più dettagliato:
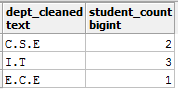
Information Technology come valore che dovrebbe essere convertito in I.T ei.t come altro valore che dovrebbe essere convertito in I.T.Nel primo caso puoi REPLACE il valore Information Technology con I.T, e nel secondo caso converti i caratteri in maiuscolo con UPPER. Puoi ottenere tutto in un'unica query, anche se è consigliabile affrontare questo tipo di problemi passo dopo passo. Ecco la query per risolvere il problema:
select upper(replace(dept_name, 'Information Technology', 'I.T')) as dept_cleaned,
count(dept_name) as student_count
from student_details
group by dept_cleaned;
E il report:
Puoi leggere di più sulle funzioni per le stringhe in PostgreSQL qui.
Passiamo ora a qualche esempio di come i valori date possano essere disordinati e cosa puoi fare per ripulirli.
Immagina di lavorare con una tabella chiamata employees che contiene una colonna birthdate ma non con un tipo date appropriato. Ora vuoi eseguire query con funzioni dedicate alle date come DATE_PART(). Non potrai farlo finché non esegui il CAST della colonna birthdate al tipo date. Vediamolo in azione.
Considera che le birthdate siano nel formato YYYY-MM-DD.
Ecco com'è la tabella employees:
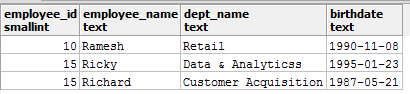
Ora esegui la seguente query per estrarre i mesi dalle date di nascita:
select date_part('month', birthdate) from employees;
E ottieni subito questo errore:
ERROR: function date_part(unknown, text) does not exist
Insieme all'errore, ricevi anche un ottimo suggerimento:
HINT: No function matches the given name and argument types. You might need to add explicit type casts.
Seguiamo il suggerimento ed eseguiamo il CAST di birthdate al tipo date appropriato, quindi applichiamo DATE_PART():
select date_part('month', CAST(birthdate AS date)) as birthday_months from employees;
Dovresti ottenere il risultato:
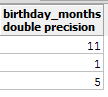
Procediamo ora alla sezione pre-conclusiva di questo tutorial, in cui studierai gli effetti delle duplicazioni di dati e come gestirle.
In questa sezione studierai alcune delle cause più comuni che portano a duplicazioni di dati. Vedrai anche i loro effetti e alcuni modi per prevenirle. Considera le seguenti due tabelle band_details e some_festival_record:
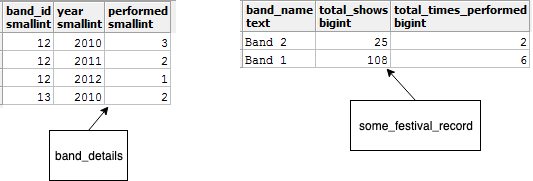
La tabella band_details riporta informazioni sulle band musicali: contiene i loro identificativi, i nomi e il numero totale di spettacoli effettuati. La tabella some_festival_record, invece, rappresenta un ipotetico festival musicale e contiene i record delle band che vi hanno suonato.
Ora, supponi di voler produrre un report che contenga i nomi delle band, il conteggio dei loro spettacoli e il numero totale di volte in cui hanno suonato al festival. Qui serve un INNER join. Esegui la seguente query:
select band_name, sum(total_show_count) as total_shows, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name;
E la query produce:
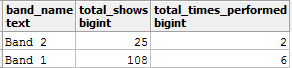
Non pensi che i valori di total_shows siano errati qui? Perché dalla tabella band_details sai che Band_1 ha effettuato in totale 36 spettacoli. Allora cos'è andato storto? Duplicati!
Unendo le due tabelle, hai aggregato per errore la colonna total_show_count, causando una duplicazione dei dati nei risultati intermedi del join. Se rimuovi l'aggregazione e modifichi la query di conseguenza, dovresti ottenere i risultati desiderati:
select band_name, total_show_count, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name, total_show_count;
Ora ottieni i risultati attesi:
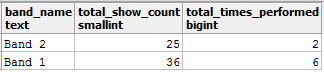
C'è un altro modo per prevenire la duplicazione dei dati, cioè aggiungere un altro campo nella clausola JOIN in modo che le tabelle vengano unite con condizioni più restrittive.
Puoi usare questo file .SQL per generare le tabelle usate qui e anche i valori mostrati.
Grazie per aver letto questo tutorial. Ti ha introdotto a uno dei passaggi più importanti nella pipeline di analisi dei dati: la pulizia dei dati. Hai visto diverse forme di dati disordinati e come affrontarle. Esistono però tecniche più avanzate per gestire problemi di pulizia più complessi e, se vuoi approfondire, di seguito trovi alcuni eccellenti corsi DataCamp che puoi seguire:
Sentiti libero di condividere le tue opinioni nella sezione Comments.
Corsi SQL
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



