Curso
Manipulación de datos en SQL
4 h
335.5K
Veamos los problemas más comunes si no limpias los datos (respecto a los casos anteriores).
Supón que tienes valores nulos en una columna numérica y calculas estadísticas descriptivas (media, máximo, mínimo) sobre ella. Los resultados no representarán bien la realidad. Volviendo al conjunto Pima Indian Diabetes con entradas inválidas de ceros: si calculas estadísticas en esas columnas sin tratarlas, ¿obtendrás resultados correctos? ¿No saldrán sesgados? ¿Cómo lo solucionas? Hay varias opciones:
- Eliminar las entradas con valores ausentes/nulos (no recomendado)
- Imputar los nulos con un valor numérico (típicamente la media o la mediana de la columna)
Pasemos a la práctica con el segundo enfoque para combatir los nulos.
Considera la siguiente tabla de PostgreSQL llamada entries:
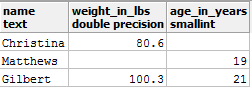
Ves dos valores nulos en la tabla. Supón que quieres obtener el peso medio y ejecutas esta consulta:
select avg(weight_in_lbs) as average_weight_in_lbs from entries;
Obtienes 90.45 como resultado. ¿Es correcto? ¿Qué puedes hacer? Rellena los nulos con ese valor medio usando la función COALESCE().
Primero, completa los valores que faltan con COALESCE() (recuerda que COALESCE() no cambia la tabla original; devuelve una vista temporal con los valores sustituidos):
select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries;
Deberías ver algo así:
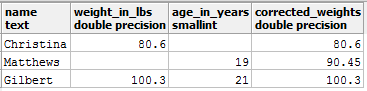
Ahora aplica de nuevo AVG():
select avg(corrected_weights) from
(select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries) as subquery;
Este resultado es mucho más preciso que el anterior. Veamos ahora otro problema cuando hay desajustes en los tipos de las columnas.
Imagina que trabajas con las tablas student_metadata y department_details:
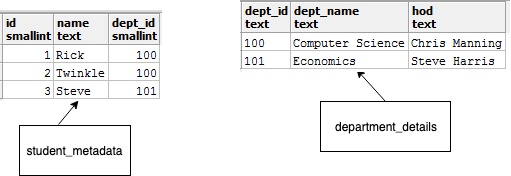
En student_mtadata, dept_id es entero, mientras que en department_details es texto. Si unes ambas para generar un informe con estas columnas:
y ejecutas esta consulta:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = d.dept_id;
Te encontrarás con este error:
ERROR: operator does not exist: smallint = text
Este infográfico lo ilustra muy bien (del curso de DataCamp Reporting in SQL):
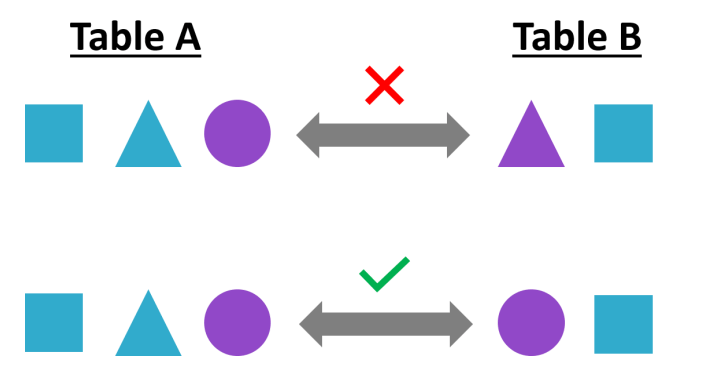
Ocurre porque los tipos no coinciden al unir. Aquí puedes hacer CAST de dept_id en department_details a entero durante el join. Así:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = cast(d.dept_id as smallint);
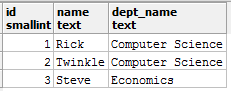
Y obtendrás el informe deseado:
Pasemos a cómo tratar cadenas desordenadas, sus problemas y soluciones.
Los valores de texto también son muy comunes. Empecemos viendo los valores de una columna dept_name (nombres de departamento) de la tabla student_details:
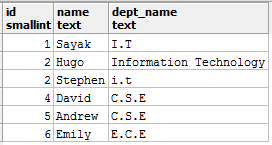
Textos como estos dan muchos quebraderos de cabeza. I.T, Information Technology e i.t significan lo mismo, Information Technology, y el documento de especificación exige que el valor sea I.T. Ahora bien, si quieres contar estudiantes del departamento I.T. y ejecutas:
select dept_name, count(dept_name) as student_count
from student_details
group by dept_name;
Obtienes:
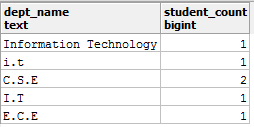
¿Es un informe correcto? ¡No! ¿Cómo lo arreglas?
Desgranemos el problema:
Information Technology, que debería convertirse en I.T, yi.t, que debería convertirse en I.T.En el primer caso, puedes REPLACE Information Technology por I.T, y en el segundo, convertir a UPPER. Puedes hacerlo en una sola consulta (aunque es mejor ir paso a paso):
select upper(replace(dept_name, 'Information Technology', 'I.T')) as dept_cleaned,
count(dept_name) as student_count
from student_details
group by dept_cleaned;
Y el informe:
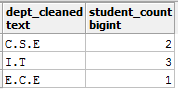
Puedes leer más sobre funciones de texto en PostgreSQL aquí.
Ahora veamos ejemplos de date desordenadas y cómo limpiarlas.
Imagina que trabajas con una tabla employees que contiene una columna birthdate, pero no con el tipo fecha adecuado. Quieres ejecutar funciones de date como DATE_PART(). No podrás hacerlo hasta que hagas CAST de birthdate a tipo date. Veámoslo.
Supón que los birthdate están en formato YYYY-MM-DD.
Así es la tabla employees:
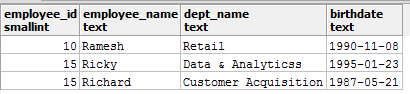
Ahora ejecutas esta consulta para extraer el mes:
select date_part('month', birthdate) from employees;
Y aparece el error:
ERROR: function date_part(unknown, text) does not exist
Junto con una pista muy útil:
HINT: No function matches the given name and argument types. You might need to add explicit type casts.
Sigue la pista y haz CAST de birthdate a date antes de aplicar DATE_PART():
select date_part('month', CAST(birthdate AS date)) as birthday_months from employees;
Deberías obtener:
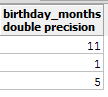
Pasemos a la sección previa a la conclusión, donde verás los efectos de las duplicidades y cómo afrontarlas.
En esta sección revisarás causas habituales de duplicación de datos, sus efectos y algunas formas de prevenirla. Considera las tablas band_details y some_festival_record:
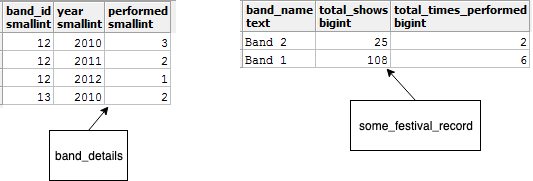
band_details contiene información sobre bandas (identificador, nombre y número total de conciertos). some_festival_record recoge, de forma hipotética, las actuaciones de esas bandas en un festival.
Ahora quieres un informe con nombre de la banda, su número total de conciertos y cuántas veces actuaron en el festival. Aquí necesitas un INNER join. Ejecutas:
select band_name, sum(total_show_count) as total_shows, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name;
Y la consulta produce:
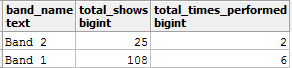
¿No te parecen erróneos los valores de total_shows? Porque en band_details sabes que Band_1 tiene 36 conciertos en total. ¿Qué ha pasado? ¡Duplicados!
Al unir ambas tablas agregaste por error la columna total_show_count, lo que duplicó datos en el resultado intermedio del join. Si quitas esa agregación y ajustas la consulta, obtendrás lo correcto:
select band_name, total_show_count, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name, total_show_count;
Ahora sí obtienes lo esperado:
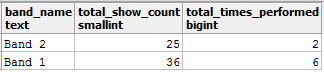
Otra forma de evitar la duplicación es añadir otro campo en la cláusula JOIN para unir con condiciones más estrictas.
Puedes usar este archivo .SQL para generar las tablas y valores mostrados.
Gracias por leer este tutorial. Te hemos introducido en uno de los pasos clave del pipeline analítico: la limpieza de datos. Has visto distintas formas de datos desordenados y cómo tratarlas. Existen técnicas más avanzadas para problemas más complejos; si te interesa profundizar, estos cursos de DataCamp son un excelente siguiente paso:
No dudes en dejar tus opiniones en la sección de Comments.
Cursos de SQL
Curso
Curso
blog
Tim Lu
12 min
Tutorial
Sejal Jaiswal
15 min
Tutorial
DataCamp Team
3 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Allan Ouko
9 min