Khóa học
Xử lý dữ liệu trong SQL
4 giờ
338.8K
Giờ hãy xem những vấn đề thường gặp nhất nếu bạn không làm sạch dữ liệu lộn xộn (theo các loại đã nêu ở trên).
Giả sử bạn có các mục nhập null cho một cột số và bạn đang tính các thống kê tóm tắt (như trung bình, lớn nhất, nhỏ nhất) trên cột đó. Kết quả sẽ không được phản ánh chính xác trong trường hợp này. Một lần nữa, hãy xem xét tập dữ liệu Pima Indian Diabetes với các mục nhập bằng 0 không hợp lệ. Nếu bạn tính các thống kê tóm tắt trên các cột như đã nói, liệu bạn có nhận được kết quả đúng không? Kết quả chẳng phải sẽ sai lệch sao? Vậy xử lý thế nào? Có một số cách:
- Removing the entries containing missing/null values (not recommended)
- Imputing the null entries with a numeric value (typically with mean or median of the respective column)
Giờ hãy thực hành với các vấn đề này và lựa chọn thứ hai để đối phó với giá trị null.
Xét bảng PostgreSQL sau có tên entries:
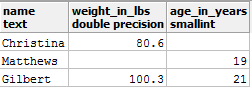
Bạn có thể thấy hai mục null trong bảng trên. Giả sử bạn muốn lấy giá trị cân nặng trung bình từ bảng này và bạn đã chạy truy vấn sau:
select avg(weight_in_lbs) as average_weight_in_lbs from entries;
Bạn nhận được 90.45 làm đầu ra. Điều này có đúng không? Vậy có thể làm gì? Hãy điền giá trị null bằng giá trị trung bình này với sự trợ giúp của hàm COALESCE().
Hãy điền các giá trị thiếu trước bằng COALESCE() (nhớ rằng COALESCE() không thay đổi giá trị trong bảng gốc, nó chỉ trả về một chế độ xem tạm thời của bảng với các giá trị đã được thay đổi):
select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries;
Bạn sẽ nhận được đầu ra như sau:
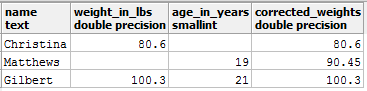
Giờ bạn có thể áp dụng lại AVG():
select avg(corrected_weights) from
(select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries) as subquery;
Đây là kết quả chính xác hơn nhiều so với trước đó. Giờ hãy nghiên cứu một vấn đề khác có thể xảy ra nếu bạn có sự không khớp về kiểu dữ liệu của cột.
Giả sử bạn đang làm việc với các bảng sau: student_metadata và department_details:
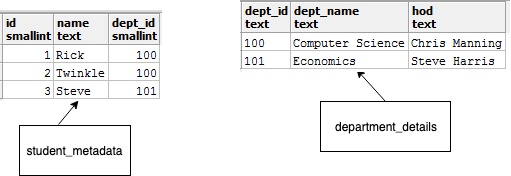
Bạn có thể thấy trong bảng student_mtadata, dept_id thuộc kiểu số nguyên, còn trong bảng department_details, nó đang ở kiểu văn bản. Giờ, giả sử bạn muốn nối hai bảng này và tạo một báo cáo chứa các cột sau:
Để làm điều này, bạn chạy truy vấn sau:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = d.dept_id;
Bạn sẽ gặp lỗi này:
ERROR: operator does not exist: smallint = text
Dưới đây là một đồ họa thông tin minh họa vấn đề này (từ khóa học Reporting in SQL của DataCamp):
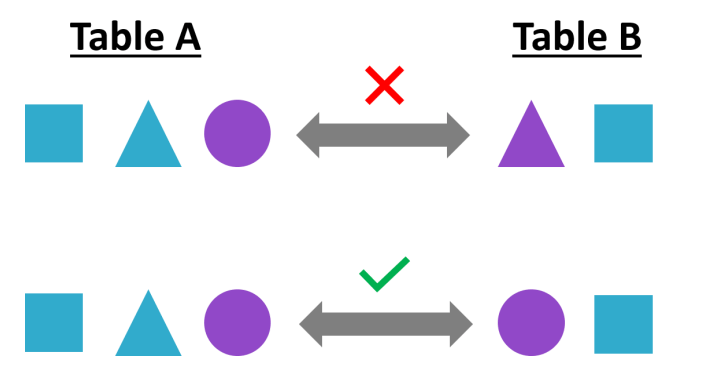
Điều này xảy ra vì kiểu dữ liệu không khớp khi nối hai bảng. Ở đây, bạn có thể CAST cột dept_id trong bảng department_details sang kiểu số nguyên khi nối các bảng. Cách thực hiện như sau:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = cast(d.dept_id as smallint);
Và bạn sẽ nhận được báo cáo mong muốn:
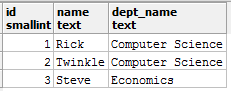
Giờ hãy thảo luận cách chuỗi có thể ở dạng lộn xộn, các vấn đề của chúng và cách xử lý.
Giá trị chuỗi cũng rất phổ biến. Bắt đầu phần này bằng cách xem các giá trị của một cột dept_name (chỉ tên khoa/phòng) lấy từ bảng student_details:
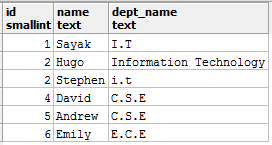
Những giá trị chuỗi như trên có thể gây ra nhiều vấn đề ngoài dự kiến. I.T, Information Technology và i.t đều chỉ cùng một khoa, tức là Information Technology và giả sử tài liệu đặc tả yêu cầu các giá trị chỉ được ghi là I.T. Giờ, bạn muốn đếm số sinh viên thuộc khoa I.T., và bạn chạy truy vấn sau:
select dept_name, count(dept_name) as student_count
from student_details
group by dept_name;
Và bạn nhận được:
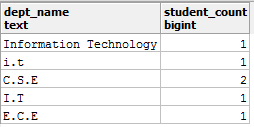
Đây có phải báo cáo chính xác không? - Không! Vậy xử lý vấn đề này thế nào?
Trước hết, hãy xác định vấn đề chi tiết hơn:
Information Technology cần được chuyển thành I.T vài.t cần được chuyển thành I.T.Trong trường hợp đầu, bạn có thể REPLACE giá trị Information Technology thành I.T, và trong trường hợp thứ hai, bạn chuyển ký tự thành chữ UPPER. Bạn có thể thực hiện điều này trong một truy vấn, dù khuyến nghị xử lý các vấn đề kiểu này theo từng bước. Đây là truy vấn để xử lý vấn đề:
select upper(replace(dept_name, 'Information Technology', 'I.T')) as dept_cleaned,
count(dept_name) as student_count
from student_details
group by dept_cleaned;
Và báo cáo:
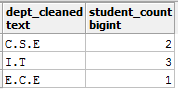
Bạn có thể đọc thêm về các hàm chuỗi của PostgreSQL tại đây.
Giờ hãy thảo luận một ví dụ trong đó các giá trị date có thể lộn xộn và bạn có thể làm gì để làm sạch chúng.
Giả sử bạn đang làm việc với bảng tên employees chứa một cột gọi là birthdate nhưng không ở kiểu ngày thích hợp. Giờ bạn muốn chạy các truy vấn với các hàm date chuyên dụng như DATE_PART(). Bạn sẽ không thể làm được điều đó trừ khi bạn CAST cột birthdate sang kiểu date. Hãy xem điều này trong thực tế.
Giả định các birthdate ở định dạng YYYY-MM-DD.
Đây là những gì bảng employees trông như sau:
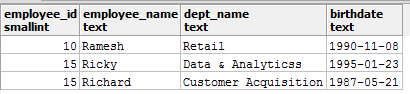
Giờ bạn chạy truy vấn sau để trích xuất tháng từ ngày sinh:
select date_part('month', birthdate) from employees;
Và bạn ngay lập tức nhận lỗi này:
ERROR: function date_part(unknown, text) does not exist
Cùng với lỗi, bạn cũng nhận được một gợi ý rất hay:
HINT: No function matches the given name and argument types. You might need to add explicit type casts.
Hãy làm theo gợi ý và CAST birthdate sang kiểu date phù hợp rồi áp dụng DATE_PART():
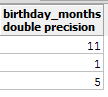
select date_part('month', CAST(birthdate AS date)) as birthday_months from employees;
Bạn sẽ nhận được kết quả:
Giờ hãy chuyển sang phần gần kết luận của hướng dẫn này, nơi bạn sẽ tìm hiểu tác động của việc trùng lặp dữ liệu và cách xử lý chúng.
Trong phần này, bạn sẽ tìm hiểu một số nguyên nhân phổ biến dẫn đến trùng lặp dữ liệu. Bạn cũng sẽ thấy tác động và một số cách để ngăn chặn chúng. Xét hai bảng sau band_details và some_festival_record:
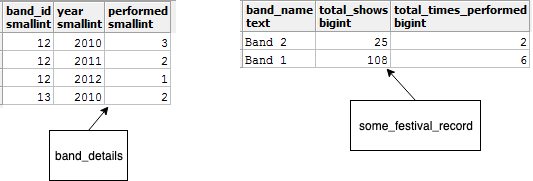
Bảng band_details cung cấp thông tin về các ban nhạc, gồm mã định danh, tên và tổng số buổi diễn họ đã thực hiện. Mặt khác, bảng some_festival_record mô tả một lễ hội âm nhạc giả định và chứa bản ghi về các ban nhạc đã biểu diễn ở đó.
Giờ, giả sử bạn muốn tạo một báo cáo bao gồm tên ban nhạc, số buổi diễn của họ và tổng số lần họ biểu diễn tại lễ hội. Cần INNER join ở đây. Bạn chạy truy vấn sau:
select band_name, sum(total_show_count) as total_shows, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name;
Và truy vấn cho ra:
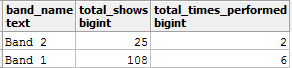
Bạn có nghĩ các giá trị total_shows ở đây là sai không? Bởi vì từ bảng band_details, bạn biết Band_1 đã biểu diễn tổng cộng 36 buổi. Vậy sai ở đâu? Trùng lặp!
Khi nối hai bảng, bạn đã vô tình tổng hợp cột total_show_count dẫn đến trùng lặp dữ liệu trong kết quả join trung gian. Nếu bạn bỏ tổng hợp và chỉnh truy vấn tương ứng, bạn sẽ nhận được kết quả mong muốn:
select band_name, total_show_count, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name, total_show_count;
Giờ bạn nhận được kết quả như kỳ vọng:
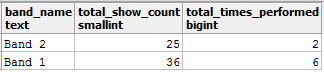
Có một cách khác để ngăn trùng lặp dữ liệu, đó là thêm một trường nữa vào mệnh đề JOIN để các bảng được nối với điều kiện chặt chẽ hơn.
Bạn có thể dùng tệp .SQL này để tạo các bảng sử dụng ở đây và cả các giá trị minh họa.
Cảm ơn bạn đã đọc hướng dẫn này. Hướng dẫn đã giới thiệu một trong những bước quan trọng nhất trong quy trình phân tích dữ liệu - làm sạch dữ liệu. Bạn đã thấy các dạng dữ liệu lộn xộn khác nhau và cách xử lý chúng. Tuy nhiên, còn có những kỹ thuật nâng cao để giải quyết các vấn đề làm sạch dữ liệu phức tạp hơn, và nếu bạn muốn theo đuổi điều đó, dưới đây là một số khóa học tuyệt vời của DataCamp mà bạn có thể tham gia:
Hãy thoải mái đăng quan điểm của bạn trong phần Comments.
Khóa học SQL
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
