

凌乱数字的问题与处理方法
接下来看看如果不清洗凌乱数据(针对上述类型)您最可能遇到的问题。
1. 数据聚合
假设某个数值列存在空值,而您正在计算该列的汇总统计(如均值、最大值、最小值)。此时结果将无法被准确传达。再次考虑含有无效 0 值的 Pima Indian Diabetes 数据集。如果您直接对这些列计算汇总统计,会得到正确结果吗?结果是否会出现偏差?那么,如何解决这个问题?有几种方式:
- Removing the entries containing missing/null values (not recommended)
- Imputing the null entries with a numeric value (typically with mean or median of the respective column)下面动手实践这些问题,以及用于对抗空值的第二种方法。
考虑以下名为 entries 的 PostgreSQL 表:
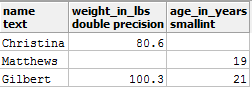
您可以看到上表中有两个空值。假设您想要从该表获取平均体重,并执行了以下查询:
select avg(weight_in_lbs) as average_weight_in_lbs from entries;
您得到的输出是 90.45。这是正确的吗?可以怎么做?让我们使用 COALESCE() 函数,用该平均值填充空值。
先用 COALESCE() 填充缺失值(请记住,COALESCE() 不会改变原表中的值,它只会返回一个值已替换的临时视图):
select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries;
您应当得到类似下面的输出:
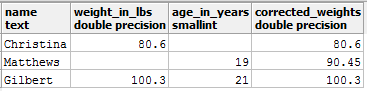
现在可以再次应用 AVG():
select avg(corrected_weights) from
(select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries) as subquery;
这个结果比先前的要准确得多。接下来研究当列数据类型存在不匹配时可能出现的另一个问题。
2. 表连接
设想您正在处理以下两张表 student_metadata 和 department_details:
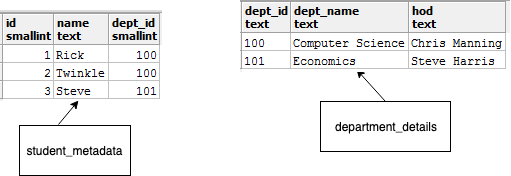
您会看到在 student_mtadata 表中,dept_id 是整数类型,而在 department_details 表中,它是文本类型。现在,您想将这两张表进行连接,并产出包含以下列的报告:
- id
- name
- dept_name
为此,您运行了如下查询:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = d.dept_id;
随后您会遇到如下错误:
ERROR: operator does not exist: smallint = text
这有一张很棒的信息图展示了这个问题(来自 DataCamp 的 Reporting in SQL 课程):
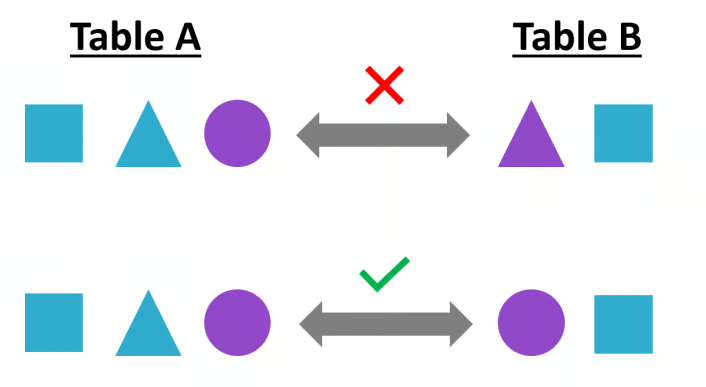
出现该问题是因为在连接两张表时数据类型不匹配。这里,您可以在连接时将 department_details 表中的 dept_id 列 CAST 为整数。操作如下:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = cast(d.dept_id as smallint);
然后您就得到了想要的报告:
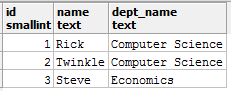
接下来讨论字符串如何会以凌乱的形式出现、会带来哪些问题,以及应对方法。
凌乱的字符串及其清洗
字符串值也非常常见。让我们从表 student_details 中一列名为 dept_name(表示系名)的值开始看起:
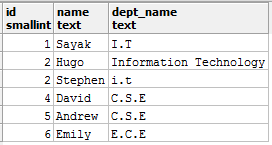
像上面这样的字符串值可能导致许多意想不到的问题。I.T、Information Technology 和 i.t 实际上都表示同一个系,即 Information Technology,且假设规范文档要求这些值只以 I.T 的形式出现。现在,假设您想统计属于 I.T. 系的学生数量,并运行了如下查询:
select dept_name, count(dept_name) as student_count
from student_details
group by dept_name;
然后您得到:
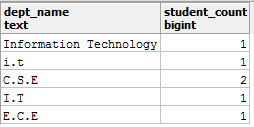
这是准确的报告吗?——不是!那么该如何解决?
先更具体地识别问题:
- 存在值
Information Technology,应转换为I.T;以及 - 存在值
i.t,也应转换为I.T。
第一种情况可以使用 REPLACE 将 Information Technology 替换为 I.T;第二种情况可以将字符转换为 UPPER 大写。您可以在一条查询中完成,尽管建议分步处理此类问题。以下查询可用于解决该问题:
select upper(replace(dept_name, 'Information Technology', 'I.T')) as dept_cleaned,
count(dept_name) as student_count
from student_details
group by dept_cleaned;
得到的报告:
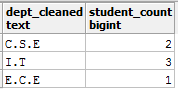
您可以在这里阅读更多 PostgreSQL 字符串函数。
下面讨论一个日期值可能凌乱的例子,以及如何清洗它们。
凌乱的日期及其清洗
设想您正在处理一张名为 employees 的表,其中包含一列 birthdate,但类型并不合适。现在,您希望使用 DATE_PART() 等专用的 date 函数来编写查询。在未将 birthdate 列 CAST 为 date 类型之前,您将无法做到这一点。让我们来看看。
假设 birthdate 的格式为 YYYY-MM-DD。
employees 表如下所示:
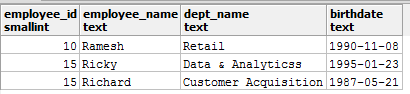
现在,您运行以下查询从生日中提取月份:
select date_part('month', birthdate) from employees;
随即得到这个错误:
ERROR: function date_part(unknown, text) does not exist
同时还给出了一个很好的提示:
HINT: No function matches the given name and argument types. You might need to add explicit type casts.
按照提示,将 birthdate CAST 为合适的 date 类型,再应用 DATE_PART():
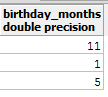
select date_part('month', CAST(birthdate AS date)) as birthday_months from employees;
您应得到如下结果:
现在进入本教程的预总结部分,看看数据重复带来的影响以及如何应对。
数据重复:成因、影响与解决方案
本节将学习一些导致数据重复的最常见原因;您还将看到其影响及若干预防方法。考虑以下两张表 band_details 和 some_festival_record:
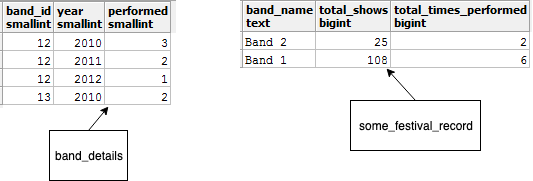
band_details 表提供乐队信息,包含它们的标识符、名称以及已举办的演出总数。另一方面,some_festival_record 表描述了一个假想的音乐节,并记录了在此演出的乐队。
现在,假设您想生成一份报告,应包含乐队名称、其演出总数,以及他们在该音乐节上演出的总次数。这里需要进行 INNER 连接。您运行了如下查询:
select band_name, sum(total_show_count) as total_shows, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name;
查询产出了如下结果:
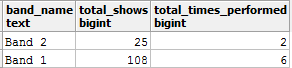
您不觉得这里的 total_shows 值是错误的吗?因为从 band_details 表中您知道,Band_1 总共举办了 36 场演出。那问题出在哪?重复!
在连接两张表时,您误将 total_show_count 列进行了聚合,导致在中间连接结果中发生了数据重复。如果去掉该聚合并相应修改查询,您应得到期望的结果:
select band_name, total_show_count, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name, total_show_count;
现在得到预期结果:
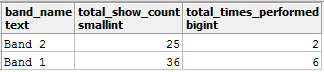
还有另一种防止数据重复的方法,即在 JOIN 子句中添加另一个字段,从而在更严格的条件下连接表。
您可以使用这个 .SQL 文件来生成此处使用的表及其示例值。
更进一步
感谢您阅读本教程。本文向您介绍了数据分析流程中最关键的步骤之一——数据清洗。您看到了不同形式的脏数据及其处理方法。不过,应对更复杂的数据清洗问题还有更高级的技术。如果您希望在这方面继续深入,以下是一些优秀的 DataCamp 课程可供选择:
欢迎在评论区发表您的看法。
现实世界的数据几乎总是很凌乱。作为数据科学家、数据分析师,甚至是开发者,如果您需要从数据中发现事实,确保数据足够整洁至关重要。关于整洁数据其实有一个较为完善的定义,您可以查看这个维基页面获取更多资料。
在本教程中,您将练习一些最常见的 SQL 数据清洗技巧。您将创建自己的虚拟数据集,但这些技巧同样适用于现实世界的(表格形式)数据。内容很多,我们开始吧!
注意,您应当已经掌握了在 PostgreSQL(本教程将使用的关系型数据库)中编写基础 SQL 查询的方法。如果需要温习概念,以下资源可能有帮助:
不同数据类型、常见脏值与处理方法
在表格数据中,最常见的数据类型是
string、numeric或date-time。以上各类型都可能出现脏值。下面我们逐一看看这些类型及其典型的脏值示例。先从numeric类型开始。凌乱的数字
数值可能以多种方式变得凌乱。这里将介绍最常见的几种:
不理想的类型/类型不匹配:设想您正在处理的数据集中有一列名为
age。您发现该列中的值是float类型——示例值如 23.0、45.0、34.0 等。在这种情况下,age列并不需要是float类型,对吗?空值:这在上述所有数据类型中都很常见,这里的空值仅意味着该值不可用/留空。不过,空值也可能以其他形式出现。以 Pima Indian Diabetes 数据集为例。该数据集中诸如
Plasma glucose concentration、Diastolic blood pressure等列存在 0 值,这在实际中是无效的。如果在未处理这些无效条目的情况下对数据集进行统计分析,您的分析将不准确。现在来研究这些问题可能引发的后果,以及如何应对它们。