Tutorial ini merupakan kontribusi berharga dari komunitas kami dan telah disunting untuk kejelasan dan ketepatan oleh DataCamp.
Tertarik membagikan keahlian Anda sendiri? Kami ingin mendengarnya! Silakan kirim artikel atau ide Anda melalui Formulir Kontribusi Komunitas kami.
Perkembangan pembelajaran mesin telah menghasilkan model fondasi, yaitu kelas model yang dipra-latih pada data dalam jumlah besar dan berfungsi sebagai basis serbaguna untuk beragam aplikasi. Model-model ini, yang dicontohkan oleh GPT dan BERT dalam Natural Language Processing (NLP), telah menunjukkan kemampuan luar biasa dalam tugas-tugas seperti zero-shot dan few-shot learning.
Dalam artikel ini, kita menelusuri ranah model fondasi gambar-teks, mengeksplorasi model inovatif Contrastive Captioner (CoCa). Kita akan mengurai arsitekturnya, memahami pendekatan uniknya yang menggabungkan objektif kontrastif dan generatif, serta melihat bagaimana ia menyematkan kemampuan model seperti CLIP dan SIMVLM ke dalam satu model yang koheren.
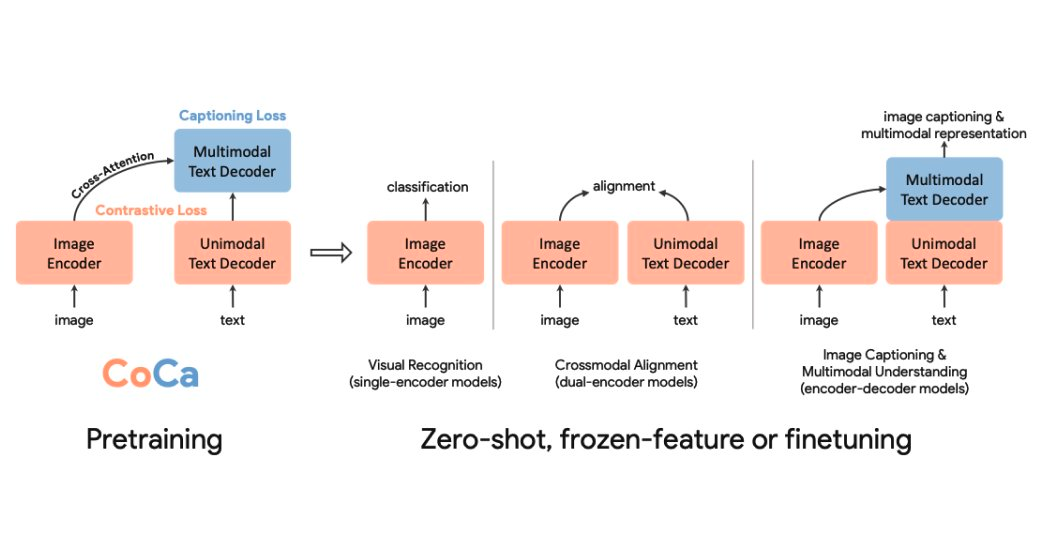
Gbr-1 - Contrastive Captioner - (CoCa)
Kebangkitan Model Fondasi
Gagasan model fondasi bukanlah hal baru dalam pembelajaran mesin. Dalam deep learning, teknik yang memungkinkan pelatihan model-model ini memungkinkan kita menyesuaikannya di masa depan untuk tugas hilir. Di NLP, telah terjadi ledakan model fondasi seperti GPT dan BERT, yang dilatih pada data berskala internet yang bising, dan telah menunjukkan kemampuan zero-shot dan few-shot yang luar biasa.
Penelitian untuk membangun model fondasi visi dan visi-bahasa telah mengeksplorasi tiga jalur utama: model encoder tunggal, model dual-encoder gambar-teks dengan contrastive loss, dan model encoder-decoder dengan objektif generatif. Sebelum kita mengeksplorasi model CoCa, mari kita lihat garis penelitian ini dalam membangun model fondasi beserta kelemahannya.
Glosarium
- Model Fondasi. Model pra-latih yang menjadi titik awal untuk berbagai aplikasi pembelajaran mesin, dapat disesuaikan untuk tugas spesifik.
- Contrastive Loss. Fungsi loss yang melatih model untuk mempelajari representasi serupa untuk pasangan masukan yang serupa dan tidak serupa untuk pasangan yang tidak terkait.
- Interaksi Lintas-Modal. Interaksi antara berbagai jenis modalitas data (misalnya gambar dan teks) untuk menghasilkan representasi gabungan.
- Arsitektur Encoder-Decoder. Struktur jaringan saraf dengan encoder untuk memroses data masukan dan decoder untuk menghasilkan keluaran, digunakan untuk tugas sequence-to-sequence.
- Causal Masking. Teknik pada model transformer untuk mencegah akses ke token masa depan dalam urutan selama pelatihan.
- Mekanisme Atensi. Komponen yang memungkinkan model memberi bobot dan memprioritaskan bagian-bagian berbeda dari masukan saat memproses informasi.
- Zero-Shot Learning. Paradigma pembelajaran di mana model membuat prediksi atau klasifikasi pada kelas data yang tidak terlihat saat pelatihan.
- Visual Question Answering (VQA). Tugas di mana model menjawab pertanyaan tentang konten gambar, menggabungkan computer vision dan pemrosesan bahasa alami.
- Representasi Unimodal dan Multimodal. Representasi unimodal menangkap informasi dari satu jenis modalitas data, sedangkan representasi multimodal mengintegrasikan informasi dari berbagai modalitas.
- Contrastive Language-Image Pre-training (CLIP). Model yang dilatih menggunakan contrastive learning untuk menyelaraskan gambar dan teks dalam ruang representasi bersama.
Model Encoder Tunggal
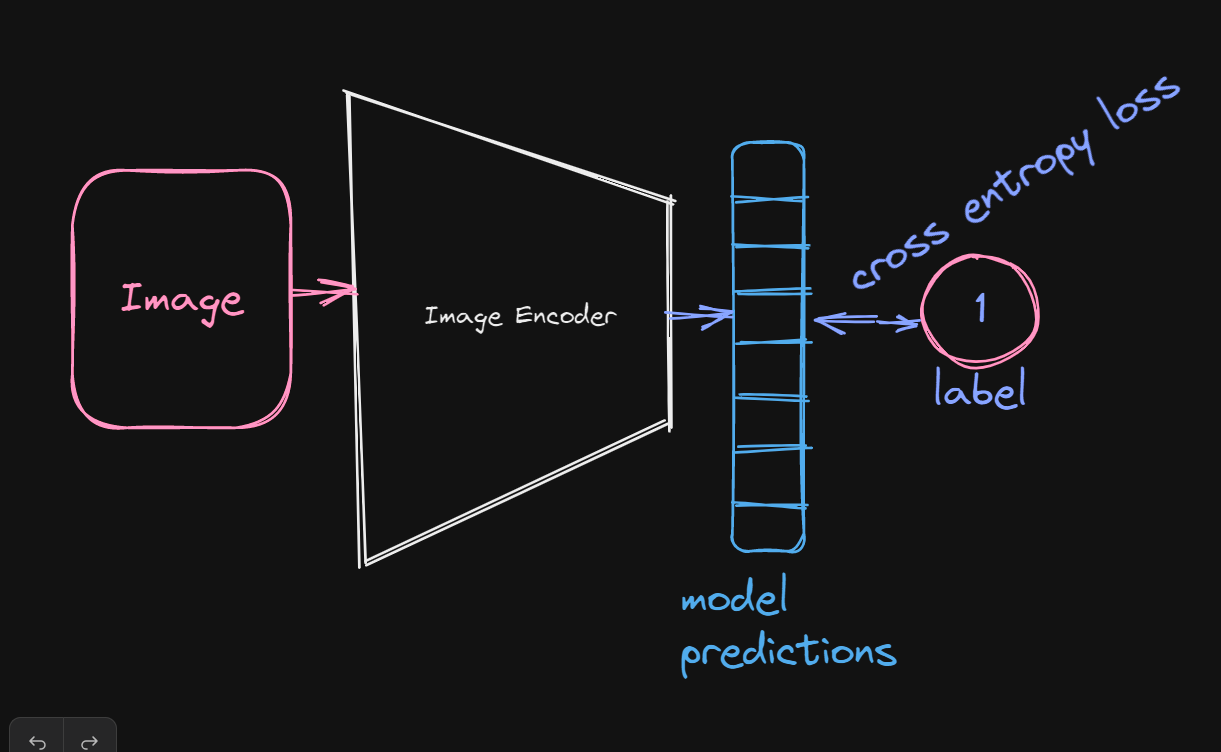
Jika Anda pernah berkecimpung dalam computer vision, kemungkinan besar Anda pernah menemui kelas model ini. Model-model ini mempelajari representasi gambar yang nantinya dapat disesuaikan untuk tugas visi hilir dengan melatih pada dataset besar berisi gambar beranotasi menggunakan cross-entropy loss.
Model-model ini secara empiris terbukti unggul dalam tugas terkait visi seperti deteksi, tetapi kurang baik pada tugas yang melibatkan visi-bahasa karena ketergantungannya yang besar pada anotasi manusia, yang mencegah penyematan bahasa alami manusia ke dalamnya.
Model Dual-Encoder Gambar-Teks dengan Contrastive Loss
Model populer dalam kelas model fondasi visi-bahasa ini mencakup CLIP (Contrastive Language-Image Pre-training) dan ALIGN.
Selama pra-pelatihan, kita mempelajari tugas penyelarasan dengan melatih model gambar dan bahasa secara bersama menggunakan contrastive loss.
Gagasan di balik objektif pra-pelatihan mereka cukup sederhana: mengelompokkan representasi pasangan gambar-teks (yang saling terkait) dan menjauhkan representasi gambar dan teks yang tidak terkait (bukan pasangan) dalam ruang laten yang sama. Model dual-encoder yang dihasilkan kemudian dapat disiapkan untuk melakukan tugas klasifikasi zero-shot dan penelusuran gambar.
Model terbaru dari kelas ini, seperti CLIP, telah terbukti mencapai kinerja mengesankan pada berbagai tugas visi-bahasa tetapi hampir mustahil digunakan pada tugas yang memerlukan representasi gabungan gambar dan teks, seperti visual question answering, karena kita hanya belajar menyelaraskan representasi gambar dan teks, bukan menghasilkan representasi terpadu yang menyandikan informasi dari masukan gambar dan teks.
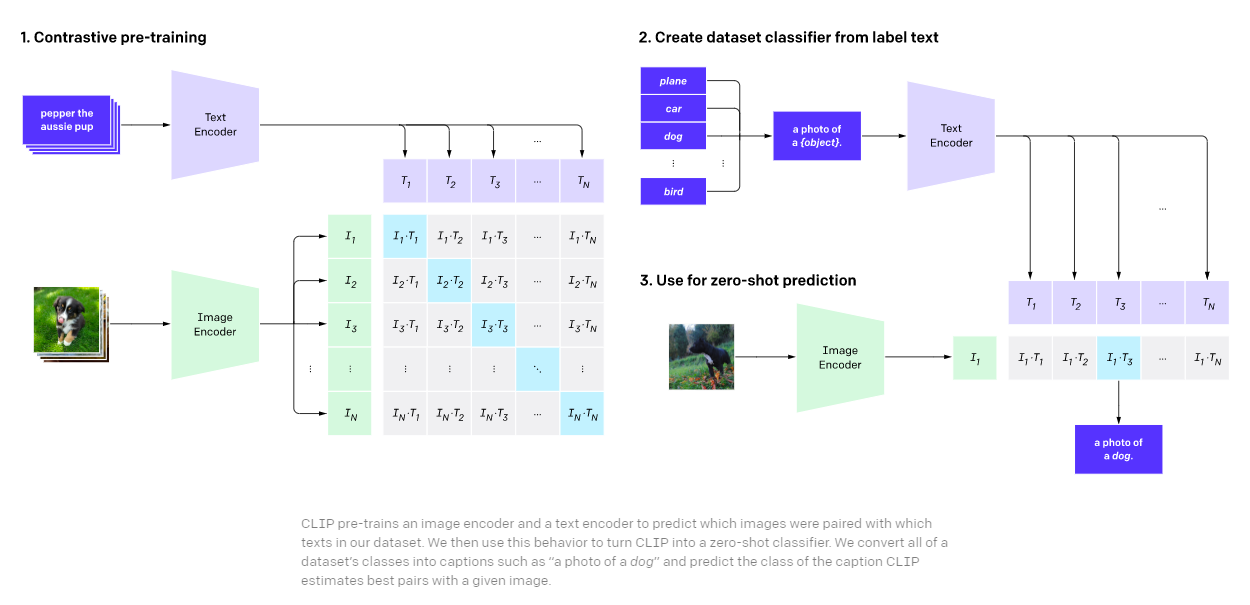
Gbr-3 - Contrastive Language-Image Pre-training (CLIP)
Pra-pelatihan Generatif dengan Arsitektur Encoder-Decoder
Model-model ini memanfaatkan interaksi lintas-modal antara representasi tersembunyi gambar dan teks untuk menghasilkan representasi bersama.
Selama pra-pelatihan, kita menghasilkan representasi terpadu dari gambar dan teks melalui interaksi lintas-modal antara representasi teks tersembunyi dan keluaran encoder gambar, lalu menerapkan Language Modelling loss pada keluaran decoder.
Dalam arsitektur pembelajaran mesin mutakhir, interaksi lintas-modal sebagian besar dilakukan melalui mekanisme cross-attention pada transformer dengan keluaran encoder gambar sebagai query dan representasi teks tersembunyi sebagai key dan value.
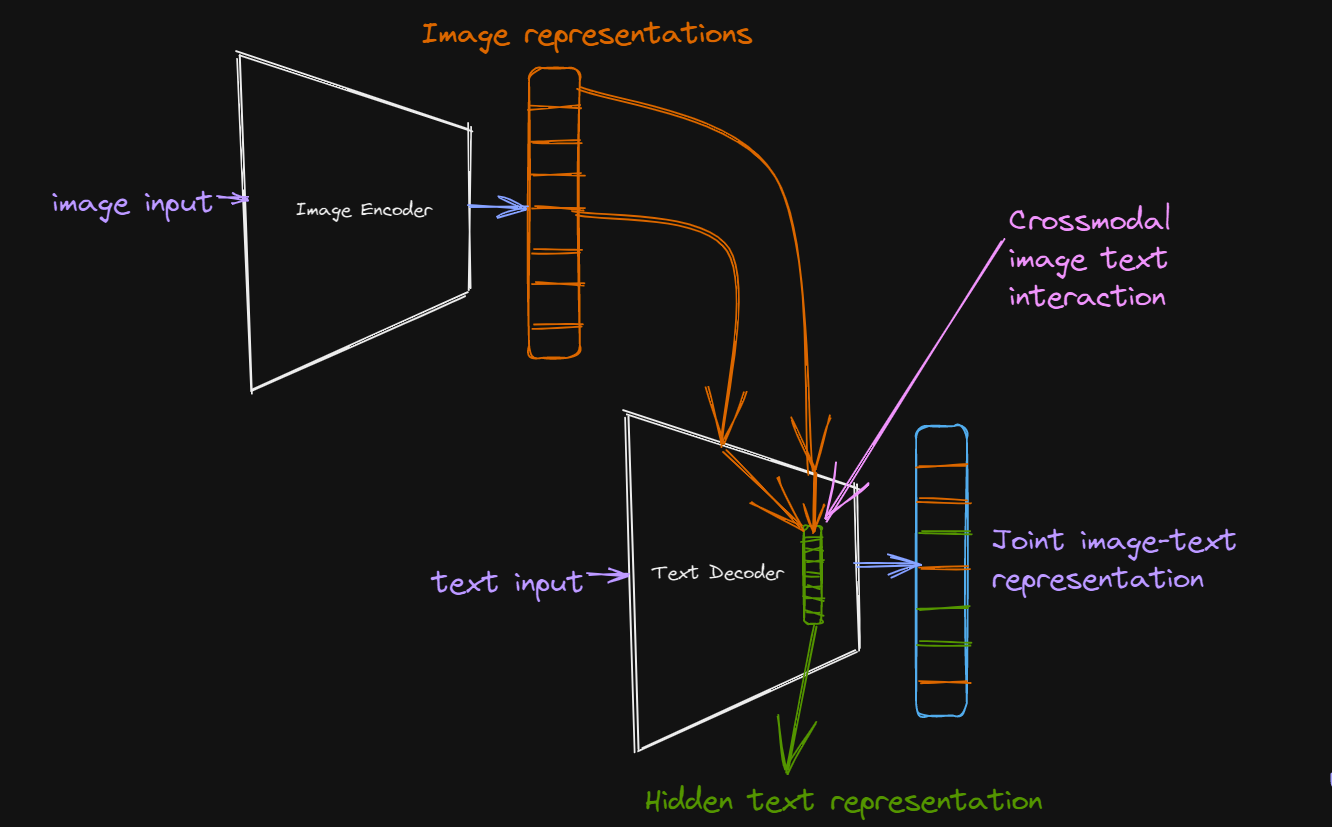
Untuk tugas hilir, kita dapat mengambil keluaran decoder, yang merupakan representasi gabungan gambar dan teks, dan melakukan berbagai tugas pemahaman gambar-teks multimodal seperti Visual Question Answering. Salah satu model terbaru yang menggunakan paradigma ini adalah Simple Visual Language Model (SIMVLM).
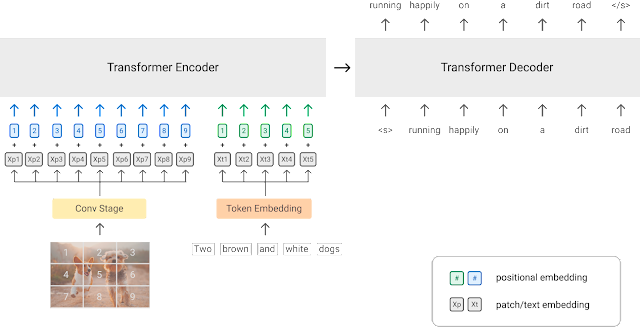
Gbr-5 - Simple Visual Language Model (SIMVLM)
Motivasi di Balik CoCa
Para penulis model CoCa berupaya menyatukan kemampuan dari berbagai paradigma pembangunan model fondasi gambar-teks ke dalam satu model sederhana. Desain CoCa memanfaatkan contrastive loss untuk mempelajari penyelarasan representasi gambar dan teks dalam satu ruang vektor serta objektif generatif (captioning loss) untuk mempelajari representasi gabungan gambar-teks, sehingga menyematkan kemampuan model seperti CLIP dan SIMVLM dalam satu model tunggal.
Arsitektur Model
CoCa menggunakan pendekatan encoder-decoder standar dan, seperti kebanyakan model sejenis, melakukan pengodean gambar dengan jaringan saraf seperti convolutional neural network atau transformer.
Keunikan arsitektur CoCa dimulai pada keluaran encodernya dan keseluruhan pengaturan decodernya.
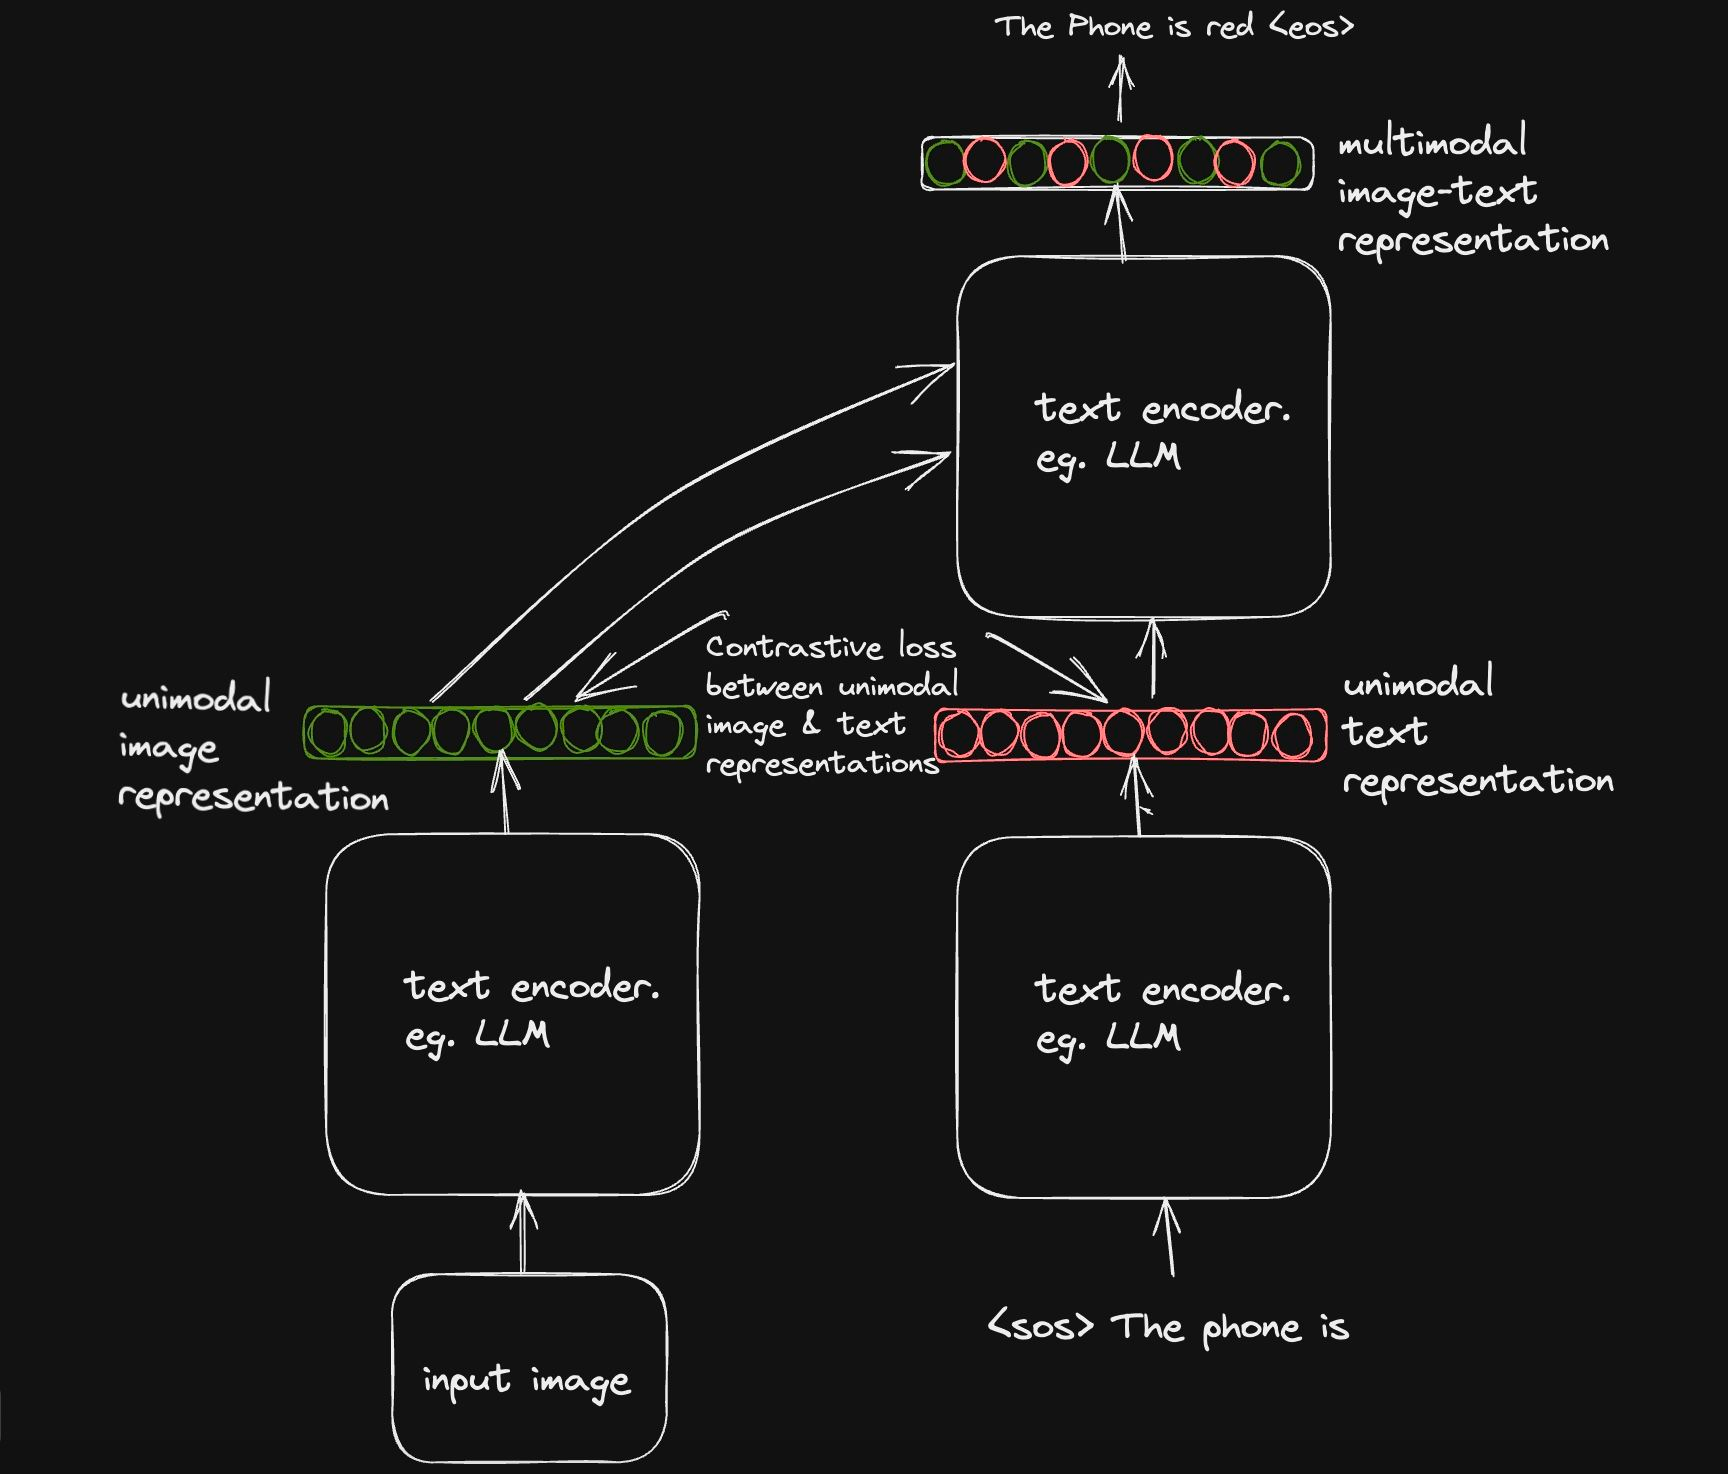
Ingat bahwa tujuan paper CoCa adalah menggabungkan kemampuan dua paradigma model visi-bahasa (objektif kontrastif dan generatif) ke dalam satu model. Paradigma objektif kontrastif mengharuskan decoder teks kita menghasilkan representasi teks unimodal, yang kemudian diproyeksikan ke ruang vektor serupa dengan representasi gambar untuk mempelajari tugas penyelarasan.
Sebaliknya, objektif generatif memungkinkan decoder menerima representasi gambar dari encoder dan secara autoregresif menghasilkan teks yang dikondisikan pada representasi gambar dan masukan teks.
Perlu dicatat bahwa kedua bagian decoder menerapkan causal masking untuk mencegah model melihat token di depan waktu.
Untuk mencapai ini, para penulis dengan cerdas mengadaptasi pengaturan decoder terlepas (decoupled), bagian pertama belajar menghasilkan representasi teks unimodal untuk objektif kontrastif dan bagian kedua belajar menghasilkan representasi multimodal gambar-teks.
Objektif Kontrastif
Gagasan di balik objektif kontrastif, seperti digunakan pada beberapa model seperti CLIP dan ALIGN, cukup sederhana. Idenya adalah mempelajari representasi untuk berbagai modalitas, seperti gambar dan teks, sedemikian rupa sehingga pasangan yang serupa lebih dekat satu sama lain dalam ruang representasi dan pasangan yang tidak serupa lebih jauh satu sama lain.
Pada setiap langkah pelatihan, kita mengambil sampel pasangan gambar-teks dari dataset dan mengarahkan bobot encoder kita untuk mengelompokkan pasangan sampel serta menjauhkan yang bukan pasangan.
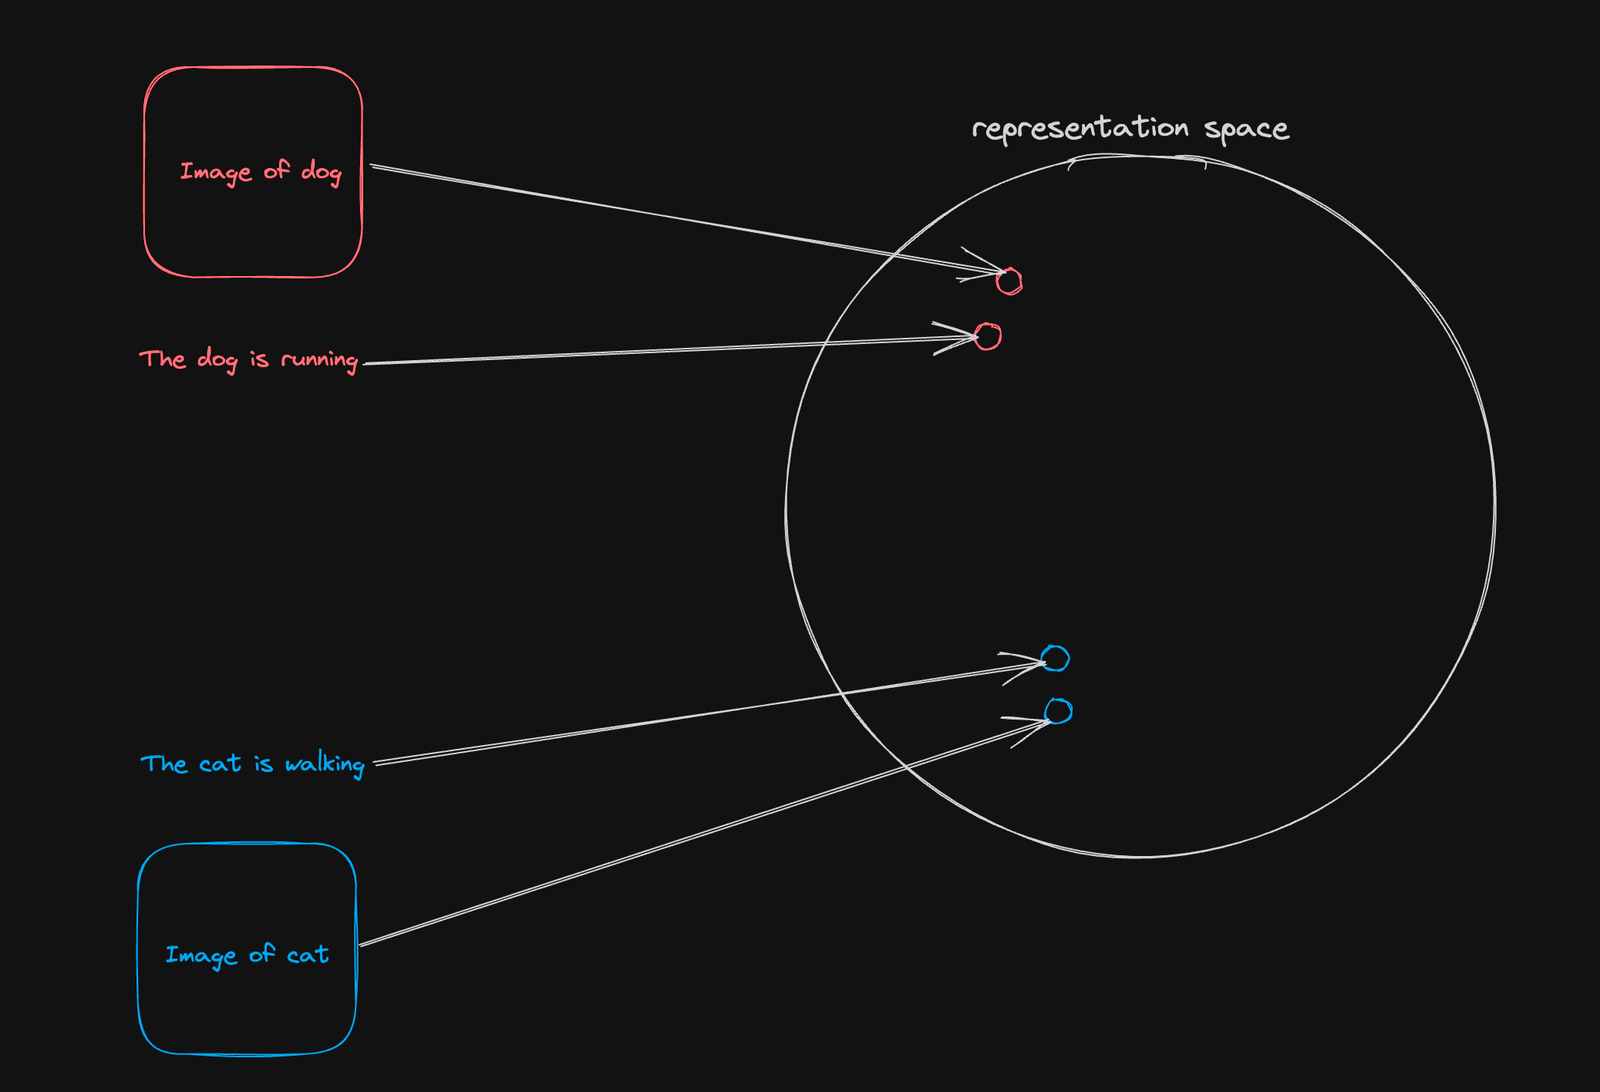
Seperti disebutkan sebelumnya, objektif kontrastif memerlukan representasi unimodal dari kedua modalitas gambar dan teks. Untuk mencapainya di sisi encoder teks, kita menerapkan teknik klasik yang digunakan pada model bahasa BERT.
Sebagai bagian dari urutan masukan, kita memperkenalkan token klasifikasi yang dapat dipelajari [CLS] di akhir urutan masukan dan berharap vektor keluaran yang dipetakan ke token ini akan menangkap makna semantik dari seluruh urutan masukan.
Karena decoder kita menerapkan causal masking pada peta atensinya, menambahkan token klasifikasi di akhir urutan memastikan adanya koneksi atensi antara token klasifikasi dan semua token lain dalam urutan masukan sehingga menangkap makna semantik dari seluruh kalimat.
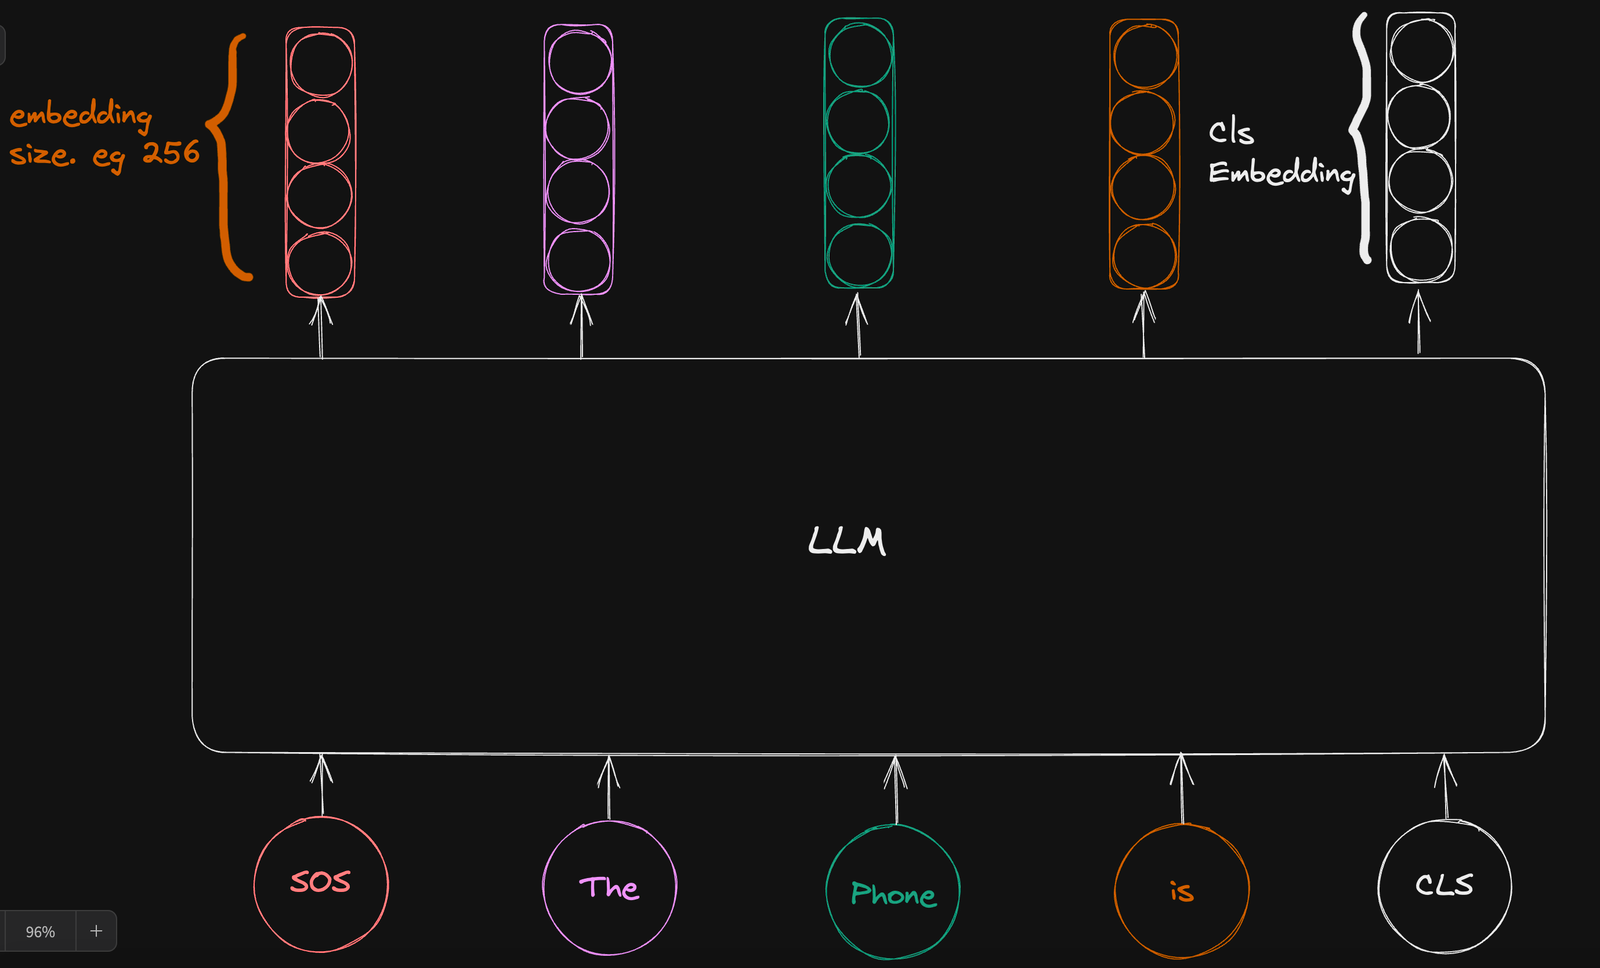
Kita mengabaikan representasi vektor dari token masukan lainnya dan menggunakan representasi vektor token klasifikasi untuk mengestimasi contrastive loss.
Di sisi encoder gambar, keadaannya sedikit berbeda.
Pada gambar Gbr-6, Anda dapat melihat bahwa sebagian keluaran dari encoder gambar digunakan bersama embedding token klasifikasi untuk mengestimasi contrastive loss, dan sebagian lainnya dikirim ke bagian atas pengaturan terlepas untuk mengestimasi representasi gabungan.
Faktanya, hanya satu embedding keluaran gambar yang diperlukan untuk mengestimasi objektif kontrastif, sementara seluruh urutan embedding keluaran encoder gambar digunakan untuk mengestimasi objektif generatif.
Para penulis berargumen bahwa secara empiris mereka menentukan bahwa satu keluaran embedding yang dipool membantu menangkap representasi global gambar (yang memang kita butuhkan untuk objektif kontrastif), dan urutan keluaran embedding membantu pada tugas yang memerlukan representasi gambar yang lebih rinci.
Untuk mencapai ini, sebuah lapisan attentional pooling, yaitu satu lapisan multi-head attention, digunakan untuk menyesuaikan keluaran encoder gambar untuk objektif yang berbeda melalui parameter query yang dapat dipelajari. Dengan menetapkan parameter query ke nilai bilangan bulat tertentu, kita dapat menyesuaikan keseluruhan pengaturan encoder agar menghasilkan urutan embedding dengan panjang sesuai parameter query.
Dalam kasus objektif kontrastif, kita menetapkan parameter query ke satu untuk memperoleh hanya satu embedding guna menghitung contrastive loss, dan dalam kasus objektif generatif, kita menetapkannya ke nilai sewenang-wenang yang idealnya sama dengan panjang urutan teks kita. Dalam paper CoCa, para penulis memilih 256 untuk objektif generatif.
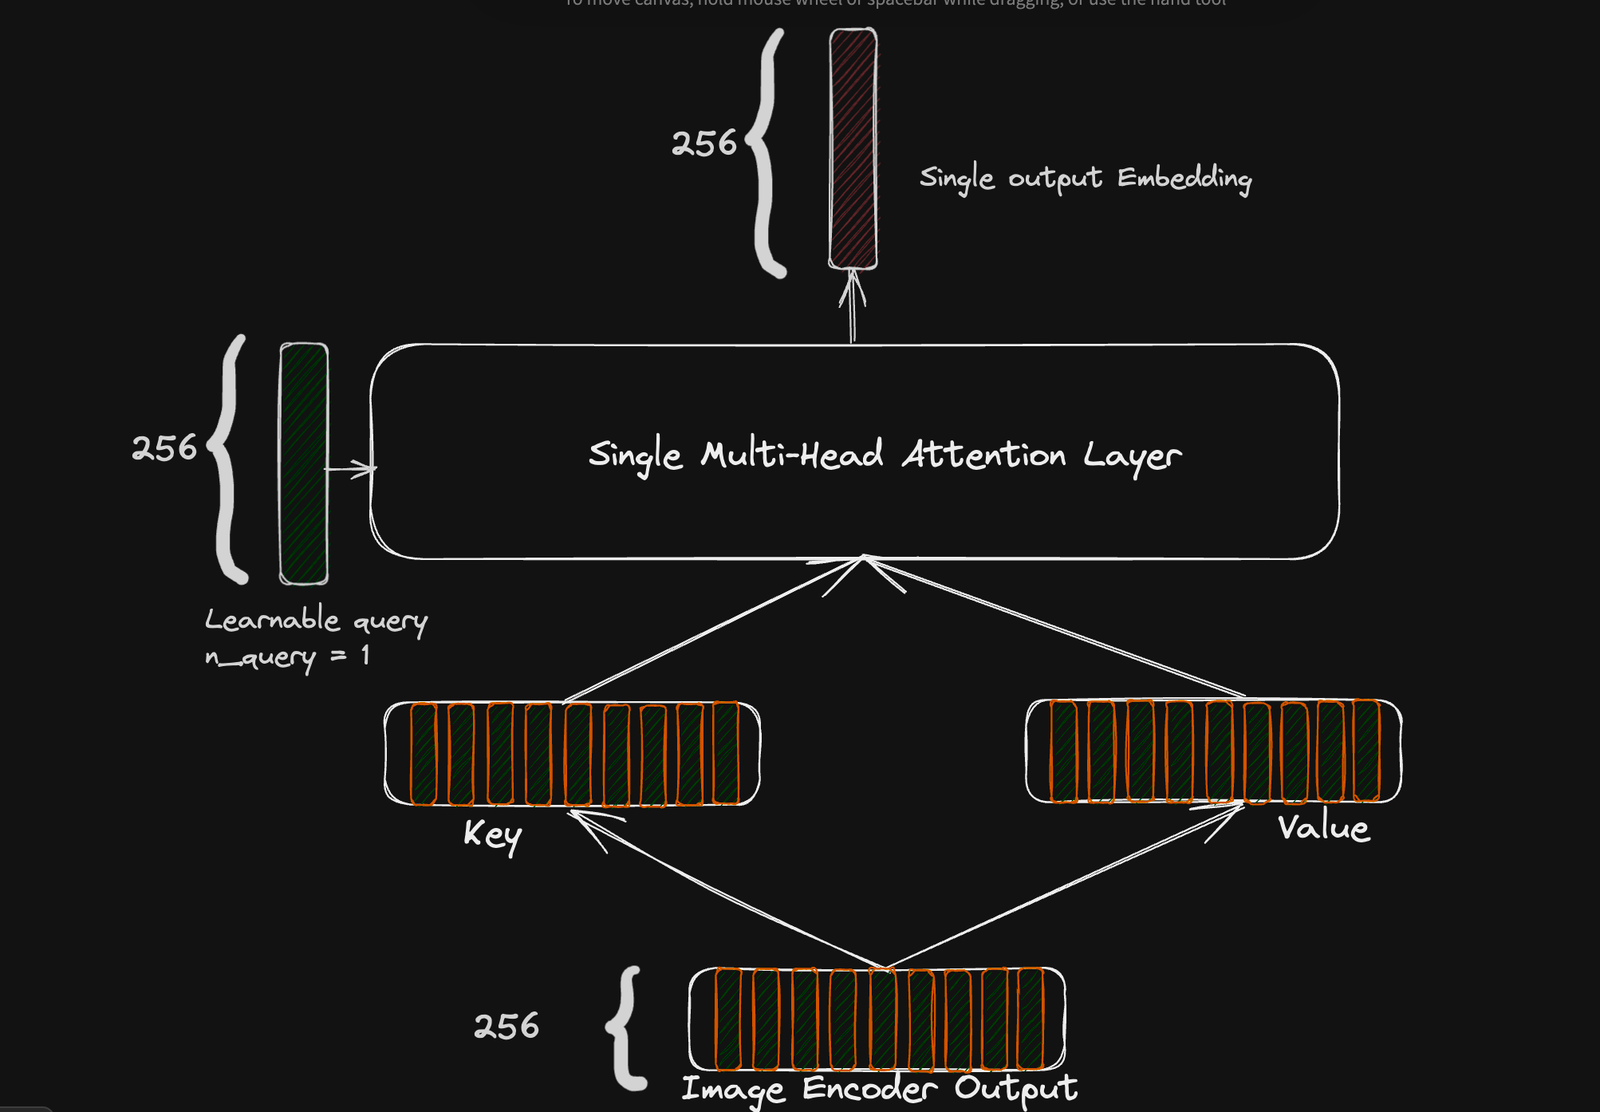
Pengaturan attention pooling untuk contrastive loss. Keluaran lapisan attention adalah embedding berdimensi 256 tunggal.
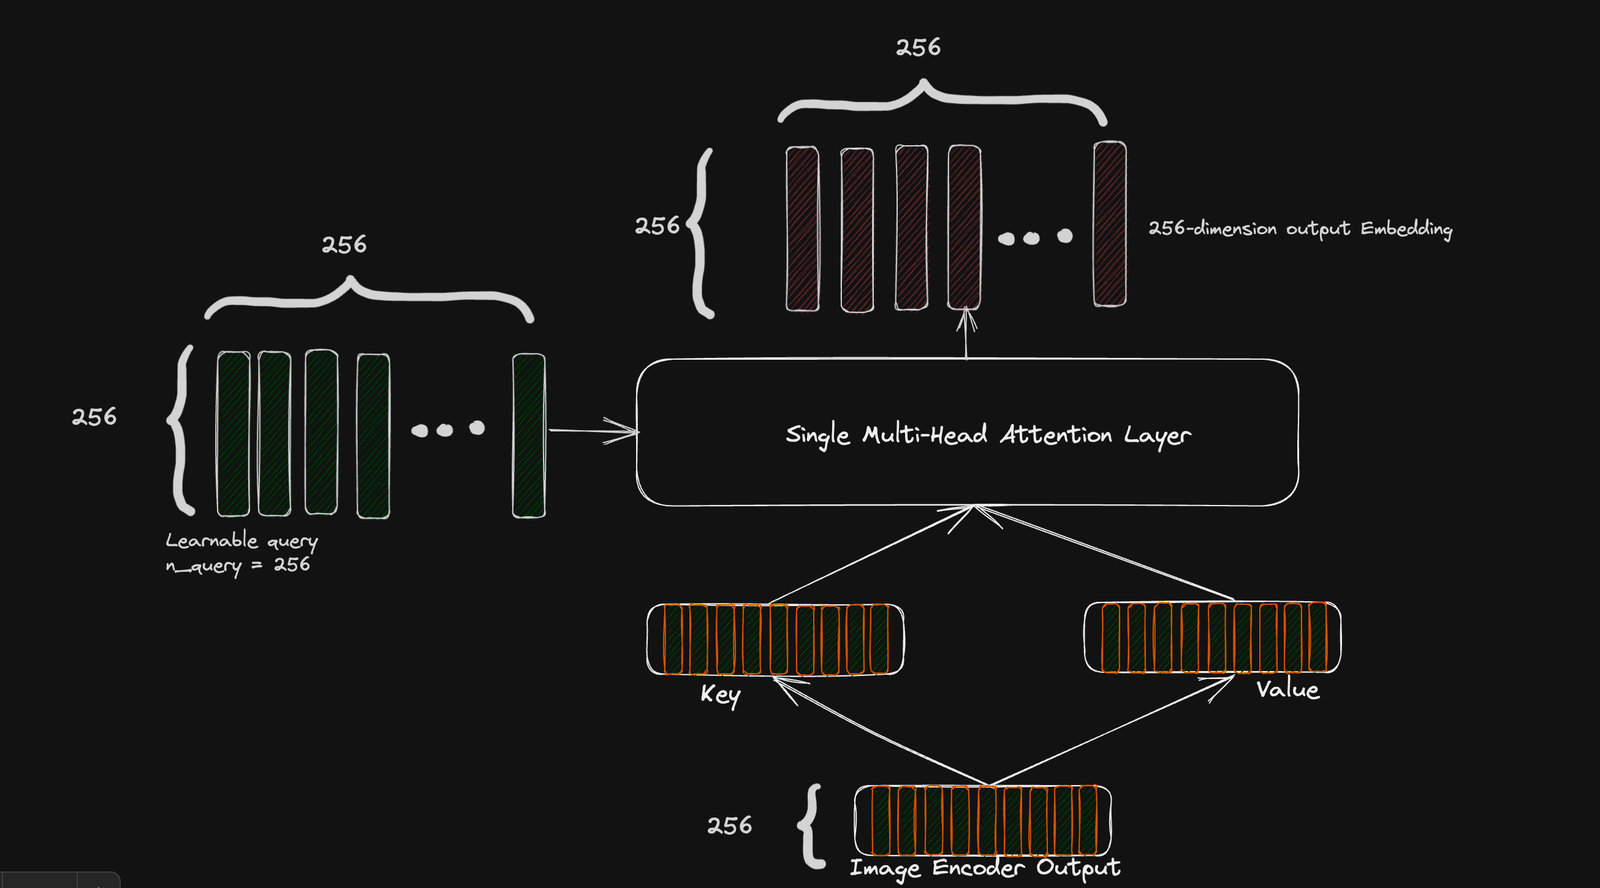
Objektif Generatif
Tidak seperti objektif kontrastif yang hanya memerlukan representasi global gambar, objektif generatif lebih efektif ketika kita menghasilkan representasi gambar yang lebih rinci.
Seperti telah dijelaskan, kita memperoleh representasi gambar terperinci dengan menetapkan parameter query ke angka sewenang-wenang (256 pada paper CoCa) yang menghasilkan representasi gambar kaya berukuran 256 x 256.
Representasi ini diteruskan ke bagian atas pengaturan decoder terlepas, dan melalui interaksi lintas-modal dengan representasi teks unimodal (mengabaikan representasi CLS), kita memperoleh representasi gambar-teks terpadu yang digunakan untuk memprediksi distribusi probabilitas kosa kata melalui faktorisasi autoregresi.
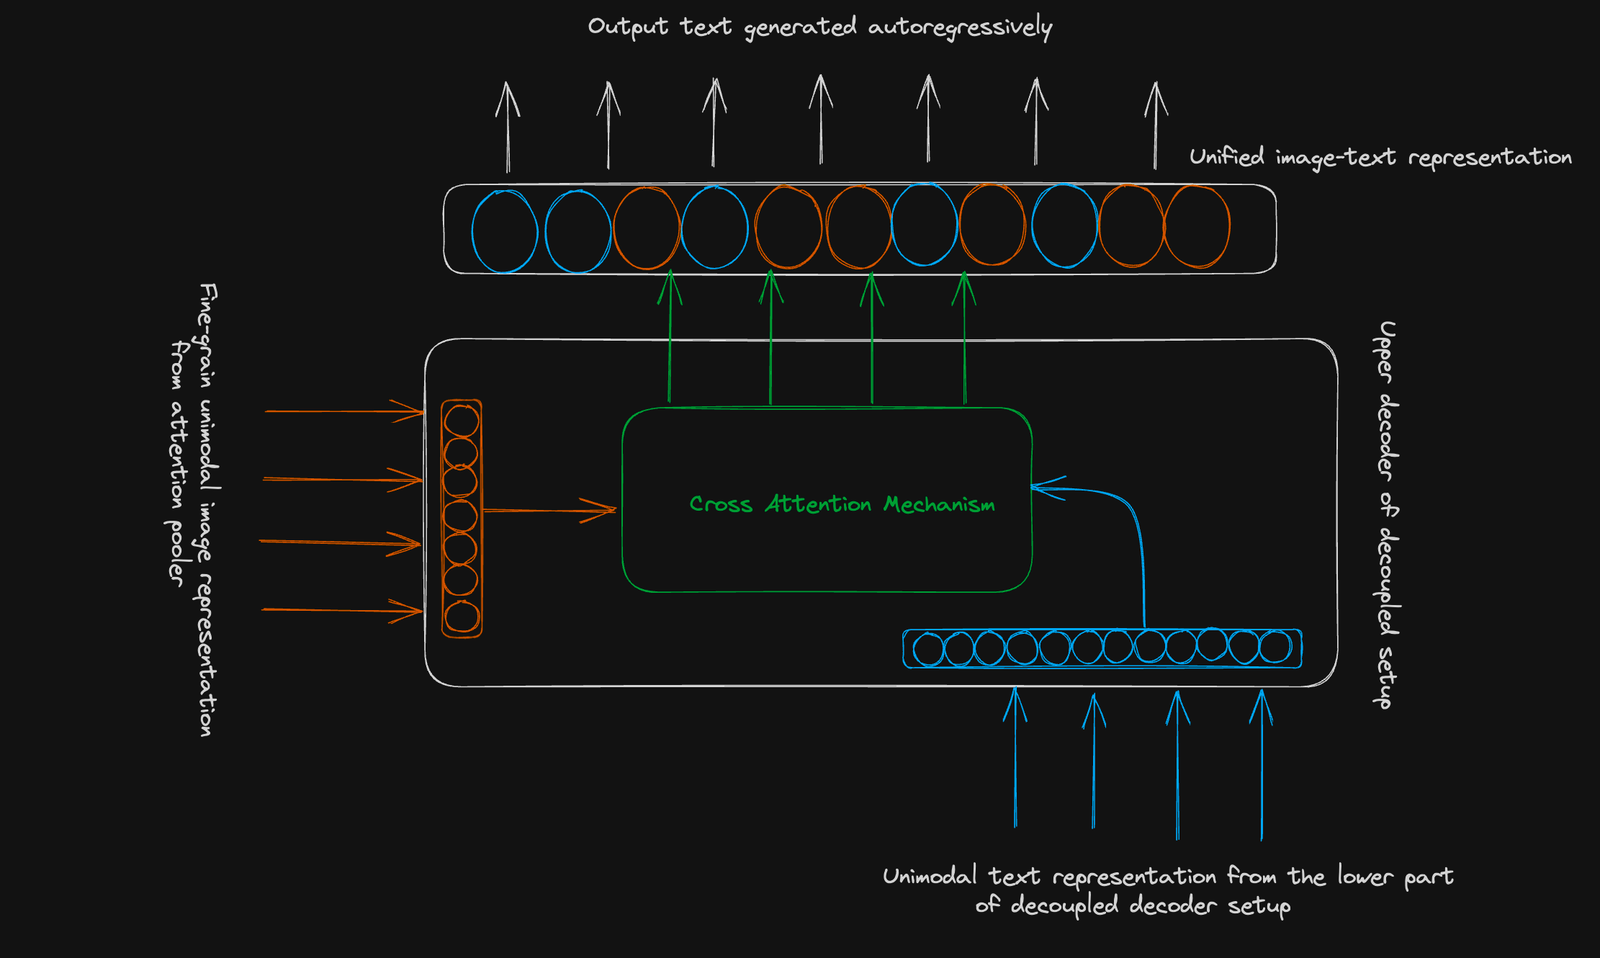
Seperti diilustrasikan dalam dua bagian sebelumnya, pengaturan arsitektural model CoCa memungkinkan penyatuan kemampuan kelas model yang unggul pada tugas zero-shot seperti klasifikasi gambar dan penelusuran lintas-modal, serta kelas model lain yang unggul pada VQA dan pembuatan caption gambar. Model CoCa juga dapat disesuaikan (fine-tuned) pada berbagai tugas visi dan bahasa hilir.
Pemikiran Akhir
Munculnya model fondasi seperti CoCa menandai langkah signifikan dalam bidang pembelajaran mesin. CoCa menggabungkan kekuatan berbagai paradigma, menawarkan model terpadu yang mampu menyelaraskan representasi gambar dan teks sekaligus menghasilkan representasi gabungan gambar-teks.
Model ini menjadi bukti potensi integrasi objektif kontrastif dan generatif, membuka jalan bagi peningkatan kinerja pada tugas seperti Visual Question Answering dan pembuatan caption gambar. Ia merangkum kemampuan model yang unggul pada tugas zero-shot dan model yang mahir pada pemahaman gambar-teks multimodal, menyediakan alat serbaguna untuk banyak tugas visi dan bahasa hilir.
Bagi Anda yang ingin menyelami konsep tingkat lanjut dalam pembelajaran mesin dan mengeksplorasi seluk-beluk deep learning, Kursus Advanced Deep Learning with Keras di DataCamp akan membekali Anda dengan pengetahuan dan keterampilan untuk menyelesaikan berbagai masalah menggunakan Keras functional API yang serbaguna, memungkinkan Anda mengeksplorasi dan memahami model lanjutan seperti CoCa beserta prinsip-prinsip dasarnya secara lebih mendalam.