Este tutorial é uma valiosa contribuição da nossa comunidade e foi editado pela DataCamp para garantir clareza e precisão.
Quer compartilhar sua experiência? A gente quer te ouvir! Envie seus artigos ou ideias pelo nosso formulário de contribuição da comunidade.
A evolução do machine learning levou ao desenvolvimento dos modelos base, uma classe de modelos pré-treinados em grandes volumes de dados que servem como alicerce versátil para uma infinidade de aplicações. Esses modelos, representados por nomes como GPT e BERT em Processamento de Linguagem Natural (NLP), demonstraram capacidades inéditas em tarefas como zero-shot e few-shot learning.
Neste artigo, vamos explorar o universo dos modelos base de imagem e texto, com foco no inovador modelo Contrastive Captioner (CoCa). Vamos dissecar sua arquitetura, entender sua abordagem única que combina objetivos contrastivos e generativos e ver como ele incorpora as capacidades de modelos como CLIP e SIMVLM em um único modelo coeso.
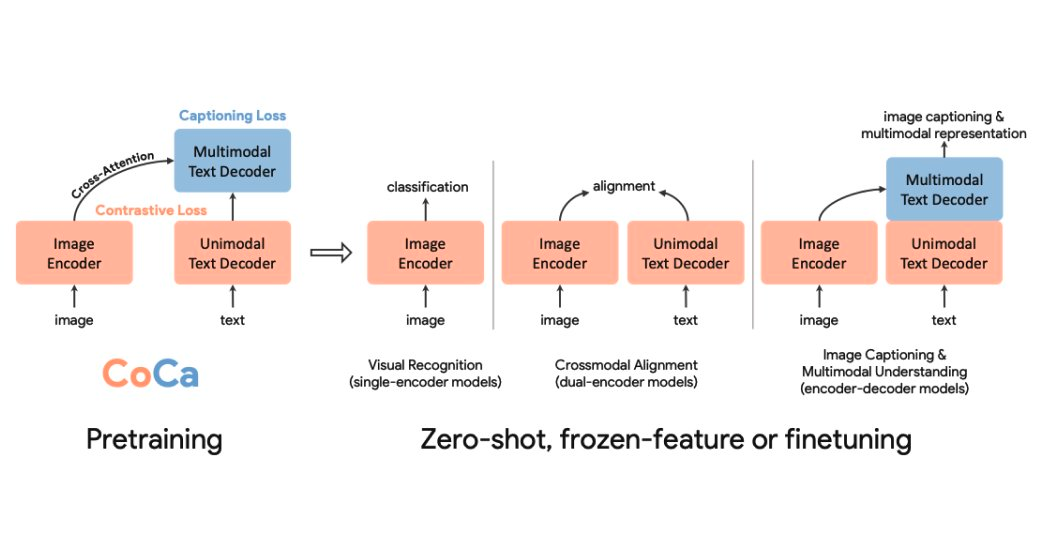
Fig-1 - Contrastive Captioner - (CoCa)
a ascensão dos modelos base
A ideia de modelos base não é nova em machine learning. No deep learning, as técnicas que viabilizam o treinamento desses modelos permitem adaptá-los no futuro para tarefas downstream. Em NLP, houve um boom de modelos base como o GPT e o BERT, treinados em dados ruidosos em escala de internet, que demonstraram notáveis capacidades de zero-shot e few-shot.
As pesquisas para construir modelos base de visão e visão-linguagem exploraram três caminhos principais: modelos de encoder único, modelos dual-encoder de imagem e texto com loss contrastivo e modelos encoder-decoder com objetivo generativo. Antes de mergulharmos no CoCa, vamos olhar essas linhas de pesquisa e seus pontos fracos.
glossário
- Modelos base. Modelos pré-treinados que servem como ponto de partida para diversas aplicações em machine learning, adaptáveis a tarefas específicas.
- Loss contrastivo. Função de perda que treina modelos para aprender representações semelhantes para pares de entrada semelhantes e dessemelhantes para pares diferentes.
- Interação cross-modal. Interação entre diferentes modalidades de dados (por exemplo, imagem e texto) para gerar uma representação conjunta.
- Arquitetura encoder-decoder. Estrutura de rede neural com um encoder para processar a entrada e um decoder para gerar a saída, usada em tarefas de sequência para sequência.
- Mascaramento causal. Técnica em transformers para impedir acesso a tokens futuros na sequência durante o treino.
- Mecanismo de atenção. Componente que permite aos modelos ponderar e priorizar partes diferentes da entrada ao processar informações.
- Zero-shot learning. Paradigma em que modelos fazem previsões ou classificações em classes de dados não vistas durante o treino.
- Visual Question Answering (VQA). Tarefa em que modelos respondem perguntas sobre o conteúdo de imagens, combinando visão computacional e processamento de linguagem natural.
- Representações unimodais e multimodais. Representações unimodais capturam informações de uma única modalidade de dados, enquanto as multimodais integram informações de várias modalidades.
- Contrastive Language-Image Pre-training (CLIP). Modelo treinado com aprendizado contrastivo para alinhar imagens e textos em um espaço de representação compartilhado.
modelos de encoder único
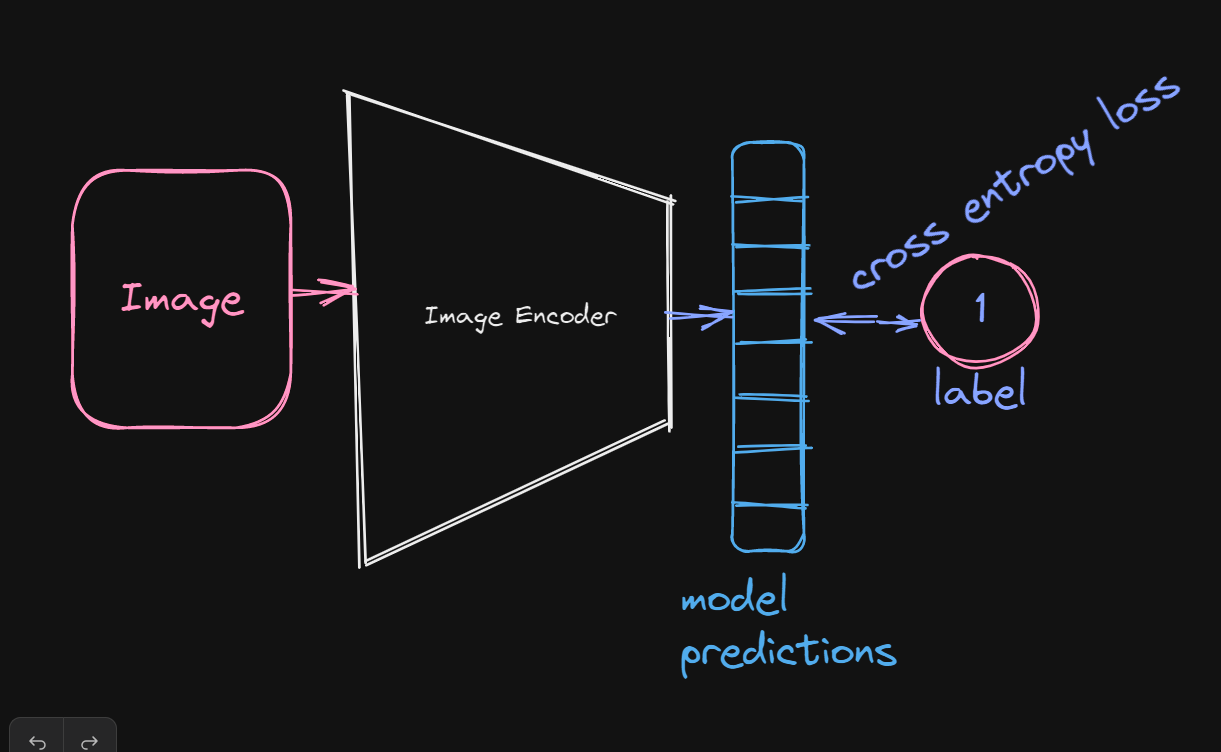
Se você já mexeu com visão computacional, provavelmente conhece essa classe de modelos. Eles aprendem representações de imagens que depois podem ser adaptadas a tarefas downstream de visão ao treinar em um grande conjunto de imagens anotadas com cross-entropy loss.
Esses modelos se mostram excelentes em tarefas de visão, como detecção, mas ficam aquém em tarefas de visão-linguagem por dependerem fortemente de anotações humanas, o que impede incorporar linguagem natural humana nas representações.
modelos dual-encoder de imagem e texto com loss contrastivo
Modelos populares dessa classe de modelos base de visão-linguagem incluem o CLIP (Contrastive Language-Image Pre-training) e o ALIGN.
Durante o pré-treinamento, aprende-se uma tarefa de alinhamento treinando conjuntamente um modelo de imagem e um de linguagem usando um loss contrastivo.
A ideia por trás do objetivo de pré-treinamento é simples: agrupar as representações de pares imagem-texto (relacionados) e afastar representações de imagens e textos que não são relacionados (pares negativos) no mesmo espaço latente. O modelo dual-encoder resultante pode então ser configurado para realizar tarefas de classificação zero-shot e busca de imagens.
Modelos recentes dessa classe, como o CLIP, alcançaram desempenhos impressionantes em várias tarefas de visão-linguagem, mas são praticamente inviáveis em tarefas que exigem representação fundida de imagens e textos, como VQA, pois aprendemos apenas a alinhar as representações de imagem e texto, e não a gerar uma representação unificada que codifique informações de ambas as entradas.
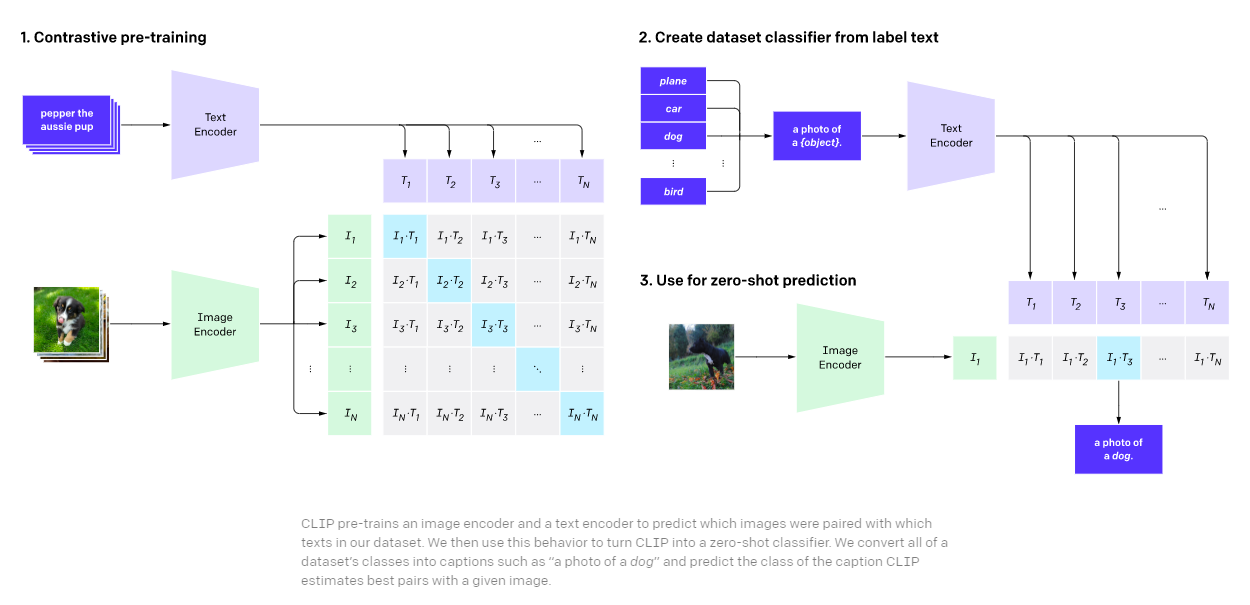
Fig-3 - Contrastive Language-Image Pre-training (CLIP)
pré-treinamento generativo com arquitetura encoder-decoder
Esses modelos empregam interação cross-modal entre as representações latentes de imagem e texto para gerar uma representação conjunta.
Durante o pré-treinamento, geramos uma representação unificada de imagem e texto por meio de interações cross-modais entre a representação latente de texto e a saída do encoder de imagem, e aplicamos uma perda de modelagem de linguagem na saída do decoder.
Nas arquiteturas modernas de machine learning, a interação cross-modal é feita principalmente via mecanismo de cross-attention em transformers, usando saídas do encoder de imagem como query e representações latentes de texto como key e value.
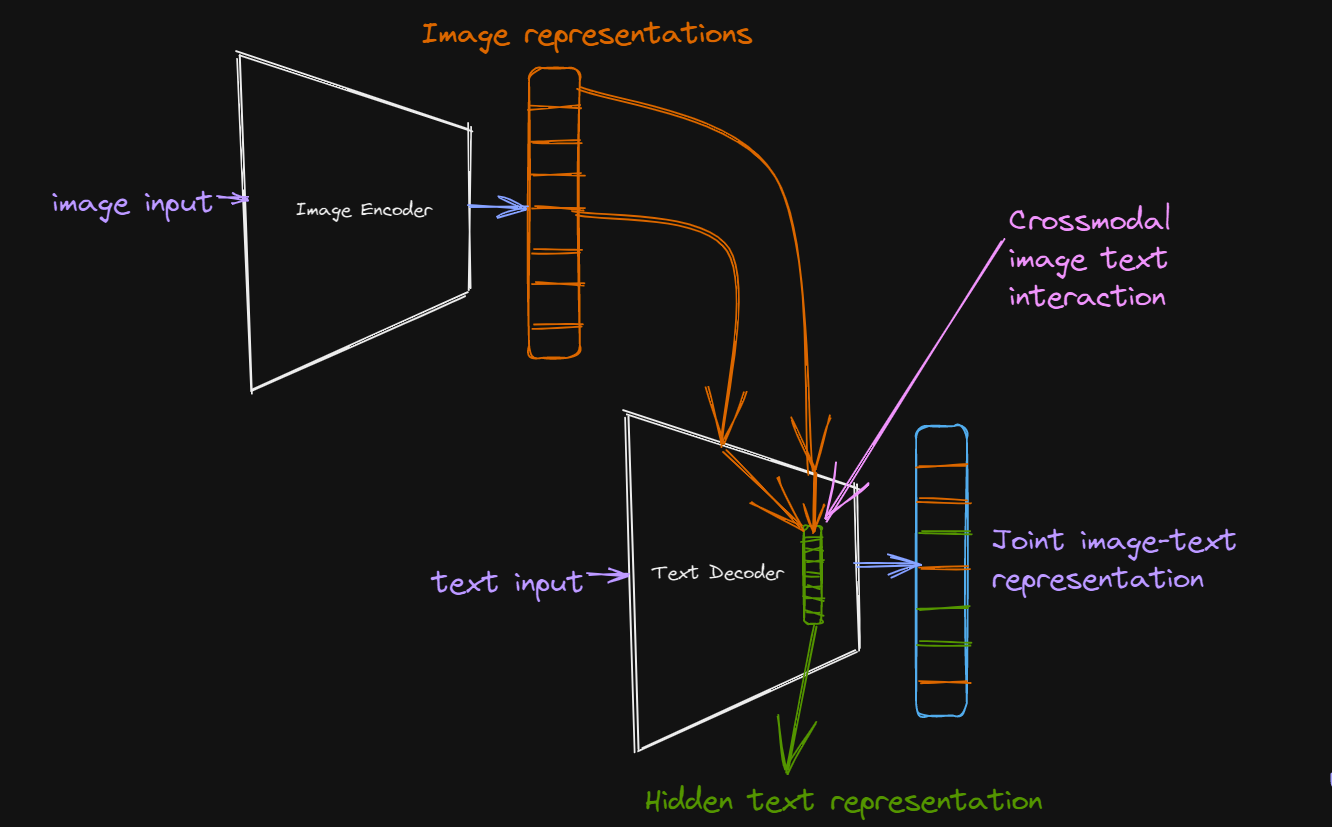
Para tarefas downstream, podemos usar a saída do decoder, que é uma representação conjunta de imagem e texto, e executar várias tarefas multimodais de compreensão imagem-texto, como Visual Question Answering. Um modelo recente que segue esse paradigma é o Simple Visual Language Model (SIMVLM).
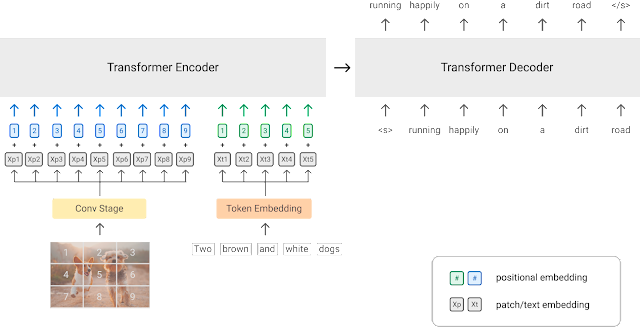
Fig-5 - Simple Visual Language Model (SIMVLM)
motivação por trás do CoCa
Os autores do CoCa buscaram reunir, em um modelo simples, as capacidades dos diferentes paradigmas de construção de modelos base de imagem e texto. O CoCa combina um loss contrastivo para aprender a alinhar representações de imagem e texto em um único espaço vetorial e um objetivo generativo (captioning loss) para aprender uma representação conjunta imagem-texto, incorporando assim as capacidades de modelos como CLIP e SIMVLM em um único modelo.
arquitetura do modelo
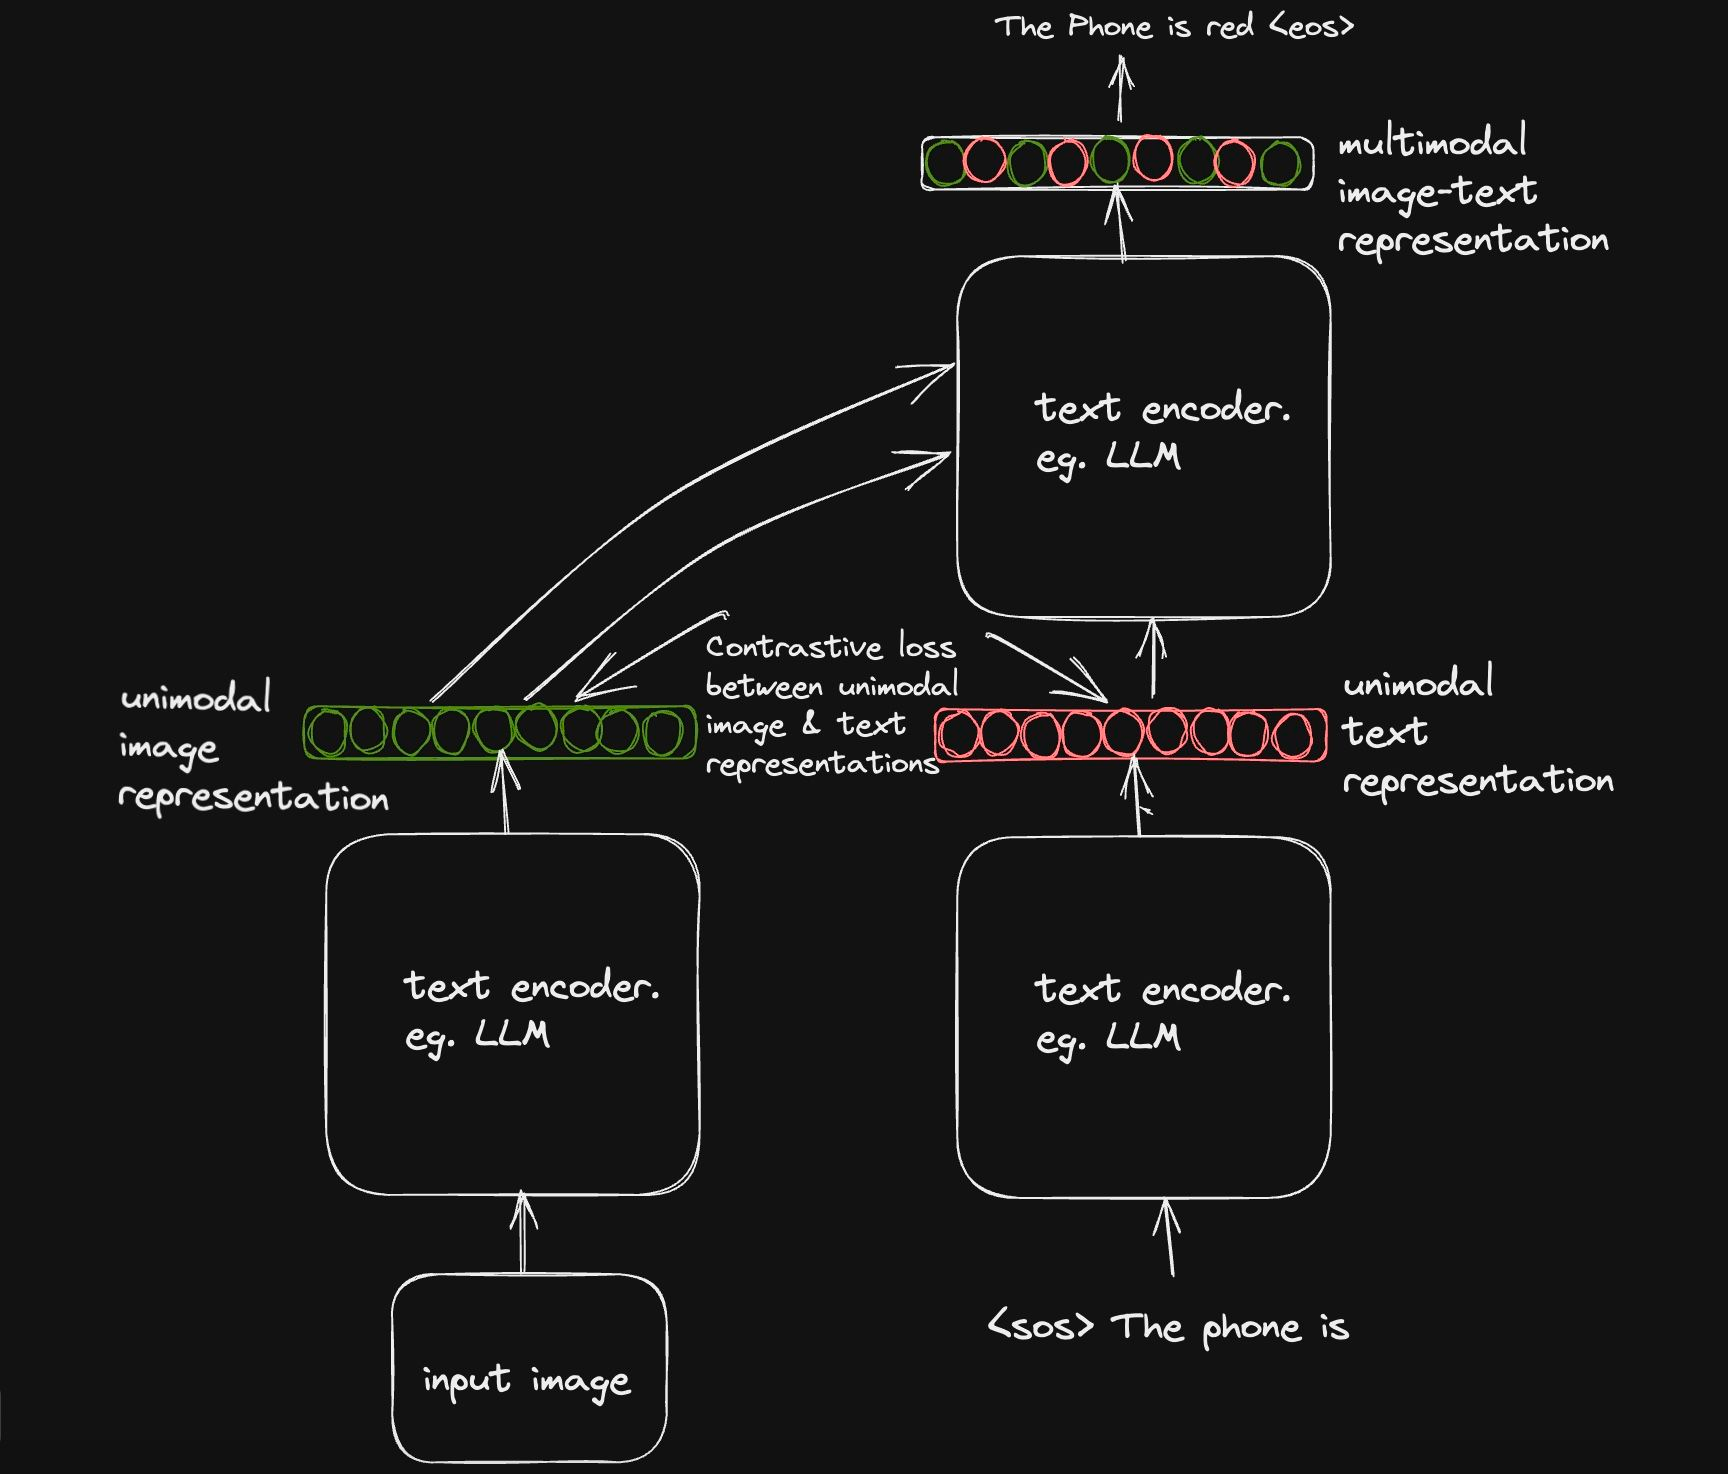
O CoCa segue a abordagem padrão encoder-decoder e, como a maioria dos modelos desse tipo, codifica a imagem com uma rede neural como uma rede neural convolucional ou um transformer.
A originalidade da arquitetura do CoCa começa na saída do encoder e em toda a configuração do decoder.
Lembre que o objetivo do artigo do CoCa é combinar as capacidades de dois paradigmas de modelos visão-linguagem (objetivo contrastivo e generativo) em um único modelo. O paradigma contrastivo exige que nosso decoder de texto produza uma representação de texto unimodal, que então é projetada para um espaço vetorial semelhante ao da representação de imagem para aprender a tarefa de alinhamento.
O objetivo generativo, por sua vez, permite que o decoder receba representações de imagem vindas do encoder e gere texto de forma autorregressiva condicionado nas representações de imagem e na entrada de texto.
Vale notar que ambas as partes do decoder aplicam mascaramento causal para impedir que o modelo olhe para tokens futuros.
Para conseguir isso, os autores adaptaram de forma inteligente uma configuração de decoder desacoplada: a primeira parte aprende a produzir uma representação de texto unimodal para o objetivo contrastivo e a segunda parte aprende a gerar uma representação multimodal imagem-texto.
objetivo contrastivo
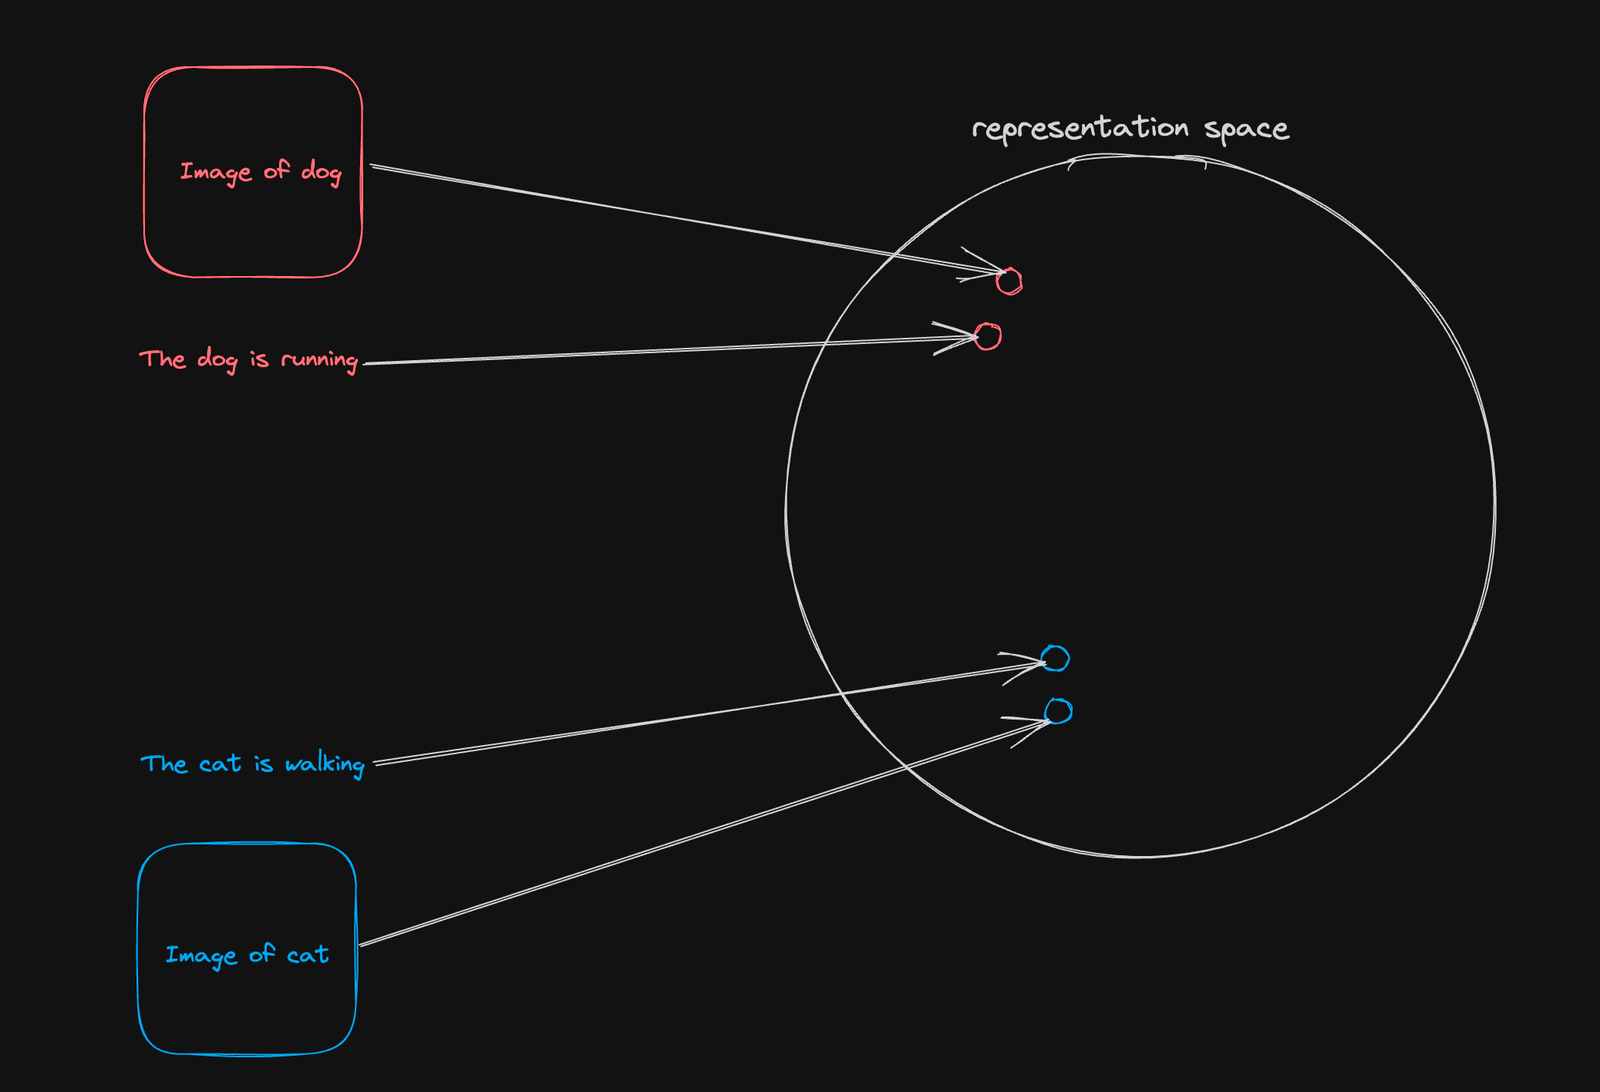
A ideia por trás do objetivo contrastivo, usada em vários modelos como CLIP e ALIGN, é simples: aprender representações para diferentes modalidades, como imagem e texto, de modo que pares semelhantes fiquem próximos no espaço de representação e pares diferentes fiquem afastados.
A cada passo de treino, amostramos pares imagem-texto do dataset e ajustamos os pesos dos encoders para agrupar os pares positivos e afastar os negativos.
Como mencionado, o objetivo contrastivo requer representações unimodais de imagem e texto. Para isso, no lado do encoder/decoder de texto aplicamos uma técnica clássica usada no BERT.
Como parte da sequência de entrada, introduzimos um token de classificação aprendível [CLS] no final da sequência e esperamos que o vetor de saída mapeado para esse token capture o significado semântico de toda a entrada.
Como nossos decoders aplicam mascaramento causal em seus mapas de atenção, colocar o token de classificação no fim da sequência garante conexão de atenção entre o token de classificação e todos os demais tokens da entrada, capturando assim o significado semântico da frase inteira.
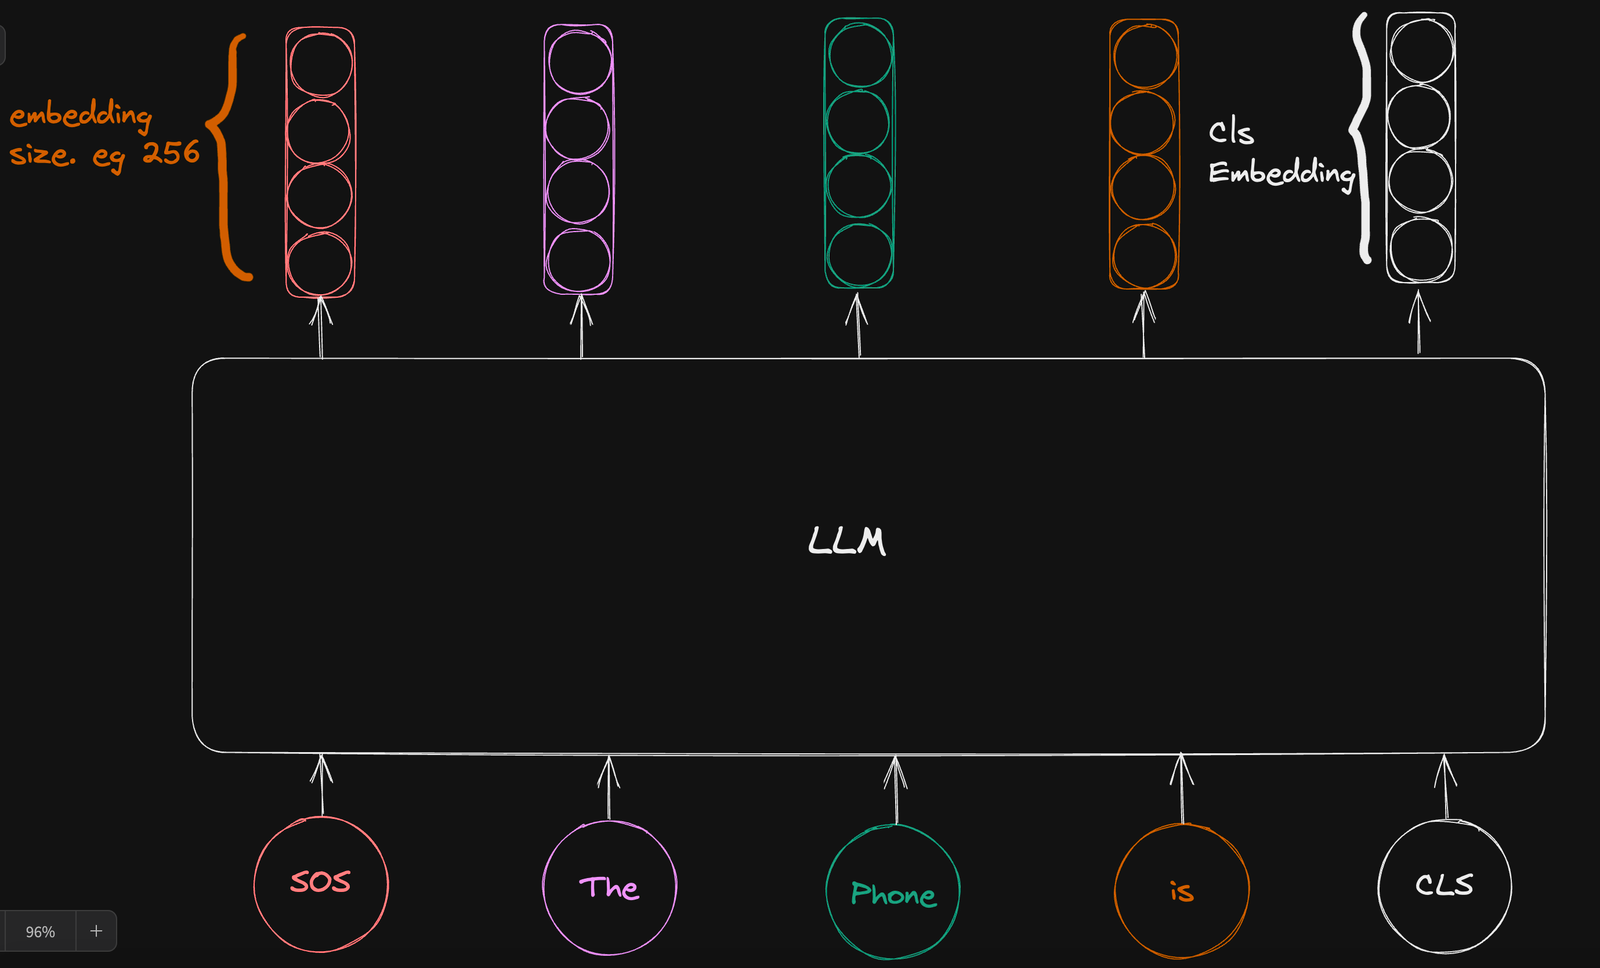
Ignoramos a representação vetorial dos outros tokens de entrada e usamos a representação do token de classificação para estimar o loss contrastivo.
Do lado do encoder de imagem, as coisas são um pouco diferentes.
Na imagem da Fig-6, dá para ver que parte da saída do encoder de imagem é usada junto com o embedding do token de classificação para estimar o loss contrastivo, e parte é enviada para a parte superior da configuração desacoplada para estimar a representação conjunta.
Na prática, basta um único embedding de saída da imagem para estimar o objetivo contrastivo, enquanto toda a sequência de embeddings de saída do encoder de imagem é usada para estimar o objetivo generativo.
Os autores argumentam que, empiricamente, um único embedding "pooled" ajuda a capturar a representação global da imagem (exatamente o que queremos para o objetivo contrastivo), e uma sequência de embeddings ajuda em tarefas que exigem uma representação mais detalhada da imagem.
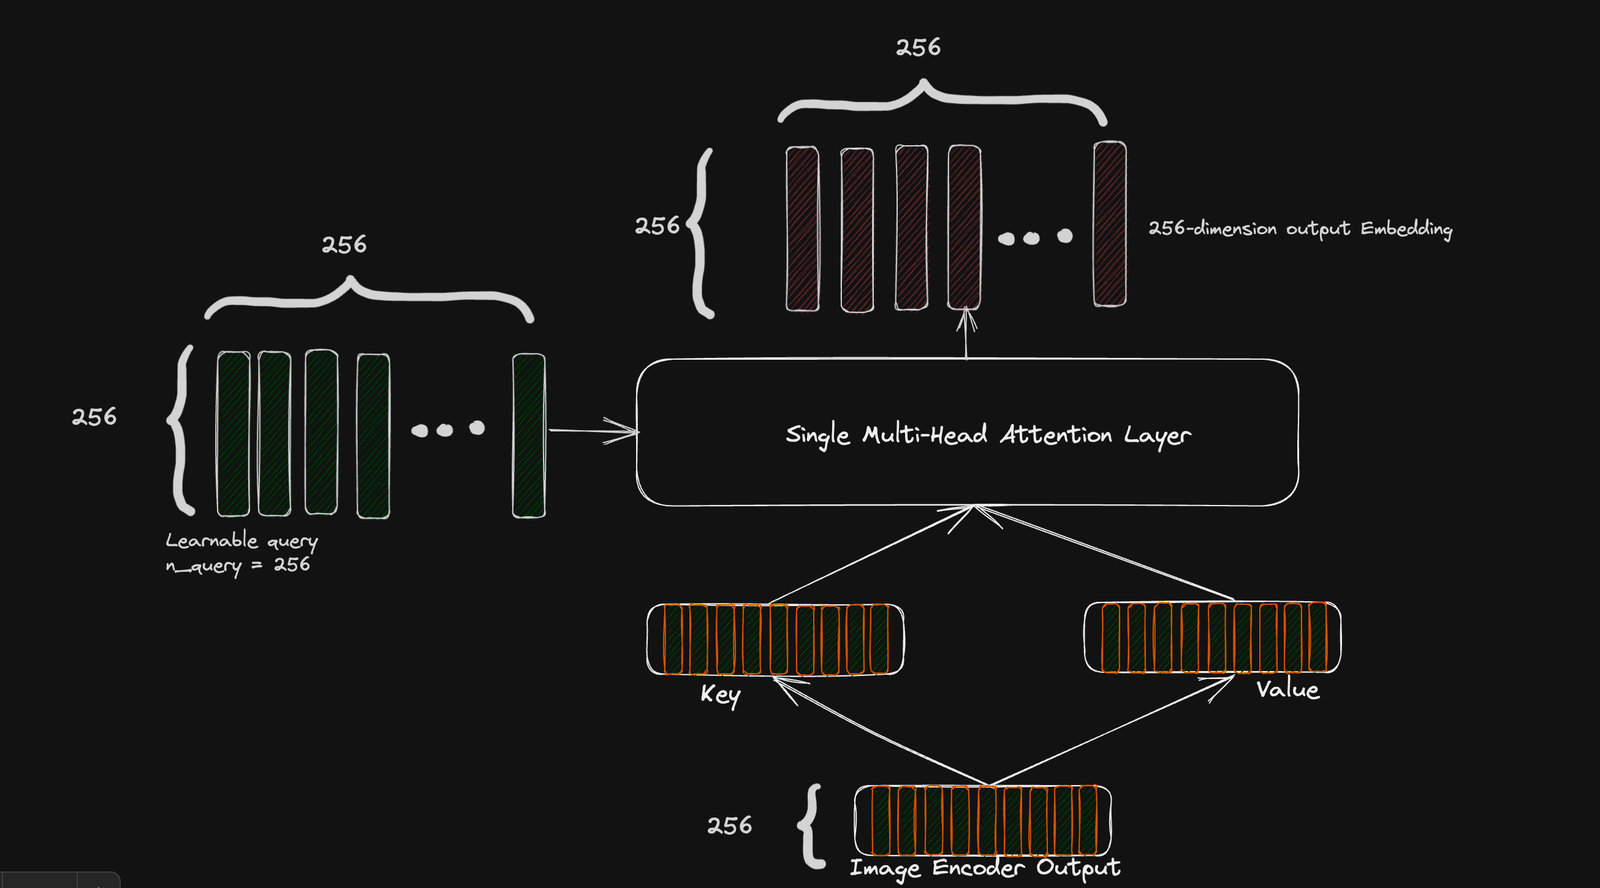
Para isso, emprega-se uma camada de attention pooling, que é uma única camada de multi-head attention, para adaptar a saída do encoder de imagem a objetivos diferentes por meio de um parâmetro de query aprendível. Ao definir o parâmetro de query para um valor inteiro específico, ajustamos todo o encoder para emitir uma sequência de embeddings cujo comprimento é esse parâmetro.
No caso do objetivo contrastivo, definimos o parâmetro de query como 1 para obter um único embedding e calcular o loss contrastivo; já no objetivo generativo, definimos para um valor arbitrário, idealmente igual ao comprimento da sequência de texto. No artigo do CoCa, os autores escolheram 256 para o objetivo generativo.
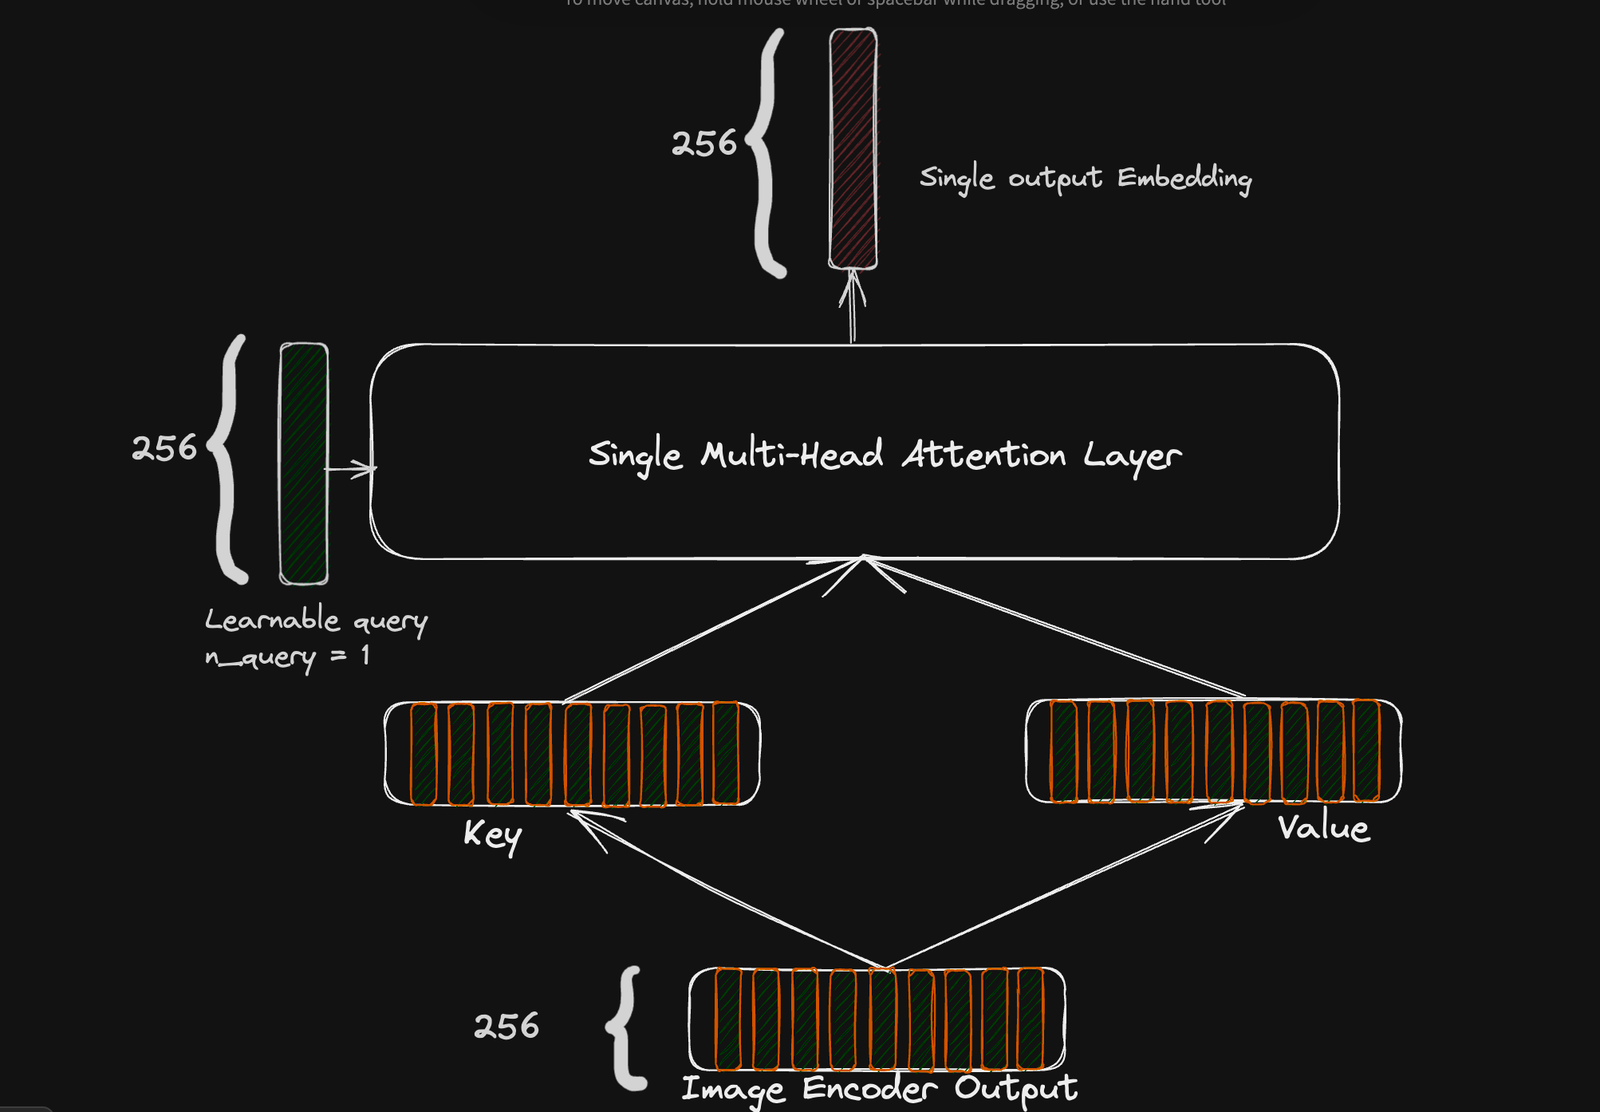
Configuração de attention pooling para loss contrastivo. A saída da camada de atenção é um único embedding de 256 dimensões.
objetivo generativo
Ao contrário do objetivo contrastivo, que exige apenas uma representação global da imagem, o objetivo generativo funciona melhor quando geramos uma representação mais detalhada da imagem.
Como já explicado, obtemos a representação detalhada da imagem definindo o parâmetro de query para um número arbitrário (256 no artigo do CoCa), o que gera uma representação rica de 256 x 256 da imagem.
Essa representação é enviada para a parte superior da configuração de decoder desacoplada e, por meio da interação cross-modal com a representação de texto unimodal (ignorando a representação do CLS), obtemos uma representação unificada imagem-texto, usada para prever uma distribuição de probabilidade do vocabulário via fatoração autorregressiva.
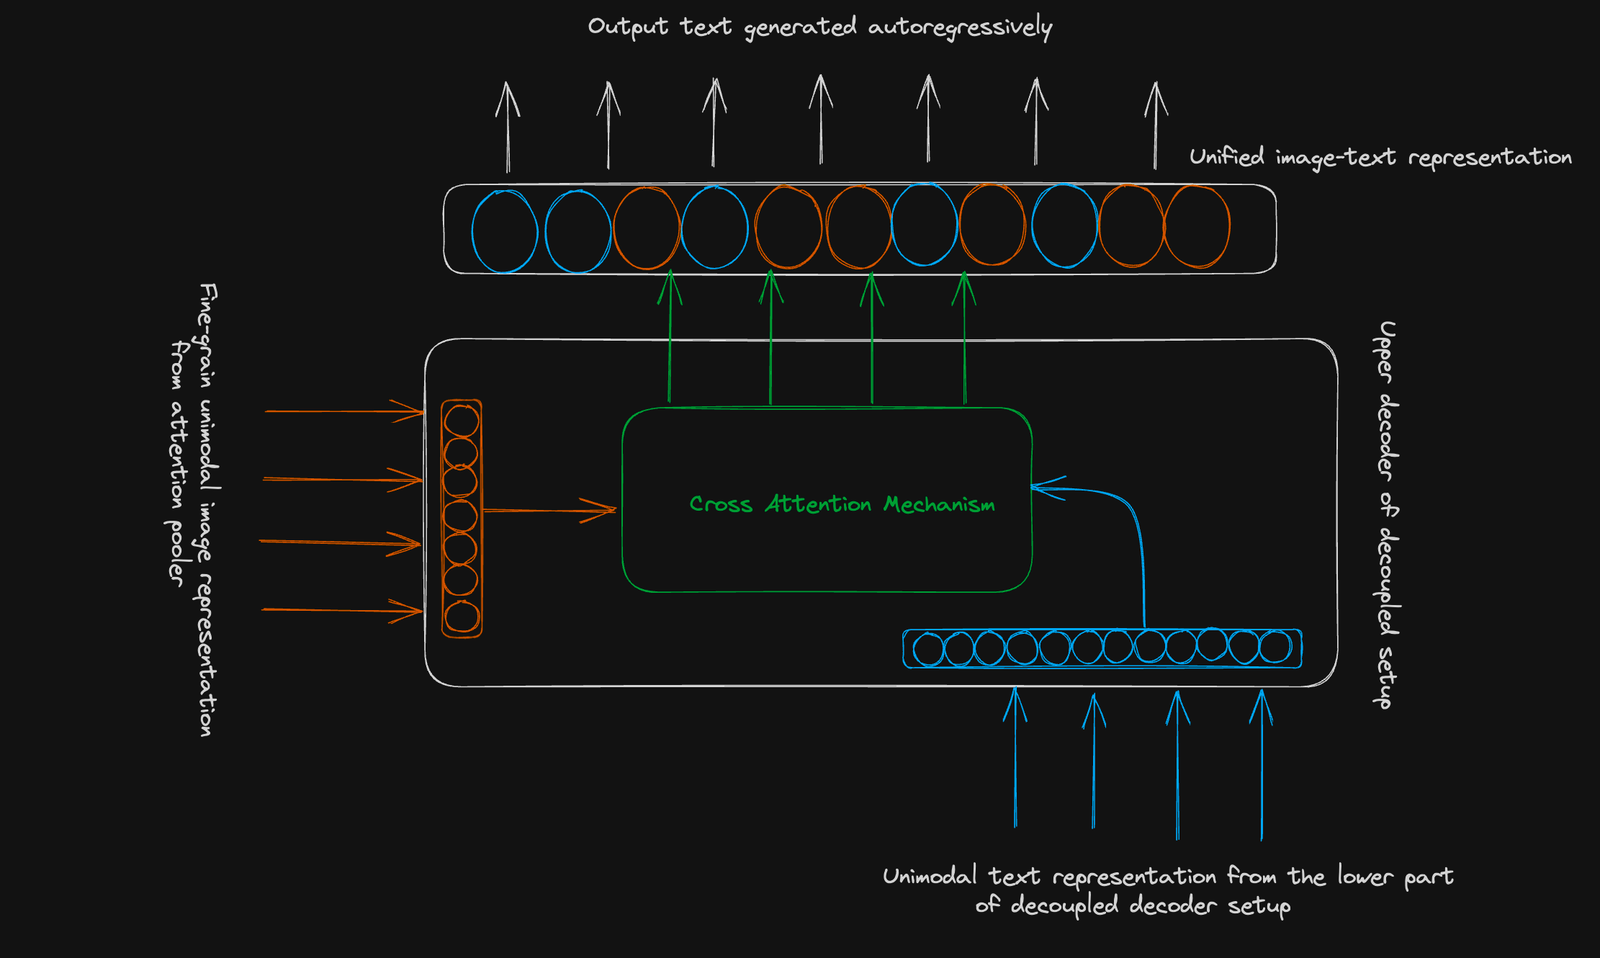
Como vimos nas duas seções anteriores, a configuração arquitetural do CoCa permite incorporar as capacidades de uma classe de modelos que brilham em tarefas de zero-shot learning, como classificação de imagens e recuperação cross-modal, e de outra classe que se destaca em VQA e legendagem de imagens. O CoCa também pode ser ajustado (fine-tuned) para várias tarefas downstream de visão e linguagem.
considerações finais
O surgimento de modelos base como o CoCa marca um avanço importante em machine learning. O CoCa reúne pontos fortes de diversos paradigmas, oferecendo um modelo unificado capaz de alinhar representações de imagem e texto e gerar representações conjuntas imagem-texto.
Esse modelo mostra o potencial de integrar objetivos contrastivos e generativos, abrindo caminho para melhor desempenho em tarefas como Visual Question Answering e legendagem de imagens. Ele reúne as capacidades de modelos que se destacam em zero-shot learning e de modelos especializados em compreensão multimodal imagem-texto, entregando uma ferramenta versátil para inúmeras tarefas downstream de visão e linguagem.
Se você quer se aprofundar em conceitos avançados de machine learning e explorar a fundo os detalhes de deep learning, o curso Advanced Deep Learning with Keras da DataCamp vai te equipar com o conhecimento e as habilidades para resolver uma variedade de problemas usando a versátil Keras Functional API, permitindo explorar e entender modelos avançados como o CoCa e seus princípios em maior profundidade.