Bu eğitim içeriği topluluğumuzun değerli bir katkısıdır ve DataCamp tarafından açıklık ve doğruluk için düzenlenmiştir.
Kendi uzmanlığınızı paylaşmakla ilgileniyor musunuz? Sizden haber almak isteriz! Makalelerinizi veya fikirlerinizi Topluluk Katkı Formumuz aracılığıyla iletebilirsiniz.
Makine öğrenmesinin evrimi, kapsamlı veriler üzerinde önceden eğitilen ve sayısız uygulama için çok yönlü bir temel işlevi gören bir model sınıfı olan temel modellerin geliştirilmesine yol açtı. Doğal Dil İşleme (NLP) alanında GPT ve BERT gibi örneklerle somutlaşan bu modeller, sıfır-atış ve az-atış öğrenme gibi görevlerde eşi benzeri görülmemiş yetenekler sergiledi.
Bu yazıda, görüntü-metin temel modellerinin dünyasına dalıyor ve yenilikçi Contrastive Captioner (CoCa) modelini inceliyoruz. Mimarisini parçalara ayıracak, karşıtlıkçı ve üretimsel hedefleri birleştiren benzersiz yaklaşımını anlayacak ve CLIP ile SIMVLM gibi modellerin yeteneklerini tek, bütünlüklü bir modelde nasıl gömdüğünü göreceğiz.
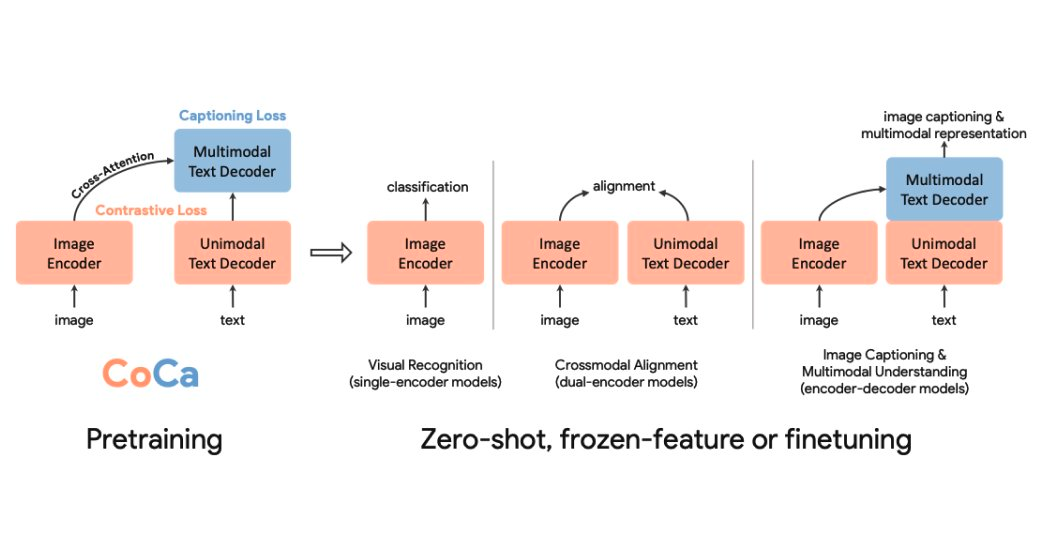
Şekil-1 - Contrastive Captioner - (CoCa)
Temel Modellerin Yükselişi
Temel modeller fikri makine öğrenmesinde yeni değil. Derin öğrenmede, bu modellerin eğitilmesini mümkün kılan teknikler, gelecekte aşağı akış görevler için modelleri uyarlamamıza olanak tanır. NLP’de, gürültülü internet ölçeğinde veriler üzerinde eğitilen GPT ve BERT gibi temel modellerde bir patlama yaşandı; bu modeller, dikkat çekici sıfır-atış ve az-atış yetenekleri sergiledi.
Görüş ve görüş-dil temel modelleri inşa etmeye yönelik araştırmalar, üç ana yolu keşfetti: tek kodlayıcılı (single-encoder) modeller, karşıtlıkçı kayıplı görüntü-metin çift kodlayıcılı (dual-encoder) modeller ve üretimsel hedefli kodlayıcı-çözücü (encoder-decoder) modeller. CoCa modelini incelemeden önce, temel modelleri inşa etmeye yönelik bu araştırma çizgilerine ve zayıf yönlerine bir göz atalım.
Sözlük
- Temel Modeller. Makine öğrenmesinde çeşitli uygulamalar için başlangıç noktası olarak hizmet veren, belirli görevlere uyarlanabilir önceden eğitilmiş modeller.
- Karşıtlıkçı Kayıp (Contrastive Loss). Benzer giriş çiftleri için benzer, benzer olmayanlar için farklı temsilleri öğrenmek üzere modelleri eğiten bir kayıp işlevi.
- Çapraz-Mod (Cross-Modal) Etkileşim. Farklı veri kiplerinin (ör. görüntü ve metin) ortak bir gösterim üretmek üzere etkileşime girmesi.
- Kodlayıcı-Çözücü Mimarisi. Girdi verisini işleyen bir kodlayıcı ve çıktıyı üreten bir çözücü içeren, sıradan sıraya (sequence-to-sequence) görevlerde kullanılan sinir ağı yapısı.
- Nedensel Maskeleme. Eğitim sırasında modelin dizideki gelecekteki belirteçlere erişmesini engelleyen dönüştürücü (transformer) tekniği.
- Dikkat (Attention) Mekanizması. Modellerin bilgi işlerken girdinin farklı kısımlarını tartmasına ve önceliklendirmesine olanak tanıyan bileşen.
- Sıfır-Atış Öğrenme. Modellerin eğitim sırasında görmediği veri sınıflarında tahmin veya sınıflandırma yaptığı öğrenme paradigması.
- Görsel Soru Cevaplama (VQA). Modellerin görüntülerin içeriği hakkında soruları yanıtladığı; bilgisayarlı görü ile doğal dil işlemenin birleştirildiği görev.
- Tek Kipli ve Çok Kipli Temsiller. Tek kipli temsiller tek bir veri kipinden bilgi yakalarken, çok kipli temsiller birden fazla kipten bilgiyi bütünleştirir.
- Karşıtlıkçı Dil-Görüntü Ön-eğitimi (CLIP). Görüntüler ve metni ortak bir gösterim uzayında hizalamak için karşıtlıkçı öğrenme kullanan bir model.
Tek Kodlayıcılı Modeller
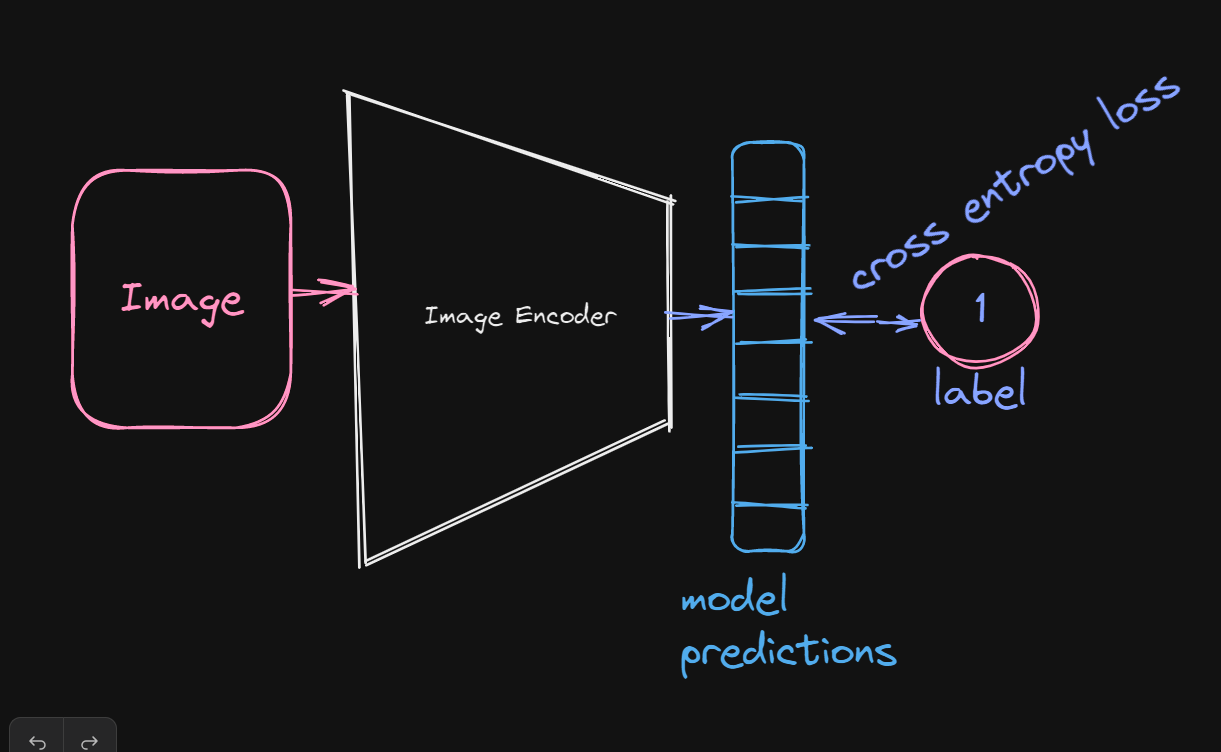
Daha önce bilgisayarlı görüyle ilgilendiyseniz, muhtemelen bu model sınıfına denk gelmişsinizdir. Bu modeller, çapraz-entropi kaybı ile etiketli büyük bir görüntü veri kümesi üzerinde eğitilerek, daha sonra aşağı akış görsel görevler için uyarlanabilecek görüntü temsilleri öğrenir.
Bu modellerin tespit gibi görsel görevlerde deneysel olarak üstün olduğu gösterilmiştir; ancak yoğun biçimde insan açıklamalarına dayanması nedeniyle, doğal dili içkinleştirmeyi engellediğinden, görsel-dil içeren görevlerde daha zayıf kalırlar.
Karşıtlıkçı Kayıplı Görüntü-Metin Çift Kodlayıcılı Modeller
Bu tür görsel-dil temel modellerinin popüler örnekleri arasında CLIP (Contrastive Language-Image Pre-training) ve ALIGN bulunur.
Ön-eğitim sırasında, bir görüntü ve bir dil modelini karşıtlıkçı bir kayıpla birlikte eğiterek bir hizalama görevi öğreniriz.
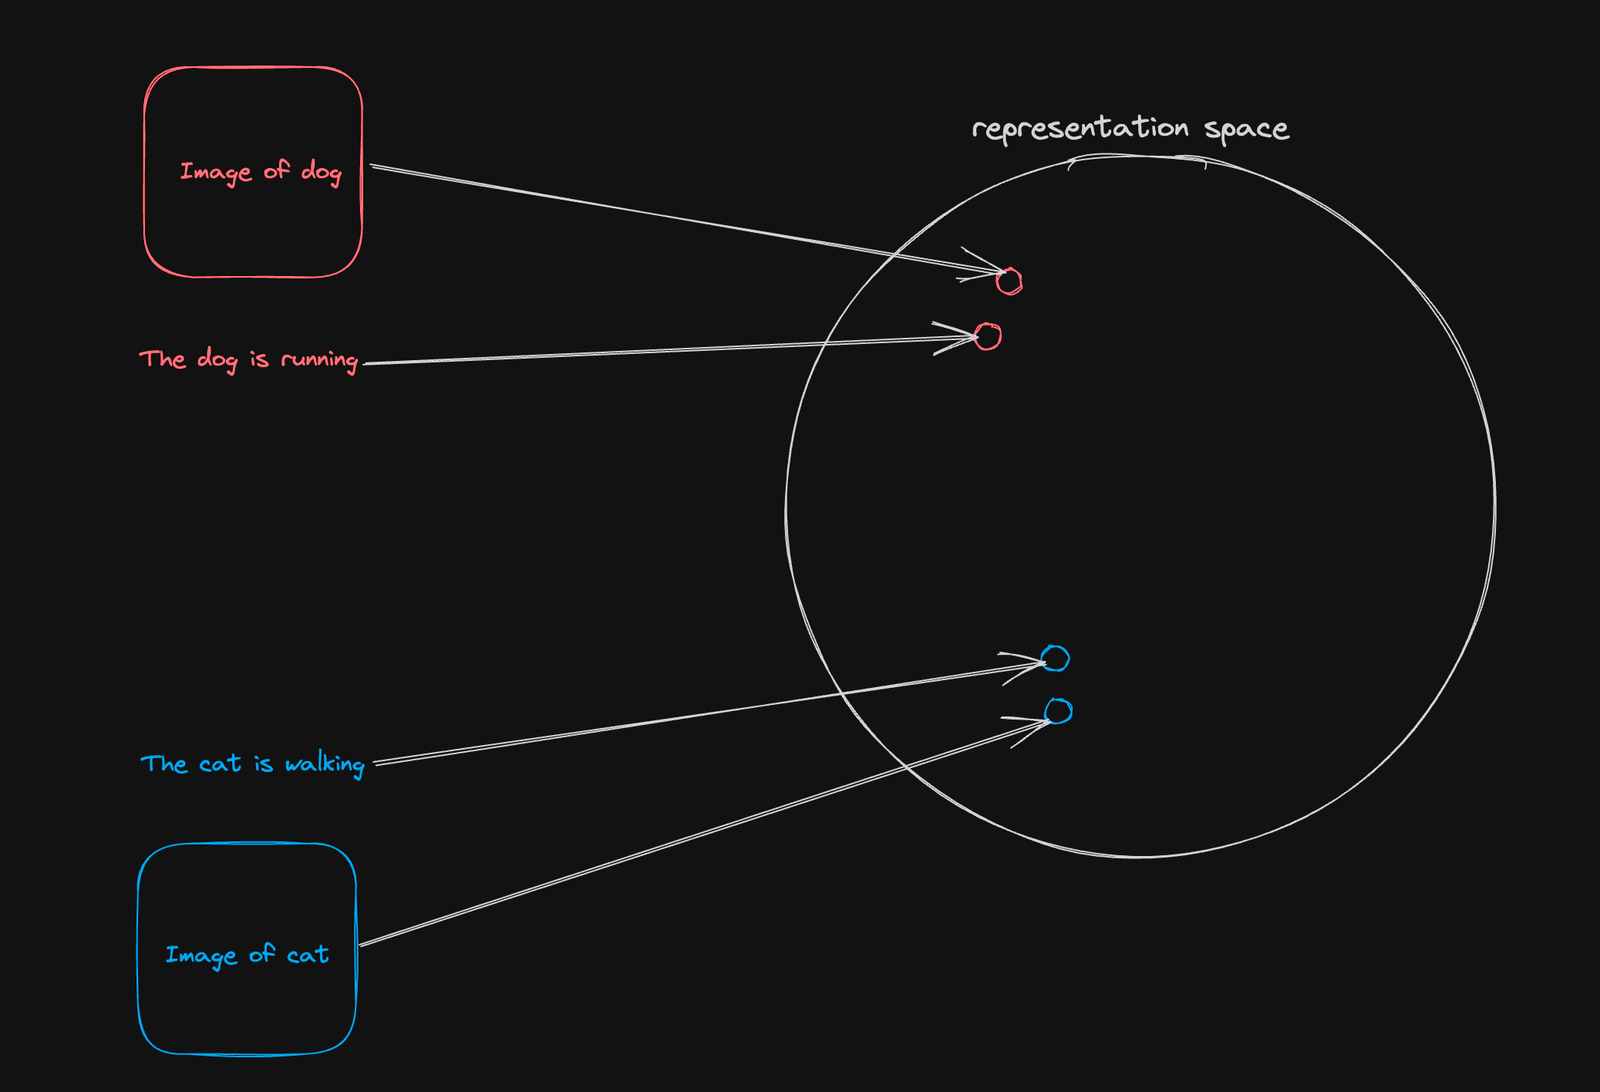
Ön-eğitim hedeflerinin ardındaki fikir oldukça basittir: aynı gizil uzayda ilişkili görüntü-metin çiftlerinin temsillerini kümelerken, ilişkili olmayan görüntü ve metinlerin (çift olmayanların) temsillerini birbirinden uzaklaştırmak. Ortaya çıkan çift kodlayıcılı model, sıfır-atış sınıflandırma görevleri ve görüntü getirme için yapılandırılabilir.
CLIP gibi bu sınıftaki son modeller, çeşitli görsel-dil görevlerinde dikkat çekici performanslara ulaşmıştır; ancak yalnızca görüntü ve metin temsillerini hizalamayı, her iki girdinin bilgisini kodlayan birleşik bir temsil üretmeyi değil, öğrendikleri için; görsel soru cevaplama gibi, görüntü ve metnin kaynaşmış temsilini gerektiren görevlerde neredeyse kullanılamazlar.
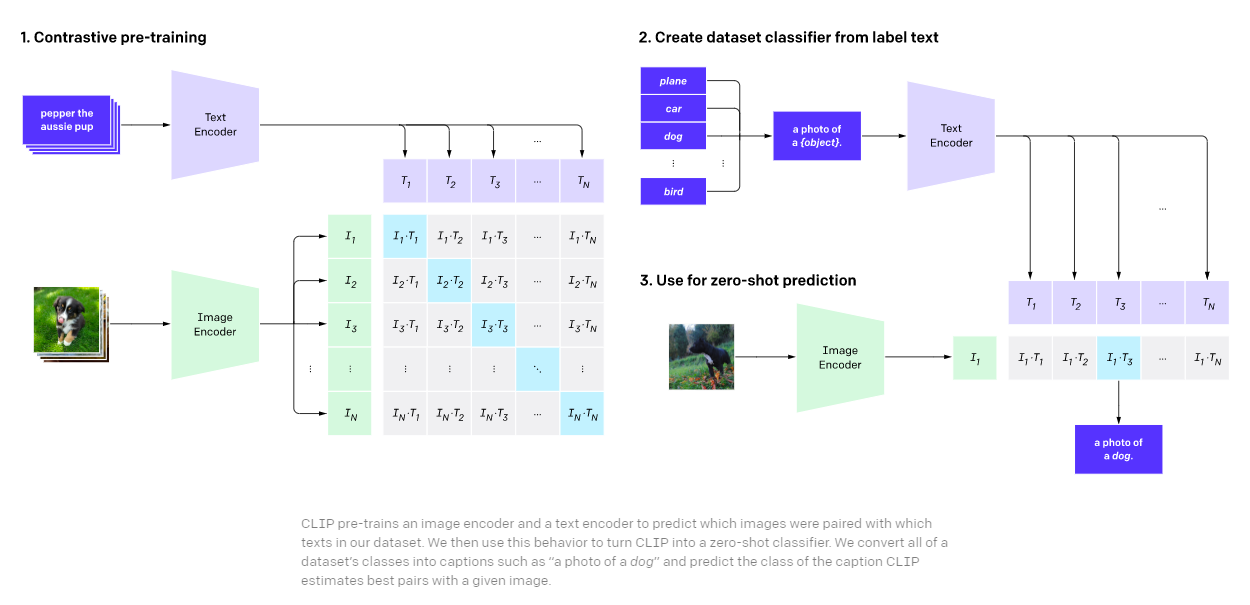
Şekil-3 - Karşıtlıkçı Dil-Görüntü Ön-eğitimi (CLIP)
Kodlayıcı-Çözücü Mimarisiyle Üretimsel Ön-eğitim
Bu modeller, ortak bir temsil üretmek için görüntü ve metnin gizli temsilleri arasında çapraz-mod etkileşim kullanır.
Ön-eğitim sırasında, gizli metin temsili ile görüntü kodlayıcının çıktısı arasındaki çapraz-mod etkileşimler yoluyla görüntü ve metnin birleşik bir temsilini üretir ve çözücü çıktısı üzerinde bir Dil Modellemesi kaybı uygularız.
Güncel makine öğrenmesi mimarisinde, çapraz-mod etkileşim çoğunlukla dönüştürücülerde çapraz-dikkat (cross-attention) mekanizmasıyla, görüntü kodlayıcı çıktıları sorgu (query) ve gizli metin temsilleri anahtar (key) ve değer (value) olarak kullanılarak gerçekleştirilir.
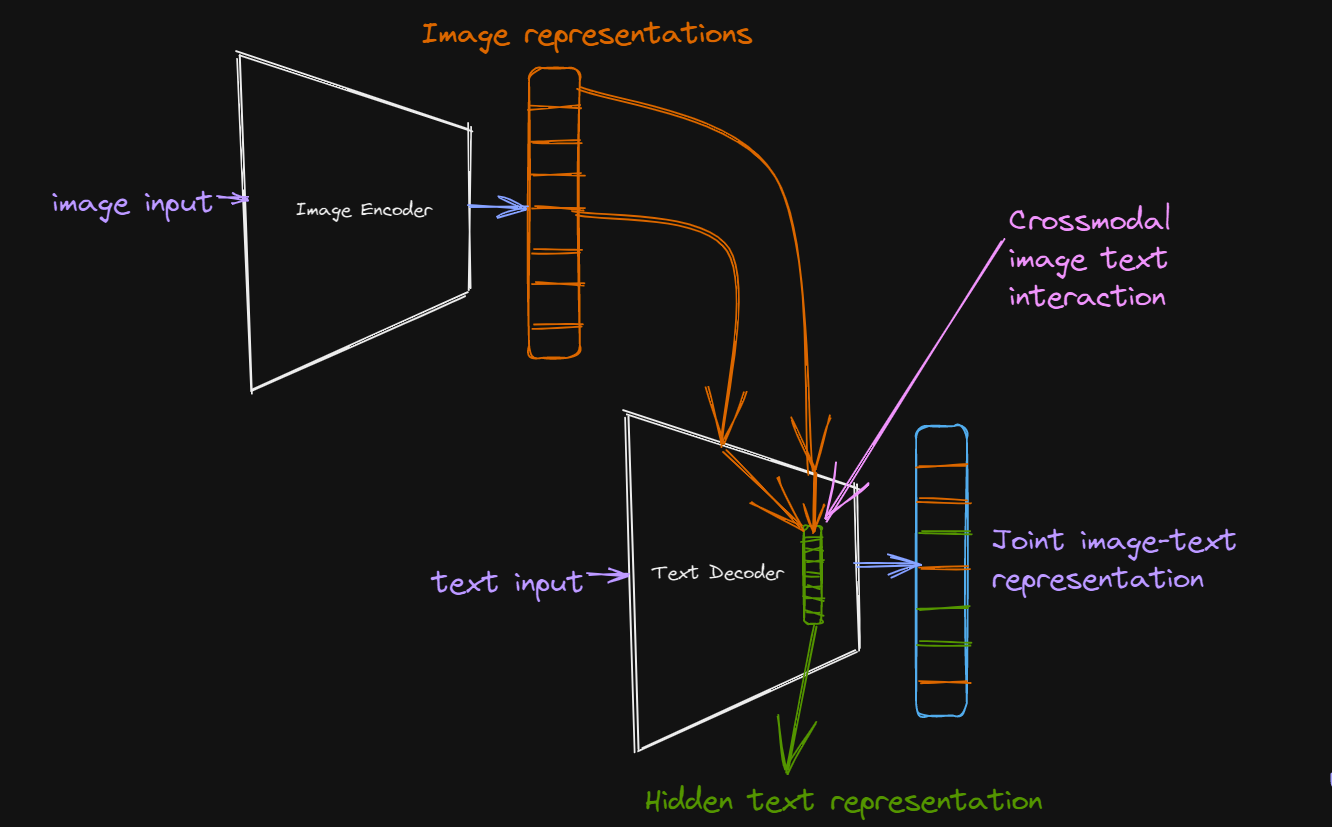
Aşağı akış görevleri için, görüntü ve metnin birleşik temsili olan çözücü çıktısını alıp Görsel Soru Cevaplama gibi çeşitli çok kipli görüntü-metin anlama görevlerini gerçekleştirebiliriz. Bu paradigmayı kullanan yakın tarihli bir model, Basit Görsel Dil Modeli’dir (SIMVLM).
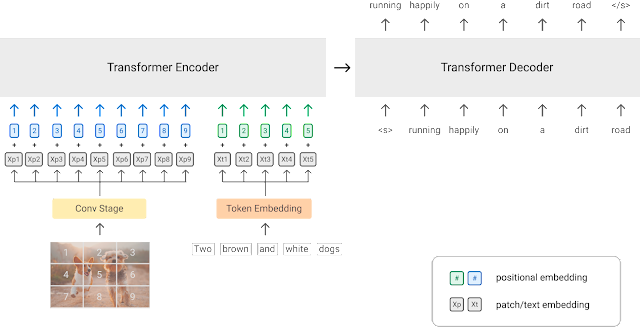
Şekil-5 - Basit Görsel Dil Modeli (SIMVLM)
CoCa’nın Arkasındaki Motivasyon
CoCa modelinin yazarları, görüntü-metin temel modelleri inşa etmenin farklı paradigmalarının yeteneklerini basit bir modelde toplamayı amaçladı. CoCa’nın tasarımı, görüntü ve metin temsillerini tek bir vektör uzayında hizalamayı öğrenmek için karşıtlıkçı kaybı ve birleşik bir görüntü-metin temsili öğrenmek için üretimsel hedefi (altyazılama kaybı) kullanır; böylece CLIP ve SIMVLM gibi modellerin yeteneklerini tek bir modele gömer.
Model Mimarisi
CoCa, standart kodlayıcı-çözücü yaklaşımını benimser ve bu tür modellerin çoğunda olduğu gibi, görüntüyü bir evrişimli sinir ağı ya da bir dönüştürücü gibi bir sinir ağıyla kodlar.
CoCa mimarisinin özgünlüğü, kodlayıcısının çıktısında ve tüm çözücü kurulumunda başlar.
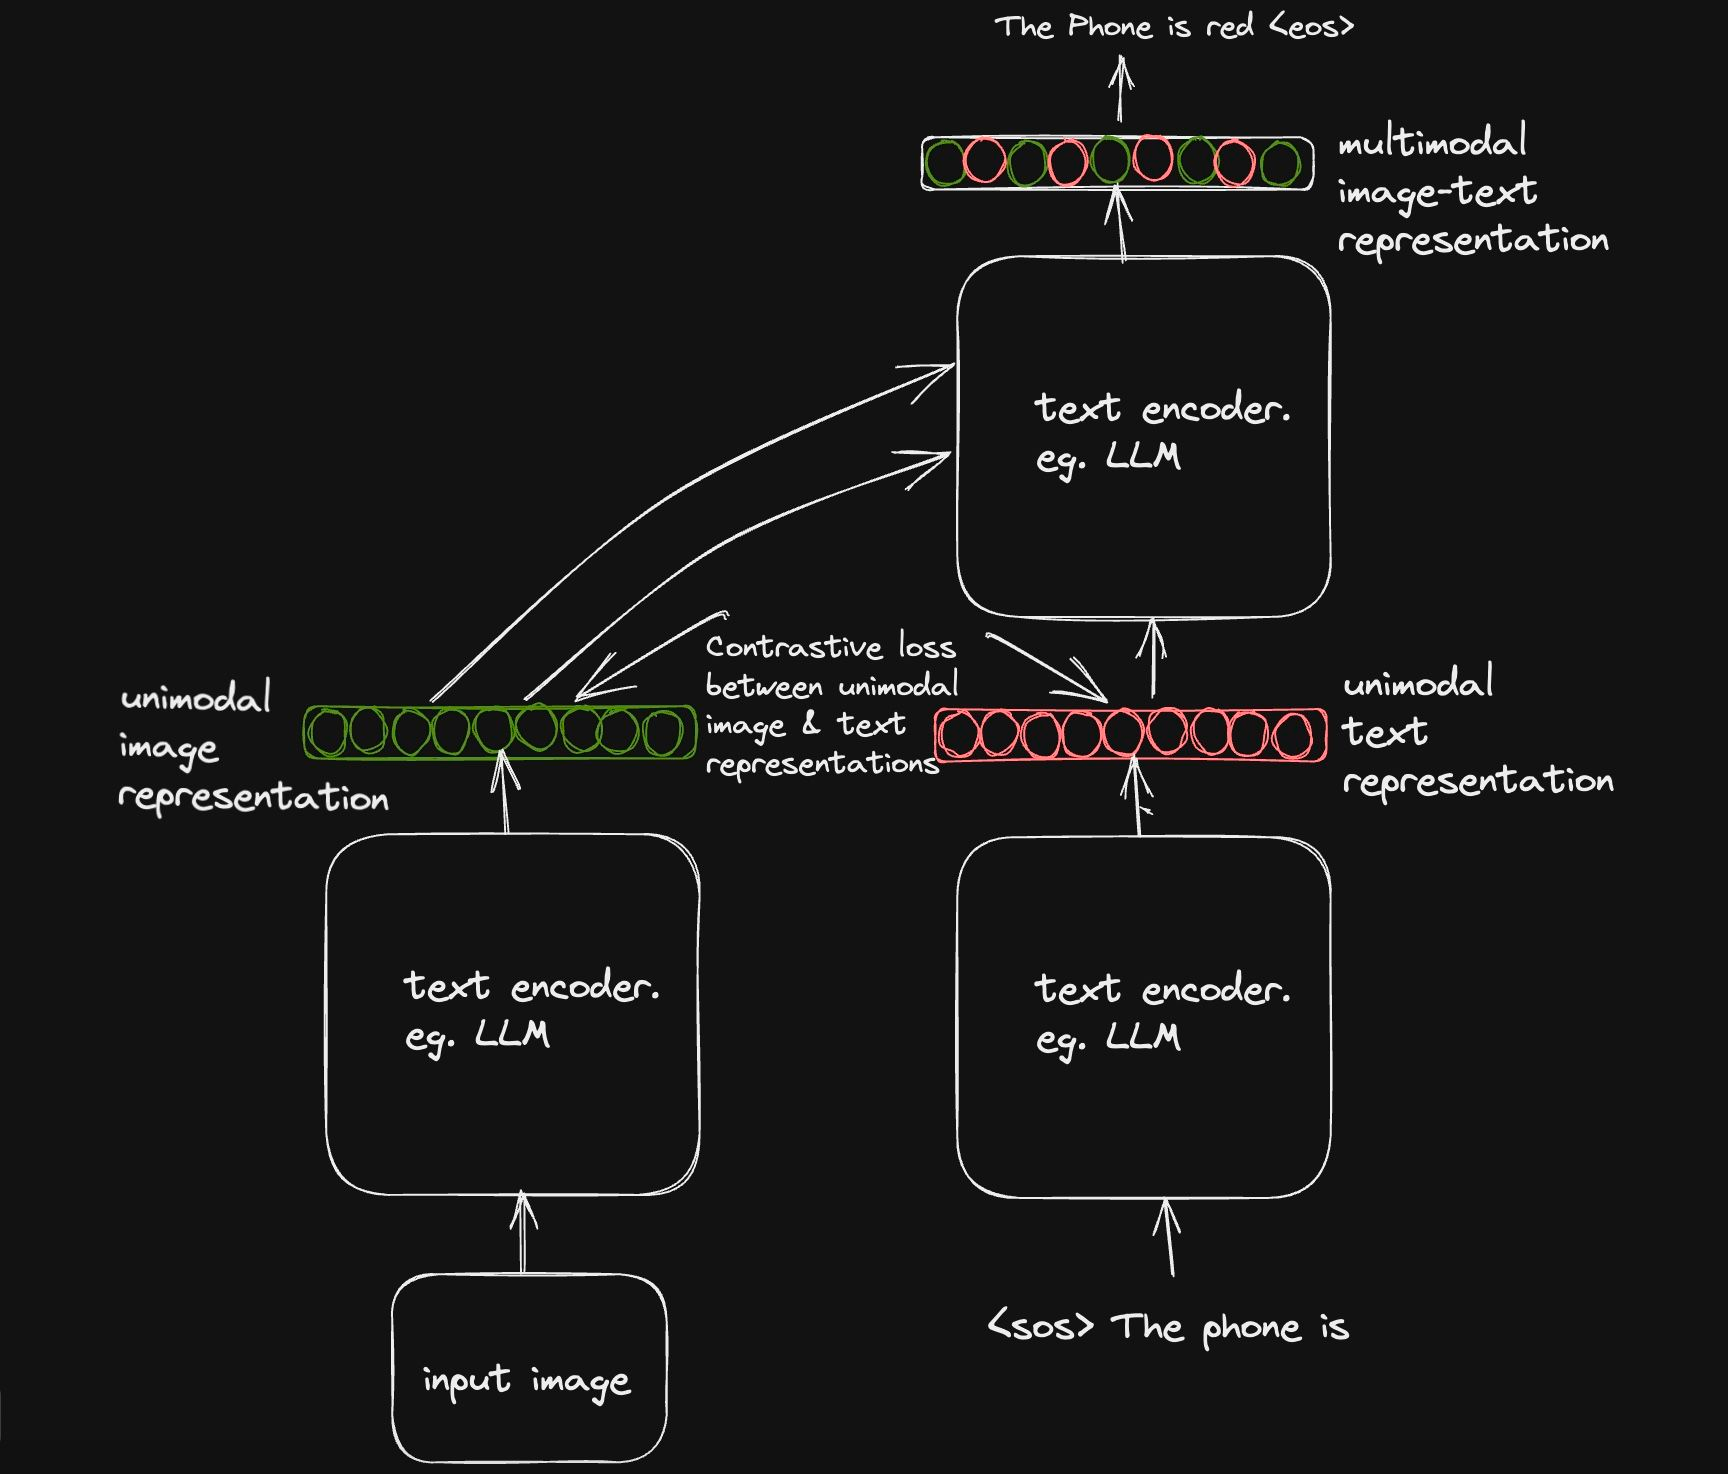
CoCa makalesinin amacının, görsel-dil modellerinin iki paradigmasının (karşıtlıkçı ve üretimsel hedef) yeteneklerini tek bir modelde birleştirmek olduğunu hatırlayın. Karşıtlıkçı hedef paradigması, metin çözücümüzün tek kipli bir metin temsili üretmesini gerektirir; bu temsil, hizalama görevini öğrenmek üzere görüntü temsiliyle benzer bir vektör uzayına yansıtılır.
Öte yandan, üretimsel hedef; çözücünün kodlayıcıdan gelen görüntü temsillerini almasına ve görüntü temsilleri ile metin girdisine koşullu olarak metni otoregresif biçimde üretmesine olanak tanır.
Her iki çözücü bölümünün de modelin belirteçlere erkenden bakmasını engellemek için nedensel maskeleme uyguladığını unutmayın.
Bunu başarmak için yazarlar, ayrıştırılmış (decoupled) bir çözücü kurulumu uyarladı: ilk kısım karşıtlıkçı hedef için tek kipli bir metin temsili üretmeyi öğrenir; ikinci kısım ise çok kipli bir görüntü-metin temsili üretmeyi öğrenir.
Karşıtlıkçı Hedef
CLIP ve ALIGN gibi birçok modelde kullanılan karşıtlıkçı hedefin ardındaki fikir oldukça basittir. Amaç; görüntü ve metin gibi farklı kipler için temsiller öğrenmek ve benzer çiftlerin temsil uzayında birbirine daha yakın, benzer olmayan çiftlerin ise birbirinden daha uzak olmasını sağlamaktır.
Her eğitim adımında, veri kümesinden görüntü-metin çiftlerinden bir örneklem çeker ve kodlayıcılarımızın ağırlıklarını, örnek çiftleri bir araya toplayacak ve çift olmayanları uzaklaştıracak şekilde yönlendiririz.
Daha önce belirtildiği gibi, karşıtlıkçı hedef hem görüntü hem de metin kipleri için tek kipli temsiller gerektirir. Bunu metin kodlayıcı tarafında başarmak için BERT dil modelinde kullanılan klasik bir tekniği uygularız.
Girdi dizisinin bir parçası olarak, girdi dizisinin sonuna öğrenilebilir bir sınıflandırma belirteci [CLS] ekler ve bu belirtece eşlenen çıktı vektörünün tüm girdi dizisinin anlamsal içeriğini yakalamasını umarız.
Çözücülerimiz dikkat haritalarına nedensel maskeleme uyguladığından, sınıflandırma belirtecinin dizinin sonuna eklenmesi; bu belirteç ile girdi dizisindeki diğer tüm belirteçler arasında bir dikkat bağlantısı olmasını sağlar ve böylece tüm cümlenin anlamsal içeriğini yakalar.
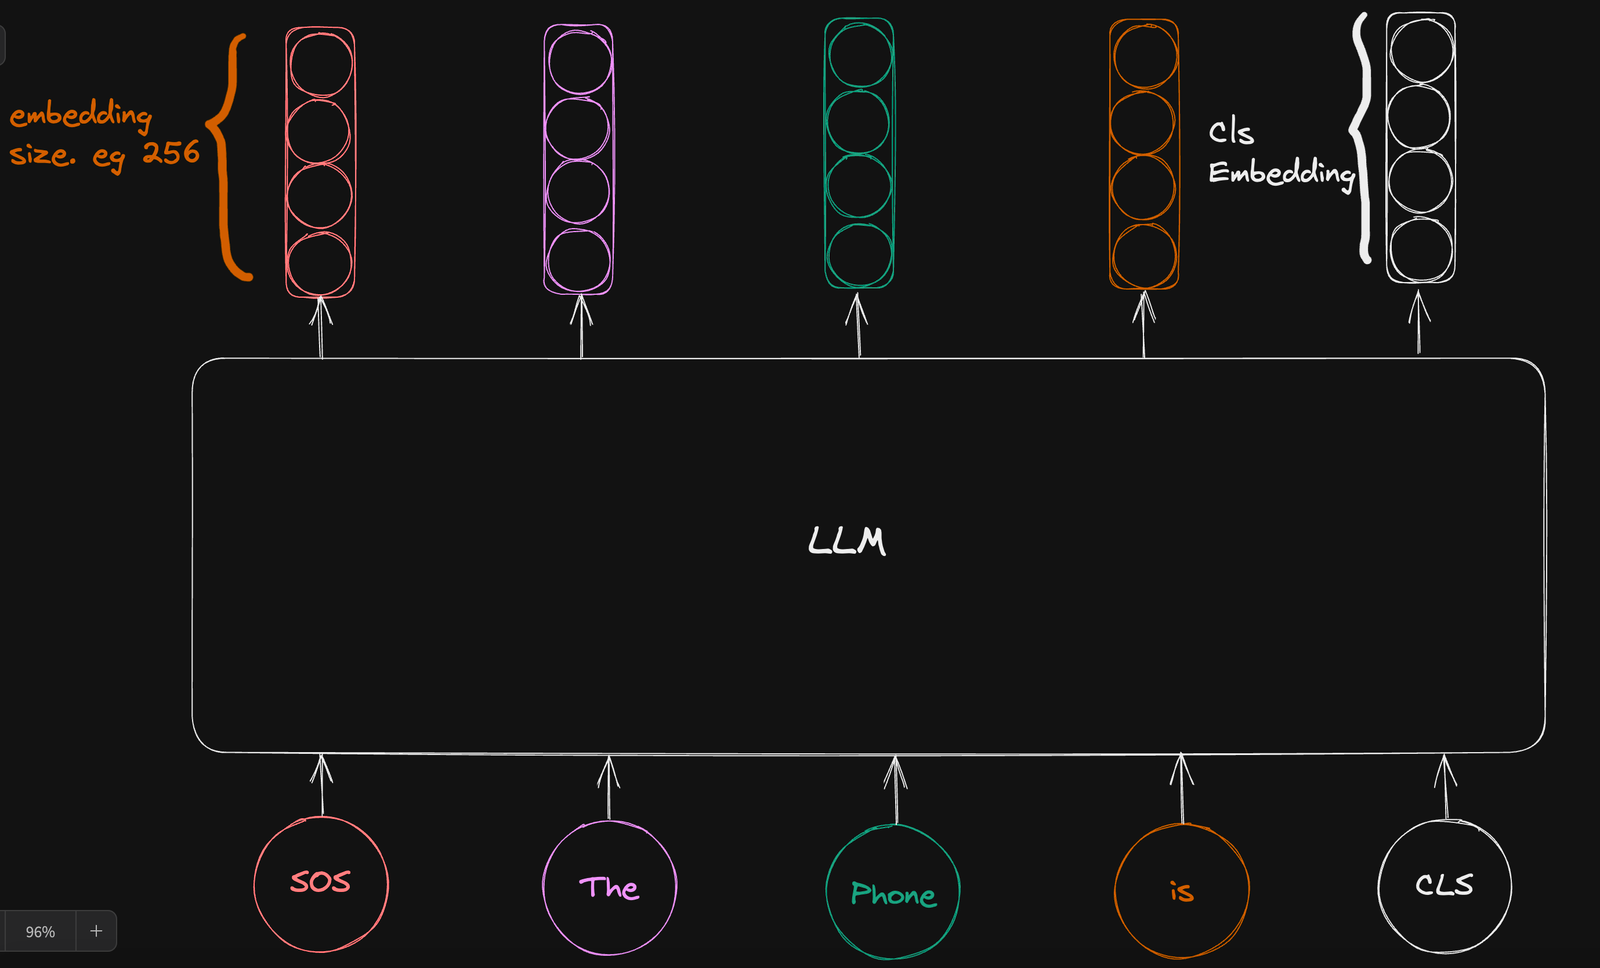
Diğer girdi belirteçlerinin vektör temsilini göz ardı eder ve karşıtlıkçı kaybı tahmin etmek için sınıflandırma belirtecinin vektör temsilini kullanırız.
Görüntü kodlayıcı tarafında işler biraz farklıdır.
Şekil-6’daki görüntüde, görüntü kodlayıcının çıktısının bir bölümünün sınıflandırma belirteci gömmesiyle birlikte karşıtlıkçı kaybı tahmin etmek için kullanıldığını, bir bölümünün ise ayrıştırılmış kurulumun üst kısmına birleşik temsili tahmin etmek üzere gönderildiğini görebilirsiniz.
Aslında, karşıtlıkçı hedefi tahmin etmek için görüntünün yalnızca tek bir gömme çıktısı gerekirken, görüntü kodlayıcısının gömme çıktı dizisinin tamamı üretimsel hedefi tahmin etmek için kullanılır.
Yazarlar, tek bir havuzlanmış (pooled) gömme çıktısının görüntünün küresel (global) temsilini yakalamaya yardımcı olduğunu (karşıtlıkçı hedef için tam da istediğimiz şey) ve bir gömme çıktı dizisinin ise görüntünün daha ince taneli temsilini gerektiren görevlerde yardımcı olduğunu ampirik olarak belirlediklerini savunuyor.
Bunu başarmak için, tek bir çok başlı dikkat katmanı olan dikkat havuzlama (attentional pooling) katmanı, öğrenilebilir bir sorgu (query) parametresi aracılığıyla görüntü kodlayıcı çıktısını farklı hedeflere göre uyarlamak üzere kullanılır. Sorgu parametresini belirli bir tamsayı değerine ayarlayarak, tüm kodlayıcı kurulumumuzu uzunluğu bu sorgu parametresi olan bir gömme dizisi çıktısı verecek şekilde uyarlayabiliriz.
Karşıtlıkçı hedef durumunda, karşıtlıkçı kaybı hesaplamak için tek bir gömme elde etmek üzere sorgu parametresini bire ayarlarız; üretimsel hedef durumumuzda ise ideali metnimizin dizi uzunluğuna eşit olan keyfi bir değere ayarlarız. CoCa makalesinde yazarlar üretimsel hedef için 256’yı seçmiştir.
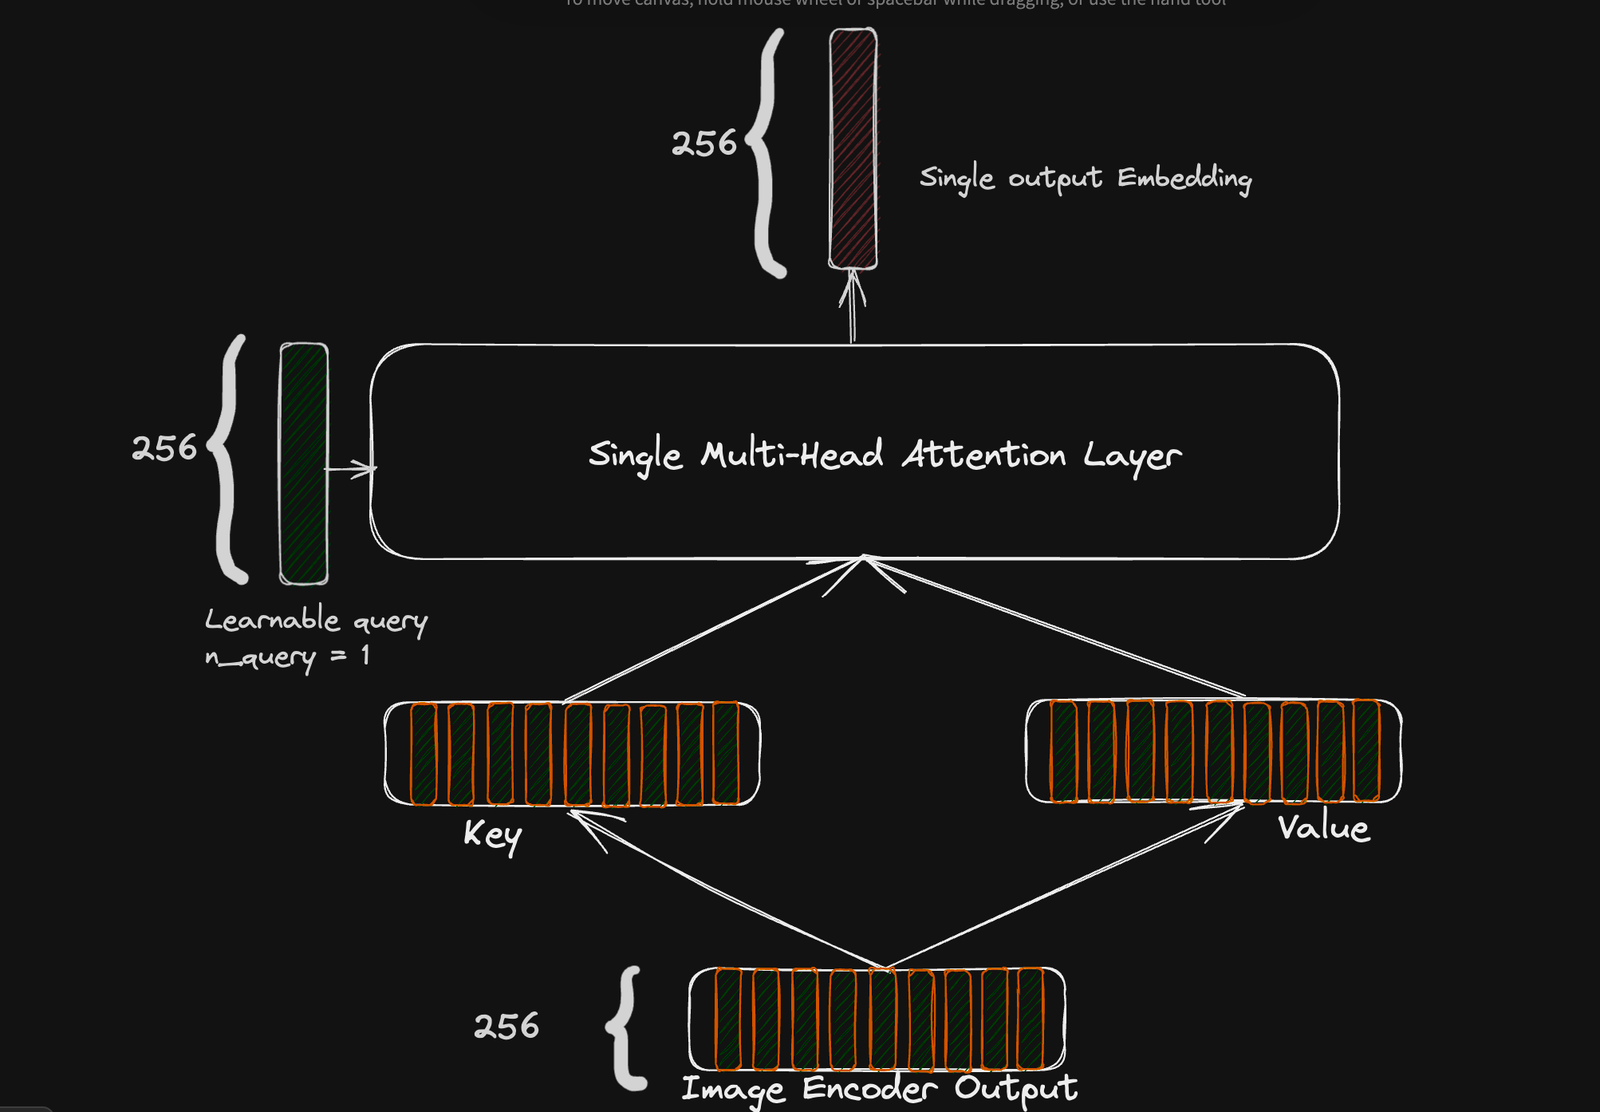
Karşıtlıkçı kayıp için dikkat havuzlama kurulumu. Dikkat katmanının çıktısı, 256 boyutlu tek bir gömmedir.
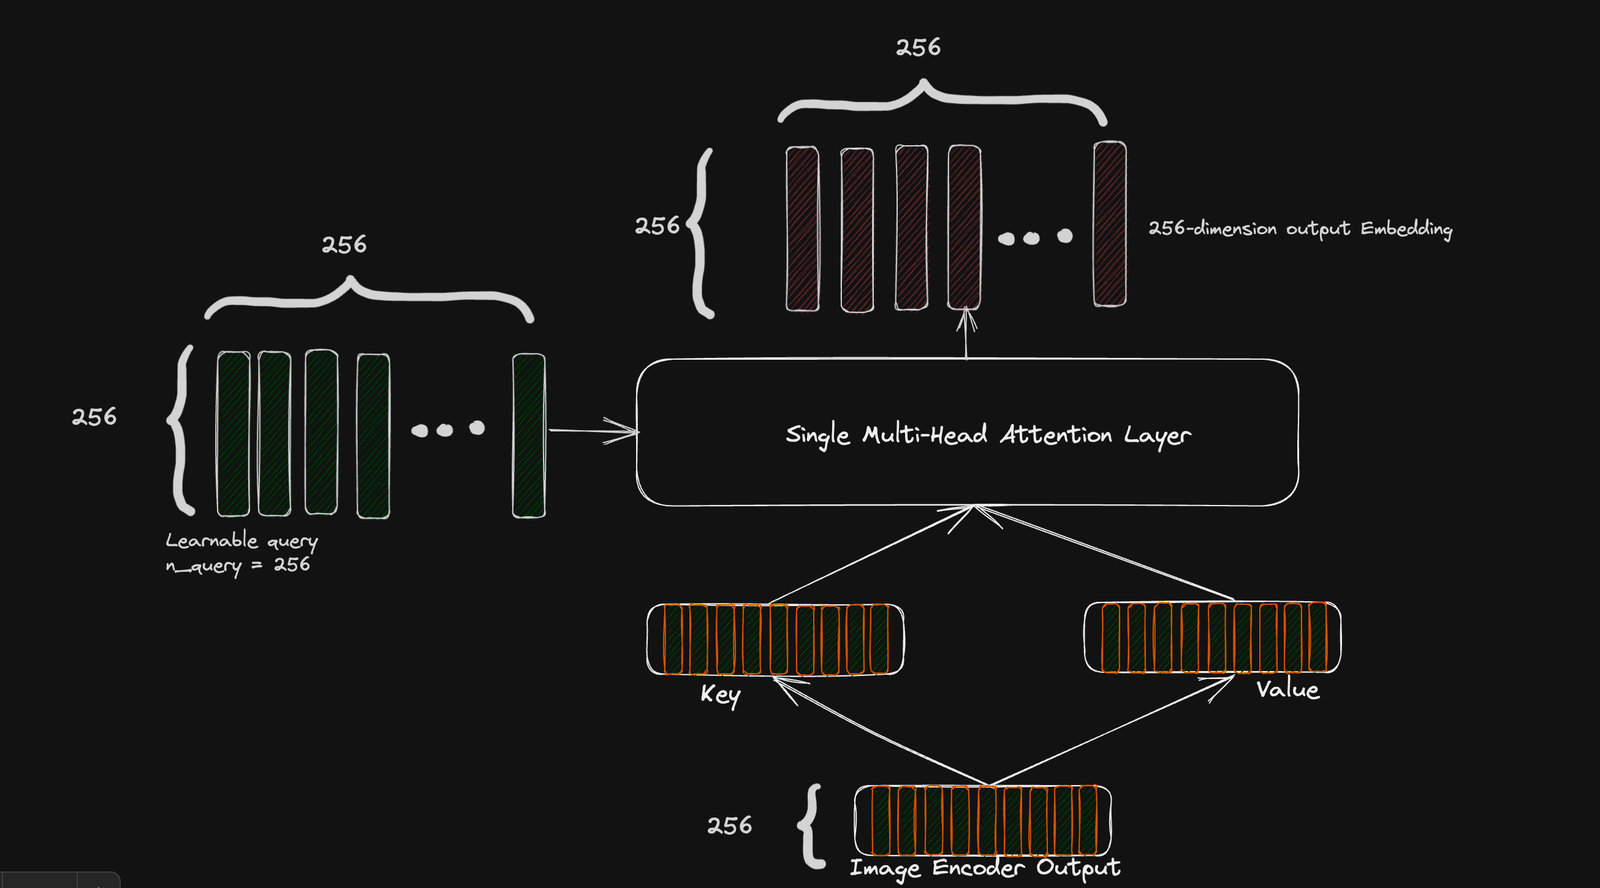
Üretimsel Hedef
Yalnızca görüntünün küresel temsilini gerektiren karşıtlıkçı hedeften farklı olarak, üretimsel hedef; görüntünün daha ince taneli bir temsilini ürettiğimizde daha etkilidir.
Daha önce açıklandığı gibi, sorgu parametresini keyfi bir sayıya (CoCa makalesinde 256) ayarlayarak, görüntünün 256 x 256 boyutlarında zengin bir temsilini elde ederiz.
Bu temsil, ayrıştırılmış çözücü kurulumunun üst kısmına aktarılır ve tek kipli metin temsiliyle (CLS temsilini göz ardı ederek) çapraz-mod etkileşim yoluyla, kelime dağarcığının olasılık dağılımını otoregresyon ayrıştırmasıyla tahmin etmek için kullanılan birleşik bir görüntü-metin temsili elde edilir.
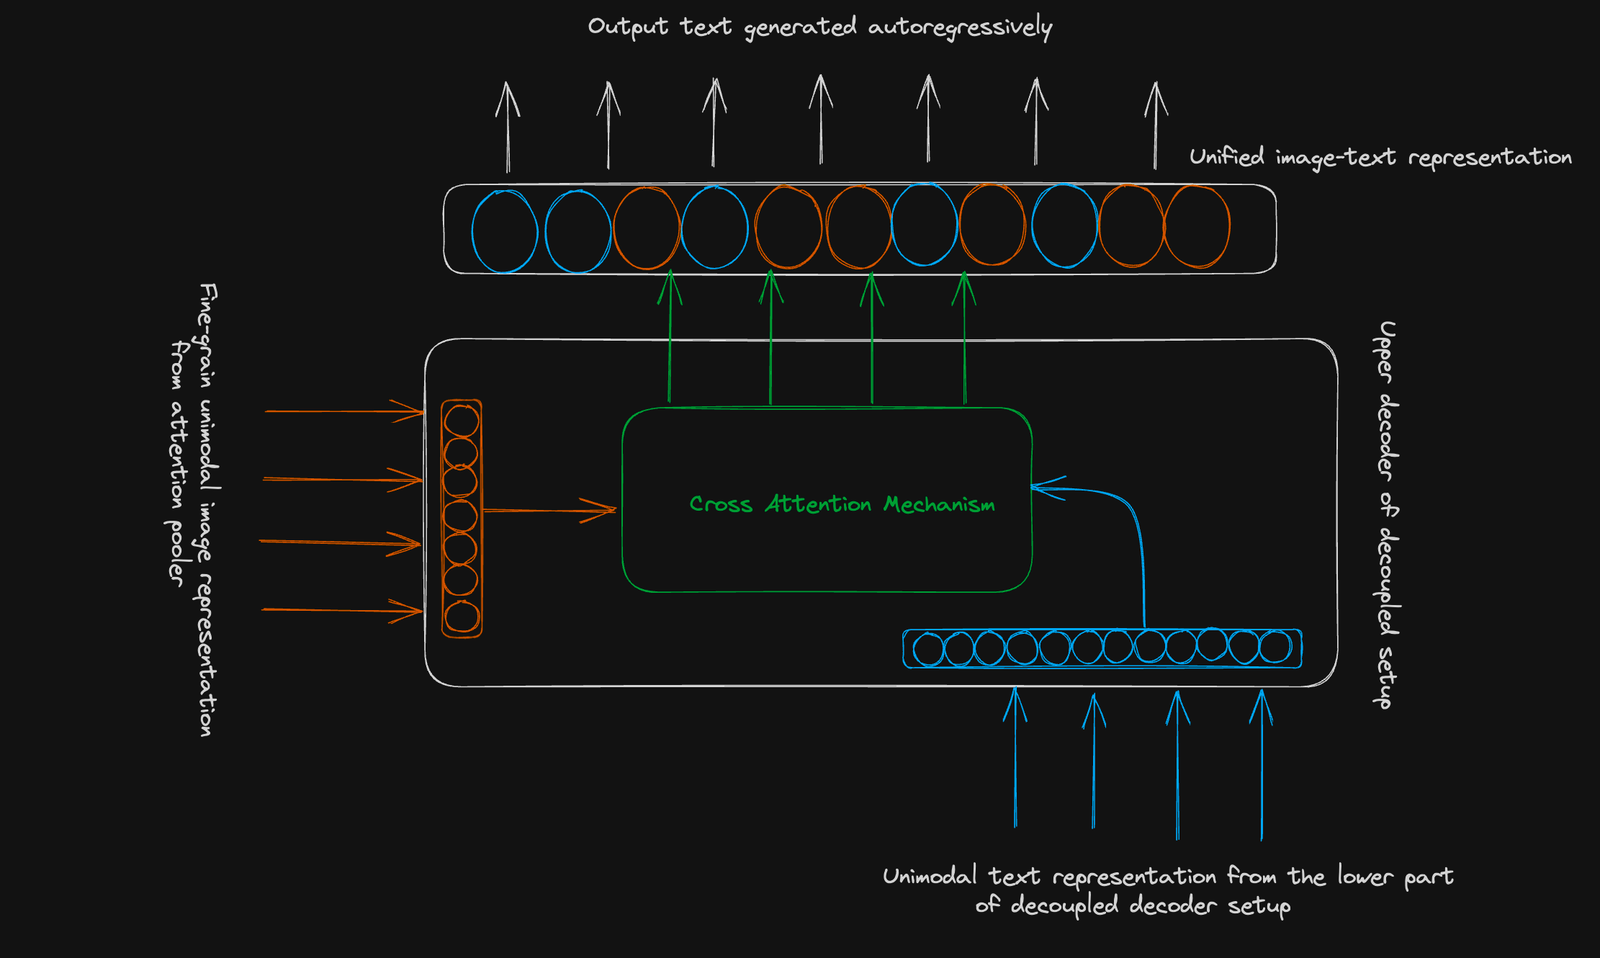
Bu metnin önceki iki bölümünde gösterildiği gibi, CoCa modelinin mimari kurulumu; görüntü sınıflandırma ve çapraz-mod getirme gibi sıfır-atış öğrenme görevlerinde başarılı olan bir model sınıfının ve VQA ile görüntü altyazılama görevlerinde başarılı olan diğer bir model sınıfının yeteneklerini bir araya getirmeye olanak tanır. CoCa modeli ayrıca çeşitli aşağı akış görsel ve dil görevlerinde ince ayar yapılabilir.
Son Düşünceler
CoCa gibi temel modellerin ortaya çıkışı, makine öğrenmesi alanında önemli bir adımı işaret eder. CoCa, çeşitli paradigmaların güçlü yanlarını birleştirerek, görüntü ve metin temsillerini hizalayabilen ve birleşik görüntü-metin temsilleri üretebilen tek bir model sunar.
Bu model, karşıtlıkçı ve üretimsel hedeflerin bütünleştirilmesinin potansiyeline bir kanıt niteliğindedir ve Görsel Soru Cevaplama ile görüntü altyazılama gibi görevlerde daha yüksek performansın önünü açar. Sıfır-atış öğrenme görevlerinde üstünlük gösteren modellerin ve çok kipli görüntü-metin anlama görevlerinde yetkin olanların yeteneklerini kapsayarak, çok sayıda aşağı akış görsel ve dil görevi için çok yönlü bir araç sağlar.
Makine öğrenmesindeki ileri kavramlara daha derinlemesine dalmak ve derin öğrenmenin inceliklerini keşfetmek isteyenler için, DataCamp’teki İleri Düzey Keras ile Derin Öğrenme Kursu, çok yönlü Keras fonksiyonel API’sini kullanarak çeşitli sorunları çözmek için gerekli bilgi ve becerileri kazandırır; CoCa gibi gelişmiş modelleri ve bunların temel ilkelerini daha derinlemesine keşfetmenize ve anlamanıza olanak tanır.