Last chance! 50% off DataCamp Premium
Sale ends in
Deze tutorial is een gewaardeerde bijdrage uit onze community en is door DataCamp bewerkt voor duidelijkheid en nauwkeurigheid.
Wil je je eigen expertise delen? We horen graag van je! Dien je artikelen of ideeën in via ons Community Contribution Formulier.
De evolutie van machine learning heeft geleid tot de ontwikkeling van foundation-modellen, een klasse modellen die vooraf getraind zijn op uitgebreide data en dienen als veelzijdige basis voor talloze toepassingen. Deze modellen, met GPT en BERT in Natural Language Processing (NLP) als boegbeelden, hebben ongekende capaciteiten laten zien op taken zoals zero-shot- en few-shot-leren.
In dit artikel duiken we in de wereld van image-text foundation-modellen en verkennen we het innovatieve Contrastive Captioner (CoCa)-model. We ontleden de architectuur, leggen de unieke aanpak uit waarin contrastieve en generatieve doelen worden gecombineerd, en laten zien hoe het de mogelijkheden van modellen als CLIP en SIMVLM samenbrengt in één samenhangend model.
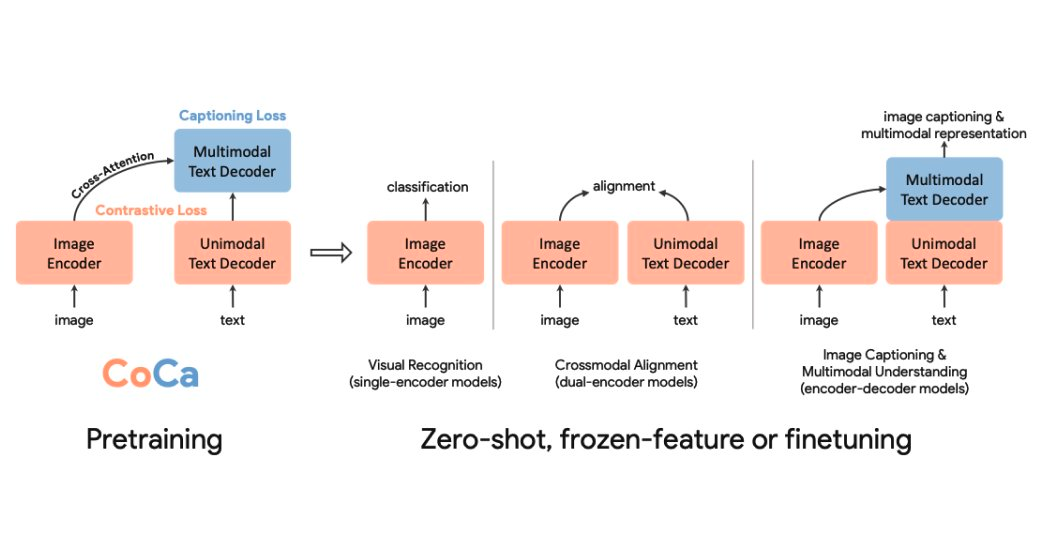
Fig-1 - Contrastive Captioner - (CoCa)
Het idee van foundation-modellen is niet nieuw in machine learning. In deep learning maken de technieken die de training van deze modellen mogelijk maken het eenvoudig om ze later aan te passen aan downstream-taken. In NLP is er een golf aan foundation-modellen zoals GPT en BERT, getraind op ruwe data op internetschaal, die opmerkelijke zero-shot- en few-shot-capaciteiten hebben laten zien.
Onderzoek naar visie- en visie-taal foundation-modellen heeft drie hoofdsporen verkend: single-encoder-modellen, image-text dual-encoder-modellen met contrastive loss, en encoder-decoder-modellen met een generatief doel. Voordat we het CoCa-model verkennen, kijken we naar deze onderzoekslijnen voor het bouwen van foundation-modellen en hun zwaktes.
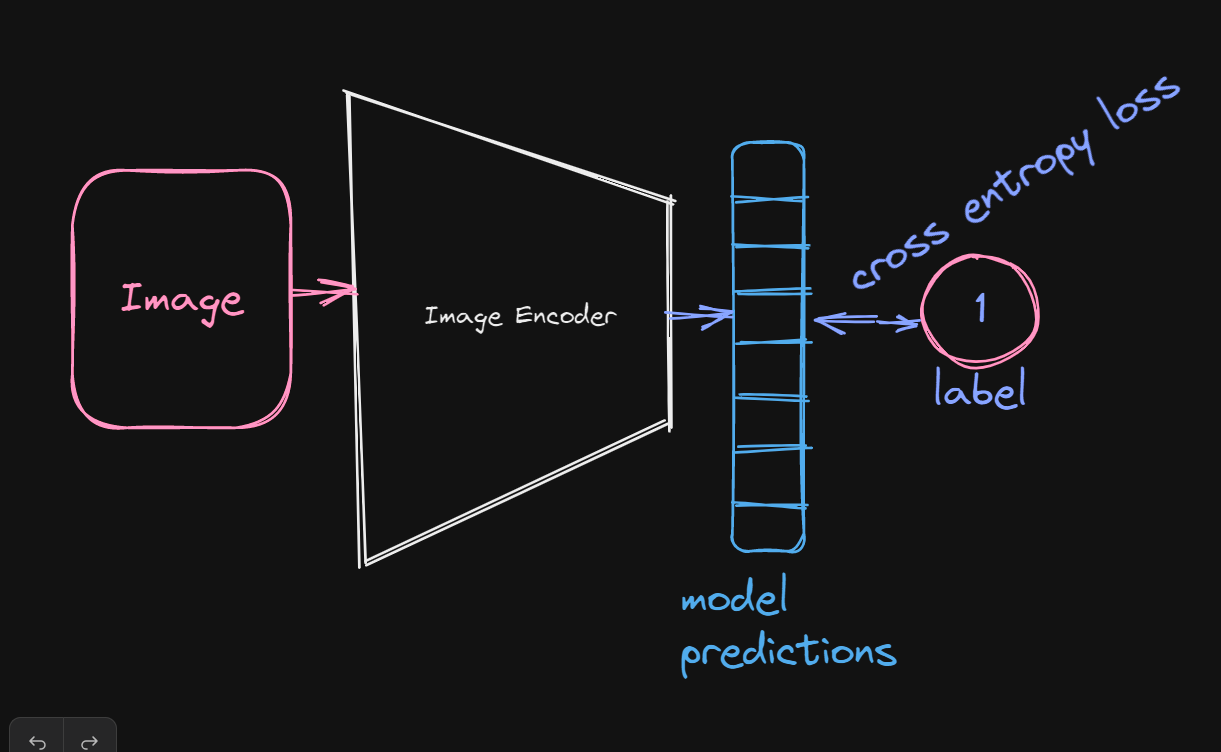
Als je eerder met computer vision hebt gewerkt, is de kans groot dat je deze klasse modellen bent tegengekomen. Deze modellen leren representaties van beelden die later kunnen worden aangepast voor downstream vision-taken door training op een grote dataset met geannoteerde beelden met een cross-entropy-verlies.
Deze modellen blinken empirisch uit in visiegerelateerde taken zoals detectie, maar zijn minder goed in taken waarbij visie en taal samenkomen. Ze leunen sterk op menselijke annotaties, waardoor natuurlijke taal minder in het model verankerd raakt.
Populaire modellen binnen deze klasse van visie-taal foundation-modellen zijn onder meer CLIP (Contrastive Language-Image Pre-training) en ALIGN.
Tijdens pretraining leren we een alignmente-taak door een beeld- en taalmodel gezamenlijk te trainen met een contrastive loss.
Het idee achter hun pretrainingdoel is vrij eenvoudig: groepeer de representaties van beeld-tekst-paren (ze zijn gerelateerd) en duw representaties van beelden en teksten die niet gerelateerd zijn (geen paren) uit elkaar in dezelfde latente ruimte. Het resulterende dual-encoder-model kan vervolgens worden ingezet voor zero-shot-classificatietaken en beeldopzoeking.
Recente modellen uit deze klasse, zoals CLIP, leveren opmerkelijke prestaties op diverse visie-taaltaken, maar zijn vrijwel onbruikbaar voor taken die een gefuseerde representatie van beeld en tekst vereisen, zoals visual question answering. We leren immers alleen de uitlijning van beeld- en tekstrepresentaties, niet het genereren van een uniforme representatie die informatie van zowel beeld als tekst encodeert.
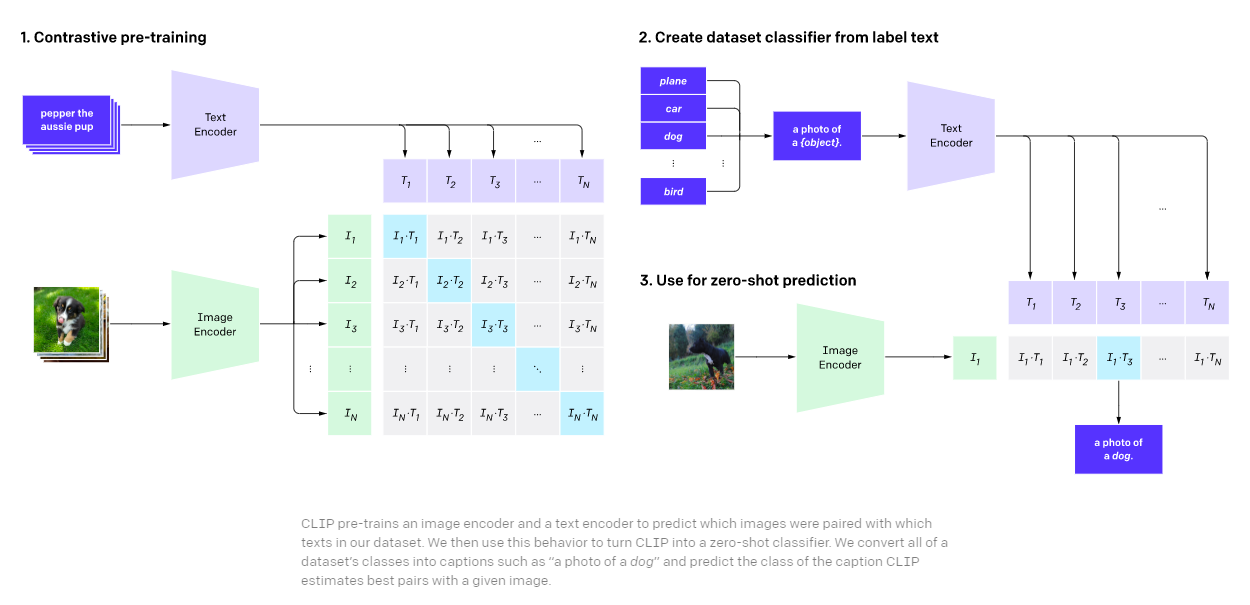
Fig-3 - Contrastive Language-Image Pre-training (CLIP)
Deze modellen gebruiken cross-modale interactie tussen verborgen beeld- en tekstrepresentaties om een gezamenlijke representatie te genereren.
Tijdens pretraining genereren we een verenigde representatie van beeld en tekst via cross-modale interacties tussen de verborgen tekstrepresentatie en de output van de beeldencoder, en passen we een Language Modelling-verlies toe op de decoderoutput.
In recente machinelearningarchitecturen vindt cross-modale interactie meestal plaats via een cross-attention-mechanisme in transformers, waarbij de outputs van de beeldencoder dienen als query en verborgen tekstrepresentaties als key en value.
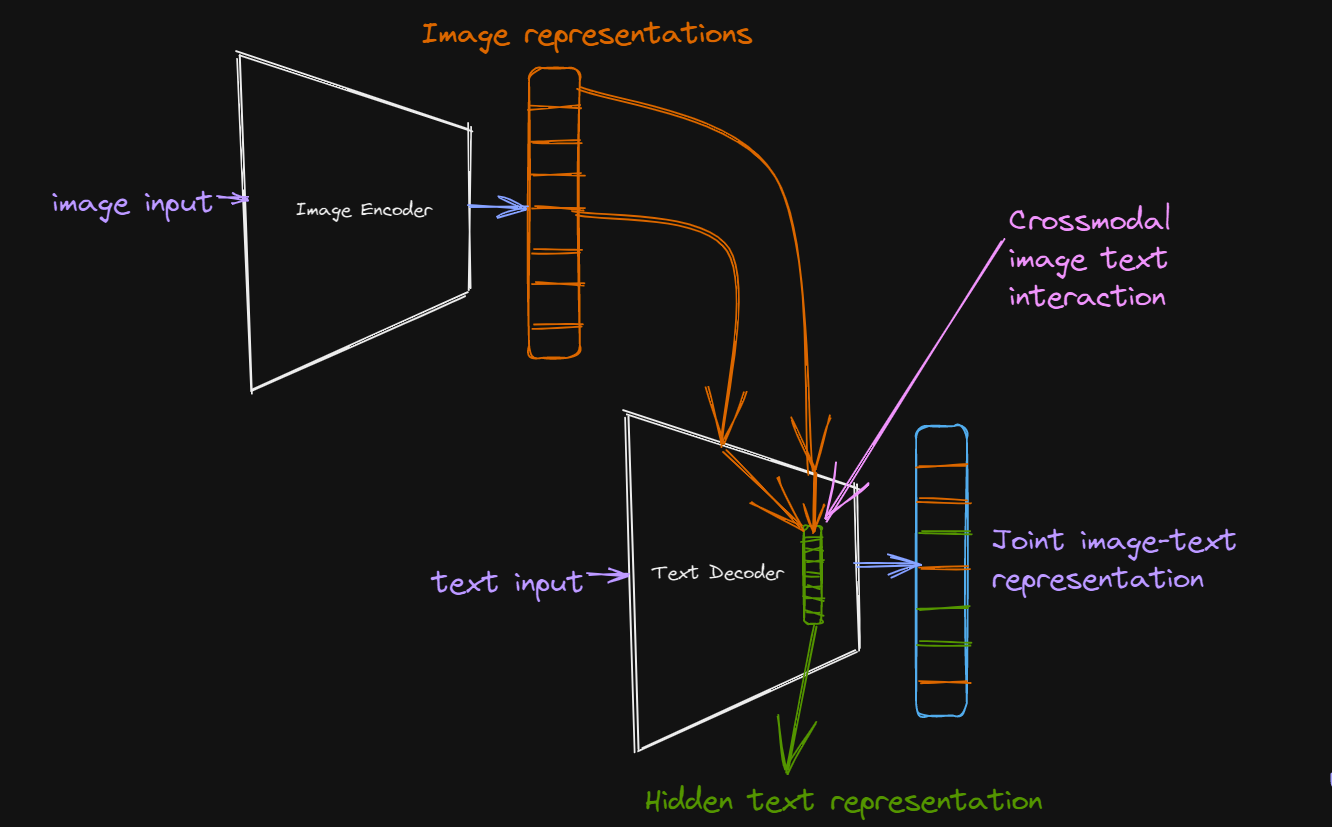
Voor downstream-taken kunnen we de decoderoutput, een gezamenlijke representatie van beeld en tekst, gebruiken voor diverse multimodale beeld-tekstbegripstaken zoals Visual Question Answering. Een recent model dat dit paradigma hanteert is het Simple Visual Language Model (SIMVLM).
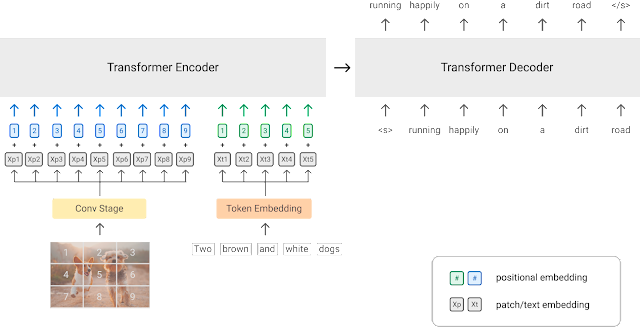
Fig-5 - Simple Visual Language Model (SIMVLM)
De auteurs van het CoCa-model wilden de mogelijkheden van de verschillende paradigma’s voor het bouwen van image-text foundation-modellen samenbrengen in één eenvoudig model. Het ontwerp van CoCa benut een contrastive loss om beeld- en tekstrepresentaties in één vectorruimte op elkaar af te stemmen, en een generatief doel (captioning loss) om een gezamenlijke beeld-tekstrepresentatie te leren. Zo worden de capaciteiten van modellen zoals CLIP en SIMVLM in één enkel model ingebed.
CoCa hanteert de standaard encoder-decoder-aanpak en, zoals de meeste modellen van dit type, encodeert het het beeld met een neuraal netwerk zoals een convolutioneel neuraal netwerk of een transformer.
De eigenheid van de CoCa-architectuur begint bij de output van de encoder en de volledige decodersetup.
Onthoud dat het doel van de CoCa-paper is om de mogelijkheden van twee paradigma’s van visie-taalmodellen (contrastief en generatief doel) te combineren in één model. Het contrastieve paradigma vereist dat onze tekstdecoder een unimodale tekstrepresentatie oplevert, die vervolgens wordt geprojecteerd in een vergelijkbare vectorruimte als de beeldrepresentatie om de alignmente-taak te leren.
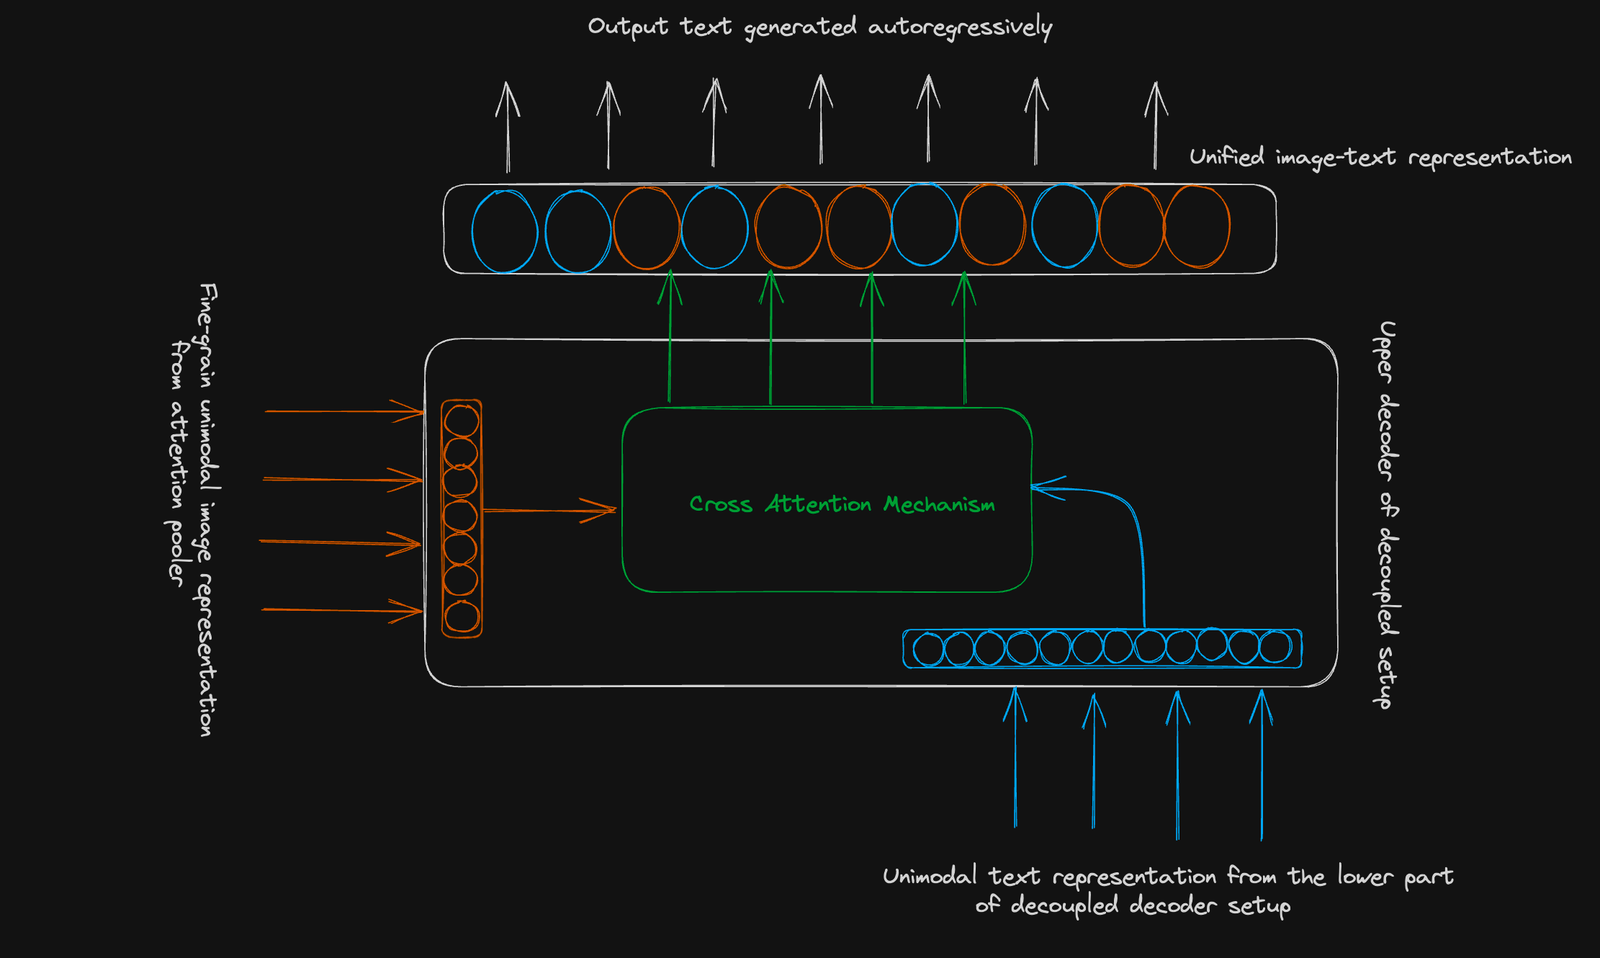
Het generatieve doel stelt de decoder daarentegen in staat om beeldrepresentaties van de encoder te gebruiken en autoregressief tekst te genereren, geconditioneerd op de beeldrepresentaties en tekstinput.
Let erop dat beide decoderonderdelen causaal maskeren toepassen om te voorkomen dat het model vooruitkijkt naar toekomstige tokens.
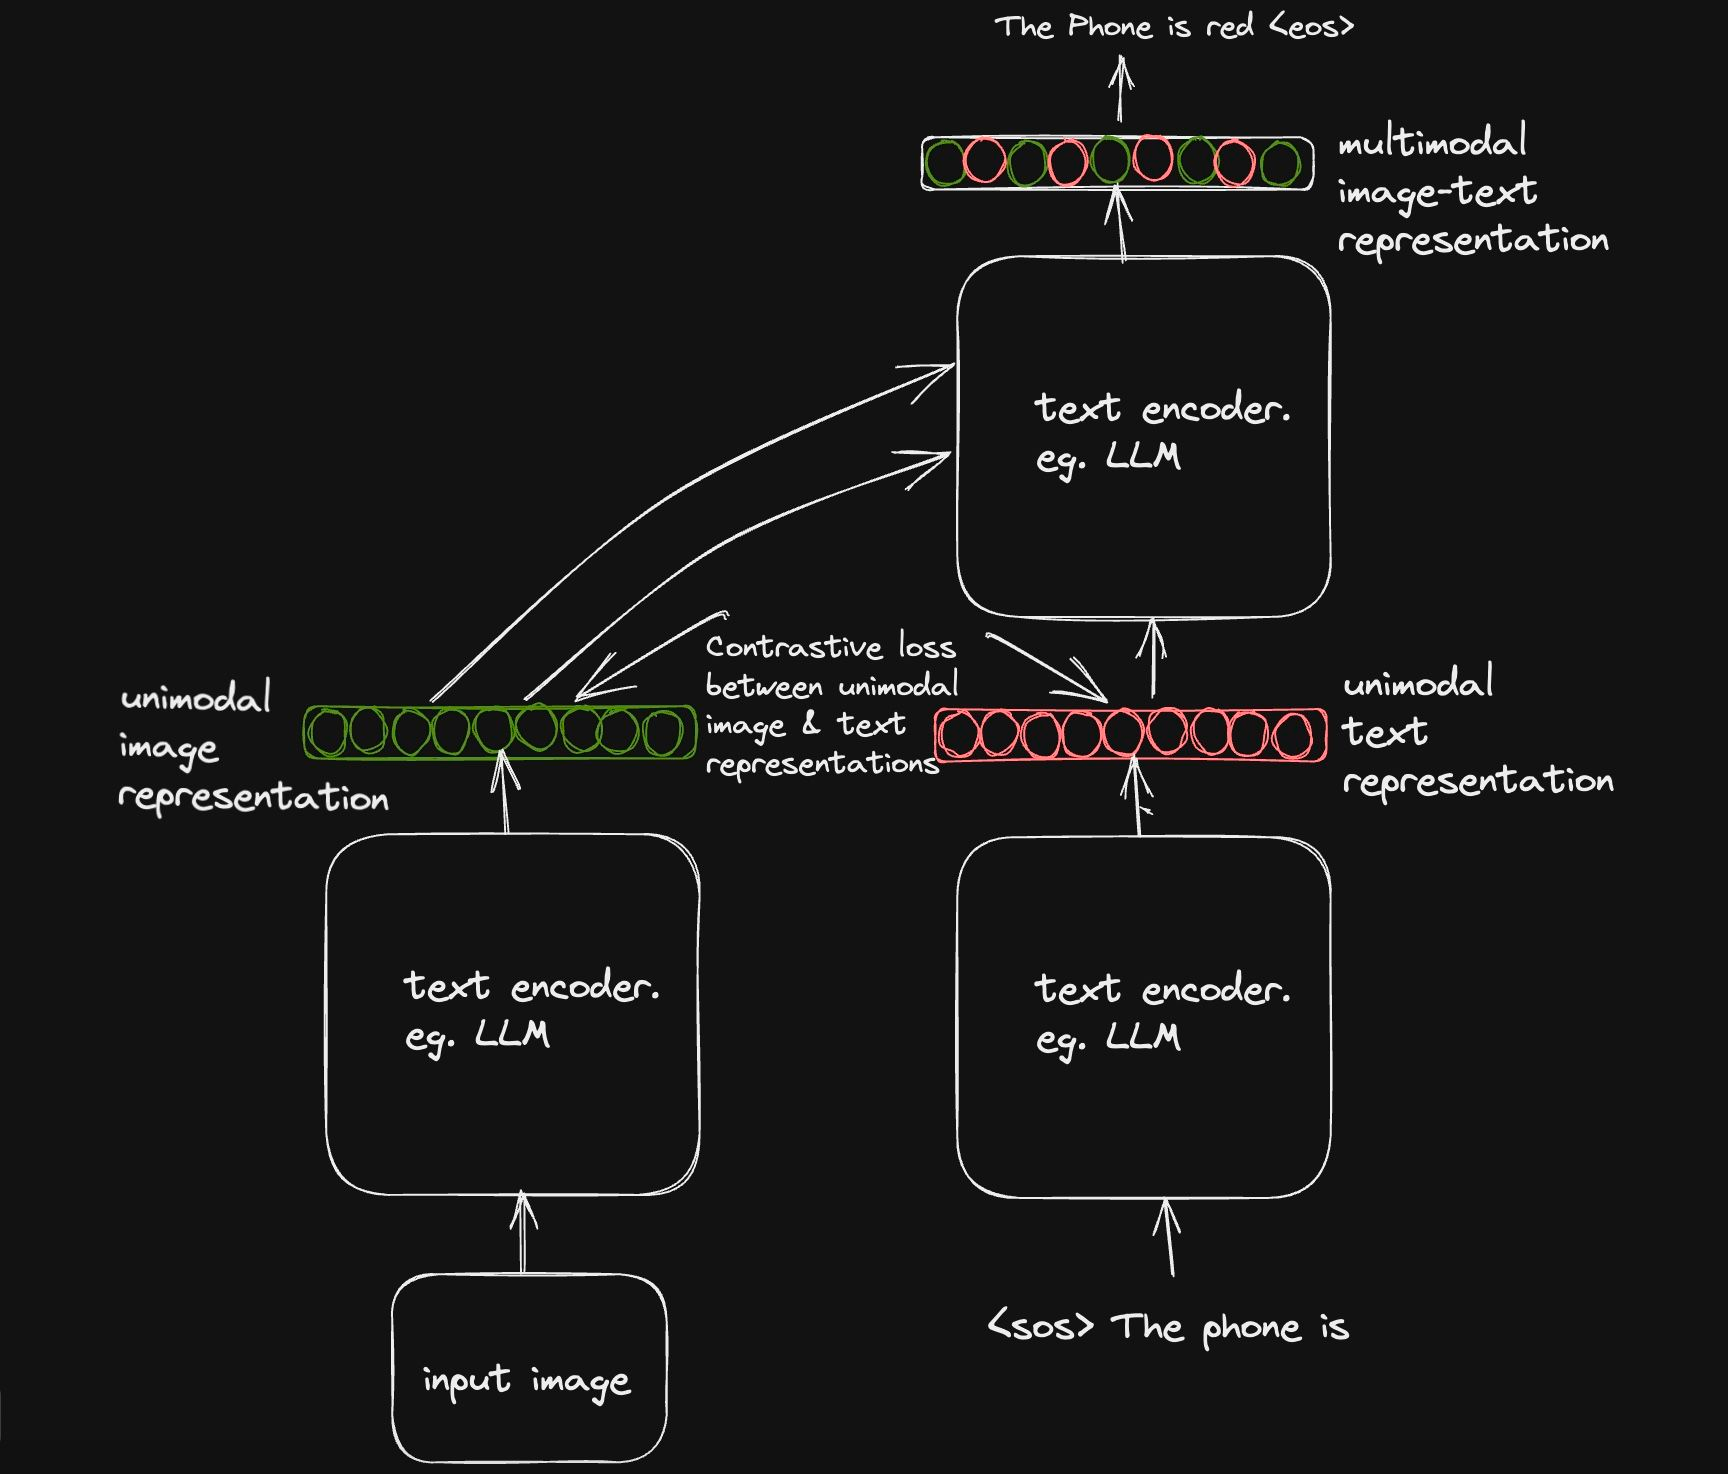
Om dit te bereiken, pasten de auteurs een slim losgekoppelde decodersetup toe: het eerste deel leert een unimodale tekstrepresentatie produceren voor het contrastieve doel en het tweede deel leert een multimodale beeld-tekstrepresentatie te genereren.
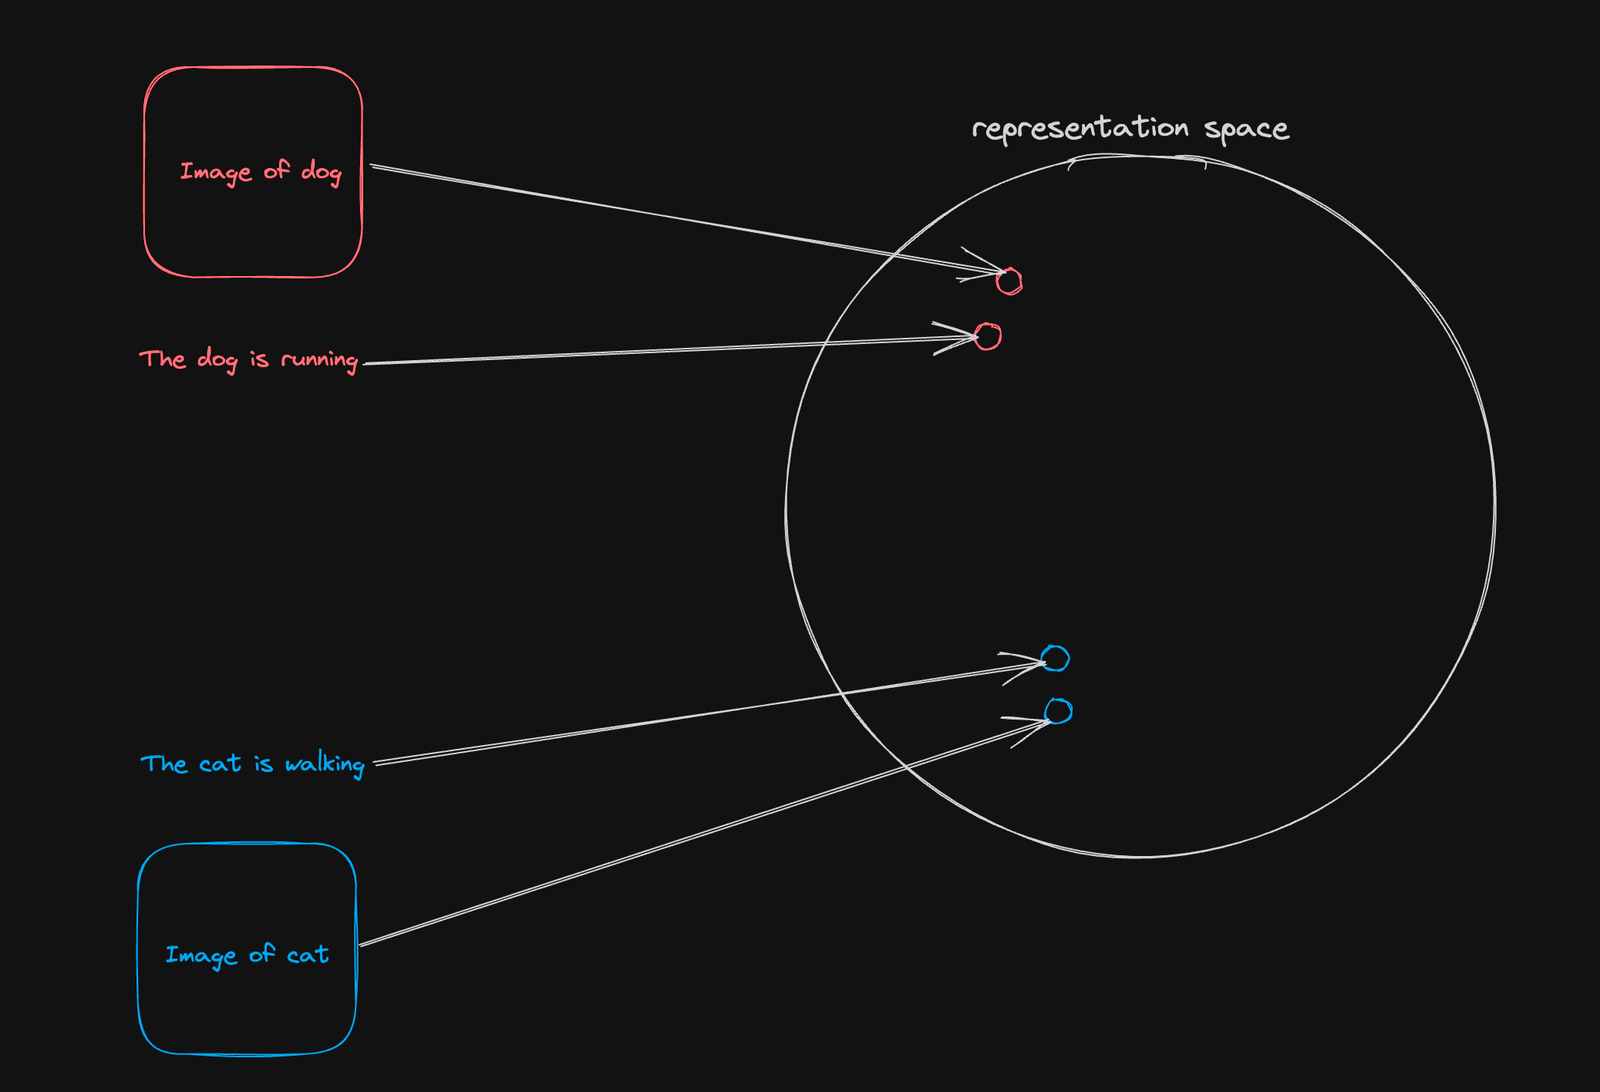
Het idee achter het contrastieve doel, zoals gebruikt in verschillende modellen als CLIP en ALIGN, is vrij eenvoudig. Het doel is om een representatie te leren voor verschillende modaliteiten, zoals beeld en tekst, zodanig dat soortgelijke paren dichter bij elkaar liggen in de representatieruimte en ongelijke paren verder uit elkaar.
Bij elke trainingsstap trekken we een sample van beeld-tekst-paren uit de dataset en sturen we de gewichten van onze encoders zo aan dat de sampleparen clusteren en niet-paren uit elkaar worden geduwd.
Zoals eerder genoemd vereist het contrastieve doel unimodale representaties van zowel beeld- en tekstmodaliteiten. Om dit aan de tekstencorderkant te bereiken, passen we een klassieke techniek toe die in het BERT-taalmodel wordt gebruikt.
Als onderdeel van de inputsequentie introduceren we een leerbaar classificatietoken [CLS] aan het einde van de sequentie, in de hoop dat de outputvector die aan dit token is gekoppeld de semantische betekenis van de volledige inputsequentie vastlegt.
Aangezien onze decoders causaal maskeren toepassen op hun attention-maps, zorgt het toevoegen van het classificatietoken aan het einde van de sequentie ervoor dat er een attention-verbinding is tussen het classificatietoken en alle andere tokens in de inputsequentie, waardoor de semantische betekenis van de hele zin wordt vastgelegd.
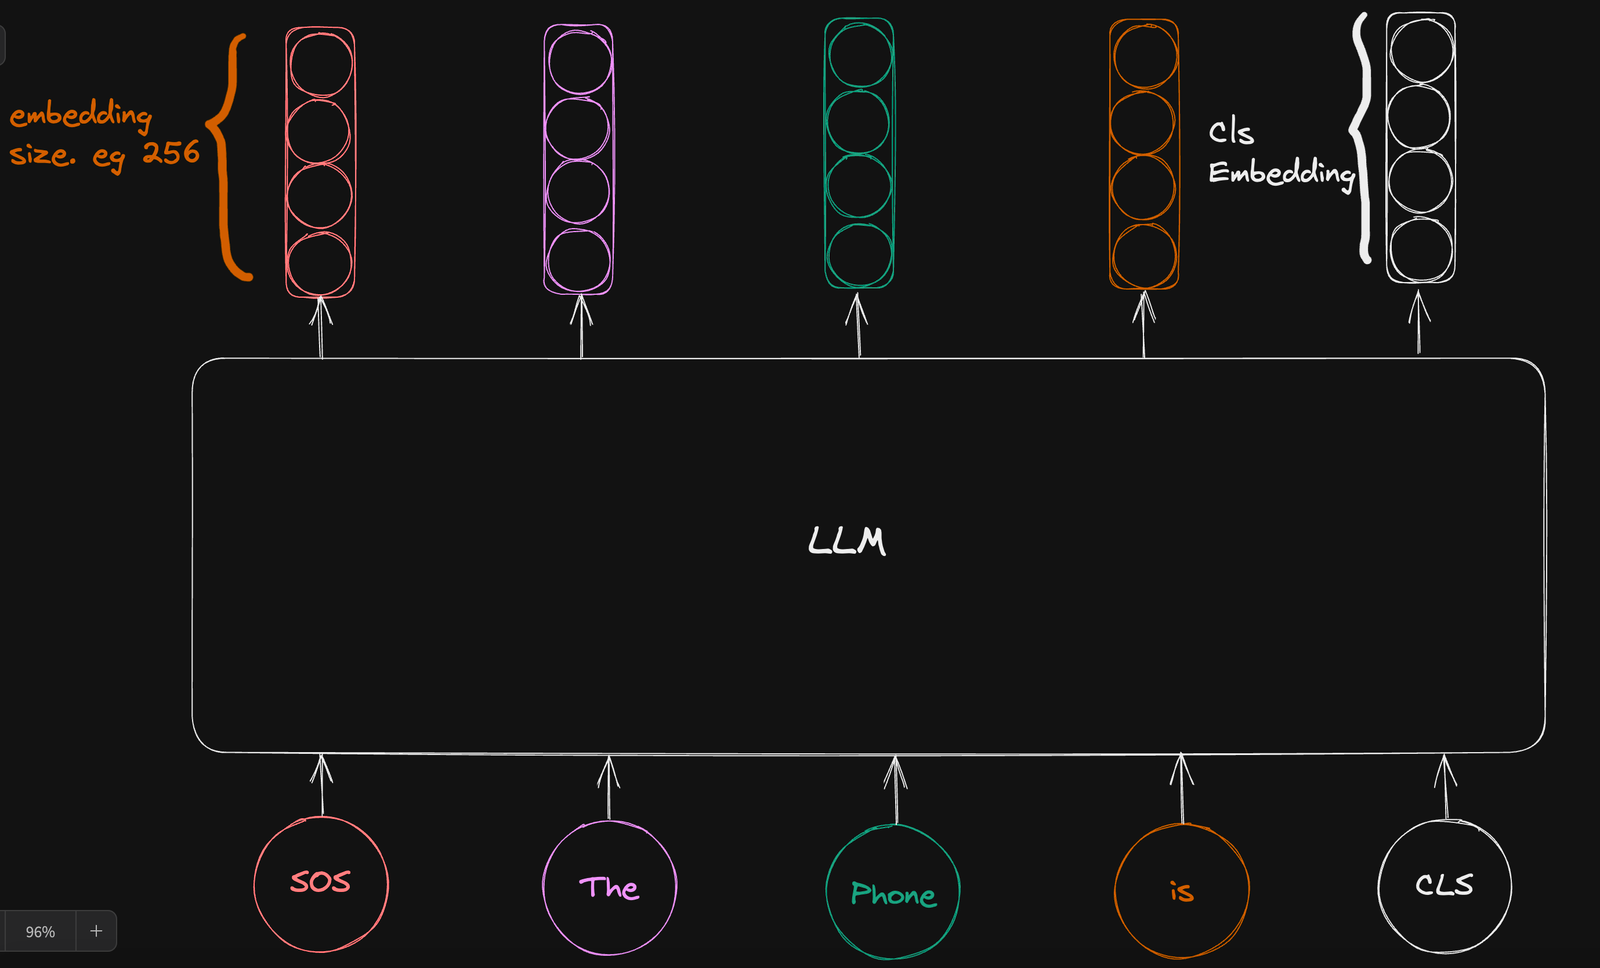
We negeren de vectorrepresentatie van de andere inputtokens en gebruiken de vectorrepresentatie van het classificatietoken om het contrastieve verlies te schatten.
Aan de beeldencorderkant ligt het iets anders.
In de afbeelding van Fig-6 zie je dat een deel van de output van de beeldencoder samen met de embedding van het classificatietoken wordt gebruikt om het contrastieve verlies te schatten, en een ander deel naar het bovenste deel van de losgekoppelde setup wordt gestuurd om de gezamenlijke representatie te bepalen.
Voor het contrastieve doel is in feite slechts één enkele embeddingoutput van het beeld nodig, terwijl de volledige sequentie van embeddingoutputs van de beeldencoder wordt gebruikt om het generatieve doel te schatten.
De auteurs stellen dat zij empirisch hebben vastgesteld dat een enkele gepoolde embeddingoutput helpt om de globale representatie van het beeld vast te leggen (precies wat we willen voor het contrastieve doel), en dat een sequentie van embeddingoutputs helpt bij taken die een fijnmazigere representatie van het beeld vereisen.
Om dit te bereiken wordt een attentional pooling-laag, een enkele multi-head attention-laag, gebruikt om de beeldencoderoutput voor verschillende doelen aan te passen via een leerbare query-parameter. Door de query-parameter op een specifieke integerwaarde in te stellen, kunnen we de hele encodersetup laten uitgeven als een embeddingsequentie waarvan de lengte gelijk is aan de query-parameter.
Voor het contrastieve doel zetten we de query-parameter op 1 om slechts één embedding te verkrijgen voor het berekenen van het contrastieve verlies, en voor het generatieve doel kiezen we een willekeurige waarde die idealiter gelijk is aan de sequentielengte van onze tekst. In de CoCa-paper kozen de auteurs 256 voor het generatieve doel.
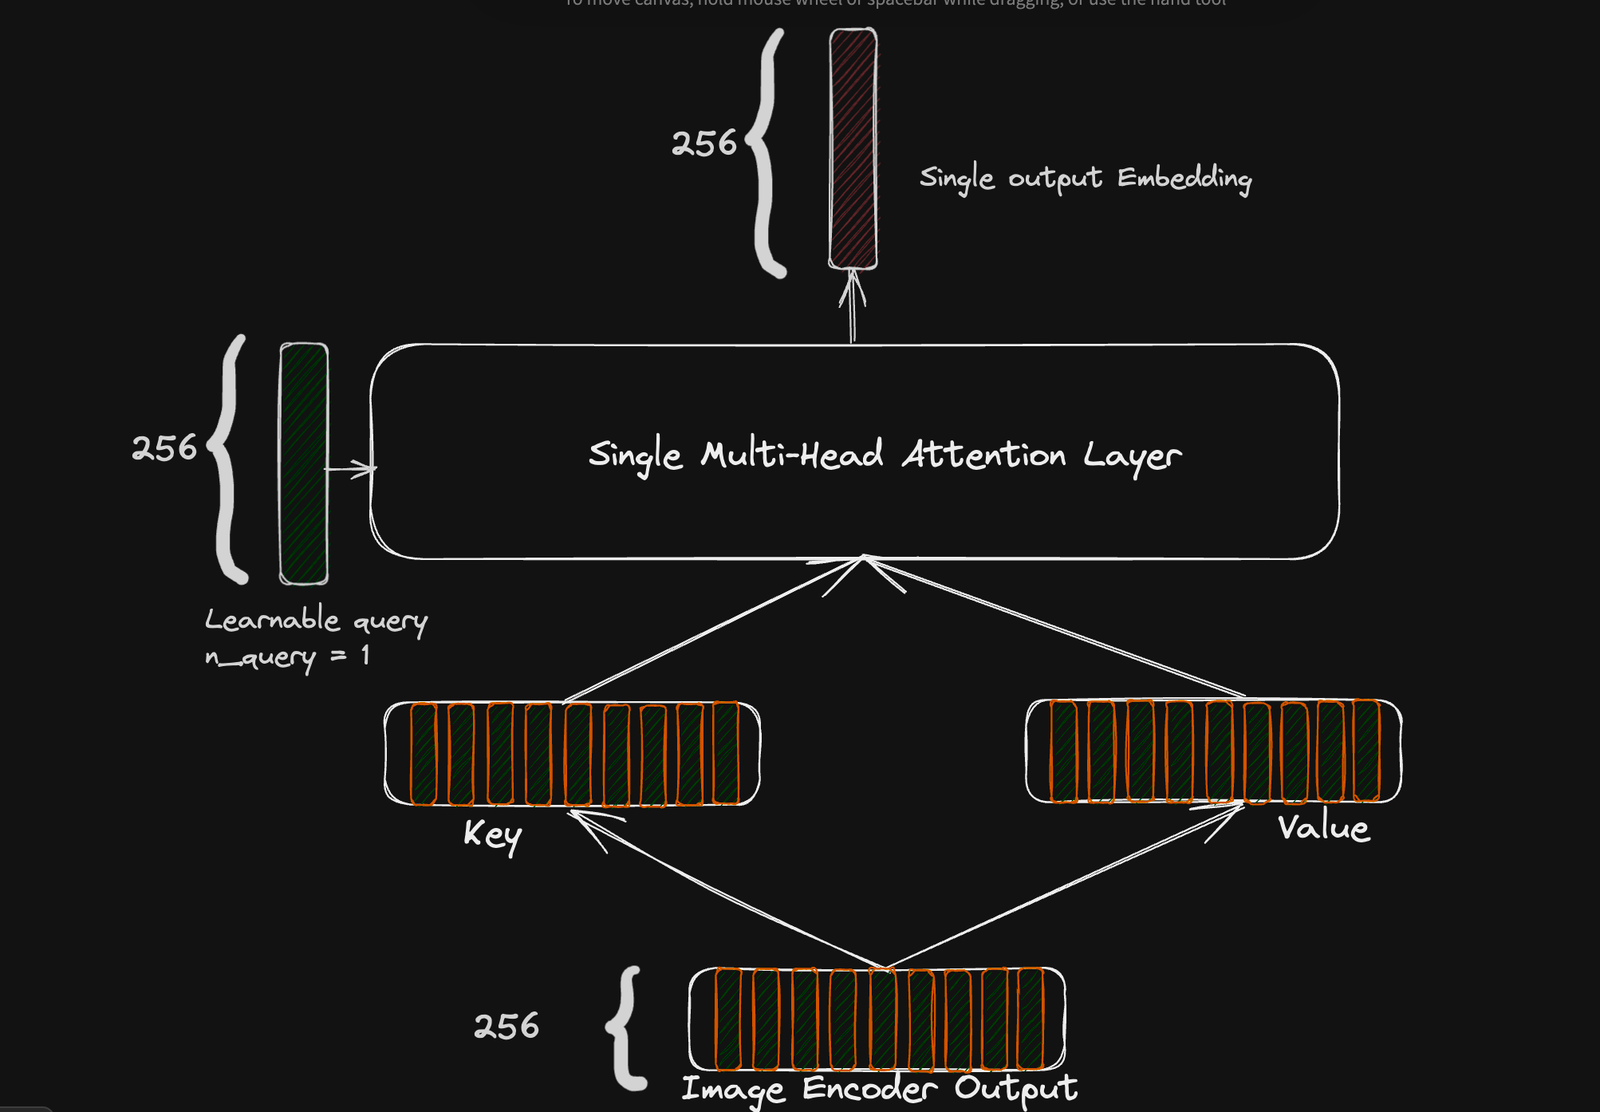
Attention-pooling-setup voor contrastive loss. De output van de attention-laag is een enkele embedding met 256 dimensies.
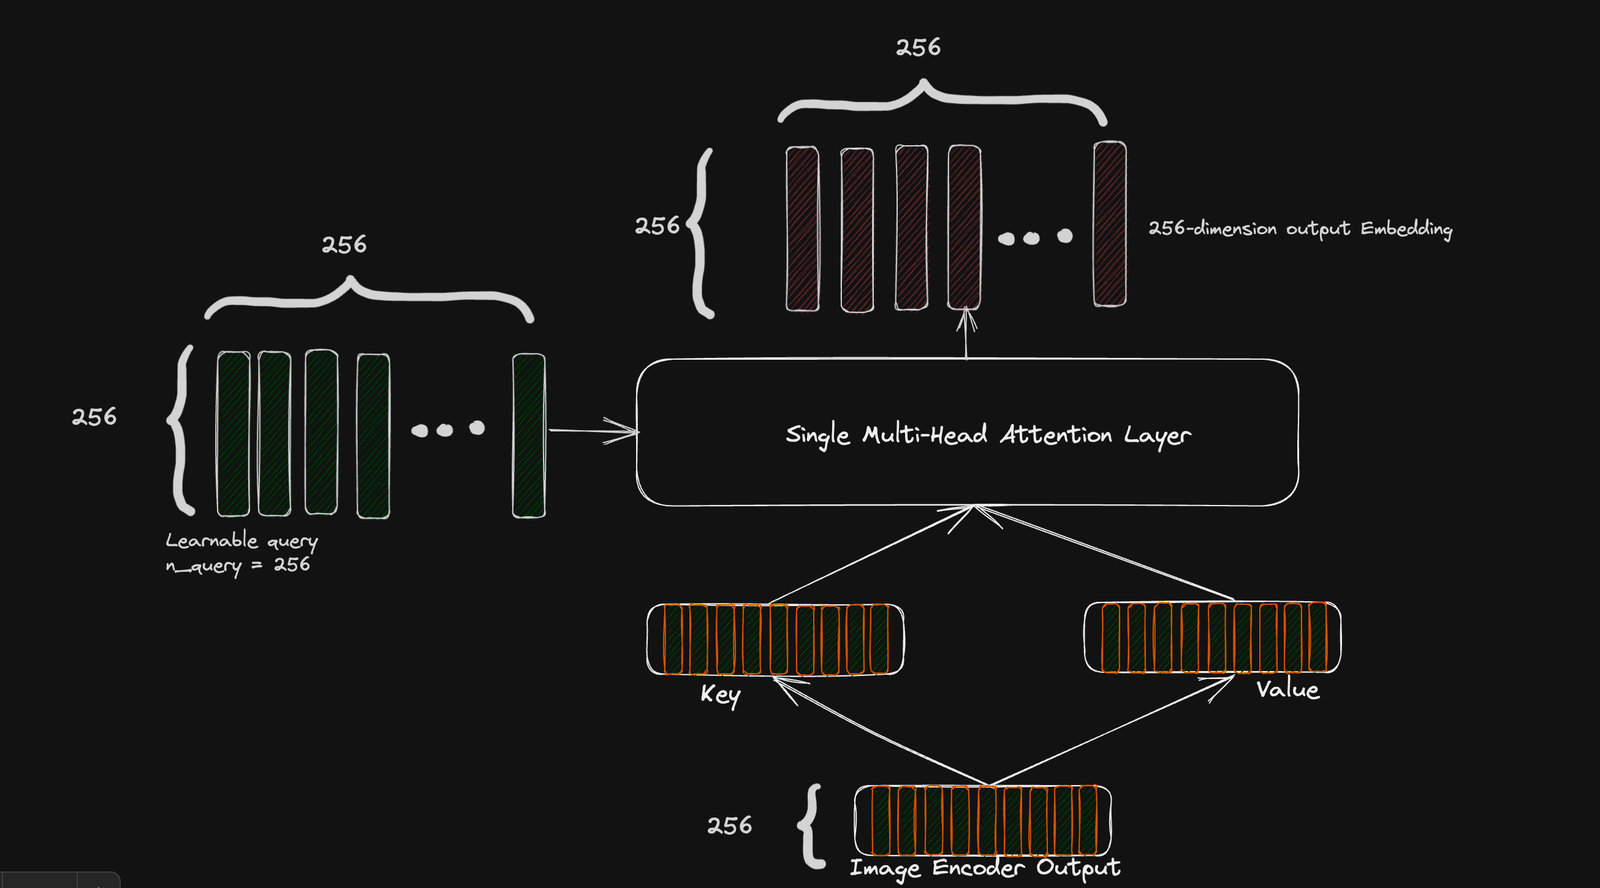
In tegenstelling tot het contrastieve doel, dat alleen een globale representatie van het beeld vereist, is het generatieve doel effectiever wanneer we een fijnmazigere representatie van het beeld genereren.
Zoals uitgelegd verkrijgen we de fijnmazige beeldrepresentatie door de query-parameter op een willekeurig getal in te stellen (256 in de CoCa-paper), wat een rijke representatie van 256 x 256 van het beeld oplevert.
Deze representatie gaat naar het bovenste deel van de losgekoppelde decodersetup en levert, via cross-modale interactie met de unimodale tekstrepresentatie (waarbij de CLS-representatie wordt genegeerd), een verenigde beeld-tekstrepresentatie op. Die wordt gebruikt om via autoregressieve factorisatie een waarschijnlijkheidsverdeling over de woordenschat te voorspellen.
Zoals in de voorgaande twee secties is geïllustreerd, maakt de architectuur van het CoCa-model het mogelijk om de capaciteiten te bundelen van een klasse modellen die uitblinken in zero-shot-learntaken zoals beeldclassificatie en cross-modale retrieval, en een andere klasse die uitblinkt in VQA en beeldbeschrijving. Het CoCa-model kan bovendien worden fijngesteld voor verschillende downstream visie- en taaltaken.
De komst van foundation-modellen zoals CoCa is een belangrijke stap voorwaarts in machine learning. CoCa verenigt de sterke punten van verschillende paradigma’s en biedt een uniform model dat beeld- en tekstrepresentaties kan uitlijnen én gezamenlijke beeld-tekstrepresentaties kan genereren.
Dit model is een bewijs van het potentieel van het integreren van contrastieve en generatieve doelen, en effent het pad voor betere prestaties bij taken als Visual Question Answering en beeldbeschrijving. Het verenigt de capaciteiten van modellen die uitblinken in zero-shot-learntaken en modellen die sterk zijn in multimodaal beeld-tekstbegrip, en biedt zo een veelzijdig hulpmiddel voor tal van downstream visie- en taaltaken.
Voor wie dieper wil duiken in geavanceerde concepten in machine learning en de finesses van deep learning wil verkennen: de Advanced Deep Learning with Keras-cursus op DataCamp geeft je de kennis en vaardigheden om uiteenlopende problemen op te lossen met de veelzijdige Keras functional API, zodat je geavanceerde modellen zoals CoCa en hun onderliggende principes nog beter kunt doorgronden.
blog
Adel Nehme
15 min