Dieses Tutorial ist ein geschätzter Beitrag aus unserer Community und wurde von DataCamp im Hinblick auf Verständlichkeit und Korrektheit bearbeitet.
Du möchtest dein Know-how teilen? Wir freuen uns auf dich! Reiche deine Artikel oder Ideen gern über unser Community Contribution Form ein.
Die Entwicklung des Machine Learnings hat zu sogenannten Foundation-Modellen geführt: vortrainierte Modelle auf umfangreichen Daten, die als vielseitige Basis für eine Vielzahl von Anwendungen dienen. Diese Modelle, etwa GPT und BERT in der Natural Language Processing (NLP), zeigen beeindruckende Fähigkeiten in Zero-shot- und Few-shot-Learning-Aufgaben.
In diesem Artikel tauchen wir in die Welt der Bild-Text-Foundation-Modelle ein und beleuchten das innovative Contrastive Captioner (CoCa) Modell. Wir zerlegen seine Architektur, erklären den kombinierten Ansatz aus kontrastivem und generativem Ziel und zeigen, wie es die Stärken von Modellen wie CLIP und SIMVLM in einem einzigen, schlüssigen Modell vereint.
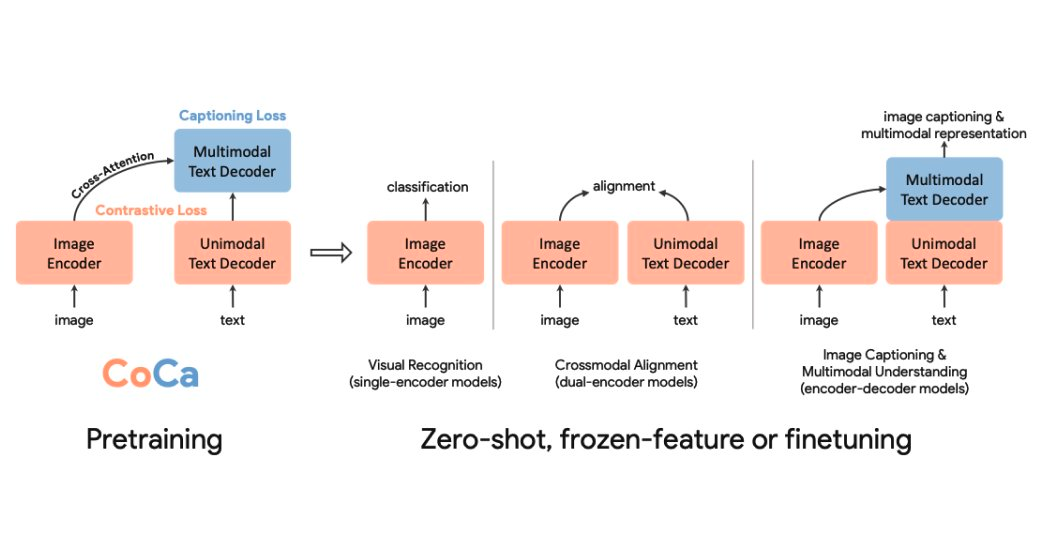
Abb. 1 - Contrastive Captioner - (CoCa)
Der Aufstieg der Foundation-Modelle
Die Idee von Foundation-Modellen ist im Machine Learning nicht neu. In der Deep Learning-Praxis ermöglichen Trainingsverfahren, diese Modelle später für Downstream-Aufgaben anzupassen. In der NLP gab es einen Boom bei Foundation-Modellen wie GPT und BERT, die auf großen, teils verrauschten Internetdaten trainiert wurden und bemerkenswerte Zero-shot- und Few-shot-Fähigkeiten zeigen.
Die Forschung zu Vision- und Vision-Language-Foundation-Modellen hat drei Hauptpfade untersucht: Single-Encoder-Modelle, Bild-Text-Dual-Encoder mit kontrastivem Loss und Encoder-Decoder-Modelle mit generativem Ziel. Bevor wir CoCa erkunden, werfen wir einen Blick auf diese Ansätze und ihre Schwächen.
Glossar
- Foundation-Modelle. Vortrainierte Modelle, die als Ausgangspunkt für verschiedene Machine-Learning-Anwendungen dienen und sich für spezifische Aufgaben anpassen lassen.
- Contrastive Loss. Eine Verlustfunktion, die Modelle darauf trainiert, ähnliche Repräsentationen für ähnliche Eingabepaare und unähnliche für unähnliche Paare zu lernen.
- Cross-Modal Interaction. Die Interaktion zwischen unterschiedlichen Datenmodalitäten (z. B. Bild und Text), um eine gemeinsame Repräsentation zu erzeugen.
- Encoder-Decoder-Architektur. Eine neuronale Struktur mit einem Encoder zur Verarbeitung der Eingabe und einem Decoder zur Ausgabeerzeugung, häufig für Sequence-to-Sequence-Aufgaben.
- Causal Masking. Eine Technik in Transformer-Modellen, um während des Trainings den Zugriff auf zukünftige Tokens in der Sequenz zu verhindern.
- Attention-Mechanismus. Eine Komponente, mit der Modelle unterschiedliche Teile der Eingabe gewichten und priorisieren können.
- Zero-Shot Learning. Ein Lernparadigma, bei dem Modelle Vorhersagen für Klassen treffen, die sie im Training nicht gesehen haben.
- Visual Question Answering (VQA). Eine Aufgabe, bei der Modelle Fragen zum Inhalt von Bildern beantworten und damit Computer Vision und Natural Language Processing verbinden.
- Unimodale und Multimodale Repräsentationen. Unimodale Repräsentationen erfassen Informationen aus einer Datenmodalität, multimodale integrieren Informationen aus mehreren Modalitäten.
- Contrastive Language-Image Pre-training (CLIP). Ein Modell, das mittels kontrastiven Lernens Bilder und Texte in einem gemeinsamen Repräsentationsraum ausrichtet.
Single-Encoder-Modelle
Wenn du dich schon mit Computer Vision beschäftigt hast, bist du dieser Modellklasse vermutlich begegnet. Diese Modelle lernen Bildrepräsentationen, die sich später für Downstream-Vision-Aufgaben anpassen lassen, indem sie auf großen, annotierten Datensätzen mit Cross-Entropy-Loss trainiert werden.
Empirisch schneiden sie bei visionbezogenen Aufgaben wie Detektion hervorragend ab, sind jedoch bei Vision-Language-Aufgaben schwächer, da sie stark auf menschliche Annotationen angewiesen sind und so natürliche Sprache nicht von Grund auf mitlernen.
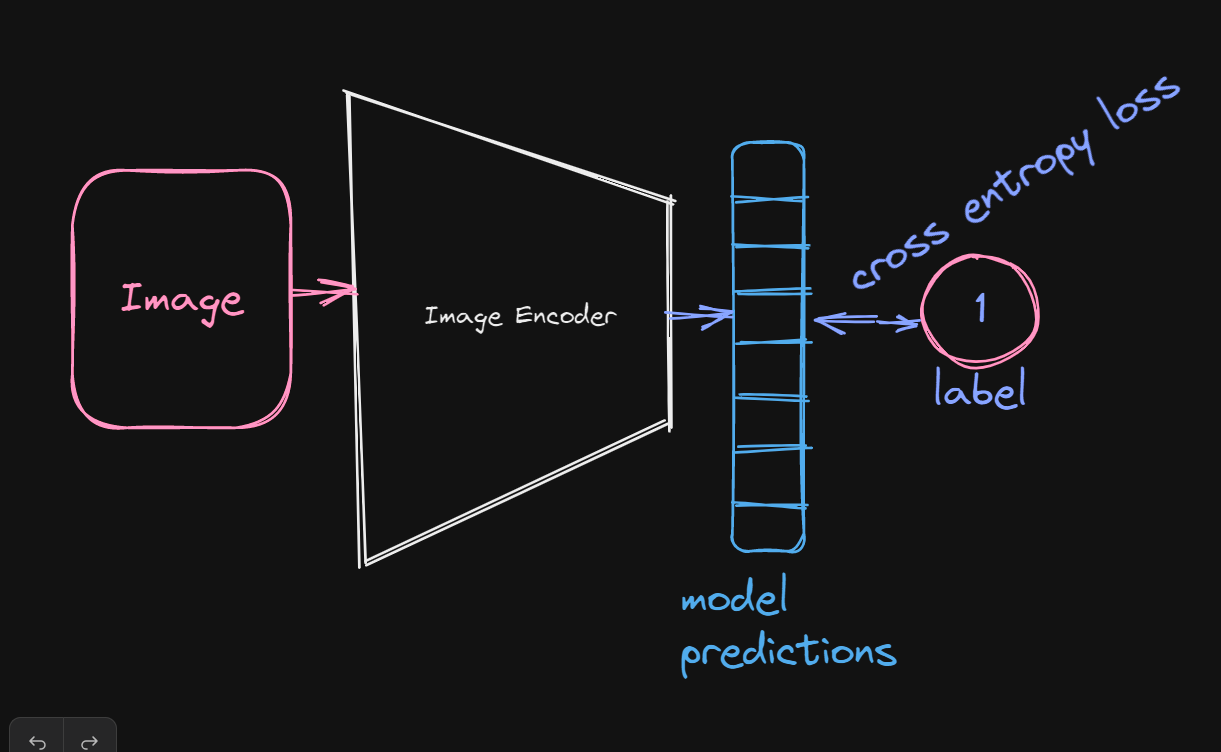
Bild-Text-Dual-Encoder mit kontrastivem Loss
Beliebte Vertreter dieser Vision-Language-Foundation-Modelle sind CLIP (Contrastive Language-Image Pre-training) und ALIGN.
Beim Pre-Training wird eine Alignment-Aufgabe gelernt, indem ein Bild- und ein Sprachmodell gemeinsam mit einem kontrastiven Loss trainiert werden.
Die Idee dahinter ist einfach: Repräsentationen zusammengehöriger Bild-Text-Paare werden im selben latenten Raum nahe beieinander gruppiert, nicht zusammengehörige Bilder und Texte hingegen auseinander gedrückt. Das resultierende Dual-Encoder-Modell kann anschließend für Zero-shot-Klassifikation und Bildsuche eingesetzt werden.
Neuere Modelle dieser Klasse, wie CLIP, erreichen beeindruckende Leistungen auf diversen Vision-Language-Aufgaben, sind jedoch kaum nutzbar für Aufgaben, die eine verschmolzene Bild-Text-Repräsentation erfordern, etwa Visual Question Answering. Der Grund: Es wird nur die Ausrichtung von Bild- und Textrepräsentationen gelernt, nicht aber eine einheitliche Repräsentation, die beide Eingaben gemeinsam kodiert.
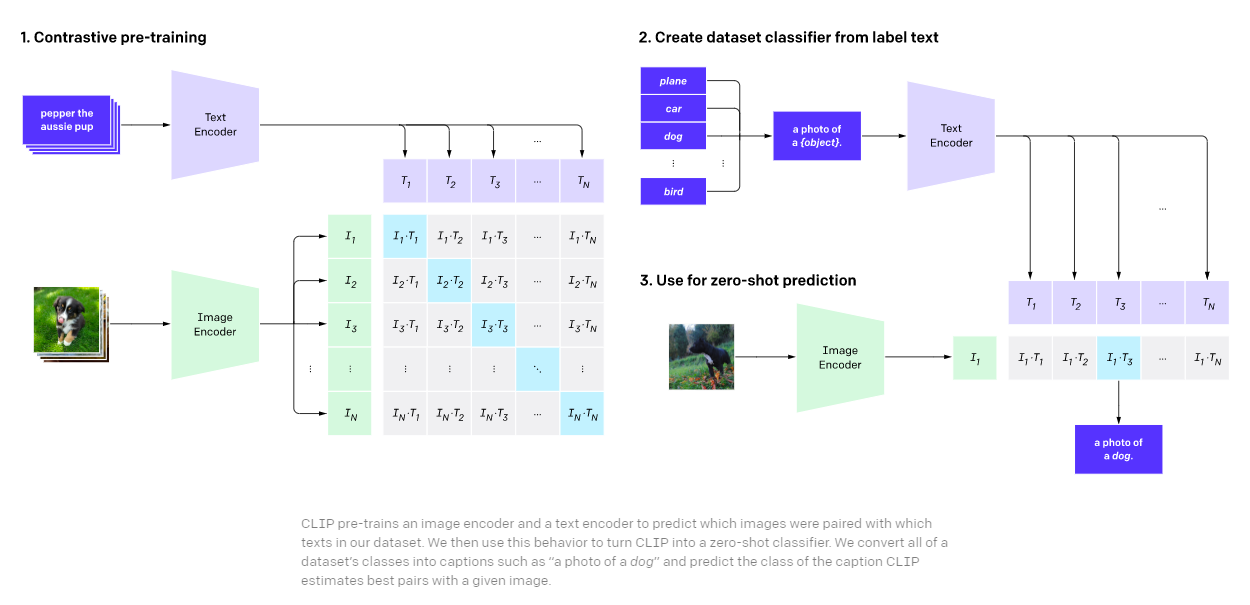
Abb. 3 - Contrastive Language-Image Pre-training (CLIP)
Generatives Pre-Training mit Encoder-Decoder-Architektur
Diese Modelle nutzen Cross-Modal-Interaktion zwischen verborgenen Bild- und Textrepräsentationen, um eine gemeinsame Repräsentation zu erzeugen.
Beim Pre-Training entsteht durch Cross-Modal-Interaktionen zwischen der verborgenen Textrepräsentation und dem Output des Bildencoders eine einheitliche Bild-Text-Repräsentation. Auf den Decoder-Output wird anschließend ein Language-Modeling-Loss angewandt.
In aktuellen ML-Architekturen erfolgt Cross-Modal-Interaktion meist über Cross-Attention in Transformern, wobei Bildencoder-Ausgaben als Query und verborgene Textrepräsentationen als Key und Value dienen.
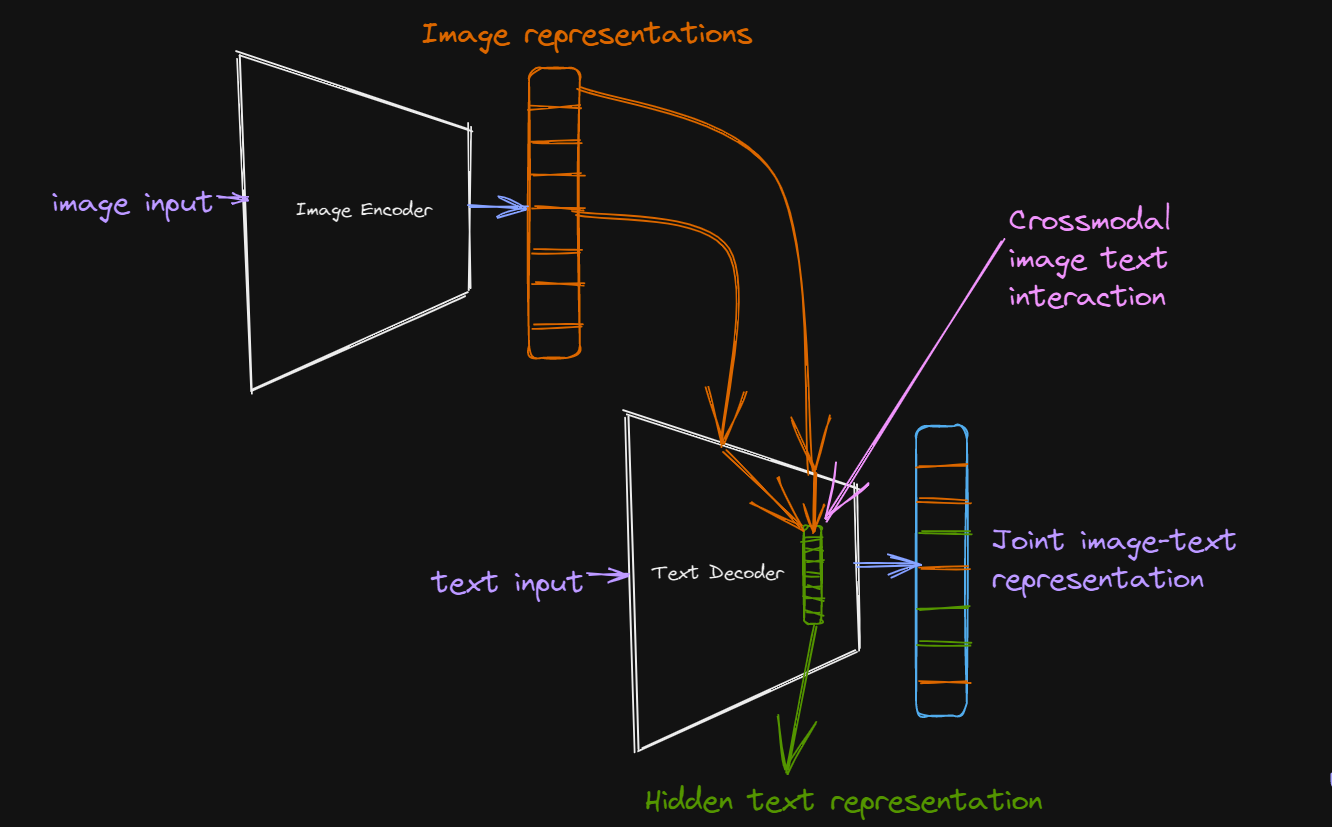
Für Downstream-Aufgaben lässt sich der Decoder-Output, also die gemeinsame Bild-Text-Repräsentation, verwenden, um verschiedene multimodale Aufgaben wie Visual Question Answering zu lösen. Ein aktuelles Modell, das diesem Paradigma folgt, ist das Simple Visual Language Model (SIMVLM).
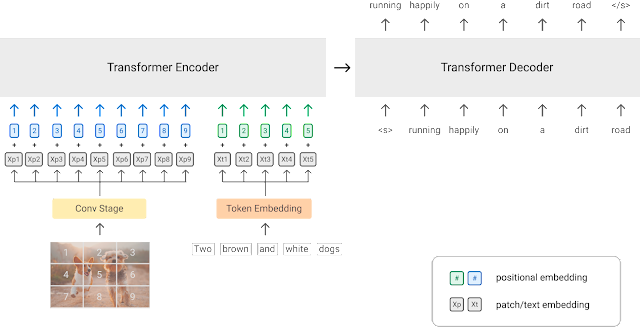
Abb. 5 - Simple Visual Language Model (SIMVLM)
Motivation hinter CoCa
Die Autorinnen und Autoren von CoCa wollten die Fähigkeiten verschiedener Paradigmen zum Aufbau von Bild-Text-Foundation-Modellen in einem einfachen Modell vereinen. CoCa nutzt einen kontrastiven Loss, um Bild- und Textrepräsentationen in einem Vektorraum auszurichten, und ein generatives Ziel (Captioning-Loss), um eine gemeinsame Bild-Text-Repräsentation zu lernen. So werden die Stärken von Modellen wie CLIP und SIMVLM in einem einzigen Modell gebündelt.
Modellarchitektur
CoCa setzt auf den klassischen Encoder-Decoder-Ansatz und kodiert Bilder – wie die meisten Modelle dieser Art – mit einem neuronalen Netz, etwa einem Convolutional Neural Network oder einem Transformer.
Die Besonderheit der CoCa-Architektur beginnt beim Encoder-Output und der gesamten Decoder-Konfiguration.
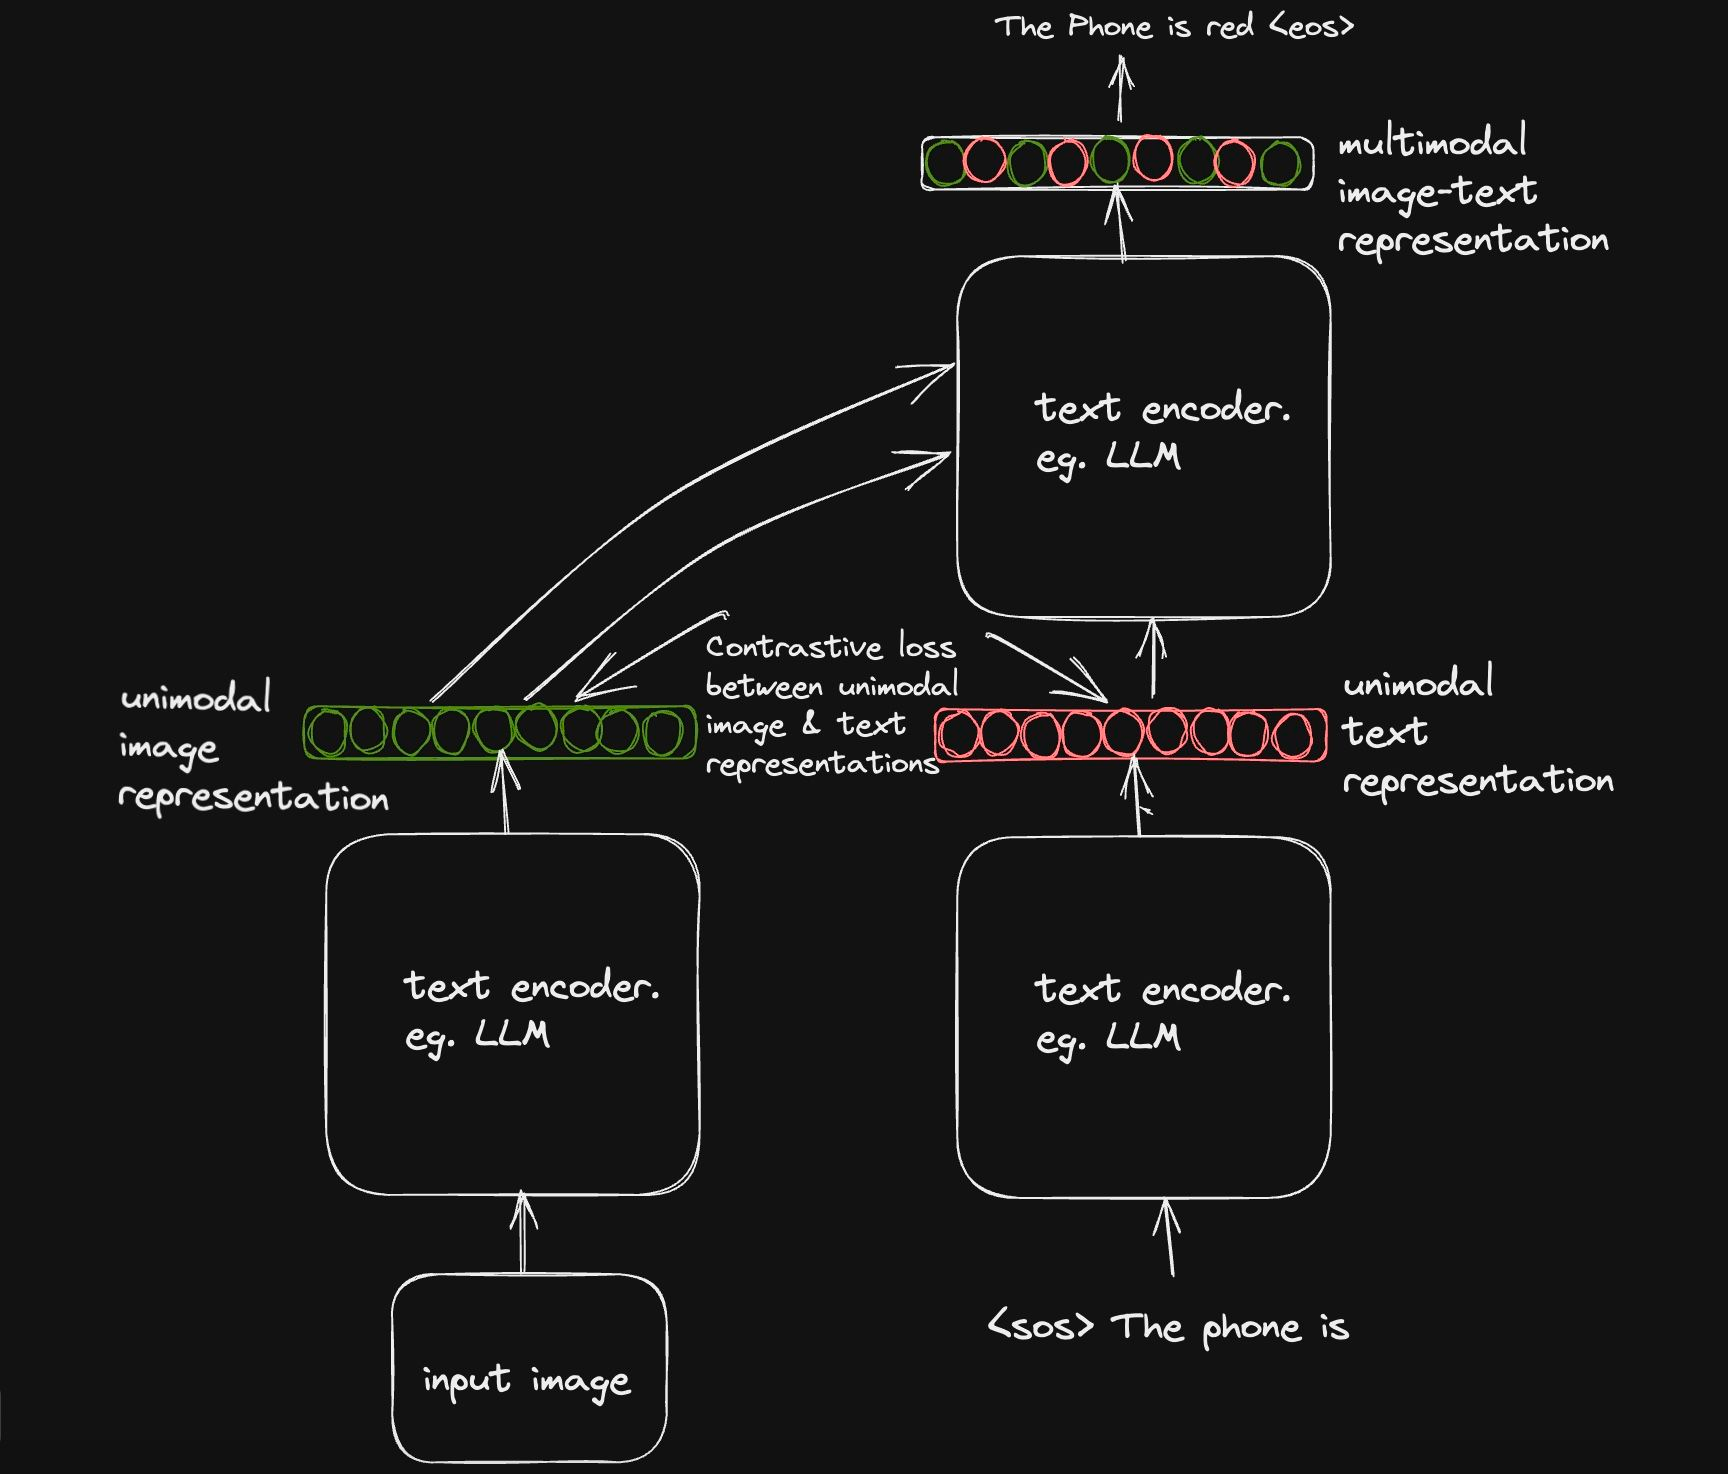
Ziel des CoCa-Papers ist es, die Fähigkeiten zweier Vision-Language-Paradigmen (kontrastives und generatives Ziel) in einem Modell zu kombinieren. Das kontrastive Paradigma verlangt, dass der Textdecoder eine unimodale Textrepräsentation ausgibt, die dann in denselben Vektorraum wie die Bildrepräsentation projiziert wird, um das Alignment zu lernen.
Das generative Ziel erlaubt dem Decoder dagegen, Bildrepräsentationen aus dem Encoder aufzunehmen und bedingt auf Bildrepräsentationen und Texteingabe autoregressiv Text zu erzeugen.
Beachte, dass in beiden Decoder-Teilen Causal Masking eingesetzt wird, damit das Modell nicht auf zukünftige Tokens blickt.
Dafür passt CoCa ein entkoppeltes Decoder-Setup an: Der erste Teil lernt, eine unimodale Textrepräsentation für das kontrastive Ziel zu erzeugen, der zweite Teil lernt, eine multimodale Bild-Text-Repräsentation zu generieren.
Kontrastives Ziel
Die Idee des kontrastiven Ziels, wie in Modellen wie CLIP und ALIGN, ist simpel: Für unterschiedliche Modalitäten wie Bild und Text werden Repräsentationen gelernt, sodass ähnliche Paare im Repräsentationsraum nahe beieinander liegen und unähnliche weiter auseinander.
In jedem Trainingsschritt ziehen wir eine Stichprobe von Bild-Text-Paaren und treiben die Encoder-Gewichte so, dass Paare zusammenclustern und Nicht-Paare auseinanderdriften.
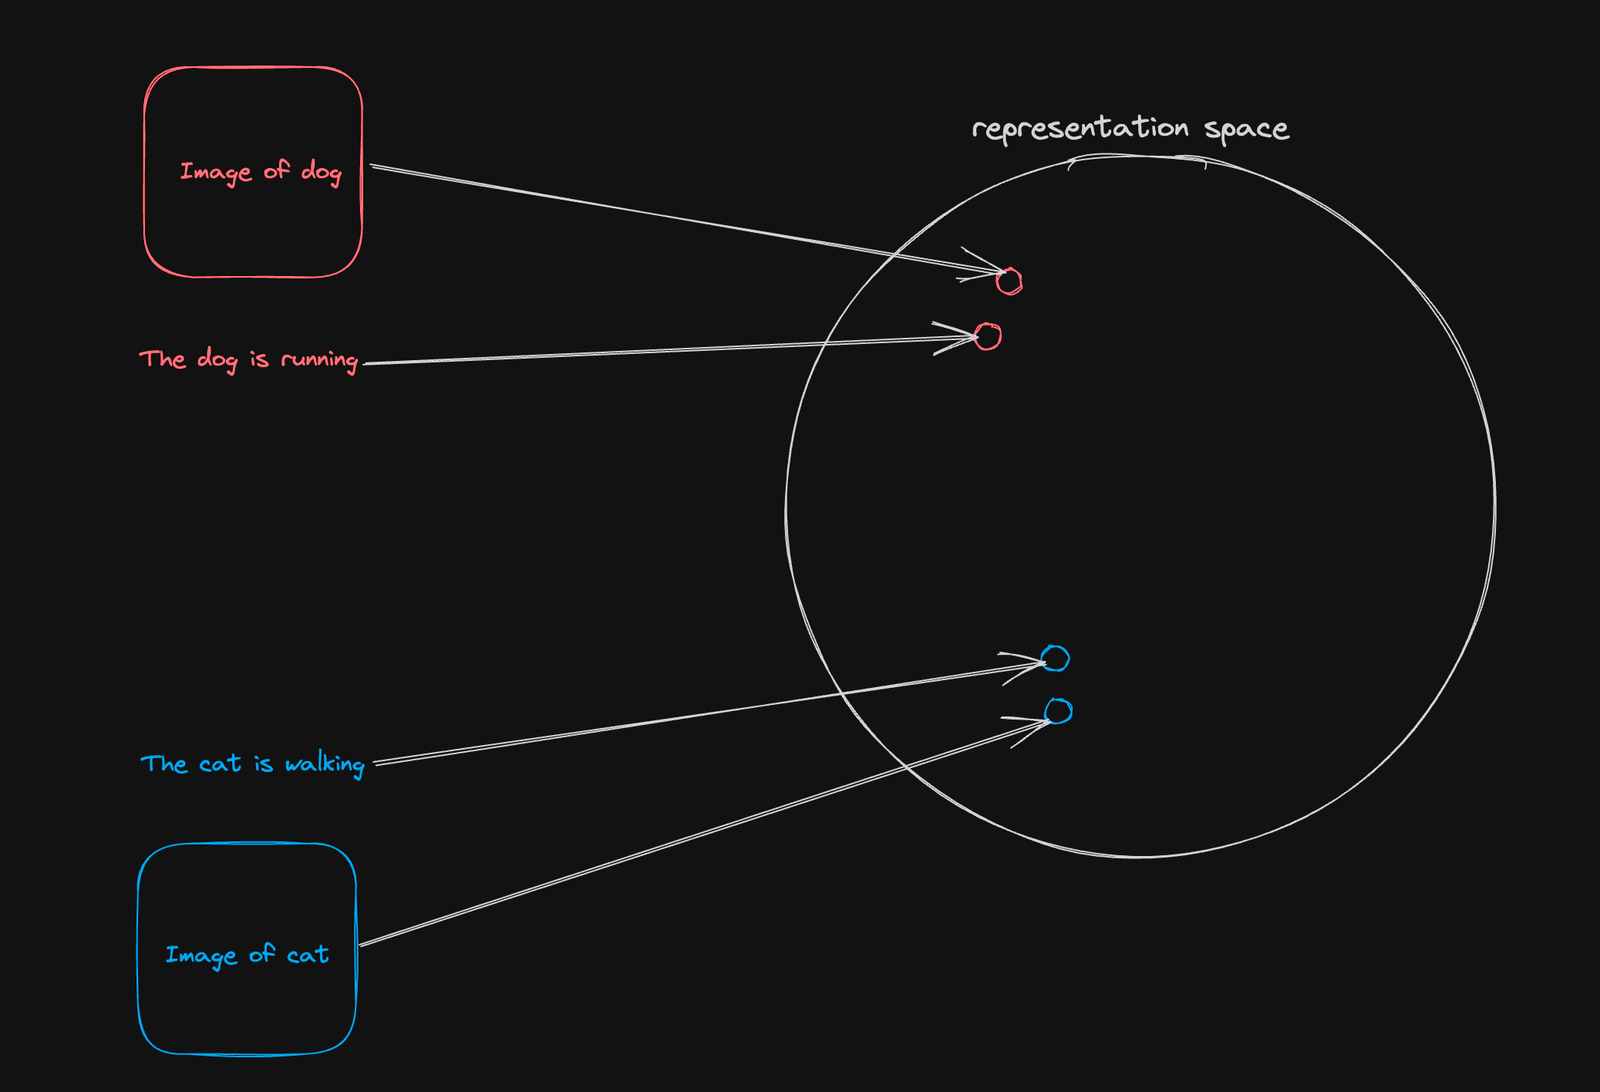
Wie erwähnt, verlangt das kontrastive Ziel unimodale Repräsentationen beider Modalitäten. Auf der Textseite nutzen wir dazu eine bekannte Technik aus dem BERT-Sprachmodell.
Wir fügen am Ende der Eingabesequenz ein lernbares Klassifikationstoken [CLS] ein und hoffen, dass der zu diesem Token gemappte Ausgabevektor die semantische Bedeutung der gesamten Sequenz einfängt.
Da unsere Decoder in ihren Attention-Maps Causal Masking verwenden, stellt die Position am Sequenzende sicher, dass das Klassifikationstoken mit allen anderen Tokens in der Eingabe verbunden ist und so die Semantik des gesamten Satzes erfasst.
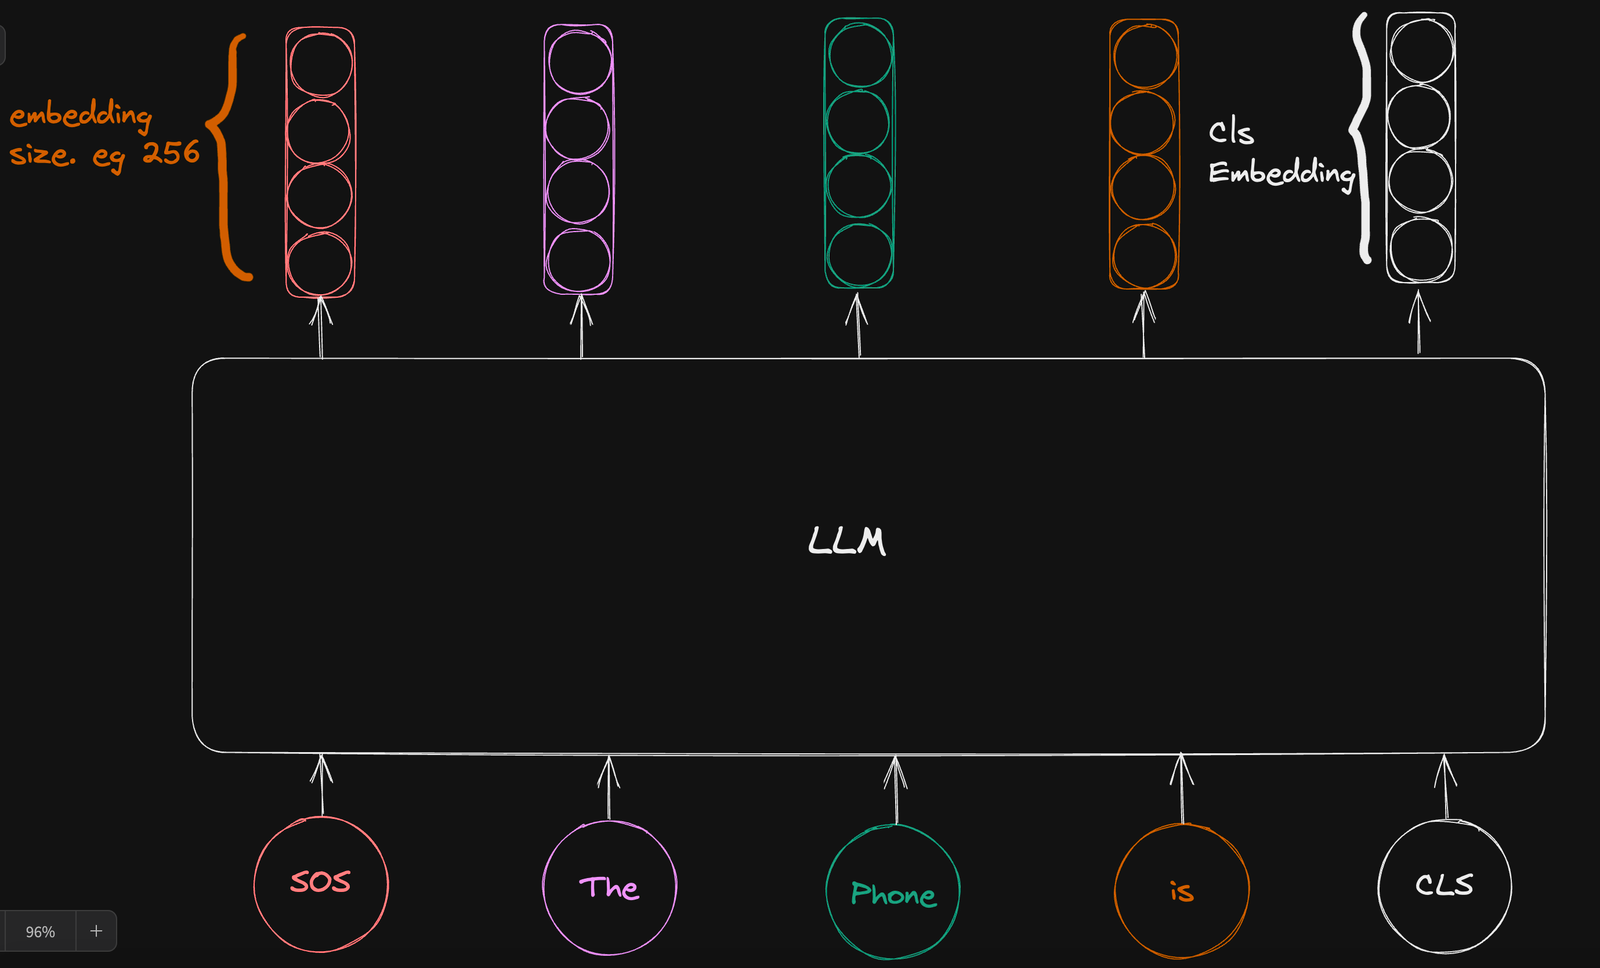
Wir ignorieren die Vektoren der übrigen Eingabetokens und verwenden die Vektordarstellung des Klassifikationstokens zur Schätzung des kontrastiven Loss.
Auf der Bildencoder-Seite ist es etwas anders.
In Abb. 6 siehst du, dass ein Teil des Bildencoder-Outputs zusammen mit der Einbettung des Klassifikationstokens zur Schätzung des kontrastiven Loss genutzt wird, während der andere Teil in den oberen Strang des entkoppelten Setups fließt, um die gemeinsame Repräsentation zu bestimmen.
Tatsächlich reicht für das kontrastive Ziel eine einzige Bildeinbettung, während für das generative Ziel die gesamte Sequenz der Bildencoder-Einbettungen verwendet wird.
Die Autorinnen und Autoren zeigen empirisch, dass ein einzelnes gepooltes Embedding die globale Bildrepräsentation gut einfängt (genau das braucht das kontrastive Ziel), während eine Sequenz von Embeddings Aufgaben unterstützt, die eine feinere Bildbeschreibung erfordern.
Dafür kommt eine Attentional-Pooling-Schicht zum Einsatz, eine einzelne Multi-Head-Attention-Layer, die den Bildencoder-Output über einen lernbaren Query-Parameter für unterschiedliche Ziele zuschneidet. Durch Setzen des Query-Parameters auf einen bestimmten Integer-Wert lässt sich der Encoder so anpassen, dass er eine Embedding-Sequenz der gewünschten Länge ausgibt.
Für das kontrastive Ziel setzen wir den Query-Parameter auf 1, um ein einzelnes Embedding für den Loss zu erhalten. Für das generative Ziel wählen wir einen beliebigen Wert, idealerweise in der Länge der Textsequenz. Im CoCa-Paper wurde 256 verwendet.
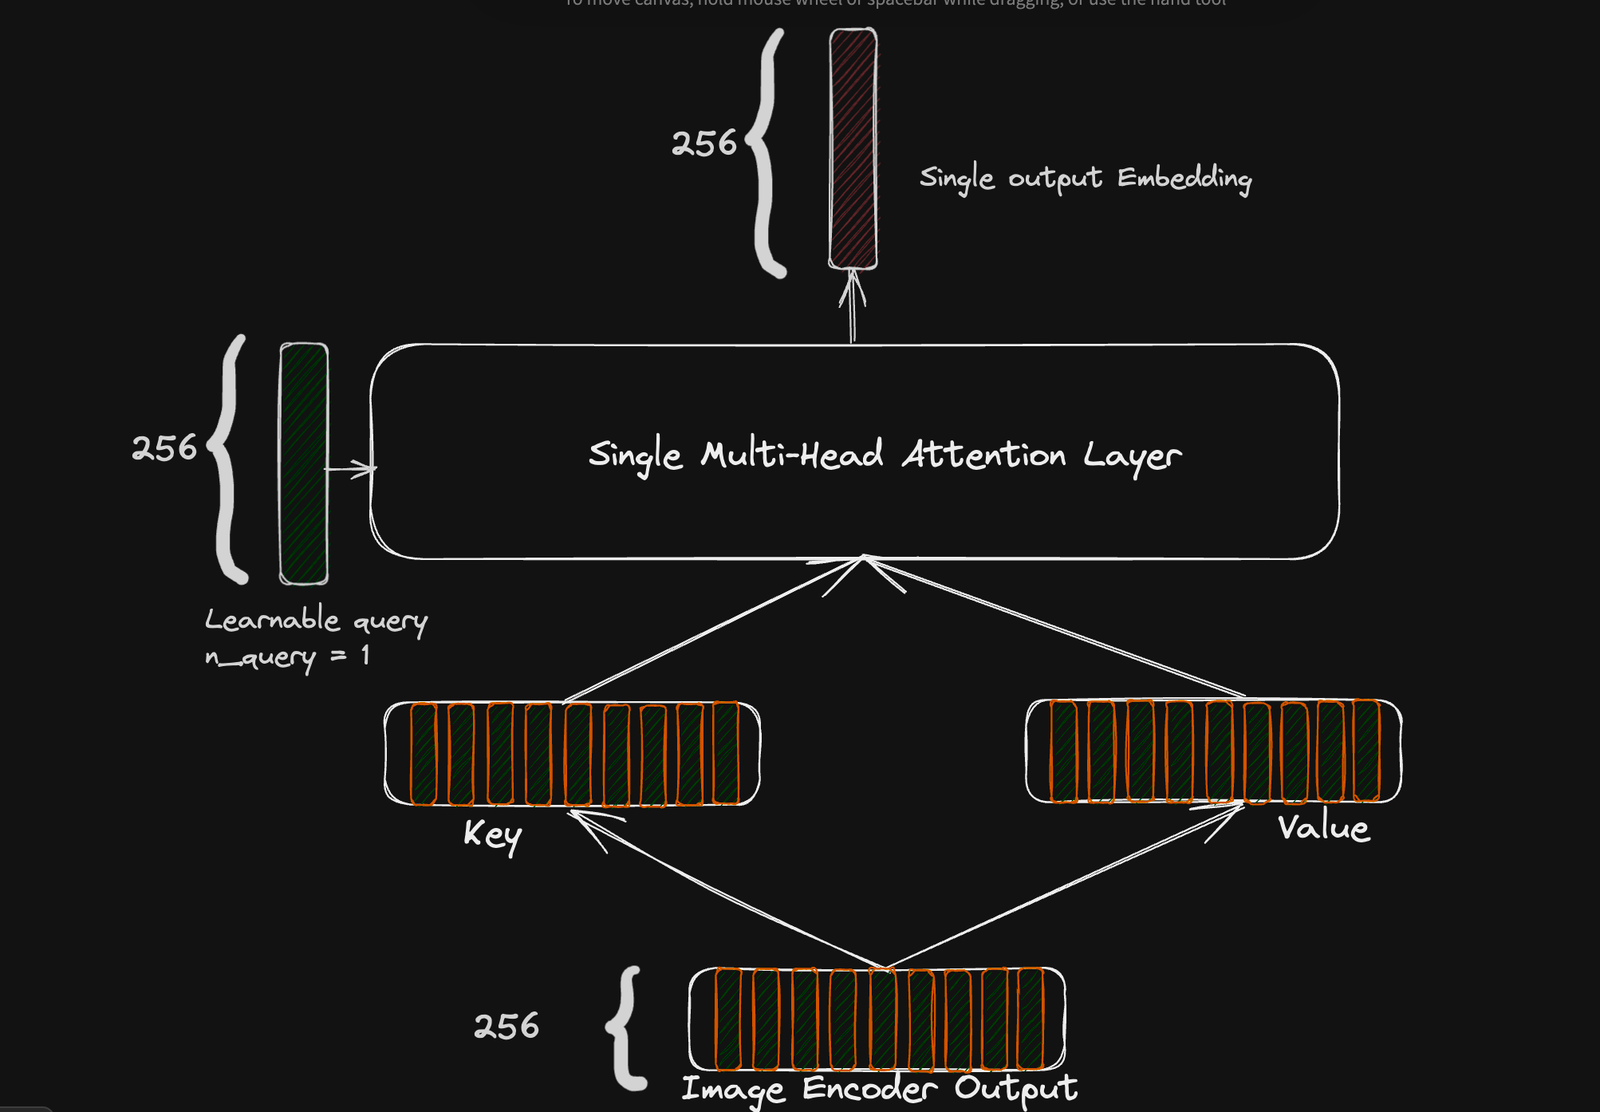
Attention-Pooling-Setup für den kontrastiven Loss. Der Output der Attention-Schicht ist ein einzelnes Embedding mit 256 Dimensionen.
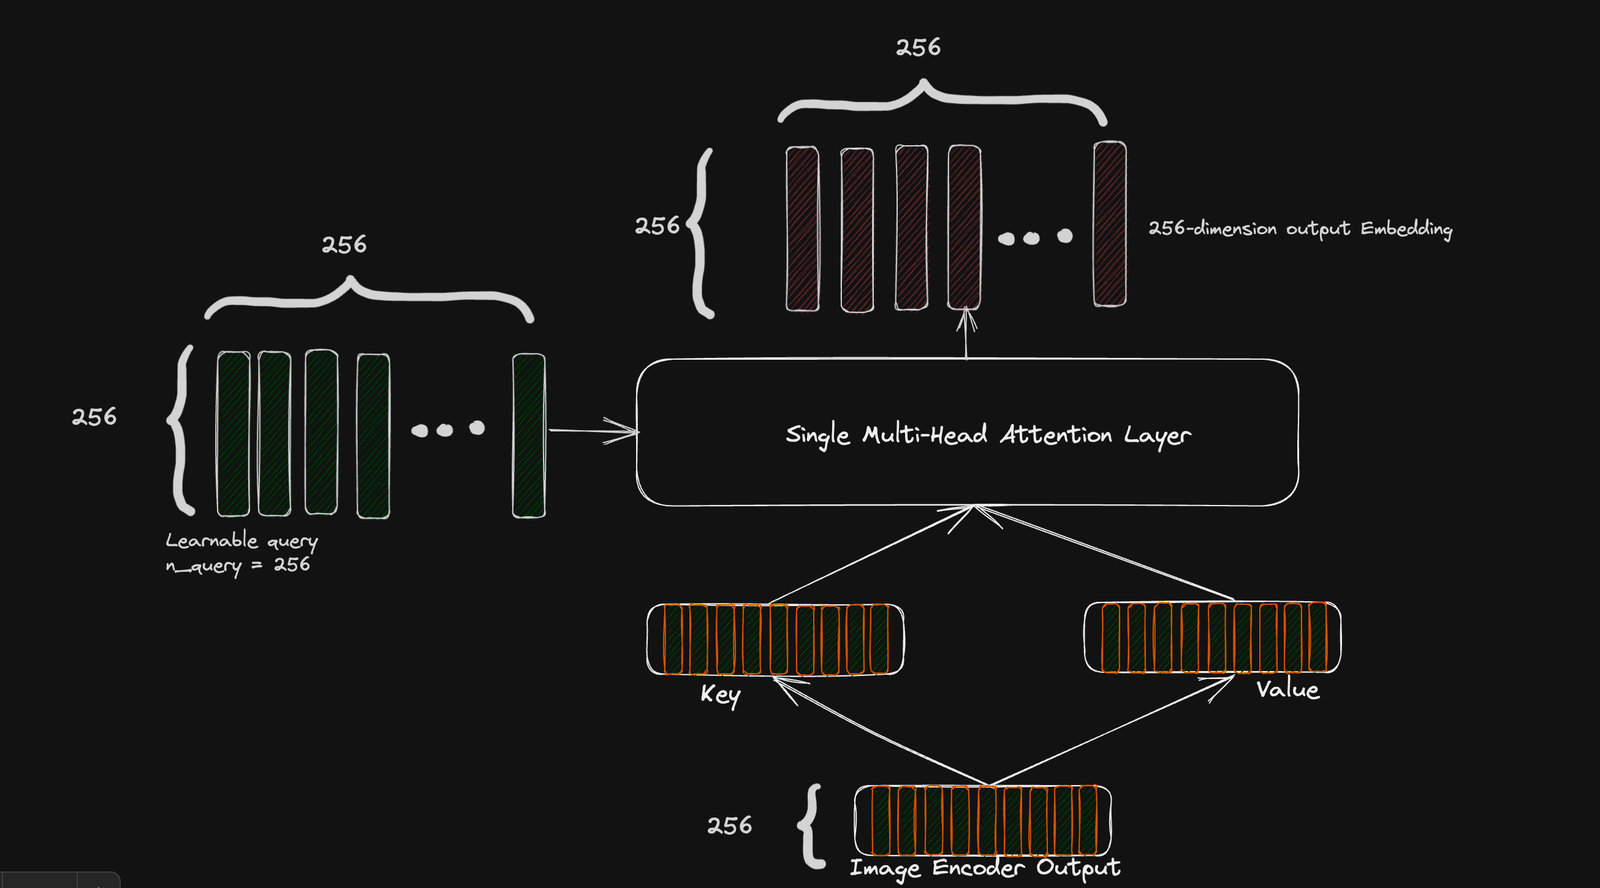
Generatives Ziel
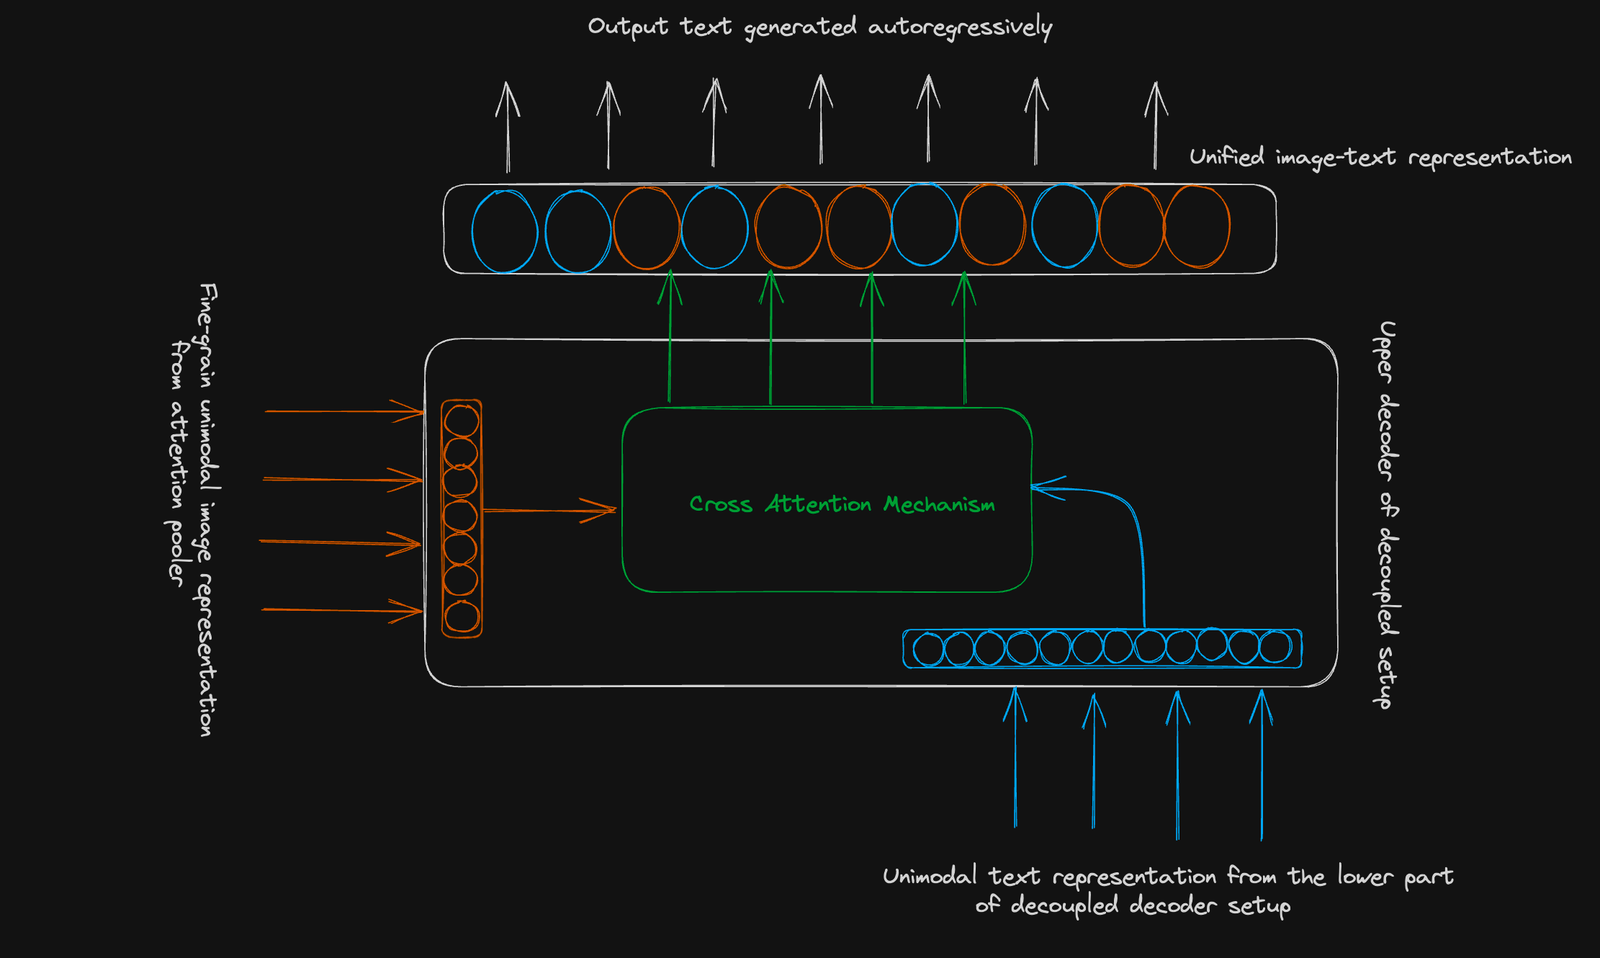
Im Gegensatz zum kontrastiven Ziel, das nur eine globale Bildrepräsentation benötigt, profitiert das generative Ziel von einer feineren Bildbeschreibung.
Wie beschrieben erhalten wir die feinkörnige Bildrepräsentation, indem wir den Query-Parameter auf eine Zahl setzen (im CoCa-Paper 256), die eine 256 x 256 reichhaltige Darstellung des Bildes erzeugt.
Diese Repräsentation geht in den oberen Strang des entkoppelten Decoders. Durch Cross-Modal-Interaktion mit der unimodalen Textrepräsentation (ohne die CLS-Repräsentation) entsteht eine einheitliche Bild-Text-Repräsentation, die über eine autoregressive Faktorisierung zur Vorhersage einer Wahrscheinlichkeitsverteilung über das Vokabular verwendet wird.
Wie in den letzten beiden Abschnitten gezeigt, ermöglicht die CoCa-Architektur, die Fähigkeiten einer Modellklasse für Zero-shot-Aufgaben wie Bildklassifikation und Cross-Modal-Retrieval sowie einer weiteren Klasse für VQA und Bildbeschreibung zu vereinen. CoCa lässt sich zudem für verschiedene Downstream-Aufgaben in Vision und Sprache feinabstimmen.
Fazit
Das Aufkommen von Foundation-Modellen wie CoCa ist ein bedeutender Schritt im Machine Learning. CoCa bündelt die Stärken verschiedener Paradigmen und bietet ein einheitliches Modell, das Bild- und Textrepräsentationen ausrichtet und gemeinsame Bild-Text-Repräsentationen generiert.
Das Modell zeigt, welches Potenzial in der Kombination aus kontrastiven und generativen Zielen steckt und ebnet den Weg für bessere Leistungen bei Aufgaben wie Visual Question Answering und Bildbeschreibung. Es vereint die Stärken von Modellen für Zero-shot-Learning und solchen für multimodales Bild-Text-Verständnis und bietet damit ein vielseitiges Werkzeug für zahlreiche Downstream-Aufgaben in Vision und Sprache.
Wenn du tiefer in fortgeschrittene Konzepte des Machine Learnings eintauchen und die Feinheiten des Deep Learnings erkunden möchtest, vermittelt dir der Advanced Deep Learning with Keras Course auf DataCamp das nötige Wissen und die Kompetenzen, um mit der vielseitigen Keras Functional API unterschiedlichste Probleme zu lösen – und Modelle wie CoCa sowie ihre Grundlagen noch besser zu verstehen.