Este tutorial es una valiosa contribución de nuestra comunidad y DataCamp lo ha editado para mejorar su claridad y precisión.
¿Te gustaría compartir tu experiencia? ¡Nos encantaría leerte! Envía tus artículos o ideas a través de nuestro formulario de contribución de la comunidad.
La evolución del aprendizaje automático ha dado lugar a los modelos base, una clase de modelos preentrenados en grandes volúmenes de datos que sirven como punto de partida versátil para multitud de aplicaciones. Estos modelos, con referentes como GPT y BERT en el procesamiento del lenguaje natural (NLP), han demostrado capacidades sin precedentes en tareas como el aprendizaje zero-shot y few-shot.
En este artículo nos adentramos en los modelos base imagen-texto, con el innovador modelo Contrastive Captioner (CoCa). Desgranaremos su arquitectura, entenderemos su enfoque único que combina objetivos contrastivos y generativos, y veremos cómo integra las capacidades de modelos como CLIP y SIMVLM en un único modelo cohesionado.
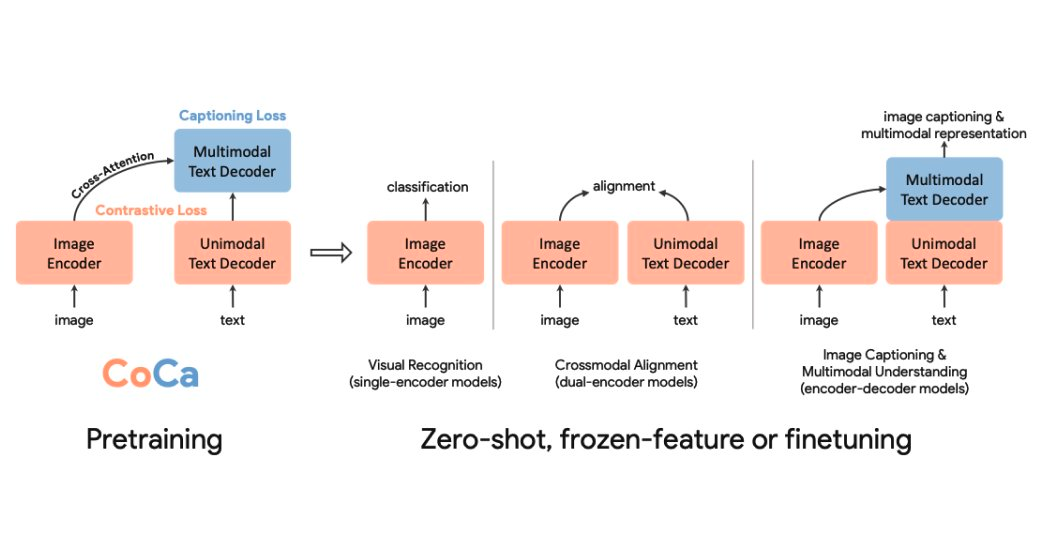
Fig-1 - Contrastive Captioner - (CoCa)
El auge de los modelos base
La idea de los modelos base no es nueva en aprendizaje automático. En deep learning, las técnicas que permiten entrenarlos facilitan su adaptación posterior a tareas específicas. En NLP, ha habido un boom de modelos base como GPT y BERT, entrenados con datos ruidosos a escala de Internet, que han mostrado capacidades destacadas en zero-shot y few-shot.
La investigación para construir modelos base de visión y visión-lenguaje ha explorado tres vías principales: modelos de un único codificador, modelos de doble codificador imagen-texto con pérdida contrastiva y modelos encoder-decoder con objetivo generativo. Antes de meternos con CoCa, veamos estas líneas de trabajo y sus debilidades.
Glosario
- Modelos base. Modelos preentrenados que sirven como punto de partida para distintas aplicaciones en aprendizaje automático y se adaptan a tareas concretas.
- Pérdida contrastiva. Función de pérdida que entrena modelos para aprender representaciones similares para pares de entrada similares y distintas para pares no relacionados.
- Interacción multimodal. Interacción entre distintos tipos de modalidades de datos (p. ej., imagen y texto) para generar una representación conjunta.
- Arquitectura encoder-decoder. Estructura de red neuronal con un codificador que procesa la entrada y un decodificador que genera la salida; se usa en tareas de secuencia a secuencia.
- Enmascarado causal. Técnica en transformadores que impide el acceso a tokens futuros de la secuencia durante el entrenamiento.
- Mecanismo de atención. Componente que permite ponderar y priorizar distintas partes de la entrada al procesar información.
- Aprendizaje zero-shot. Paradigma en el que los modelos hacen predicciones o clasificaciones sobre clases de datos que no han visto en el entrenamiento.
- Visual Question Answering (VQA). Tarea en la que los modelos responden preguntas sobre el contenido de imágenes, combinando visión por computador y NLP.
- Representaciones unimodales y multimodales. Las unimodales capturan información de una sola modalidad de datos; las multimodales integran información de varias.
- Contrastive Language-Image Pre-training (CLIP). Modelo entrenado con aprendizaje contrastivo para alinear imágenes y texto en un espacio de representación compartido.
Modelos de un único codificador
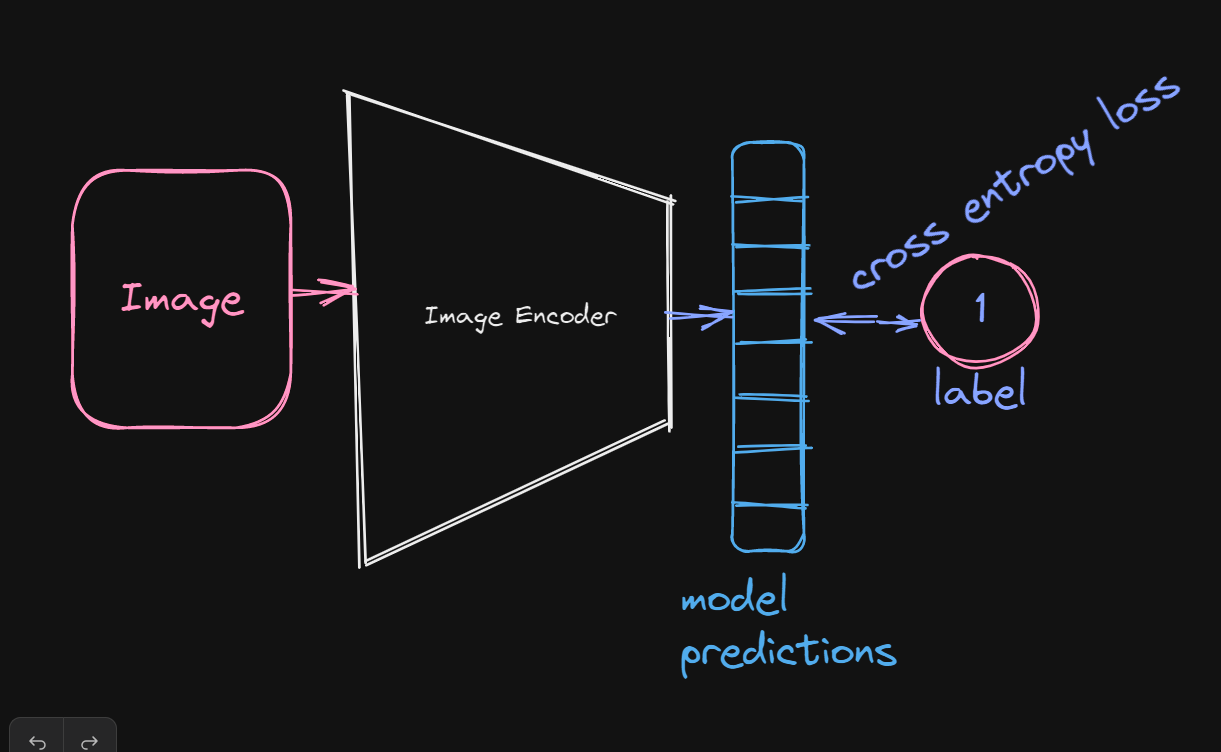
Si has trasteado con visión por computador, seguramente conozcas esta clase de modelos. Aprenden representaciones de imágenes que luego se pueden adaptar a tareas de visión entrenando con grandes conjuntos de imágenes anotadas y una pérdida de entropía cruzada.
Han demostrado rendir muy bien en tareas de visión como la detección, pero se quedan cortos en tareas de visión-lenguaje por su fuerte dependencia de anotaciones humanas, lo que impide incorporar lenguaje natural humano en el propio modelo.
Modelos dual-encoder imagen-texto con pérdida contrastiva
Entre los modelos más populares de esta categoría están CLIP (Contrastive Language-Image Pre-training) y ALIGN.
Durante el preentrenamiento, se aprende una tarea de alineamiento entrenando conjuntamente un modelo de imagen y otro de lenguaje con una pérdida contrastiva.
La idea del objetivo de preentrenamiento es sencilla: agrupar las representaciones de pares imagen-texto relacionados y separar las representaciones de imágenes y textos no relacionados en el mismo espacio latente. El modelo de doble codificador resultante puede configurarse para hacer clasificación zero-shot y recuperación de imágenes.
Modelos recientes como CLIP logran resultados notables en varias tareas de visión-lenguaje, pero son casi imposibles de usar en tareas que requieren una representación fusionada de imagen y texto, como VQA, ya que solo aprenden a alinear representaciones de imagen y texto, no a generar una representación unificada que codifique información de ambas entradas.
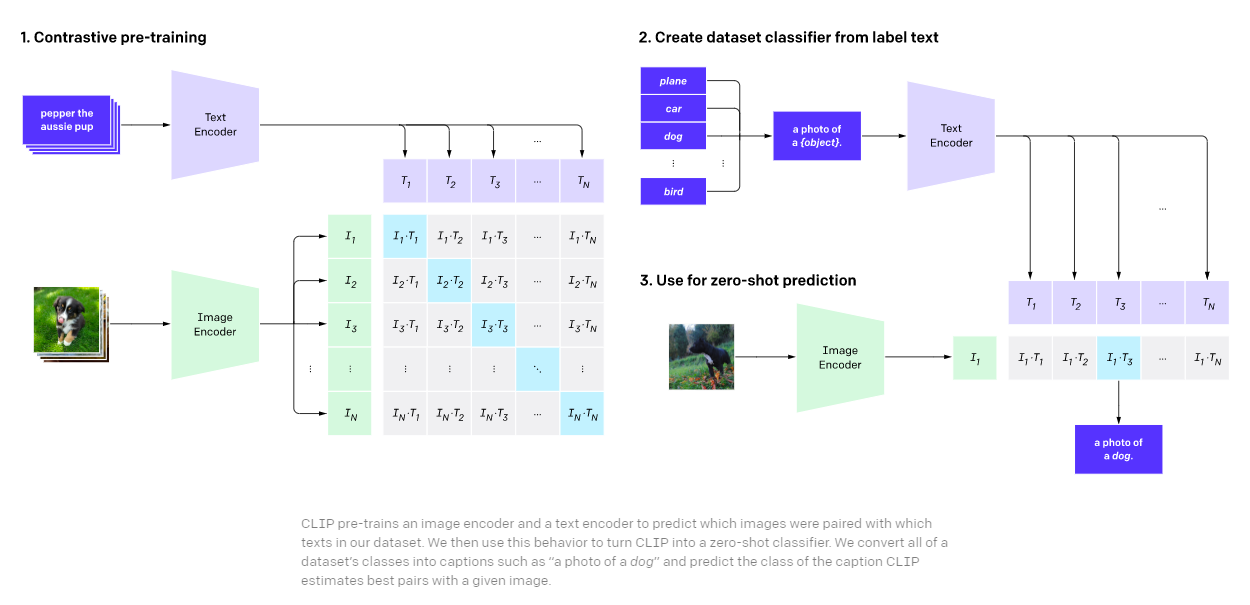
Fig-3 - Contrastive Language-Image Pre-training (CLIP)
Preentrenamiento generativo con arquitectura encoder-decoder
Estos modelos emplean interacción multimodal entre las representaciones ocultas de imagen y texto para generar una representación conjunta.
Durante el preentrenamiento, generamos una representación unificada de imagen y texto mediante interacciones cruzadas entre la representación textual oculta y la salida del codificador de imagen, y aplicamos una pérdida de modelado del lenguaje sobre la salida del decodificador.
En arquitecturas recientes, la interacción multimodal suele realizarse con un mecanismo de atención cruzada en transformadores, usando las salidas del codificador de imagen como query y las representaciones textuales ocultas como key y value.
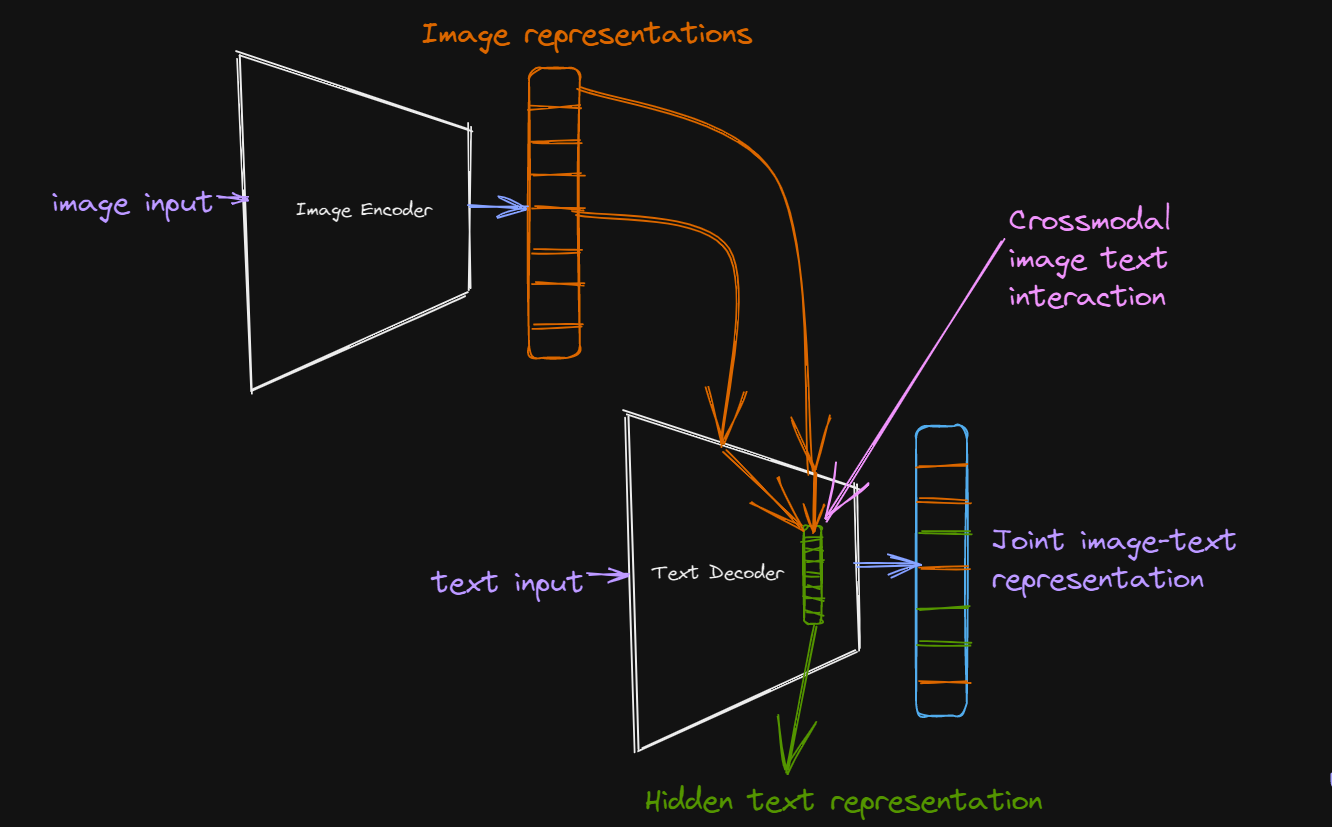
Para las tareas downstream, podemos tomar la salida del decodificador, que es una representación conjunta de imagen y texto, y abordar diversas tareas multimodales como VQA. Un modelo reciente que usa este paradigma es Simple Visual Language Model (SIMVLM).
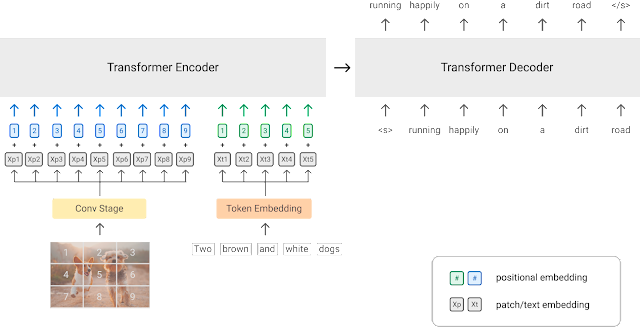
Fig-5 - Simple Visual Language Model (SIMVLM)
Motivación de CoCa
Los autores de CoCa buscaron reunir en un modelo sencillo las capacidades de los distintos paradigmas para construir modelos base imagen-texto. El diseño de CoCa aprovecha una pérdida contrastiva para alinear representaciones de imagen y texto en un mismo espacio vectorial y un objetivo generativo (pérdida de subtitulado) para aprender una representación conjunta imagen-texto, incorporando así las capacidades de modelos como CLIP y SIMVLM en uno solo.
Arquitectura del modelo
CoCa emplea el enfoque estándar encoder-decoder y, como la mayoría de modelos de este tipo, codifica la imagen con una red neuronal como una red neuronal convolucional o un transformer.
La singularidad de CoCa empieza en la salida de su codificador y en toda la configuración del decodificador.
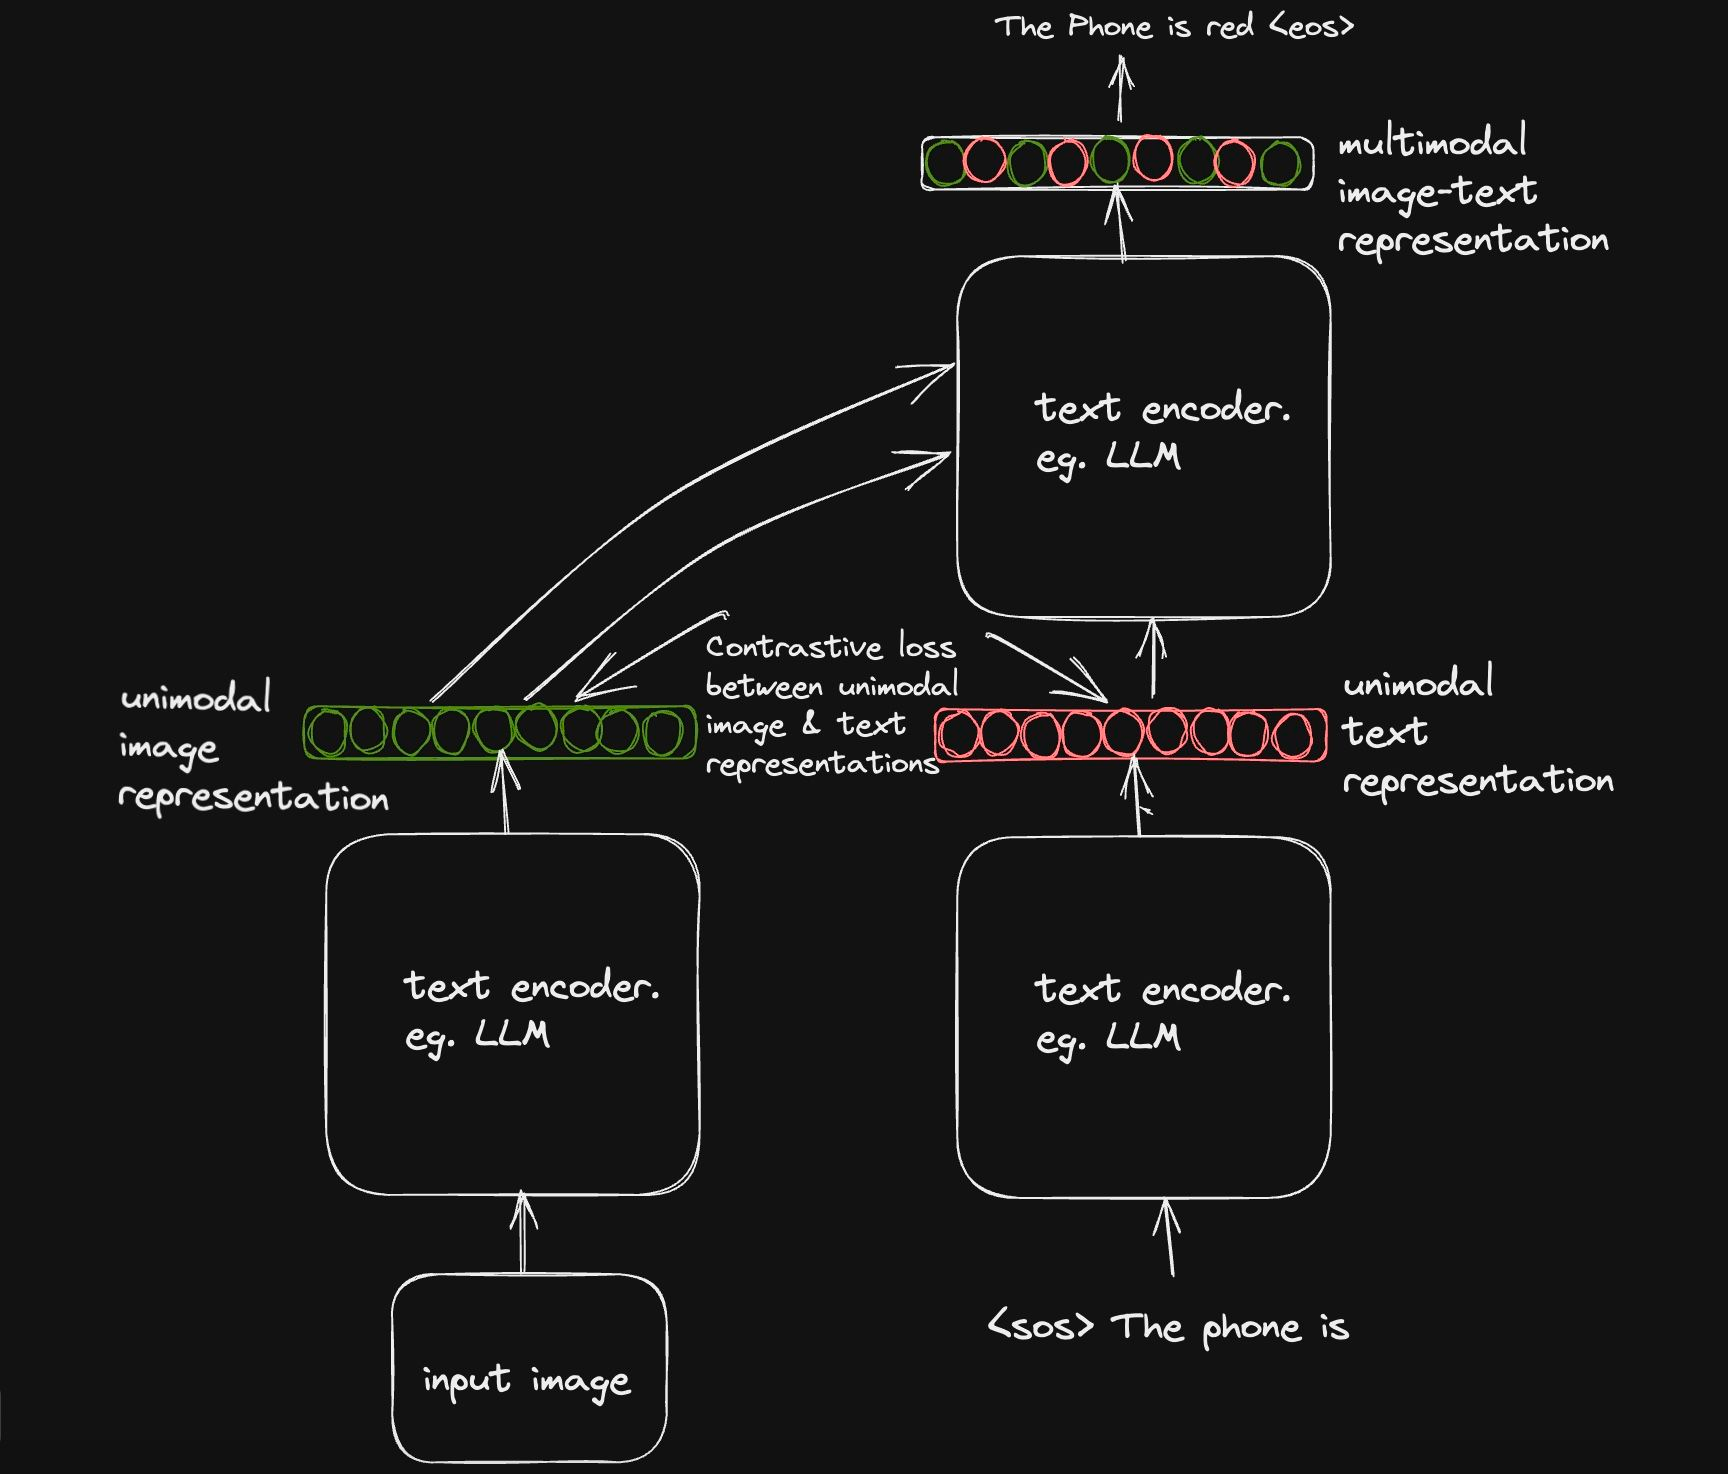
Recuerda que el objetivo del artículo de CoCa es combinar las capacidades de dos paradigmas de modelos visión-lenguaje (objetivo contrastivo y objetivo generativo) en un único modelo. El paradigma contrastivo exige que el decodificador de texto produzca una representación textual unimodal, que luego se proyecta a un espacio vectorial similar al de la representación de imagen para aprender la tarea de alineamiento.
El objetivo generativo, por su parte, permite que el decodificador reciba representaciones de imagen del codificador y genere texto de forma autorregresiva condicionado por la imagen y la entrada de texto.
Ten en cuenta que ambas partes del decodificador aplican enmascarado causal para evitar que el modelo mire tokens futuros.
Para lograrlo, los autores adaptan inteligentemente una configuración de decodificador desacoplado: la primera parte aprende a producir una representación textual unimodal para el objetivo contrastivo y la segunda aprende a generar una representación multimodal imagen-texto.
Objetivo contrastivo
La idea del objetivo contrastivo, como en modelos como CLIP y ALIGN, es sencilla: aprender una representación para modalidades distintas, como imagen y texto, de modo que los pares similares queden cerca en el espacio de representación y los no similares se alejen.
En cada paso de entrenamiento, muestreamos pares imagen-texto del conjunto de datos y ajustamos los pesos de los codificadores para agrupar los pares correctos y separar los que no lo son.
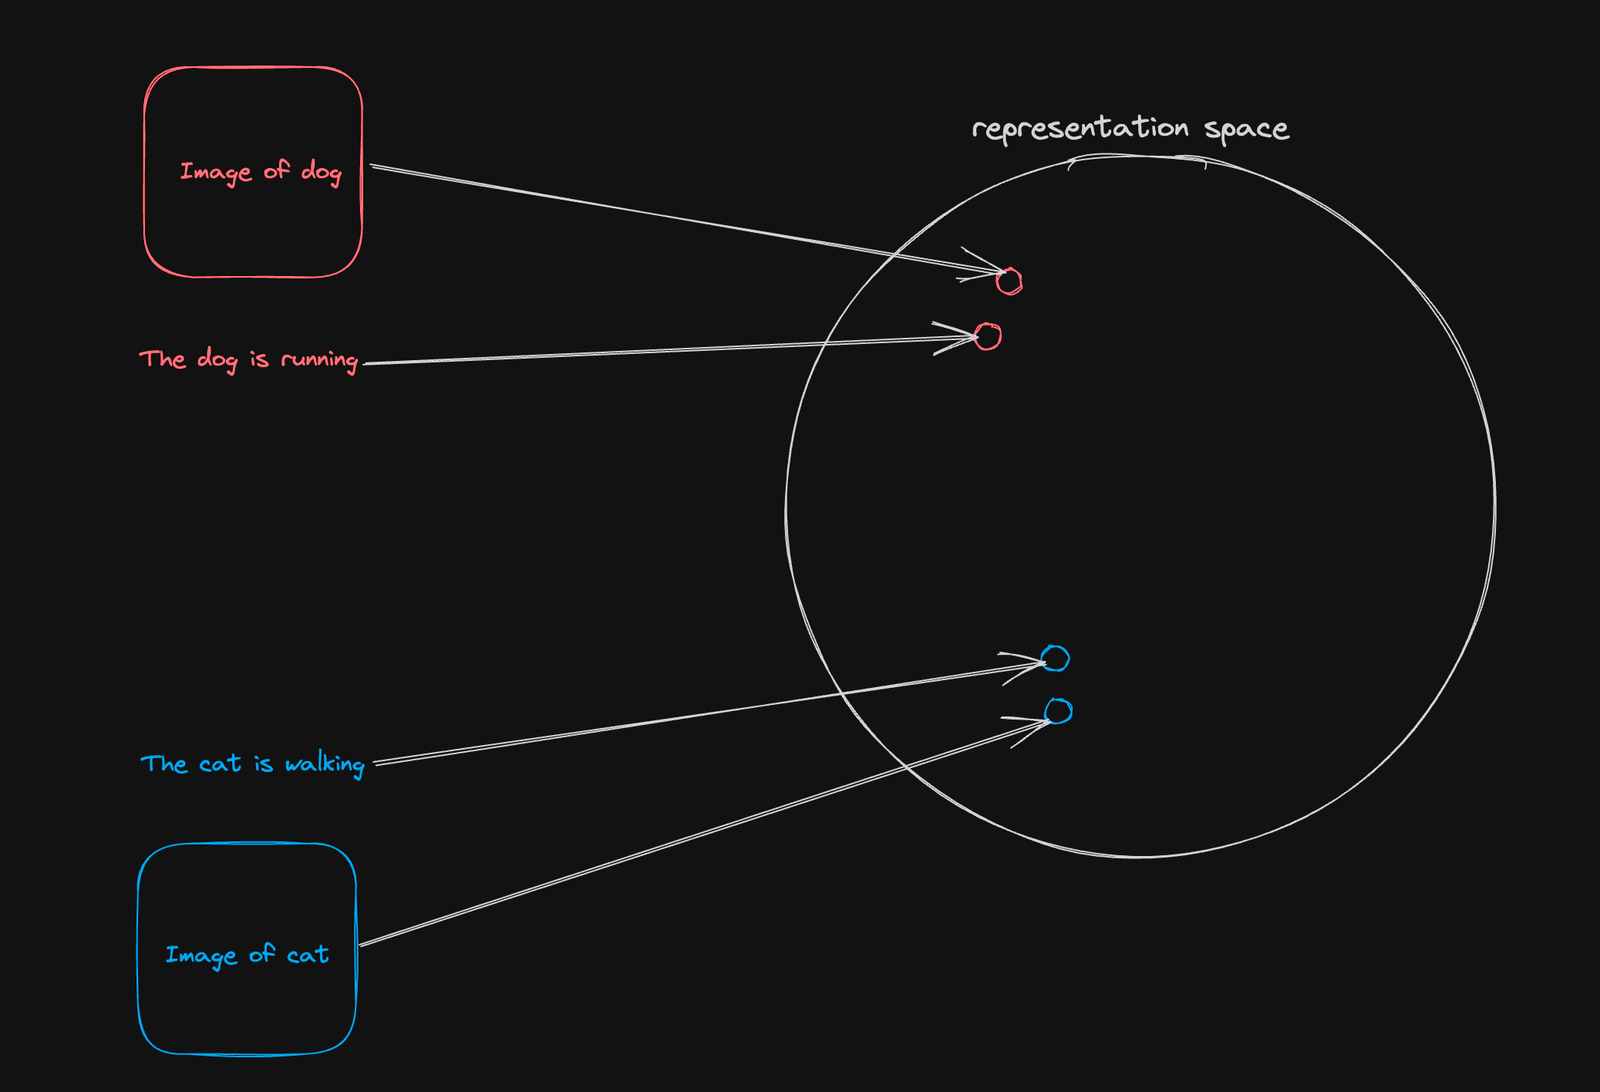
Como comentábamos, el objetivo contrastivo requiere representaciones unimodales de imagen y texto. Para conseguirlo en el lado de texto, aplicamos una técnica clásica usada en BERT.
Como parte de la secuencia de entrada, introducimos un token de clasificación aprendible [CLS] al final de la secuencia y esperamos que el vector asociado a ese token capture el significado semántico de toda la entrada.
Dado que los decodificadores aplican enmascarado causal en sus mapas de atención, añadir el token de clasificación al final garantiza que exista una conexión de atención entre dicho token y todos los demás tokens de la entrada, capturando así el significado de toda la frase.
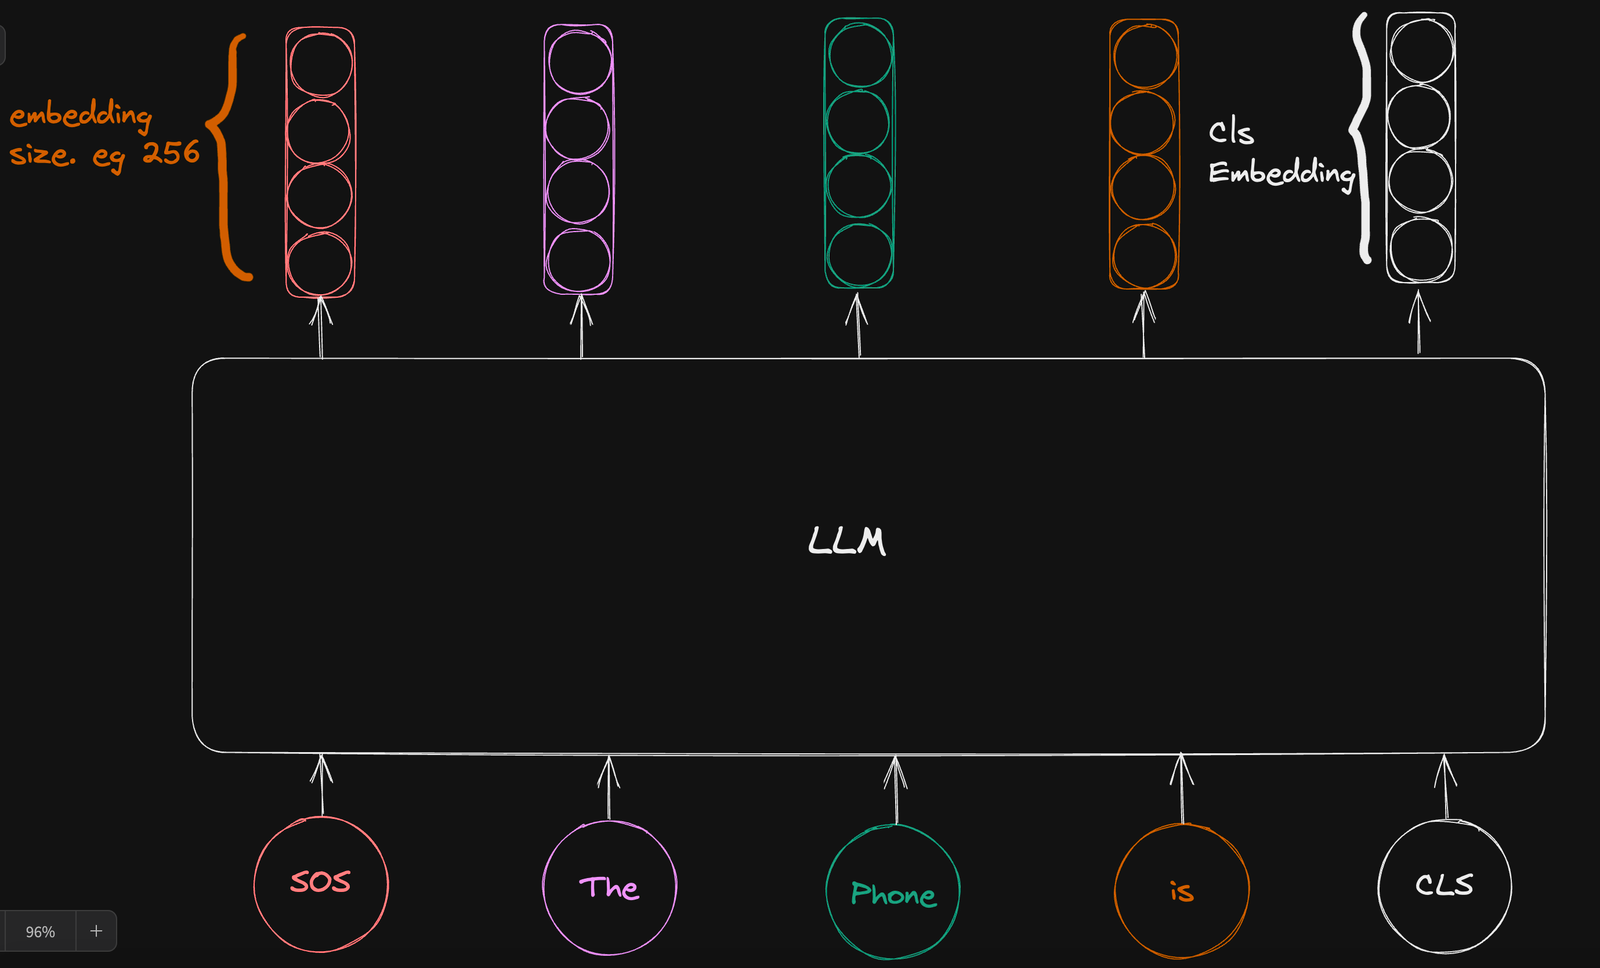
Ignoramos la representación vectorial del resto de tokens y usamos la del token de clasificación para estimar la pérdida contrastiva.
En el codificador de imagen, la cosa cambia un poco.
En la imagen de la Fig-6 puedes ver que una parte de la salida del codificador de imagen se usa junto con la incrustación del token de clasificación para estimar la pérdida contrastiva, y otra parte se envía a la parte superior del decodificador desacoplado para estimar la representación conjunta.
De hecho, basta una única incrustación de la imagen para estimar el objetivo contrastivo, mientras que se usa toda la secuencia de incrustaciones de salida del codificador de imagen para el objetivo generativo.
Los autores sostienen, a partir de evidencia empírica, que una sola incrustación combinada ayuda a capturar la representación global de la imagen (justo lo que buscamos para el objetivo contrastivo) y que una secuencia de incrustaciones ayuda en tareas que requieren una representación más detallada.
Para ello, se emplea una capa de pooling atencional (una única capa de atención multi-cabeza) que personaliza la salida del codificador de imagen para distintos objetivos mediante un parámetro de consulta aprendible. Ajustando ese parámetro a un valor entero concreto, podemos adaptar todo el codificador para que produzca una secuencia de incrustaciones cuya longitud sea dicho valor.
En el caso del objetivo contrastivo, fijamos la consulta a uno para obtener una sola incrustación con la que calcular la pérdida contrastiva; para el objetivo generativo, la fijamos a un valor arbitrario que idealmente coincide con la longitud de la secuencia de texto. En el artículo de CoCa, los autores eligieron 256 para el objetivo generativo.
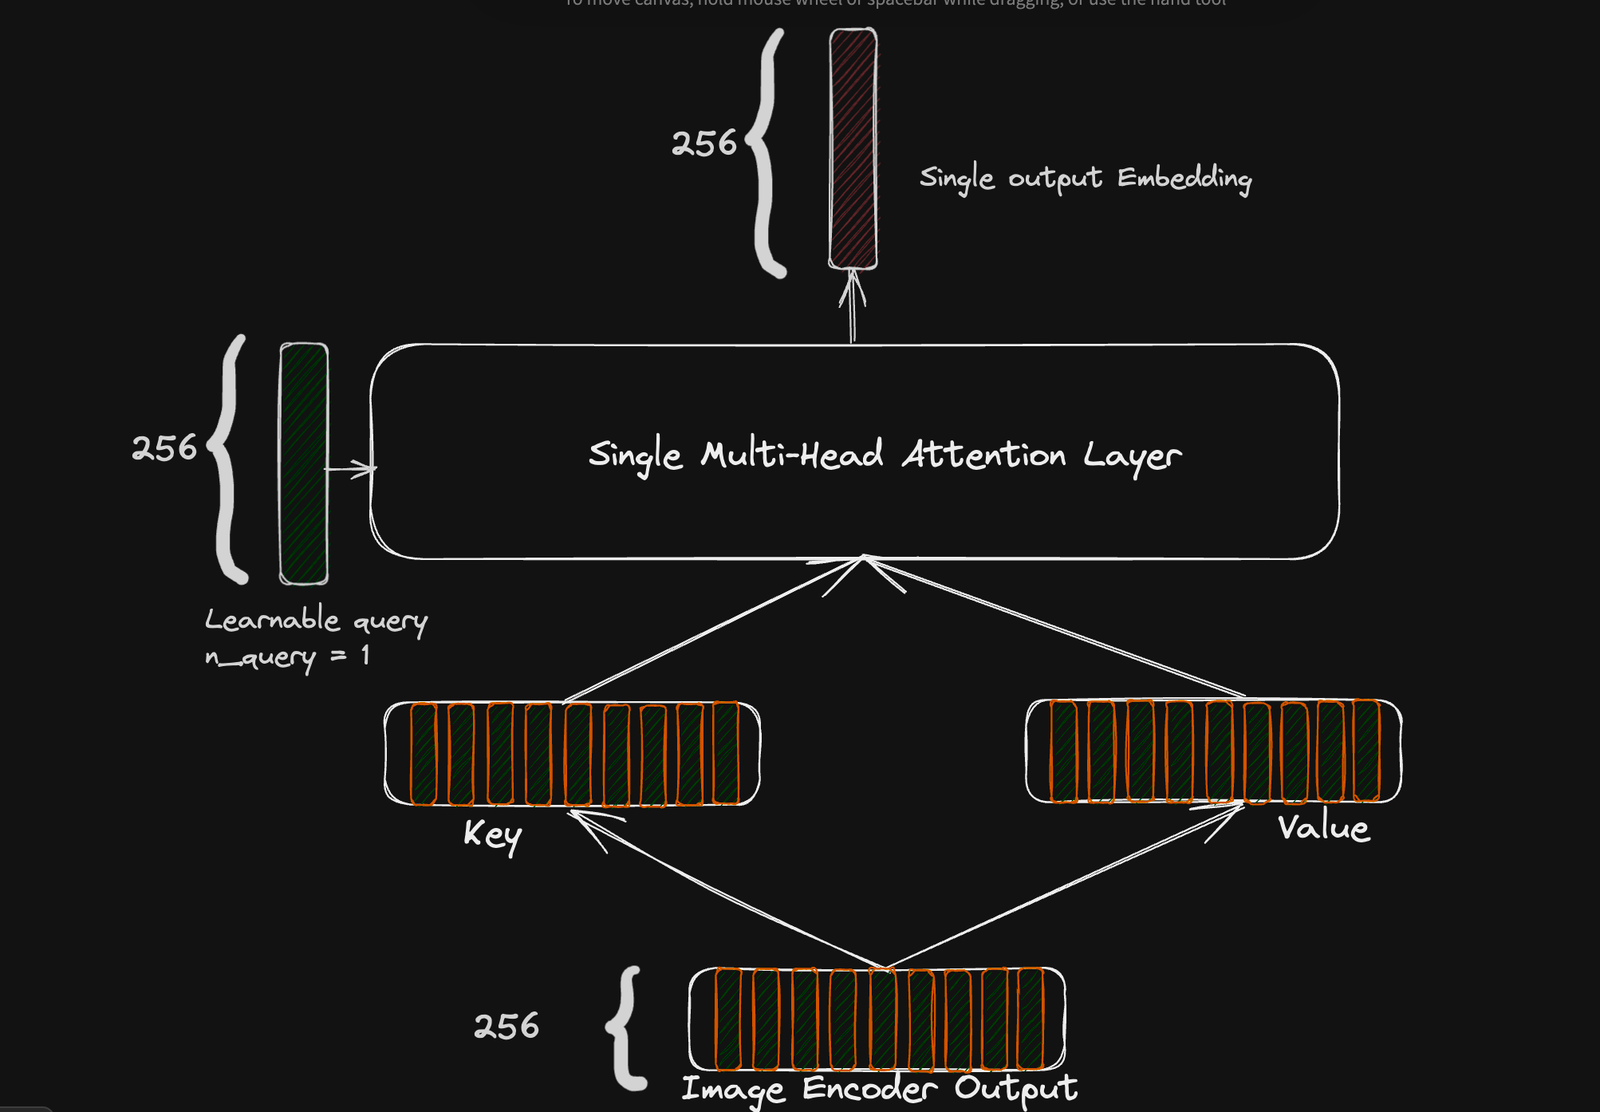
Configuración de pooling atencional para la pérdida contrastiva. La salida de la capa de atención es una única incrustación de 256 dimensiones.
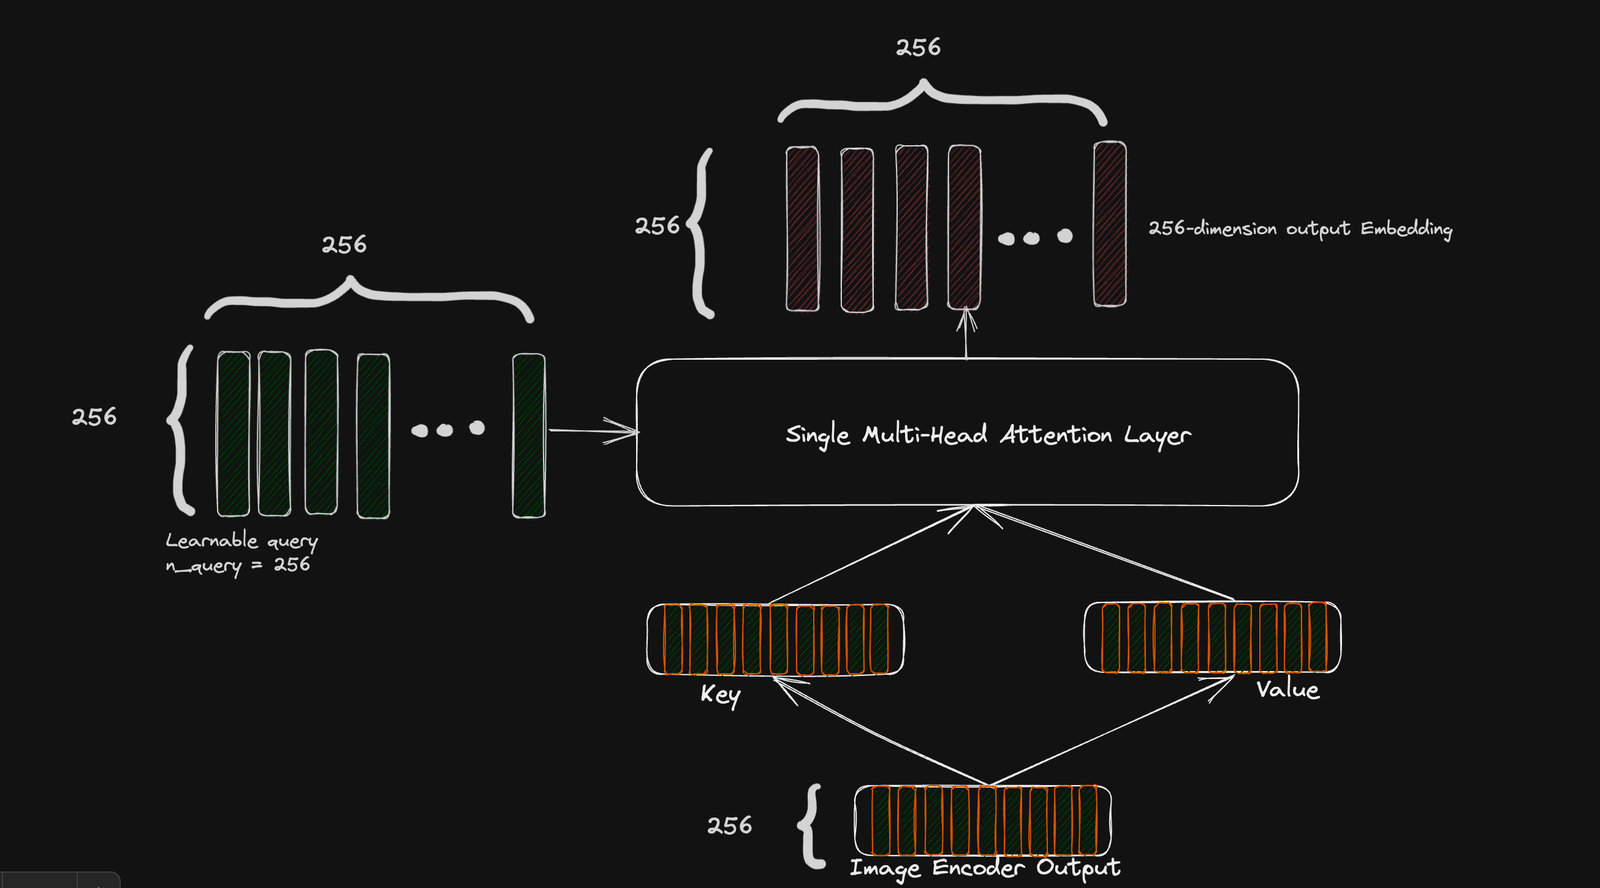
Objetivo generativo
A diferencia del objetivo contrastivo, que solo requiere una representación global de la imagen, el objetivo generativo funciona mejor cuando generamos una representación más detallada.
Como ya explicamos, obtenemos esta representación detallada fijando el parámetro de consulta a un número arbitrario (256 en el artículo de CoCa), lo que genera una representación rica de 256 x 256 de la imagen.
Esta representación pasa a la parte superior del decodificador desacoplado y, mediante interacción multimodal con la representación textual unimodal (ignorando la representación CLS), obtenemos una representación unificada imagen-texto que se usa para predecir, de forma autorregresiva, una distribución de probabilidad sobre el vocabulario.
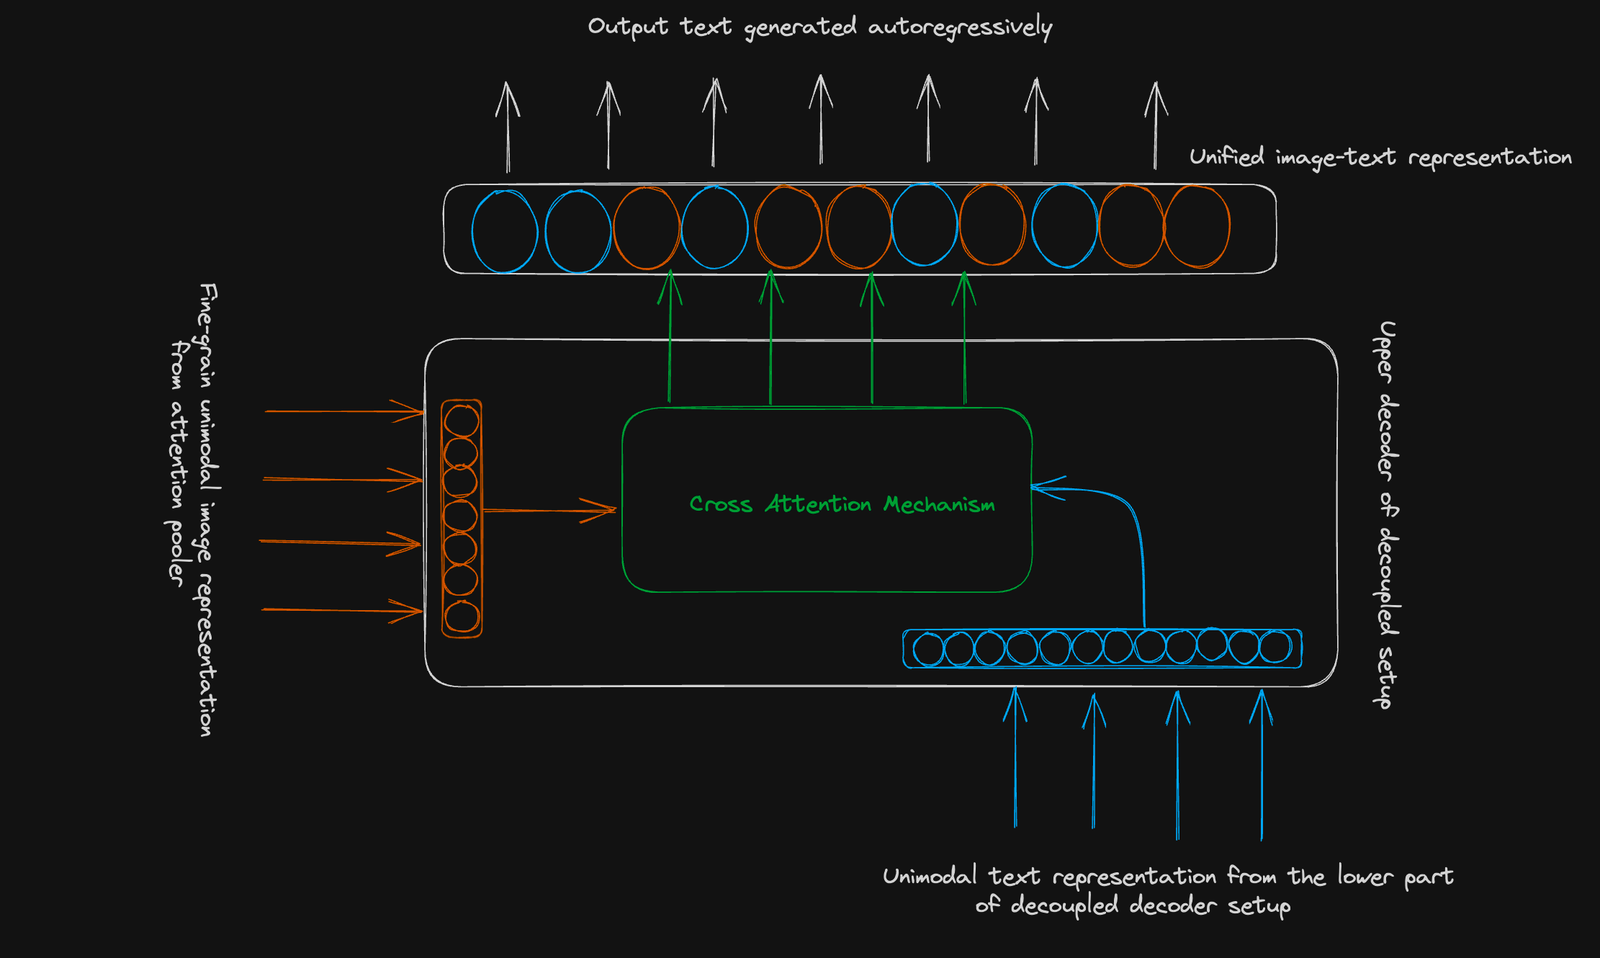
Como hemos visto en las dos secciones anteriores, la arquitectura de CoCa permite reunir las capacidades de una clase de modelos que destacan en tareas zero-shot como la clasificación de imágenes y la recuperación cruzada, y otra clase que brilla en VQA y subtitulado de imágenes. Además, CoCa puede ajustarse finamente para varias tareas downstream de visión y lenguaje.
Reflexiones finales
La llegada de modelos base como CoCa supone un gran avance en aprendizaje automático. CoCa combina las fortalezas de varios paradigmas y ofrece un modelo unificado capaz de alinear representaciones de imagen y texto y de generar representaciones conjuntas.
Este modelo demuestra el potencial de integrar objetivos contrastivos y generativos, abriendo la puerta a un mejor rendimiento en tareas como VQA y subtitulado de imágenes. Reúne las capacidades de modelos que sobresalen en zero-shot y de aquellos expertos en comprensión multimodal imagen-texto, proporcionando una herramienta versátil para numerosas tareas downstream de visión y lenguaje.
Si te apetece profundizar en conceptos avanzados de aprendizaje automático y explorar a fondo el deep learning, el curso Advanced Deep Learning with Keras en DataCamp te dará los conocimientos y habilidades para resolver una gran variedad de problemas con la versátil API funcional de Keras, y te permitirá explorar y entender en mayor profundidad modelos avanzados como CoCa y sus principios.