Ce tutoriel est une précieuse contribution de notre communauté, éditée par DataCamp pour plus de clarté et d'exactitude.
Envie de partager votre expertise ? Nous serions ravis de vous lire ! Proposez vos articles ou idées via notre formulaire de contribution communautaire.
L'évolution de l'apprentissage automatique a conduit à l'émergence des modèles fondamentaux : des modèles pré‑entraînés sur des volumes massifs de données, servant de base polyvalente à une myriade d'applications. En traitement du langage naturel (NLP), des modèles comme GPT et BERT ont démontré des capacités inédites en zéro‑shot et few‑shot learning.
Dans cet article, nous explorons l'univers des modèles fondamentaux image‑texte à travers le modèle innovant Contrastive Captioner (CoCa). Nous en analyserons l'architecture, sa démarche originale combinant objectifs contrastifs et génératifs, et la façon dont il intègre les capacités de modèles comme CLIP et SIMVLM au sein d'un modèle unique et cohérent.
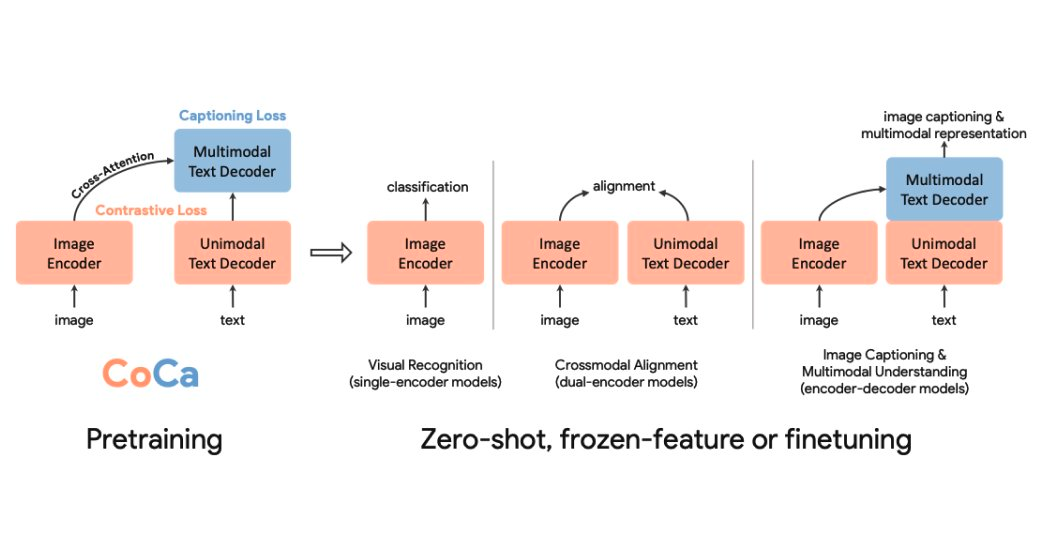
Fig-1 - Contrastive Captioner - (CoCa)
L'essor des modèles fondamentaux
L'idée des modèles fondamentaux n'est pas nouvelle en apprentissage automatique. En deep learning, les techniques qui permettent de les entraîner offrent la possibilité d'adapter ensuite ces modèles à des tâches aval. En NLP, on a vu fleurir des modèles comme GPT et BERT, entraînés sur des données web bruitées à grande échelle, qui affichent des performances remarquables en zéro‑shot et few‑shot.
La recherche sur les modèles fondamentaux pour la vision et le couple vision‑langage a exploré trois voies principales : les modèles à encodeur unique, les modèles à double encodeur image‑texte avec perte contrastive, et les architectures encodeur‑décodeur avec objectif génératif. Avant d'entrer dans le détail de CoCa, voyons ces approches et leurs limites.
Glossaire
- Modèles fondamentaux. Modèles pré‑entraînés servant de point de départ pour diverses applications en apprentissage automatique, adaptables à des tâches spécifiques.
- Perte contrastive. Fonction de coût qui apprend des représentations proches pour des paires similaires et éloignées pour des paires dissemblables.
- Interaction croisée entre modalités. Interaction entre différents types de données (p. ex. : image et texte) pour générer une représentation conjointe.
- Architecture encodeur‑décodeur. Réseau de neurones avec un encodeur qui traite l'entrée et un décodeur qui génère la sortie, utilisé pour les tâches séquence‑à‑séquence.
- Masquage causal. Technique des transformeurs qui empêche l'accès aux jetons futurs d'une séquence pendant l'entraînement.
- Mécanisme d'attention. Composant permettant au modèle de pondérer et prioriser différentes parties de l'entrée lors du traitement.
- Apprentissage zéro‑shot. Paradigme où le modèle prédit ou classe des catégories jamais vues à l'entraînement.
- Visual Question Answering (VQA). Tâche qui consiste à répondre à des questions sur le contenu d'images, croisant vision par ordinateur et traitement du langage.
- Représentations unimodales et multimodales. Les représentations unimodales capturent une seule modalité, tandis que les multimodales intègrent plusieurs modalités.
- Contrastive Language-Image Pre-training (CLIP). Modèle entraîné via apprentissage contrastif pour aligner images et textes dans un espace de représentation commun.
Modèles à encodeur unique
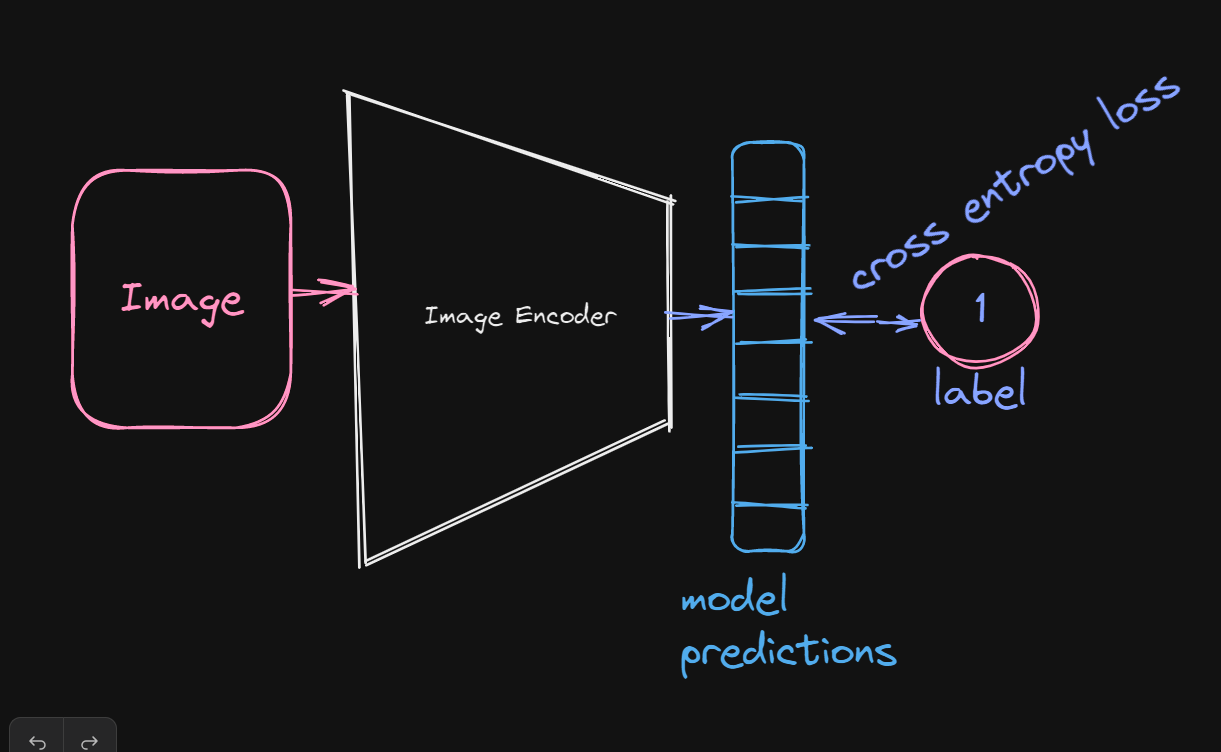
Si vous avez déjà touché à la vision par ordinateur, vous connaissez sans doute cette famille de modèles. Ils apprennent des représentations d'images que l'on peut ensuite adapter à des tâches de vision aval en s'entraînant sur un vaste jeu d'images annotées avec une perte d'entropie croisée.
Empiriquement, ces modèles excellent sur des tâches liées à la vision, comme la détection, mais sont moins performants sur les tâches vision‑langage, car ils dépendent fortement des annotations humaines, ce qui empêche d'y intégrer la langue naturelle humaine.
Modèles à double encodeur image‑texte avec perte contrastive
Parmi les modèles phares de cette catégorie de modèles fondamentaux vision‑langage, on retrouve CLIP (Contrastive Language-Image Pre-training) et ALIGN.
Pendant la pré‑formation, on apprend une tâche d'alignement en entraînant conjointement un modèle d'image et un modèle de langue avec une perte contrastive.
Le principe de leur objectif de pré‑formation est simple : rapprocher dans l'espace latent les représentations des paires image‑texte liées, et éloigner celles des images et textes non liés. Le modèle à double encodeur ainsi obtenu peut être configuré pour des tâches de classification en zéro‑shot et de recherche d'images.
Des modèles récents comme CLIP affichent des performances remarquables sur diverses tâches vision‑langage, mais restent quasi impossibles à utiliser pour des tâches nécessitant une représentation fusionnée image‑texte, comme le VQA, car on apprend uniquement à aligner les représentations, sans générer une représentation unifiée encodant l'information des deux entrées.
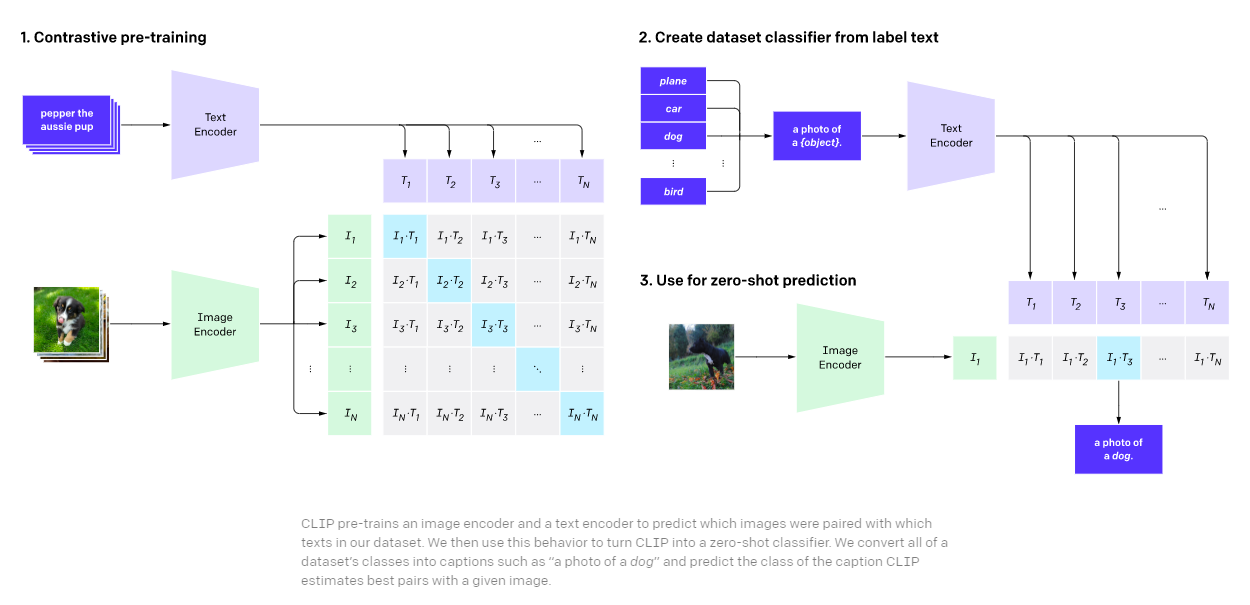
Fig-3 - Contrastive Language-Image Pre-training (CLIP)
Pré‑formation générative avec architecture encodeur‑décodeur
Ces modèles mettent en œuvre des interactions croisées entre les représentations latentes d'images et de textes pour générer une représentation conjointe.
Lors de la pré‑formation, on produit une représentation unifiée image‑texte via des interactions croisées entre la représentation latente du texte et la sortie de l'encodeur d'images, puis on applique une perte de modélisation du langage sur la sortie du décodeur.
Dans les architectures récentes, l'interaction cross‑modal s'effectue surtout par un mécanisme d'attention croisée dans des transformeurs, utilisant les sorties de l'encodeur d'images comme requêtes (queries) et les représentations textuelles comme clés et valeurs.
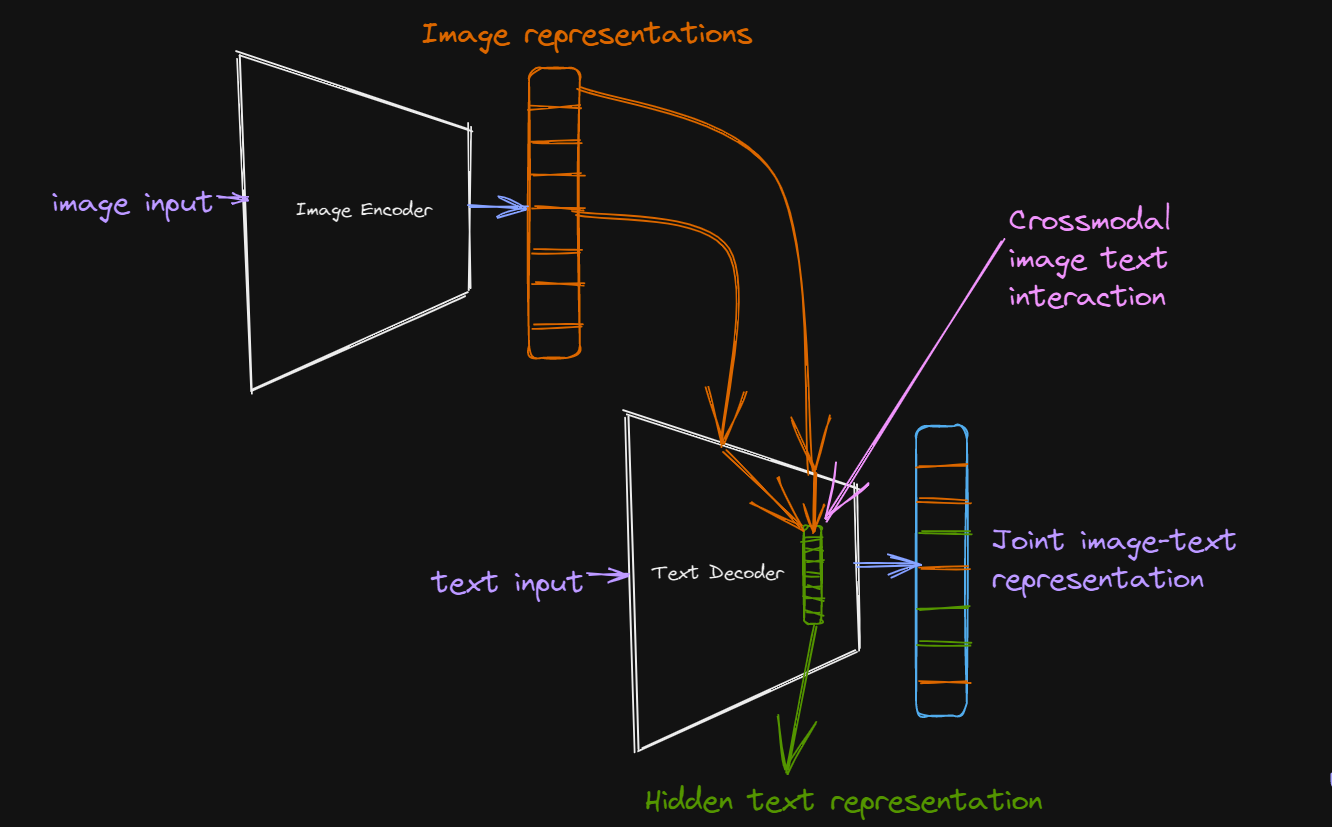
Pour les tâches aval, on peut exploiter la sortie du décodeur — représentation conjointe image‑texte — pour réaliser des tâches multimodales comme le Visual Question Answering. Un modèle récent suivant ce paradigme est le Simple Visual Language Model (SIMVLM).
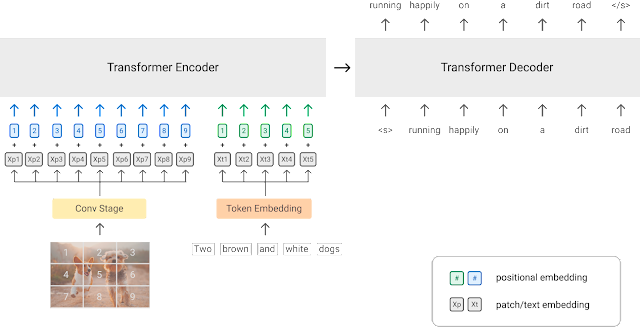
Fig-5 - Simple Visual Language Model (SIMVLM)
Motivation derrière CoCa
Les auteurs de CoCa ont cherché à réunir, dans un modèle simple, les capacités des différents paradigmes de modèles fondamentaux image‑texte. CoCa s'appuie sur une perte contrastive pour aligner les représentations image et texte dans un même espace vectoriel, et sur un objectif génératif (perte de légendage) pour apprendre une représentation conjointe image‑texte ; il regroupe ainsi les atouts de modèles tels que CLIP et SIMVLM en un seul modèle.
Architecture du modèle
CoCa adopte une approche encodeur‑décodeur classique et, comme la plupart des modèles de ce type, encode l'image avec un réseau de neurones tel qu'un réseau de neurones convolutionnel ou un transformer.
L'originalité de l'architecture de CoCa commence à la sortie de son encodeur et dans toute sa configuration de décodeur.
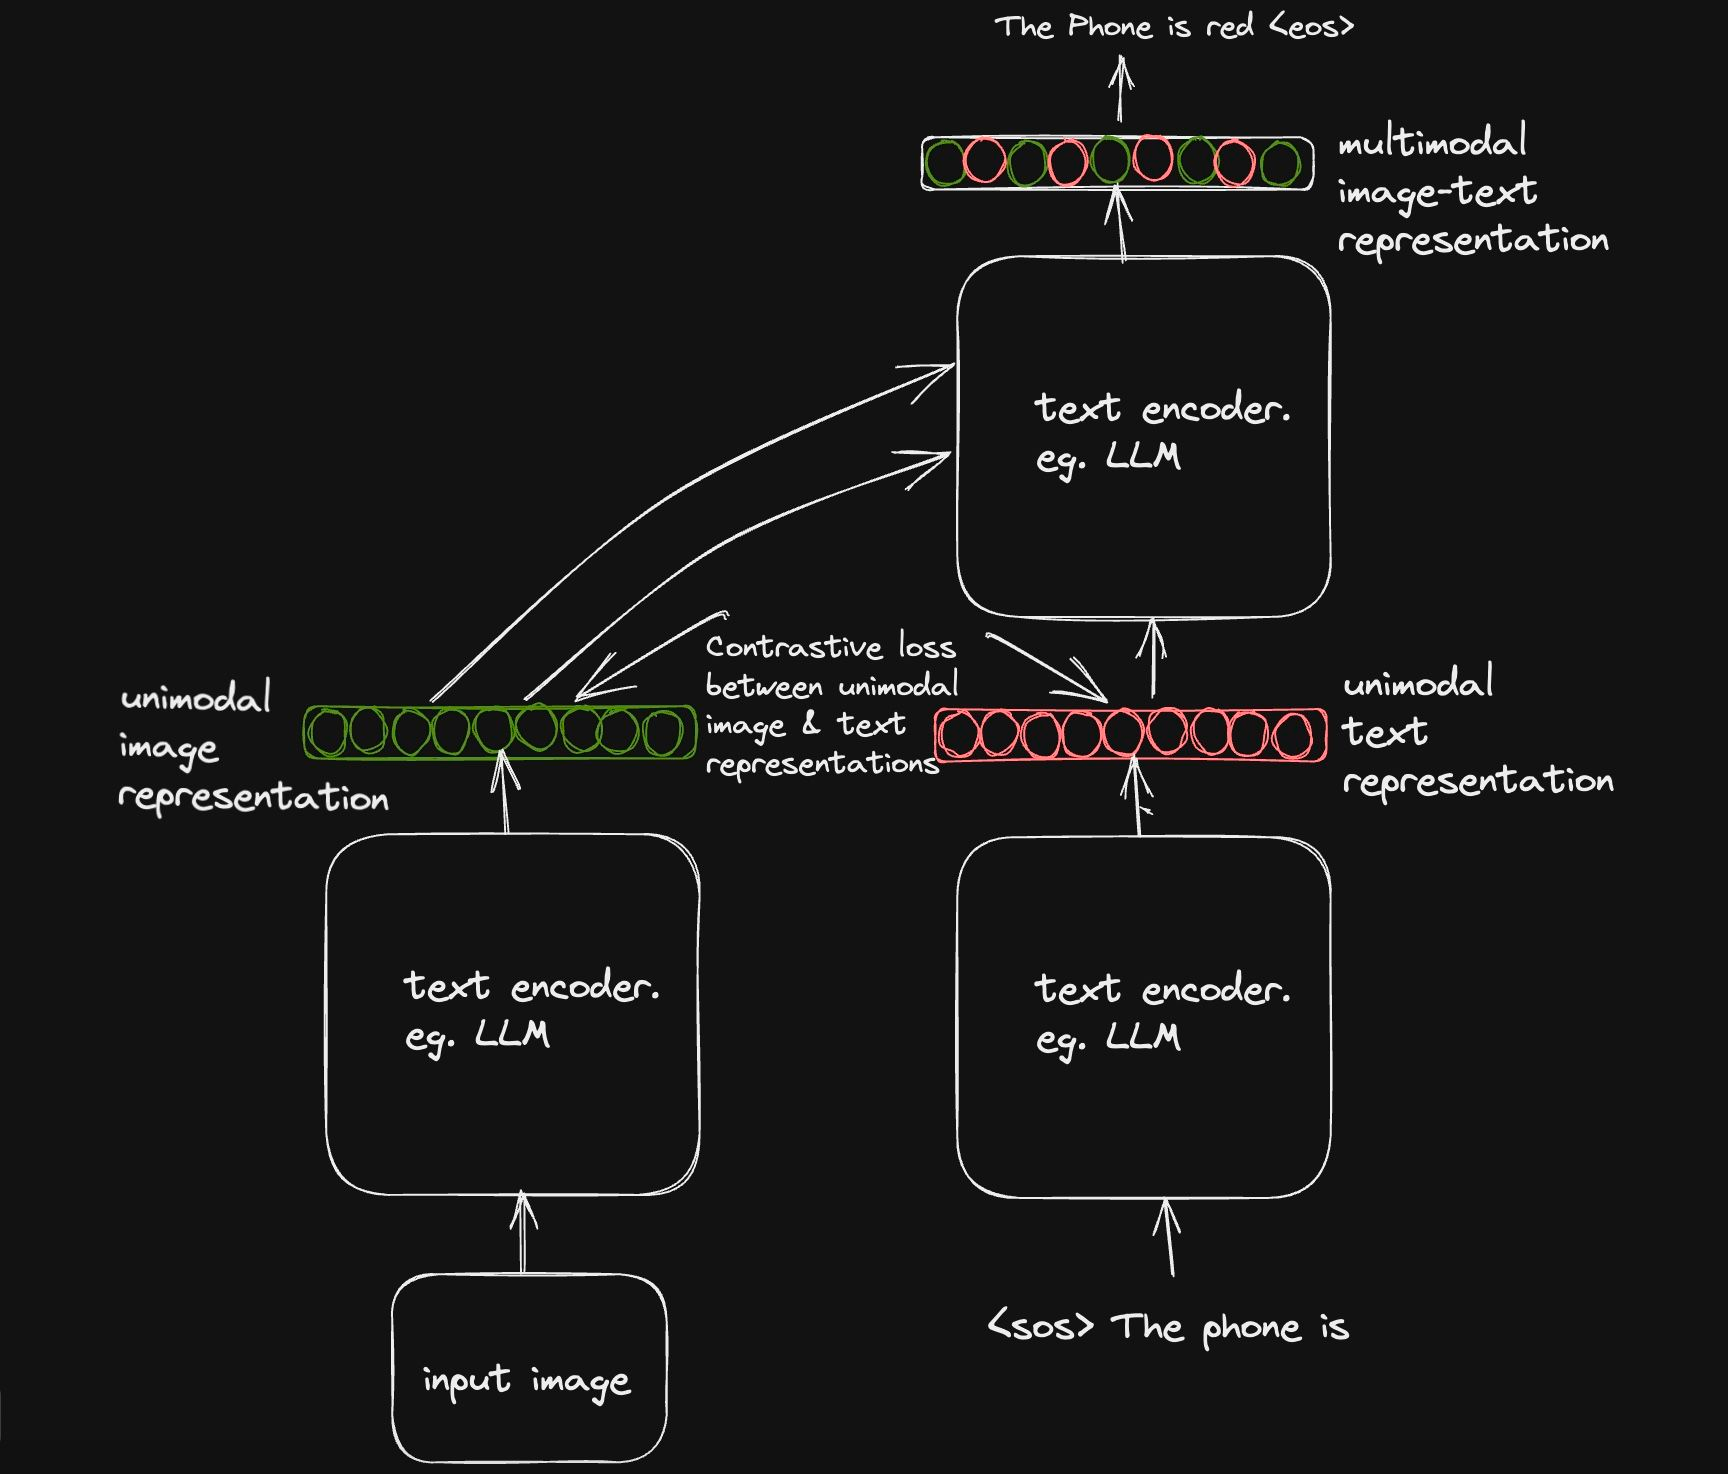
Rappelons que l'objectif de l'article CoCa est de combiner, dans un seul modèle, les capacités de deux paradigmes de modèles vision‑langage (objectif contrastif et objectif génératif). Le paradigme contrastif exige que le décodeur de texte produise une représentation textuelle unimodale, projetée ensuite dans le même espace que la représentation d'image pour apprendre l'alignement.
L'objectif génératif, lui, permet au décodeur d'intégrer les représentations d'images issues de l'encodeur et de générer de manière auto‑régressive un texte conditionné par l'image et l'entrée textuelle.
Notez que les deux parties du décodeur appliquent un masquage causal pour empêcher le modèle d'accéder par avance à des jetons futurs.
Pour y parvenir, les auteurs ont conçu un décodeur découplé : une première partie apprend à produire une représentation textuelle unimodale pour l'objectif contrastif, et une seconde partie apprend à générer une représentation multimodale image‑texte.
Objectif contrastif
L'idée derrière l'objectif contrastif, adoptée par des modèles comme CLIP et ALIGN, est simple : apprendre des représentations pour différentes modalités (image, texte) telles que les paires similaires soient proches dans l'espace de représentation, et les paires dissemblables éloignées.
À chaque itération d'entraînement, on échantillonne des paires image‑texte et on ajuste les poids des encodeurs pour regrouper les paires correspondantes et écarter les non‑paires.
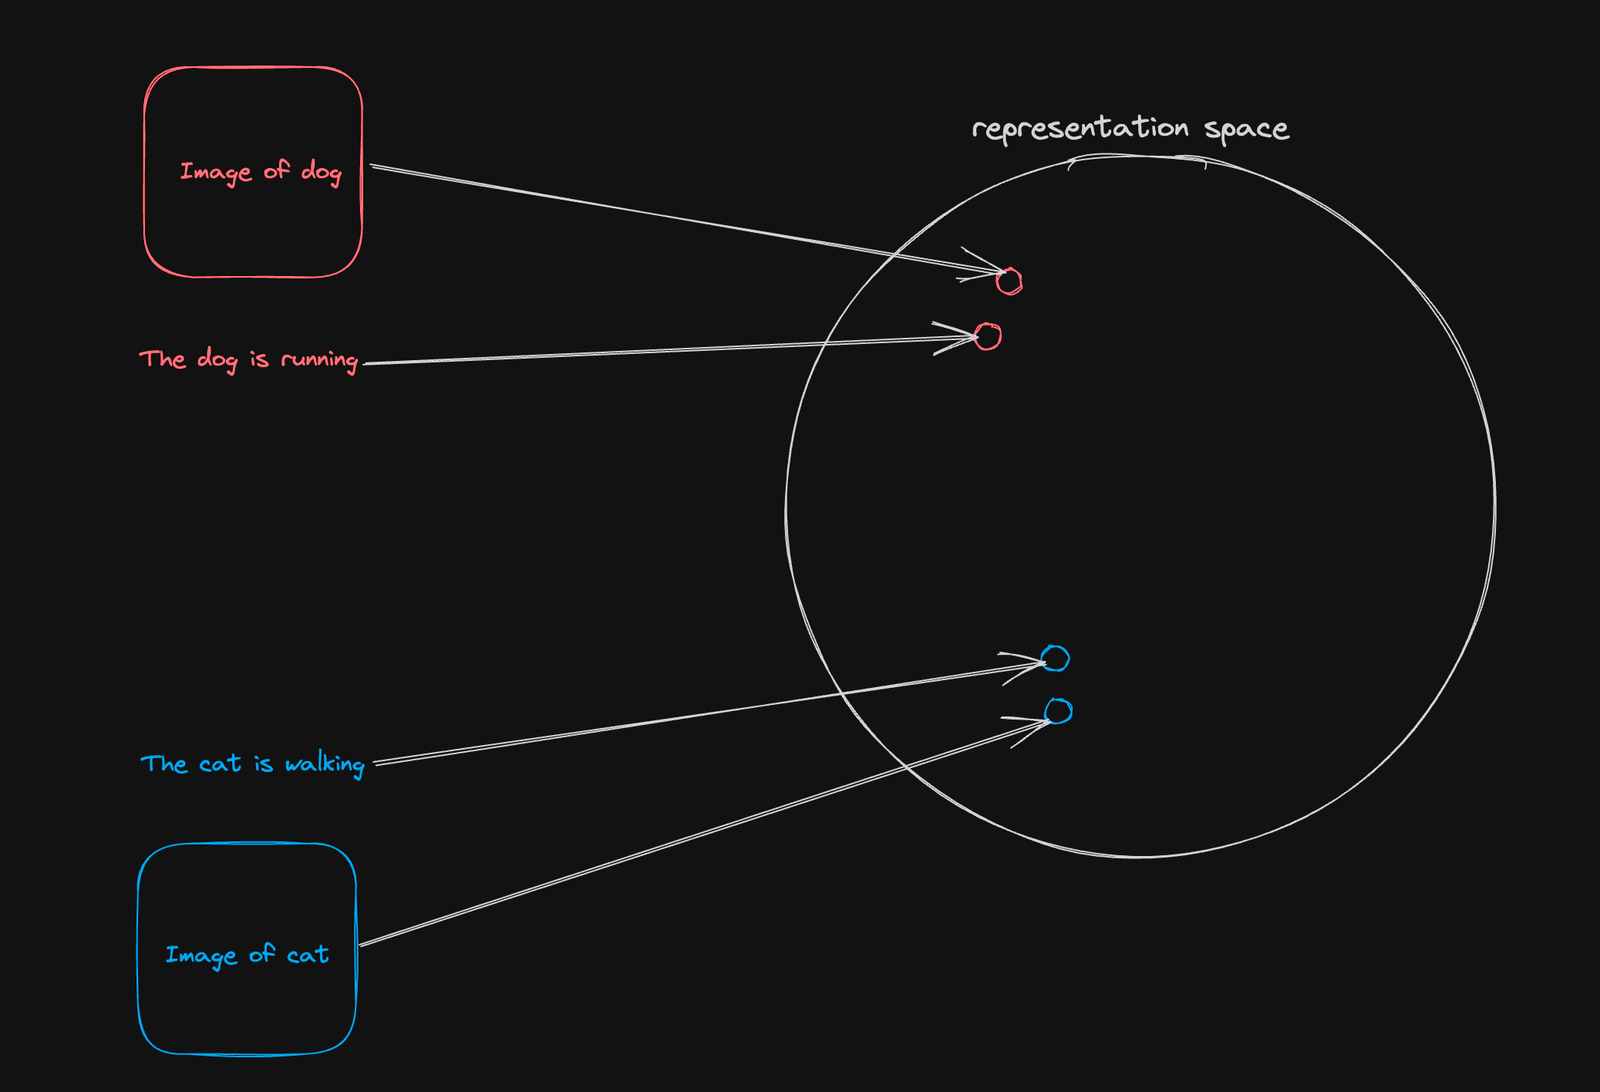
Comme indiqué plus haut, l'objectif contrastif requiert des représentations unimodales pour l'image et le texte. Côté texte, on applique une technique classique du modèle BERT.
On insère un jeton de classification apprenable [CLS] à la fin de la séquence d'entrée pour que le vecteur associé à ce jeton capture la sémantique de l'ensemble de la séquence.
Comme nos décodeurs appliquent un masquage causal dans leurs cartes d'attention, placer le jeton de classification en fin de séquence garantit une connexion d'attention entre ce jeton et tous les autres, et donc la capture du sens global de la phrase.
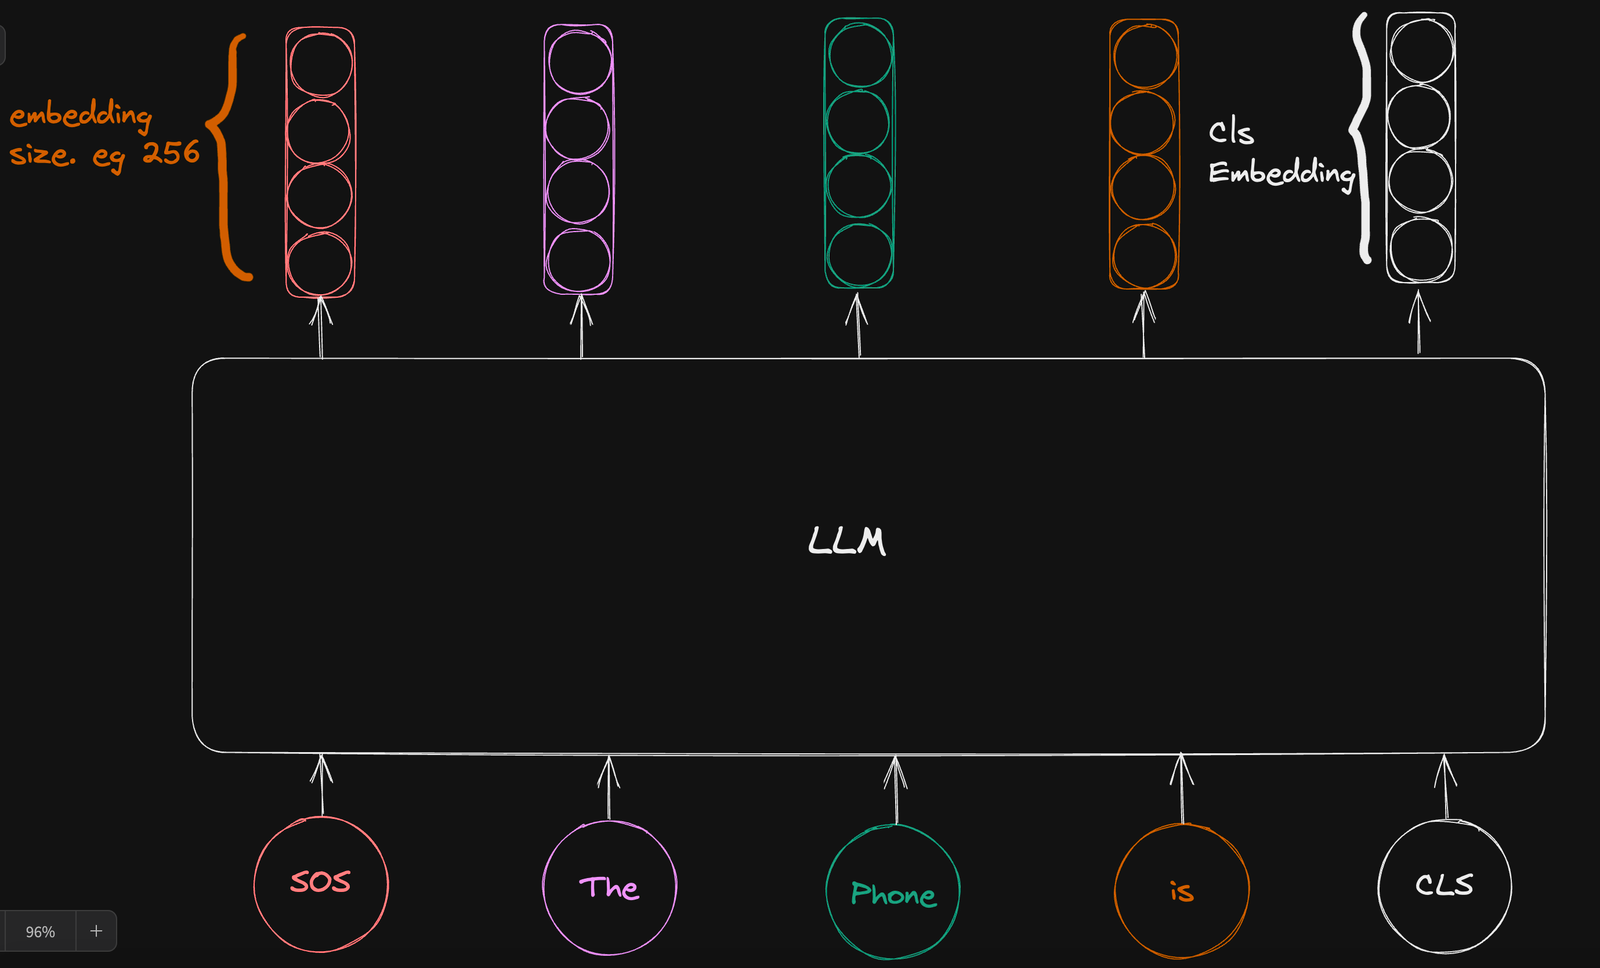
On ignore les vecteurs des autres jetons et on utilise uniquement la représentation du jeton de classification pour estimer la perte contrastive.
Côté encodeur d'images, la logique diffère légèrement.
Comme le montre la figure 6, une partie de la sortie de l'encodeur d'images est utilisée avec l'embedding du jeton de classification pour estimer la perte contrastive, et une autre partie alimente la branche supérieure du décodeur découplé afin d'estimer la représentation conjointe.
En pratique, un seul vecteur d'embedding d'image suffit pour estimer l'objectif contrastif, tandis que l'ensemble de la séquence d'embeddings issue de l'encodeur d'images sert à l'objectif génératif.
Les auteurs indiquent avoir constaté empiriquement qu'un embedding agrégé unique capture bien la représentation globale de l'image (ce qui est requis pour l'objectif contrastif), tandis qu'une séquence d'embeddings est utile pour des tâches nécessitant une représentation plus fine de l'image.
Pour ce faire, une couche d'agrégation attentionnelle (multi‑tête unique) personnalise la sortie de l'encodeur d'images pour différents objectifs via un paramètre de requête apprenable. En fixant ce paramètre à une valeur entière donnée, on adapte l'encodeur pour produire une séquence d'embeddings dont la longueur correspond à cette valeur.
Pour l'objectif contrastif, on règle ce paramètre à 1 afin d'obtenir un seul embedding pour calculer la perte contrastive ; pour l'objectif génératif, on le fixe à une valeur arbitraire, idéalement égale à la longueur de la séquence texte. Dans l'article CoCa, les auteurs retiennent 256 pour l'objectif génératif.
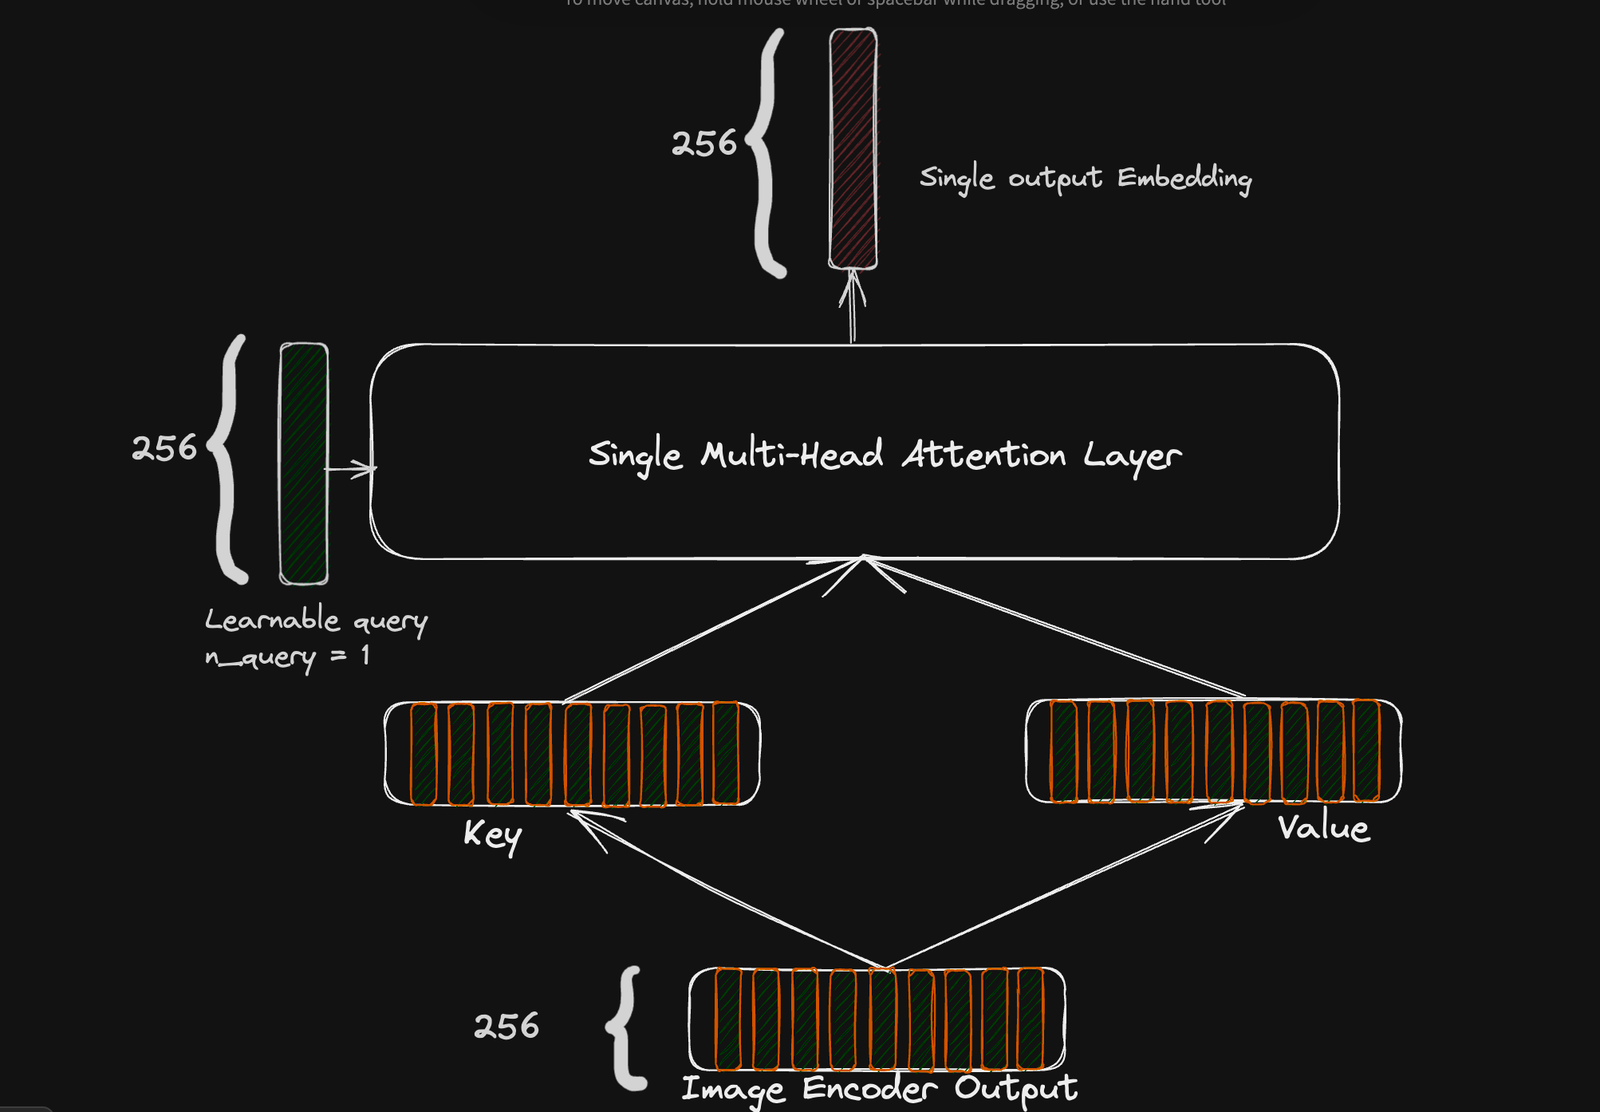
Configuration de l'agrégation attentionnelle pour la perte contrastive. La sortie est un embedding unique en 256 dimensions.
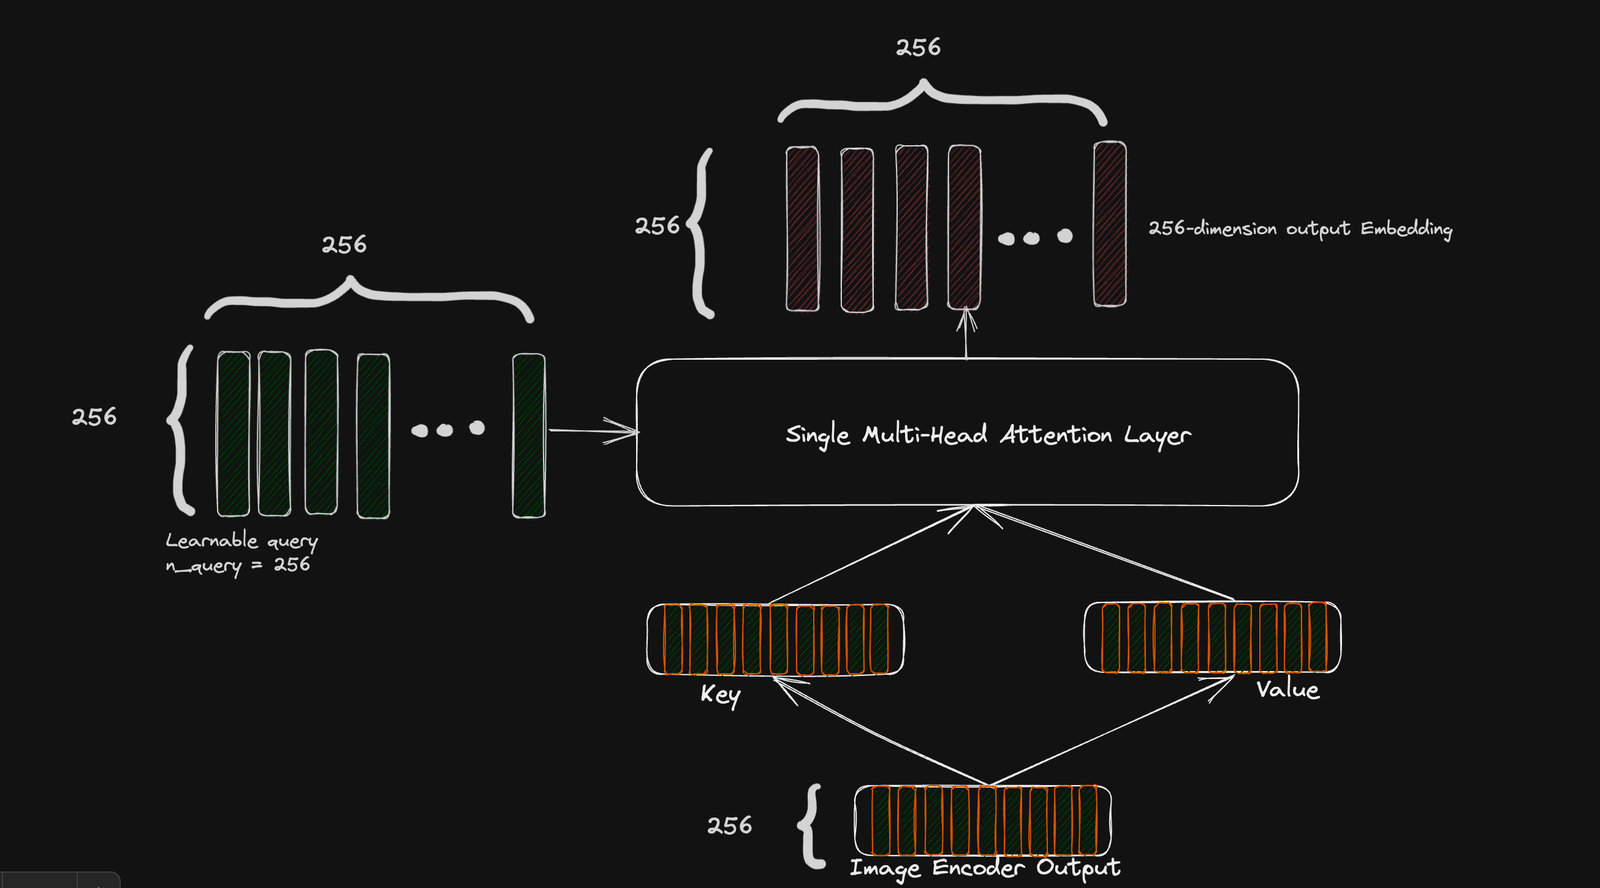
Objectif génératif
Contrairement à l'objectif contrastif, qui requiert seulement une représentation globale de l'image, l'objectif génératif bénéficie d'une représentation plus fine.
Comme expliqué, on obtient cette représentation fine en fixant le paramètre de requête à un nombre arbitraire (256 dans l'article CoCa), ce qui produit une représentation riche de taille 256 × 256.
Cette représentation alimente la branche supérieure du décodeur découplé et, grâce à une interaction cross‑modal avec la représentation textuelle unimodale (en ignorant la représentation CLS), on obtient une représentation unifiée image‑texte, utilisée pour prédire une distribution de probabilités sur le vocabulaire via une factorisation auto‑régressive.
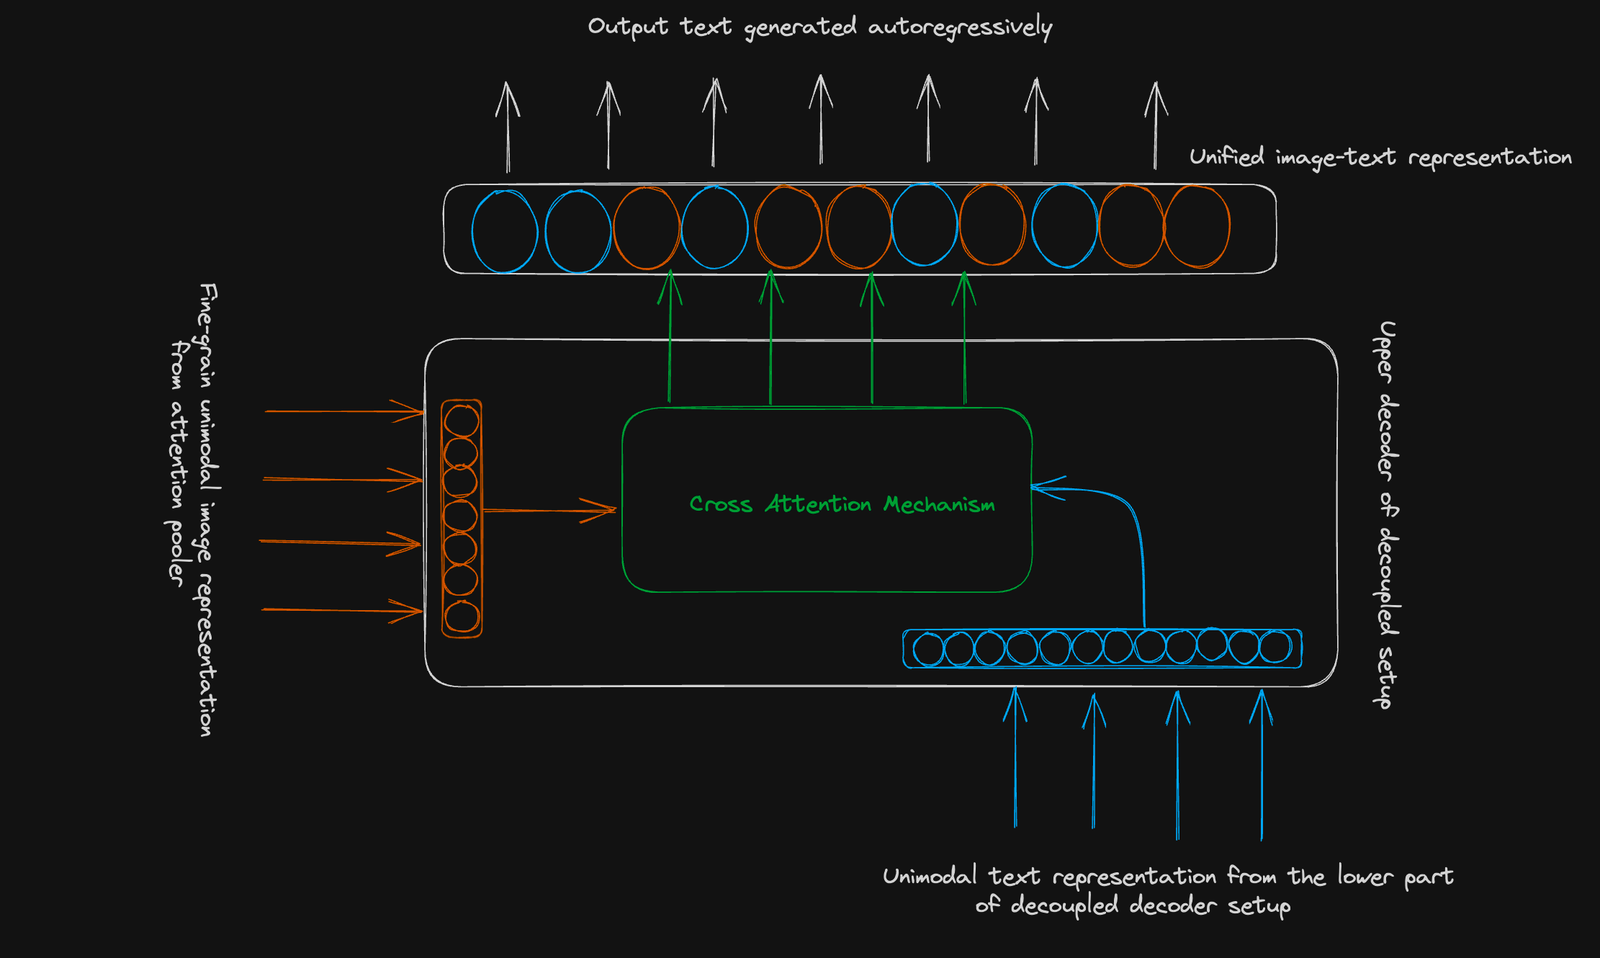
Comme illustré plus haut, l'architecture de CoCa réunit les capacités d'une classe de modèles excellant en zéro‑shot (classification d'images, recherche cross‑modal) et d'une autre spécialisée dans le VQA et le légendage d'images. CoCa peut également être affiné sur de nombreuses tâches aval de vision et de langage.
Pour conclure
L'arrivée de modèles fondamentaux comme CoCa marque une avancée majeure en apprentissage automatique. CoCa combine les forces de plusieurs paradigmes et propose un modèle unifié capable d'aligner les représentations image et texte, tout en générant des représentations conjointes.
Ce modèle illustre le potentiel de l'intégration d'objectifs contrastifs et génératifs, ouvrant la voie à de meilleures performances sur des tâches comme le Visual Question Answering et le légendage d'images. Il réunit les capacités de modèles très performants en zéro‑shot et de modèles spécialistes de la compréhension multimodale image‑texte, offrant un outil polyvalent pour de nombreuses tâches aval.
Pour aller plus loin dans les concepts avancés de l'apprentissage automatique et explorer les arcanes du deep learning, le cours Advanced Deep Learning with Keras sur DataCamp vous donnera les connaissances et compétences nécessaires pour résoudre une grande variété de problèmes avec l'API fonctionnelle Keras, et comprendre en profondeur des modèles avancés comme CoCa et leurs principes sous‑jacents.