Hướng dẫn này là đóng góp quý giá từ cộng đồng của chúng tôi và đã được DataCamp biên tập để đảm bảo rõ ràng và chính xác.
Quan tâm chia sẻ chuyên môn của riêng bạn? Chúng tôi rất mong nhận được từ bạn! Hãy gửi bài viết hoặc ý tưởng của bạn qua Biểu mẫu Đóng góp Cộng đồng.
Sự phát triển của máy học đã dẫn đến sự ra đời của các mô hình nền tảng, một lớp mô hình được tiền huấn luyện trên dữ liệu khổng lồ, đóng vai trò là nền tảng linh hoạt cho vô vàn ứng dụng. Những mô hình này, tiêu biểu như GPT và BERT trong Xử lý Ngôn ngữ Tự nhiên (NLP), đã thể hiện năng lực vượt trội ở các tác vụ như học không ví dụ (zero-shot) và học ít ví dụ (few-shot).
Trong bài viết này, chúng ta đi sâu vào lĩnh vực các mô hình nền tảng hình ảnh–văn bản, khám phá mô hình Contrastive Captioner (CoCa) đầy sáng tạo. Chúng ta sẽ phân tích kiến trúc của nó, tìm hiểu cách tiếp cận độc đáo kết hợp mục tiêu đối sánh tương phản và mục tiêu sinh, và xem cách nó tích hợp năng lực của các mô hình như CLIP và SIMVLM vào một mô hình thống nhất, mạch lạc.
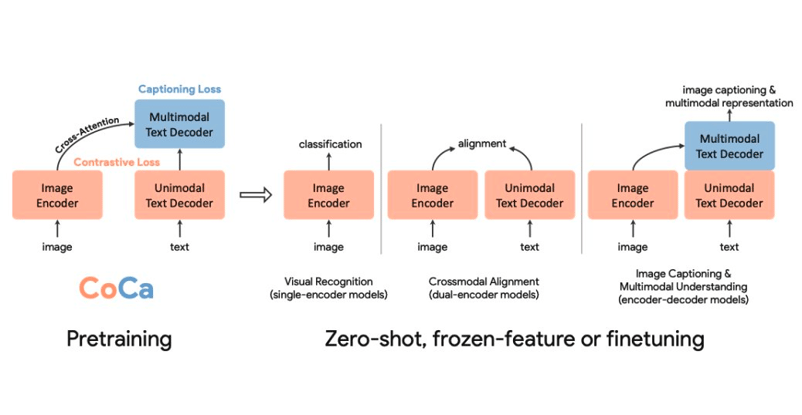
Hình-1 - Contrastive Captioner - (CoCa)
Sự trỗi dậy của các mô hình nền tảng
Ý tưởng về mô hình nền tảng không mới trong máy học. Trong học sâu, các kỹ thuật giúp huấn luyện những mô hình này cho phép chúng ta điều chỉnh mô hình sau này cho các tác vụ hạ nguồn. Trong NLP, đã có sự bùng nổ các mô hình nền tảng như GPT và BERT, được huấn luyện trên dữ liệu quy mô internet nhiễu, cho thấy khả năng zero-shot và few-shot đáng chú ý.
Nghiên cứu xây dựng các mô hình nền tảng thị giác và thị giác–ngôn ngữ đã khám phá ba hướng chính: mô hình mã hóa đơn, mô hình mã hóa kép hình ảnh–văn bản với hàm mất mát đối sánh tương phản, và mô hình mã hóa–giải mã với mục tiêu sinh. Trước khi tìm hiểu mô hình CoCa, hãy điểm qua các hướng nghiên cứu này và những điểm yếu của chúng.
Thuật ngữ
- Mô hình nền tảng. Các mô hình tiền huấn luyện đóng vai trò điểm khởi đầu cho nhiều ứng dụng máy học, có thể điều chỉnh cho các tác vụ cụ thể.
- Mất mát đối sánh tương phản (Contrastive Loss). Một hàm mất mát huấn luyện mô hình học biểu diễn tương tự cho các cặp đầu vào tương tự và khác biệt cho các cặp không tương tự.
- Tương tác đa phương thức chéo (Cross-Modal Interaction). Sự tương tác giữa các kiểu dữ liệu khác nhau (ví dụ: hình ảnh và văn bản) để tạo biểu diễn chung.
- Kiến trúc mã hóa–giải mã (Encoder-Decoder). Cấu trúc mạng nơ-ron với bộ mã hóa xử lý dữ liệu đầu vào và bộ giải mã tạo đầu ra, dùng cho các tác vụ chuỗi-đến-chuỗi.
- Che nhân quả (Causal Masking). Kỹ thuật trong mô hình transformer để ngăn truy cập các token tương lai trong chuỗi khi huấn luyện.
- Cơ chế chú ý (Attention Mechanism). Thành phần cho phép mô hình gán trọng số và ưu tiên các phần khác nhau của đầu vào khi xử lý thông tin.
- Học không ví dụ (Zero-Shot Learning). Mô hình dự đoán hoặc phân loại trên các lớp dữ liệu không thấy trong quá trình huấn luyện.
- Hỏi đáp trực quan (VQA). Tác vụ mô hình trả lời câu hỏi về nội dung hình ảnh, kết hợp thị giác máy tính và xử lý ngôn ngữ tự nhiên.
- Biểu diễn đơn phương thức và đa phương thức. Biểu diễn đơn phương thức nắm bắt thông tin từ một kiểu dữ liệu; đa phương thức tích hợp thông tin từ nhiều kiểu.
- Tiền huấn luyện Ngôn ngữ–Hình ảnh theo hướng đối sánh (CLIP). Mô hình huấn luyện bằng học tương phản để căn chỉnh hình ảnh và văn bản trong không gian biểu diễn chung.
Mô hình mã hóa đơn
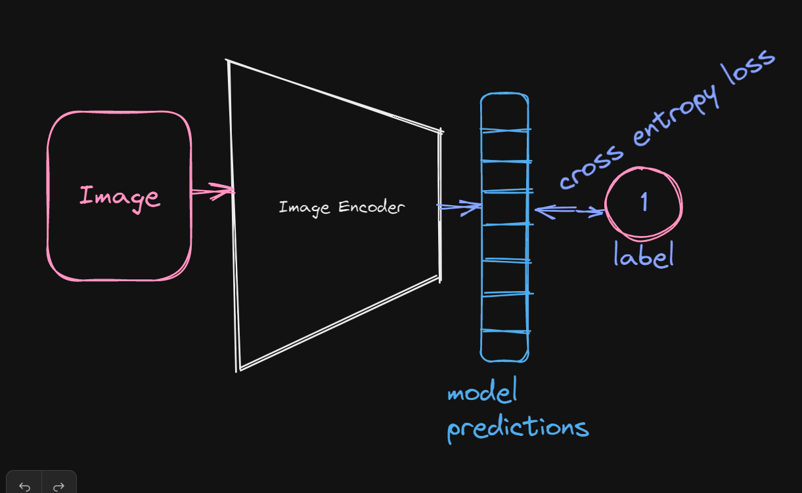
Nếu bạn từng thử sức với thị giác máy tính, nhiều khả năng bạn đã gặp lớp mô hình này. Các mô hình này học biểu diễn của hình ảnh có thể được điều chỉnh cho các tác vụ thị giác hạ nguồn bằng cách huấn luyện trên tập dữ liệu lớn ảnh có gán nhãn với mất mát cross-entropy.
Thực nghiệm cho thấy chúng rất mạnh ở các tác vụ liên quan đến thị giác như phát hiện đối tượng, nhưng kém ở các tác vụ liên quan đến thị giác–ngôn ngữ do phụ thuộc nhiều vào gán nhãn của con người, khiến chúng không tích hợp được ngôn ngữ tự nhiên của con người.
Mô hình mã hóa kép hình ảnh–văn bản với mất mát đối sánh tương phản
Các mô hình phổ biến thuộc lớp mô hình nền tảng thị giác–ngôn ngữ này gồm CLIP (Contrastive Language-Image Pre-training) và ALIGN.
Trong giai đoạn tiền huấn luyện, chúng ta học tác vụ căn chỉnh bằng cách huấn luyện đồng thời mô hình hình ảnh và mô hình ngôn ngữ với mất mát tương phản.
Ý tưởng đằng sau mục tiêu tiền huấn luyện này khá đơn giản: gom cụm các biểu diễn của các cặp hình ảnh–văn bản (có liên quan) và đẩy xa các biểu diễn của hình ảnh và văn bản không liên quan (không phải cặp) trong cùng không gian tiềm ẩn. Mô hình mã hóa kép thu được sau đó có thể được cấu hình để thực hiện phân loại zero-shot và truy hồi hình ảnh.
Các mô hình gần đây như CLIP đã đạt hiệu năng đáng kể ở nhiều tác vụ thị giác–ngôn ngữ, nhưng hầu như không thể dùng cho các tác vụ cần biểu diễn hợp nhất của hình ảnh và văn bản, như hỏi đáp trực quan, vì chúng ta chỉ học căn chỉnh biểu diễn của hình ảnh và văn bản mà không tạo ra một biểu diễn thống nhất mã hóa cả thông tin từ ảnh và văn bản.
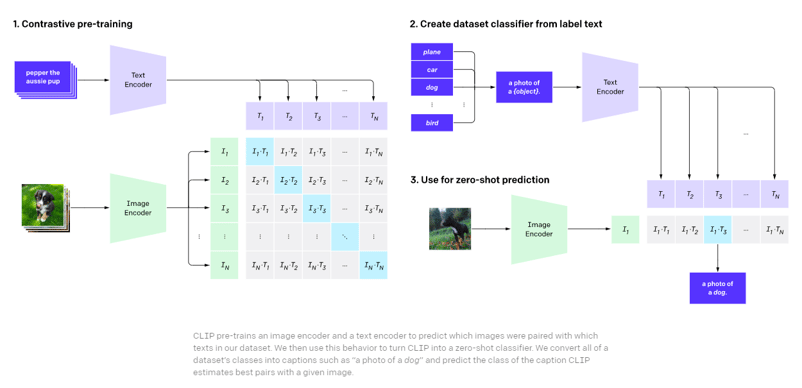
Hình-3 - Contrastive Language-Image Pre-training (CLIP)
Tiền huấn luyện sinh với kiến trúc mã hóa–giải mã
Các mô hình này sử dụng tương tác đa phương thức chéo giữa các biểu diễn ẩn của hình ảnh và văn bản để tạo ra biểu diễn chung.
Trong tiền huấn luyện, chúng ta tạo biểu diễn hợp nhất của hình ảnh và văn bản thông qua tương tác đa phương thức chéo giữa biểu diễn văn bản ẩn và đầu ra của bộ mã hóa ảnh, rồi áp dụng mất mát Mô hình Hóa Ngôn ngữ lên đầu ra bộ giải mã.
Trong kiến trúc máy học gần đây, tương tác đa phương thức chéo chủ yếu được thực hiện qua cơ chế cross-attention trong transformer, dùng đầu ra bộ mã hóa ảnh làm query và các biểu diễn văn bản ẩn làm key và value.
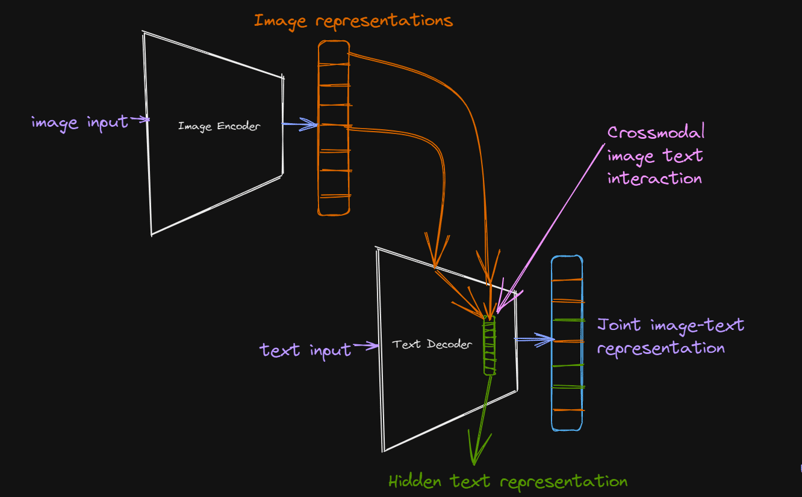
Đối với các tác vụ hạ nguồn, chúng ta có thể lấy đầu ra bộ giải mã, tức biểu diễn chung của hình ảnh và văn bản, để thực hiện các tác vụ hiểu hình ảnh–văn bản đa phương thức như Hỏi đáp Trực quan. Một mô hình gần đây dùng cách tiếp cận này là Simple Visual Language Model (SIMVLM).
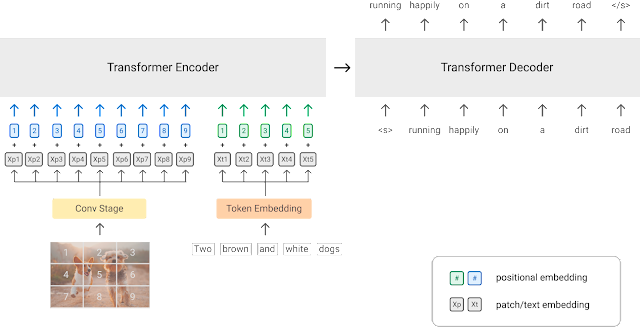
Hình-5 - Simple Visual Language Model (SIMVLM)
Động lực đằng sau CoCa
Các tác giả của mô hình CoCa muốn bao trùm năng lực của các khuynh hướng xây dựng mô hình nền tảng hình ảnh–văn bản khác nhau trong một mô hình đơn giản. Thiết kế của CoCa tận dụng mất mát tương phản để học căn chỉnh biểu diễn hình ảnh và văn bản trong cùng một không gian vector và mục tiêu sinh (mất mát chú thích) để học biểu diễn hợp nhất hình ảnh–văn bản, qua đó tích hợp năng lực của các mô hình như CLIP và SIMVLM vào một mô hình duy nhất.
Kiến trúc mô hình
CoCa sử dụng cách tiếp cận mã hóa–giải mã tiêu chuẩn và, giống hầu hết các mô hình kiểu này, mã hóa ảnh bằng mạng nơ-ron như mạng nơ-ron tích chập hoặc transformer.
Điểm độc đáo của kiến trúc CoCa bắt đầu từ đầu ra của bộ mã hóa và toàn bộ thiết lập bộ giải mã.
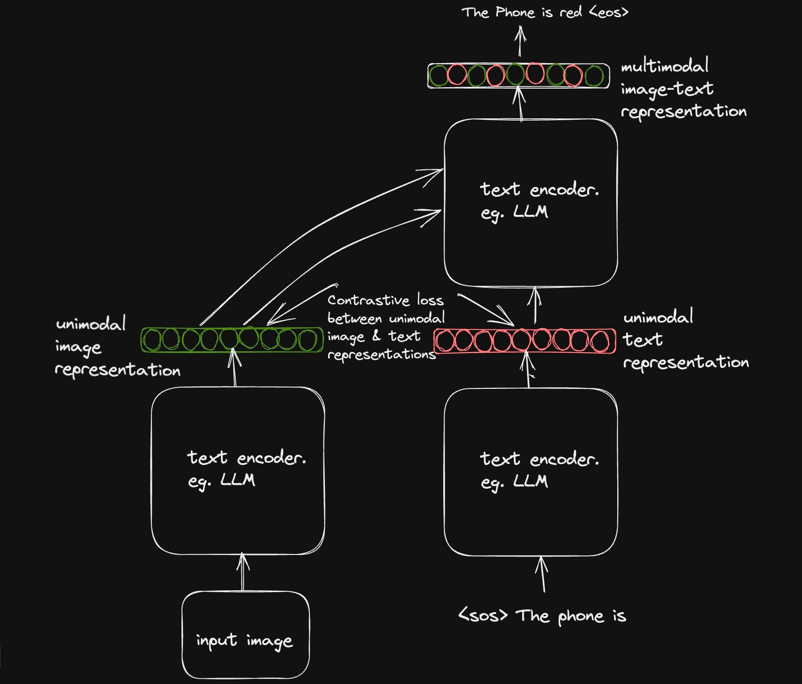
Nhớ rằng mục tiêu của bài báo CoCa là kết hợp năng lực của hai khuynh hướng mô hình thị giác–ngôn ngữ (mục tiêu tương phản và mục tiêu sinh) vào một mô hình. Khuynh hướng mục tiêu tương phản yêu cầu bộ giải mã văn bản của chúng ta xuất ra biểu diễn văn bản đơn phương thức, sau đó được chiếu vào không gian vector tương tự như biểu diễn ảnh để học tác vụ căn chỉnh.
Mục tiêu sinh, ngược lại, cho phép bộ giải mã nhận các biểu diễn ảnh từ bộ mã hóa và sinh văn bản theo cách tự hồi quy có điều kiện trên biểu diễn ảnh và đầu vào văn bản.
Lưu ý rằng cả hai phần bộ giải mã đều áp dụng che nhân quả để ngăn mô hình nhìn trước các token.
Để đạt được điều này, các tác giả khéo léo điều chỉnh thiết lập bộ giải mã tách rời: phần đầu học tạo biểu diễn văn bản đơn phương thức cho mục tiêu tương phản và phần sau học tạo biểu diễn đa phương thức hình ảnh–văn bản.
Mục tiêu tương phản
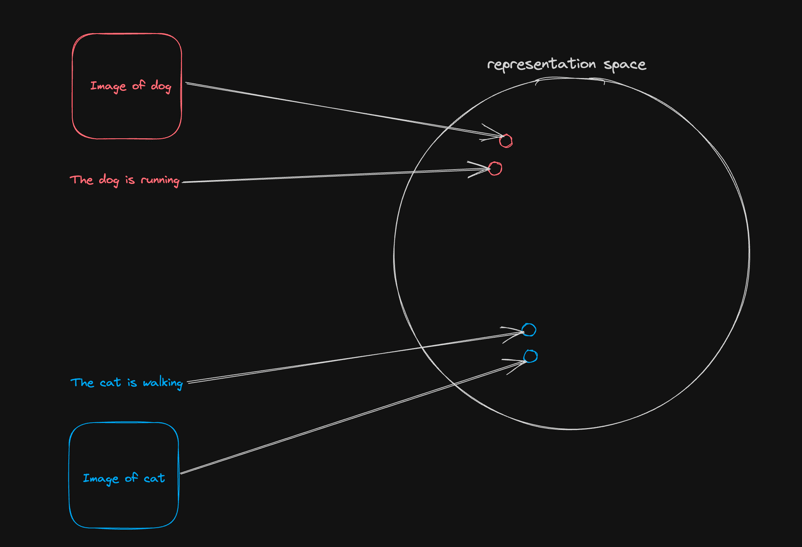
Ý tưởng đằng sau mục tiêu tương phản, như trong nhiều mô hình CLIP và ALIGN, khá đơn giản. Mục tiêu là học biểu diễn cho các phương thức khác nhau như hình ảnh và văn bản sao cho các cặp tương tự gần nhau hơn trong không gian biểu diễn và các cặp không tương tự xa nhau hơn.
Ở mỗi bước huấn luyện, chúng ta lấy một mẫu các cặp hình ảnh–văn bản từ tập dữ liệu và điều chỉnh trọng số của các bộ mã hóa để gom cụm các cặp và đẩy xa các không-cặp.
Như đã đề cập, mục tiêu tương phản yêu cầu biểu diễn đơn phương thức cho cả hai phương thức ảnh và văn bản. Để đạt được điều này ở phía bộ mã hóa văn bản, chúng ta áp dụng kỹ thuật kinh điển dùng trong mô hình ngôn ngữ BERT.
Là một phần của chuỗi đầu vào, chúng ta đưa vào một token phân loại [CLS] có thể học được ở cuối chuỗi và kỳ vọng vector đầu ra ánh xạ tới token này sẽ nắm bắt được nghĩa ngữ nghĩa của toàn bộ chuỗi đầu vào.
Vì các bộ giải mã của chúng ta áp dụng che nhân quả lên bản đồ chú ý, việc đặt token phân loại ở cuối chuỗi đảm bảo có kết nối chú ý giữa token phân loại và tất cả token khác trong chuỗi đầu vào, qua đó nắm bắt nghĩa ngữ nghĩa của cả câu.
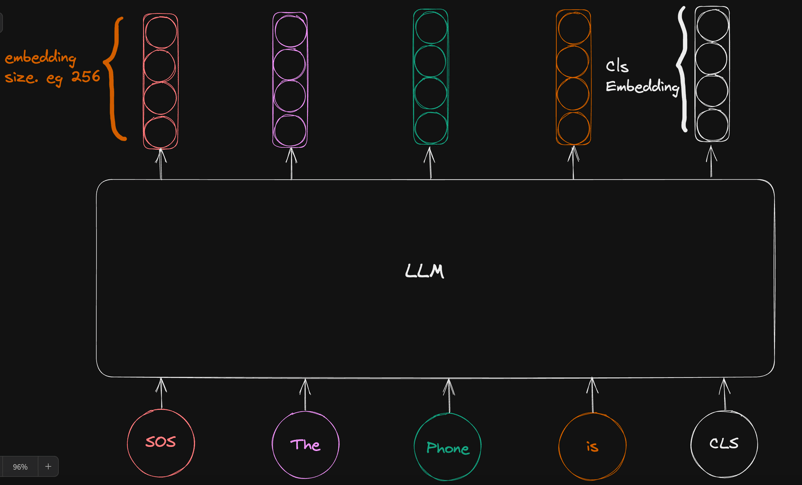
Chúng ta bỏ qua biểu diễn vector của các token đầu vào khác và dùng biểu diễn vector của token phân loại để ước lượng mất mát tương phản.
Ở phía bộ mã hóa ảnh, mọi thứ hơi khác.
Trong hình từ Hình-6, bạn có thể thấy một phần đầu ra của bộ mã hóa ảnh được dùng cùng với embedding của token phân loại để ước lượng mất mát tương phản, và một phần được gửi tới phần trên của thiết lập tách rời để ước lượng biểu diễn hợp nhất.
Thực tế, chỉ cần một embedding đầu ra duy nhất của ảnh để ước lượng mục tiêu tương phản, trong khi toàn bộ chuỗi embedding đầu ra của bộ mã hóa ảnh được dùng để ước lượng mục tiêu sinh.
Các tác giả cho rằng họ xác định được bằng thực nghiệm rằng một embedding gộp duy nhất giúp nắm bắt biểu diễn toàn cục của ảnh (đúng với điều chúng ta muốn cho mục tiêu tương phản), còn một chuỗi embedding giúp ở các tác vụ cần biểu diễn chi tiết hơn của ảnh.
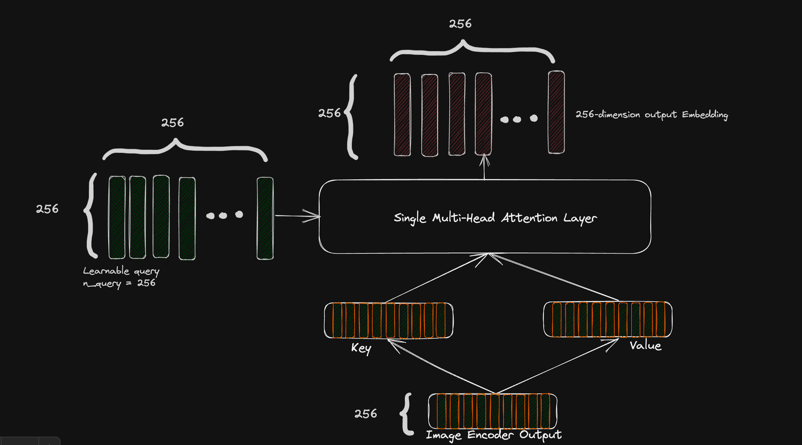
Để làm được điều này, một tầng gộp chú ý, tức một tầng multi-head attention đơn, được dùng để tùy biến đầu ra bộ mã hóa ảnh cho các mục tiêu khác nhau thông qua tham số query có thể học. Bằng cách đặt tham số query thành một giá trị số nguyên cụ thể, chúng ta có thể điều chỉnh toàn bộ thiết lập mã hóa để xuất một chuỗi embedding có độ dài bằng tham số query.
Trong mục tiêu tương phản, chúng ta đặt tham số query bằng một để chỉ lấy một embedding tính mất mát tương phản; còn trong mục tiêu sinh, chúng ta đặt nó thành một giá trị tùy ý, lý tưởng bằng độ dài chuỗi văn bản. Trong bài CoCa, các tác giả chọn 256 cho mục tiêu sinh.
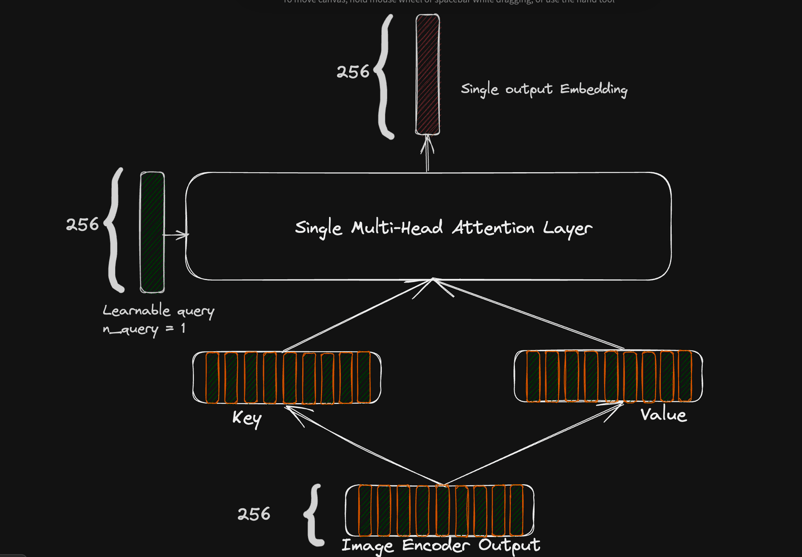
Thiết lập gộp chú ý cho mất mát tương phản. Đầu ra của tầng chú ý là một embedding 256 chiều duy nhất.
Mục tiêu sinh
Khác với mục tiêu tương phản chỉ cần biểu diễn toàn cục của ảnh, mục tiêu sinh hiệu quả hơn khi chúng ta tạo biểu diễn chi tiết hơn của ảnh.
Như đã giải thích, chúng ta thu được biểu diễn ảnh chi tiết bằng cách đặt tham số query thành một số tùy ý (256 trong bài CoCa) để tạo biểu diễn phong phú 256 x 256 của ảnh.
Biểu diễn này được đưa vào phần trên của thiết lập bộ giải mã tách rời và thông qua tương tác đa phương thức chéo với biểu diễn văn bản đơn phương thức (bỏ qua biểu diễn CLS), chúng ta có được biểu diễn hợp nhất hình ảnh–văn bản, được dùng để dự đoán phân phối xác suất của từ vựng theo phương pháp tự hồi quy.
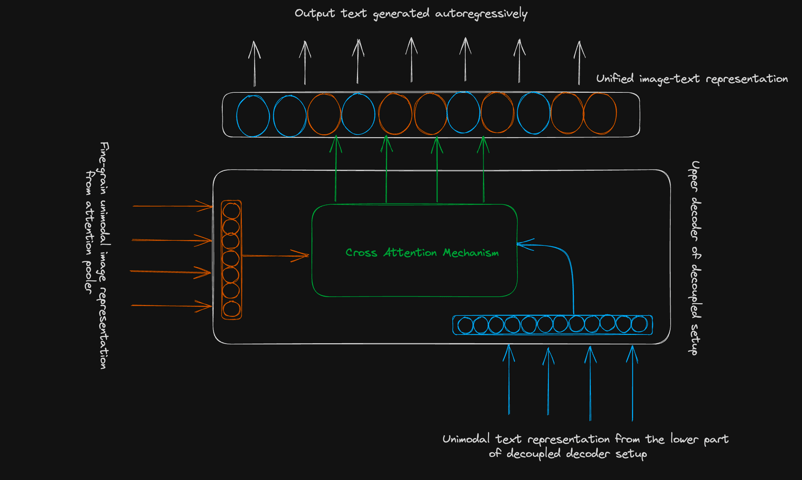
Như minh họa ở hai phần trước, thiết lập kiến trúc của mô hình CoCa cho phép bao trùm năng lực của một lớp mô hình xuất sắc ở các tác vụ zero-shot như phân loại ảnh và truy hồi đa phương thức, và một lớp mô hình khác xuất sắc ở VQA và chú thích ảnh. Mô hình CoCa cũng có thể được tinh chỉnh trên nhiều tác vụ thị giác và ngôn ngữ hạ nguồn.
Suy ngẫm cuối
Sự xuất hiện của các mô hình nền tảng như CoCa đánh dấu một bước tiến đáng kể trong lĩnh vực máy học. CoCa kết hợp điểm mạnh của nhiều khuynh hướng, mang đến một mô hình thống nhất có khả năng căn chỉnh biểu diễn hình ảnh và văn bản cũng như tạo ra biểu diễn hợp nhất hình ảnh–văn bản.
Mô hình này là minh chứng cho tiềm năng của việc tích hợp mục tiêu tương phản và mục tiêu sinh, mở đường cho hiệu năng vượt trội ở các tác vụ như Hỏi đáp Trực quan và chú thích ảnh. Nó bao trùm năng lực của các mô hình xuất sắc ở tác vụ zero-shot và những mô hình thành thạo các tác vụ hiểu hình ảnh–văn bản đa phương thức, cung cấp một công cụ linh hoạt cho nhiều tác vụ thị giác và ngôn ngữ hạ nguồn.
Đối với những ai muốn đào sâu các khái niệm nâng cao trong máy học và khám phá những tinh tế của học sâu, khóa Advanced Deep Learning with Keras trên DataCamp sẽ trang bị cho bạn kiến thức và kỹ năng để giải quyết nhiều vấn đề bằng Keras functional API linh hoạt, cho phép bạn khám phá và hiểu sâu hơn các mô hình tiên tiến như CoCa và những nguyên lý nền tảng của chúng.
Tài liệu đọc thêm
- Learning Transferable Visual Models From Natural Language Supervision
- Image-Text Pre-training with Contrastive Captioners


 Matt Crabtree• 10 phút
Hướng dẫn này là đóng góp quý giá từ cộng đồng của chúng tôi và đã được DataCamp biên tập để đảm bảo rõ ràng và chính xác.
Quan tâm chia sẻ chuyên môn của riêng bạn? Chúng tôi rất mong nhận được từ bạn! Hãy gửi bài viết hoặc ý tưởng của bạn qua Biểu mẫu Đóng góp Cộng đồng.
Sự phát triển của máy học đã dẫn đến sự ra đời của các mô hình nền tảng, một lớp mô hình được tiền huấn luyện trên dữ liệu khổng lồ, đóng vai trò là nền tảng linh hoạt cho vô vàn ứng dụng. Những mô hình này, tiêu biểu như GPT và BERT trong Xử lý Ngôn ngữ Tự nhiên (NLP), đã thể hiện năng lực vượt trội ở các tác vụ như học không ví dụ (zero-shot) và học ít ví dụ (few-shot).
Trong bài viết này, chúng ta đi sâu vào lĩnh vực các mô hình nền tảng hình ảnh–văn bản, khám phá mô hình Contrastive Captioner (CoCa) đầy sáng tạo. Chúng ta sẽ phân tích kiến trúc của nó, tìm hiểu cách tiếp cận độc đáo kết hợp mục tiêu đối sánh tương phản và mục tiêu sinh, và xem cách nó tích hợp năng lực của các mô hình như CLIP và SIMVLM vào một mô hình thống nhất, mạch lạc.
Hình-1 - Contrastive Captioner - (CoCa)
Sự trỗi dậy của các mô hình nền tảng
Ý tưởng về mô hình nền tảng không mới trong máy học. Trong học sâu, các kỹ thuật giúp huấn luyện những mô hình này cho phép chúng ta điều chỉnh mô hình sau này cho các tác vụ hạ nguồn. Trong NLP, đã có sự bùng nổ các mô hình nền tảng như GPT và BERT, được huấn luyện trên dữ liệu quy mô internet nhiễu, cho thấy khả năng zero-shot và few-shot đáng chú ý.
Nghiên cứu xây dựng các mô hình nền tảng thị giác và thị giác–ngôn ngữ đã khám phá ba hướng chính: mô hình mã hóa đơn, mô hình mã hóa kép hình ảnh–văn bản với hàm mất mát đối sánh tương phản, và mô hình mã hóa–giải mã với mục tiêu sinh. Trước khi tìm hiểu mô hình CoCa, hãy điểm qua các hướng nghiên cứu này và những điểm yếu của chúng.
Thuật ngữ
Mô hình mã hóa đơn
Nếu bạn từng thử sức với thị giác máy tính, nhiều khả năng bạn đã gặp lớp mô hình này. Các mô hình này học biểu diễn của hình ảnh có thể được điều chỉnh cho các tác vụ thị giác hạ nguồn bằng cách huấn luyện trên tập dữ liệu lớn ảnh có gán nhãn với mất mát cross-entropy.
Thực nghiệm cho thấy chúng rất mạnh ở các tác vụ liên quan đến thị giác như phát hiện đối tượng, nhưng kém ở các tác vụ liên quan đến thị giác–ngôn ngữ do phụ thuộc nhiều vào gán nhãn của con người, khiến chúng không tích hợp được ngôn ngữ tự nhiên của con người.
Mô hình mã hóa kép hình ảnh–văn bản với mất mát đối sánh tương phản
Các mô hình phổ biến thuộc lớp mô hình nền tảng thị giác–ngôn ngữ này gồm CLIP (Contrastive Language-Image Pre-training) và ALIGN.
Trong giai đoạn tiền huấn luyện, chúng ta học tác vụ căn chỉnh bằng cách huấn luyện đồng thời mô hình hình ảnh và mô hình ngôn ngữ với mất mát tương phản.
Ý tưởng đằng sau mục tiêu tiền huấn luyện này khá đơn giản: gom cụm các biểu diễn của các cặp hình ảnh–văn bản (có liên quan) và đẩy xa các biểu diễn của hình ảnh và văn bản không liên quan (không phải cặp) trong cùng không gian tiềm ẩn. Mô hình mã hóa kép thu được sau đó có thể được cấu hình để thực hiện phân loại zero-shot và truy hồi hình ảnh.
Các mô hình gần đây như CLIP đã đạt hiệu năng đáng kể ở nhiều tác vụ thị giác–ngôn ngữ, nhưng hầu như không thể dùng cho các tác vụ cần biểu diễn hợp nhất của hình ảnh và văn bản, như hỏi đáp trực quan, vì chúng ta chỉ học căn chỉnh biểu diễn của hình ảnh và văn bản mà không tạo ra một biểu diễn thống nhất mã hóa cả thông tin từ ảnh và văn bản.
Hình-3 - Contrastive Language-Image Pre-training (CLIP)
Tiền huấn luyện sinh với kiến trúc mã hóa–giải mã
Các mô hình này sử dụng tương tác đa phương thức chéo giữa các biểu diễn ẩn của hình ảnh và văn bản để tạo ra biểu diễn chung.
Trong tiền huấn luyện, chúng ta tạo biểu diễn hợp nhất của hình ảnh và văn bản thông qua tương tác đa phương thức chéo giữa biểu diễn văn bản ẩn và đầu ra của bộ mã hóa ảnh, rồi áp dụng mất mát Mô hình Hóa Ngôn ngữ lên đầu ra bộ giải mã.
Trong kiến trúc máy học gần đây, tương tác đa phương thức chéo chủ yếu được thực hiện qua cơ chế cross-attention trong transformer, dùng đầu ra bộ mã hóa ảnh làm query và các biểu diễn văn bản ẩn làm key và value.
Đối với các tác vụ hạ nguồn, chúng ta có thể lấy đầu ra bộ giải mã, tức biểu diễn chung của hình ảnh và văn bản, để thực hiện các tác vụ hiểu hình ảnh–văn bản đa phương thức như Hỏi đáp Trực quan. Một mô hình gần đây dùng cách tiếp cận này là Simple Visual Language Model (SIMVLM).
Hình-5 - Simple Visual Language Model (SIMVLM)
Động lực đằng sau CoCa
Các tác giả của mô hình CoCa muốn bao trùm năng lực của các khuynh hướng xây dựng mô hình nền tảng hình ảnh–văn bản khác nhau trong một mô hình đơn giản. Thiết kế của CoCa tận dụng mất mát tương phản để học căn chỉnh biểu diễn hình ảnh và văn bản trong cùng một không gian vector và mục tiêu sinh (mất mát chú thích) để học biểu diễn hợp nhất hình ảnh–văn bản, qua đó tích hợp năng lực của các mô hình như CLIP và SIMVLM vào một mô hình duy nhất.
Kiến trúc mô hình
CoCa sử dụng cách tiếp cận mã hóa–giải mã tiêu chuẩn và, giống hầu hết các mô hình kiểu này, mã hóa ảnh bằng mạng nơ-ron như mạng nơ-ron tích chập hoặc transformer.
Điểm độc đáo của kiến trúc CoCa bắt đầu từ đầu ra của bộ mã hóa và toàn bộ thiết lập bộ giải mã.
Nhớ rằng mục tiêu của bài báo CoCa là kết hợp năng lực của hai khuynh hướng mô hình thị giác–ngôn ngữ (mục tiêu tương phản và mục tiêu sinh) vào một mô hình. Khuynh hướng mục tiêu tương phản yêu cầu bộ giải mã văn bản của chúng ta xuất ra biểu diễn văn bản đơn phương thức, sau đó được chiếu vào không gian vector tương tự như biểu diễn ảnh để học tác vụ căn chỉnh.
Mục tiêu sinh, ngược lại, cho phép bộ giải mã nhận các biểu diễn ảnh từ bộ mã hóa và sinh văn bản theo cách tự hồi quy có điều kiện trên biểu diễn ảnh và đầu vào văn bản.
Lưu ý rằng cả hai phần bộ giải mã đều áp dụng che nhân quả để ngăn mô hình nhìn trước các token.
Để đạt được điều này, các tác giả khéo léo điều chỉnh thiết lập bộ giải mã tách rời: phần đầu học tạo biểu diễn văn bản đơn phương thức cho mục tiêu tương phản và phần sau học tạo biểu diễn đa phương thức hình ảnh–văn bản.
Mục tiêu tương phản
Ý tưởng đằng sau mục tiêu tương phản, như trong nhiều mô hình CLIP và ALIGN, khá đơn giản. Mục tiêu là học biểu diễn cho các phương thức khác nhau như hình ảnh và văn bản sao cho các cặp tương tự gần nhau hơn trong không gian biểu diễn và các cặp không tương tự xa nhau hơn.
Ở mỗi bước huấn luyện, chúng ta lấy một mẫu các cặp hình ảnh–văn bản từ tập dữ liệu và điều chỉnh trọng số của các bộ mã hóa để gom cụm các cặp và đẩy xa các không-cặp.
Như đã đề cập, mục tiêu tương phản yêu cầu biểu diễn đơn phương thức cho cả hai phương thức ảnh và văn bản. Để đạt được điều này ở phía bộ mã hóa văn bản, chúng ta áp dụng kỹ thuật kinh điển dùng trong mô hình ngôn ngữ BERT.
Là một phần của chuỗi đầu vào, chúng ta đưa vào một token phân loại [CLS] có thể học được ở cuối chuỗi và kỳ vọng vector đầu ra ánh xạ tới token này sẽ nắm bắt được nghĩa ngữ nghĩa của toàn bộ chuỗi đầu vào.
Vì các bộ giải mã của chúng ta áp dụng che nhân quả lên bản đồ chú ý, việc đặt token phân loại ở cuối chuỗi đảm bảo có kết nối chú ý giữa token phân loại và tất cả token khác trong chuỗi đầu vào, qua đó nắm bắt nghĩa ngữ nghĩa của cả câu.
Chúng ta bỏ qua biểu diễn vector của các token đầu vào khác và dùng biểu diễn vector của token phân loại để ước lượng mất mát tương phản.
Ở phía bộ mã hóa ảnh, mọi thứ hơi khác.
Trong hình từ Hình-6, bạn có thể thấy một phần đầu ra của bộ mã hóa ảnh được dùng cùng với embedding của token phân loại để ước lượng mất mát tương phản, và một phần được gửi tới phần trên của thiết lập tách rời để ước lượng biểu diễn hợp nhất.
Thực tế, chỉ cần một embedding đầu ra duy nhất của ảnh để ước lượng mục tiêu tương phản, trong khi toàn bộ chuỗi embedding đầu ra của bộ mã hóa ảnh được dùng để ước lượng mục tiêu sinh.
Các tác giả cho rằng họ xác định được bằng thực nghiệm rằng một embedding gộp duy nhất giúp nắm bắt biểu diễn toàn cục của ảnh (đúng với điều chúng ta muốn cho mục tiêu tương phản), còn một chuỗi embedding giúp ở các tác vụ cần biểu diễn chi tiết hơn của ảnh.
Để làm được điều này, một tầng gộp chú ý, tức một tầng multi-head attention đơn, được dùng để tùy biến đầu ra bộ mã hóa ảnh cho các mục tiêu khác nhau thông qua tham số query có thể học. Bằng cách đặt tham số query thành một giá trị số nguyên cụ thể, chúng ta có thể điều chỉnh toàn bộ thiết lập mã hóa để xuất một chuỗi embedding có độ dài bằng tham số query.
Trong mục tiêu tương phản, chúng ta đặt tham số query bằng một để chỉ lấy một embedding tính mất mát tương phản; còn trong mục tiêu sinh, chúng ta đặt nó thành một giá trị tùy ý, lý tưởng bằng độ dài chuỗi văn bản. Trong bài CoCa, các tác giả chọn 256 cho mục tiêu sinh.
Thiết lập gộp chú ý cho mất mát tương phản. Đầu ra của tầng chú ý là một embedding 256 chiều duy nhất.
Mục tiêu sinh
Khác với mục tiêu tương phản chỉ cần biểu diễn toàn cục của ảnh, mục tiêu sinh hiệu quả hơn khi chúng ta tạo biểu diễn chi tiết hơn của ảnh.
Như đã giải thích, chúng ta thu được biểu diễn ảnh chi tiết bằng cách đặt tham số query thành một số tùy ý (256 trong bài CoCa) để tạo biểu diễn phong phú 256 x 256 của ảnh.
Biểu diễn này được đưa vào phần trên của thiết lập bộ giải mã tách rời và thông qua tương tác đa phương thức chéo với biểu diễn văn bản đơn phương thức (bỏ qua biểu diễn CLS), chúng ta có được biểu diễn hợp nhất hình ảnh–văn bản, được dùng để dự đoán phân phối xác suất của từ vựng theo phương pháp tự hồi quy.
Như minh họa ở hai phần trước, thiết lập kiến trúc của mô hình CoCa cho phép bao trùm năng lực của một lớp mô hình xuất sắc ở các tác vụ zero-shot như phân loại ảnh và truy hồi đa phương thức, và một lớp mô hình khác xuất sắc ở VQA và chú thích ảnh. Mô hình CoCa cũng có thể được tinh chỉnh trên nhiều tác vụ thị giác và ngôn ngữ hạ nguồn.
Suy ngẫm cuối
Sự xuất hiện của các mô hình nền tảng như CoCa đánh dấu một bước tiến đáng kể trong lĩnh vực máy học. CoCa kết hợp điểm mạnh của nhiều khuynh hướng, mang đến một mô hình thống nhất có khả năng căn chỉnh biểu diễn hình ảnh và văn bản cũng như tạo ra biểu diễn hợp nhất hình ảnh–văn bản.
Mô hình này là minh chứng cho tiềm năng của việc tích hợp mục tiêu tương phản và mục tiêu sinh, mở đường cho hiệu năng vượt trội ở các tác vụ như Hỏi đáp Trực quan và chú thích ảnh. Nó bao trùm năng lực của các mô hình xuất sắc ở tác vụ zero-shot và những mô hình thành thạo các tác vụ hiểu hình ảnh–văn bản đa phương thức, cung cấp một công cụ linh hoạt cho nhiều tác vụ thị giác và ngôn ngữ hạ nguồn.
Đối với những ai muốn đào sâu các khái niệm nâng cao trong máy học và khám phá những tinh tế của học sâu, khóa Advanced Deep Learning with Keras trên DataCamp sẽ trang bị cho bạn kiến thức và kỹ năng để giải quyết nhiều vấn đề bằng Keras functional API linh hoạt, cho phép bạn khám phá và hiểu sâu hơn các mô hình tiên tiến như CoCa và những nguyên lý nền tảng của chúng.
Tài liệu đọc thêm