Last chance! 50% off DataCamp Premium
Sale ends in
Questo tutorial è un prezioso contributo della nostra community ed è stato revisionato da DataCamp per chiarezza e accuratezza.
Vuoi condividere le tue competenze? Ci farebbe piacere! Invia i tuoi articoli o le tue idee tramite il nostro Community Contribution Form.
L'evoluzione del machine learning ha portato allo sviluppo dei foundation model, una classe di modelli pre-addestrati su dati estesi che fungono da base versatile per una miriade di applicazioni. Questi modelli, esemplificati da GPT e BERT nell'elaborazione del linguaggio naturale (NLP), hanno mostrato capacità senza precedenti in compiti come lo zero-shot e il few-shot learning.
In questo articolo entriamo nel mondo dei foundation model immagine-testo, esplorando l'innovativo modello Contrastive Captioner (CoCa). Ne analizzeremo l'architettura, capiremo il suo approccio unico che combina obiettivi contrastivi e generativi e vedremo come incorpora le capacità di modelli come CLIP e SIMVLM in un unico modello coeso.
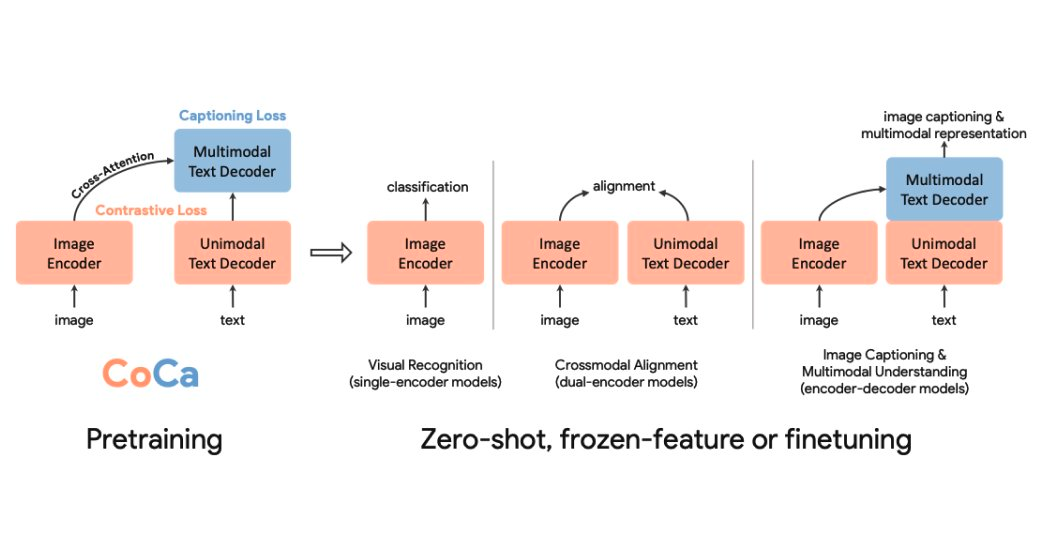
Fig-1 - Contrastive Captioner - (CoCa)
L'idea dei foundation model non è nuova nel machine learning. Nel deep learning, le tecniche che consentono l'addestramento di questi modelli ci permettono di adattarli in futuro a compiti a valle. Nell'NLP c'è stato un boom di foundation model come GPT e BERT, addestrati su dati rumorosi di scala internet, che hanno dimostrato notevoli capacità zero-shot e few-shot.
La ricerca per costruire foundation model di visione e visione-linguaggio ha esplorato tre percorsi principali: modelli a singolo encoder, modelli dual-encoder immagine-testo con loss contrastiva e modelli encoder-decoder con un obiettivo generativo. Prima di esplorare il modello CoCa, diamo un'occhiata a queste linee di ricerca nella costruzione di foundation model e alle loro debolezze.
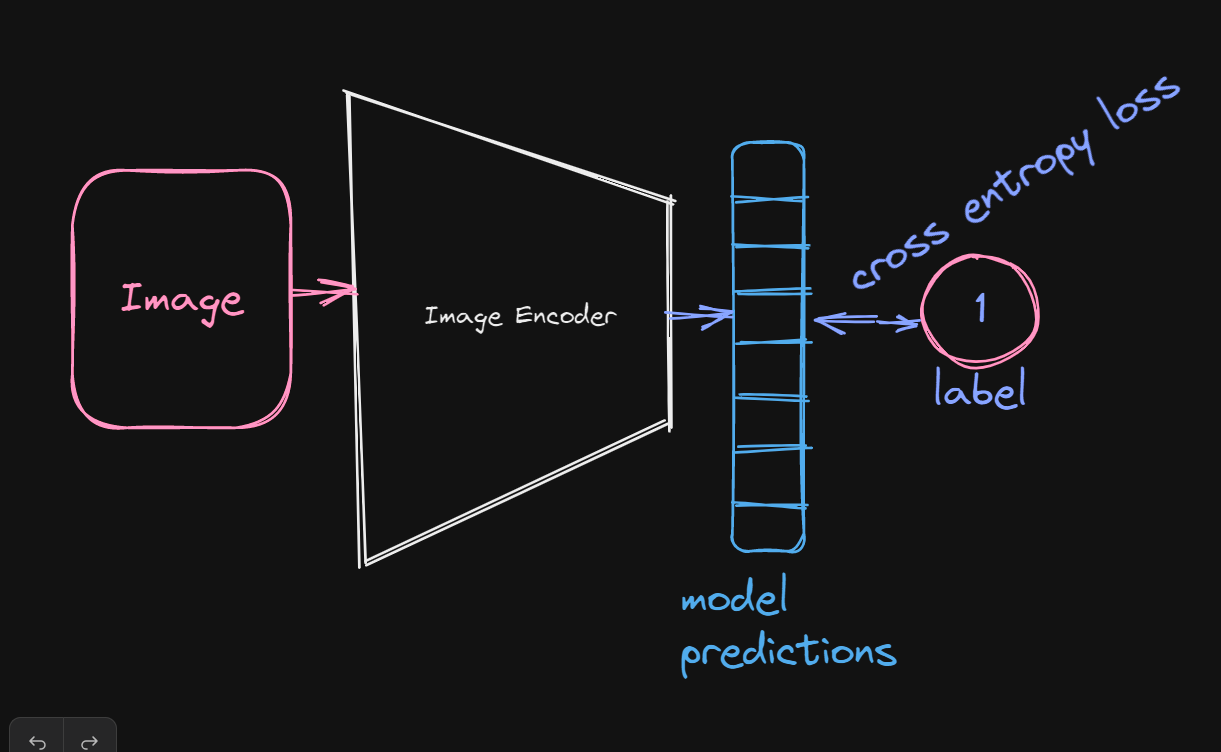
Se ti sei già cimentato nella computer vision, è probabile che tu ti sia imbattuto in questa classe di modelli. Questi modelli imparano rappresentazioni delle immagini che possono poi essere adattate a compiti di visione a valle addestrando su un ampio dataset di immagini annotate con una loss di cross-entropy.
Empiricamente, questi modelli eccellono in compiti legati alla visione come il detection, ma risultano inferiori in compiti che coinvolgono visione e linguaggio a causa della forte dipendenza da annotazioni umane, che impedisce di incorporare in essi il linguaggio naturale umano.
Modelli popolari di questa classe di foundation model visione-linguaggio includono CLIP (Contrastive Language-Image Pre-training) e ALIGN.
Durante il pre-addestramento, si impara un compito di allineamento addestrando congiuntamente un modello di immagini e uno di linguaggio utilizzando una loss contrastiva.
L'idea alla base del loro obiettivo di pre-addestramento è piuttosto semplice: raggruppare le rappresentazioni delle coppie immagine-testo (sono correlate) e allontanare le rappresentazioni di immagini e testi non correlati (coppie non corrispondenti) nello stesso spazio latente. Il modello dual-encoder risultante può quindi essere configurato per eseguire compiti di classificazione zero-shot e image retrieval.
Modelli recenti di questa classe, come CLIP, hanno mostrato prestazioni notevoli su vari compiti visione-linguaggio, ma sono quasi impossibili da usare in compiti che richiedono una rappresentazione fusa di immagini e testi, come il visual question answering, poiché si impara solo ad allineare le rappresentazioni di immagini e testo e non a generare una rappresentazione unificata che codifichi le informazioni di entrambi gli input.
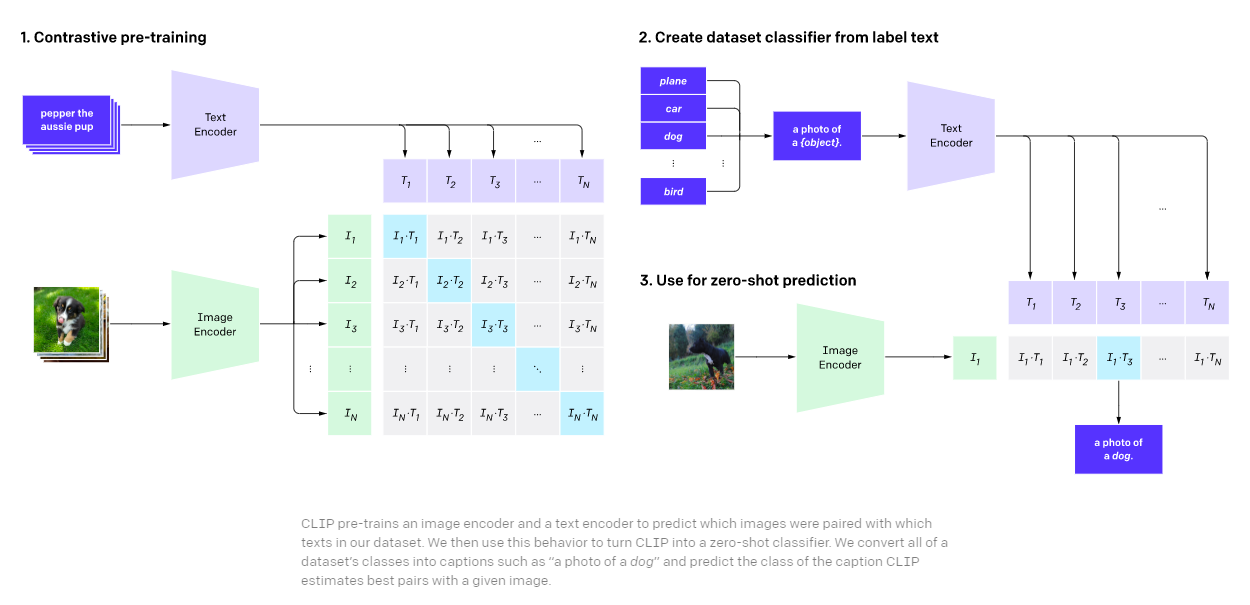
Fig-3 - Contrastive Language-Image Pre-training (CLIP)
Questi modelli impiegano un'interazione cross-modale tra le rappresentazioni nascoste di immagine e testo per generare una rappresentazione congiunta.
Durante il pre-addestramento, generiamo una rappresentazione unificata di immagine e testo tramite interazioni cross-modali tra la rappresentazione testuale nascosta e l'output dell'image encoder e applichiamo una loss di modellazione del linguaggio sull'output del decoder.
Nelle architetture recenti di machine learning, l'interazione cross-modale viene per lo più eseguita tramite un meccanismo di cross-attention nei transformer usando gli output dell'image encoder come query e le rappresentazioni testuali nascoste come key e value.
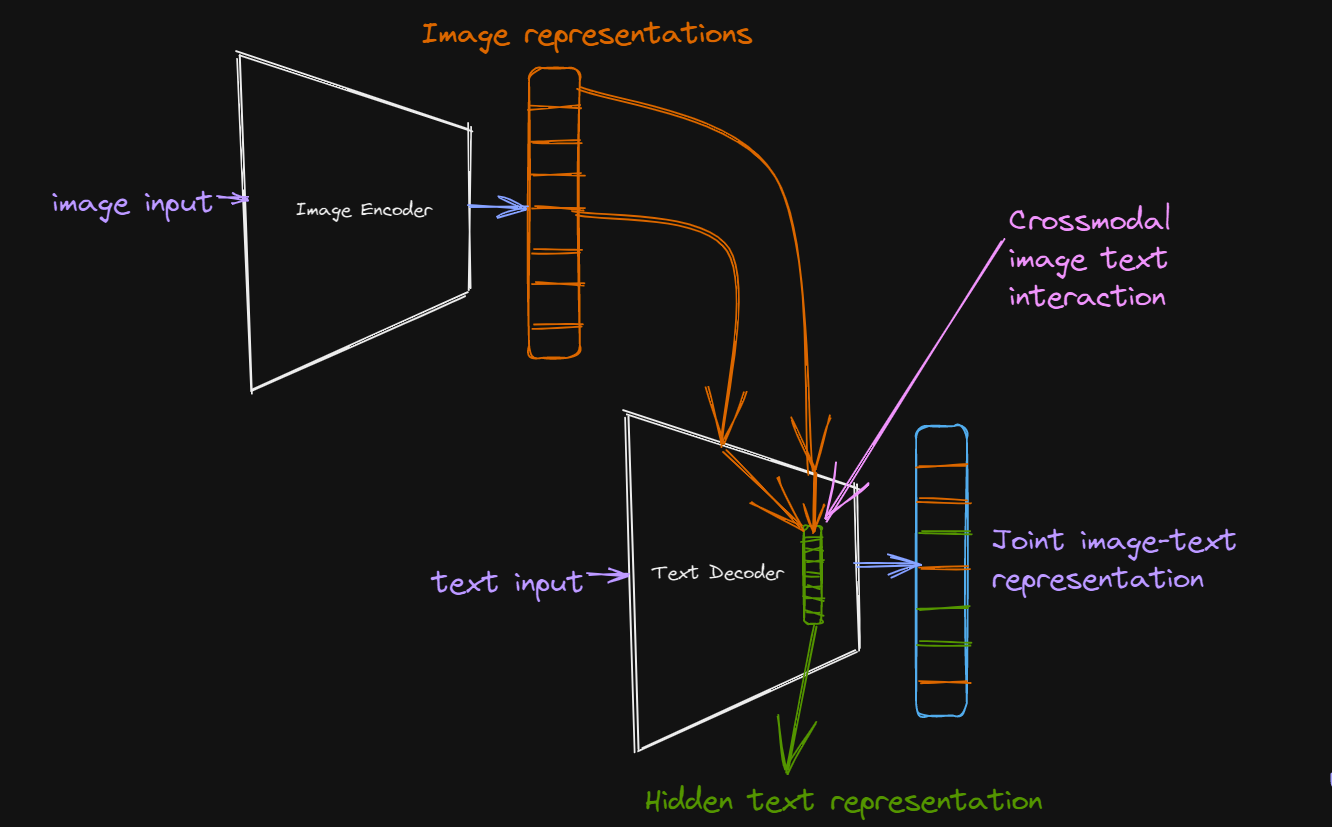
Per i compiti a valle, possiamo prendere l'output del decoder, che è una rappresentazione congiunta di immagine e testo, ed eseguire vari compiti di comprensione multimodale immagine-testo come il Visual Question Answering. Un modello recente che usa questo paradigma è il Simple Visual Language Model (SIMVLM).
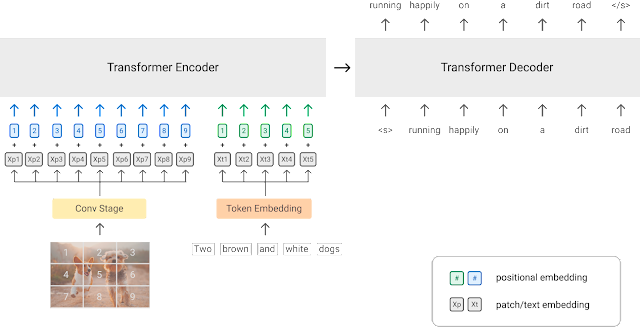
Fig-5 - Simple Visual Language Model (SIMVLM)
Gli autori del modello CoCa hanno cercato di riunire le capacità dei diversi paradigmi per costruire foundation model immagine-testo in un modello semplice. Il design di CoCa sfrutta una loss contrastiva per imparare ad allineare le rappresentazioni di immagini e testi in un unico spazio vettoriale e un obiettivo generativo (captioning loss) per imparare una rappresentazione congiunta immagine-testo, incorporando così le capacità di modelli come CLIP e SIMVLM in un unico modello.
CoCa adotta il classico approccio encoder-decoder e, come la maggior parte dei modelli di questo tipo, codifica l'immagine con una rete neurale come una convolutional neural network o un transformer.
L'unicità dell'architettura di CoCa inizia all'output del suo encoder e in tutta la configurazione del decoder.
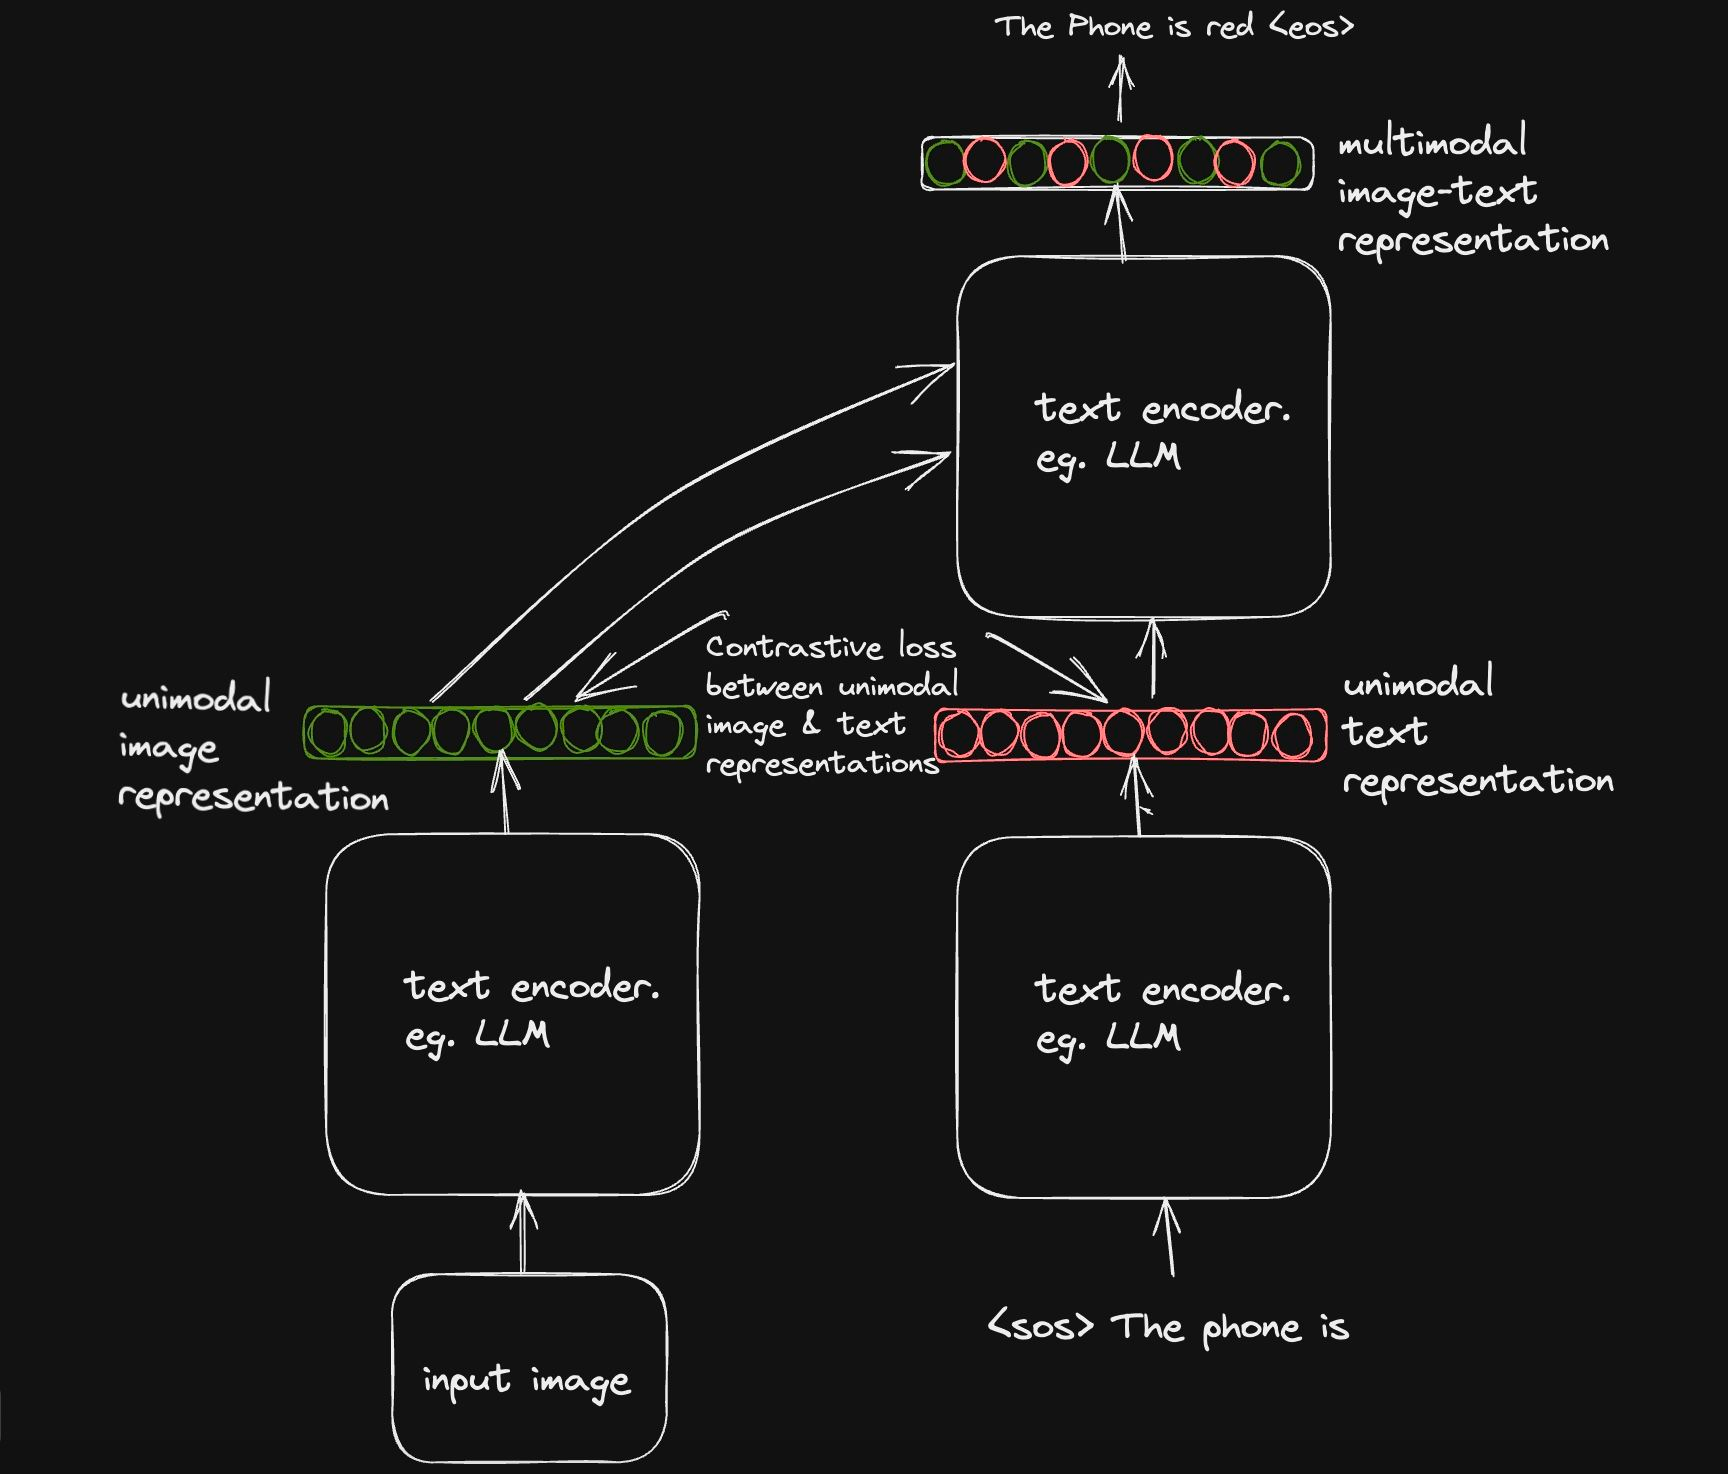
Ricordiamo che l'obiettivo dell'articolo su CoCa è combinare le capacità di due paradigmi di modelli visione-linguaggio (obiettivi contrastivi e generativi) in un unico modello. Il paradigma con obiettivo contrastivo richiede che il nostro decoder testuale produca una rappresentazione testuale unimodale, che viene poi proiettata in uno spazio vettoriale simile a quello della rappresentazione dell'immagine per imparare il compito di allineamento.
L'obiettivo generativo, invece, consente al decoder di ricevere rappresentazioni di immagine dall'encoder e generare autoregressivamente testo condizionato sulle rappresentazioni di immagine e sull'input testuale.
Nota che entrambe le parti del decoder applicano masking causale per impedire al modello di vedere i token futuri.
Per ottenere ciò, gli autori hanno adattato in modo ingegnoso una configurazione di decoder disaccoppiata: la prima parte impara a produrre una rappresentazione testuale unimodale per l'obiettivo contrastivo e la seconda parte impara a generare una rappresentazione multimodale immagine-testo.
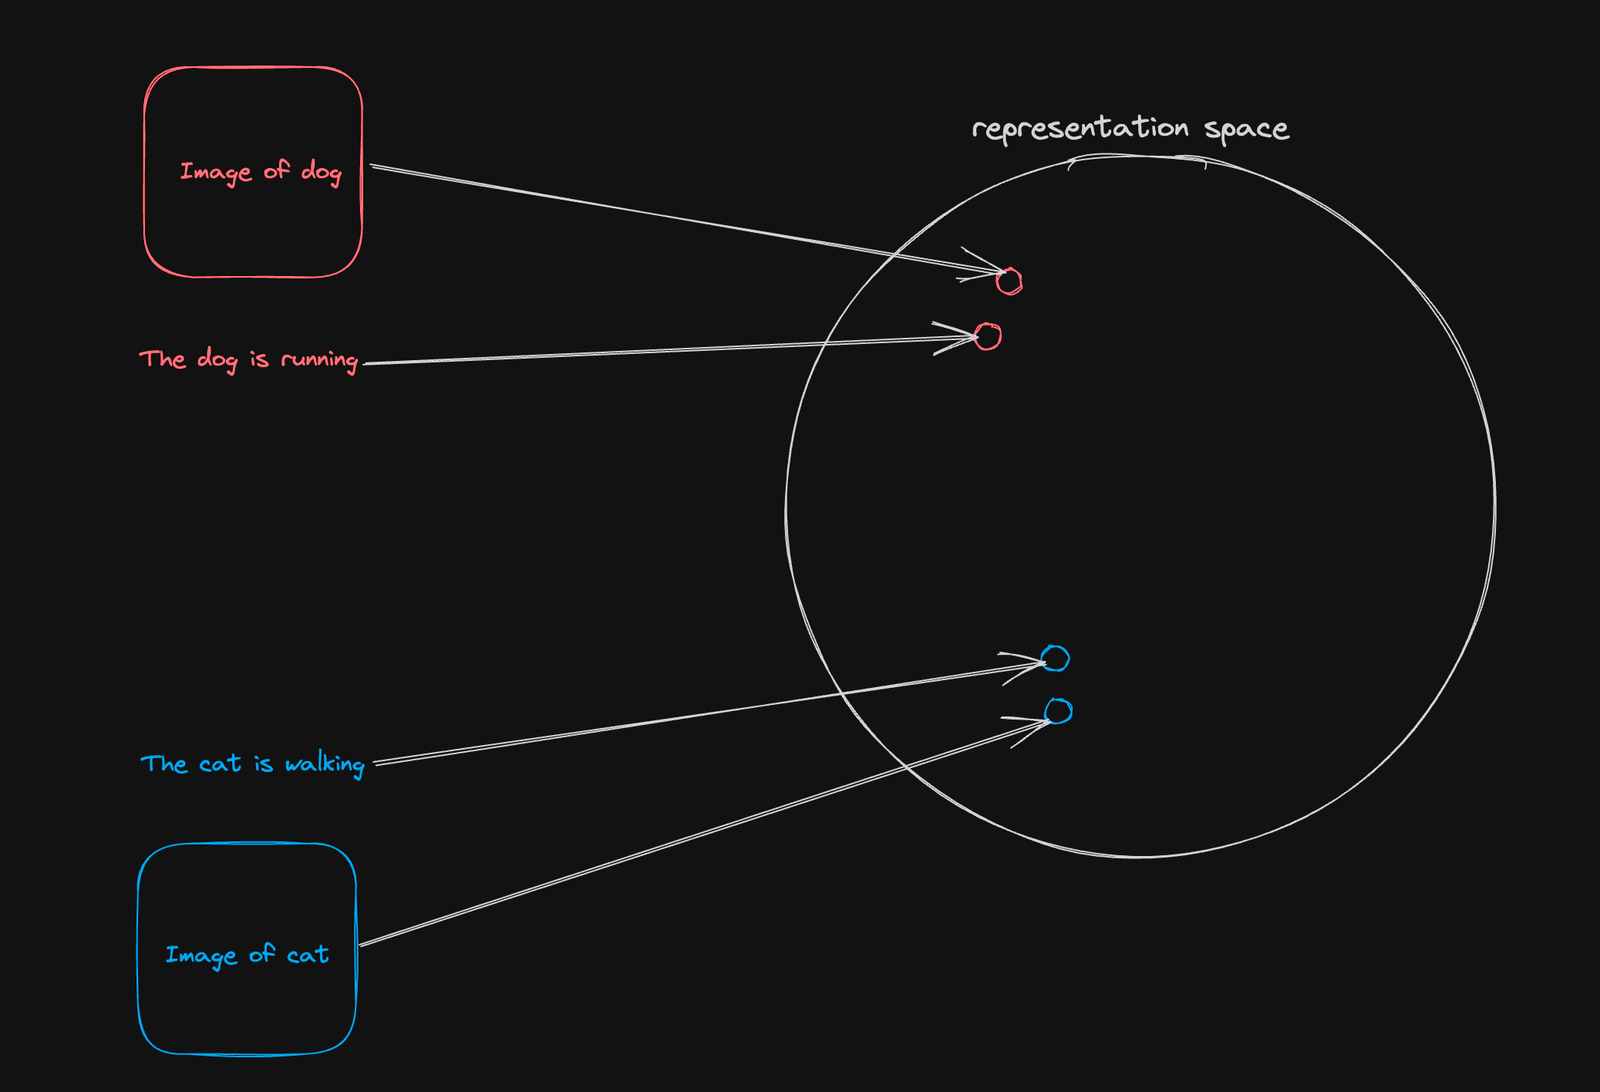
L'idea alla base dell'obiettivo contrastivo, come usato in diversi modelli come CLIP e ALIGN, è piuttosto semplice. Si tratta di imparare una rappresentazione per diverse modalità, come immagine e testo, tale che le coppie simili siano più vicine nello spazio di rappresentazione e le coppie dissimili siano più lontane.
A ogni step di addestramento, estraiamo un campione di coppie immagine-testo dal dataset e guidiamo i pesi dei nostri encoder a raggruppare le coppie corrispondenti e ad allontanare le non-coppie.
Come detto, l'obiettivo contrastivo richiede rappresentazioni unimodali di entrambe le modalità immagine e testo. Per ottenerlo lato encoder testuale, applichiamo una tecnica classica usata nel linguaggio BERT.
Come parte della sequenza di input, introduciamo un token di classificazione apprendibile [CLS] alla fine della sequenza e ci aspettiamo che il vettore di output mappato a questo token catturi il significato semantico dell'intera sequenza di input.
Poiché i nostri decoder applicano masking causale alle loro mappe di attenzione, aggiungere il token di classificazione alla fine della sequenza garantisce una connessione di attenzione tra il token di classificazione e tutti gli altri token nella sequenza di input, catturando così il significato semantico dell'intera frase.
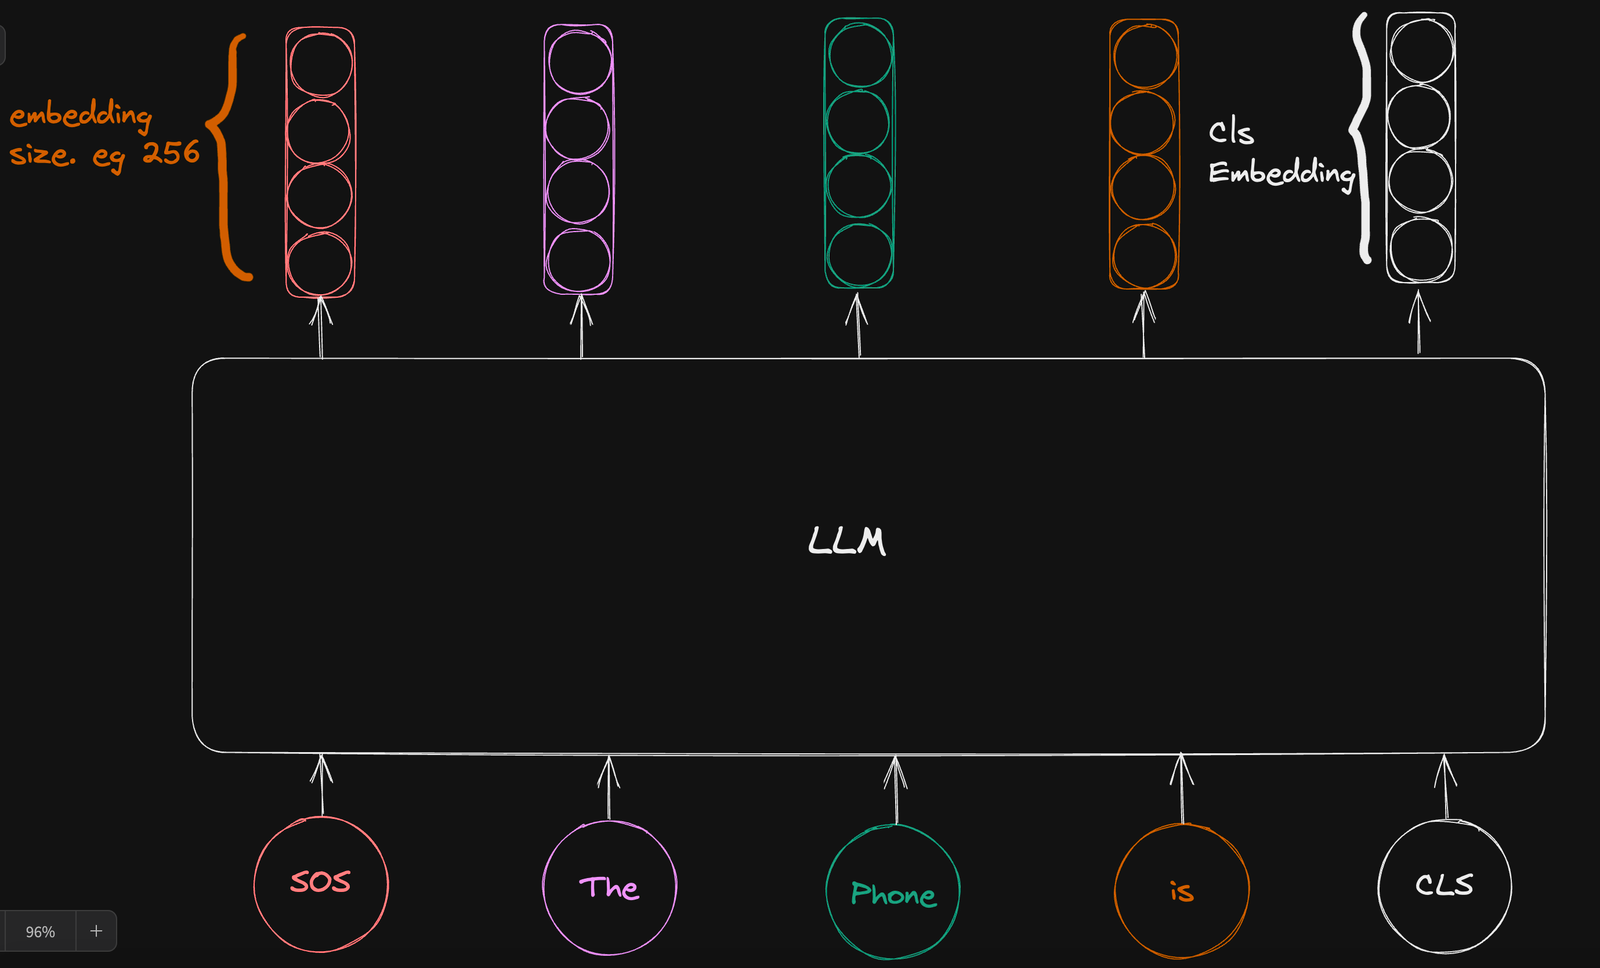
Ignoriamo la rappresentazione vettoriale degli altri token di input e utilizziamo la rappresentazione vettoriale del token di classificazione per stimare la loss contrastiva.
Lato image encoder, le cose sono un po' diverse.
Nell'immagine della Fig-6, puoi vedere che parte dell'output dell'image encoder viene utilizzata insieme all'embedding del token di classificazione per stimare la loss contrastiva, e parte viene inviata alla parte superiore della configurazione disaccoppiata per stimare la rappresentazione congiunta.
In realtà, è necessario un solo embedding di output dell'immagine per stimare l'obiettivo contrastivo, mentre l'intera sequenza di embedding di output dell'image encoder viene utilizzata per stimare l'obiettivo generativo.
Gli autori sostengono di aver determinato empiricamente che un singolo embedding pooled aiuta a catturare la rappresentazione globale dell'immagine (esattamente ciò che vogliamo per l'obiettivo contrastivo), mentre una sequenza di embedding aiuta in compiti che richiedono una rappresentazione più granulare dell'immagine.
Per ottenere ciò, si impiega un livello di attentional pooling, ovvero un singolo layer di multi-head attention, per personalizzare l'output dell'image encoder per obiettivi diversi tramite un parametro di query apprendibile. Impostando il parametro di query su un valore intero specifico, possiamo adattare l'intera configurazione dell'encoder per produrre una sequenza di embedding la cui lunghezza è il parametro di query.
Nel caso dell'obiettivo contrastivo, impostiamo il parametro di query a uno per ottenere un singolo embedding con cui calcolare la loss contrastiva; nel caso dell'obiettivo generativo, lo impostiamo su un valore arbitrario idealmente uguale alla lunghezza di sequenza del nostro testo. Nell'articolo su CoCa, gli autori hanno scelto 256 per l'obiettivo generativo.
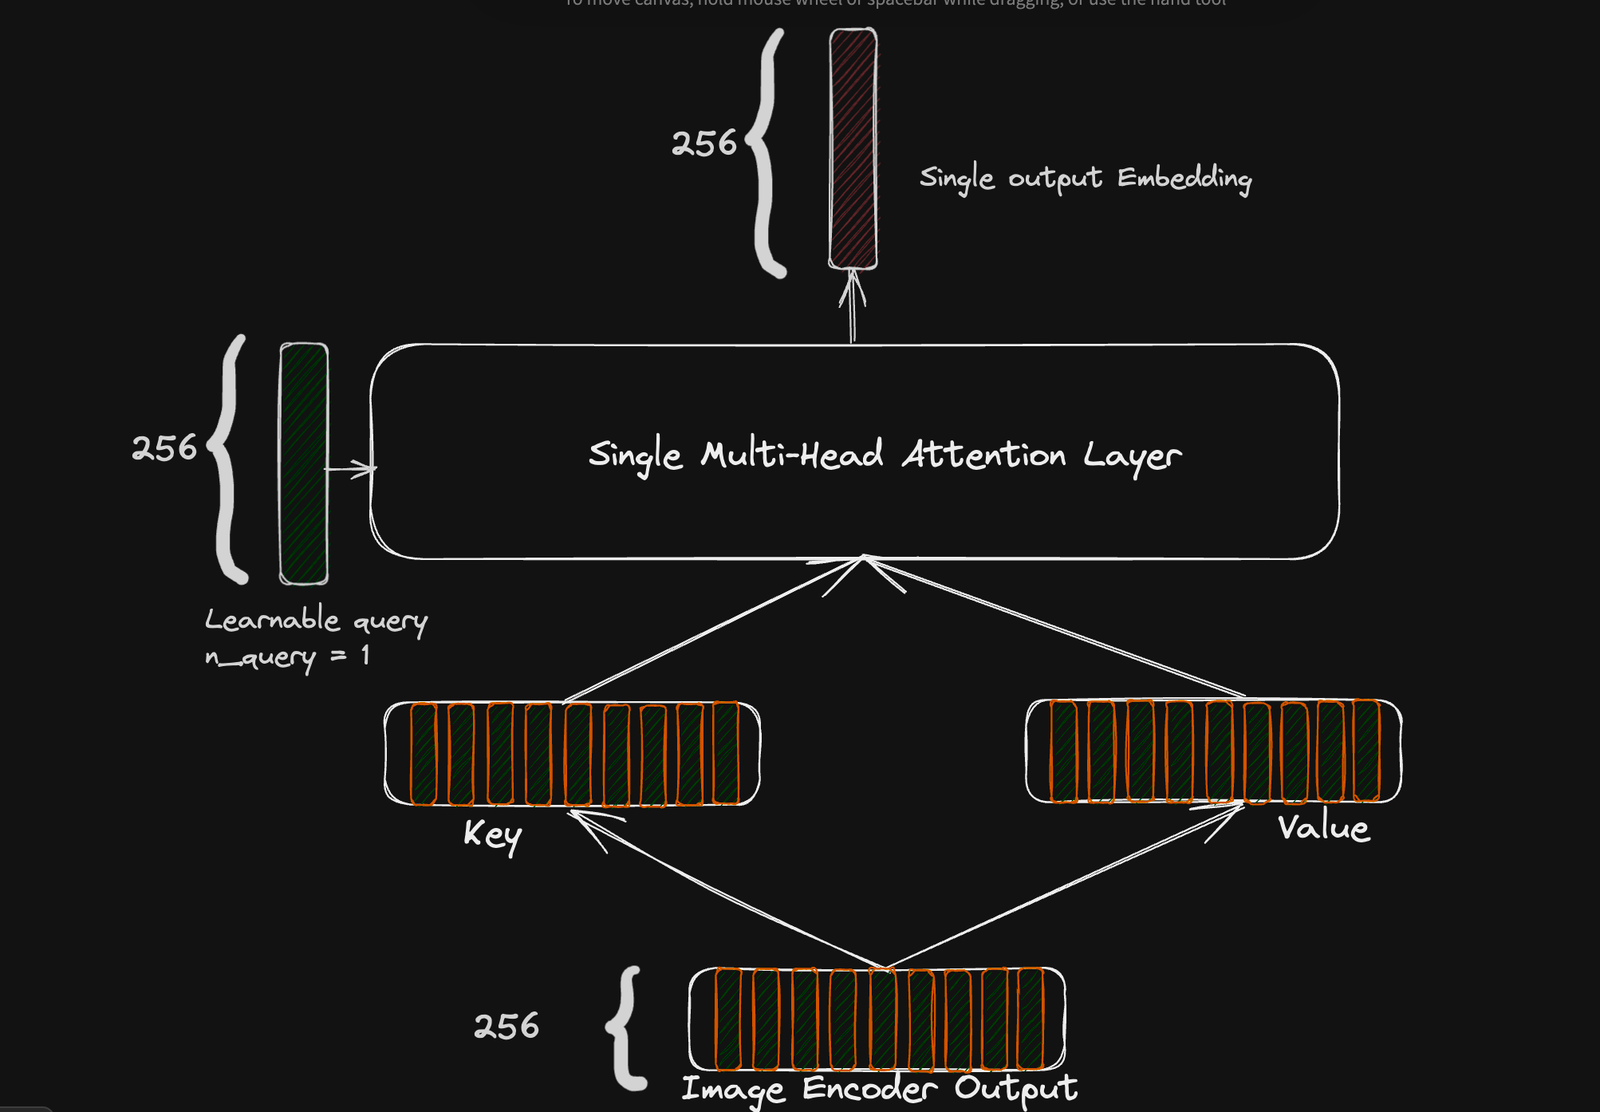
Configurazione di attention pooling per la loss contrastiva. L'output del layer di attenzione è un singolo embedding a 256 dimensioni.
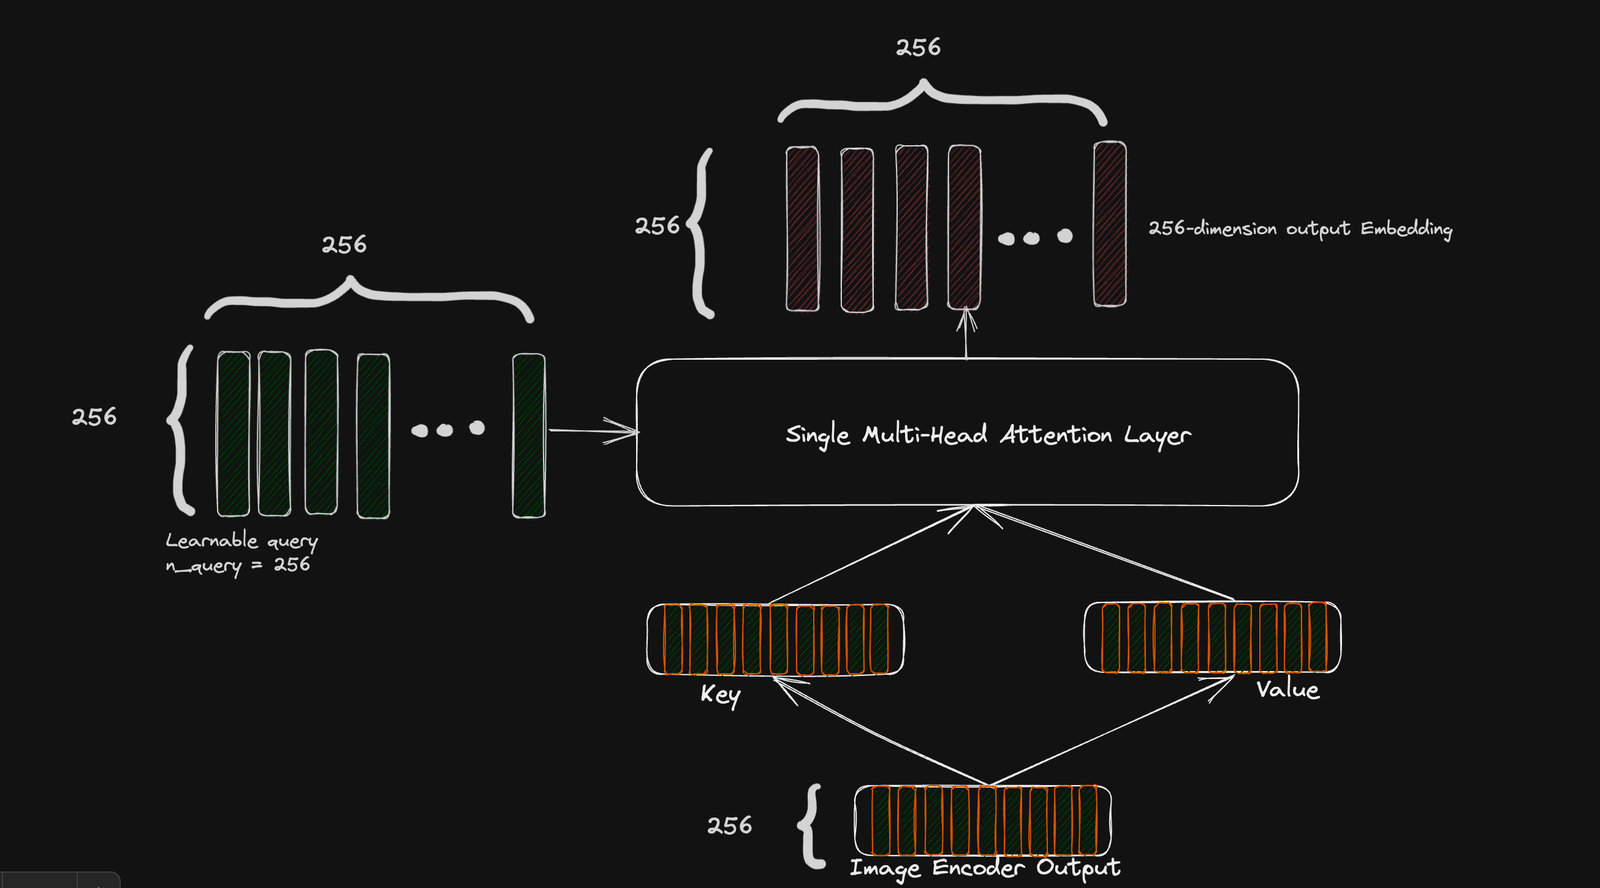
A differenza dell'obiettivo contrastivo, che richiede solo una rappresentazione globale dell'immagine, l'obiettivo generativo è più efficace quando generiamo una rappresentazione dell'immagine più granulare.
Come già spiegato, otteniamo la rappresentazione granulare dell'immagine impostando il parametro di query su un numero arbitrario (256 nell'articolo su CoCa) che genera una ricca rappresentazione 256 x 256 dell'immagine.
Questa rappresentazione viene passata alla parte superiore della configurazione di decoder disaccoppiata e, tramite interazione cross-modale con la rappresentazione testuale unimodale (ignorando la rappresentazione CLS), otteniamo una rappresentazione unificata immagine-testo che viene utilizzata per prevedere una distribuzione di probabilità del vocabolario tramite una fattorizzazione autoregressiva.
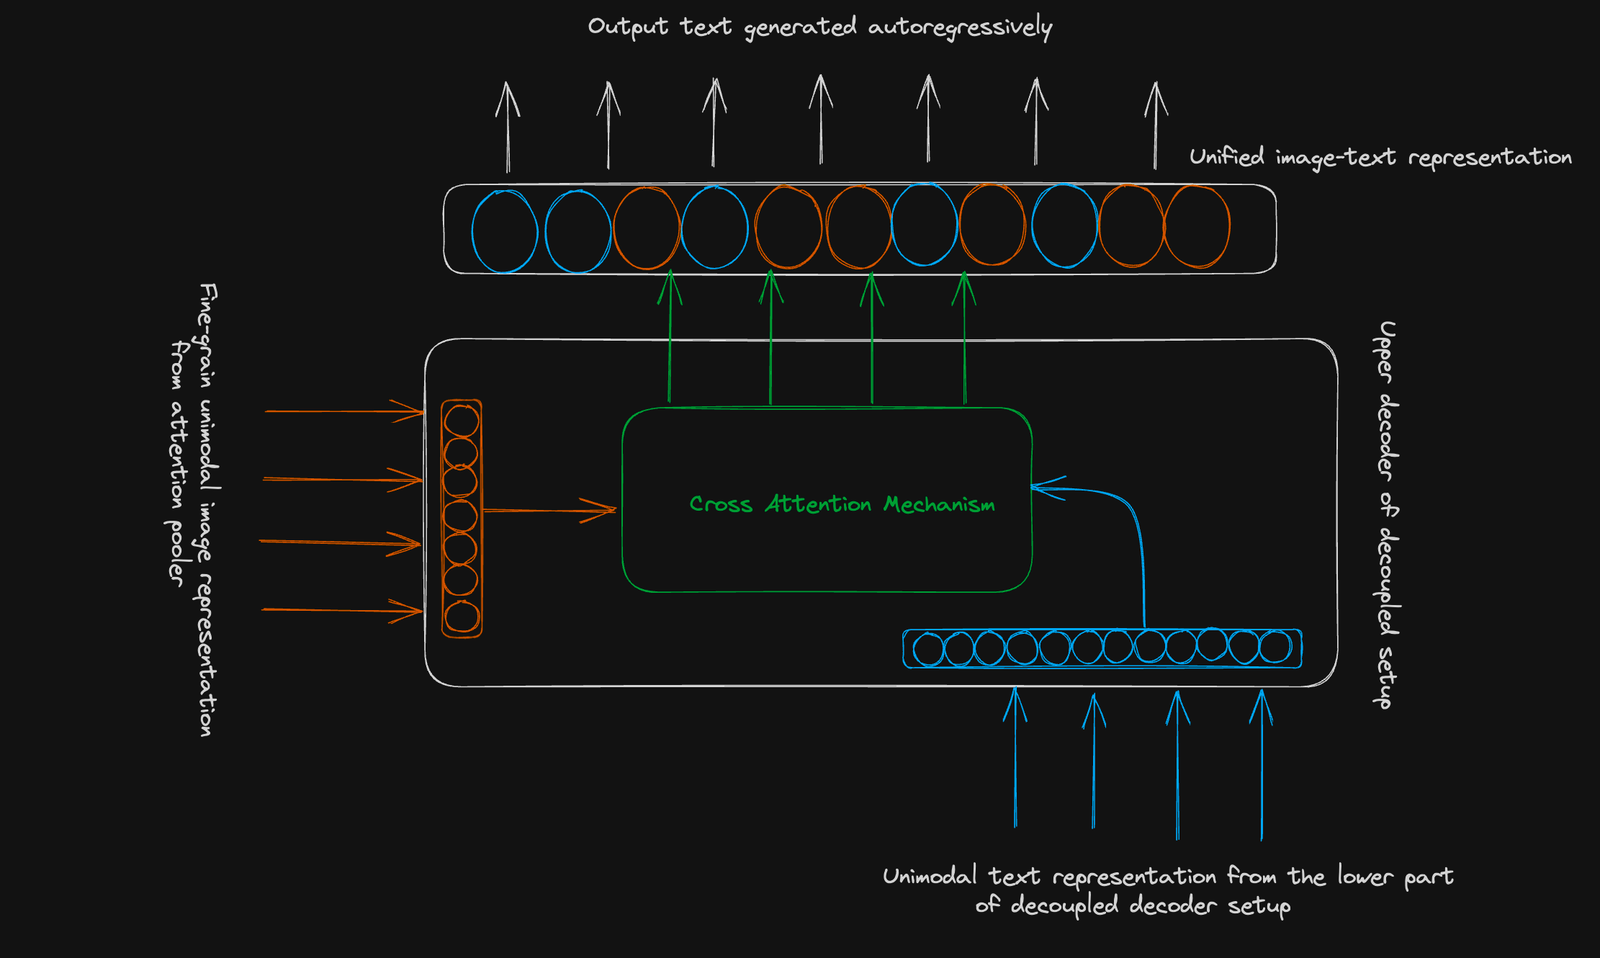
Come illustrato nelle due sezioni precedenti, la configurazione architetturale del modello CoCa consente di riunire le capacità di una classe di modelli che eccellono nei compiti di zero-shot learning come la classificazione di immagini e il retrieval cross-modale, e di un'altra classe di modelli che eccellono in VQA e image captioning. Il modello CoCa può anche essere perfezionato su diversi compiti a valle di visione e linguaggio.
L'avvento di foundation model come CoCa segna un passo significativo nel campo del machine learning. CoCa unisce i punti di forza di vari paradigmi, offrendo un modello unificato in grado sia di allineare le rappresentazioni di immagini e testi sia di generare rappresentazioni congiunte immagine-testo.
Questo modello è la prova del potenziale dell'integrazione di obiettivi contrastivi e generativi, aprendo la strada a prestazioni migliori in compiti come il Visual Question Answering e l'image captioning. Riunisce le capacità dei modelli che eccellono nei compiti di zero-shot learning e di quelli esperti nella comprensione multimodale immagine-testo, fornendo uno strumento versatile per numerosi compiti a valle di visione e linguaggio.
Per chi desidera approfondire concetti avanzati di machine learning ed esplorare le complessità del deep learning, il corso Advanced Deep Learning with Keras su DataCamp ti fornirà le conoscenze e le competenze per risolvere una varietà di problemi usando la versatile Keras Functional API, permettendoti di esplorare e comprendere più a fondo modelli avanzati come CoCa e i loro principi alla base.
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min