यह ट्यूटोरियल हमारे समुदाय का एक मूल्यवान योगदान है और स्पष्टता व सटीकता के लिए DataCamp द्वारा संपादित किया गया है।
अपनी विशेषज्ञता साझा करने में रुचि है? हम आपसे सुनना चाहेंगे! हमारे Community Contribution Form के माध्यम से अपने लेख या विचार निःसंकोच भेजें।
मशीन लर्निंग के विकास ने फाउंडेशन मॉडल्स के उदय का मार्ग प्रशस्त किया है—ऐसे मॉडल जो व्यापक डेटा पर पूर्व-प्रशिक्षित होते हैं और असंख्य अनुप्रयोगों के लिए बहुउद्देशीय आधार का कार्य करते हैं। NLP में GPT और BERT जैसे मॉडल्स ने ज़ीरो-शॉट और फ्यू-शॉट लर्निंग जैसे कार्यों में अभूतपूर्व क्षमताएँ दिखाईं हैं।
इस लेख में, हम इमेज-टेक्स्ट फाउंडेशन मॉडल्स के क्षेत्र में प्रवेश करेंगे और नवोन्मेषी Contrastive Captioner (CoCa) मॉडल का अन्वेषण करेंगे। हम इसकी संरचना को समझेंगे, इसके कॉन्ट्रास्टिव और जेनरेटिव उद्देश्यों के संयोजन वाले अनूठे दृष्टिकोण को जानेंगे, और देखेंगे कि यह कैसे CLIP और SIMVLM जैसे मॉडलों की क्षमताओं को एक एकीकृत, सुसंगत मॉडल में समाहित करता है।
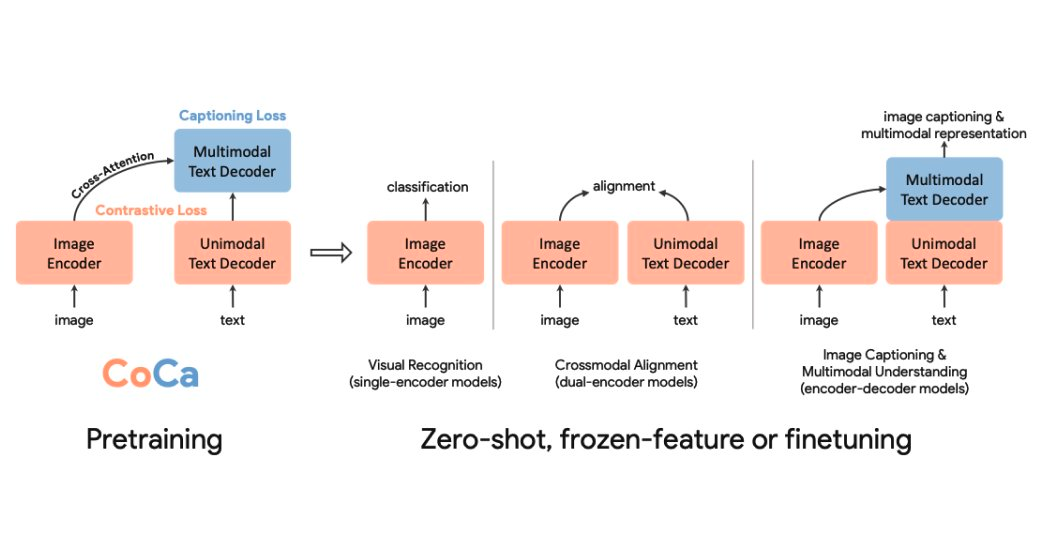
Fig-1 - Contrastive Captioner - (CoCa)
फाउंडेशन मॉडल्स का उभार
फाउंडेशन मॉडल्स का विचार मशीन लर्निंग में नया नहीं है। डीप लर्निंग में, इन मॉडलों को प्रशिक्षित करने की तकनीकें हमें भविष्य में डाउनस्ट्रीम कार्यों के लिए इन्हें अनुकूलित करने देती हैं। NLP में, GPT और BERT जैसे फाउंडेशन मॉडल्स, जो इंटरनेट-स्तरीय शोरयुक्त डेटा पर प्रशिक्षित हैं, ने उल्लेखनीय ज़ीरो-शॉट और फ्यू-शॉट क्षमताएँ प्रदर्शित की हैं।
विजन और विजन-भाषा फाउंडेशन मॉडल्स बनाने के शोध ने तीन मुख्य राहों का अन्वेषण किया है: सिंगल-एन्कोडर मॉडल्स, कॉन्ट्रास्टिव लॉस के साथ इमेज-टेक्स्ट डुअल-एन्कोडर मॉडल्स, और जेनरेटिव उद्देश्य वाले एन्कोडर-डीकोडर मॉडल्स। CoCa मॉडल देखने से पहले, आइए फाउंडेशन मॉडल्स बनाने की इन शोध-रेखाओं और उनकी कमियों पर नज़र डालें।
शब्दावली
- फाउंडेशन मॉडल्स। पूर्व-प्रशिक्षित मॉडल्स जो मशीन लर्निंग में विभिन्न अनुप्रयोगों के लिए प्रारंभिक बिंदु का कार्य करते हैं और विशिष्ट कार्यों हेतु अनुकूलनीय होते हैं।
- कॉन्ट्रास्टिव लॉस। ऐसा लॉस फ़ंक्शन जो मॉडलों को समान इनपुट युग्मों के लिए समान और असमान युग्मों के लिए असमान प्रतिनिधित्व सीखने के लिए प्रशिक्षित करता है।
- क्रॉस-मोडल इंटरैक्शन। अलग-अलग डेटा मोडैलिटी (जैसे, इमेज और टेक्स्ट) के बीच अंतःक्रिया ताकि एक संयुक्त प्रतिनिधित्व बनाया जा सके।
- एन्कोडर-डीकोडर आर्किटेक्चर। ऐसा न्यूरल नेटवर्क ढाँचा जिसमें एन्कोडर इनपुट डेटा को संसाधित करता है और डीकोडर आउटपुट उत्पन्न करता है; सीक्वेंस-टू-सीक्वेंस कार्यों में प्रयुक्त।
- कॉज़ल मास्किंग। ट्रांसफॉर्मर मॉडलों में एक तकनीक ताकि प्रशिक्षण के दौरान सीक्वेंस के भविष्य के टोकनों तक पहुँच को रोका जा सके।
- अटेंशन मैकेनिज़्म। ऐसा घटक जो सूचना संसाधित करते समय इनपुट के विभिन्न भागों को तौलने और प्राथमिकता देने देता है।
- ज़ीरो-शॉट लर्निंग। ऐसा शिक्षण ढांचा जिसमें मॉडल प्रशिक्षण के दौरान न देखी गई कक्षाओं के डेटा पर भी पूर्वानुमान या वर्गीकरण करते हैं।
- विज़ुअल क्वेश्चन आंसरिंग (VQA)। ऐसा कार्य जिसमें मॉडल छवियों की सामग्री से संबंधित प्रश्नों के उत्तर देते हैं, जहाँ कंप्यूटर विज़न और प्राकृतिक भाषा प्रसंस्करण का संयोजन होता है।
- यूनिमोडल और मल्टीमोडल रिप्रेजेंटेशन। यूनिमोडल प्रतिनिधित्व एक प्रकार की मोडैलिटी से सूचना ग्रहण करते हैं, जबकि मल्टीमोडल प्रतिनिधित्व अनेक मोडैलिटी से सूचना एकीकृत करते हैं।
- कॉन्ट्रास्टिव लैंग्वेज-इमेज प्री-ट्रेनिंग (CLIP)। ऐसा मॉडल जो इमेज और टेक्स्ट को साझा प्रतिनिधित्व स्पेस में संरेखित करने हेतु कॉन्ट्रास्टिव लर्निंग से प्रशिक्षित है।
सिंगल एन्कोडर मॉडल्स
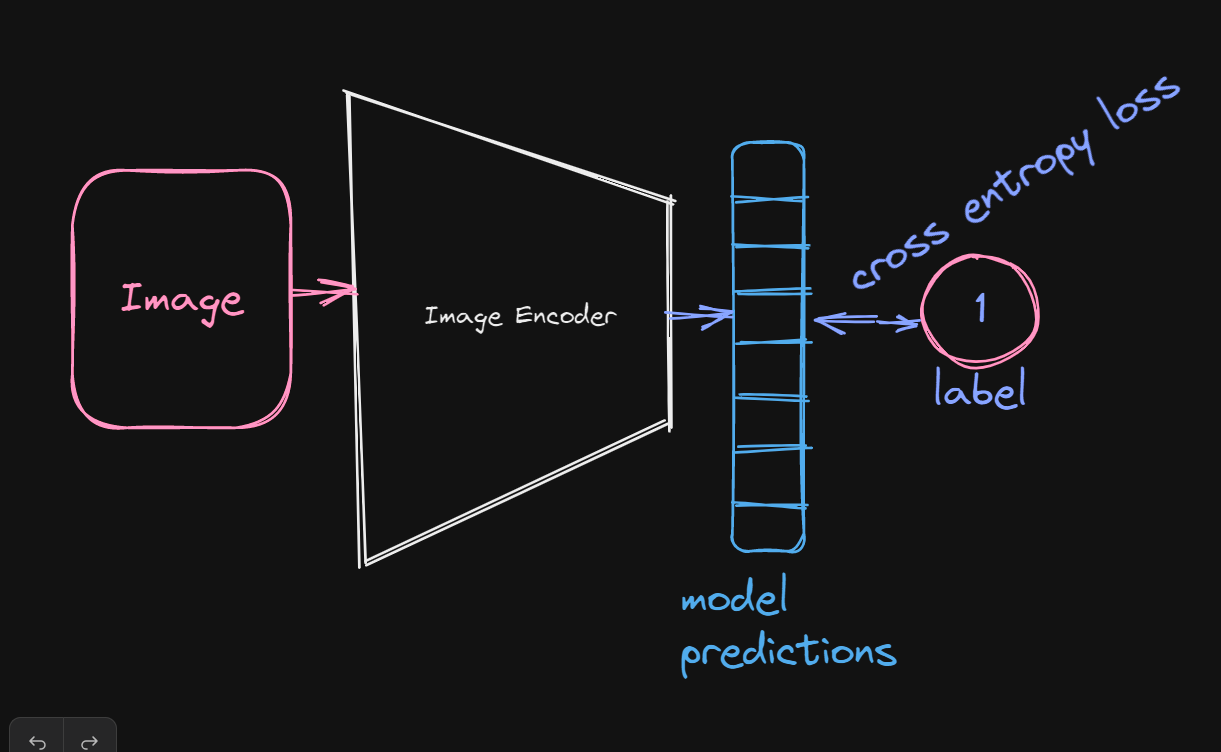
यदि आप पहले कंप्यूटर विज़न से जुड़े रहे हैं, तो संभव है कि आपने इस वर्ग के मॉडलों को देखा हो। ये मॉडल एनोटेटेड छवियों के बड़े डेटासेट पर क्रॉस-एंट्रॉपी लॉस के साथ प्रशिक्षण लेकर इमेज के प्रतिनिधित्व सीखते हैं, जिन्हें बाद में डाउनस्ट्रीम विज़न कार्यों के लिए अनुकूलित किया जा सकता है।
इन मॉडलों ने अनुभवजन्य रूप से डिटेक्शन जैसे विज़न-संबंधित कार्यों में उत्कृष्ट प्रदर्शन दिखाया है, परंतु विज़न-भाषा वाले कार्यों में ये अपेक्षाकृत कमजोर हैं क्योंकि ये मानव एनोटेशन पर भारी निर्भर रहते हैं, जिससे मानवीय प्राकृतिक भाषा इनमे समाहित नहीं हो पाती।
कॉन्ट्रास्टिव लॉस के साथ इमेज-टेक्स्ट डुअल-एन्कोडर मॉडल्स
विजन-भाषा फाउंडेशन मॉडलों के इस वर्ग के लोकप्रिय उदाहरणों में CLIP (Contrastive Language-Image Pre-training) और ALIGN शामिल हैं।
प्री-ट्रेनिंग के दौरान, हम कॉन्ट्रास्टिव लॉस का उपयोग करते हुए इमेज और भाषा मॉडल को संयुक्त रूप से प्रशिक्षित कर एक एलाइन्मेंट कार्य सीखते हैं।
उनके प्री-ट्रेनिंग उद्देश्य के पीछे का विचार सरल है: संबंधित इमेज-टेक्स्ट युग्मों के प्रतिनिधित्वों को एक साथ क्लस्टर करना और असंबंधित इमेज व टेक्स्ट (युग्म नहीं) के प्रतिनिधित्वों को उसी लेटेंट स्पेस में एक-दूसरे से दूर धकेलना। परिणामी डुअल-एन्कोडर मॉडल को तब ज़ीरो-शॉट वर्गीकरण और इमेज रिट्रीवल जैसे कार्यों के लिए सेटअप किया जा सकता है।
इस वर्ग के हालिया मॉडल्स, जैसे CLIP, ने विभिन्न विज़न-भाषा कार्यों पर उल्लेखनीय प्रदर्शन दिखाया है, लेकिन उन कार्यों में इनका उपयोग लगभग असंभव है जिनमें इमेज और टेक्स्ट के फ्यूज़्ड प्रतिनिधित्व की आवश्यकता होती है, जैसे VQA, क्योंकि हम केवल इमेज और टेक्स्ट के प्रतिनिधित्वों को संरेखित करना सीखते हैं, कोई ऐसा एकीकृत प्रतिनिधित्व नहीं बनता जो दोनों इनपुट्स की जानकारी एन्कोड करे।
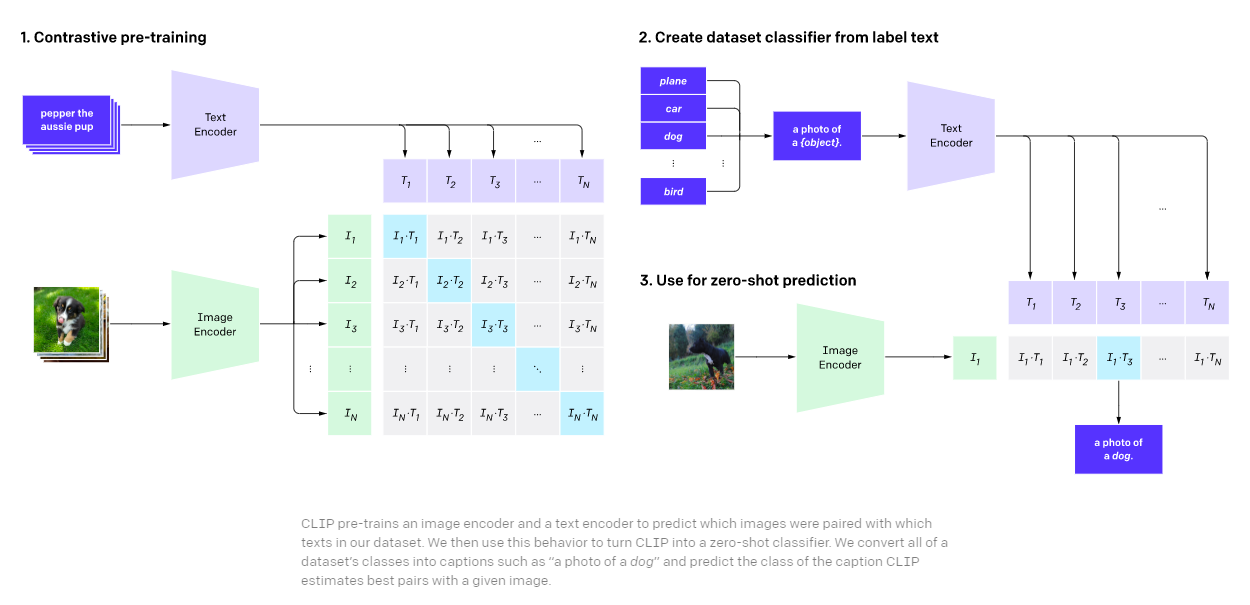
Fig-3 - Contrastive Language-Image Pre-training (CLIP)
एन्कोडर-डीकोडर आर्किटेक्चर के साथ जेनरेटिव प्री-ट्रेनिंग
ये मॉडल इमेज और टेक्स्ट के हिडन प्रतिनिधित्वों के बीच क्रॉस-मोडल इंटरैक्शन का उपयोग कर एक संयुक्त प्रतिनिधित्व बनाते हैं।
प्री-ट्रेनिंग के दौरान, हम हिडन टेक्स्ट प्रतिनिधित्व और इमेज एन्कोडर के आउटपुट के बीच क्रॉस-मोडल इंटरैक्शन के माध्यम से इमेज और टेक्स्ट का एकीकृत प्रतिनिधित्व उत्पन्न करते हैं और डीकोडर आउटपुट पर लैंग्वेज मॉडलिंग लॉस लागू करते हैं।
हाल की मशीन लर्निंग आर्किटेक्चर में, क्रॉस-मोडल इंटरैक्शन प्रायः ट्रांसफॉर्मर्स में क्रॉस-अटेंशन मैकेनिज़्म के माध्यम से किया जाता है, जहाँ इमेज एन्कोडर के आउटपुट को क्वेरी और हिडन टेक्स्ट प्रतिनिधित्व को की तथा वैल्यू के रूप में लिया जाता है।
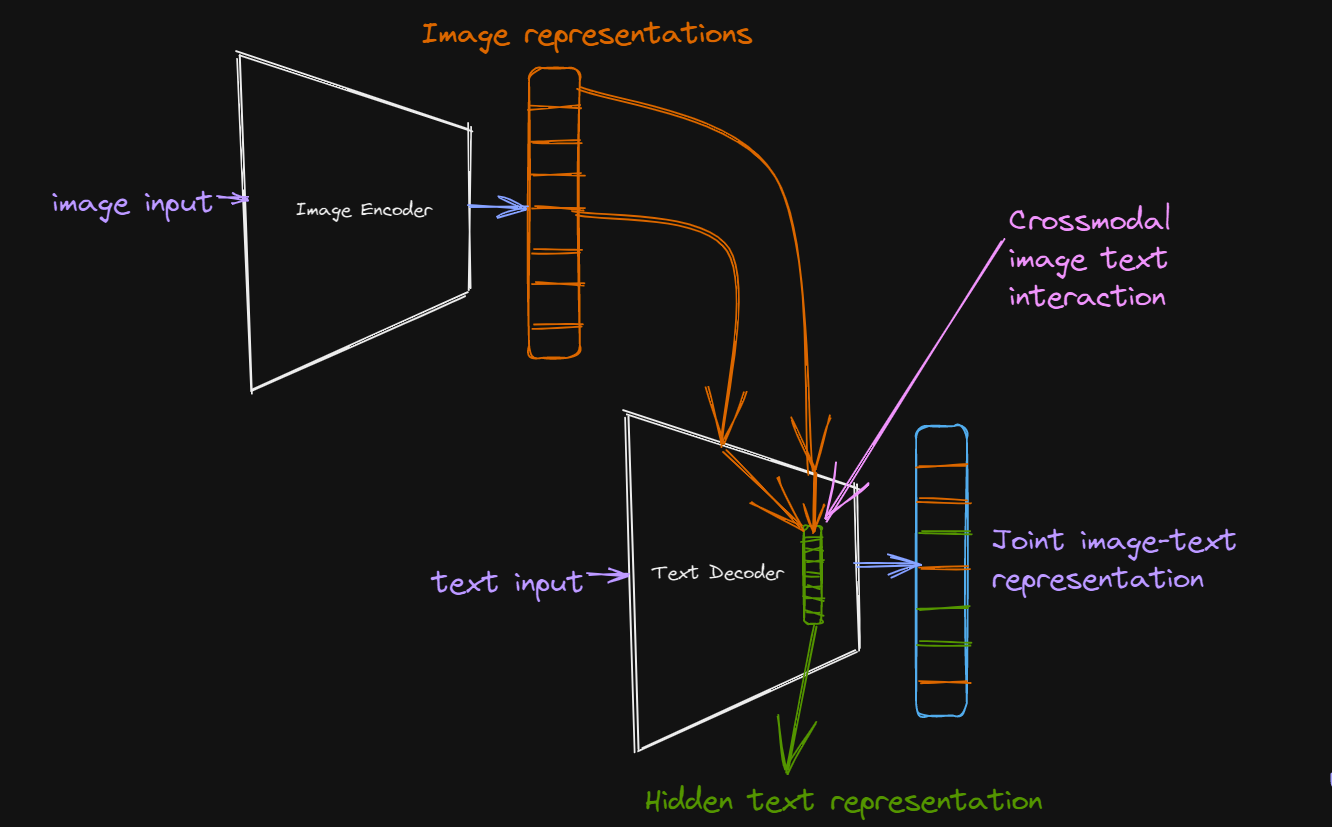
डाउनस्ट्रीम कार्यों के लिए, हम डीकोडर आउटपुट, जो इमेज और टेक्स्ट का संयुक्त प्रतिनिधित्व है, का उपयोग कर विभिन्न मल्टीमोडल इमेज-टेक्स्ट समझ कार्य कर सकते हैं, जैसे विज़ुअल क्वेश्चन आंसरिंग। इस प्रतिमान का एक हालिया मॉडल Simple Visual Language Model (SIMVLM) है.
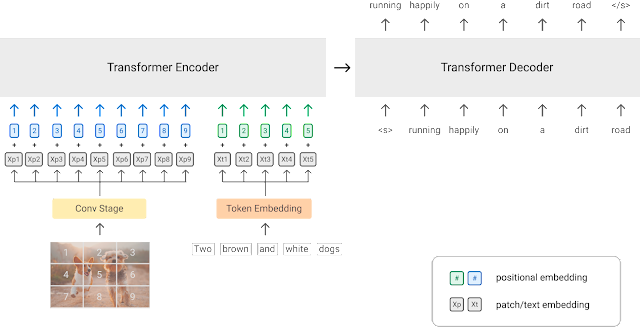
Fig-5 - Simple Visual Language Model (SIMVLM)
CoCa के पीछे की प्रेरणा
CoCa मॉडल के लेखकों का लक्ष्य इमेज-टेक्स्ट फाउंडेशन मॉडल्स बनाने की भिन्न-भिन्न प्रतिमानों की क्षमताओं को एक सरल मॉडल में समाहित करना था। CoCa का डिज़ाइन एक कॉन्ट्रास्टिव लॉस का उपयोग करता है ताकि इमेज और टेक्स्ट के प्रतिनिधित्वों को एक ही वेक्टर स्पेस में संरेखित करना सीखा जा सके, और एक जेनरेटिव उद्देश्य (कैप्शनिंग लॉस) का उपयोग कर संयुक्त इमेज-टेक्स्ट प्रतिनिधित्व सीखा जा सके—इस प्रकार CLIP और SIMVLM जैसे मॉडलों की क्षमताओं को एक ही मॉडल में एम्बेड करता है।
मॉडल आर्किटेक्चर
CoCa मानक एन्कोडर-डीकोडर दृष्टिकोण अपनाता है और, इस प्रकार के अधिकांश मॉडलों की तरह, इमेज को एक न्यूरल नेटवर्क जैसे कन्वोल्यूशनल न्यूरल नेटवर्क या ट्रांसफॉर्मर से एन्कोड करता है।
CoCa आर्किटेक्चर की विशिष्टता उसके एन्कोडर के आउटपुट और संपूर्ण डीकोडर सेटअप से शुरू होती है।
स्मरण करें कि CoCa पेपर का उद्देश्य विज़न-भाषा मॉडलों के दो प्रतिमानों (कॉन्ट्रास्टिव और जेनरेटिव उद्देश्य) की क्षमताओं को एक ही मॉडल में संयोजित करना है। कॉन्ट्रास्टिव उद्देश्य के प्रतिमान में आवश्यक है कि हमारा टेक्स्ट डीकोडर एक यूनिमोडल टेक्स्ट प्रतिनिधित्व दे, जिसे फिर इमेज प्रतिनिधित्व के समान वेक्टर स्पेस में प्रोजेक्ट किया जाता है ताकि एलाइन्मेंट कार्य सीखा जा सके।
दूसरी ओर, जेनरेटिव उद्देश्य डीकोडर को एन्कोडर से इमेज प्रतिनिधरण लेने और इमेज प्रतिनिधरणों व टेक्स्ट इनपुट पर सशर्त होकर ऑटो-रेग्रेसिव ढंग से टेक्स्ट उत्पन्न करने देता है।
ध्यान दें कि दोनों डीकोडर भाग प्री-अगले टोकनों को देखने से मॉडल को रोकने के लिए अपनी अटेंशन मैप्स पर कॉज़ल मास्किंग लागू करते हैं।
इसे साधने के लिए, लेखकों ने चतुराई से एक डीकपल्ड डीकोडर सेटअप अपनाया—पहला भाग जो कॉन्ट्रास्टिव उद्देश्य हेतु यूनिमोडल टेक्स्ट प्रतिनिधित्व बनाना सीखता है, और दूसरा भाग जो मल्टीमोडल इमेज-टेक्स्ट प्रतिनिधित्व बनाना सीखता है।
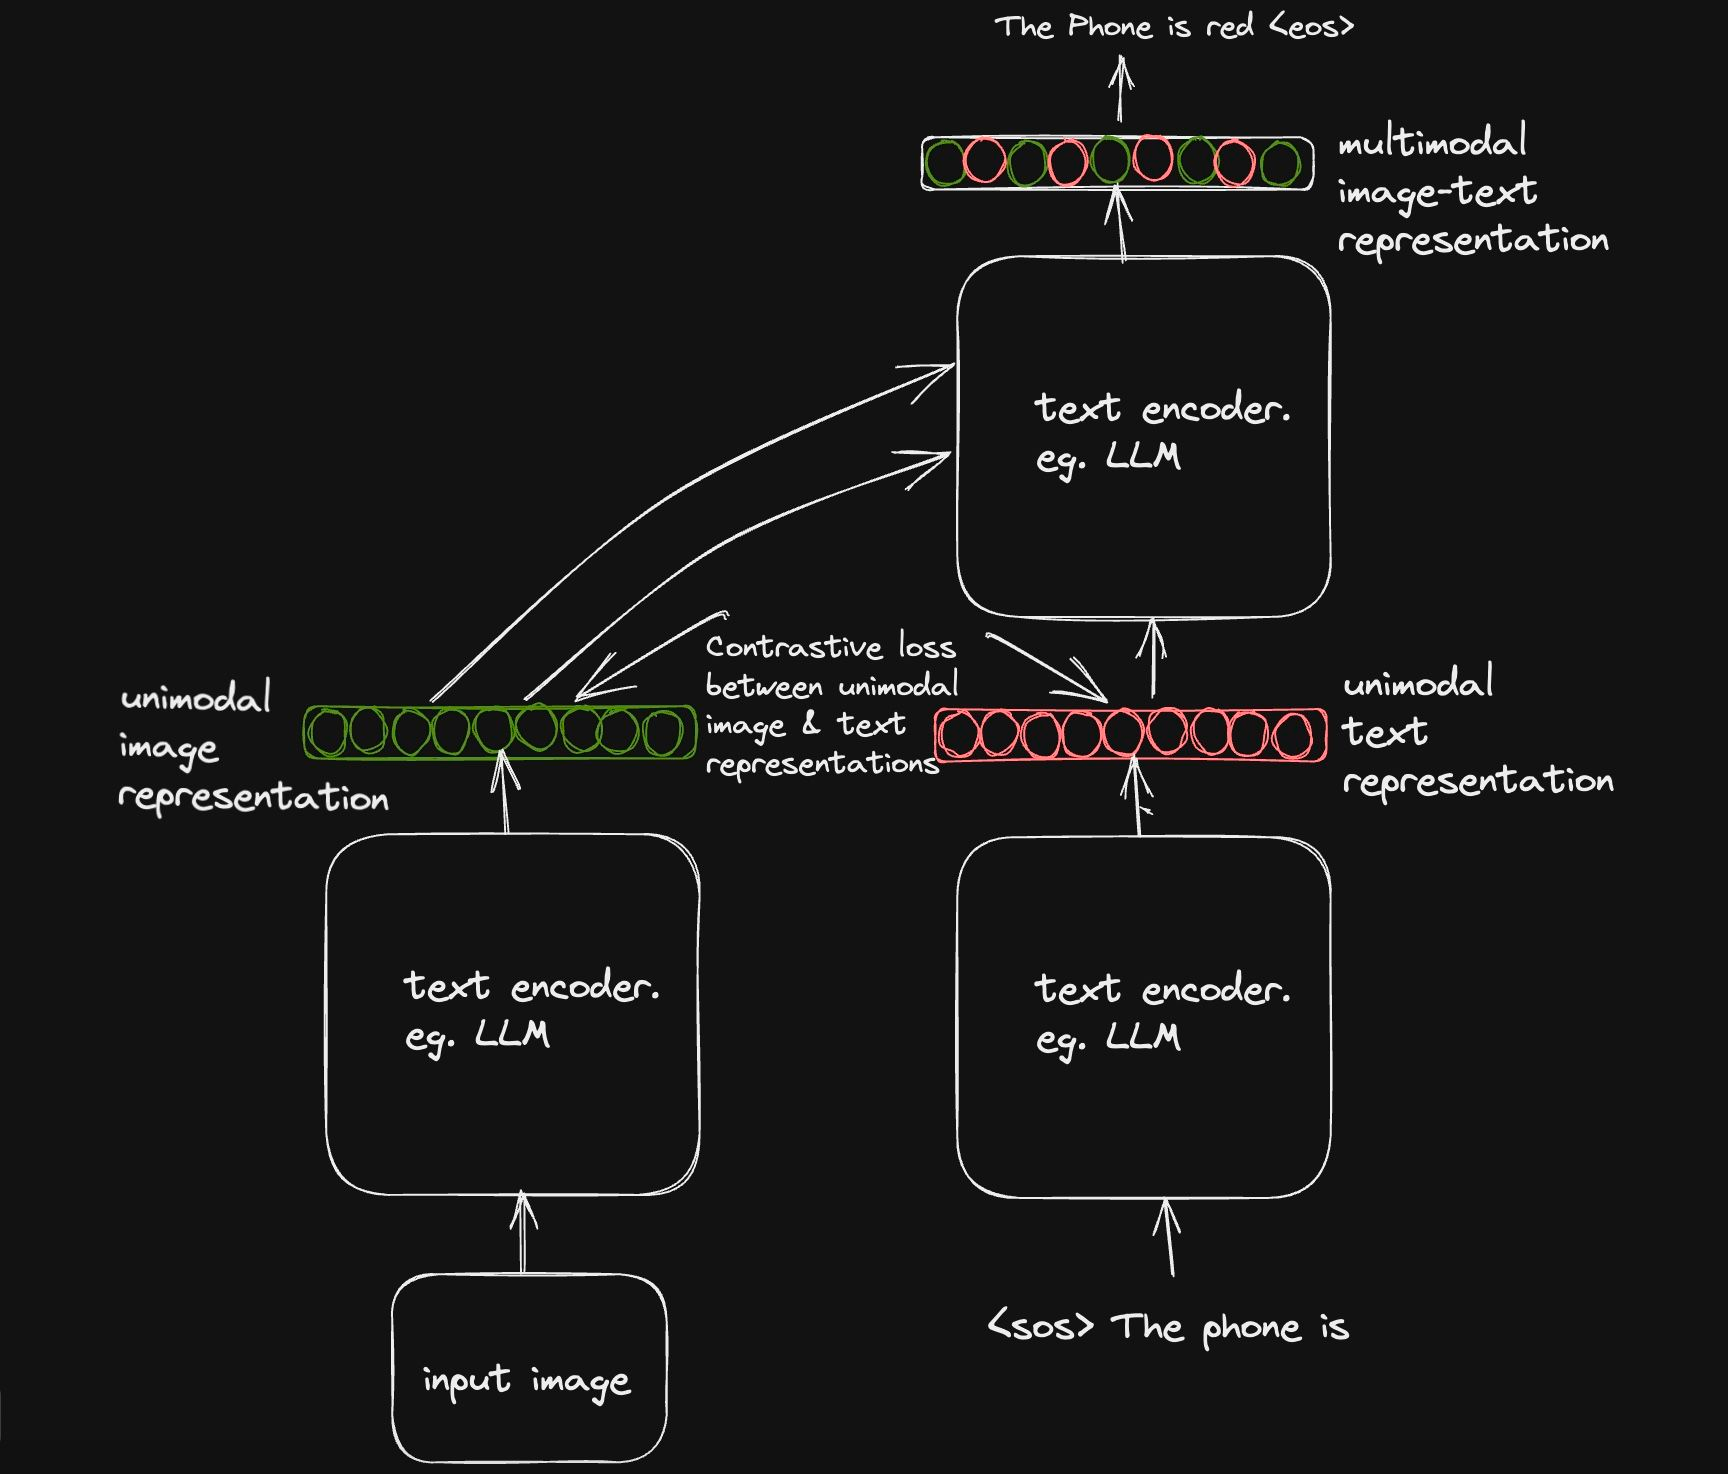
कॉन्ट्रास्टिव उद्देश्य
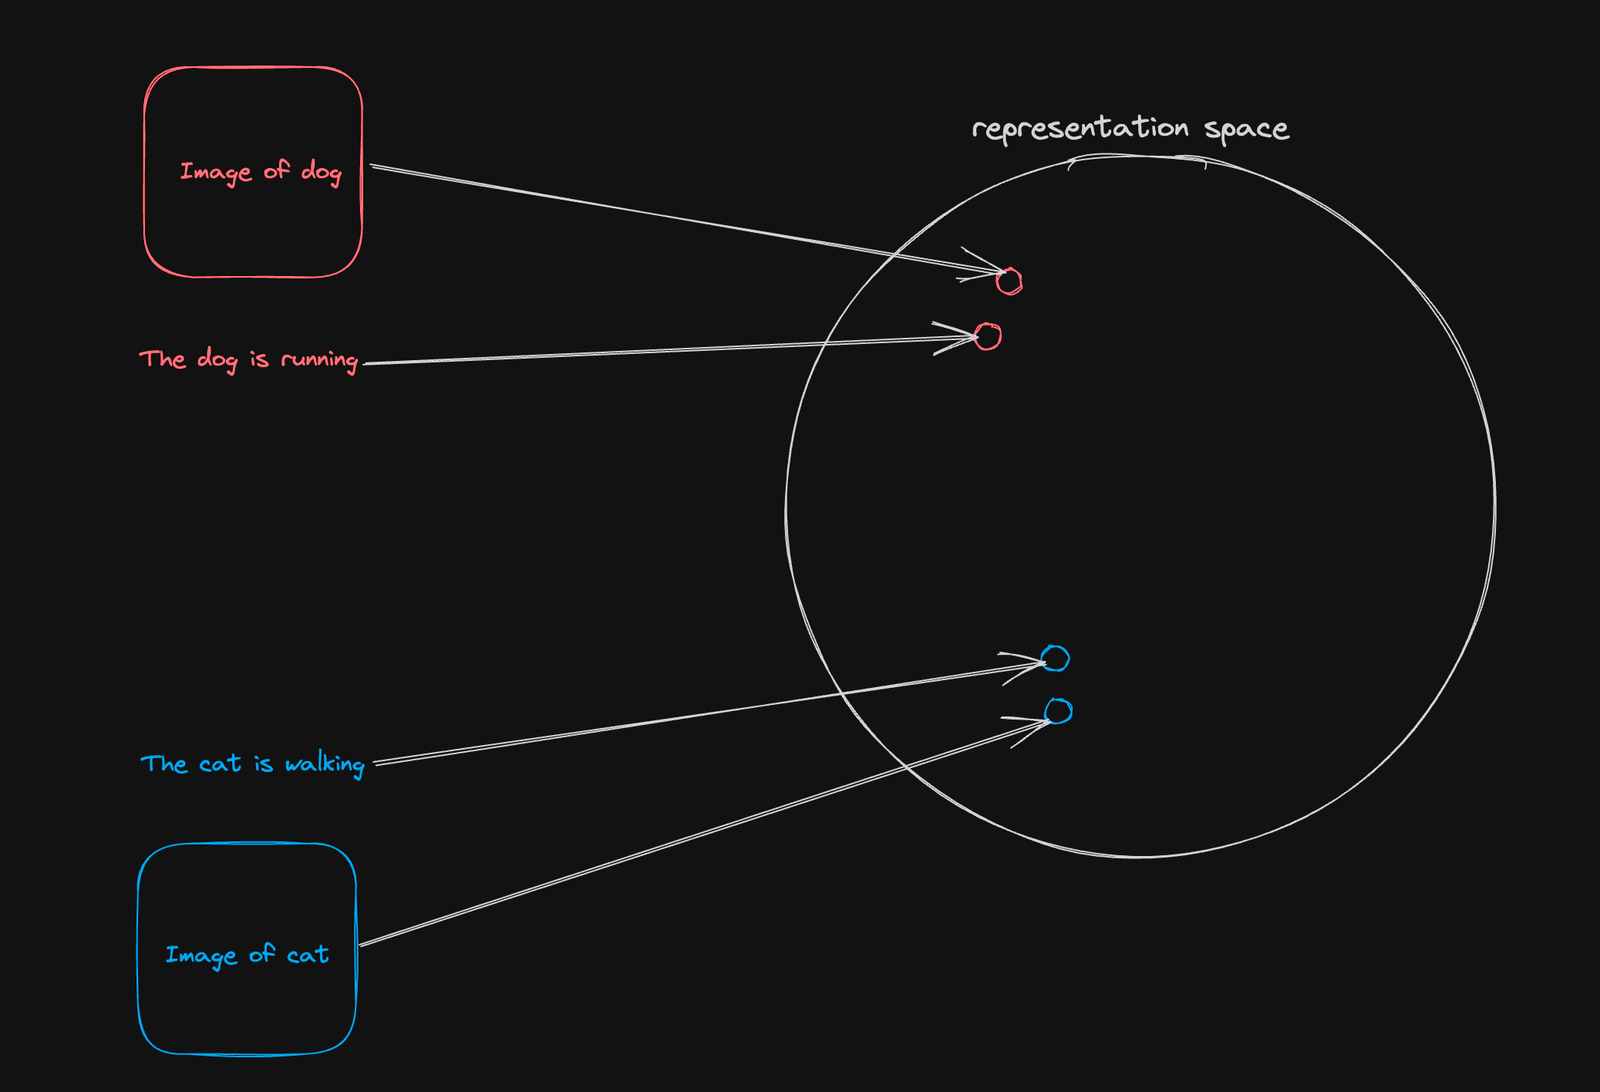
कई मॉडलों—जैसे CLIP और ALIGN—में प्रयुक्त कॉन्ट्रास्टिव उद्देश्य के पीछे का विचार काफी सरल है। लक्ष्य यह है कि अलग-अलग मोडैलिटी (इमेज और टेक्स्ट) के लिए ऐसे प्रतिनिधित्व सीखे जाएँ कि मिलते-जुलते युग्म प्रतिनिधित्व स्पेस में पास हों और असमान युग्म दूर।
प्रशिक्षण के हर चरण में, हम डेटासेट से इमेज-टेक्स्ट युग्मों का सैंपल लेते हैं और अपने एन्कोडर्स के वेट्स को इस तरह अद्यतन करते हैं कि युग्म एक साथ क्लस्टर हों और गैर-युग्म अलग धकेले जाएँ।
जैसा पहले बताया गया, कॉन्ट्रास्टिव उद्देश्य के लिए इमेज और टेक्स्ट—दोनों मोडैलिटी के यूनिमोडल प्रतिनिधित्वों की आवश्यकता होती है। टेक्स्ट एन्कोडर पक्ष पर इसे साधने के लिए, हम BERT भाषा मॉडल में प्रयुक्त एक क्लासिक तकनीक लागू करते हैं।
इनपुट सीक्वेंस के हिस्से के रूप में, हम इनपुट सीक्वेंस के अंत में एक लर्नेबल क्लासिफिकेशन टोकन [CLS] जोड़ते हैं और अपेक्षा करते हैं कि इस टोकन से संबद्ध आउटपुट वेक्टर पूरे इनपुट सीक्वेंस के सांकेतिक अर्थ को समेट लेगा।
क्योंकि हमारे डीकोडर्स अपनी अटेंशन मैप्स पर कॉज़ल मास्किंग लगाते हैं, इसलिए सीक्वेंस के अंत में क्लासिफिकेशन टोकन जोड़ने से यह सुनिश्चित होता है कि क्लासिफिकेशन टोकन और इनपुट सीक्वेंस के अन्य सभी टोकनों के बीच अटेंशन कनेक्शन हो—फलस्वरूप पूरे वाक्य के अर्थ को पकड़ा जा सके।
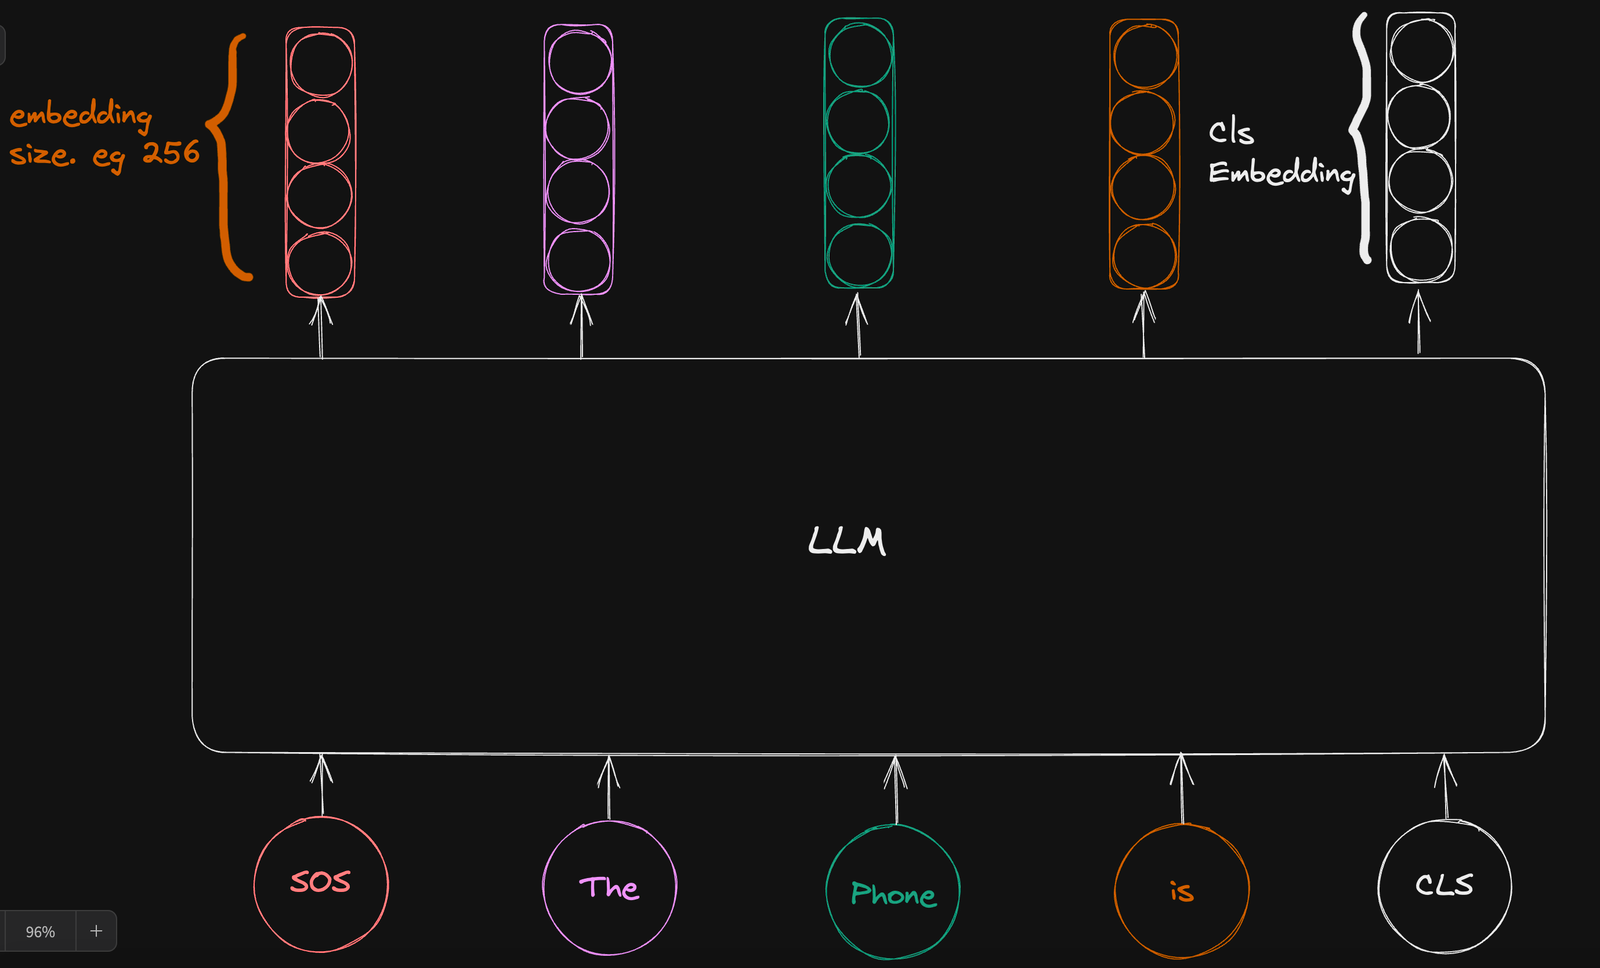
हम अन्य इनपुट टोकनों के वेक्टर प्रतिनिधित्वों को अनदेखा करते हैं और कॉन्ट्रास्टिव लॉस का अनुमान लगाने के लिए क्लासिफिकेशन टोकन के वेक्टर प्रतिनिधित्व का उपयोग करते हैं।
इमेज एन्कोडर पक्ष पर चीज़ें थोड़ी अलग हैं।
Fig-6 की छवि में, आप देख सकते हैं कि इमेज एन्कोडर के आउटपुट का एक भाग क्लासिफिकेशन टोकन एम्बेडिंग के साथ मिलकर कॉन्ट्रास्टिव लॉस के अनुमान के लिए प्रयुक्त होता है, और इसका एक भाग डीकपल्ड सेटअप के ऊपरी हिस्से में संयुक्त प्रतिनिधित्व के अनुमान के लिए भेजा जाता है।
वास्तव में, कॉन्ट्रास्टिव उद्देश्य का अनुमान लगाने के लिए इमेज का केवल एक सिंगल एम्बेडिंग आउटपुट पर्याप्त है, जबकि जेनरेटिव उद्देश्य हेतु इमेज एन्कोडर के एम्बेडिंग आउटपुट का पूरा सीक्वेंस प्रयुक्त होता है।
लेखकों का तर्क है कि उन्होंने अनुभवजन्य रूप से पाया कि एक सिंगल पूल्ड एम्बेडिंग आउटपुट इमेज के वैश्विक प्रतिनिधित्व को पकड़ने में मदद करता है (जो कि ठीक वही है जिसकी हमें कॉन्ट्रास्टिव उद्देश्य के लिए चाहत है), और एम्बेडिंग आउटपुट्स का एक सीक्वेंस उन कार्यों में मदद करता है जिनमें इमेज का अधिक सूक्ष्म-स्तरीय प्रतिनिधित्व चाहिए।
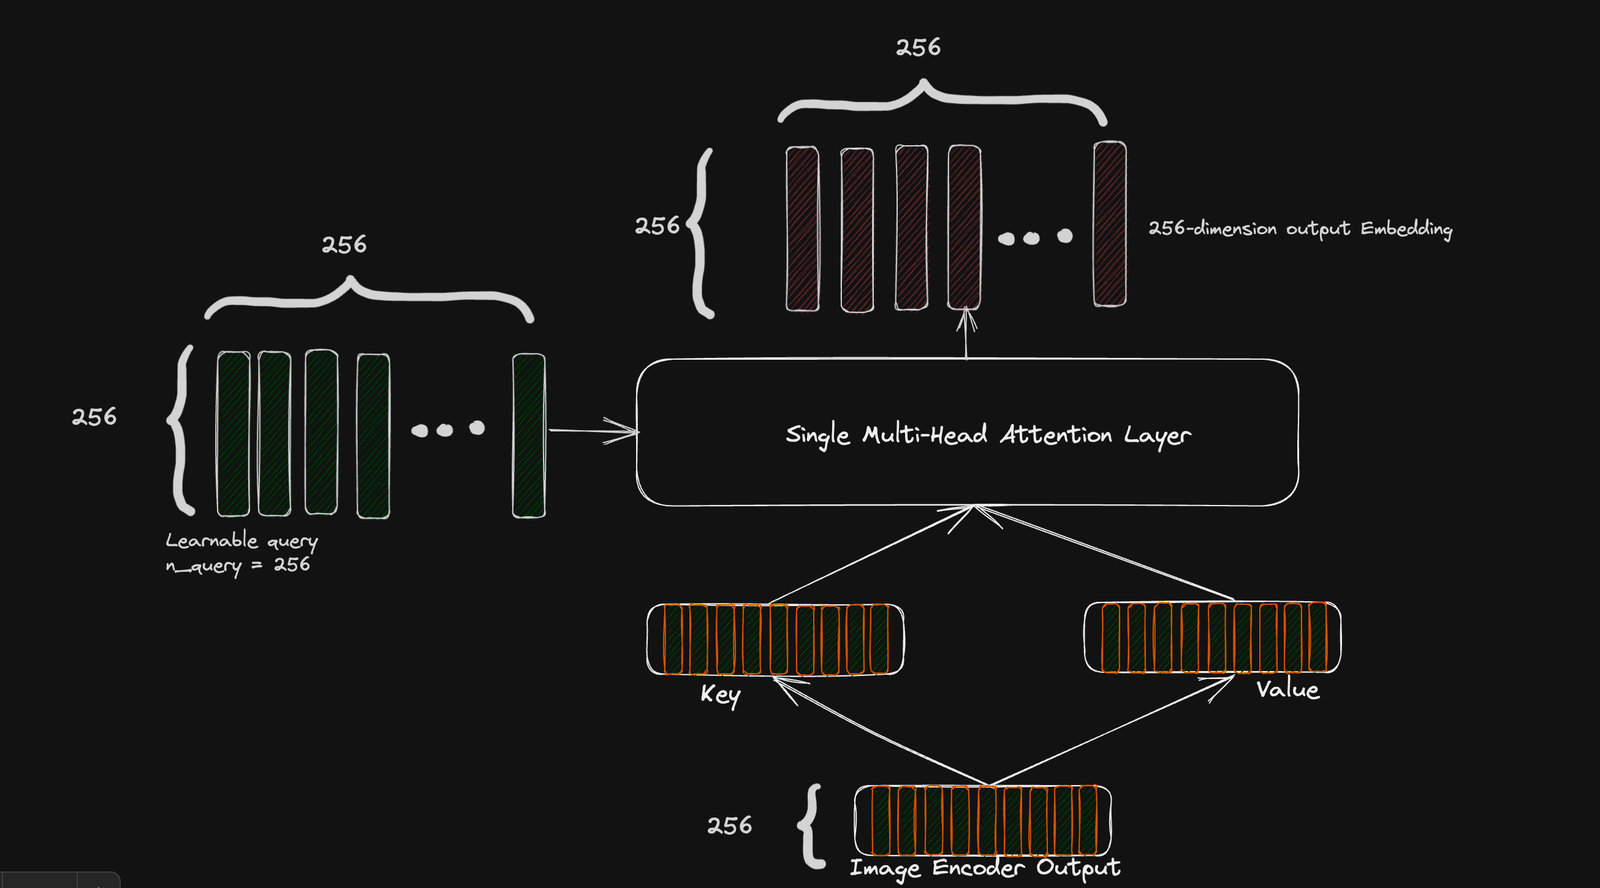
इसे साधने के लिए, एक अटेंशनल पूलिंग लेयर—जो एक सिंगल मल्टी-हेड अटेंशन लेयर है—का उपयोग किया जाता है, जो एक लर्नेबल क्वेरी पैरामीटर के माध्यम से अलग-अलग उद्देश्यों हेतु इमेज एन्कोडर आउटपुट को अनुकूलित करती है। क्वेरी पैरामीटर को एक विशिष्ट पूर्णांक मान पर सेट कर, हम अपने संपूर्ण एन्कोडर सेटअप को ऐसे एम्बेडिंग सीक्वेंस आउटपुट करने के लिए अनुकूलित कर सकते हैं जिसकी लंबाई वही क्वेरी पैरामीटर हो।
कॉन्ट्रास्टिव उद्देश्य के मामले में, हम क्वेरी पैरामीटर को 1 पर सेट करते हैं ताकि सिर्फ एक एम्बेडिंग प्राप्त हो और कॉन्ट्रास्टिव लॉस निकाला जा सके, और जेनरेटिव उद्देश्य के मामले में, इसे एक मनचाहे मान पर सेट करते हैं, जो आदर्शतः हमारे टेक्स्ट के सीक्वेंस की लंबाई के बराबर होता है। CoCa पेपर में, लेखकों ने जेनरेटिव उद्देश्य के लिए 256 चुना।
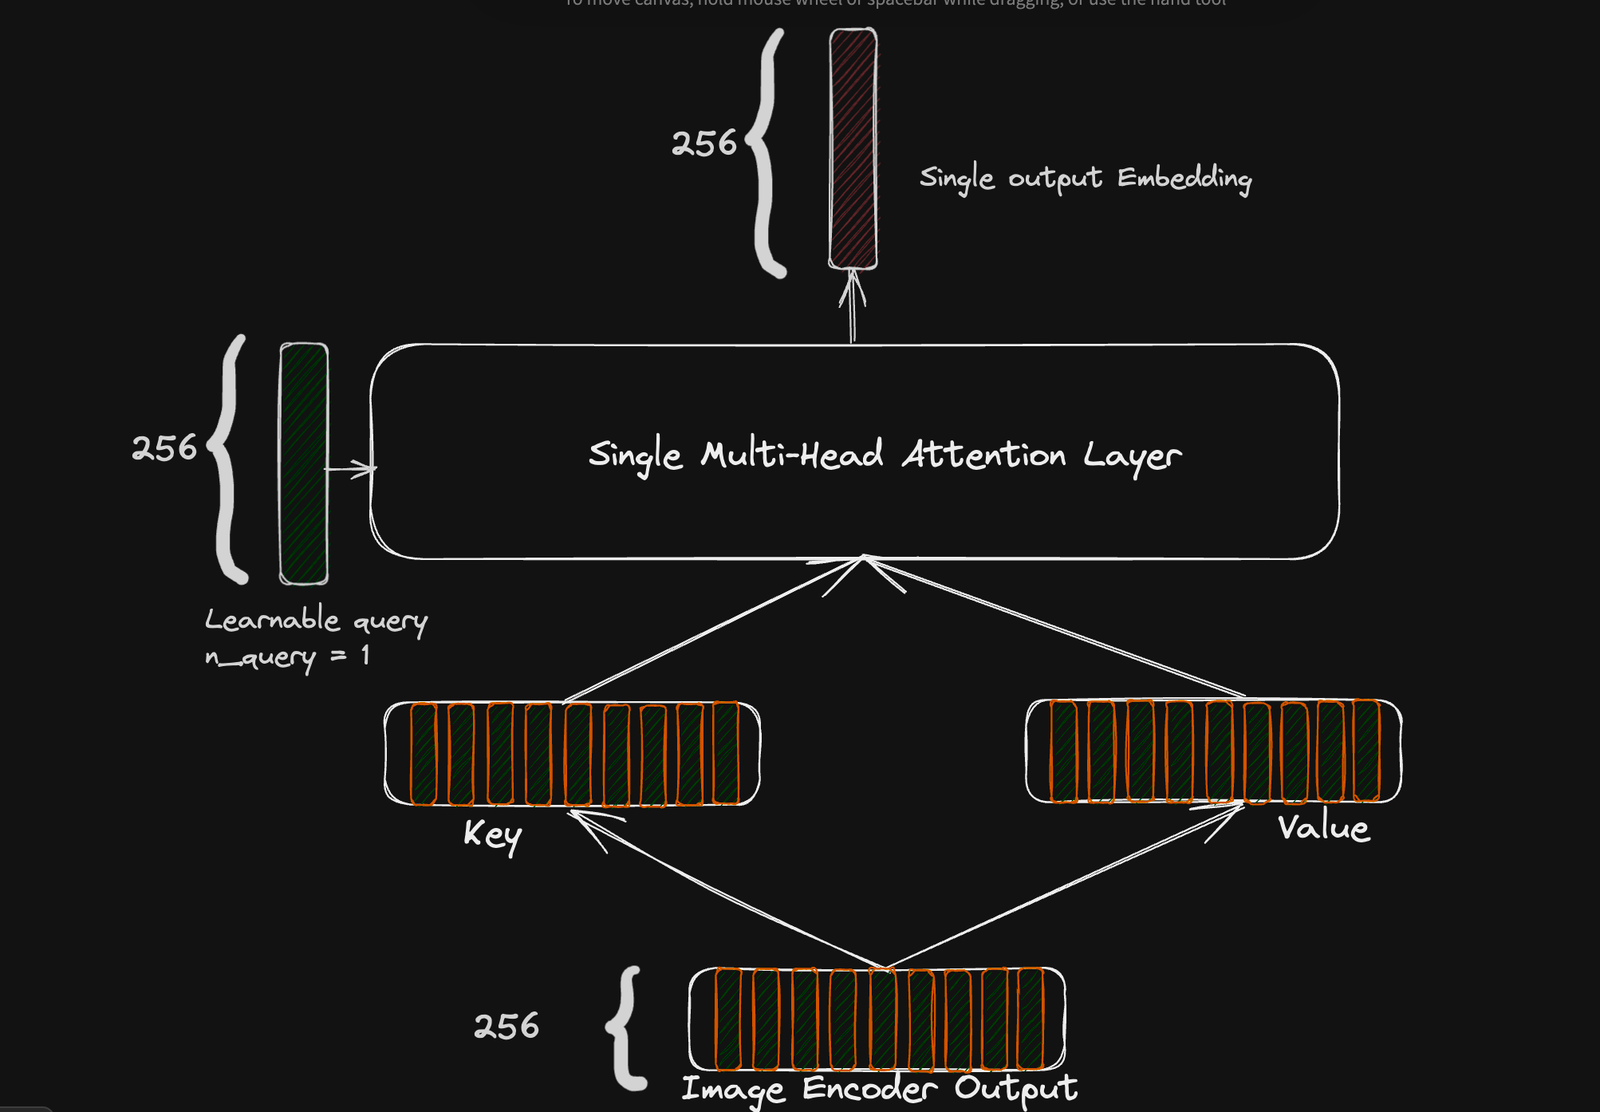
कॉन्ट्रास्टिव लॉस के लिए अटेंशन पूलिंग सेटअप। अटेंशन लेयर का आउटपुट एक एकल 256-डायमेंशन एम्बेडिंग है।
जेनरेटिव उद्देश्य
कॉन्ट्रास्टिव उद्देश्य, जिसे केवल इमेज के वैश्विक प्रतिनिधित्व की आवश्यकता होती है, के विपरीत, जेनरेटिव उद्देश्य तब अधिक प्रभावी होता है जब हम इमेज का अधिक सूक्ष्म-स्तरीय प्रतिनिधित्व उत्पन्न करते हैं।
जैसा पहले समझाया गया, हम क्वेरी पैरामीटर को एक मनचाही संख्या (CoCa पेपर में 256) पर सेट कर सूक्ष्म-स्तरीय इमेज प्रतिनिधित्व पाते हैं, जो इमेज का 256 x 256 समृद्ध प्रतिनिधित्व बनाता है।
यह प्रतिनिधरण डीकपल्ड डीकोडर सेटअप के ऊपरी हिस्से में जाता है, और यूनिमोडल टेक्स्ट प्रतिनिधरण (CLS प्रतिनिधरण को अनदेखा करते हुए) के साथ क्रॉस-मोडल इंटरैक्शन के ज़रिए हमें एक एकीकृत इमेज-टेक्स्ट प्रतिनिधरण मिलता है, जिसका उपयोग ऑटोरेग्रेसन फैक्टराइजेशन के माध्यम से शब्दावली की प्रायिकता वितरण की भविष्यवाणी के लिए किया जाता है।
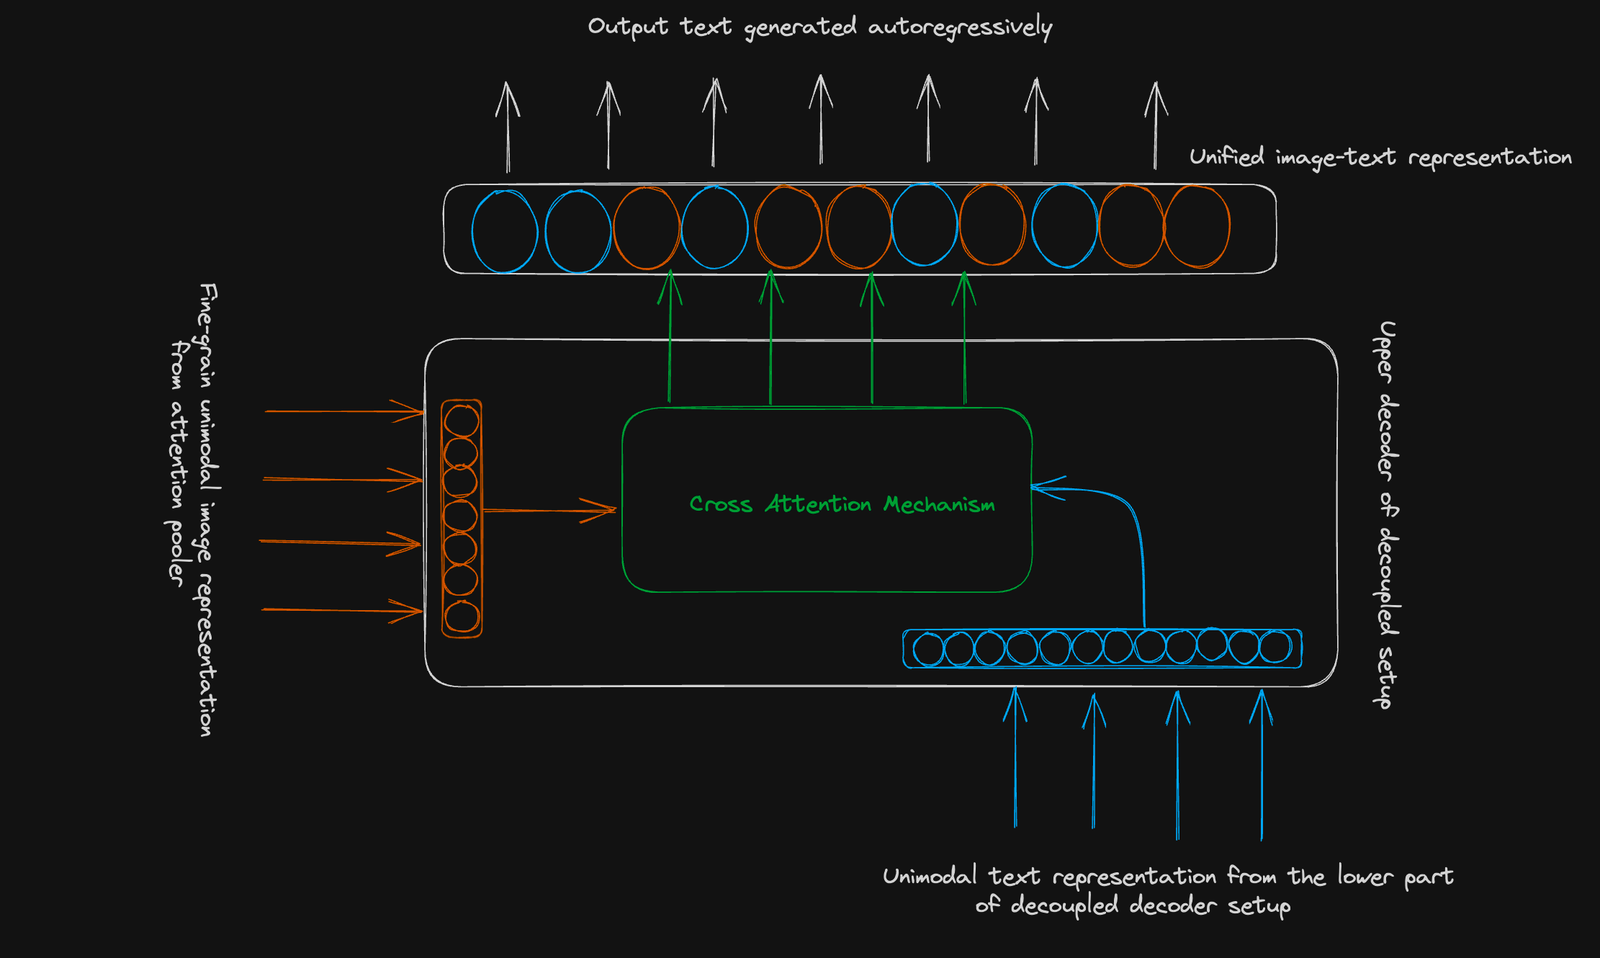
जैसा कि इस लेख के पिछले दो खंडों में दर्शाया गया है, CoCa मॉडल की आर्किटेक्चरल संरचना उन मॉडलों की क्षमताओं को समाहित करने देती है जो इमेज वर्गीकरण और क्रॉस-मोडल रिट्रीवल जैसे ज़ीरो-शॉट लर्निंग कार्यों में उत्कृष्ट हैं, और उन मॉडलों की भी जो VQA और इमेज कैप्शनिंग में श्रेष्ठ हैं। CoCa मॉडल को कई डाउनस्ट्रीम विज़न और भाषा कार्यों पर फाइन-ट्यून भी किया जा सकता है।
अंतिम विचार
CoCa जैसे फाउंडेशन मॉडल्स का आगमन मशीन लर्निंग के क्षेत्र में एक महत्वपूर्ण कदम है। CoCa विभिन्न प्रतिमानों की ताकतों को जोड़ता है—एक ऐसा एकीकृत मॉडल प्रस्तुत करता है जो इमेज और टेक्स्ट प्रतिनिधरणों को संरेखित कर सकता है और संयुक्त इमेज-टेक्स्ट प्रतिनिधरण उत्पन्न कर सकता है।
यह मॉडल कॉन्ट्रास्टिव और जेनरेटिव उद्देश्यों के एकीकरण की संभावनाओं का प्रमाण है, जो विज़ुअल क्वेश्चन आंसरिंग और इमेज कैप्शनिंग जैसे कार्यों में बेहतर प्रदर्शन का मार्ग प्रशस्त करता है। यह ज़ीरो-शॉट लर्निंग कार्यों में उत्कृष्ट मॉडलों और मल्टीमोडल इमेज-टेक्स्ट समझ में दक्ष मॉडलों—दोनों की क्षमताओं को समाहित करता है, और अनेक डाउनस्ट्रीम विज़न व भाषा कार्यों के लिए एक बहुमुखी उपकरण प्रदान करता है।
जो लोग मशीन लर्निंग की उन्नत अवधारणाओं में गहराई से उतरना और डीप लर्निंग की बारीकियों का अन्वेषण करना चाहते हैं, उनके लिए DataCamp का Advanced Deep Learning with Keras Course आपको बहुमुखी Keras फंक्शनल API का उपयोग कर विभिन्न समस्याएँ हल करने का ज्ञान और कौशल देगा, जिससे आप CoCa जैसे उन्नत मॉडलों और उनके अंतर्निहित सिद्धांतों को अधिक गहराई से समझ और परख सकेंगे।