本教程由我们的社区成员贡献,已由 DataCamp 为确保清晰与准确进行编辑。
想分享您的专业见解吗?我们非常期待!欢迎通过我们的社区投稿表单提交文章或想法。
机器学习的发展催生了基础模型——这是一类在海量数据上进行预训练的模型,可作为多种应用的通用基座。在自然语言处理(NLP)领域,以 GPT 和 BERT 为代表的模型在零样本与小样本学习等任务上展现了前所未有的能力。
本文将深入图文基础模型领域,探索创新的对比式描述器(CoCa)模型。我们将拆解其架构,理解其结合对比与生成目标的独特方法,并了解它如何将 CLIP 与 SIMVLM 等模型的能力融于一体。
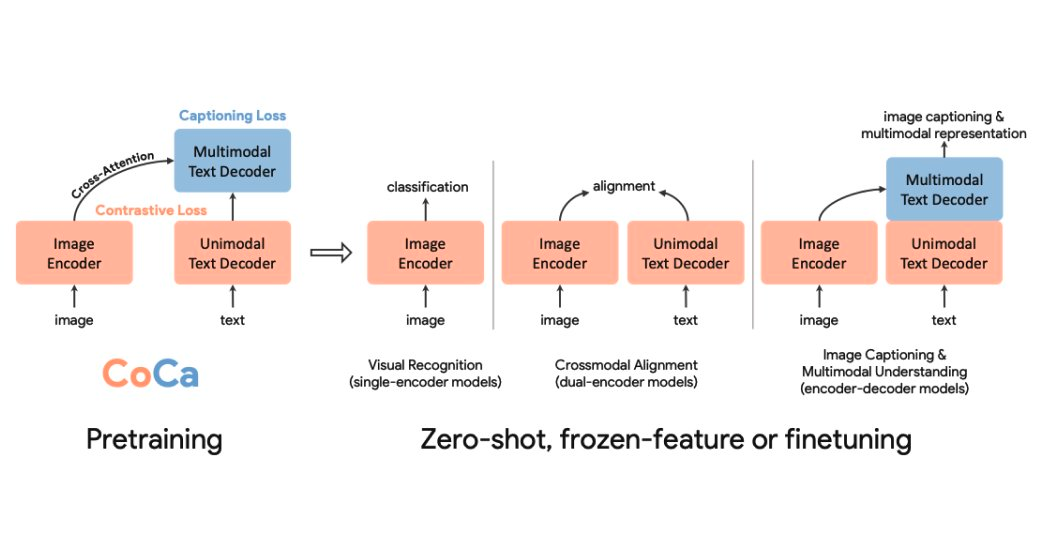
图1 - 对比式描述器(CoCa)
基础模型的崛起
基础模型的概念在机器学习中并不新鲜。在深度学习中,使这些模型得以训练的技术,使我们能在后续为下游任务对其进行适配。在 NLP 领域,诸如GPT 和 BERT 等基础模型在嘈杂的互联网规模数据上训练,已展现出卓越的零样本与小样本能力。
针对视觉与图文基础模型的研究主要探索了三条路径:单编码器模型、带对比损失的图文双编码器模型,以及以生成目标为导向的编码器-解码器模型。在探讨 CoCa 模型之前,让我们先看看这些研究路线及其局限。
术语表
- 基础模型。 预训练模型,可作为机器学习中多种应用的起点,并可适配特定任务。
- 对比损失。 一种损失函数,使模型学习对相似输入对获得相似表示、对不相似输入对获得不相似表示。
- 跨模态交互。 不同数据模态(如图像与文本)之间的交互,以生成联合表示。
- 编码器-解码器架构。 一种神经网络结构,编码器处理输入数据,解码器生成输出,常用于序列到序列任务。
- 因果掩码。 Transformer 模型中的一种技术,在训练期间阻止访问序列中的未来标记。
- 注意力机制。 一种组件,使模型在处理信息时对输入的不同部分进行加权与优先级分配。
- 零样本学习。 一种学习范式,模型可对训练期间未见过的数据类别进行预测或分类。
- 可视化问答(VQA)。 一种任务,模型需回答关于图像内容的问题,结合计算机视觉与自然语言处理。
- 单模态与多模态表示。 单模态表示捕获一种数据模态的信息,而多模态表示整合多种模态的信息。
- 对比式图文预训练(CLIP)。 一种使用对比学习在共享表示空间中对齐图像与文本的模型。
单编码器模型
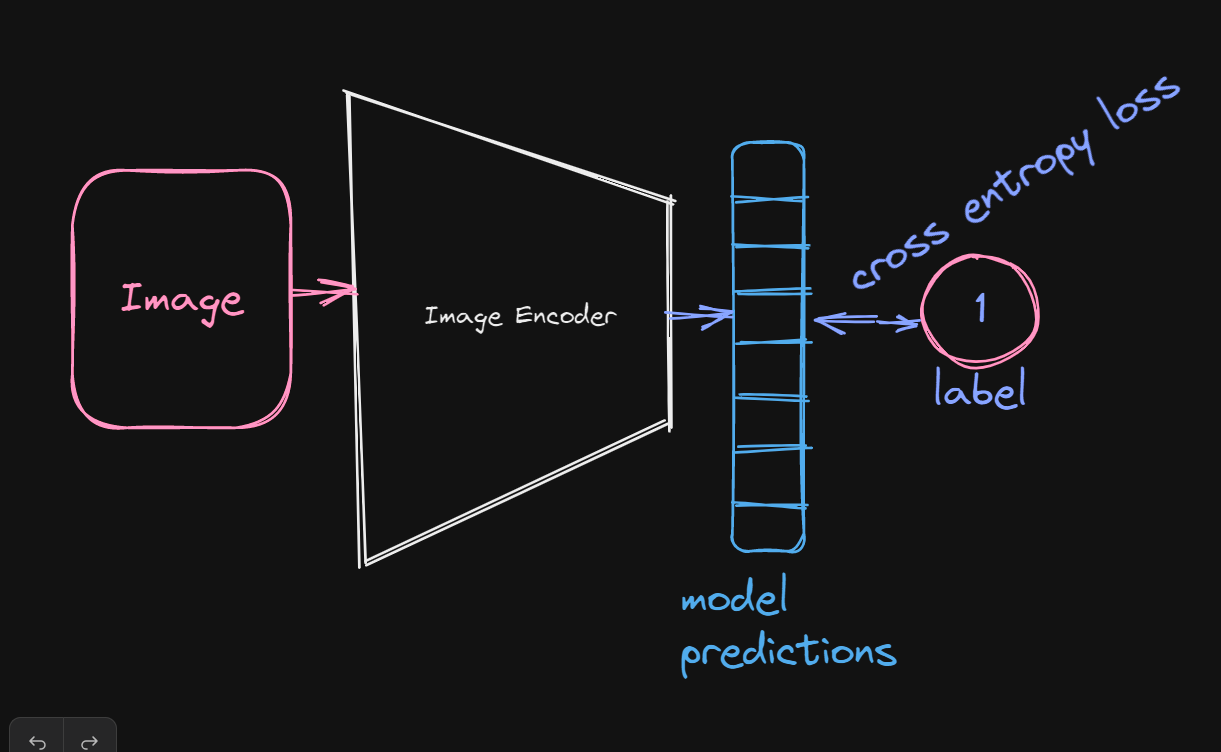
如果您接触过计算机视觉,很可能遇到过这一类模型。它们通过在大型标注图像数据集上以交叉熵损失训练,学习图像表示,随后可用于适配各种下游视觉任务。
这类模型在检测等视觉相关任务上表现优异已被实证证明,但在涉及图文的任务上表现较弱,原因在于对人工标注的高度依赖,无法将人类自然语言融入模型之中。
带对比损失的图文双编码器模型
这一类图文基础模型的代表包括 CLIP(对比式图文预训练)与 ALIGN。
在预训练阶段,通过对图像与语言模型进行联合训练并使用对比损失,我们学习一种对齐任务。
其预训练目标背后的思想很直观:将相关的图文对的表示聚在一起,并在同一隐空间中将不相关的图像与文本(非配对)表示推开。得到的双编码器模型可以执行零样本分类与图像检索等任务。
近期的此类模型(如 CLIP)在多种图文任务上取得了显著成绩,但在需要融合图像与文本表示的任务(如可视化问答)上几乎难以使用,因为我们只学习了图像与文本表示的对齐,而未生成同时编码图像与文本信息的统一表示。
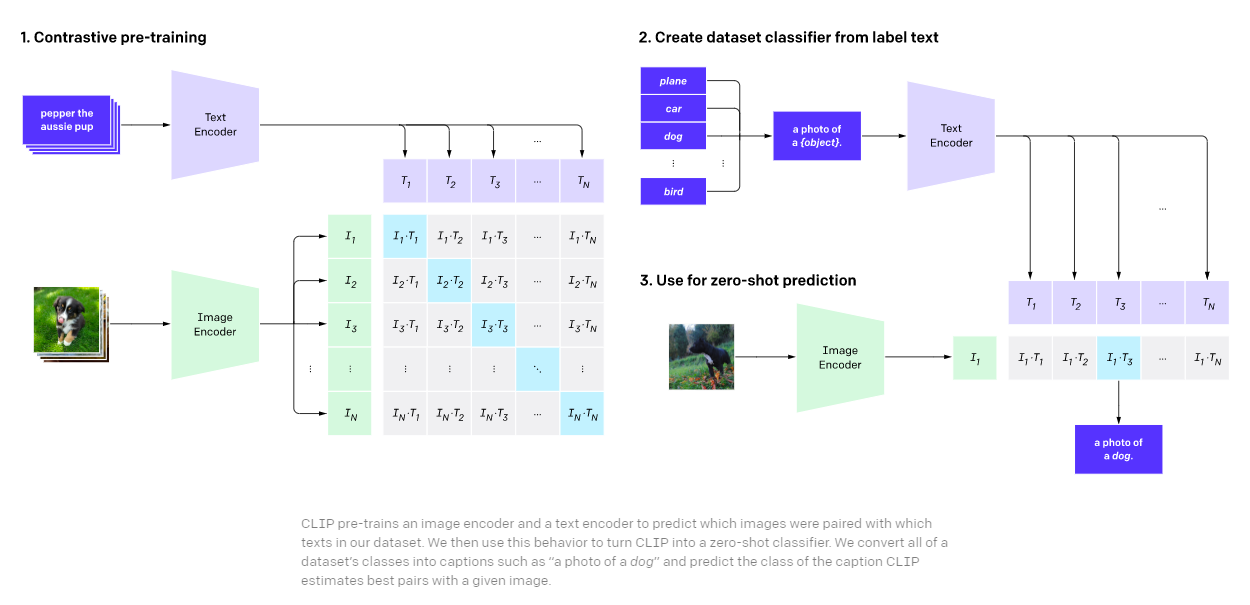
图3 - 对比式图文预训练(CLIP)
采用编码器-解码器架构的生成式预训练
这类模型通过图像与文本的隐表示之间进行跨模态交互,以生成联合表示。
在预训练过程中,我们通过文本隐表示与图像编码器输出之间的跨模态交互,生成图文统一表示,并在解码器输出上施加语言建模损失。
在近年的机器学习架构中,跨模态交互多通过 Transformer 的交叉注意力机制来实现,使用图像编码器的输出作为 query,文本隐表示作为 key 与 value。
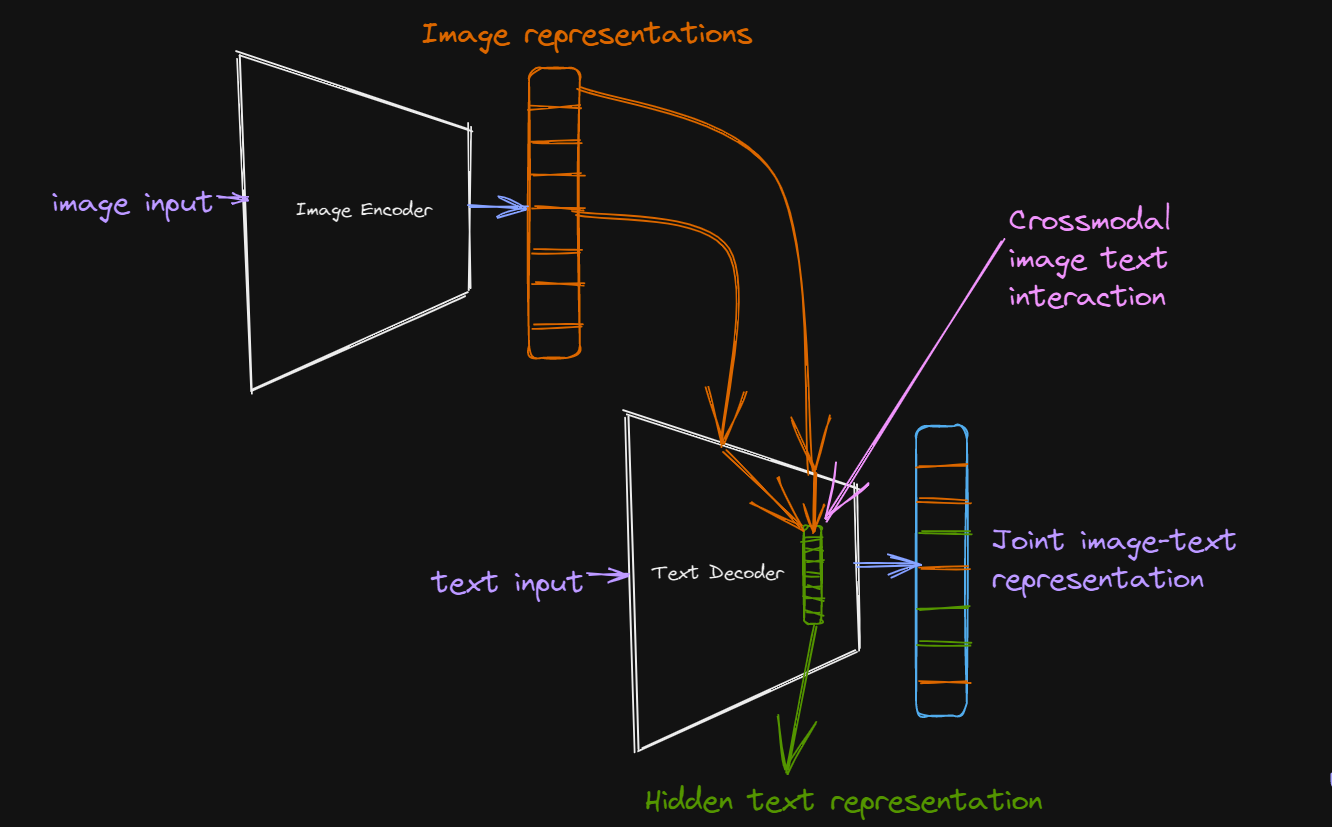
对于下游任务,我们可以取作为图文联合表示的解码器输出,执行各种多模态图文理解任务,如可视化问答。近期采用此范式的模型之一是简单视觉语言模型(SIMVLM)。
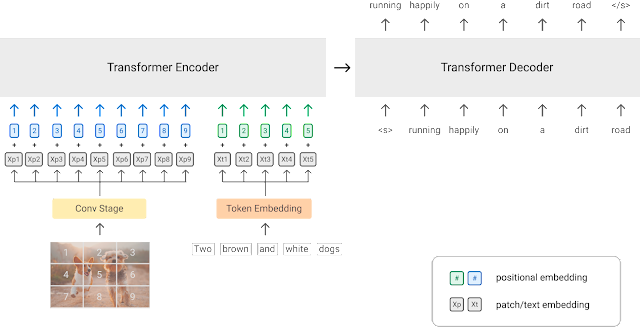
图5 - 简单视觉语言模型(SIMVLM)
CoCa 的动机
CoCa 的作者希望用一个简单的模型,囊括构建图文基础模型的不同范式的能力。CoCa 的设计利用对比损失在同一向量空间中学习对齐图像与文本表示,同时通过生成目标(描述损失)学习图文联合表示,从而将 CLIP 与 SIMVLM 等模型的能力整合到单一模型中。
模型架构
CoCa 采用标准的编码器-解码器方法,与多数同类模型一样,使用诸如卷积神经网络或Transformer对图像进行编码。
CoCa 架构的独特之处体现在其编码器输出以及整个解码器的设置上。
回顾一下,CoCa 论文的目标是将两种图文模型范式(对比与生成目标)的能力合并到一个模型中。对比目标范式要求文本解码器输出单模态文本表示,然后将其投射到与图像表示相似的向量空间,以学习对齐任务。
另一方面,生成目标允许解码器接收来自编码器的图像表示,并在图像表示与文本输入的条件下自回归地生成文本。
需要注意的是,这两部分解码器都对注意力图应用了因果掩码,以防止模型提前看到后续标记。
为此,作者巧妙地采用了解耦合解码器设置:第一部分学习为对比目标生成单模态文本表示;第二部分学习生成多模态图文表示。
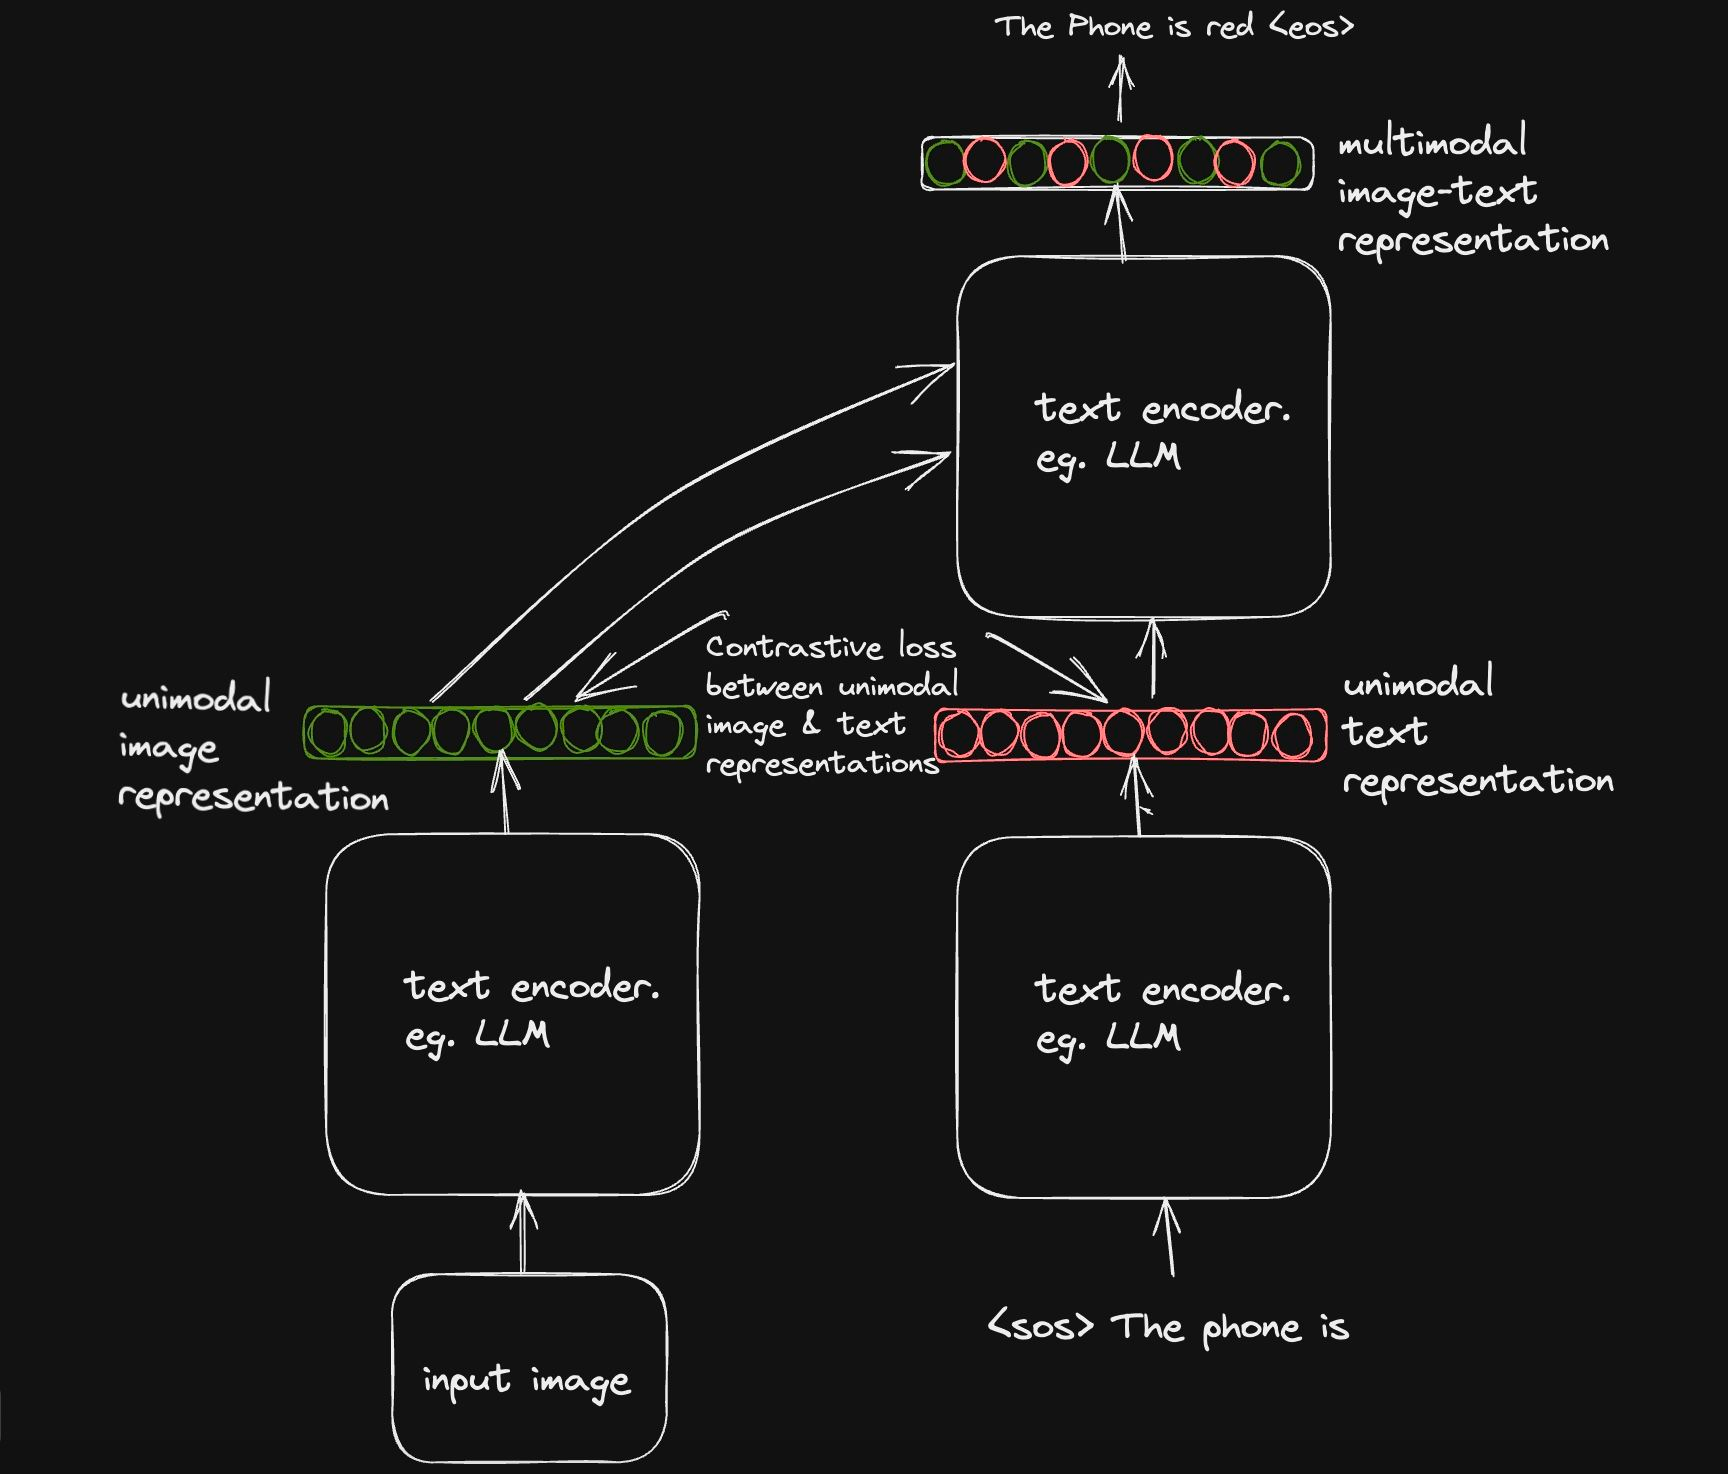
对比目标
如同在 CLIP 与 ALIGN 等多种模型中使用的那样,对比目标的思想很简单:为不同模态(如图像与文本)学习表示,使相似配对在表示空间中更接近,不相似配对更远离。
在每个训练步,我们从数据集中采样图文对,并通过调整编码器的权重,将配对样本聚集在一起、将非配对推开。
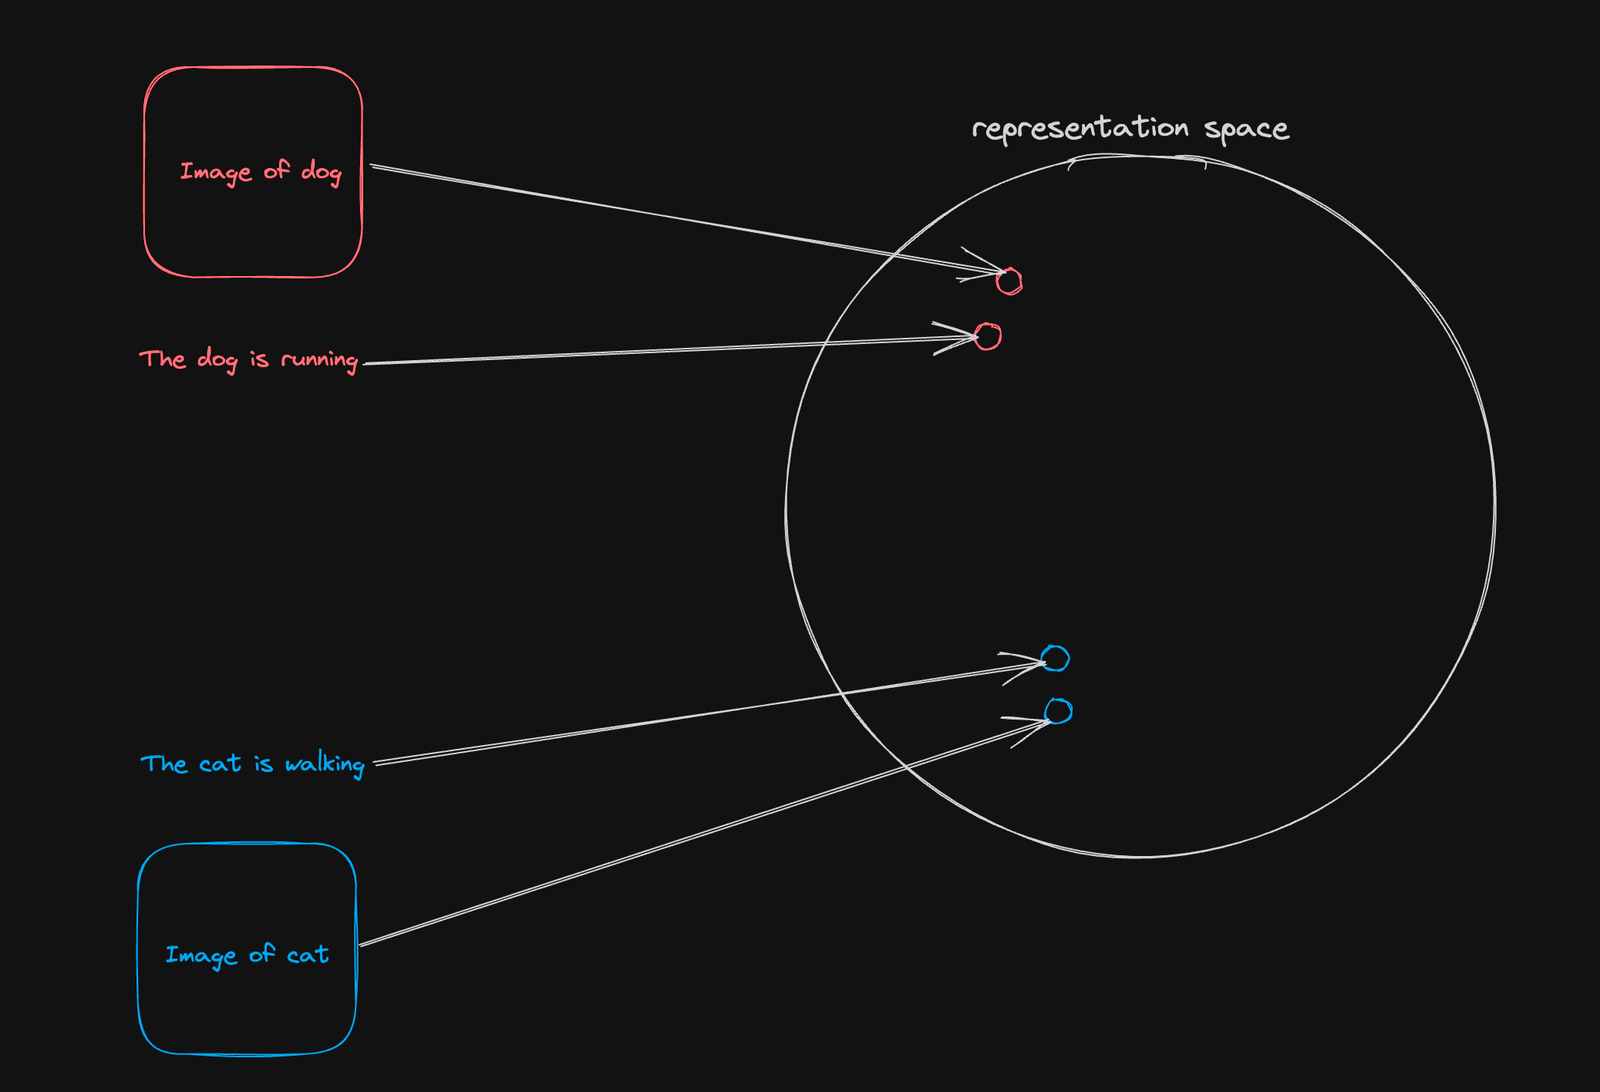
如前所述,对比目标要求图像与文本模态均为单模态表示。为在文本编码器侧实现这一点,我们采用 BERT 语言模型中的经典技巧。
作为输入序列的一部分,我们在序列末尾引入一个可学习的分类标记 [CLS],期望映射到该标记的输出向量能够捕获整个输入序列的语义。
由于我们的解码器在注意力图上应用了因果掩码,将分类标记添加在序列末尾可确保该标记与输入序列中所有其他标记之间存在注意力连接,从而捕获整句的语义。
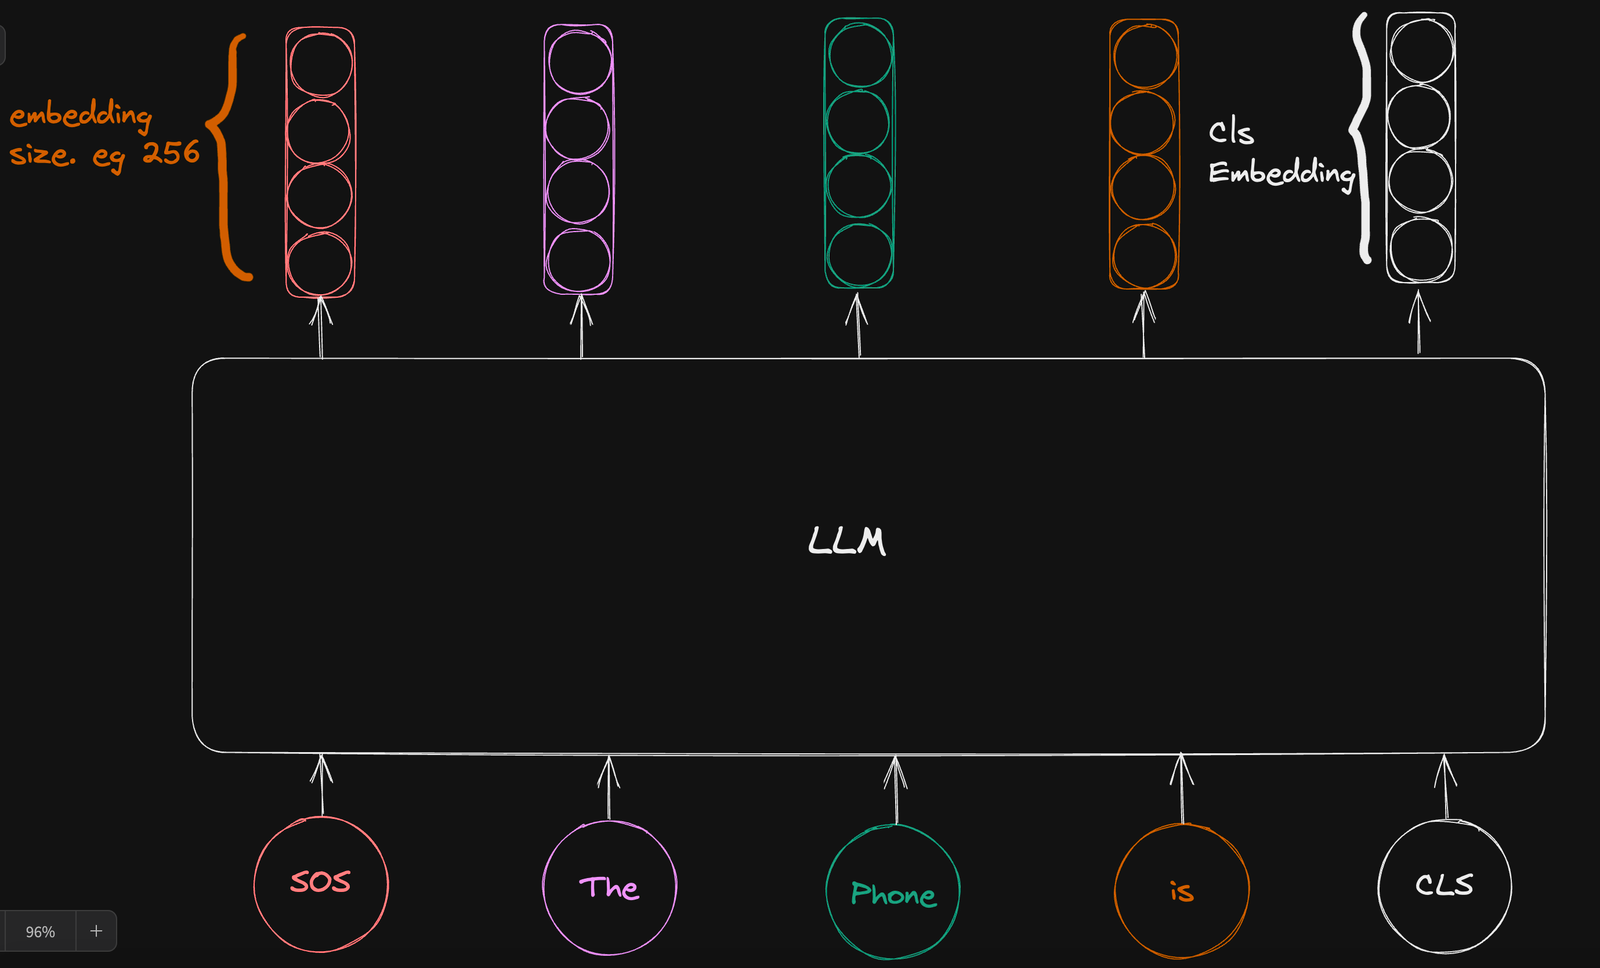
我们忽略其他输入标记的向量表示,仅使用分类标记的向量表示来估计对比损失。
在图像编码器侧,情况略有不同。
从图6可以看到,图像编码器部分输出与分类标记嵌入一起用于估计对比损失,另一部分则送往解耦合设置的上半部分以估计联合表示。
实际上,仅需一个图像的单个嵌入输出即可估计对比目标,而图像编码器的完整嵌入序列则用于估计生成目标。
作者指出,他们通过实证发现,单个池化嵌入有助于捕获图像的全局表示(这正是对比目标所需),而嵌入序列在需要更细粒度图像表示的任务中更有帮助。
为实现这一点,采用了注意力池化层(单层多头注意力),通过可学习的 query 参数来为不同目标定制图像编码器输出。通过将 query 参数设为特定整数值,我们可以使整个编码器输出长度等于该参数的嵌入序列。
在对比目标的情形中,我们将 query 参数设为 1,以获得单个嵌入来计算对比损失;在生成目标的情形中,我们将其设为任意值,理想情况下等于文本的序列长度。在 CoCa 论文中,作者为生成目标选择了 256。
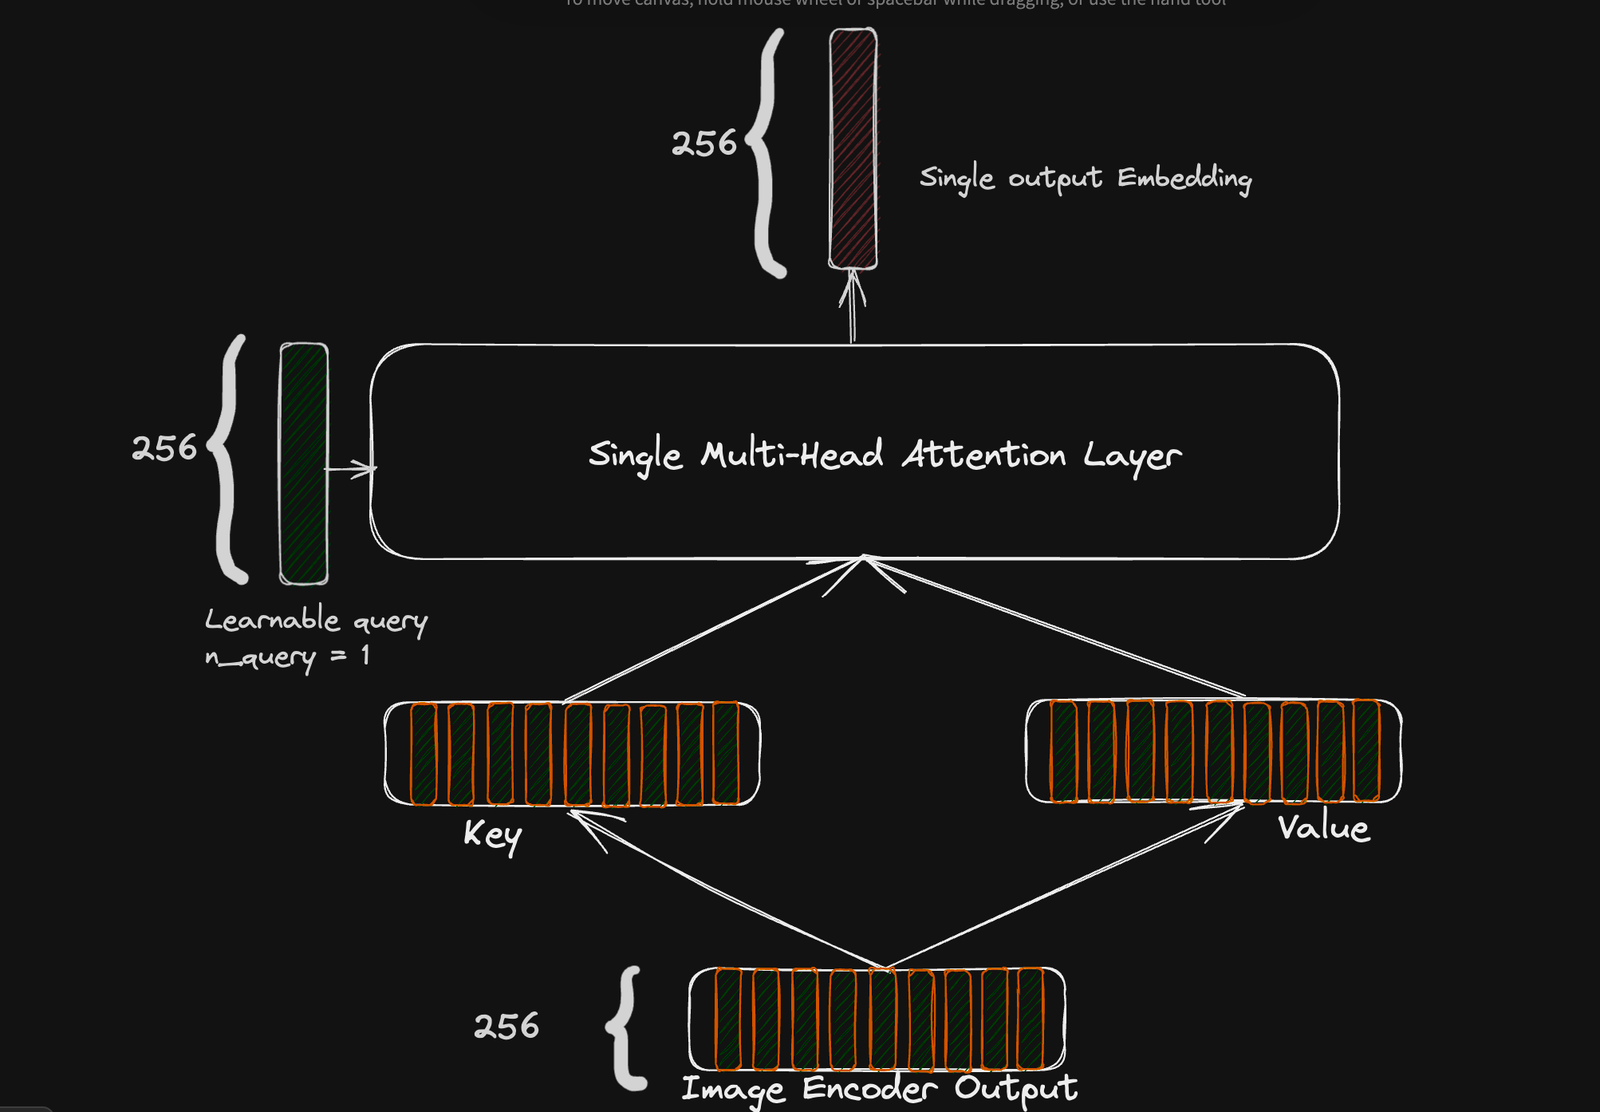
用于对比损失的注意力池化设置。注意力层的输出是一个 256 维的单个嵌入。
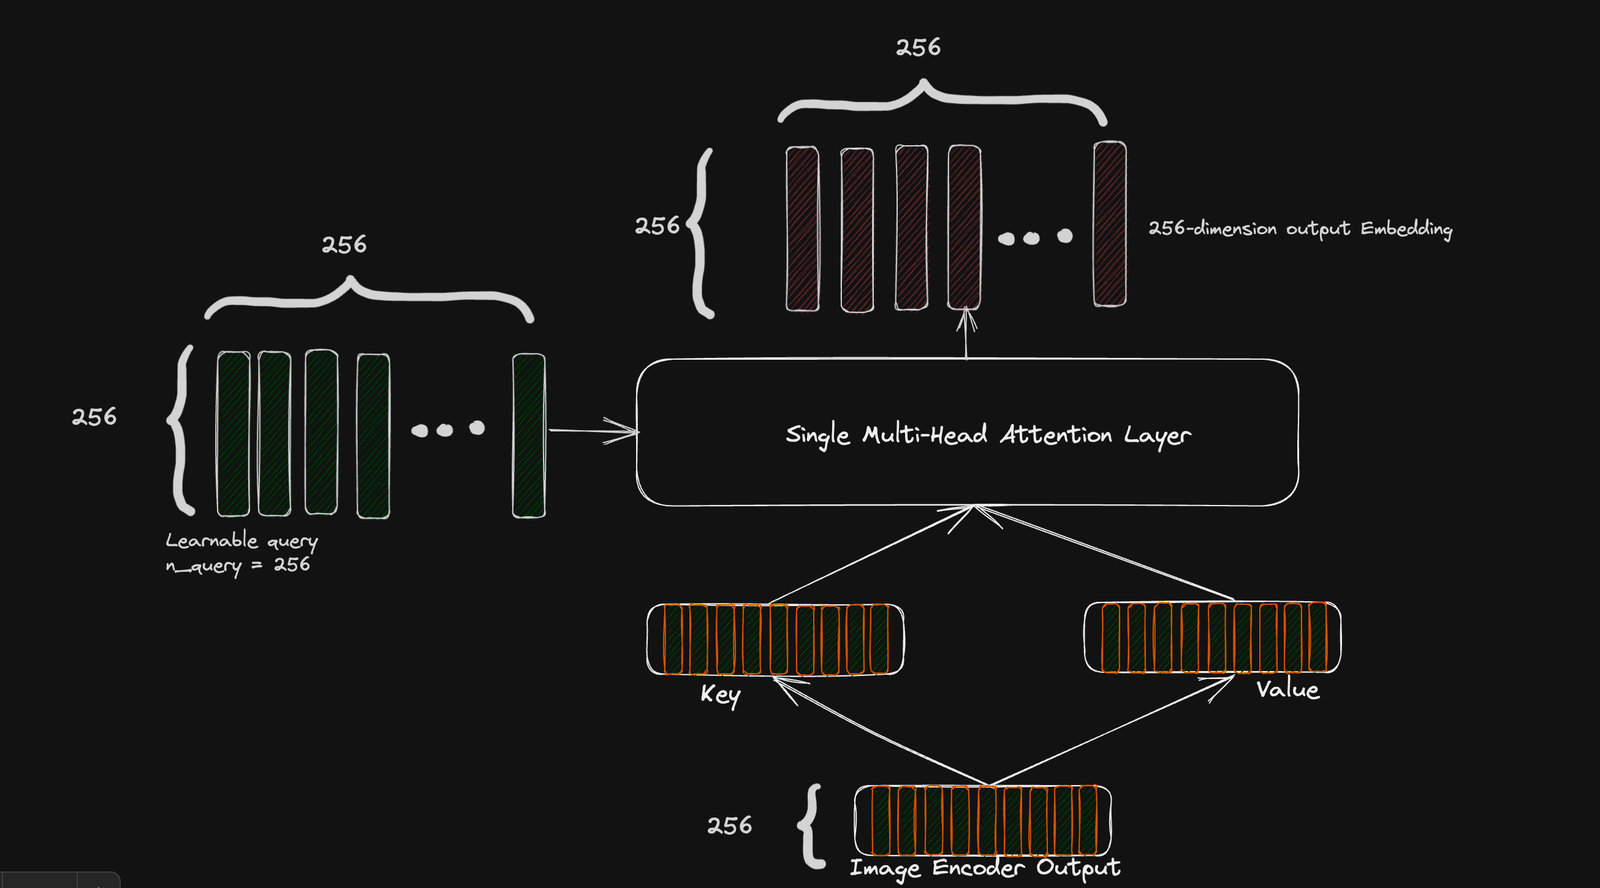
生成目标
不同于仅需图像全局表示的对比目标,生成目标在我们生成更细粒度的图像表示时更为有效。
如前所述,我们通过将 query 参数设为一个任意数值(CoCa 论文中为 256),得到细粒度图像表示,从而生成 256 x 256 的丰富图像表示。
该表示被传递至解耦合解码器设置的上半部分,并与单模态文本表示(忽略 CLS 表示)进行跨模态交互,得到统一的图文表示,随后通过自回归分解来预测词表的概率分布。
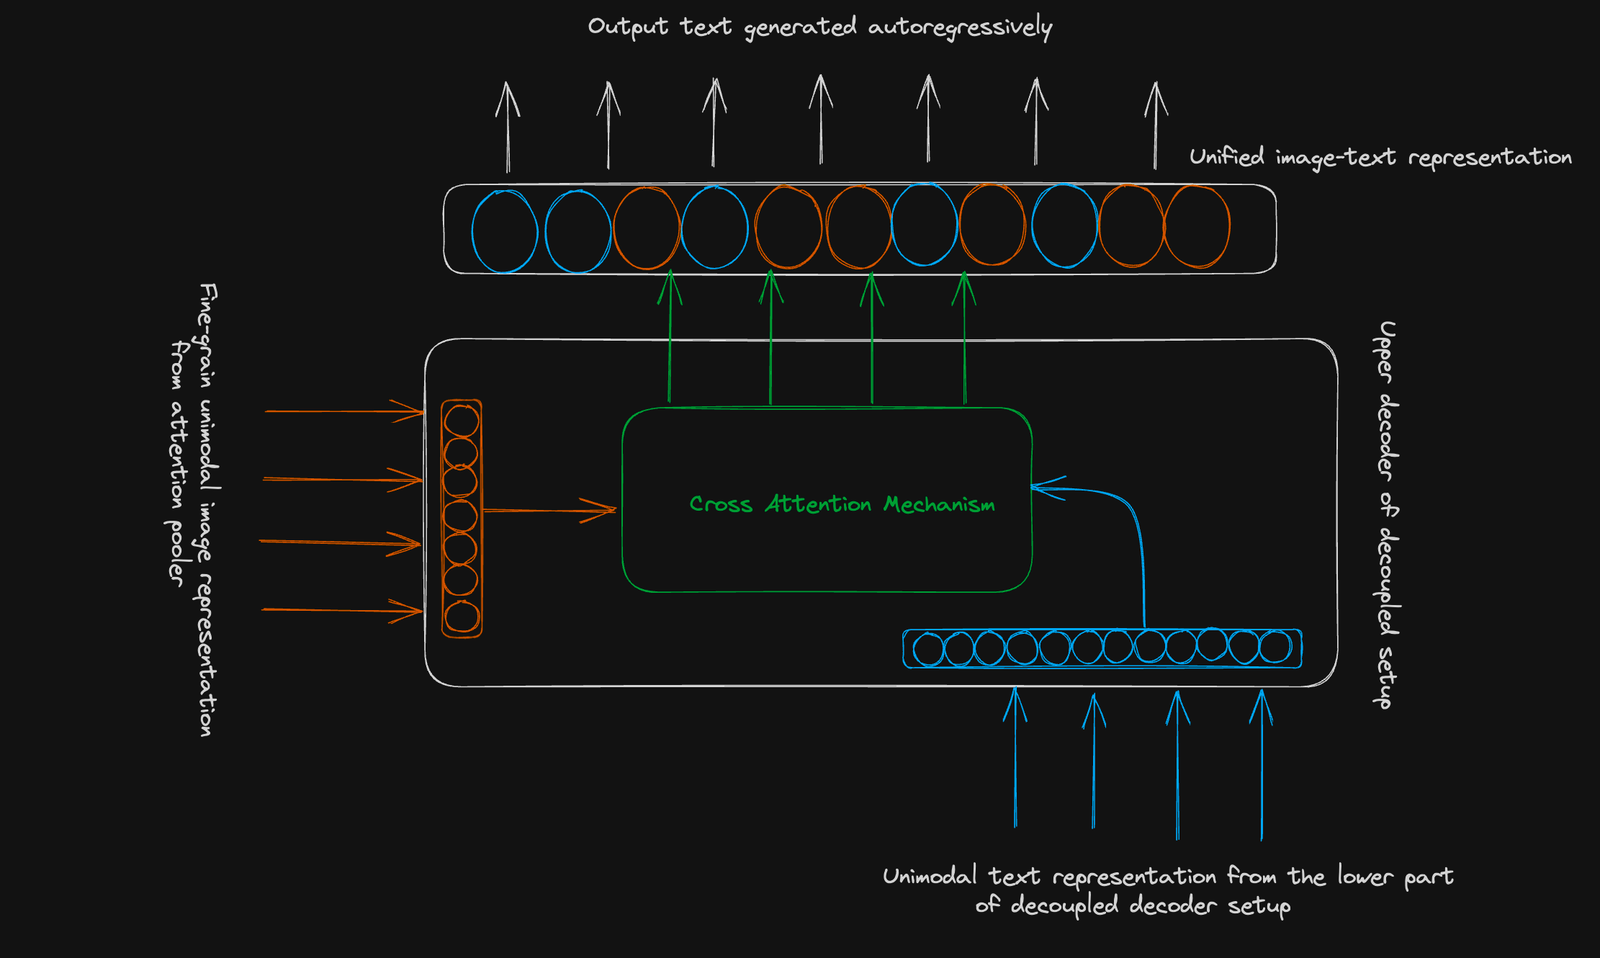
如前两节所示,CoCa 模型的架构设置使其能够囊括在零样本学习任务(如图像分类与跨模态检索)上表现突出的模型能力,也能涵盖在 VQA 与图像描述任务上表现优异的模型能力。CoCa 还可在多种下游视觉与语言任务上进行微调。
结语
像 CoCa 这样的基础模型的出现,标志着机器学习领域的重要一步。CoCa 融合多种范式的优势,提供了一个既能对齐图像与文本表示,又能生成图文联合表示的统一模型。
该模型印证了对比与生成目标融合的潜力,为可视化问答与图像描述等任务的性能提升铺平道路。它既涵盖擅长零样本学习的模型能力,也兼具精于多模态图文理解的模型能力,为众多下游视觉与语言任务提供了多才多艺的工具。
如果您希望进一步深入学习机器学习的高级概念,探索深度学习的精妙之处,DataCamp 上的Advanced Deep Learning with Keras 课程将帮助您掌握使用灵活的 Keras 函数式 API 解决多种问题的知识与技能,使您能够更深入地探索并理解像 CoCa 这样的高级模型及其底层原理。