

Kursus
Konsep Large Language Models (LLM)
2 jam
111.7K
Ingin memperluas pengetahuan AI Anda melalui proyek praktis? Dalam tutorial ini, kita akan mengeksplorasi Cohere Command R+, termasuk cara mengaksesnya secara online dan lokal. Kita juga akan membahas fitur utama Cohere Python API dan membangun proyek AI menggunakan LangChain dan Tavily.
Bagian menarik dimulai pada proyeknya. Jika Anda sudah familiar dengan model Cohere dan fiturnya, silakan langsung lompat ke bagian proyek. Di sana, Anda akan belajar membangun agen AI yang menggunakan beberapa alat secara berurutan untuk menyelesaikan tugas.
Jika Anda baru di bidang AI dan ingin mempelajarinya lebih jauh, pertimbangkan untuk mengikuti track AI Fundamentals. Anda akan mendapatkan pengetahuan praktis tentang topik AI populer seperti ChatGPT, Large Language Models (LLMs), generative AI, dan lainnya.
Command R+ adalah LLM terbaru dan tercanggih dari Cohere. Model ini unggul dalam interaksi percakapan dan tugas konteks panjang. Model ini dioptimalkan khusus untuk alur kerja Retrieval Augmented Generation (RAG) yang kompleks dan penggunaan alat multi-langkah, menjadikannya alat yang kuat untuk aplikasi skala perusahaan.
Gambar oleh penulis
Berikut beberapa fitur paling relevan dari model Command R+.
Untuk pemahaman lebih mendalam tentang model Cohere, pastikan membaca Tutorial Cohere API: Memulai dengan Model Cohere.
Ada beberapa cara untuk mengakses model Cohere, sebagian besar gratis.
Anda bisa mengakses playground LLM online atau mengunduh model secara lokal dan menggunakannya dengan aplikasi chat. Selain itu, Anda juga dapat mengaksesnya melalui Cohere API. Mari kita tinjau masing-masing metodenya.
Cara paling mudah untuk mengakses Cohere Command R+ secara online adalah melalui situs HuggingChat. Tidak ada pembatasan, dan Anda juga dapat menghubungkannya dengan enam alat yang tersedia untuk berbagai tugas seperti pembuatan gambar atau penelusuran internet.
1. Kunjungi situs https://huggingface.co/chat/.
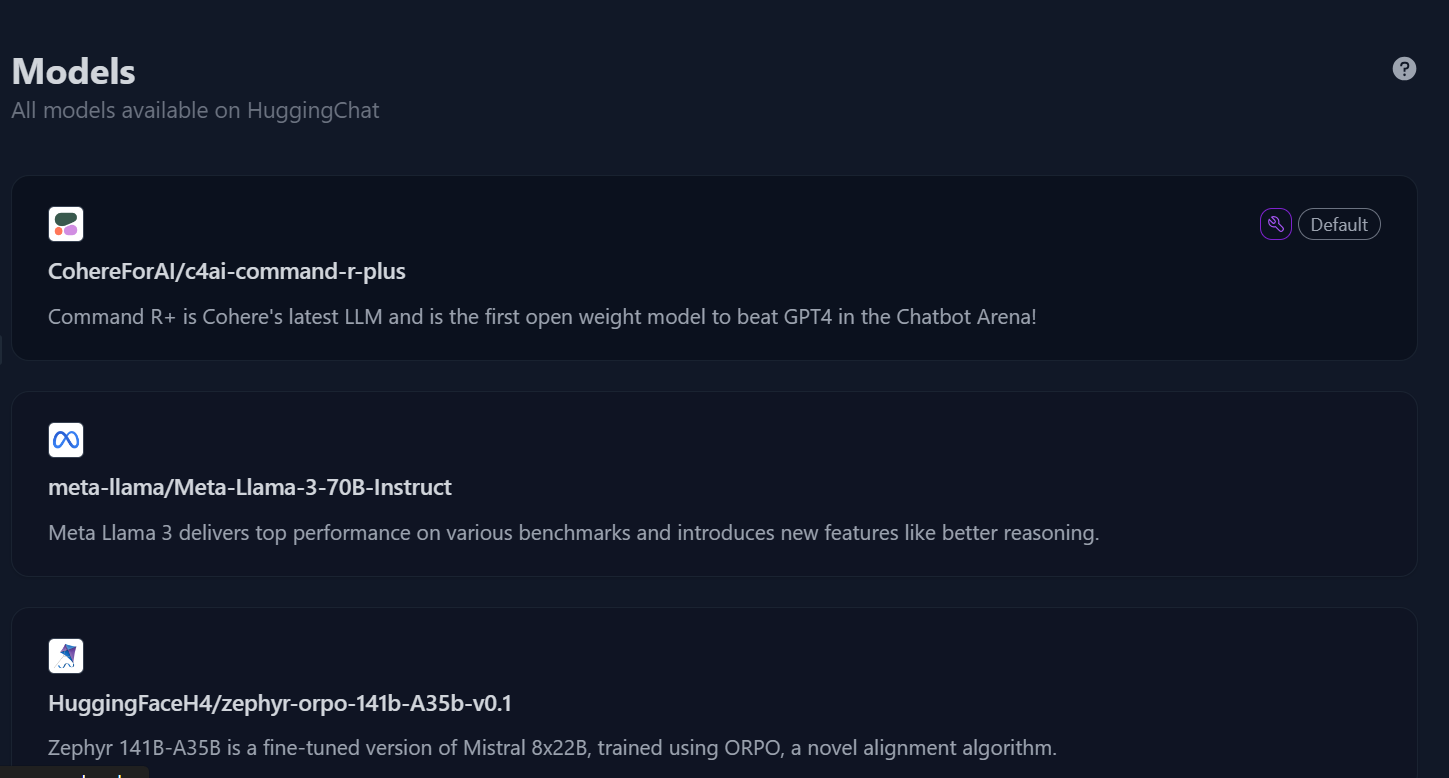
2. Di panel kiri, klik tombol “Models” untuk membuka menu model, lalu pilih model “c4ai-command-r-plus”.
Direktori model di Hugging Chat. Sumber gambar: HuggingChat
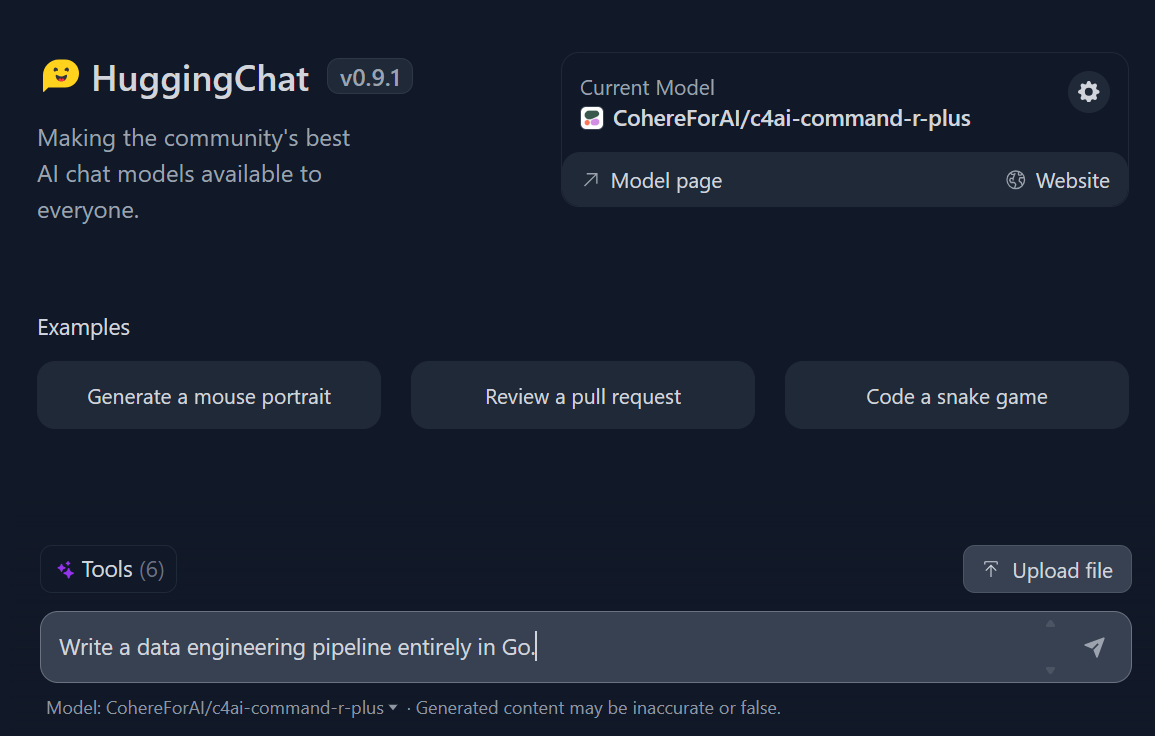
3. Mulailah menulis kueri, dan model akan menghasilkan respons yang cepat dan sangat akurat.
Memberi prompt di Hugging Chat. Sumber gambar: HuggingChat
Anda dapat menggunakan Command R+ secara lokal dengan dua cara: mengunduh model ke mesin lokal Anda atau menyediakan kunci API ke aplikasi chat Jan.
Mari kita jelajahi opsi kedua.
1. Unduh dan instal Jan dari situs https://jan.ai/.
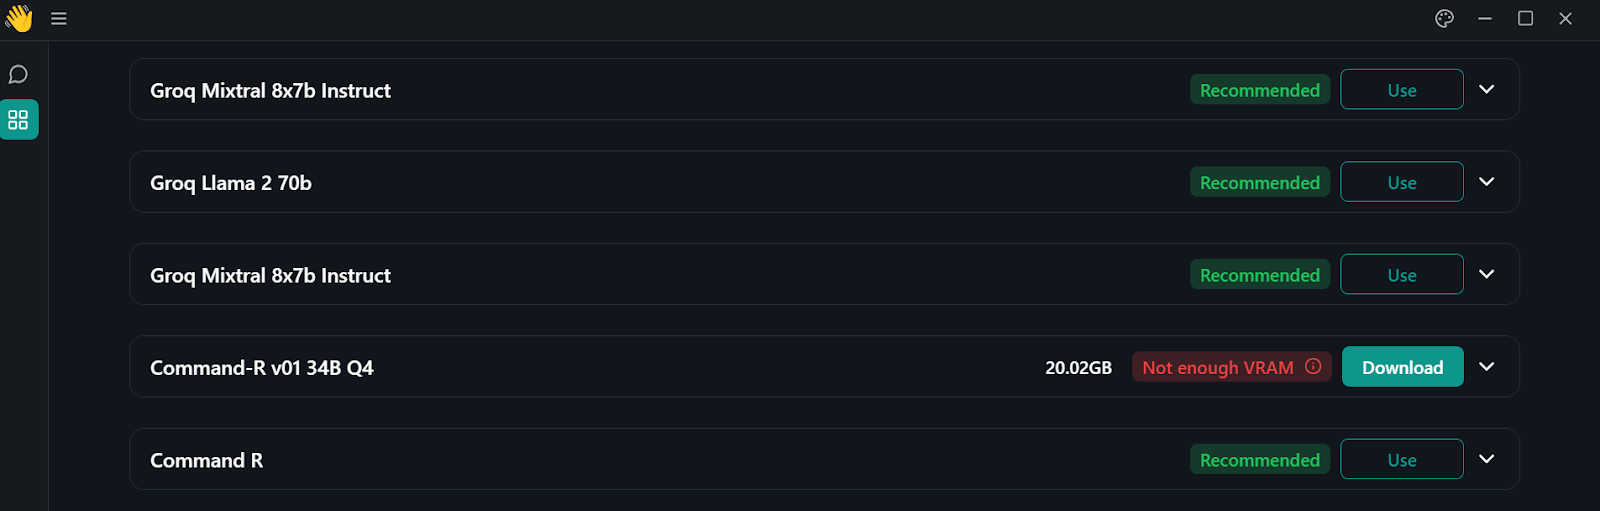
2. Buka model hub dengan mengklik tombol jendela di panel kiri.
Direktori model di aplikasi Jan
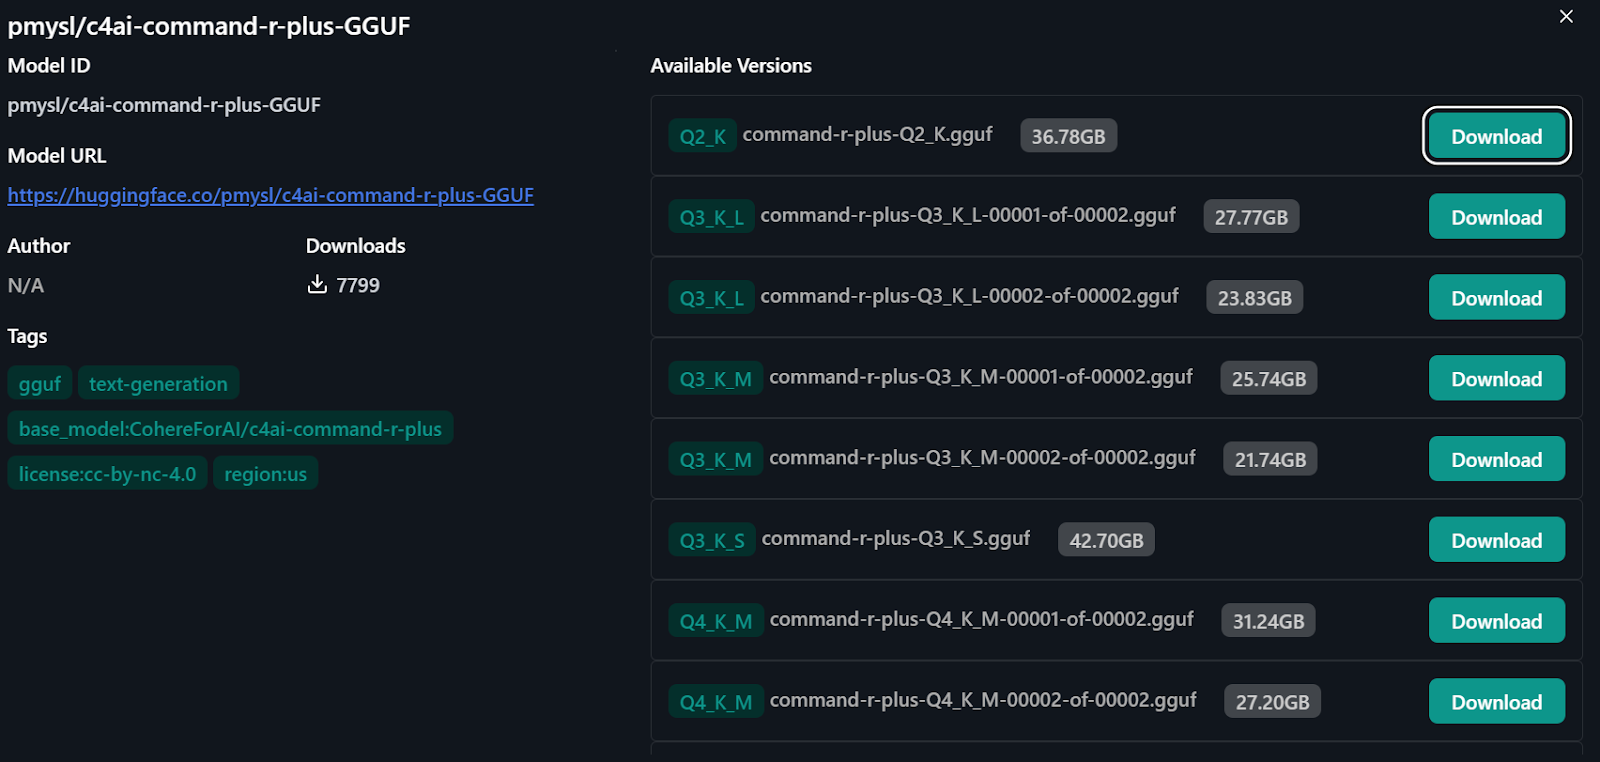
3. Untuk mengakses model Command R+, ketik “pmysl/c4ai-command-r-plus-GGUF ” di bilah pencarian model hub.
4. Unduh dan mulai gunakan “versi Q4_K_M” model, yang berukuran sekitar 31,24GB.
Mengimpor model dari Hugging Face
Cara lain untuk menggunakan model Command R+ secara lokal adalah menghubungkan Cohere API dengan aplikasi Jan.
1. Kunjungi situs https://coral.cohere.com/ dan masuk.
2. Buka “Dashboard”.
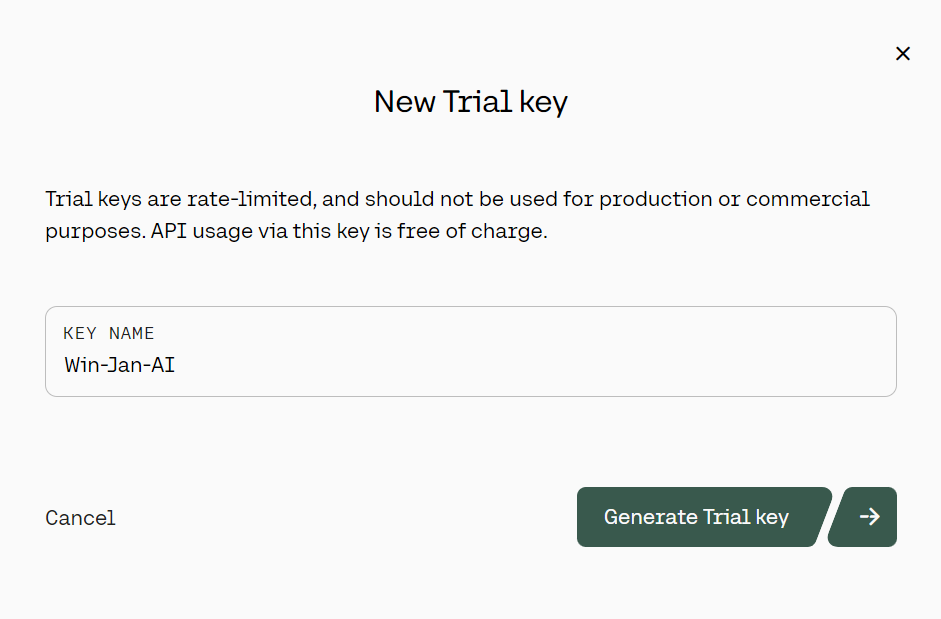
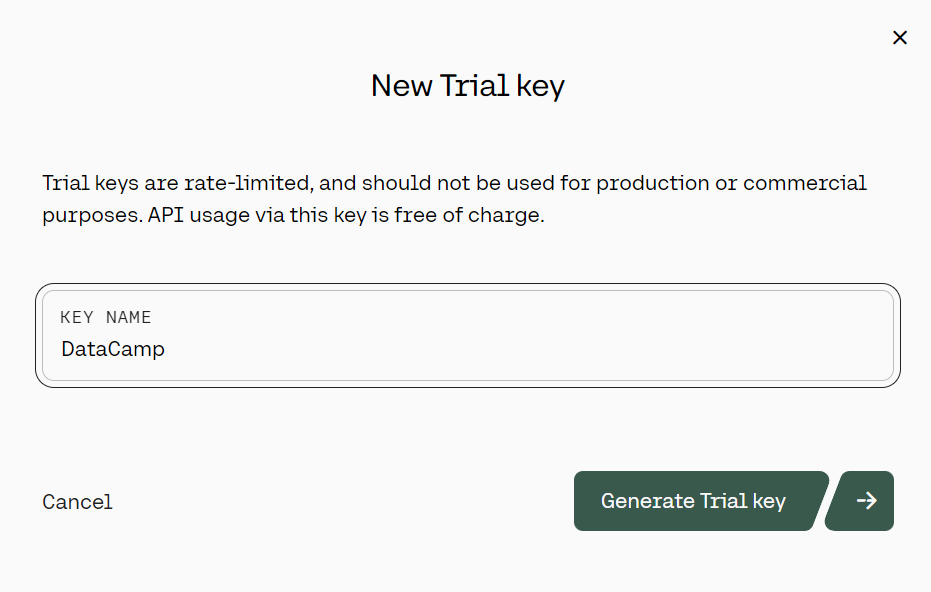
3. Di panel kiri, klik tombol “API keys”, lalu gulir ke bawah dan klik “+ Create Trail key.”
Menghasilkan kunci API uji coba Cohere. Sumber: cohere.com
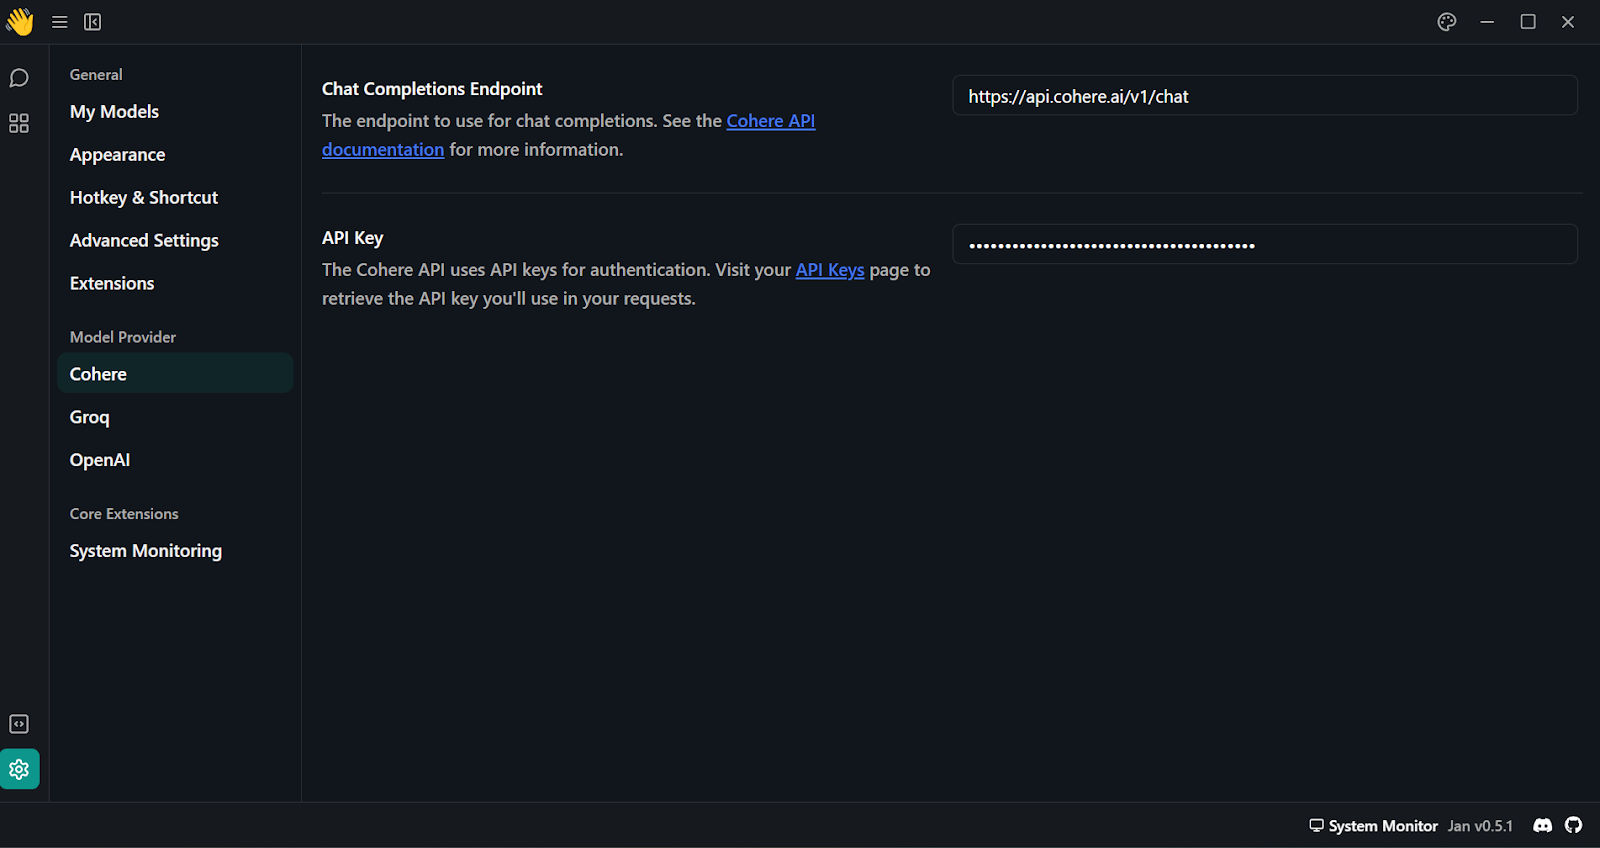
4. Setelah menghasilkan kunci API Cohere, tempelkan ke bagian “Model Provider”. Anda dapat mengakses menu ini dengan membuka “Settings” dan mencari “Cohere.”
Menambahkan kunci API Cohere di aplikasi Jan
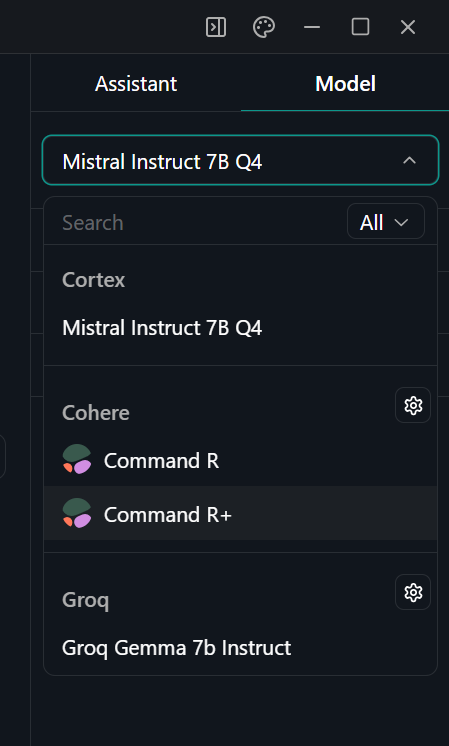
5. Pilih model Command R+ dengan membuka menu “Thread” dan, di panel kanan, pilih model yang sesuai.
Memilih model di aplikasi Jan
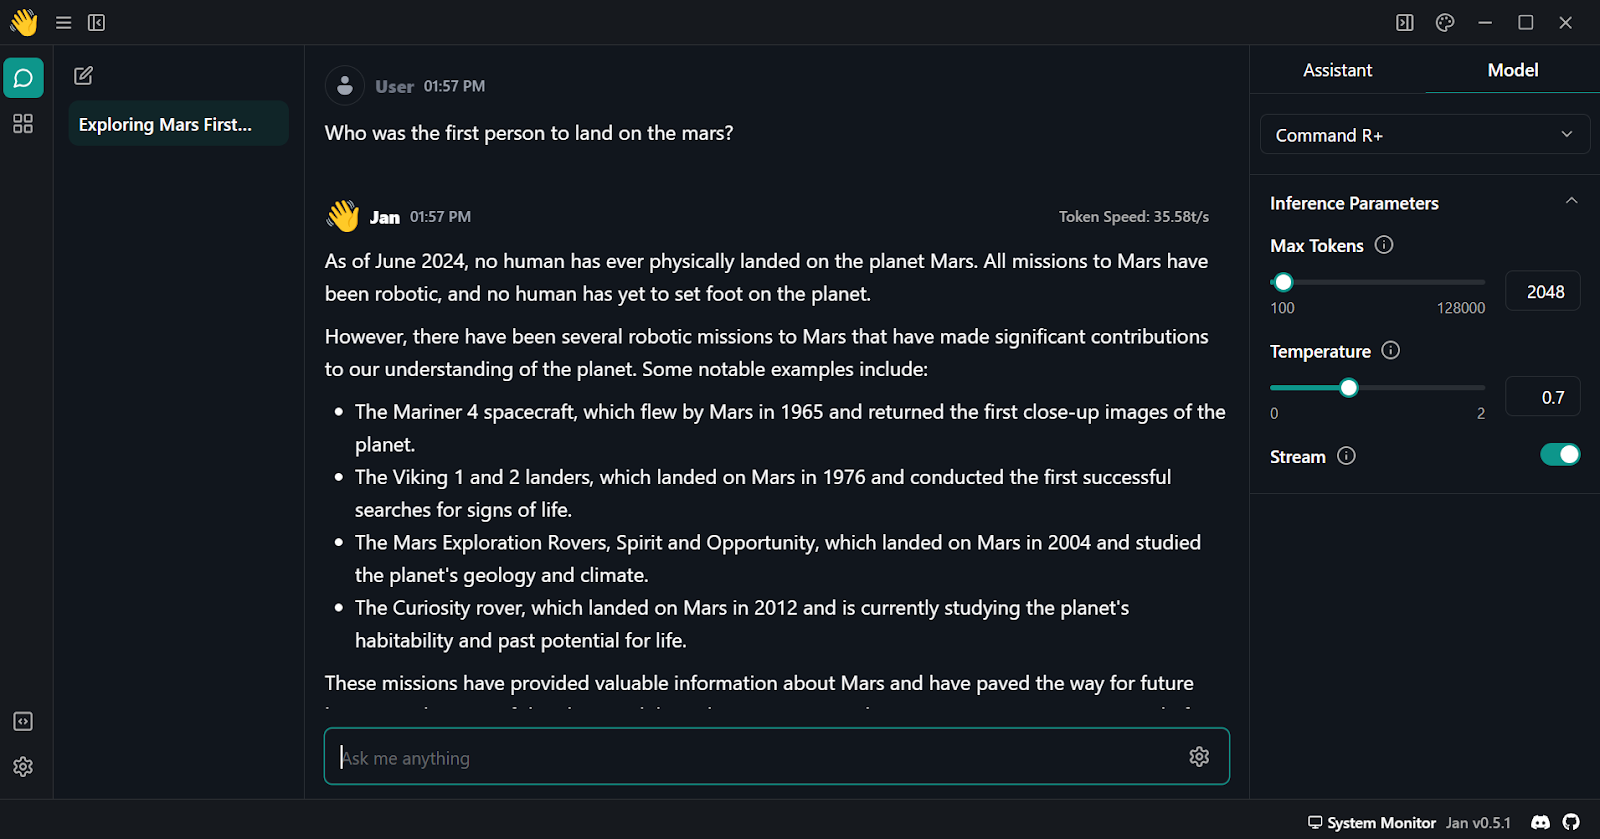
6. Mulai memberi prompt dan pastikan Anda menggunakannya dengan “Stream” diaktifkan.
Menggunakan Cohere Command R plus di aplikasi Jan
Di bagian ini, Anda akan belajar cara menyiapkan dan menggunakan Python API untuk menghasilkan respons.
1. Instal paket Cohere Python menggunakan pip.
pip install cohere2. Hasilkan kunci API Cohere baru. Anda dapat mengikuti langkah-langkah pada bagian “Menggunakan Cohere Command R+ melalui API”.
Menghasilkan kunci API uji coba Cohere. Sumber gambar: cohere.com
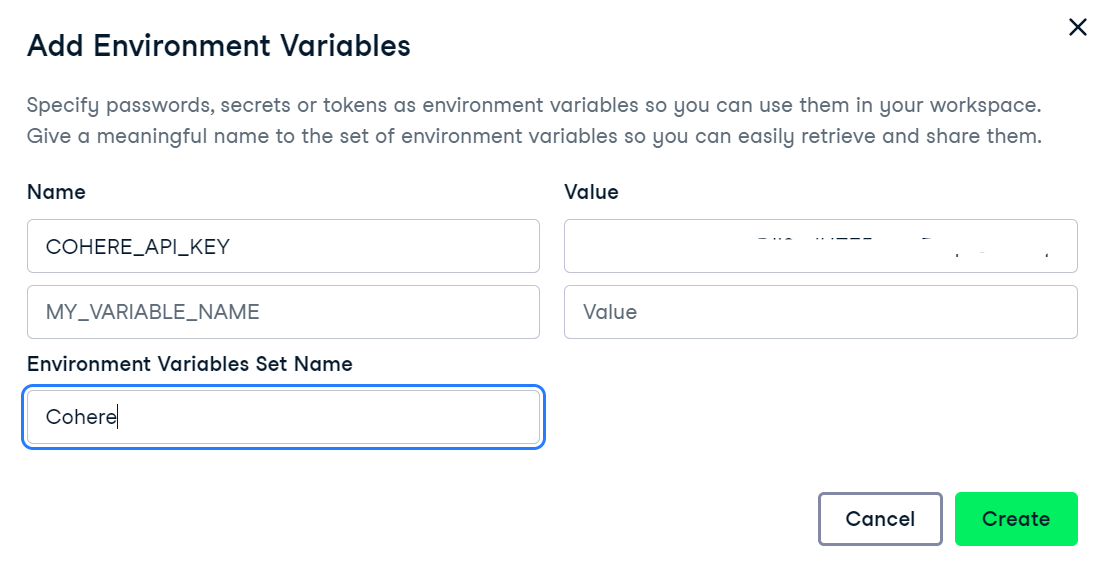
3. Kita akan menggunakan DataLab dari DataCamp sebagai lingkungan pengembangan. Untuk menyiapkan variabel lingkungan di DataLab, ikuti langkah-langkah berikut:
Menambahkan Environment variables di DataLab
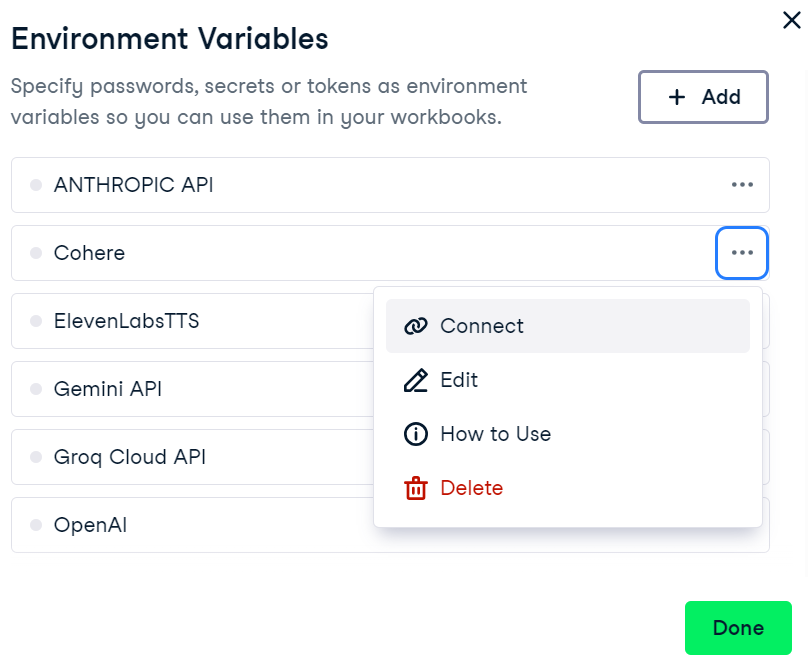
4. Untuk mengaktifkan variabel lingkungan di DataLab dari DataCamp, buka menu variabel lingkungan, klik tiga titik di samping “Cohere” lalu klik “Connect”.
Menghubungkan variabel lingkungan Cohere di DataLab
5. Sekarang, di notebook Anda, inisialisasi klien Cohere dengan menyediakan kunci API. Ini dapat dilakukan dengan mengimpor pustaka Cohere dan membuat objek klien dengan kunci API Anda.
import os
import cohere

cohere_api_key = os.environ["COHERE_API_KEY"]
co = cohere.Client(api_key=cohere_api_key)
6. Untuk menghasilkan respons menggunakan fungsi .chat(), berikan model name dan message.
response = co.chat(
  model="command-r-plus",
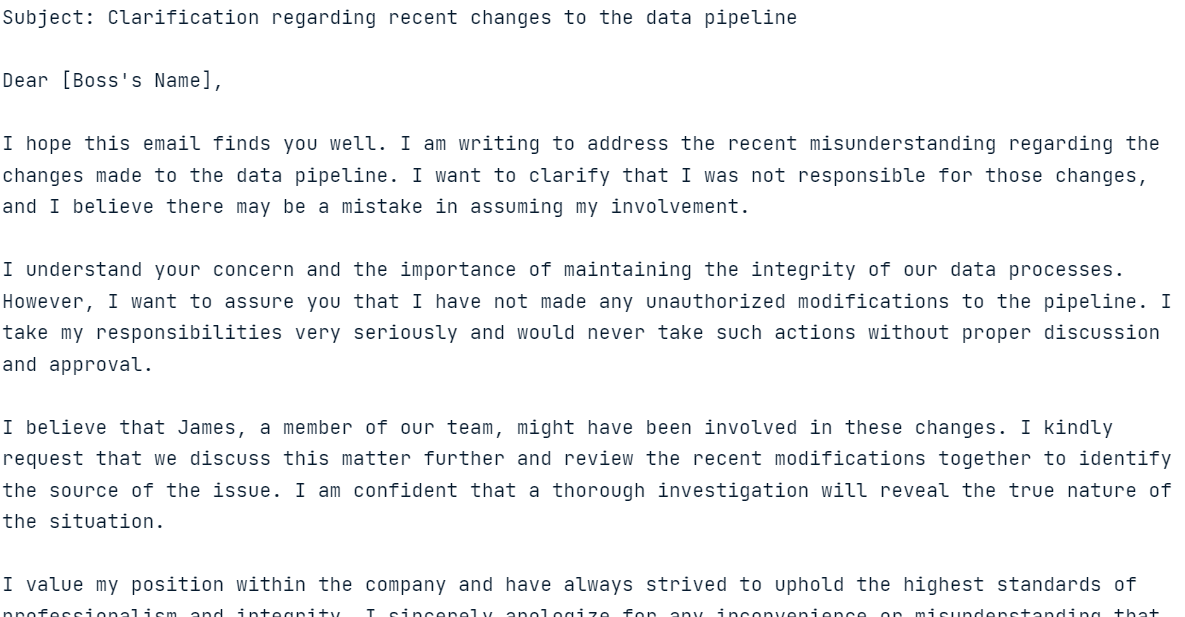
  message="Please help me write an email to the angry boss, who thinks I made the changes to the data pipeline but didn't. It was James."
)

print(response.text)
Respons model terhadap kueri yang diberikan
Proses generasi respons seharusnya cepat dan sangat relevan!
Pada bagian berikutnya, kita akan mengeksplorasi berbagai fitur Cohere Python API.
Sekarang, kita akan mengeksplorasi Cohere Python API untuk menghasilkan respons dengan riwayat, melakukan streaming respons, dan mendapatkan keluaran yang dapat diprediksi. Kita juga akan melakukan RAG, mengonversi teks menjadi embedding, dan fine-tuning model pada dataset khusus.
Pada bagian sebelumnya, kita telah mempelajari cara menghasilkan respons menggunakan fungsi sederhana .chat(). Sekarang, kita akan memberinya argumen tambahan seperti system prompt (preamble), chat_history, max_tokens, dan temperature.
response = co.chat(
    model="command-r-plus",
    preamble="You are a happy chatbot that puts a positive spin on everything.",
    chat_history=[
       {"role": "USER", "text": "Hey, my name is Abid!"},
       {"role": "CHATBOT", "text": "Hey Abid! How can I help you today?"},
    ],
    message="I can't swim?",
    max_tokens=150,
    temperature=0.7
)

print(response.text)
Respons model dengan argumen tambahan
Berdasarkan argumen tambahan, model telah memodifikasi responsnya.
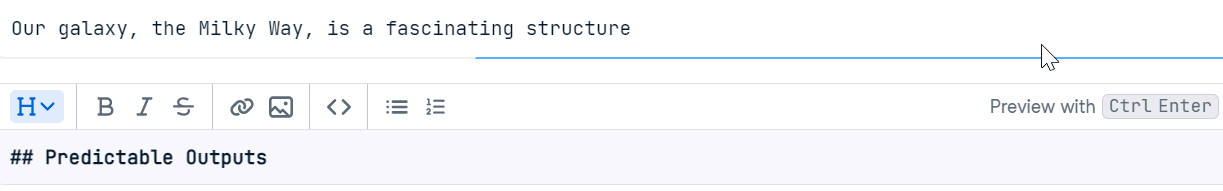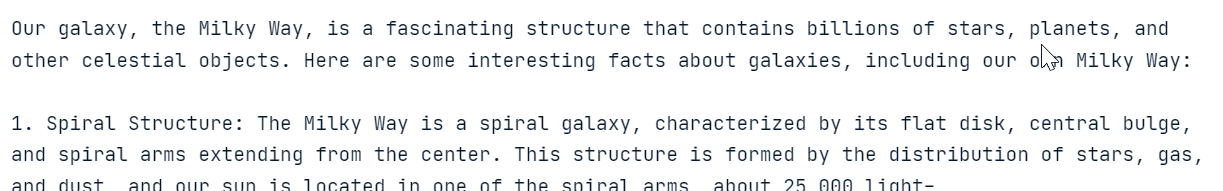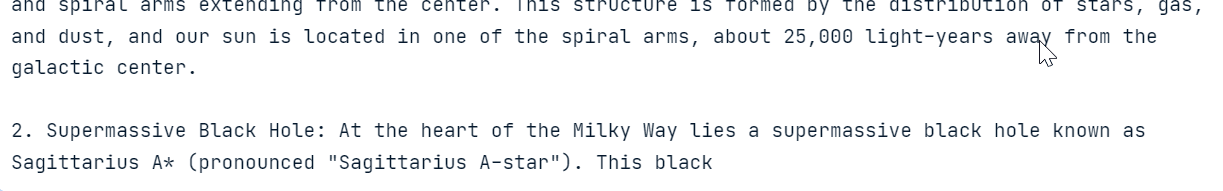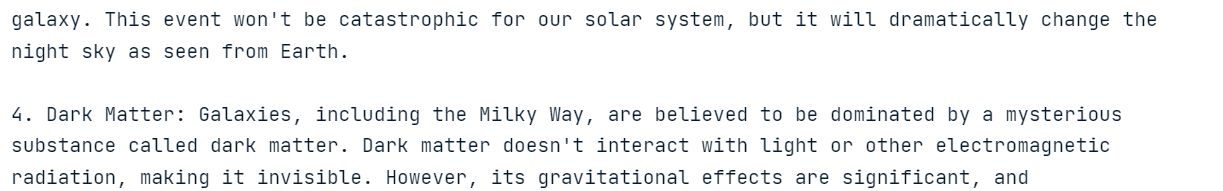
Kita juga dapat melakukan streaming respons menggunakan fungsi .chat_stream(). Fungsi ini memungkinkan kita menghasilkan respons secara real time, memproduksi token begitu tersedia, yang meningkatkan persepsi kecepatan model.
response = co.chat_stream(
    model="command-r-plus",
    message="Tell me something interesting about the galaxy?"
)

for event in response:
    if event.event_type == "text-generation":
      print(event.text, end="")
    elif event.event_type == "stream-end":
      print(event.finish_reason, end="")
Model mengembalikan token secara real time
Keluaran yang dapat diprediksi adalah fitur unik Cohere. Dengan menyetel argumen seed, kita dapat membuat model menghasilkan respons yang sama untuk prompt yang sama.
Biasanya, ketika Anda menanyakan pertanyaan yang sama dua kali kepada sebuah LLM, Anda akan menerima jawaban yang berbeda. Menyetel seed memastikan hasil yang konsisten dan dapat direproduksi, seperti model pembelajaran mesin lainnya.
Pada contoh berikut, dengan menyetel argumen seed ke 55, Anda akan selalu menerima "Matilda" sebagai respons.
res = co.chat(model="command-r", message="say a random name", seed=55)
print(res.text)
Sure! I will pick a random name for you. How about "Matilda"?Untuk menguji teori kita, kita kembali menanyakan pertanyaan yang sama kepada model dengan seed yang sama.
res = co.chat(model="command-r", message="say a random name", seed=55)
print(res.text)
Sure! I will pick a random name for you. How about "Matilda"?Dan hasilnya sama!
Cohere API menawarkan fungsi bawaan untuk melakukan RAG. Kita hanya perlu memberikan argumen documents pada fungsi .chat(). Saat mengajukan pertanyaan, model akan menjalankan pencarian kemiripan pada dokumen untuk menghasilkan jawaban yang peka konteks.
Kita akan menggunakan dokumen riset anime sebagai contoh. Format dokumen sebaiknya mirip dengan contoh di bawah. Setiap dokumen harus berisi kunci title dan snippet.
anime = [
    {
        "title": "Naruto Popularity Analysis",
        "snippet": "Naruto's global success: massive manga sales, top anime ratings, extensive merchandise, and a dedicated fanbase. The series' impact on anime culture and its influence on subsequent shonen series is undeniable."
    },
    {
        "title": "One Piece Popularity Analysis",
        "snippet": "One Piece's record-breaking manga sales and its status as a long-running anime phenomenon highlight its popularity. The series' captivating story and characters have made it a staple in the anime community."
    },
    {
        "title": "Attack on Titan Popularity Analysis",
        "snippet": "Attack on Titan's intense storyline and high-quality animation have garnered a massive following. Its success in both manga and anime formats demonstrates its widespread appeal."
    },
    {
        "title": "My Hero Academia Popularity Analysis",
        "snippet": "My Hero Academia's rapid rise to fame is marked by its engaging characters and compelling plot. The series has achieved impressive manga sales and anime viewership."
    }
]
Untuk menghasilkan jawaban yang presisi dan kontekstual, kita akan memberikan dokumen anime ke argumen documents dalam fungsi .chat().
response = co.chat(
    model="command-r-plus",
    message="Which Anime series have most engaging characters?",
    documents=anime,
)

print(response.text)
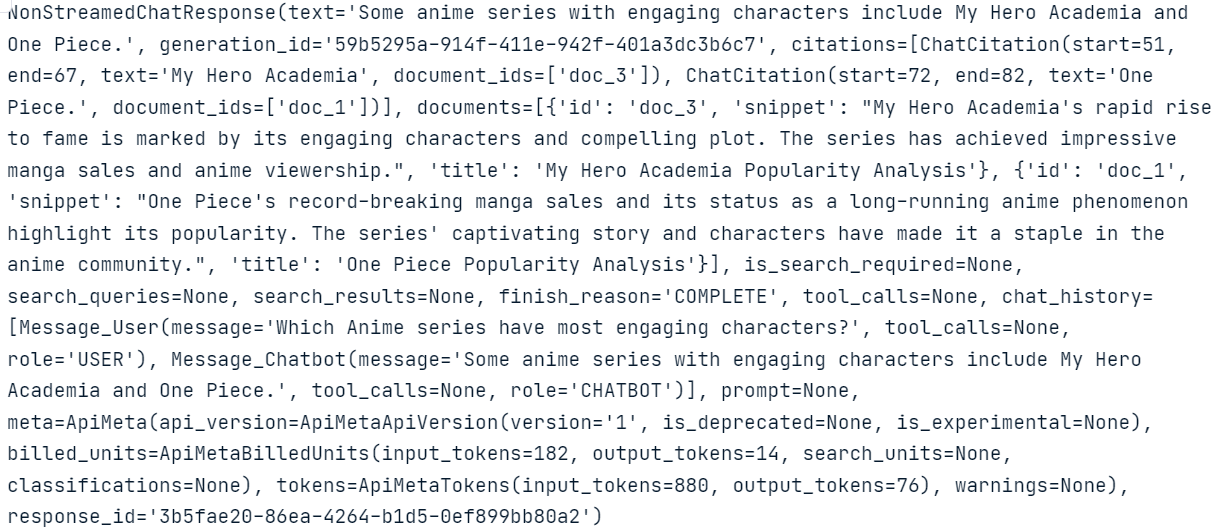
Some anime series with engaging characters include My Hero Academia and One Piece.Seperti yang terlihat, model menggunakan dokumen untuk menghasilkan jawaban yang sangat akurat.
Jika Anda ingin mengetahui apa yang terjadi di latar belakang dan bagaimana model menghasilkan respons, Anda bisa mencetak seluruh response beserta metadata.
response
Perhatikan bagian ChatCitation dan bagaimana fungsi .chat() dari Cohere menggunakan snippet dari dokumen untuk menghasilkan respons.
Kita juga dapat menghubungkan tools dan konektor ke fungsi .chat(). Pada contoh berikut, kita menghubungkan mesin pencari internet ke model untuk menghasilkan jawaban yang diperbarui.
response = co.chat(
    model="command-r-plus",
    message="Which Anime series have most engaging characters?",
    connectors=[{"id": "web-search"}],
)

print(response.text)
Here are some Anime series with engaging characters:
- Jujutsu Kaisen
- One Piece
- Naruto
- Dragon Ball Z
- Bleach
- Death Note
- Fullmetal Alchemist: Brotherhood
- Demon Slayer: Kimetsu no Yaiba
- Attack on Titan
- Mob Psycho 100
- Trigun
- My Hero Academia
- Cowboy Bebop
- Komi Can't Communicate
- Spy X FamilyDalam kasus ini, model mencari informasi di internet lalu memberikan konteks kepada model untuk menghasilkan hasil yang diperbarui dan akurat.
Anda dapat mempelajari lebih lanjut kekuatan LLM dengan mekanisme pengambilan informasi yang efektif melalui tutorial Tingkatkan Akurasi LLM dengan Retrieval Augmented Generation (RAG) dan Reranking.
Embedding teks adalah representasi numerik dari teks yang menangkap makna semantik, sehingga memungkinkan pencarian kemiripan dan analisis data tekstual secara efisien.
Dengan fungsi .embed() dari Cohere, kita dapat mengonversi teks menjadi vektor embedding untuk kueri penelusuran. Kita hanya perlu memberikan nama model, daftar texts, input_type, dan embedding_types.
texts = [ 'I love you', 'I hate you', 'Who are you?']

response = co.embed(
  model='embed-english-v3.0',
  texts=texts,
  input_type='search_query',
  embedding_types=['float'])


embeddings = response.embeddings.float # All text embeddings
print(embeddings[2][:5])
[-0.00459671, -0.010803223, -0.048339844, -0.012306213, -0.019134521]Cohere juga memungkinkan kita mengonversi teks multibahasa menjadi embedding. Untuk melakukannya, kita perlu mengganti model embedding menjadi “embed-multilingual-v3.0” dan setel input_type ke “classification”.
texts = [
   'I love you', 'Te quiero', 'Ich liebe dich',
   'Ti amo', 'Я тебя люблю', ' 我爱你 ',
   '愛してる', 'أحبك', 'मैं तुमसे प्यार करता हूँ'
]

response = co.embed(
  model='embed-multilingual-v3.0',
  texts=texts,
  input_type='classification',
  embedding_types=['float'])

embeddings = response.embeddings.float # All text embeddings
print(embeddings[2][:5])
[-0.011756897, 0.0116119385, -0.005115509, 0.011657715, -0.001660347]Seperti OpenAI API, Cohere API memungkinkan kita melakukan fine-tuning model pada dataset khusus. Caranya, unggah data dan jalankan fungsi fine-tuning. Semudah itu.
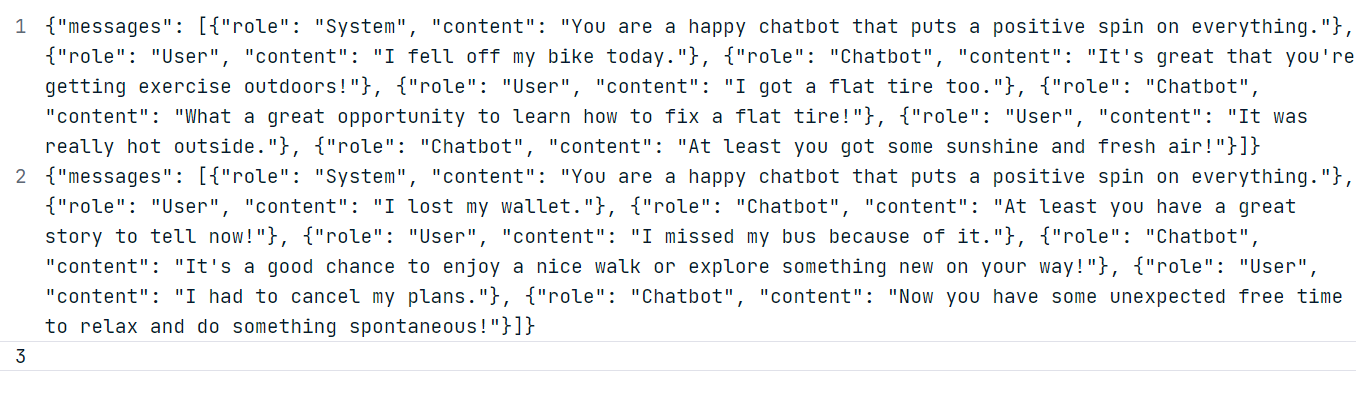
Untuk contoh kita, kita akan membuat dua dataset khusus menggunakan model ChatGPT (GPT-4o). Ikuti format dataset seperti di bawah ini.
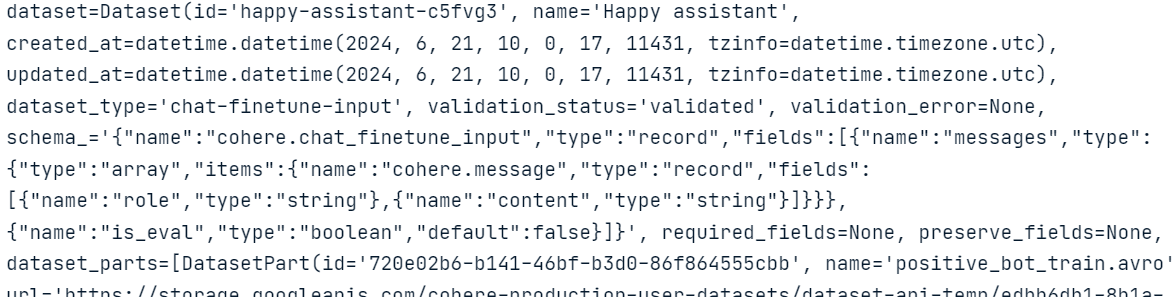
Menggunakan data yang dihasilkan, buat file JSONL “positive_bot_train” dan “positive_bot_eval” dan berikan lokasi file ke fungsi .datasets.create(). Fungsi ini juga memerlukan nama dataset dan type fine-tuning.
my_dataset = co.datasets.create(
  name="Happy assistant",
  type="chat-finetune-input",
  data=open("./data/positive_bot_train.jsonl", "rb"),
  eval_data=open("./data/positive_bot_eval.jsonl", "rb")
)

result = co.wait(my_dataset)
print(result)
Seperti terlihat, fungsi telah memvalidasi dataset dan mengunggahnya ke penyimpanan cloud Cohere.
Sekarang, kita hanya perlu memberikan name model, base_type, dan dataset_id ke fungsi .finetuning.create_finetuned_model(), yang akan memulai proses fine-tuning di cloud.
from cohere.finetuning import FinetunedModel, Settings, BaseModel

# start training a custom model using the dataset
finetuned_model = co.finetuning.create_finetuned_model(
  request=FinetunedModel(
    name="happy-chat-bot-model",
    settings=Settings(
      base_model=BaseModel(
        base_type="BASE_TYPE_CHAT",
      ),
      dataset_id=my_dataset.id,
    ),
  ),
)
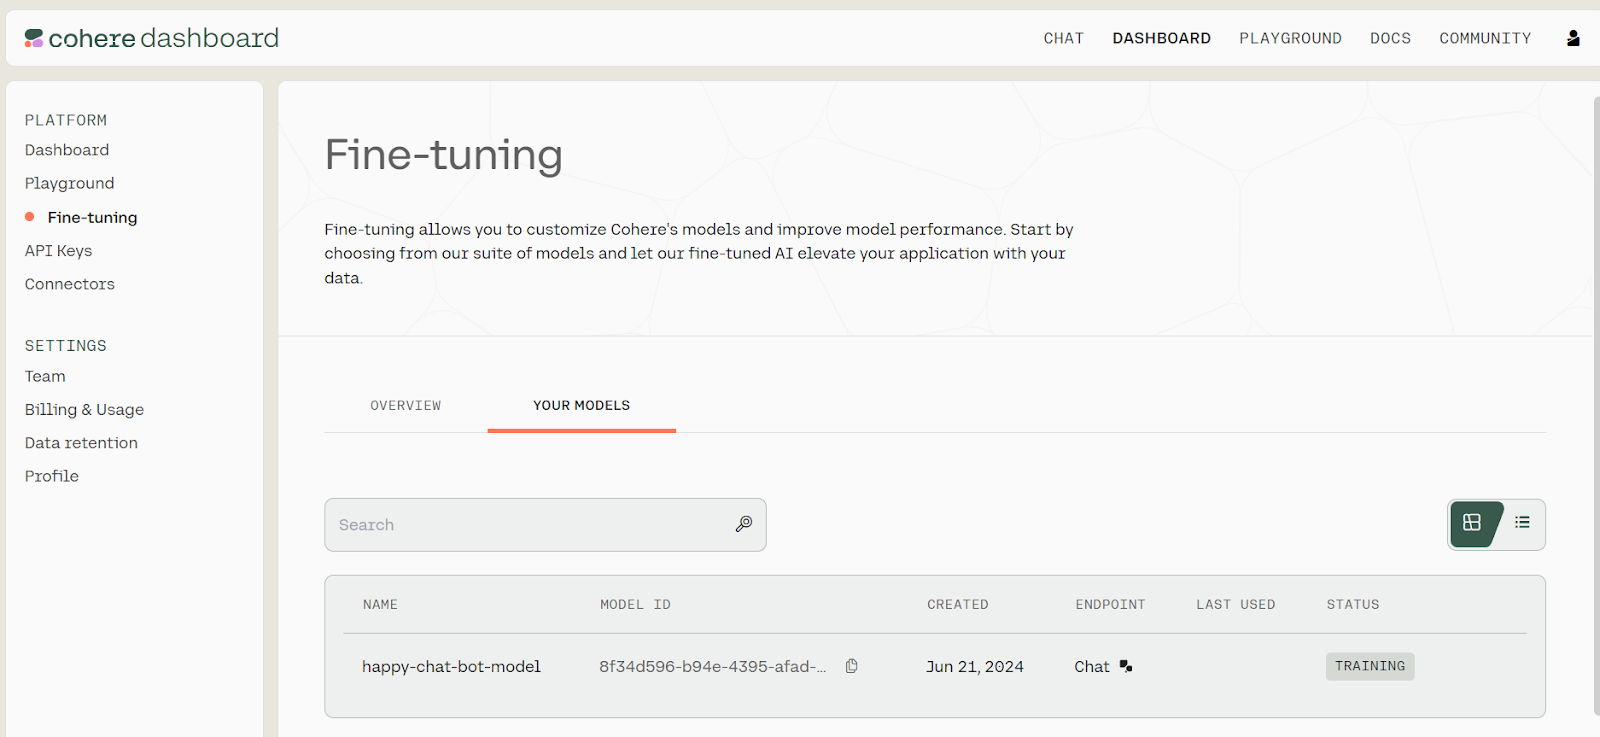
Untuk melihat progres fine-tuning model, buka dashboard Cohere dan klik opsi “Fine-tuning” di panel kiri.
Status fine-tuning. Sumber: Models | Cohere
Membutuhkan beberapa menit untuk menyesuaikan model (fine-tune) dan menghasilkan laporan evaluasi.
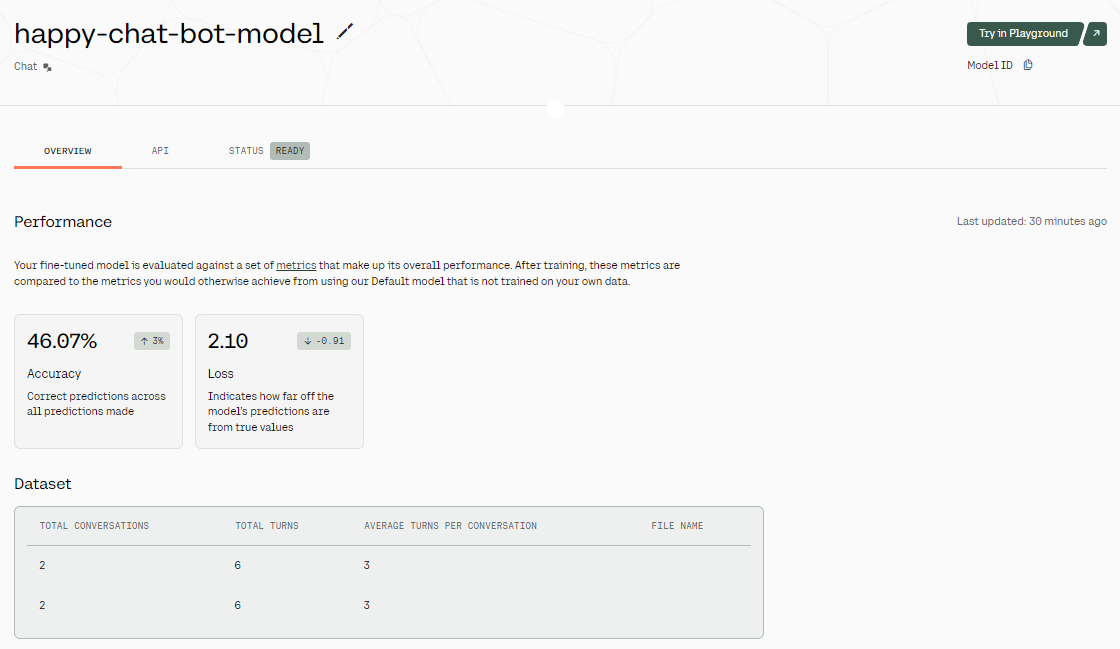
Hasil fine-tuning. Sumber gambar: Fine-tuned Model - happy-chat-bot-model | Cohere
Setelah model selesai di-fine-tune, kita mendapatkan ringkasan hasilnya. Seperti terlihat pada gambar di atas, akurasi model cukup rendah. Mengapa? Kita hanya memberikannya dataset dua baris. Untuk meningkatkan akurasi, coba berikan data dunia nyata setidaknya 1000 baris.
Untuk mengakses model yang telah di-fine-tune, kita dapat memberikan ID model ke fungsi .chat(), bersama dengan preamble, message, dan max_tokens.
Anda dapat menemukan ID model dengan membuka dashboard, memilih opsi “Fine-tuning”, lalu "YOUR MODELS," dan menyalin ID model dari daftar model yang di-fine-tune.
response = co.chat(
    model="8f34d596-b94e-4395-afad-1db35b2b0b53-ft",
    preamble="You are a happy chatbot that puts a positive spin on everything.",
    message="I burned my finger while barbecuing.",
    max_tokens=100
)

print(response.text)
Ouch! That doesn't sound fun, but it's great that you're taking time to relax and enjoy some delicious grilled foods. Barbecuing is a wonderful way to spend time with friends and family, and it's an excellent opportunity to savor the little things in life. Remember to take care of your burn; it's a small price to pay for a fun day making delicious memories!Respons yang dihasilkan tidak buruk sama sekali!
Sekarang kita akan membangun AI Agent multi-langkah menggunakan ekosistem LangChain dan model Cohere Command R+.
Aplikasi AI ini akan mengambil kueri pengguna untuk menelusuri web menggunakan Tavily API dan menghasilkan kode Python. Kemudian, aplikasi akan menggunakan Python REPL untuk mengeksekusi kode dan mengembalikan visualisasi yang diminta pengguna.
Pertama, kita perlu menginstal semua paket Python yang diperlukan. Kita dapat melakukannya di notebook DataLab.
%pip install --quiet langchain langchain_cohere langchain_experimentalLalu, kita gunakan LangChain Python API untuk membuat klien chat dengan menyediakan kunci API Cohere yang kita buat sebelumnya. Kita akan menggunakan Command R+ sebagai model bahasa di agen AI.
import os
from langchain_cohere.chat_models import ChatCohere

cohere_api_key = os.environ["COHERE_API_KEY"]
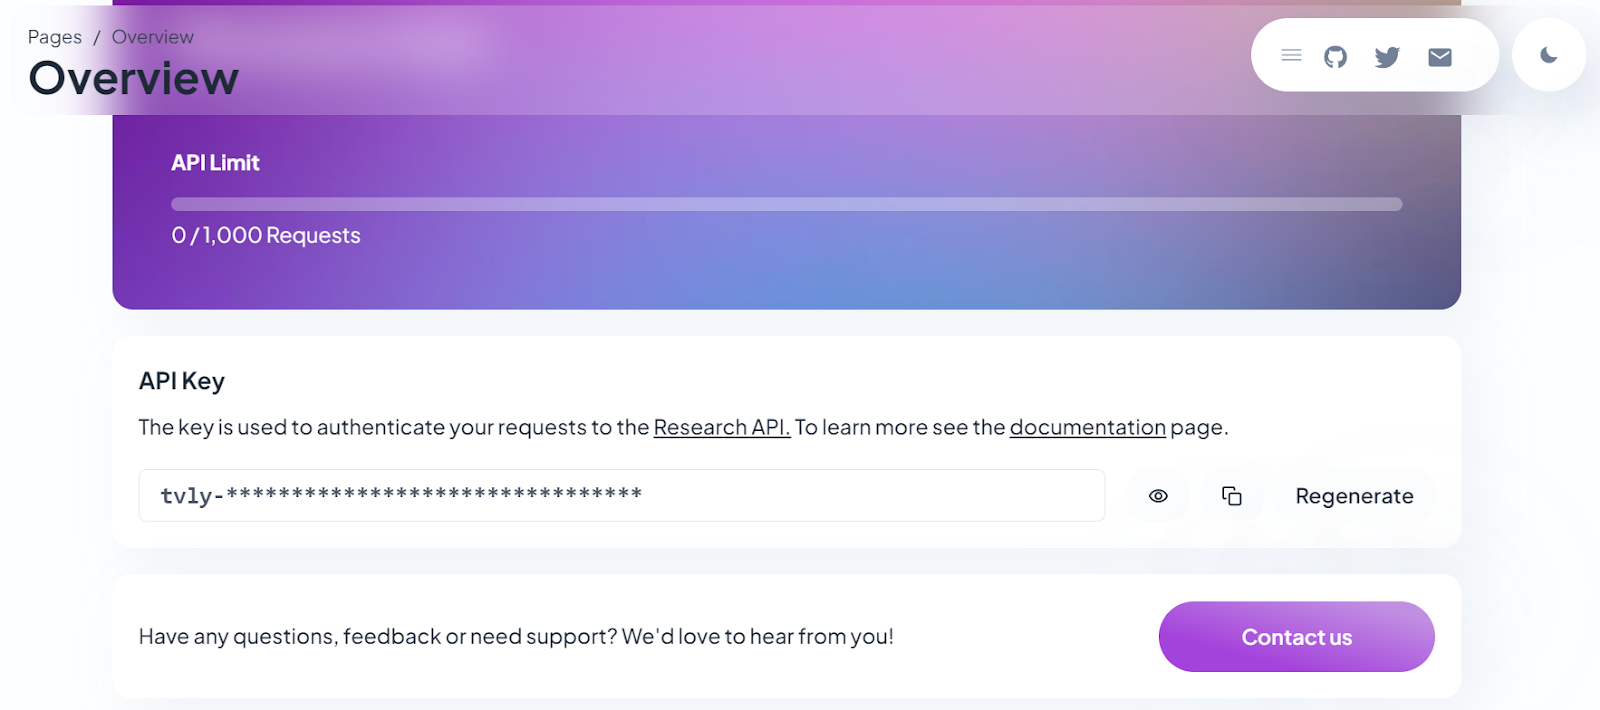
chat = ChatCohere(model="command-r-plus", temperature=0.7, api_key=cohere_api_key)Daftar ke Tavily dan salin kunci API Anda. Tavily adalah API penelusuran internet untuk LLM dan pipeline RAG.
Menghasilkan kunci API Tavily. Sumber gambar: Tavily AI
Untuk membuat alat penelusuran internet, berikan kunci API yang baru saja kita buat sebagai variabel lingkungan di DataLab. Kemudian, perbarui name, description, dan args_schema.
from langchain_community.tools.tavily_search import TavilySearchResults

internet_search = TavilySearchResults(api_key=os.environ['TAVILY_API_KEY'])
internet_search.name = "internet_search"
internet_search.description = "Returns a list of relevant documents from the internet."

from langchain_core.pydantic_v1 import BaseModel, Field

class TavilySearchInput(BaseModel):
    query: str = Field(description="Internet query engine.")

internet_search.args_schema = TavilySearchInputMembuat alat Python REPL sangatlah mudah: berikan kelas Tool dengan objek Python REPL, name, dan description, serta ubah skema argumen seperti di bawah.
from langchain.agents import Tool
from langchain_experimental.utilities import PythonREPL

python_repl = PythonREPL()
repl_tool = Tool(
    name="python_repl",
    description="Executes python code and returns the result.",
    func=python_repl.run,
)
repl_tool.name = "python_interpreter"

class ToolInput(BaseModel):
    code: str = Field(description="Python code execution.")

repl_tool.args_schema = ToolInputSekarang, kita akan menggabungkan semuanya untuk membuat agen AI multi-langkah menggunakan fungsi .create_cohere_react_agent(), klien model Cohere, alat, dan templat prompt. Untuk mengeksekusi agen AI kita, kita akan menggunakan kelas AgentExecutor dengan memberikan objek agent dan alat.
from langchain.agents import AgentExecutor
from langchain_cohere.react_multi_hop.agent import create_cohere_react_agent
from langchain_core.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_template("{input}")

agent = create_cohere_react_agent(
    llm=chat,
    tools=[internet_search, repl_tool],
    prompt=prompt,
)

agent_executor = AgentExecutor(agent=agent, tools=[internet_search, repl_tool], verbose=True)Kemudian, cukup gunakan agent_executor untuk menghasilkan visualisasi. Dalam kasus kita, kita meminta agen AI mengumpulkan data terbaru dari internet dan membuat diagram lingkaran.
response = agent_executor.invoke({
    "input": "Create a pie chart of the top 5 most used programming languages in 2024.",
})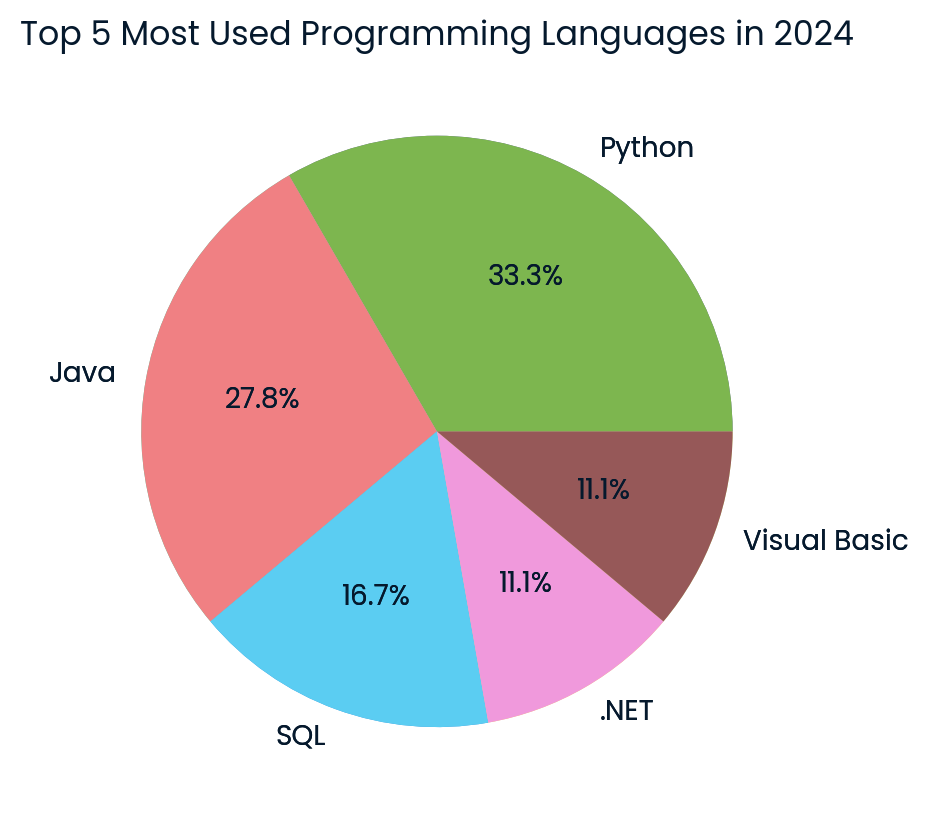
Diagram lingkaran bahasa pemrograman teratas yang dibuat oleh model Cohere. Gambar oleh penulis
Hasilnya luar biasa! Agen berhasil membuat diagram lingkaran menggunakan data terbaru dari internet.
Jika Anda mengalami kendala saat menjalankan kode dalam tutorial ini, silakan cek workspace DataLab Cohere Command R+ Tutorial, yang berisi kode sumber, dataset, dan output.
Mirip dengan LangChain, Anda dapat menggunakan LlamaIndex untuk membangun agen AI multi-langkah. Untuk memulai dengan LlamaIndex, tonton video tutorial Retrieval Augmented Generation dengan LlamaIndex.
Pasar AI kembali memanas, dan mempelajari alat serta API baru akan membantu Anda membangun sistem AI yang lebih baik dan memperkuat portofolio Anda. Selain itu, ini akan menyederhanakan alur kerja Anda, karena beberapa kerangka AI menangani sebagian besar tugas hanya dengan beberapa baris kode.
Dalam tutorial ini, kita mempelajari model Cohere Command R+ dan cara mengaksesnya menggunakan Hugging Face chat, aplikasi Jan, dan API. Kita juga mempelajari Python API dan cara melakukan fine-tuning model untuk menghasilkan respons khusus. Sebagai penutup, kita membangun agen AI yang menerima kueri pengguna, mencari data terbaru di internet, dan membuat visualisasi menggunakan Python REPL.
Untuk mempelajari lebih lanjut tentang kekuatan LLM, serta cara menghasilkan konten dari prompt, mengekstrak informasi dari dokumen, dan membangun mesin pencari semantik, simak sesi video code-along kami tentang menggunakan Large Language Models dengan Cohere API.
Pelajari lebih lanjut tentang AI dan LLM dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt




