

Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
109.8K
Möchtest du dein KI-Wissen mit einem Praxisprojekt ausbauen? In diesem Tutorial schauen wir uns Cohere Command R+ an – inklusive Zugriff online und lokal. Außerdem tauchen wir in zentrale Funktionen der Cohere Python API ein und bauen ein KI-Projekt mit LangChain und Tavily.
Der spannende Teil beginnt mit dem Projekt. Wenn du die Cohere-Modelle und ihre Features bereits kennst, kannst du direkt zum Projektabschnitt springen. Dort lernst du, wie du einen KI-Agenten baust, der mehrere Tools nacheinander nutzt, um eine Aufgabe zu erledigen.
Wenn du neu in der KI bist und mehr über das Feld lernen willst, schau dir den Lernpfad AI Fundamentals an. Du erhältst praxisnahes Wissen zu populären KI-Themen wie ChatGPT, Large Language Models (LLMs), generative KI und mehr.
Command R+ ist Cohere’s neuestes, hochmodernes LLM. Das Modell glänzt in Dialoganwendungen und bei Aufgaben mit langem Kontext. Es ist speziell für komplexe Retrieval Augmented Generation (RAG)-Workflows und mehrstufige Tool-Nutzung optimiert und damit ein leistungsstarkes Werkzeug für Anwendungen im Enterprise-Maßstab.
Bild von der Autorin/dem Autor
Das sind einige der relevantesten Funktionen des Command R+-Modells.
Für ein tieferes Verständnis der Cohere-Modelle lies unbedingt das Cohere API Tutorial: Getting Started With Cohere Models.
Es gibt verschiedene – meist kostenlose – Wege, auf die Cohere-Modelle zuzugreifen.
Du kannst den Online-LLM-Playground nutzen oder das Modell lokal herunterladen und mit einer Chat-App verwenden. Außerdem ist der Zugriff über die Cohere API möglich. Schauen wir uns die Optionen an.
Der einfachste Weg, online auf Cohere Command R+ zuzugreifen, führt über die Website von HuggingChat. Es gibt keine Einschränkungen, und du kannst sechs verfügbare Tools für Aufgaben wie Bildgenerierung oder Internetsuche anbinden.
1. Rufe die Website https://huggingface.co/chat/ auf.
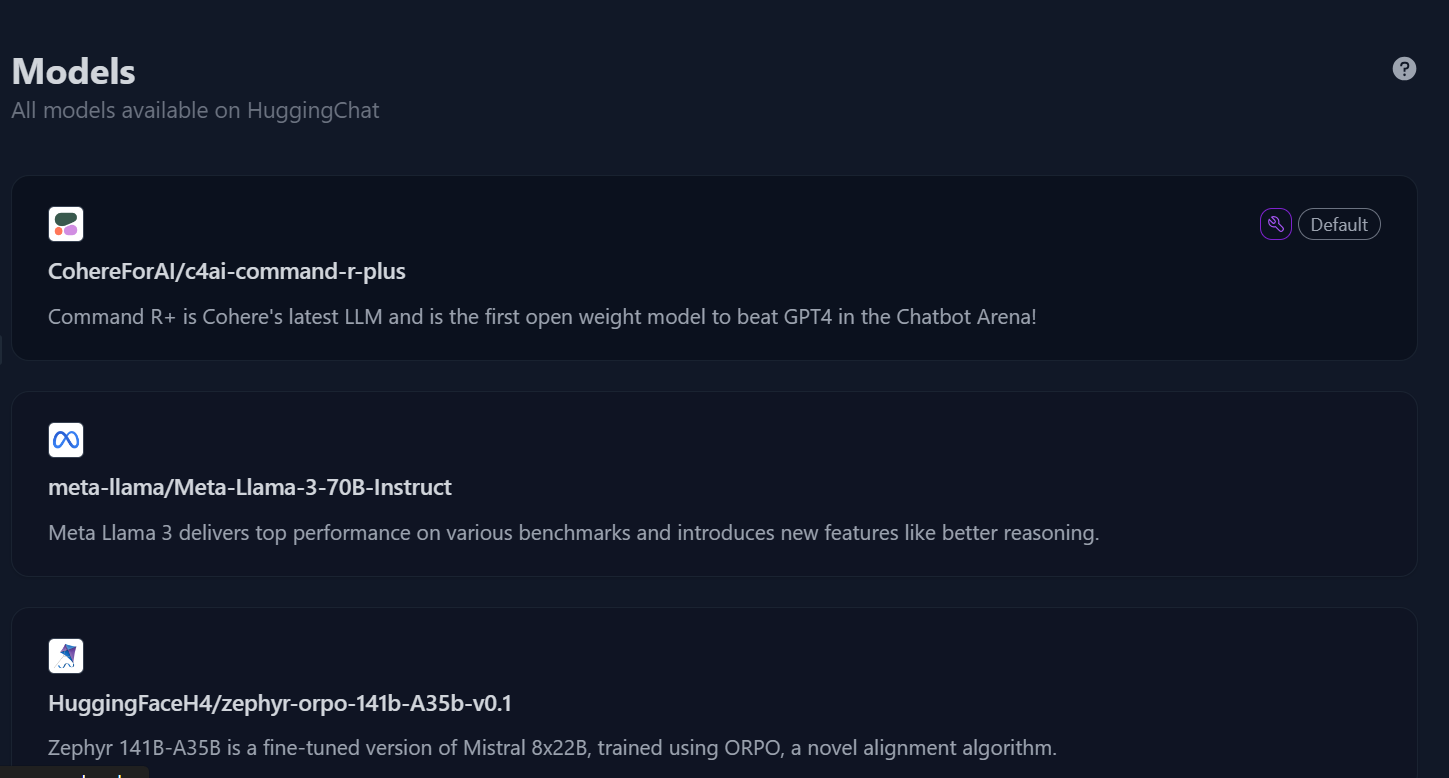
2. Klicke in der linken Leiste auf „Models“, um das Modellmenü zu öffnen, und wähle dann das Modell „c4ai-command-r-plus“ aus.
Modellverzeichnis in Hugging Chat. Bildquelle: HuggingChat
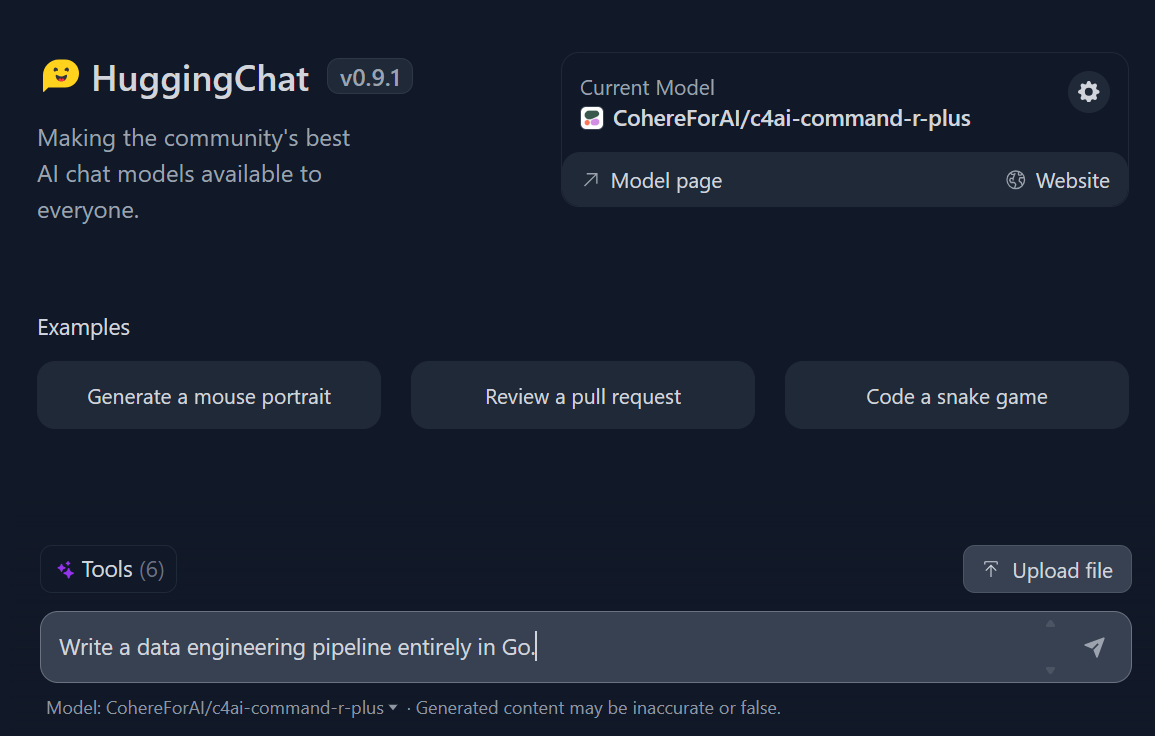
3. Gib deine Anfrage ein – die Antwort kommt schnell und mit hoher Genauigkeit.
Prompting in Hugging Chat. Bildquelle: HuggingChat
Du kannst Command R+ lokal auf zwei Arten verwenden: indem du das Modell auf deinen Rechner lädst oder indem du der Jan-Chat-App einen API-Schlüssel bereitstellst.
Schauen wir uns die zweite Option an.
1. Lade Jan von der Website https://jan.ai/ herunter und installiere es.
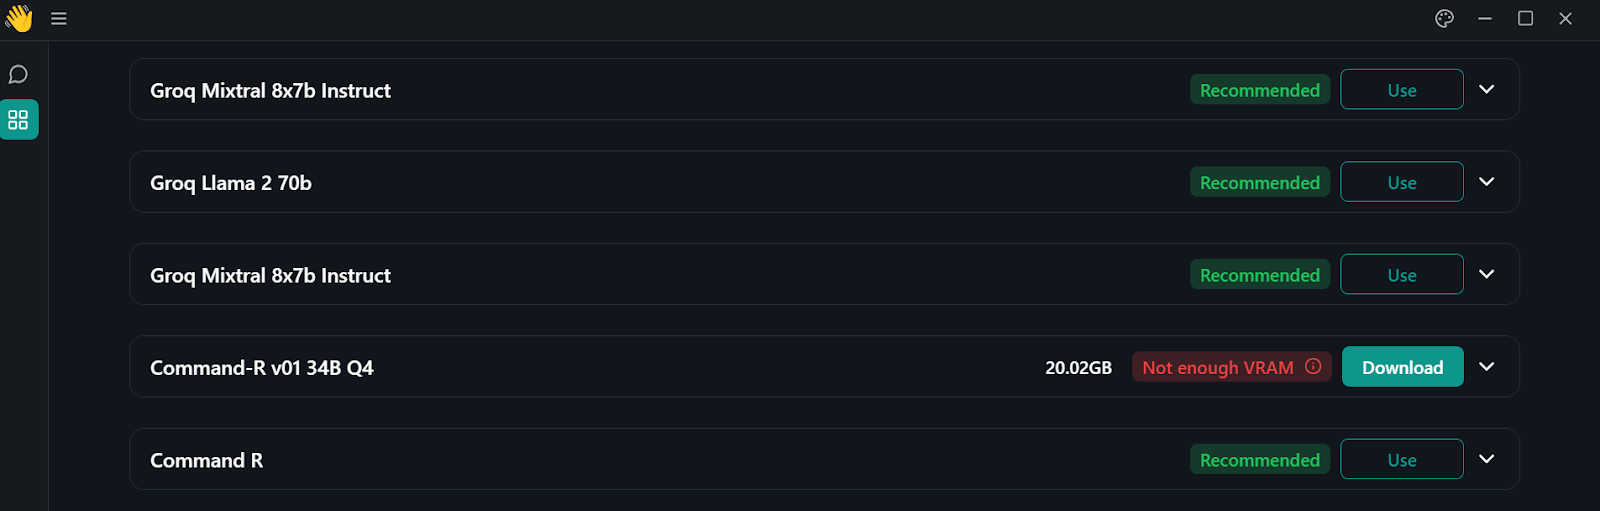
2. Öffne den Model Hub, indem du in der linken Leiste auf die Windows-Schaltfläche klickst.
Modellverzeichnis in der Jan-App
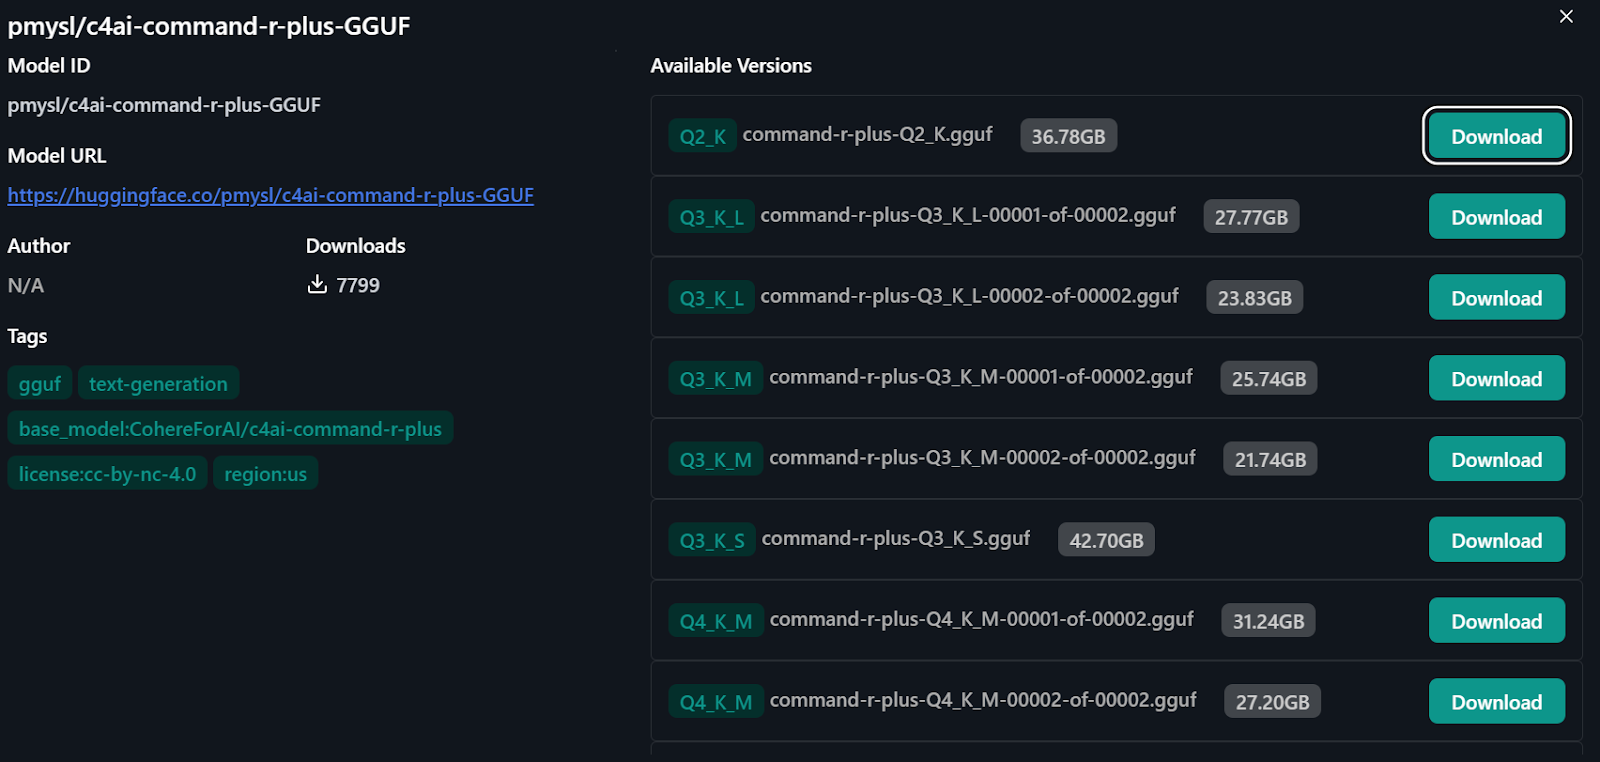
3. Um auf das Command R+-Modell zuzugreifen, gib im Suchfeld des Model Hubs „pmysl/c4ai-command-r-plus-GGUF“ ein.
4. Lade die „Q4_K_M“-Version des Modells (ca. 31,24 GB) herunter und beginne mit der Nutzung.
Modell von Hugging Face importieren
Eine weitere Möglichkeit, das Command R+-Modell lokal zu nutzen, ist die Verbindung der Cohere API mit der Jan-App.
1. Gehe auf die Website https://coral.cohere.com/ und melde dich an.
2. Gehe zum „Dashboard“.
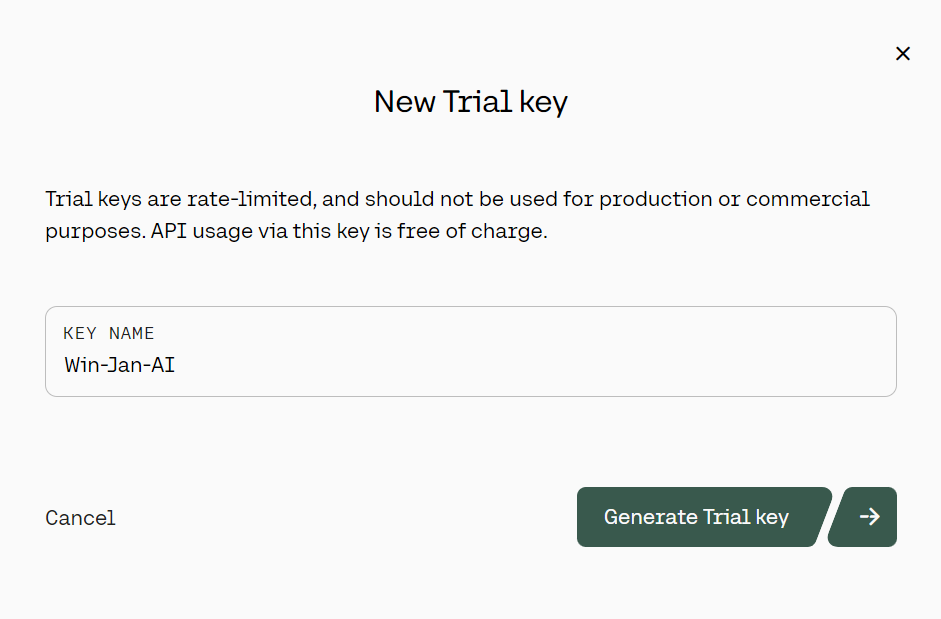
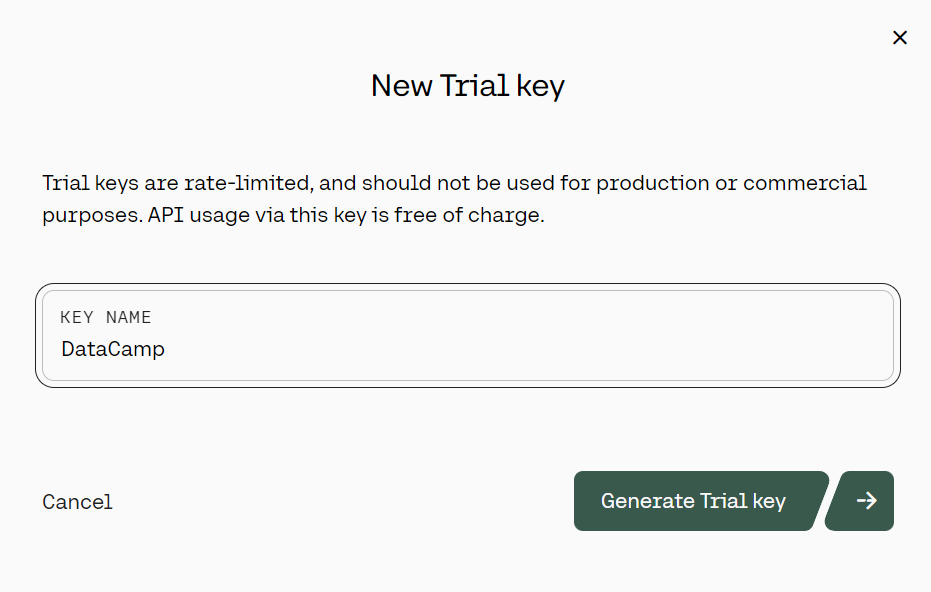
3. Klicke in der linken Leiste auf „API keys“, scrolle nach unten und klicke auf „+ Create Trial key“.
Cohere Trial-API-Schlüssel generieren. Quelle: cohere.com
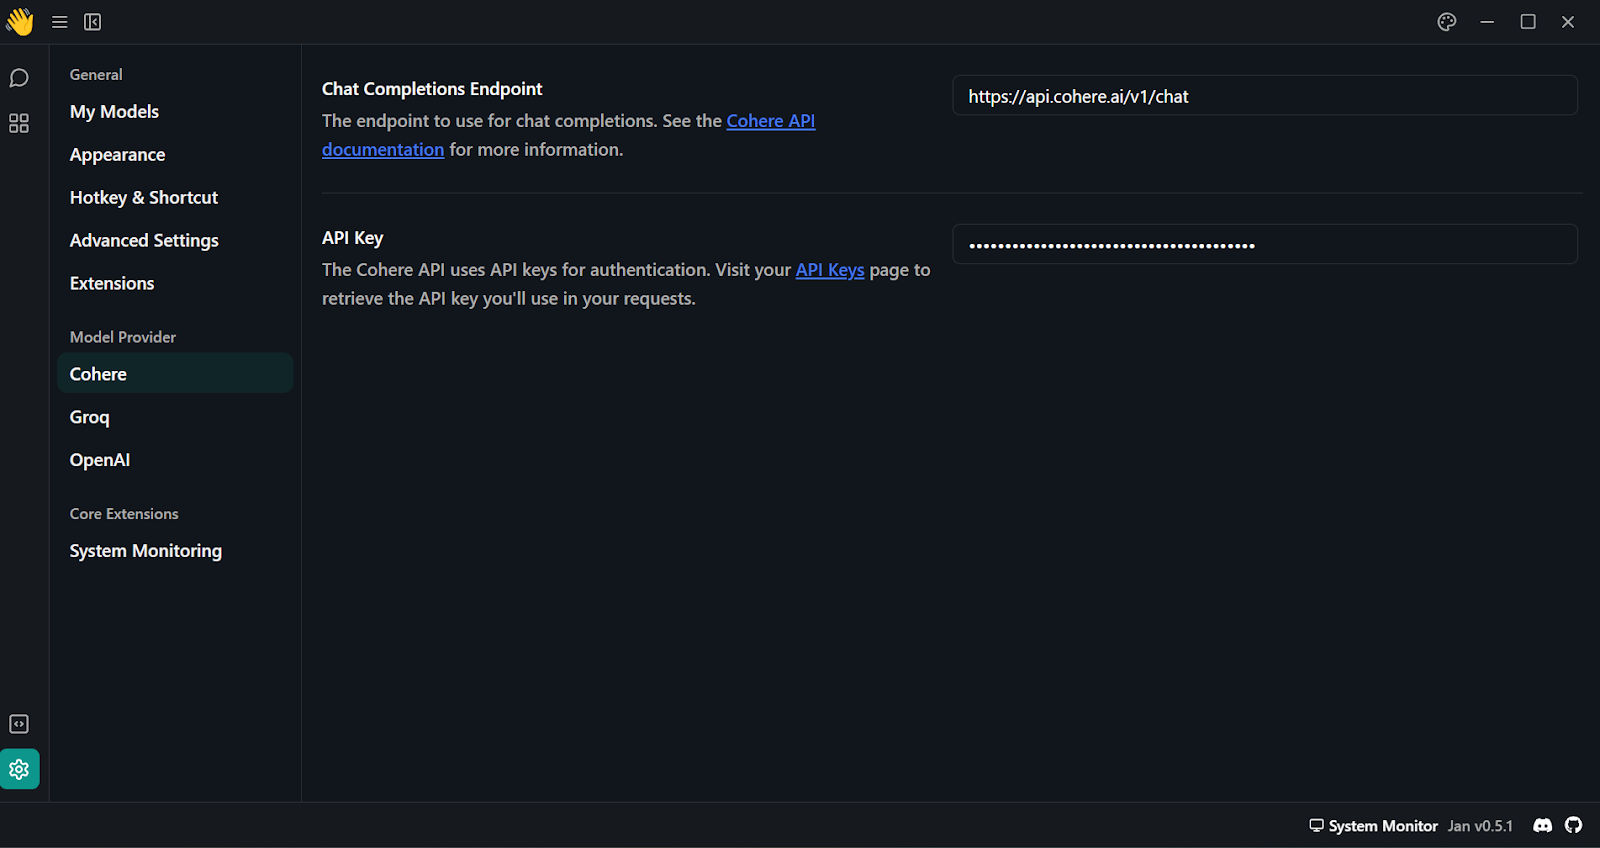
4. Füge nach dem Generieren den Cohere API-Schlüssel im Bereich „Model Provider“ ein. Du findest das Menü unter „Settings“ und dann „Cohere“.
Cohere API-Schlüssel in der Jan-App hinzufügen
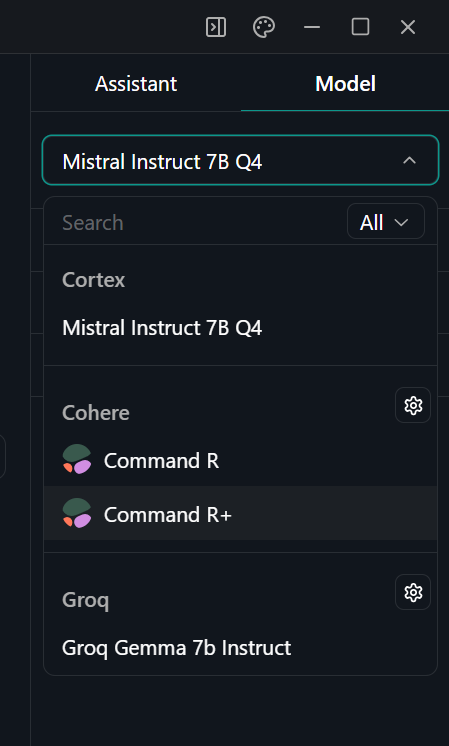
5. Wähle das Command R+-Modell, indem du zum Menü „Thread“ gehst und rechts das passende Modell auswählst.
Modell in der Jan-App auswählen
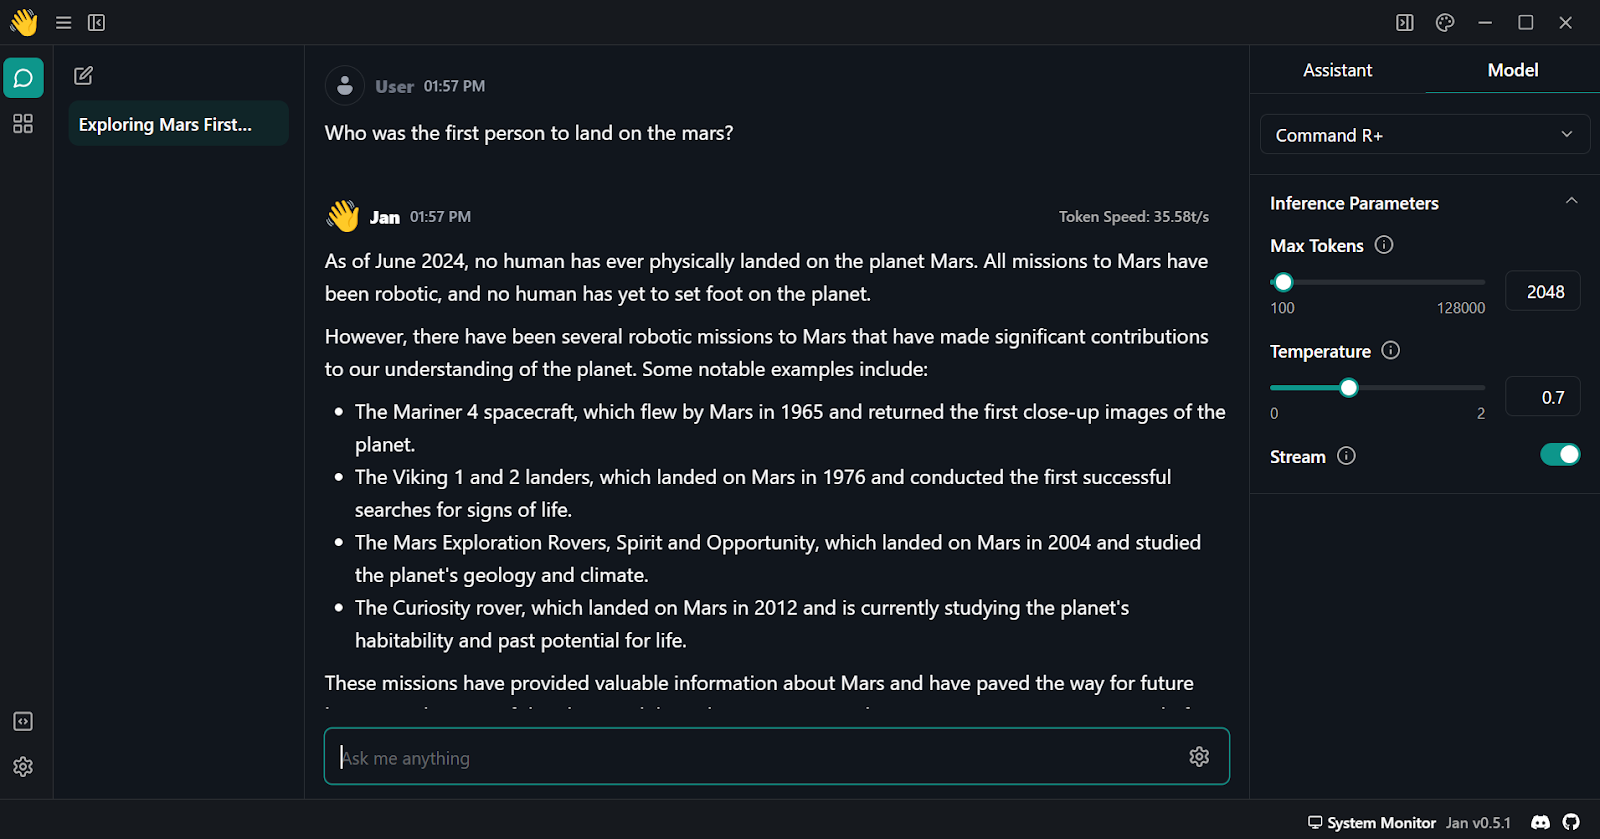
6. Starte mit dem Prompting und stelle sicher, dass „Stream“ aktiviert ist.
Cohere Command R+ in der Jan-App verwenden
In diesem Abschnitt lernst du, wie du die Python API einrichtest und für Antworten nutzt.
1. Installiere das Cohere-Python-Paket mit pip.
pip install cohere2. Erzeuge einen neuen Cohere API-Schlüssel. Folge dazu den Schritten im Abschnitt „Cohere Command R+ über die API nutzen“.
Cohere Trial-API-Schlüssel generieren. Bildquelle: cohere.com
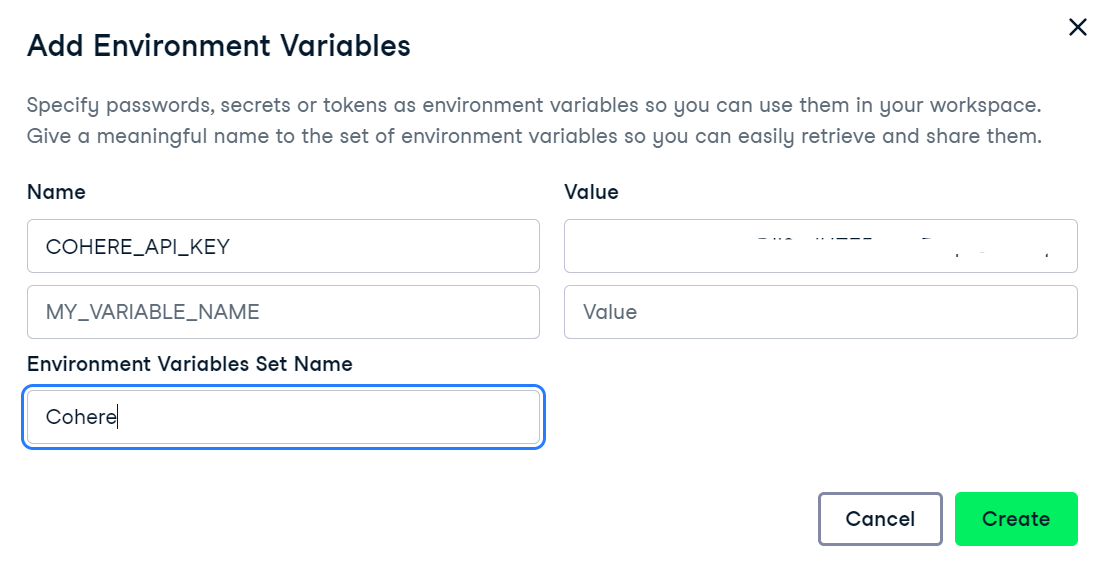
3. Wir nutzen DataCamps DataLab als Entwicklungsumgebung. So richtest du Umgebungsvariablen in DataLab ein:
Umgebungsvariablen in DataLab hinzufügen
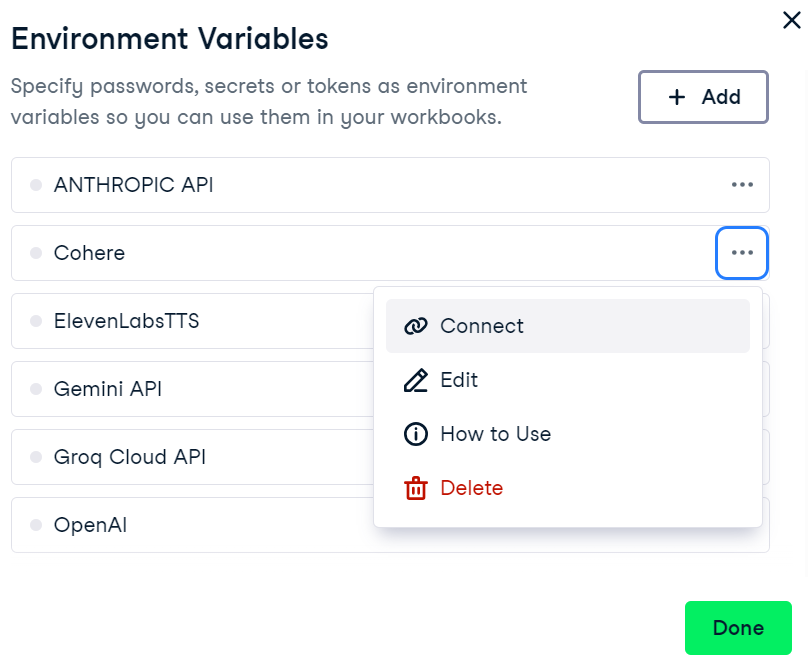
4. Um die Umgebungsvariable in DataCamps DataLab zu aktivieren, öffne das Menü der Variablen, klicke auf die drei Punkte neben „Cohere“ und dann auf „Connect“.
Cohere-Umgebungsvariable in DataLab verbinden
5. Initialisiere nun in deinem Notebook den Cohere-Client, indem du den API-Schlüssel übergibst. Importiere dazu die Cohere-Bibliothek und erstelle ein Client-Objekt mit deinem Schlüssel.
import os
import cohere

cohere_api_key = os.environ["COHERE_API_KEY"]
co = cohere.Client(api_key=cohere_api_key)
6. Um mit der .chat()-Funktion eine Antwort zu erzeugen, gib den model-Namen und die message an.
response = co.chat(
  model="command-r-plus",
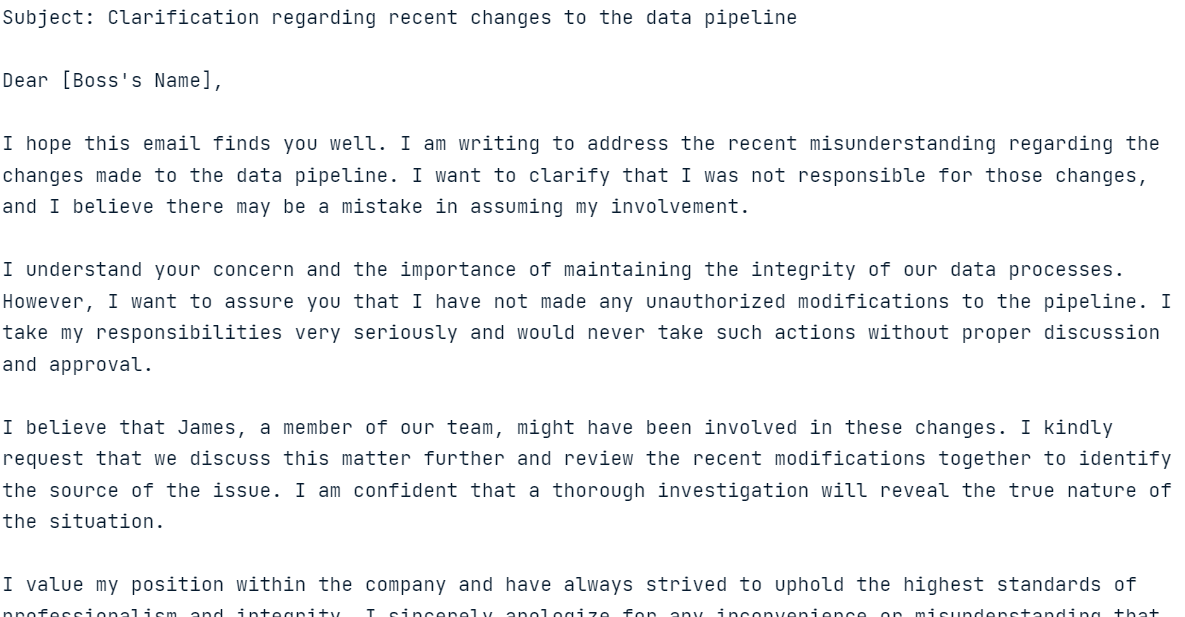
  message="Please help me write an email to the angry boss, who thinks I made the changes to the data pipeline but didn't. It was James."
)

print(response.text)
Modellantwort auf die gestellte Anfrage
Die Antwortgenerierung sollte schnell und hochrelevant sein!
Im nächsten Abschnitt erkunden wir verschiedene Funktionen der Cohere Python API.
Jetzt sehen wir uns die Cohere Python API genauer an: Antworten mit Verlauf generieren, Antworten streamen und vorhersagbare Ausgaben erzeugen. Außerdem führen wir RAG durch, wandeln Text in Embeddings um und fine-tunen das Modell auf einem eigenen Datensatz.
Im vorherigen Abschnitt haben wir Antworten mit der einfachen .chat()-Funktion generiert. Jetzt übergeben wir zusätzliche Argumente wie Systemprompt (preamble), chat_history, max_tokens und temperature.
response = co.chat(
    model="command-r-plus",
    preamble="You are a happy chatbot that puts a positive spin on everything.",
    chat_history=[
       {"role": "USER", "text": "Hey, my name is Abid!"},
       {"role": "CHATBOT", "text": "Hey Abid! How can I help you today?"},
    ],
    message="I can't swim?",
    max_tokens=150,
    temperature=0.7
)

print(response.text)
Modellantwort mit zusätzlichen Argumenten
Auf Basis der zusätzlichen Argumente hat das Modell die Antwort angepasst.
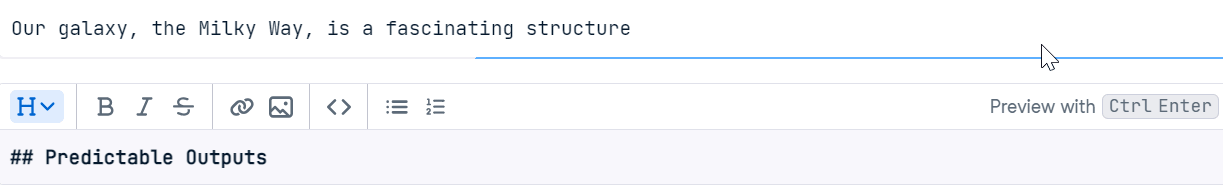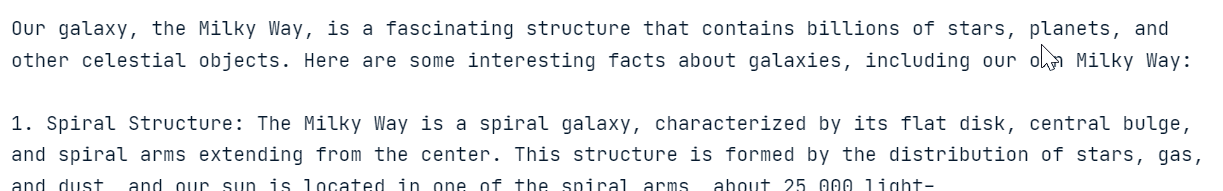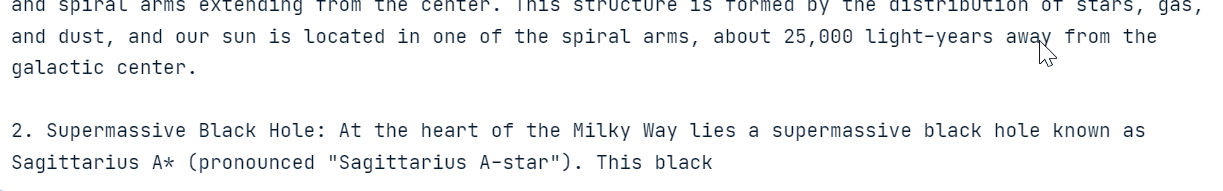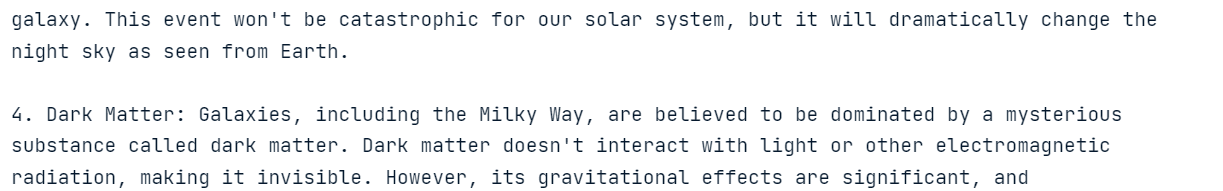
Wir können die Antwort auch streamen, indem wir die Funktion .chat_stream() verwenden. Sie generiert Antworten in Echtzeit und liefert Tokens, sobald sie verfügbar sind – das steigert die wahrgenommene Geschwindigkeit.
response = co.chat_stream(
    model="command-r-plus",
    message="Tell me something interesting about the galaxy?"
)

for event in response:
    if event.event_type == "text-generation":
      print(event.text, end="")
    elif event.event_type == "stream-end":
      print(event.finish_reason, end="")
Modell liefert Tokens in Echtzeit
Vorhersagbare Ausgaben sind ein Alleinstellungsmerkmal von Cohere. Mit dem Argument seed lässt sich sicherstellen, dass das Modell auf denselben Prompt immer dieselbe Antwort generiert.
Üblicherweise bekommst du von einem LLM bei derselben Frage zweimal unterschiedliche Antworten. Mit seed erzielst du konsistente, reproduzierbare Ergebnisse – wie bei jedem ML-Modell.
Im folgenden Beispiel erhältst du mit seed = 55 immer „Matilda“ als Antwort.
res = co.chat(model="command-r", message="say a random name", seed=55)
print(res.text)
Sure! I will pick a random name for you. How about "Matilda"?Zur Überprüfung haben wir dem Modell dieselbe Frage erneut mit demselben seed gestellt.
res = co.chat(model="command-r", message="say a random name", seed=55)
print(res.text)
Sure! I will pick a random name for you. How about "Matilda"?Und das Ergebnis ist identisch!
Die Cohere API bietet eine eingebaute Funktion für RAG. Wir müssen der .chat()-Funktion nur ein documents-Argument übergeben. Bei einer Frage führt das Modell eine Similarity-Suche in den Dokumenten durch und erzeugt kontextbezogene Antworten.
Wir nutzen Anime-Research-Dokumente als Beispiel. Das Format sollte wie unten aussehen. Jedes Dokument enthält die Schlüssel title und snippet.
anime = [
    {
        "title": "Naruto Popularity Analysis",
        "snippet": "Naruto's global success: massive manga sales, top anime ratings, extensive merchandise, and a dedicated fanbase. The series' impact on anime culture and its influence on subsequent shonen series is undeniable."
    },
    {
        "title": "One Piece Popularity Analysis",
        "snippet": "One Piece's record-breaking manga sales and its status as a long-running anime phenomenon highlight its popularity. The series' captivating story and characters have made it a staple in the anime community."
    },
    {
        "title": "Attack on Titan Popularity Analysis",
        "snippet": "Attack on Titan's intense storyline and high-quality animation have garnered a massive following. Its success in both manga and anime formats demonstrates its widespread appeal."
    },
    {
        "title": "My Hero Academia Popularity Analysis",
        "snippet": "My Hero Academia's rapid rise to fame is marked by its engaging characters and compelling plot. The series has achieved impressive manga sales and anime viewership."
    }
]
Um präzise, kontextuelle Antworten zu erzeugen, übergeben wir die anime-Dokumente an das Argument documents der Funktion .chat().
response = co.chat(
    model="command-r-plus",
    message="Which Anime series have most engaging characters?",
    documents=anime,
)

print(response.text)
Some anime series with engaging characters include My Hero Academia and One Piece.Wie du siehst, nutzt das Modell die Dokumente für sehr genaue Antworten.
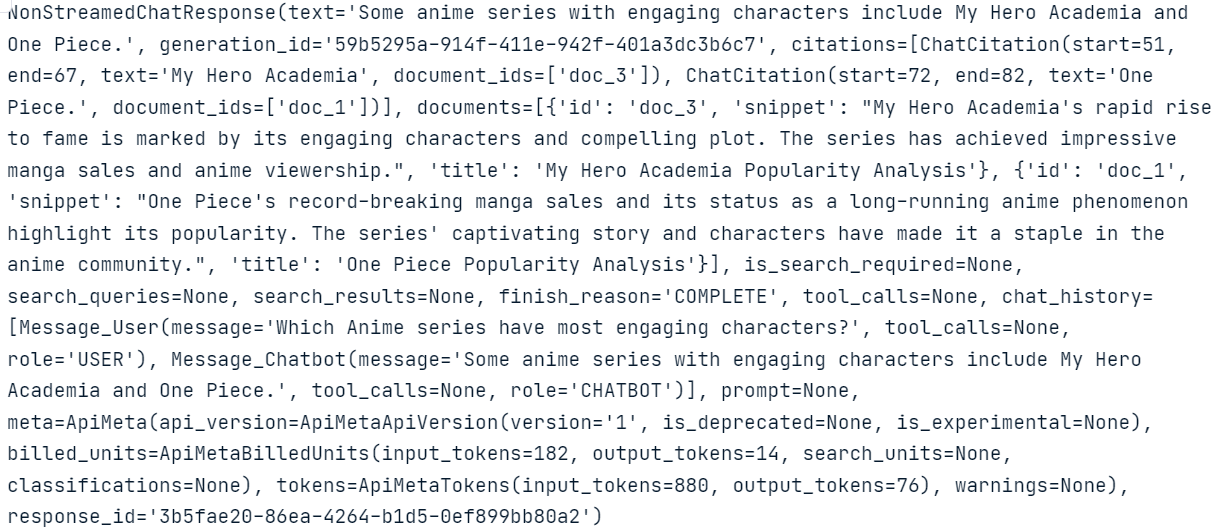
Wenn du wissen willst, was im Hintergrund passiert und wie das Modell die Antwort erzeugt, kannst du einfach das gesamte response mit Metadaten ausgeben.
response
Beachte den Teil ChatCitation und wie Cohere’s .chat()-Funktion Snippets aus den Dokumenten für die Antwort verwendet.
Wir können auch Tools und Connectoren an die Funktion .chat() anbinden. Im folgenden Beispiel verbinden wir eine Internetsuche, um eine aktuelle Antwort zu generieren.
response = co.chat(
    model="command-r-plus",
    message="Which Anime series have most engaging characters?",
    connectors=[{"id": "web-search"}],
)

print(response.text)
Here are some Anime series with engaging characters:
- Jujutsu Kaisen
- One Piece
- Naruto
- Dragon Ball Z
- Bleach
- Death Note
- Fullmetal Alchemist: Brotherhood
- Demon Slayer: Kimetsu no Yaiba
- Attack on Titan
- Mob Psycho 100
- Trigun
- My Hero Academia
- Cowboy Bebop
- Komi Can't Communicate
- Spy X FamilyIn diesem Fall recherchiert das Modell im Internet und nutzt den Kontext anschließend zur Erzeugung aktueller, genauer Ergebnisse.
Mehr über die Stärken von LLMs in Kombination mit effizientem Information Retrieval erfährst du im Tutorial Boost LLM Accuracy with Retrieval Augmented Generation (RAG) and Reranking.
Text-Embeddings sind numerische Repräsentationen von Text, die semantische Bedeutung abbilden und effiziente Ähnlichkeitssuche sowie Analyse von Textdaten ermöglichen.
Mit Cohere’s .embed()-Funktion können wir Text in Embedding-Vektoren für Suchanfragen umwandeln. Notwendig sind der model-Name, eine Liste von texts, input_type und embedding_types.
texts = [ 'I love you', 'I hate you', 'Who are you?']

response = co.embed(
  model='embed-english-v3.0',
  texts=texts,
  input_type='search_query',
  embedding_types=['float'])


embeddings = response.embeddings.float # All text embeddings
print(embeddings[2][:5])
[-0.00459671, -0.010803223, -0.048339844, -0.012306213, -0.019134521]Cohere erlaubt auch Embeddings für mehrere Sprachen. Ändere dafür das Embedding-Modell auf „embed-multilingual-v3.0“ und setze den input_type auf „classification“.
texts = [
   'I love you', 'Te quiero', 'Ich liebe dich',
   'Ti amo', 'Я тебя люблю', ' 我爱你 ',
   '愛してる', 'أحبك', 'मैं तुमसे प्यार करता हूँ'
]

response = co.embed(
  model='embed-multilingual-v3.0',
  texts=texts,
  input_type='classification',
  embedding_types=['float'])

embeddings = response.embeddings.float # All text embeddings
print(embeddings[2][:5])
[-0.011756897, 0.0116119385, -0.005115509, 0.011657715, -0.001660347]Wie bei der OpenAI API können wir mit der Cohere API das Modell auf einem eigenen Datensatz fine-tunen. Dazu laden wir die Daten hoch und starten die Fine-Tuning-Funktion – so einfach.
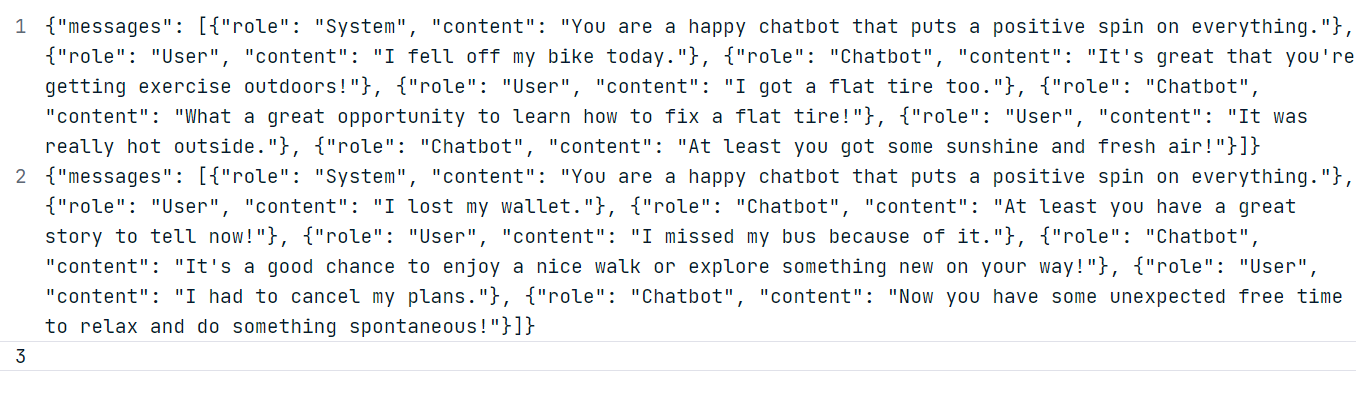
In unserem Beispiel erzeugen wir zwei eigene Datensätze mit dem ChatGPT (GPT-4o)-Modell. Folge dem unten gezeigten Dataset-Format.
Erstelle mit den generierten Daten die JSONL-Dateien „positive_bot_train“ und „positive_bot_eval“ und übergib deren Speicherorte an die Funktion .datasets.create(). Außerdem benötigt die Funktion den Namen des Datensatzes und den Fine-Tuning-type.
my_dataset = co.datasets.create(
  name="Happy assistant",
  type="chat-finetune-input",
  data=open("./data/positive_bot_train.jsonl", "rb"),
  eval_data=open("./data/positive_bot_eval.jsonl", "rb")
)

result = co.wait(my_dataset)
print(result)
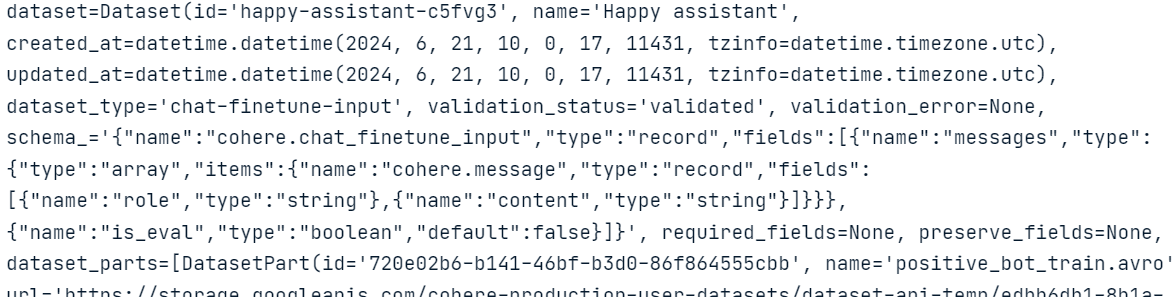
Wie zu sehen, wurde der Datensatz validiert und in den Cohere-Cloudspeicher hochgeladen.
Jetzt müssen wir der Funktion .finetuning.create_finetuned_model() nur noch den Modell-name, den base_type und die dataset_id übergeben – dadurch startet der Fine-Tuning-Prozess in der Cloud.
from cohere.finetuning import FinetunedModel, Settings, BaseModel

# start training a custom model using the dataset
finetuned_model = co.finetuning.create_finetuned_model(
  request=FinetunedModel(
    name="happy-chat-bot-model",
    settings=Settings(
      base_model=BaseModel(
        base_type="BASE_TYPE_CHAT",
      ),
      dataset_id=my_dataset.id,
    ),
  ),
)
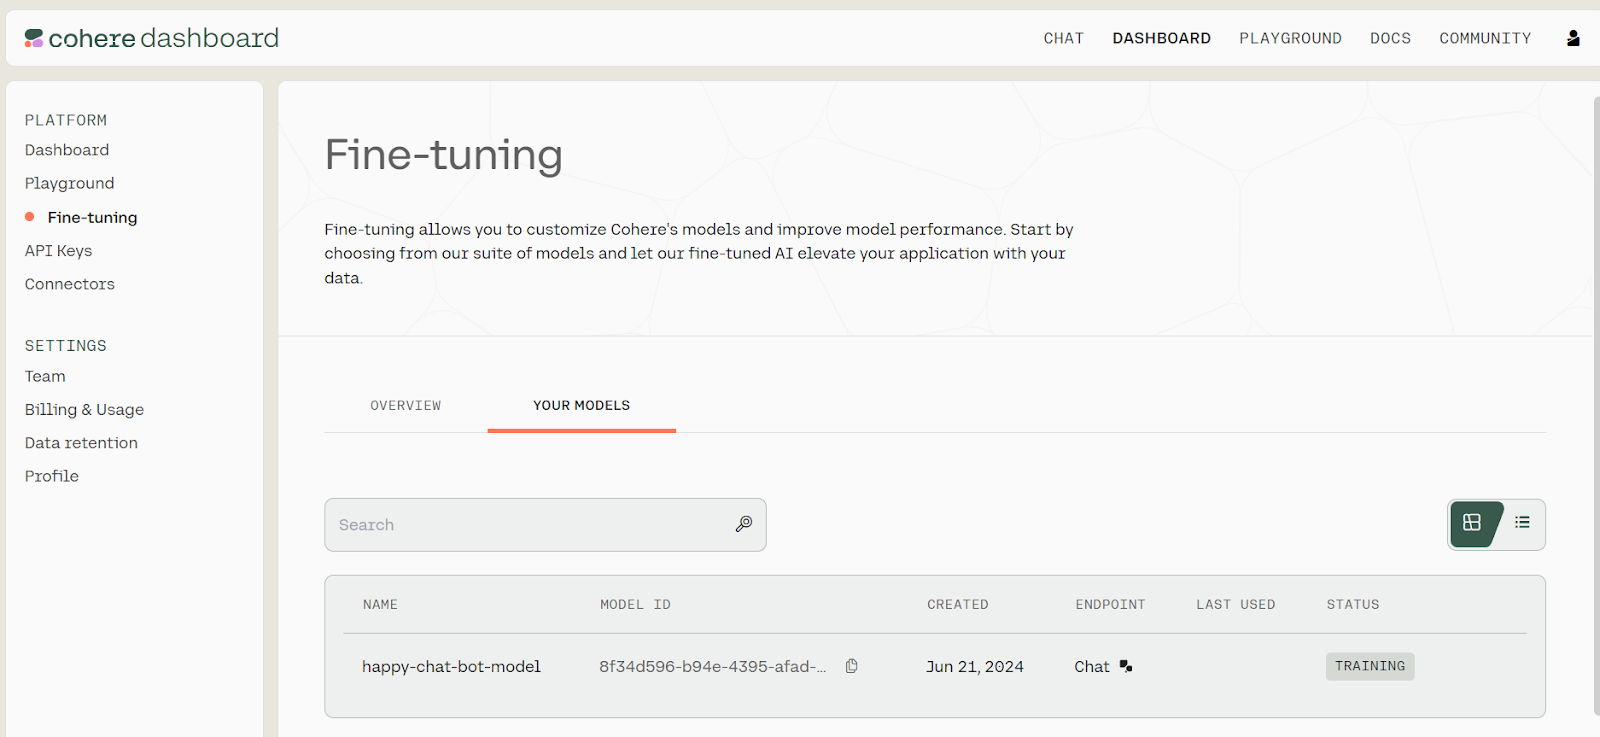
Den Fortschritt des Fine-Tunings siehst du im Cohere-Dashboard unter „Fine-tuning“ in der linken Leiste.
Fine-Tuning-Status. Quelle: Models | Cohere
Das Fine-Tuning und der Evaluationsbericht können einige Minuten dauern.
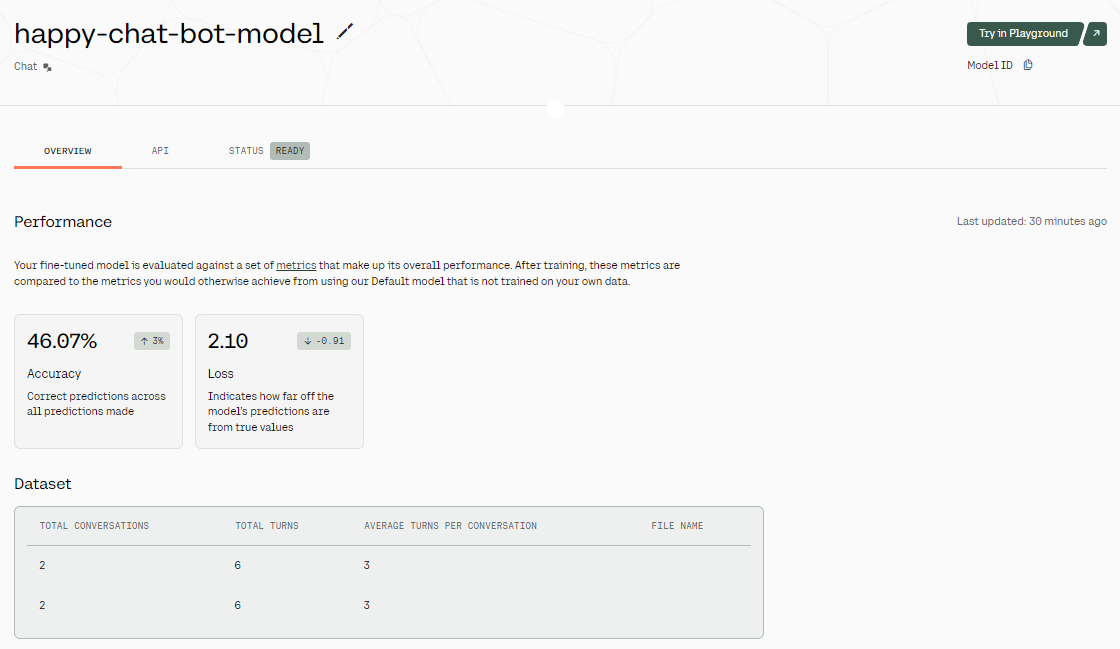
Fine-Tuning-Ergebnisse. Bildquelle: Fine-tuned Model - happy-chat-bot-model | Cohere
Nach dem Fine-Tuning erhältst du eine Übersicht der Ergebnisse. Wie im Bild zu sehen, ist die Genauigkeit recht niedrig. Warum? Wir haben nur einen Datensatz mit zwei Zeilen verwendet. Um die Genauigkeit zu steigern, nutze reale Daten mit mindestens 1.000 Zeilen.
Um auf unser feinabgestimmtes Modell zuzugreifen, übergeben wir die Modell-ID an die Funktion .chat(), zusammen mit preamble, message und max_tokens.
Die Modell-ID findest du im Dashboard unter „Fine-tuning“, dann „YOUR MODELS“ und kopierst sie aus der Liste der Fine-Tune-Modelle.
response = co.chat(
    model="8f34d596-b94e-4395-afad-1db35b2b0b53-ft",
    preamble="You are a happy chatbot that puts a positive spin on everything.",
    message="I burned my finger while barbecuing.",
    max_tokens=100
)

print(response.text)
Ouch! That doesn't sound fun, but it's great that you're taking time to relax and enjoy some delicious grilled foods. Barbecuing is a wonderful way to spend time with friends and family, and it's an excellent opportunity to savor the little things in life. Remember to take care of your burn; it's a small price to pay for a fun day making delicious memories!Die generierte Antwort kann sich sehen lassen!
Jetzt bauen wir einen mehrstufigen KI-Agenten mit dem LangChain-Ökosystem und dem Cohere Command R+-Modell.
Diese KI-Anwendung nimmt die Nutzeranfrage entgegen, durchsucht das Web mit der Tavily API und generiert Python-Code. Anschließend wird der Code per Python REPL ausgeführt und die gewünschte Visualisierung zurückgegeben.
Zuerst installieren wir alle benötigten Python-Pakete. Das machen wir in einem DataLab-Notebook.
%pip install --quiet langchain langchain_cohere langchain_experimentalDanach erstellen wir mit der LangChain Python API einen Chat-Client und übergeben den zuvor erstellten Cohere API-Schlüssel. Als Sprachmodell des KI-Agenten nutzen wir Command R+.
import os
from langchain_cohere.chat_models import ChatCohere

cohere_api_key = os.environ["COHERE_API_KEY"]
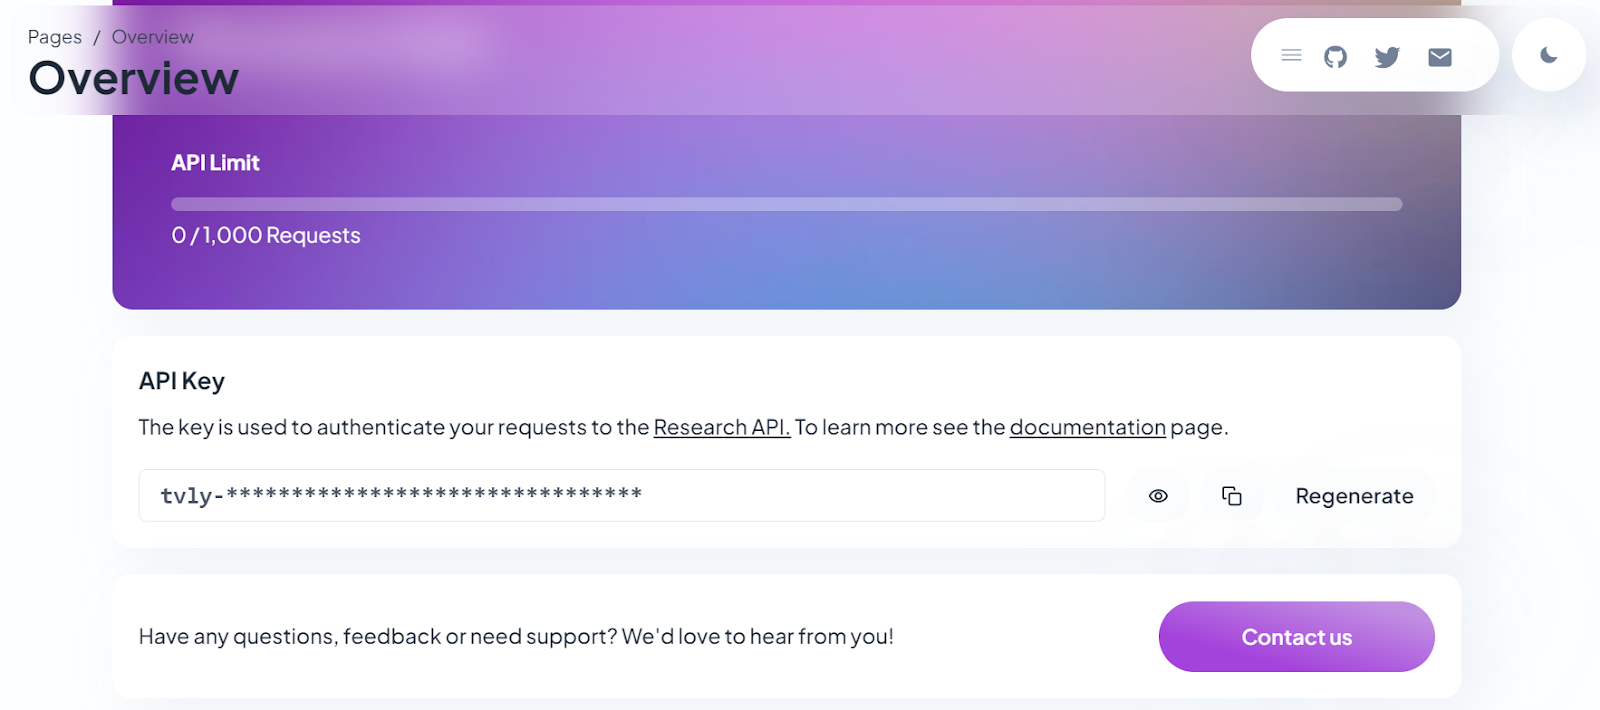
chat = ChatCohere(model="command-r-plus", temperature=0.7, api_key=cohere_api_key)Registriere dich bei Tavily und kopiere deinen API-Schlüssel. Tavily ist eine Internetsuch-API für LLMs und RAG-Pipelines.
Tavily API-Schlüssel generieren. Bildquelle: Tavily AI
Um das Internetsuch-Tool zu erstellen, hinterlege den API-Schlüssel als Umgebungsvariable in DataLab. Aktualisiere dann name, description und args_schema.
from langchain_community.tools.tavily_search import TavilySearchResults

internet_search = TavilySearchResults(api_key=os.environ['TAVILY_API_KEY'])
internet_search.name = "internet_search"
internet_search.description = "Returns a list of relevant documents from the internet."

from langchain_core.pydantic_v1 import BaseModel, Field

class TavilySearchInput(BaseModel):
    query: str = Field(description="Internet query engine.")

internet_search.args_schema = TavilySearchInputDas Python-REPL-Tool ist schnell erstellt: Übergib der Tool-Klasse ein Python-REPL-Objekt, einen name und eine description und passe das Argument-Schema wie unten an.
from langchain.agents import Tool
from langchain_experimental.utilities import PythonREPL

python_repl = PythonREPL()
repl_tool = Tool(
    name="python_repl",
    description="Executes python code and returns the result.",
    func=python_repl.run,
)
repl_tool.name = "python_interpreter"

class ToolInput(BaseModel):
    code: str = Field(description="Python code execution.")

repl_tool.args_schema = ToolInputJetzt kombinieren wir alles, um mit der Funktion .create_cohere_react_agent() den mehrstufigen KI-Agenten zu bauen – inklusive Cohere-Client, Tools und Prompt-Template. Zur Ausführung nutzen wir die Klasse AgentExecutor und übergeben Agent und Tools.
from langchain.agents import AgentExecutor
from langchain_cohere.react_multi_hop.agent import create_cohere_react_agent
from langchain_core.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_template("{input}")

agent = create_cohere_react_agent(
    llm=chat,
    tools=[internet_search, repl_tool],
    prompt=prompt,
)

agent_executor = AgentExecutor(agent=agent, tools=[internet_search, repl_tool], verbose=True)Nutze anschließend den agent_executor, um eine Visualisierung zu erzeugen. In unserem Fall soll der Agent aktuelle Daten aus dem Internet sammeln und ein Kreisdiagramm erstellen.
response = agent_executor.invoke({
    "input": "Create a pie chart of the top 5 most used programming languages in 2024.",
})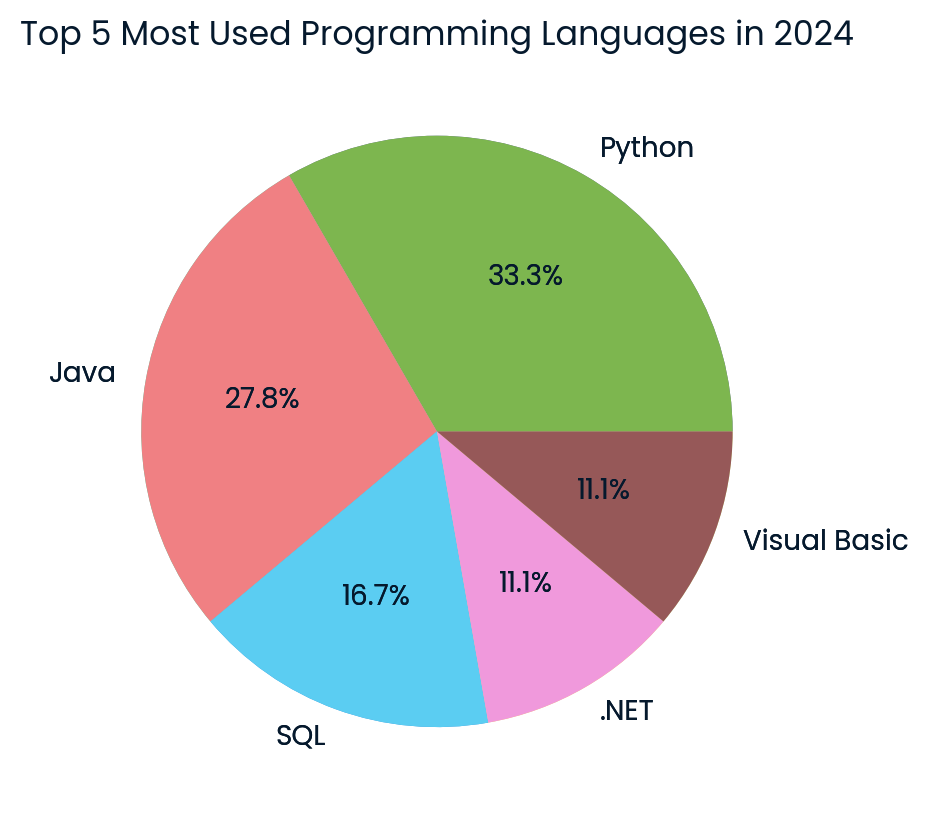
Kreisdiagramm der Top-Programmiersprachen, erstellt vom Cohere-Modell. Bild von der Autorin/dem Autor
Das Ergebnis ist stark! Das Diagramm wurde mit den neuesten Daten aus dem Internet erfolgreich erstellt.
Wenn du beim Ausführen des Codes aus diesem Tutorial auf Probleme stößt, sieh dir den DataLab-Workspace Cohere Command R+ Tutorial an. Dort findest du den Quellcode, den Datensatz und die Ausgaben.
Ähnlich wie mit LangChain kannst du mit LlamaIndex einen mehrstufigen KI-Agenten bauen. Für den Einstieg sieh dir das Video-Tutorial Retrieval Augmented Generation with LlamaIndex an.
Der KI-Markt zieht wieder deutlich an. Neue Tools und APIs zu lernen hilft dir, bessere KI-Systeme zu bauen und dein Portfolio zu stärken. Außerdem vereinfacht es deinen Workflow, denn viele KI-Frameworks übernehmen den Großteil der Arbeit – oft mit nur wenigen Codezeilen.
In diesem Tutorial haben wir das Cohere Command R+-Modell kennengelernt und den Zugriff über Hugging Face Chat, die Jan-App und die API gezeigt. Zudem haben wir die Python API genutzt und das Modell für individuelle Antworten fine-getuned. Zum Abschluss haben wir einen funktionsfähigen KI-Agenten gebaut, der Nutzeranfragen entgegennimmt, aktuelle Internetdaten recherchiert und Visualisierungen mit Python REPL erzeugt.
Mehr über die Stärken von LLMs – Inhalte aus Prompts generieren, Informationen aus Dokumenten extrahieren und eine semantische Suche bauen – erfährst du in unserer Code-Along-Session using Large Language Models with the Cohere API.
Vertiefe dein Wissen zu KI und LLMs mit diesen Kursen!
Kurs
Kurs
Kurs