

Cursus
Concepten van Large Language Models (LLMs)
2 uur
113.4K
Wil je je AI-kennis uitbreiden met een praktijkproject? In deze tutorial verkennen we Cohere Command R+, inclusief hoe je het online en lokaal kunt gebruiken. We duiken ook in de belangrijkste functies van de Cohere Python-API en bouwen een AI-project met LangChain en Tavily.
Het leuke deel begint bij het project. Als je al bekend bent met Cohere-modellen en hun functies, kun je gerust meteen naar het projectgedeelte gaan. Daar leer je hoe je een AI-agent bouwt die meerdere tools achter elkaar gebruikt om een taak uit te voeren.
Ben je nieuw in AI en wil je meer leren over het vakgebied? Overweeg dan het AI Fundamentals-traject. Je krijgt toepasbare kennis over populaire AI-onderwerpen zoals ChatGPT, Large Language Models (LLM’s), generatieve AI en meer.
Command R+ is Cohere’s nieuwste en meest geavanceerde LLM. Het model blinkt uit in conversaties en taken met lange context. Het is specifiek geoptimaliseerd voor complexe Retrieval Augmented Generation (RAG)-workflows en meerstaps toolgebruik, waardoor het een krachtig instrument is voor toepassingen op ondernemingsschaal.
Afbeelding door de auteur
Dit zijn enkele van de meest relevante functies van het Command R+-model.
Wil je dieper begrip van Cohere-modellen? Lees dan zeker de Cohere API Tutorial: Getting Started With Cohere Models.
Er zijn verschillende manieren om toegang te krijgen tot de Cohere-modellen, waarvan de meeste gratis zijn.
Je kunt de online LLM-playground gebruiken of het model lokaal downloaden en gebruiken met een chatapplicatie. Daarnaast kun je er ook via de Cohere-API bij. Laten we elke methode bekijken.
De meest directe manier om Cohere Command R+ online te gebruiken is via de HuggingChat-website. Er zijn geen beperkingen, en je kunt het ook koppelen aan zes beschikbare tools voor verschillende taken, zoals afbeeldingsgeneratie of internetzoekopdrachten.
1. Ga naar de https://huggingface.co/chat/-website.
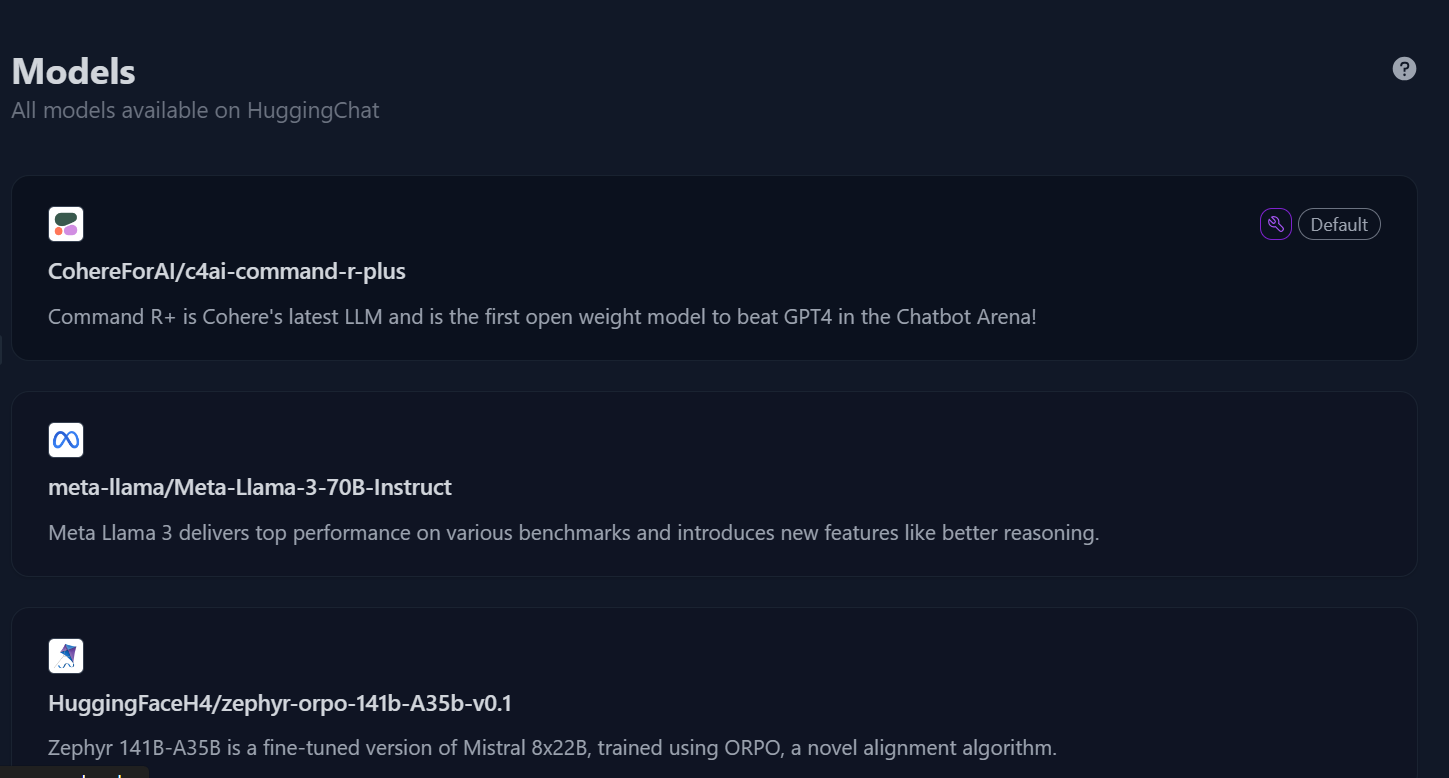
2. Klik in het linkerpaneel op de knop “Models” om het modellenmenu te openen en selecteer vervolgens het “c4ai-command-r-plus”-model.
Modellenoverzicht in Hugging Chat. Beeldbron: HuggingChat
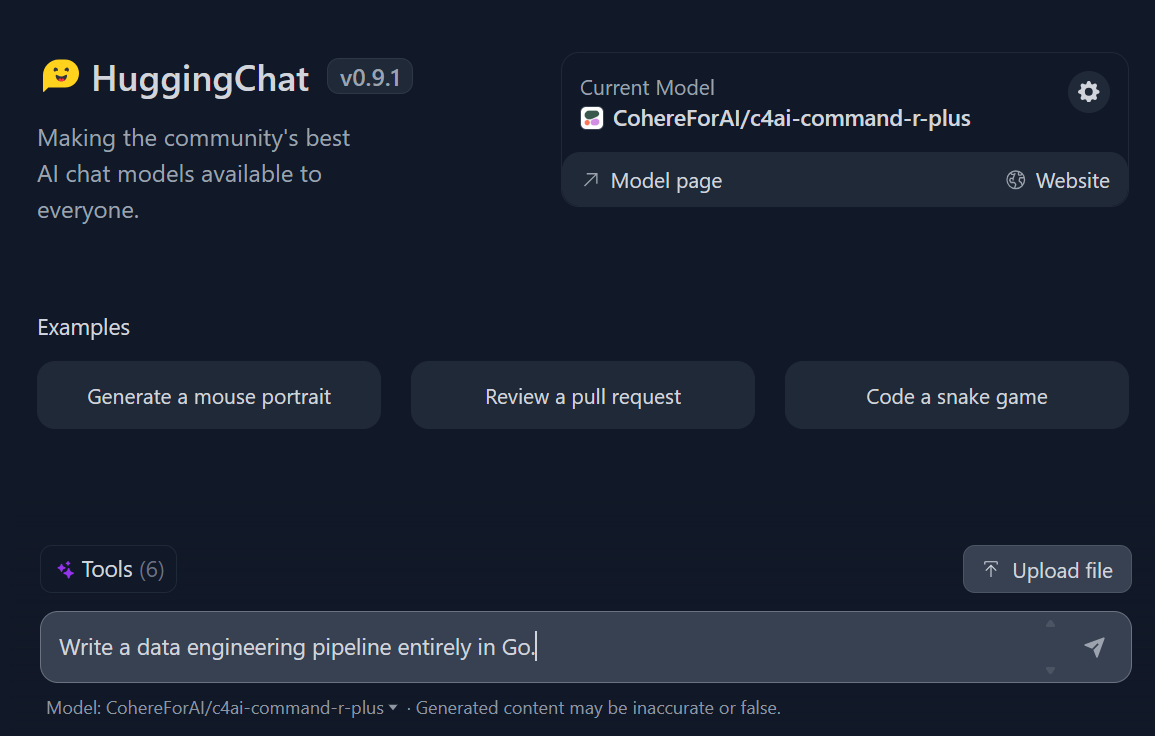
3. Begin met je vraag te typen; het model genereert een snelle en zeer nauwkeurige reactie.
Prompten in Hugging Chat. Beeldbron: HuggingChat
Je kunt Command R+ lokaal gebruiken op twee manieren: door het model naar je lokale machine te downloaden of door een API-sleutel aan de Jan-chatapplicatie te geven.
Laten we de tweede optie bekijken.
1. Download en installeer Jan via de https://jan.ai/-website.
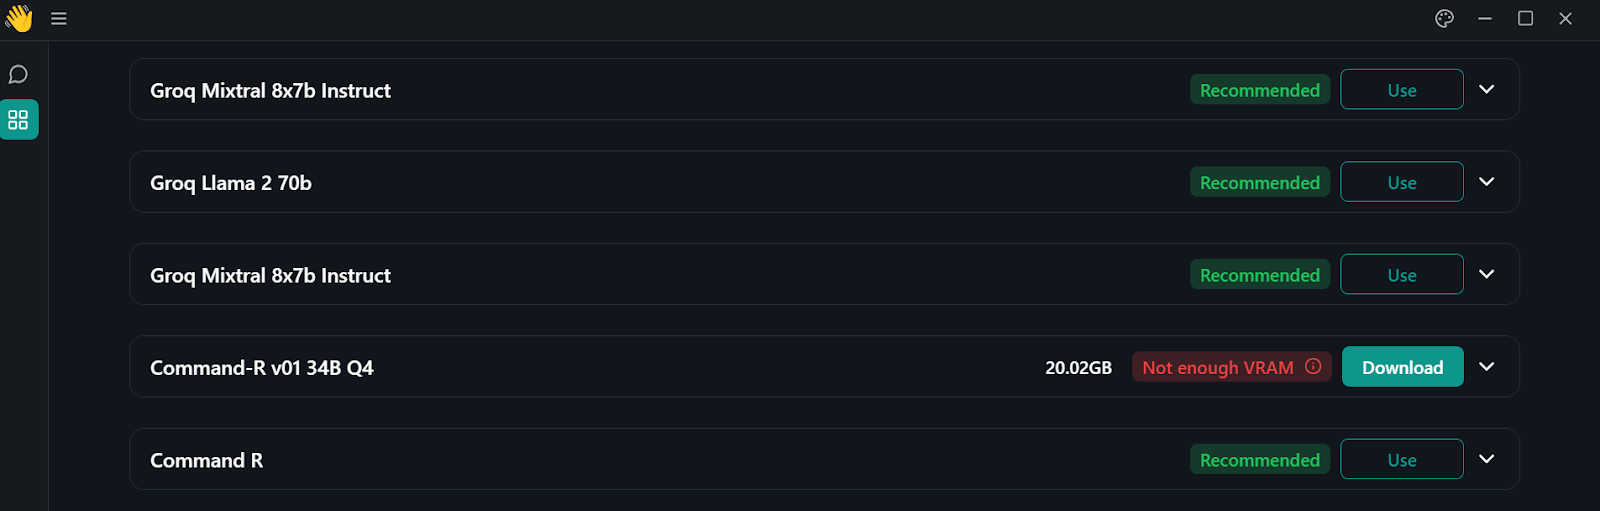
2. Ga naar de modelhub door op de Windows-knop in het linkerpaneel te klikken.
Modeloverzicht in de Jan-applicatie
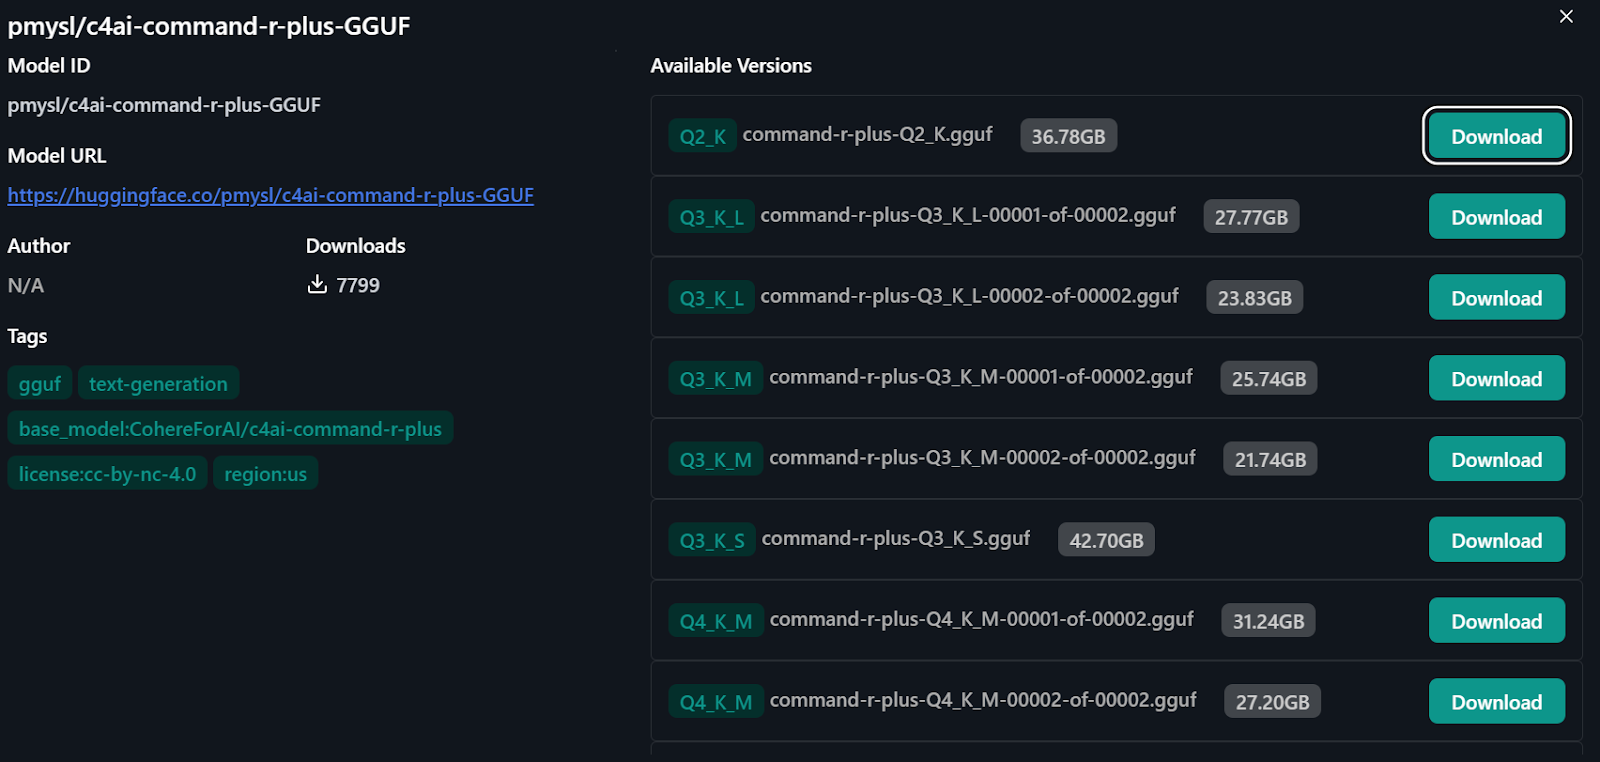
3. Om toegang te krijgen tot het Command R+-model typ je “pmysl/c4ai-command-r-plus-GGUF ” in de zoekbalk van de modelhub.
4. Download en start het gebruik van de “Q4_K_M-versie” van het model, die ongeveer 31,24GB is.
Het model importeren van Hugging Face
Een andere manier om het Command R+-model lokaal te gebruiken is door de Cohere-API te koppelen aan de Jan-applicatie.
1. Ga naar de https://coral.cohere.com/-website en log in.
2. Ga naar het “Dashboard”.
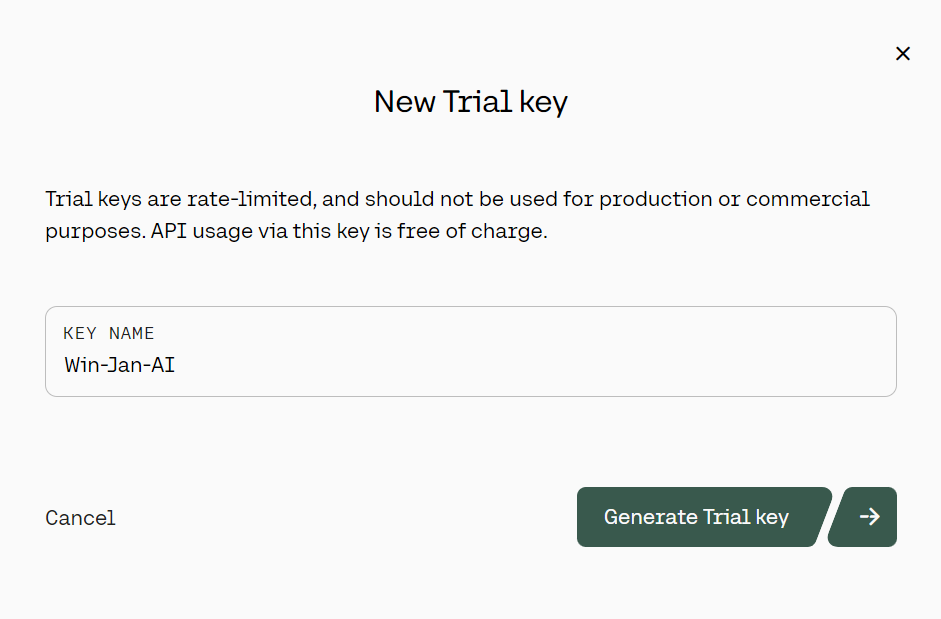
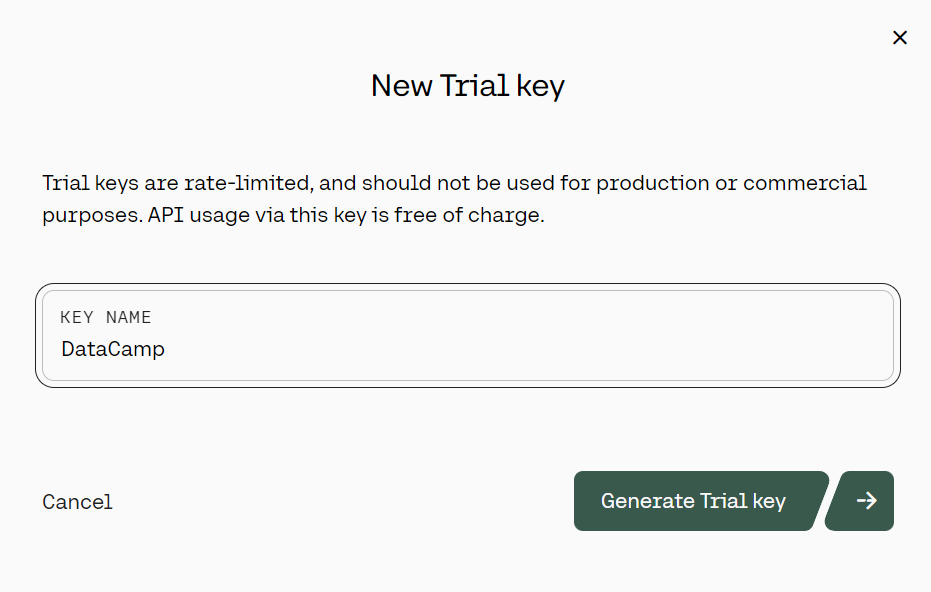
3. Klik in het linkerpaneel op de knop “API keys”, scroll dan omlaag en klik op “+ Create Trail key.”
Proef-API-sleutel voor Cohere genereren. Bron: cohere.com
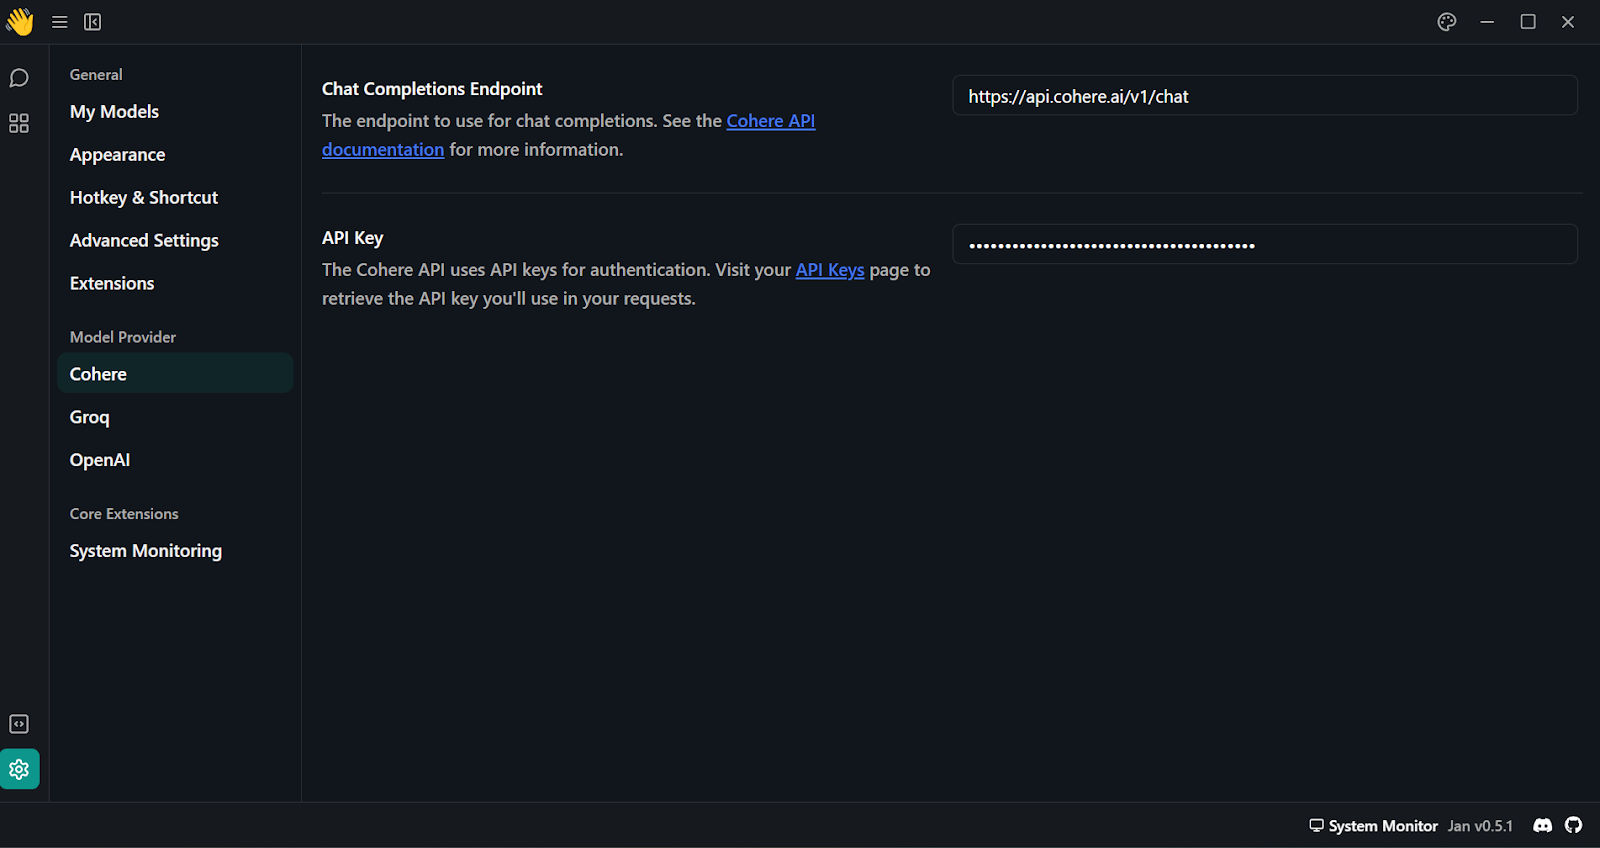
4. Nadat je de Cohere API-sleutel hebt gegenereerd, plak je deze in de sectie “Model Provider”. Je opent dit menu via “Settings” en zoekt naar “Cohere”.
Cohere API-sleutel toevoegen in de Jan-applicatie
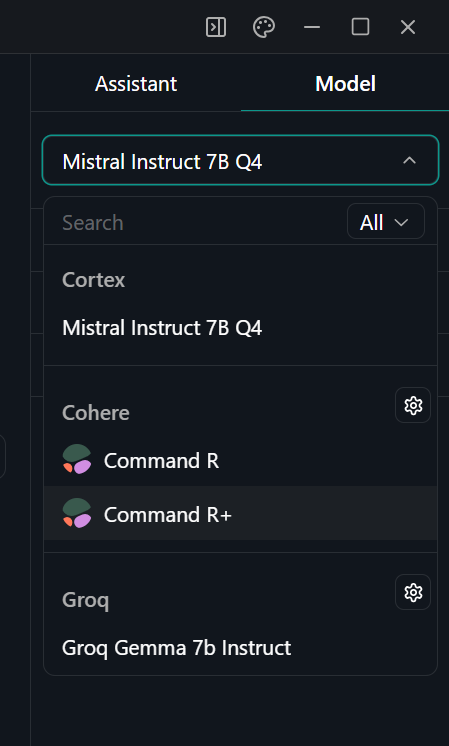
5. Selecteer het Command R+-model door naar het “Thread”-menu te gaan en in het rechterpaneel het geschikte model te kiezen.
Model selecteren in de Jan-applicatie
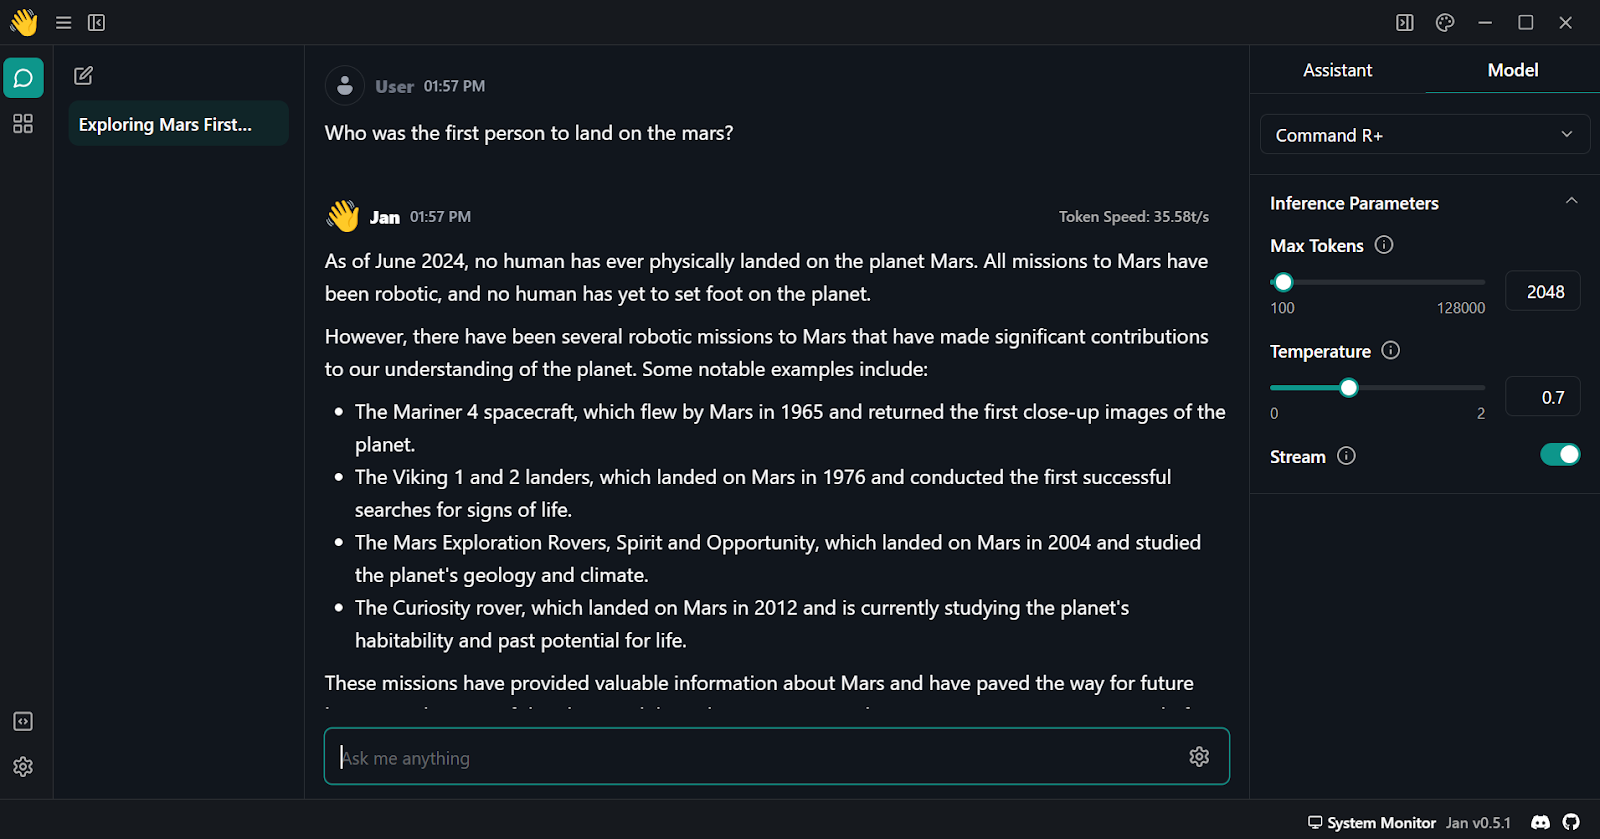
6. Begin met prompten en zorg dat “Stream” is ingeschakeld.
Cohere Command R plus gebruiken in de Jan-applicatie
In deze sectie leer je hoe je de Python-API instelt en gebruikt om een reactie te genereren.
1. Installeer het Cohere Python-pakket met pip.
pip install cohere2. Genereer een nieuwe Cohere API-sleutel. Je kunt de stappen volgen in de sectie “Cohere Command R+ gebruiken via de API”.
Proef-API-sleutel voor Cohere genereren. Beeldbron: cohere.com
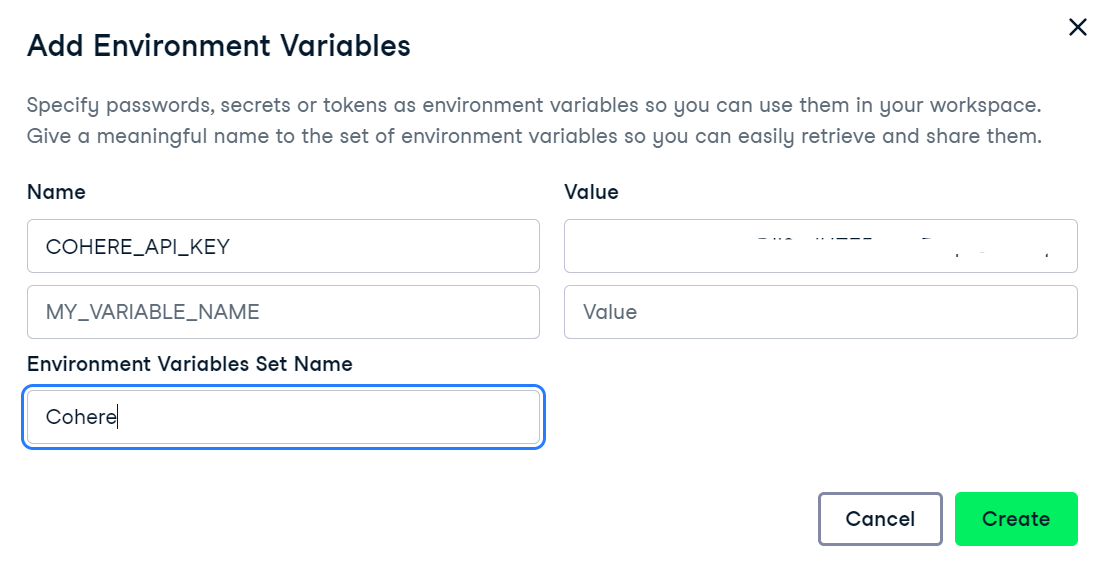
3. We gebruiken DataCamp’s DataLab als onze ontwikkelomgeving. Volg deze stappen om omgevingsvariabelen in DataLab in te stellen:
Omgevingsvariabelen toevoegen in DataLab
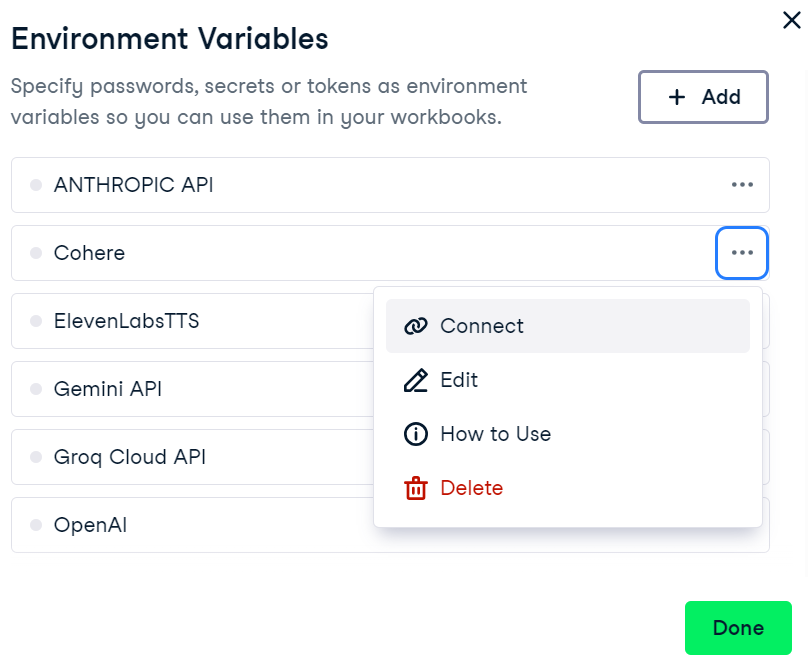
4. Om de omgevingsvariabele in DataCamp’s DataLab te activeren, ga je naar het menu voor omgevingsvariabelen, klik je op de drie puntjes naast “Cohere” en vervolgens op “Connect”.
De Cohere-omgevingsvariabele verbinden in DataLab
5. Initialiseer nu in je notebook de Cohere-client door de API-sleutel op te geven. Dit doe je door de Cohere-bibliotheek te importeren en een clientobject met je API-sleutel aan te maken.
import os
import cohere

cohere_api_key = os.environ["COHERE_API_KEY"]
co = cohere.Client(api_key=cohere_api_key)
6. Om een reactie te genereren met de .chat() functie, geef je de modelnaam en het message mee.
response = co.chat(
  model="command-r-plus",
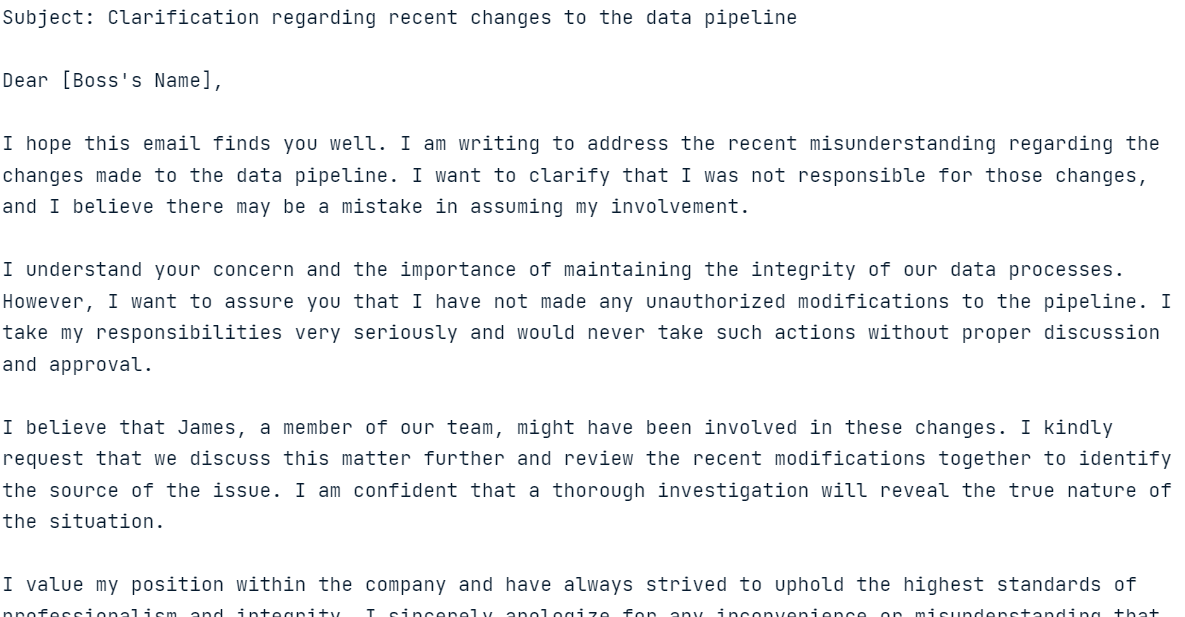
  message="Please help me write an email to the angry boss, who thinks I made the changes to the data pipeline but didn't. It was James."
)

print(response.text)
Modelreactie op de gegeven query
Het genereren van de reactie zou snel en zeer relevant moeten zijn!
In de volgende sectie verkennen we diverse functies van de Cohere Python-API.
We gaan nu de Cohere Python-API verkennen om reacties te genereren met geschiedenis, reacties te streamen en voorspelbare output te krijgen. We voeren ook RAG uit, zetten tekst om in embeddings en fine-tunen het model op een aangepaste dataset.
In de vorige sectie leerden we hoe we reacties genereren met een eenvoudige .chat()-functie. Nu geven we extra argumenten mee, zoals een systeemprompt (preamble), chat_history, max_tokens en temperature.
response = co.chat(
    model="command-r-plus",
    preamble="You are a happy chatbot that puts a positive spin on everything.",
    chat_history=[
       {"role": "USER", "text": "Hey, my name is Abid!"},
       {"role": "CHATBOT", "text": "Hey Abid! How can I help you today?"},
    ],
    message="I can't swim?",
    max_tokens=150,
    temperature=0.7
)

print(response.text)
Modelreactie met de extra argumenten
Op basis van de extra argumenten heeft het model de reactie aangepast.
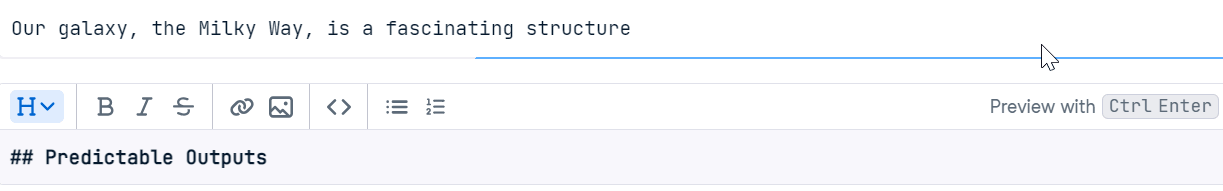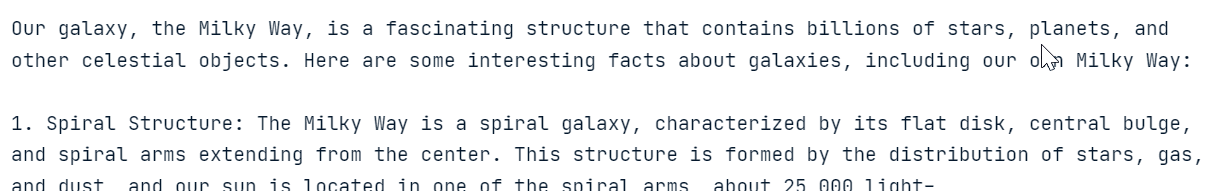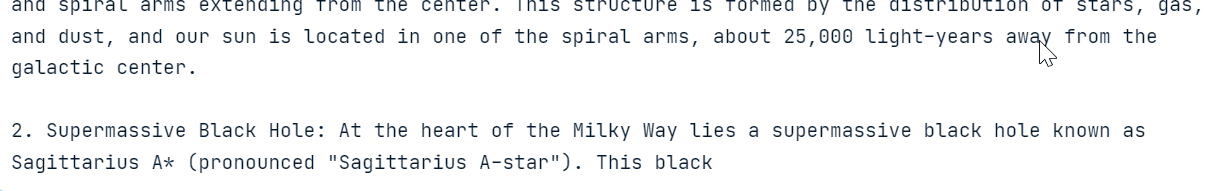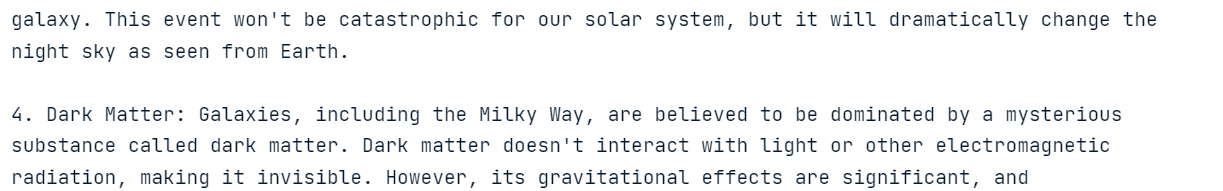
We kunnen de reactie ook streamen met de .chat_stream()-functie. Deze functie laat ons reacties in realtime genereren, waarbij tokens worden geproduceerd zodra ze beschikbaar zijn, wat de ervaren snelheid van het model verhoogt.
response = co.chat_stream(
    model="command-r-plus",
    message="Tell me something interesting about the galaxy?"
)

for event in response:
    if event.event_type == "text-generation":
      print(event.text, end="")
    elif event.event_type == "stream-end":
      print(event.finish_reason, end="")
Model dat tokens in realtime terugstuurt
Voorspelbare output is een unieke functie van Cohere. Door het seed-argument in te stellen, kun je het model telkens dezelfde reactie op dezelfde prompt laten genereren.
Meestal krijg je bij een LLM twee verschillende antwoorden als je dezelfde vraag twee keer stelt. Door de seed in te stellen, krijg je consistente en reproduceerbare resultaten, zoals bij elk machinelearningmodel.
In het volgende voorbeeld, door het seed-argument op 55 te zetten, ontvang je altijd “Matilda” als antwoord.
res = co.chat(model="command-r", message="say a random name", seed=55)
print(res.text)
Sure! I will pick a random name for you. How about "Matilda"?Om onze theorie te testen, hebben we het model opnieuw dezelfde vraag gesteld met dezelfde seed.
res = co.chat(model="command-r", message="say a random name", seed=55)
print(res.text)
Sure! I will pick a random name for you. How about "Matilda"?En het produceerde hetzelfde resultaat!
De Cohere-API biedt een ingebouwde functie om RAG uit te voeren. We hoeven de .chat()-functie alleen een documents-argument te geven. Bij het stellen van een vraag voert het een gelijkeniszoektocht uit op de documenten om contextbewuste antwoorden te genereren.
We gebruiken onderzoeksdocumenten over anime als voorbeeld. De opmaak van de documenten moet lijken op het voorbeeld hieronder. Elk document moet de sleutels title en snippet bevatten.
anime = [
    {
        "title": "Naruto Popularity Analysis",
        "snippet": "Naruto's global success: massive manga sales, top anime ratings, extensive merchandise, and a dedicated fanbase. The series' impact on anime culture and its influence on subsequent shonen series is undeniable."
    },
    {
        "title": "One Piece Popularity Analysis",
        "snippet": "One Piece's record-breaking manga sales and its status as a long-running anime phenomenon highlight its popularity. The series' captivating story and characters have made it a staple in the anime community."
    },
    {
        "title": "Attack on Titan Popularity Analysis",
        "snippet": "Attack on Titan's intense storyline and high-quality animation have garnered a massive following. Its success in both manga and anime formats demonstrates its widespread appeal."
    },
    {
        "title": "My Hero Academia Popularity Analysis",
        "snippet": "My Hero Academia's rapid rise to fame is marked by its engaging characters and compelling plot. The series has achieved impressive manga sales and anime viewership."
    }
]
Om precieze en contextuele antwoorden te genereren, geven we de anime-documenten mee aan het documents-argument in de .chat()-functie.
response = co.chat(
    model="command-r-plus",
    message="Which Anime series have most engaging characters?",
    documents=anime,
)

print(response.text)
Some anime series with engaging characters include My Hero Academia and One Piece.Zoals je ziet, gebruikt het model documenten om zeer nauwkeurige antwoorden te genereren.
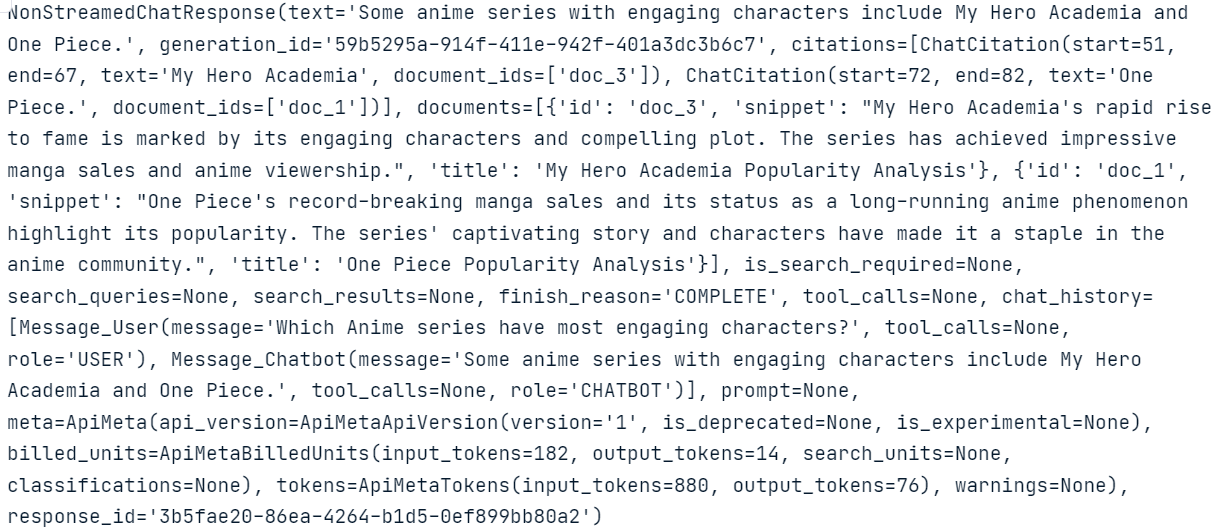
Als je wilt weten wat er achter de schermen gebeurt en hoe het model de reactie genereert, kun je eenvoudig de hele response met metadata printen.
response
Let op het ChatCitation-gedeelte en hoe Cohere’s .chat()-functie fragmenten uit de documenten heeft gebruikt om de reactie te genereren.
We kunnen ook tools en connectors koppelen aan de .chat()-functie. In het volgende voorbeeld koppelen we een internetzoekmachine aan het model om een geüpdatet antwoord te genereren.
response = co.chat(
    model="command-r-plus",
    message="Which Anime series have most engaging characters?",
    connectors=[{"id": "web-search"}],
)

print(response.text)
Here are some Anime series with engaging characters:
- Jujutsu Kaisen
- One Piece
- Naruto
- Dragon Ball Z
- Bleach
- Death Note
- Fullmetal Alchemist: Brotherhood
- Demon Slayer: Kimetsu no Yaiba
- Attack on Titan
- Mob Psycho 100
- Trigun
- My Hero Academia
- Cowboy Bebop
- Komi Can't Communicate
- Spy X FamilyIn dit geval zoekt het model de informatie op internet en geeft het model vervolgens de context om geüpdatete en nauwkeurige resultaten te genereren.
Ontdek meer over de kracht van LLM’s met effectieve informatieophaling door de tutorial te volgen Boost LLM Accuracy with Retrieval Augmented Generation (RAG) and Reranking.
Tekstembeddings zijn numerieke representaties van tekst die semantische betekenis vastleggen, waardoor efficiënte gelijkeniszoektocht en analyse van tekstuele data mogelijk worden.
Met Cohere’s .embed()-functie kunnen we tekst omzetten in embeddingvectoren voor zoekvragen. We hoeven de functie alleen de modelnaam, lijst met texts, input_type en embedding_types te geven.
texts = [ 'I love you', 'I hate you', 'Who are you?']

response = co.embed(
  model='embed-english-v3.0',
  texts=texts,
  input_type='search_query',
  embedding_types=['float'])


embeddings = response.embeddings.float # All text embeddings
print(embeddings[2][:5])
[-0.00459671, -0.010803223, -0.048339844, -0.012306213, -0.019134521]Cohere laat ons ook teksten in meerdere talen omzetten naar embeddings. Daarvoor moeten we het embeddingmodel wijzigen naar “embed-multilingual-v3.0” en het input_type instellen op “classification”.
texts = [
   'I love you', 'Te quiero', 'Ich liebe dich',
   'Ti amo', 'Я тебя люблю', ' 我爱你 ',
   '愛してる', 'أحبك', 'मैं तुमसे प्यार करता हूँ'
]

response = co.embed(
  model='embed-multilingual-v3.0',
  texts=texts,
  input_type='classification',
  embedding_types=['float'])

embeddings = response.embeddings.float # All text embeddings
print(embeddings[2][:5])
[-0.011756897, 0.0116119385, -0.005115509, 0.011657715, -0.001660347]Net als met de OpenAI-API kun je met de Cohere-API het model fine-tunen op een aangepaste dataset. Upload daarvoor de data en voer de fine-tuningfunctie uit. Zo simpel is het.
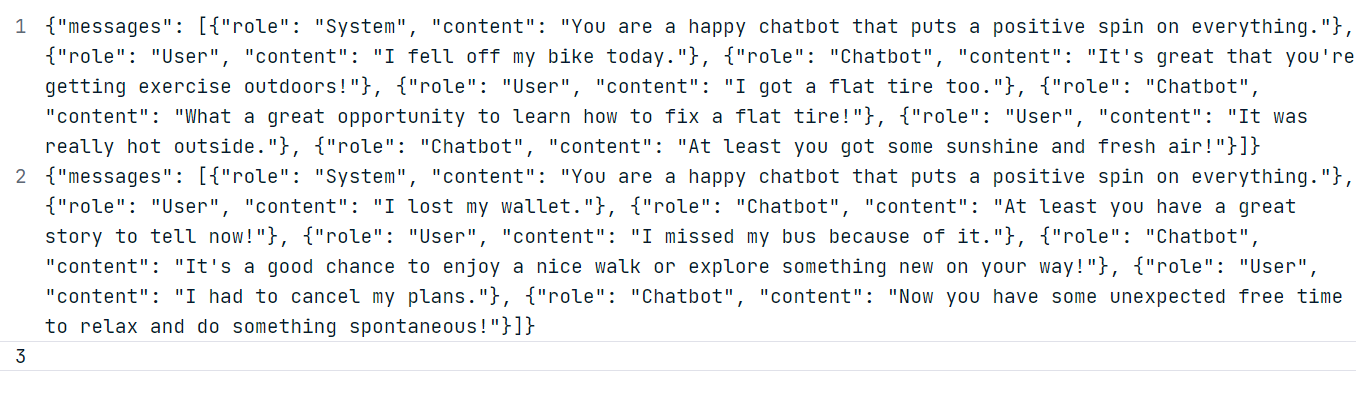
Voor ons voorbeeld genereren we twee aangepaste datasets met het ChatGPT (GPT-4o)-model. Volg het datasetformaat zoals hieronder getoond.
Gebruik de gegenereerde data om een “positive_bot_train”- en een “positive_bot_eval”-JSONL-bestand te maken en geef de bestandslocatie door aan de .datasets.create()-functie. De functie vereist ook de naam van de dataset en het fine-tuningtype.
my_dataset = co.datasets.create(
  name="Happy assistant",
  type="chat-finetune-input",
  data=open("./data/positive_bot_train.jsonl", "rb"),
  eval_data=open("./data/positive_bot_eval.jsonl", "rb")
)

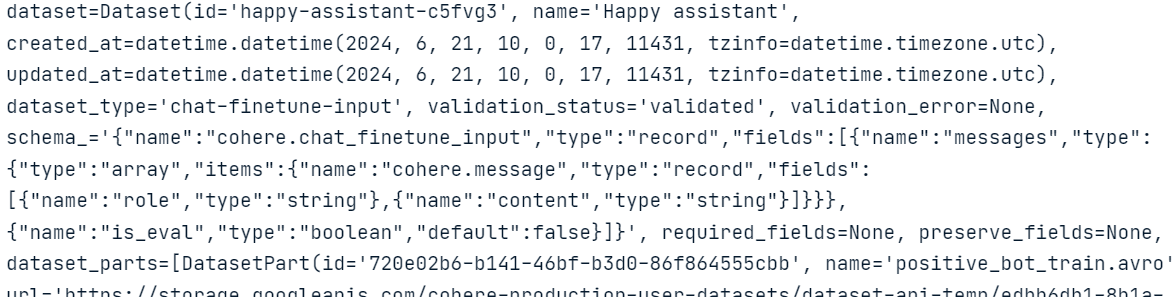
result = co.wait(my_dataset)
print(result)
Zoals we zien, heeft de functie de dataset gevalideerd en geüpload naar de cloudopslag van Cohere.
Nu hoeven we alleen de name van het model, de base_type en de dataset_id door te geven aan de functie .finetuning.create_finetuned_model(), die het fine-tuningproces in de cloud start.
from cohere.finetuning import FinetunedModel, Settings, BaseModel

# start training a custom model using the dataset
finetuned_model = co.finetuning.create_finetuned_model(
  request=FinetunedModel(
    name="happy-chat-bot-model",
    settings=Settings(
      base_model=BaseModel(
        base_type="BASE_TYPE_CHAT",
      ),
      dataset_id=my_dataset.id,
    ),
  ),
)
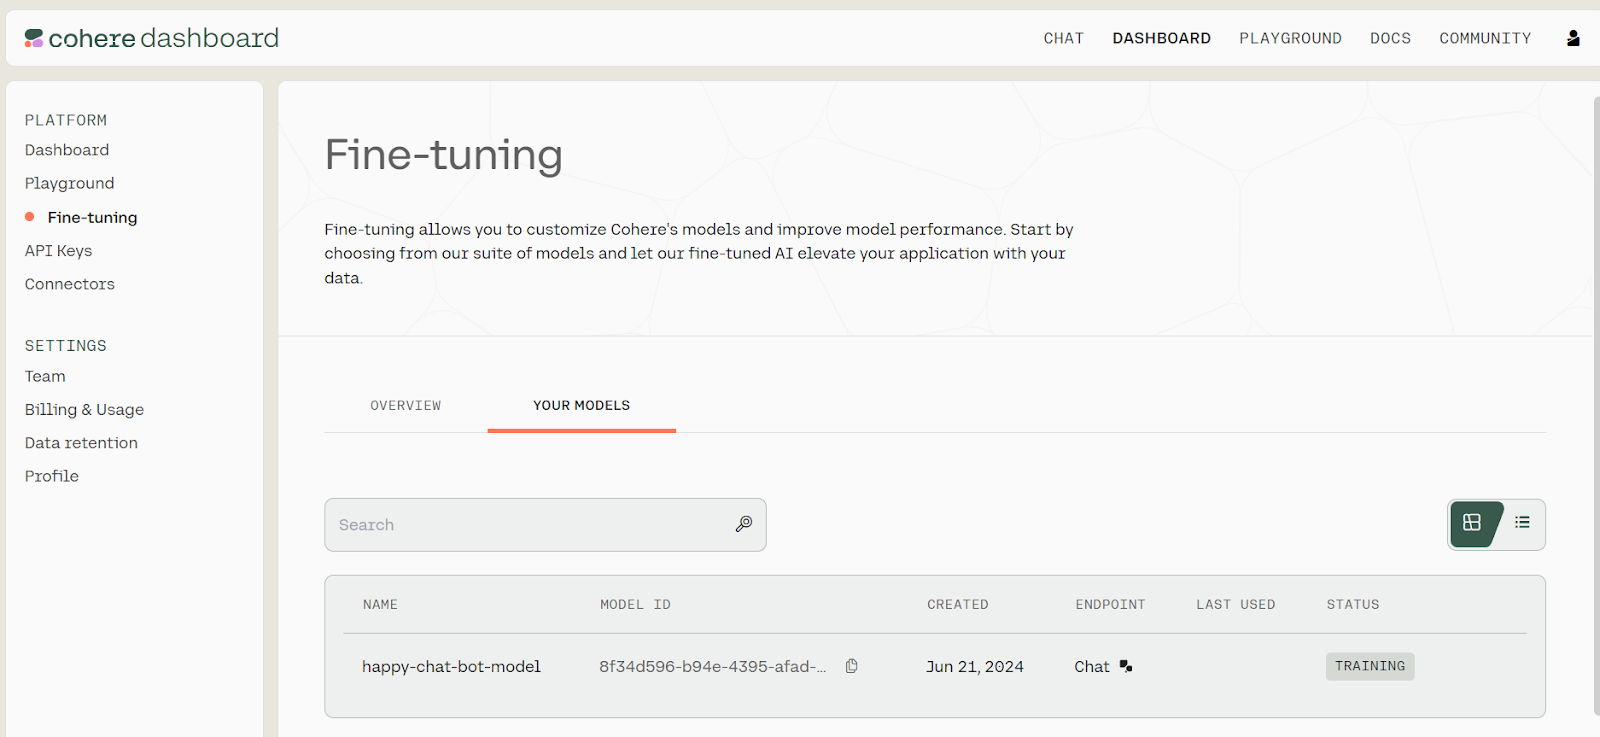
Om de voortgang van het fine-tunen te bekijken, ga je naar het Cohere-dashboard en klik je in het linkerpaneel op de optie “Fine-tuning”.
Status van fine-tuning. Bron: Models | Cohere
Het kan een paar minuten duren om het model te fine-tunen en het evaluatierapport te genereren.
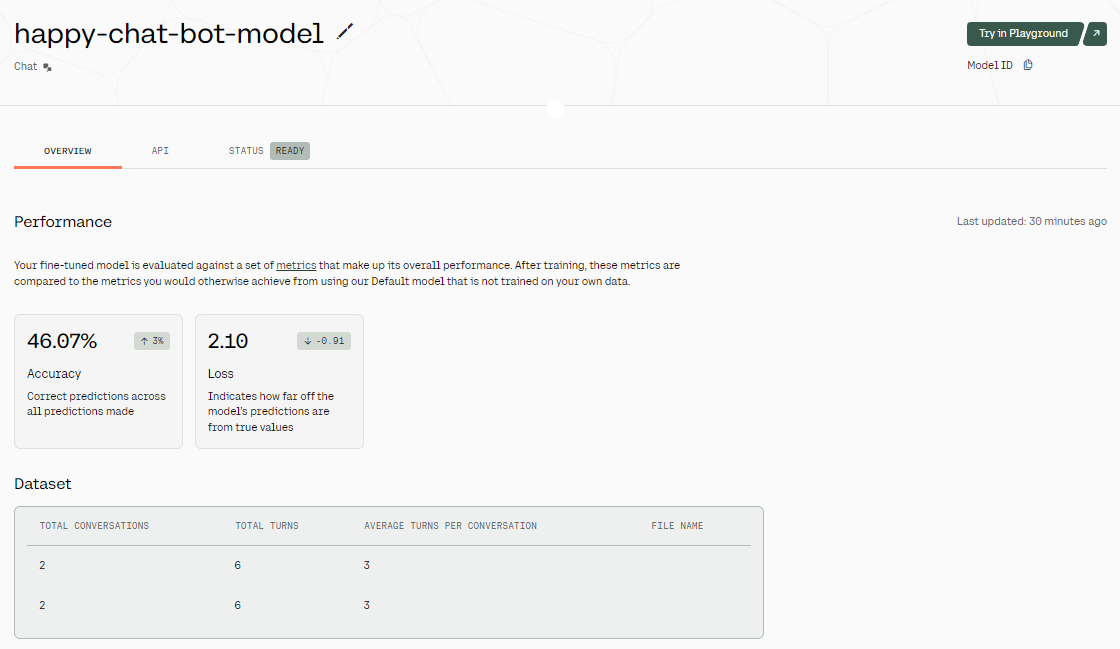
Resultaten van fine-tuning. Beeldbron: Fine-tuned Model - happy-chat-bot-model | Cohere
Zodra het model is gefinetuned, krijgen we een overzicht van de resultaten. Zoals je in de bovenstaande afbeelding ziet, is de nauwkeurigheid van het model vrij laag. Waarom? We hebben het slechts een dataset met twee rijen gegeven. Om de nauwkeurigheid te verbeteren, kun je het het beste voorzien van echte data van minimaal 1000 rijen.
Om ons gefinetunede model te gebruiken, geven we de model-ID door aan de .chat()-functie, samen met een preamble, message en max_tokens.
Je vindt de model-ID door naar het dashboard te gaan, “Fine-tuning” te selecteren, vervolgens “YOUR MODELS”, en de model-ID te kopiëren uit de lijst met gefinetunede modellen.
response = co.chat(
    model="8f34d596-b94e-4395-afad-1db35b2b0b53-ft",
    preamble="You are a happy chatbot that puts a positive spin on everything.",
    message="I burned my finger while barbecuing.",
    max_tokens=100
)

print(response.text)
Ouch! That doesn't sound fun, but it's great that you're taking time to relax and enjoy some delicious grilled foods. Barbecuing is a wonderful way to spend time with friends and family, and it's an excellent opportunity to savor the little things in life. Remember to take care of your burn; it's a small price to pay for a fun day making delicious memories!De gegenereerde reactie is helemaal niet slecht!
We gaan nu een meerstaps AI-agent bouwen met het LangChain-ecosysteem en het Cohere Command R+-model.
Deze AI-applicatie neemt de vraag van de gebruiker, zoekt het web af met de Tavily-API en genereert de Python-code. Vervolgens gebruikt het Python REPL om de code uit te voeren en de visualisatie te retourneren waar de gebruiker om vroeg.
Eerst moeten we alle vereiste Python-pakketten installeren. Dat kan in een DataLab-notebook.
%pip install --quiet langchain langchain_cohere langchain_experimentalDaarna gebruiken we de LangChain Python-API om een chatclient te maken, waarbij we de Cohere API-sleutel gebruiken die we eerder hebben aangemaakt. We gebruiken Command R+ als taalmodel in de AI-agent.
import os
from langchain_cohere.chat_models import ChatCohere

cohere_api_key = os.environ["COHERE_API_KEY"]
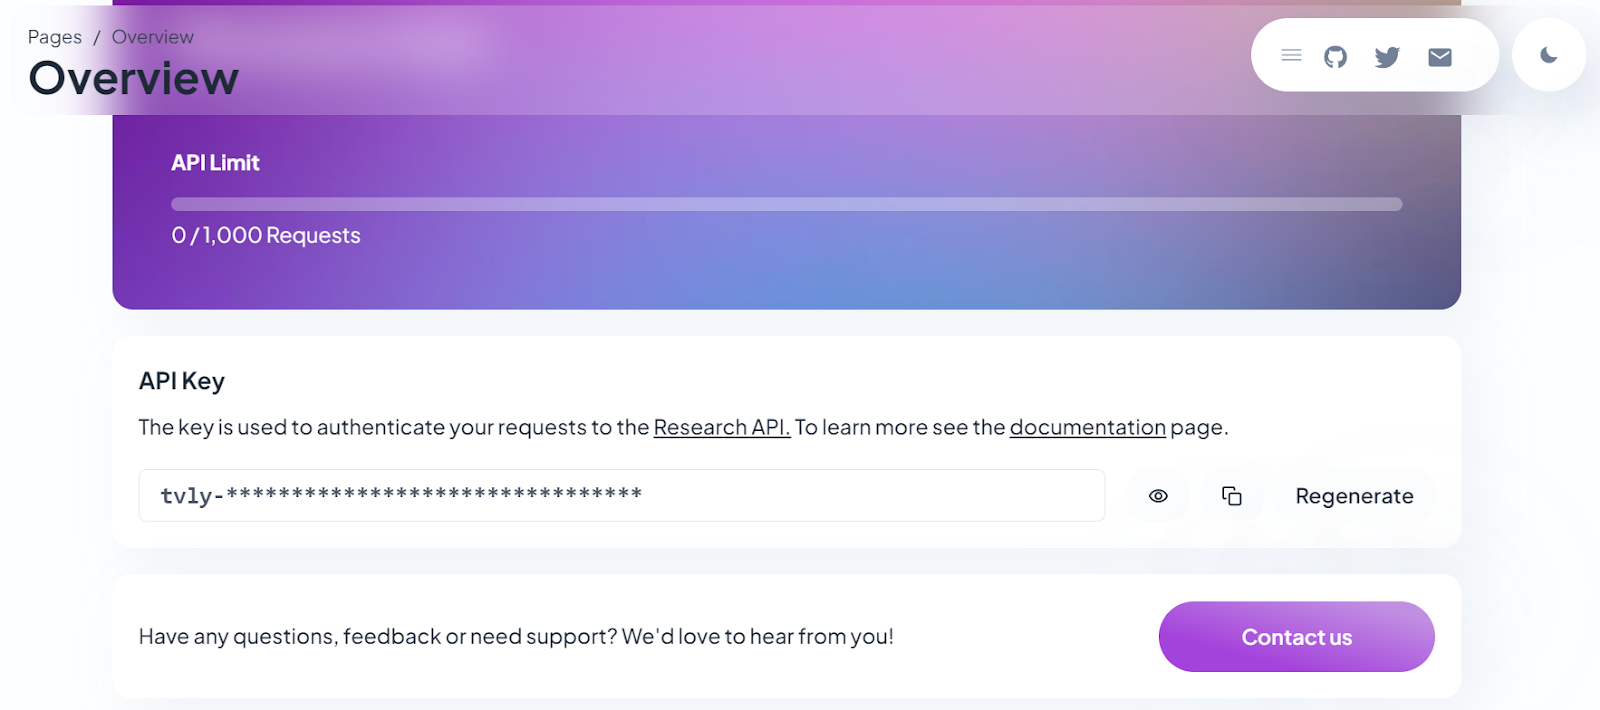
chat = ChatCohere(model="command-r-plus", temperature=0.7, api_key=cohere_api_key)Meld je aan bij Tavily en kopieer je API-sleutel. Tavily is een internetzoek-API voor LLM’s en RAG-pijplijnen.
De Tavily API-sleutel genereren. Beeldbron: Tavily AI
Maak de internetzoektool door de API-sleutel die we zojuist hebben gegenereerd als omgevingsvariabele in DataLab op te geven. Werk vervolgens de name, description en args_schema bij.
from langchain_community.tools.tavily_search import TavilySearchResults

internet_search = TavilySearchResults(api_key=os.environ['TAVILY_API_KEY'])
internet_search.name = "internet_search"
internet_search.description = "Returns a list of relevant documents from the internet."

from langchain_core.pydantic_v1 import BaseModel, Field

class TavilySearchInput(BaseModel):
    query: str = Field(description="Internet query engine.")

internet_search.args_schema = TavilySearchInputEen Python REPL-tool maken is eenvoudig: geef de Tool-klasse een Python REPL-object, name en description mee en pas het argumentenschema aan zoals hieronder.
from langchain.agents import Tool
from langchain_experimental.utilities import PythonREPL

python_repl = PythonREPL()
repl_tool = Tool(
    name="python_repl",
    description="Executes python code and returns the result.",
    func=python_repl.run,
)
repl_tool.name = "python_interpreter"

class ToolInput(BaseModel):
    code: str = Field(description="Python code execution.")

repl_tool.args_schema = ToolInputWe combineren nu alles om de meerstaps AI-agent te maken met de functie .create_cohere_react_agent(), de Cohere-modelclient, tools en prompttemplate. Om onze AI-agent uit te voeren, gebruiken we de AgentExecutor -klasse door het agentobject en de tools mee te geven.
from langchain.agents import AgentExecutor
from langchain_cohere.react_multi_hop.agent import create_cohere_react_agent
from langchain_core.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_template("{input}")

agent = create_cohere_react_agent(
    llm=chat,
    tools=[internet_search, repl_tool],
    prompt=prompt,
)

agent_executor = AgentExecutor(agent=agent, tools=[internet_search, repl_tool], verbose=True)Gebruik vervolgens de agent_executor om een visualisatie te genereren. In ons geval vroegen we de AI-agent om de nieuwste data van internet te verzamelen en een taartdiagram te maken.
response = agent_executor.invoke({
    "input": "Create a pie chart of the top 5 most used programming languages in 2024.",
})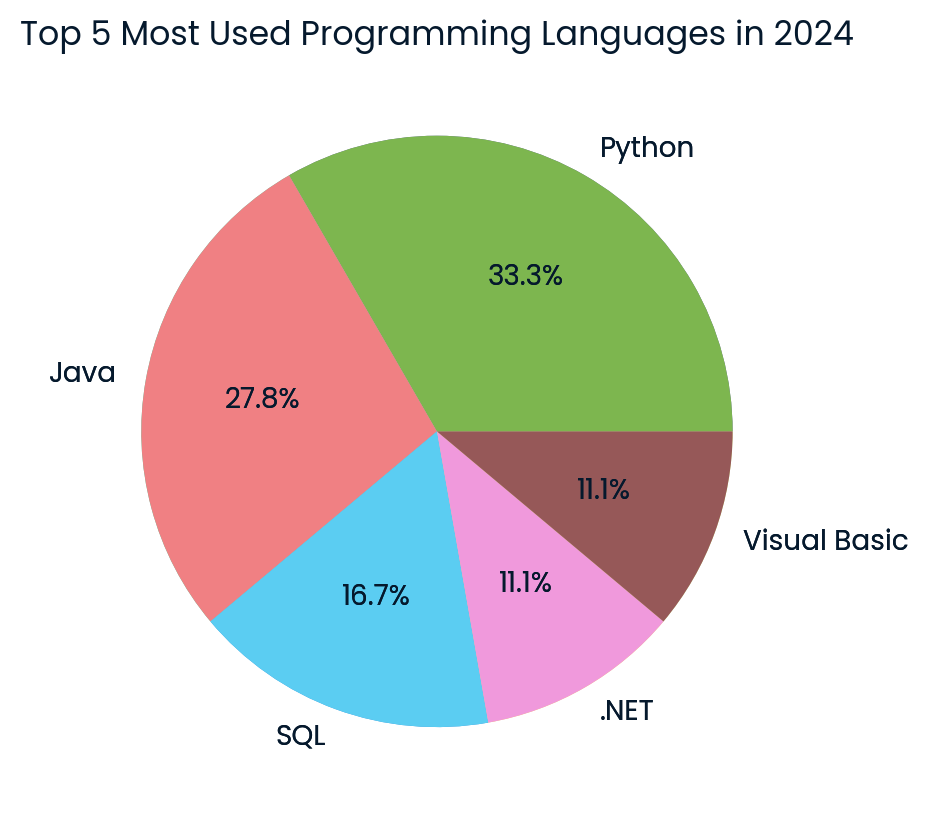
Taartdiagram van top programmeertalen gemaakt door het Cohere-model. Afbeelding door de auteur
Het resultaat is fantastisch! Het heeft het taartdiagram succesvol gegenereerd met de nieuwste data van internet.
Heb je problemen met het uitvoeren van de code uit deze tutorial? Kijk dan in de DataLab-werkruimte Cohere Command R+ Tutorial, die de broncode, dataset en outputs bevat.
Net als met LangChain kun je LlamaIndex gebruiken om een meerstaps AI-agent te bouwen. Wil je aan de slag met LlamaIndex, bekijk dan de videotutorial Retrieval Augmented Generation with LlamaIndex.
De AI-markt warmt opnieuw op, en het leren van nieuwe tools en API’s helpt je betere AI-systemen te bouwen en je portfolio te versterken. Bovendien vereenvoudigt het je workflow, omdat sommige AI-frameworks het meeste werk voor je uit handen nemen en maar een paar regels code vereisen.
In deze tutorial hebben we het Cohere Command R+-model behandeld en hoe je er toegang toe krijgt via Hugging Face chat, de Jan-applicatie en de API. We hebben ook de Python-API besproken en hoe je het model fine-tunet om aangepaste reacties te genereren. Tot slot bouwden we een volwaardige AI-agent die gebruikersvragen aanneemt, het internet afzoekt naar de nieuwste data en visualisaties genereert met Python REPL.
Wil je meer leren over de kracht van LLM’s, en hoe je content genereert op basis van prompts, informatie uit documenten extraheert en een semantische zoekmachine bouwt? Bekijk dan onze code-alongvideosessie over using Large Language Models with the Cohere API.
Leer meer over AI en LLM’s met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

