

Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.4K
Bạn đang muốn mở rộng kiến thức AI qua một dự án thực hành? Trong hướng dẫn này, chúng ta sẽ khám phá Cohere Command R+, bao gồm cách truy cập trực tuyến và cục bộ. Chúng ta cũng sẽ đi sâu vào các tính năng chính của Cohere Python API và xây dựng một dự án AI bằng LangChain và Tavily.
Phần thú vị bắt đầu ở dự án. Nếu bạn đã quen với các mô hình Cohere và tính năng của chúng, hãy thoải mái bỏ qua để đến thẳng phần dự án. Ở đó, bạn sẽ học cách xây dựng một tác nhân AI sử dụng nhiều công cụ theo trình tự để hoàn thành một tác vụ.
Nếu bạn mới bắt đầu với AI và muốn tìm hiểu thêm về lĩnh vực này, hãy cân nhắc tham gia lộ trình AI Fundamentals. Bạn sẽ nắm được kiến thức thực tiễn về các chủ đề AI phổ biến như ChatGPT, Mô hình ngôn ngữ lớn (LLM), AI tạo sinh và hơn thế nữa.
Command R+ là LLM mới nhất và tiên tiến của Cohere. Mô hình vượt trội trong tương tác hội thoại và các tác vụ ngữ cảnh dài. Nó được tối ưu đặc biệt cho quy trình Retrieval Augmented Generation (RAG) phức tạp và sử dụng công cụ đa bước, khiến nó trở thành một công cụ mạnh mẽ cho các ứng dụng quy mô doanh nghiệp.
Hình ảnh bởi tác giả
Dưới đây là một số tính năng liên quan nhất của mô hình Command R+.
Để hiểu sâu hơn về các mô hình Cohere, hãy đọc Hướng dẫn Cohere API: Bắt đầu với các mô hình Cohere.
Có nhiều cách để truy cập các mô hình Cohere, phần lớn là miễn phí.
Bạn có thể truy cập playground LLM trực tuyến hoặc tải mô hình về máy cục bộ và dùng với ứng dụng chat. Ngoài ra, bạn cũng có thể truy cập qua Cohere API. Hãy cùng điểm qua từng phương thức.
Cách đơn giản nhất để truy cập Cohere Command R+ trực tuyến là qua trang HuggingChat. Không có giới hạn và bạn cũng có thể kết nối với sáu công cụ sẵn có cho các tác vụ khác nhau như tạo ảnh hoặc tìm kiếm internet.
1. Truy cập trang https://huggingface.co/chat/.
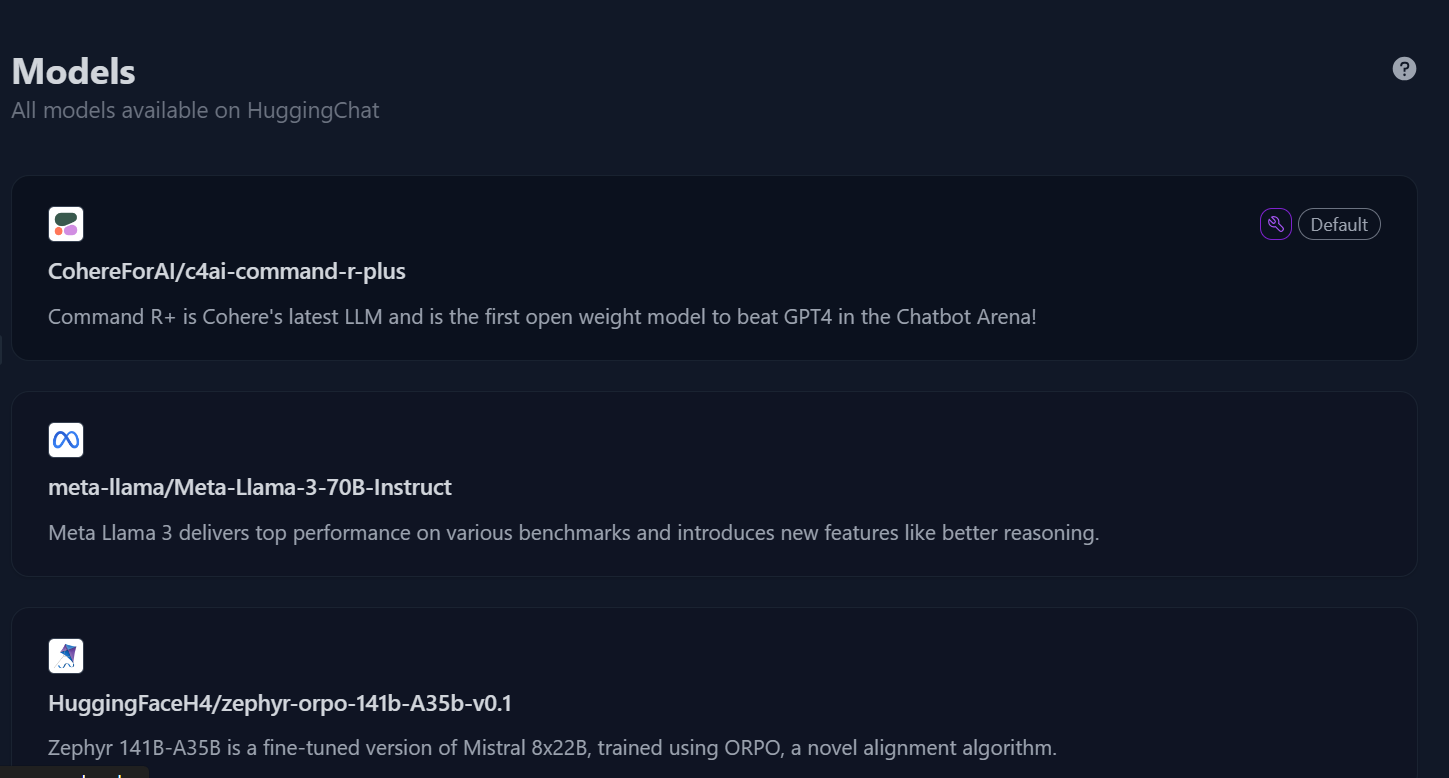
2. Ở bảng bên trái, nhấp nút “Models” để mở menu mô hình, sau đó chọn mô hình “c4ai-command-r-plus”.
Thư mục mô hình trong Hugging Chat. Nguồn hình: HuggingChat
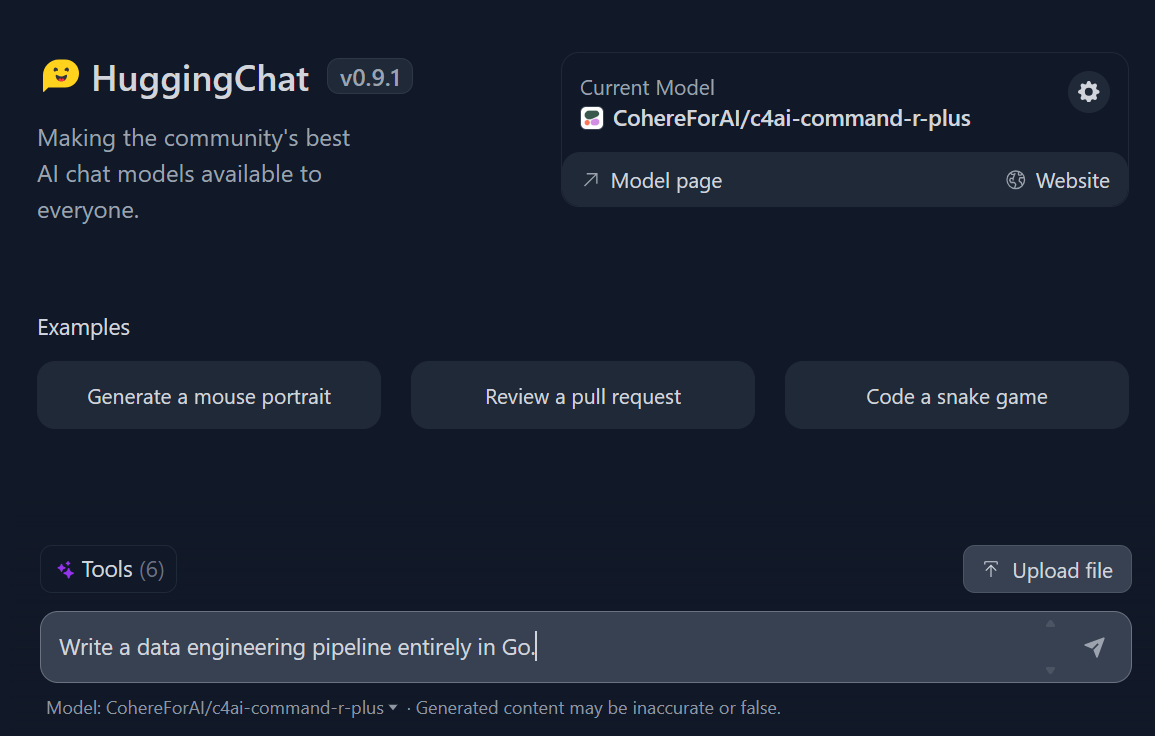
3. Bắt đầu nhập truy vấn và bạn sẽ nhận được phản hồi nhanh, chính xác cao.
Nhập lệnh trong Hugging Chat. Nguồn hình: HuggingChat
Bạn có thể dùng Command R+ cục bộ theo hai cách: tải mô hình về máy hoặc cung cấp API key cho ứng dụng chat Jan.
Hãy cùng khám phá lựa chọn thứ hai.
1. Tải và cài đặt Jan từ trang https://jan.ai/.
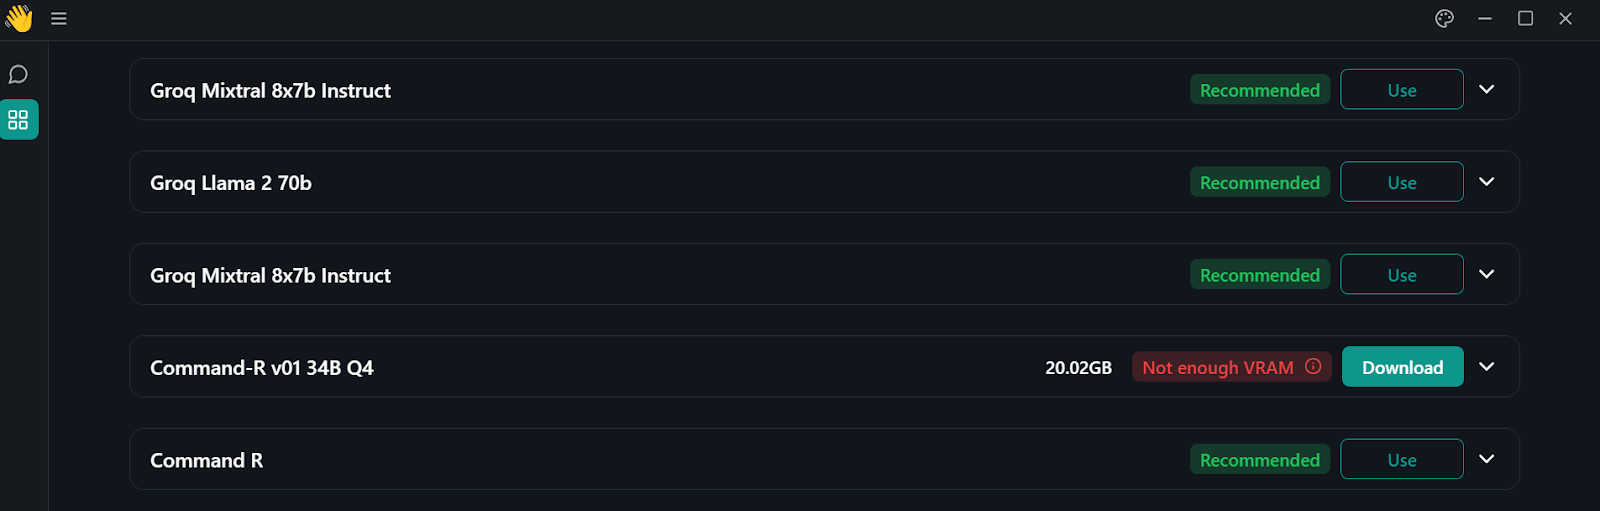
2. Vào kho mô hình bằng cách nhấn nút cửa sổ ở bảng bên trái.
Thư mục mô hình trong ứng dụng Jan
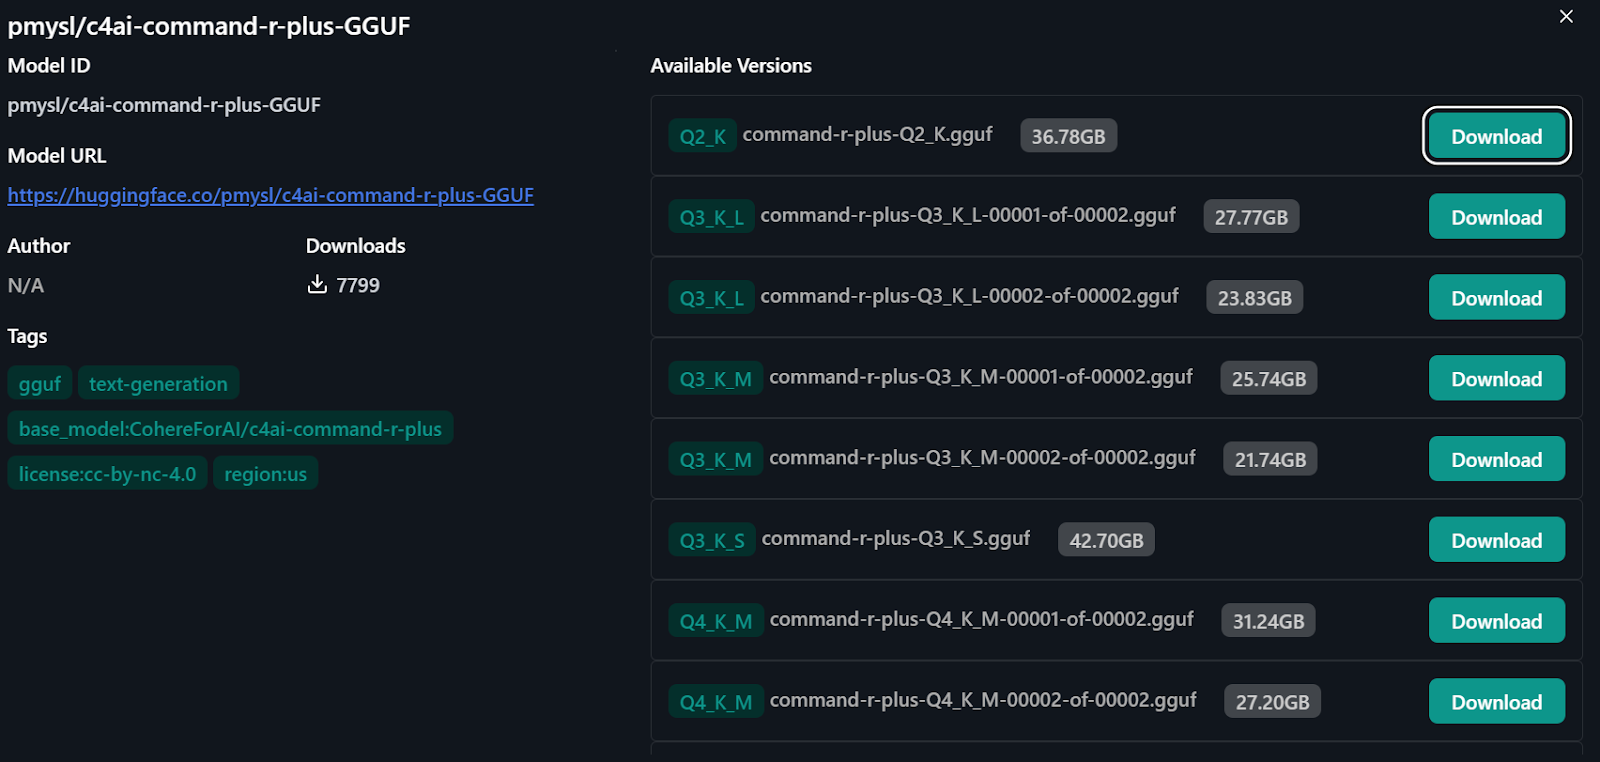
3. Để truy cập mô hình Command R+, gõ “pmysl/c4ai-command-r-plus-GGUF ” trong thanh tìm kiếm kho mô hình.
4. Tải và bắt đầu sử dụng phiên bản “Q4_K_M” của mô hình, dung lượng khoảng 31,24GB.
Nhập mô hình từ Hugging Face
Một cách khác để sử dụng mô hình Command R+ cục bộ là kết nối Cohere API với ứng dụng Jan.
1. Truy cập https://coral.cohere.com/ và đăng nhập.
2. Vào “Dashboard”.
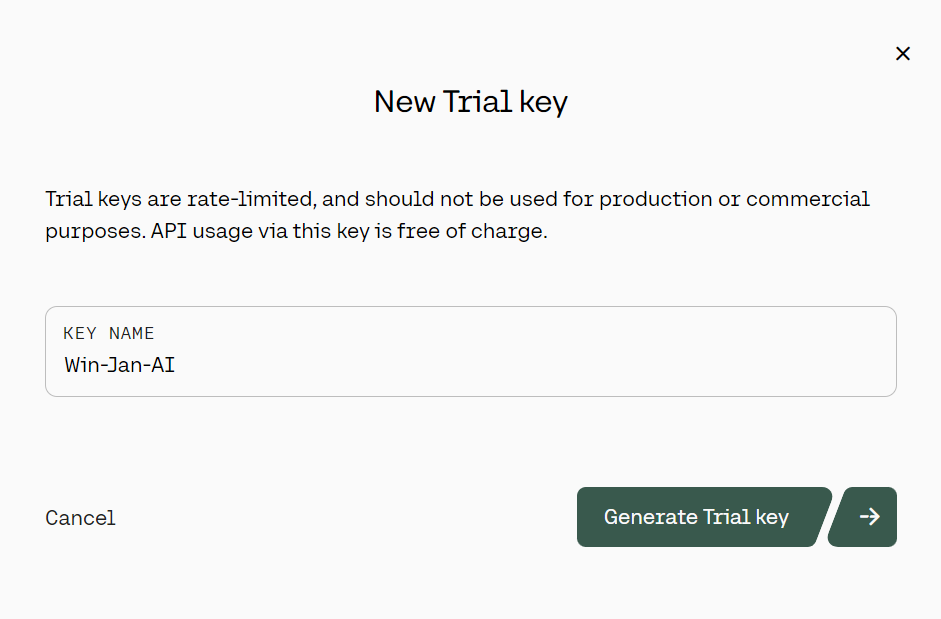
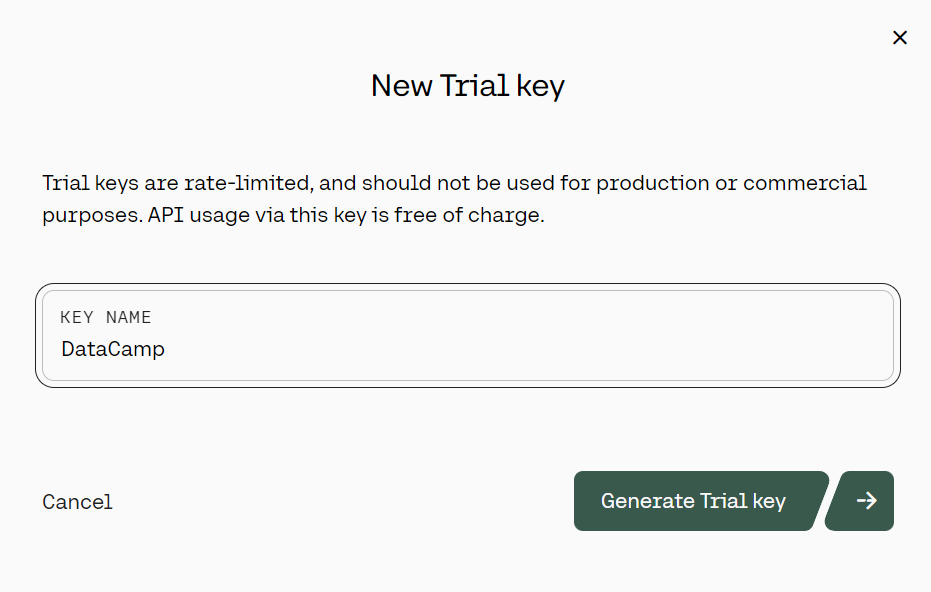
3. Ở bảng bên trái, nhấp “API keys”, sau đó cuộn xuống và nhấn “+ Create Trail key.”
Tạo khóa API dùng thử của Cohere. Nguồn: cohere.com
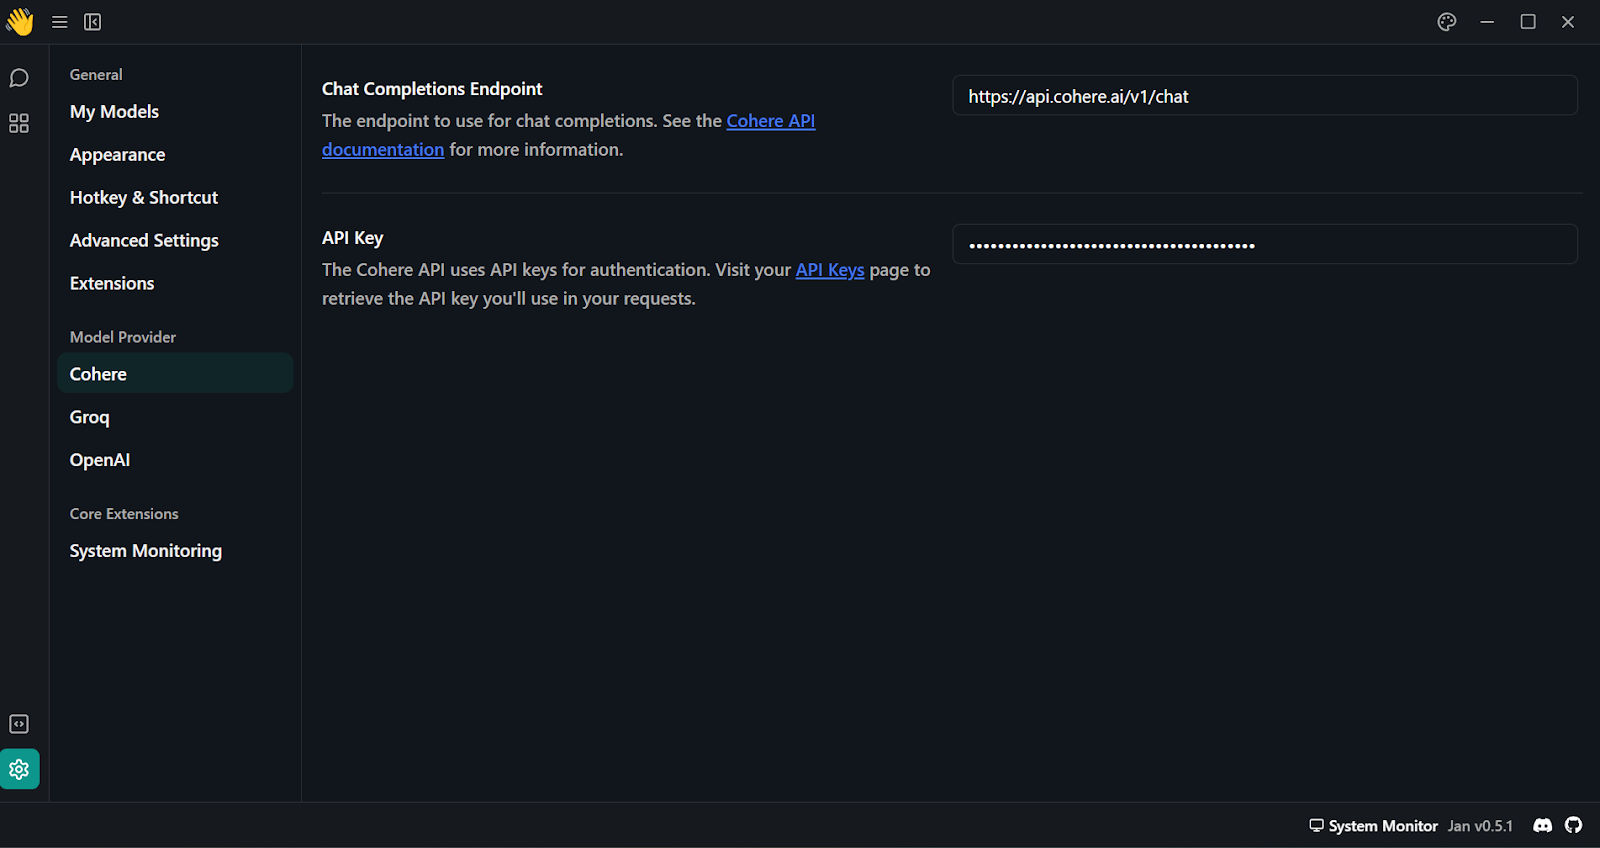
4. Sau khi tạo khóa Cohere API, dán nó vào phần “Model Provider”. Bạn có thể truy cập menu này bằng cách vào “Settings” và tìm “Cohere”.
Thêm khóa Cohere API trong ứng dụng Jan
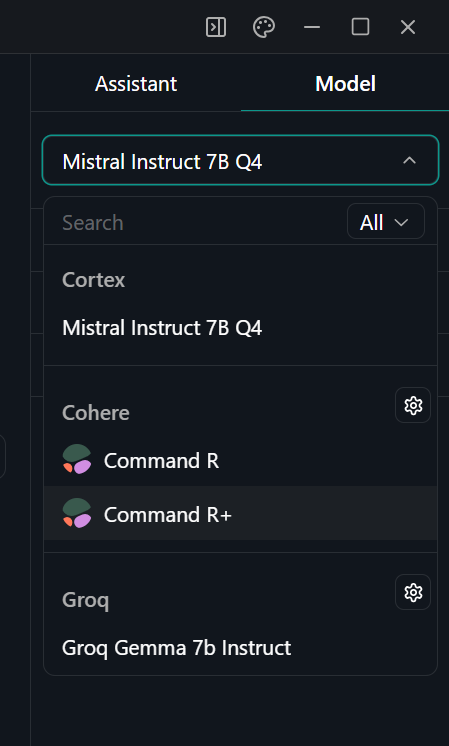
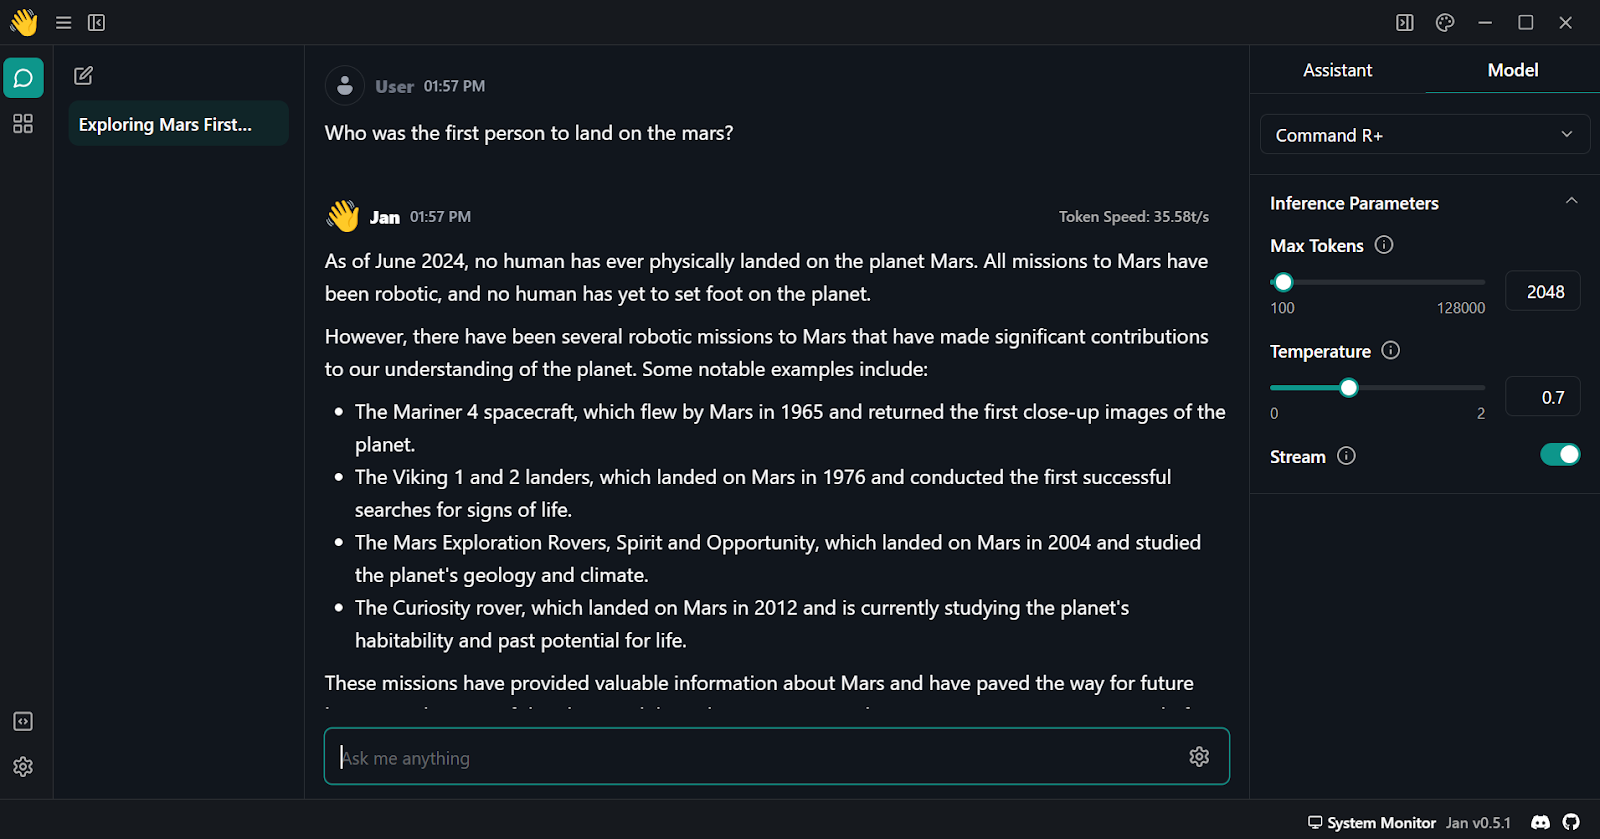
5. Chọn mô hình Command R+ bằng cách vào menu “Thread” và ở bảng bên phải, chọn mô hình phù hợp.
Chọn mô hình trong ứng dụng Jan
6. Bắt đầu nhập lệnh và đảm bảo bạn bật “Stream”.
Sử dụng Cohere Command R plus trong ứng dụng Jan
Trong phần này, bạn sẽ học cách thiết lập và sử dụng Python API để tạo phản hồi.
1. Cài đặt gói Cohere Python bằng pip.
pip install cohere2. Tạo một khóa Cohere API mới. Bạn có thể làm theo các bước trong phần “Sử dụng Cohere Command R+ qua API”.
Tạo khóa API dùng thử của Cohere. Nguồn hình: cohere.com
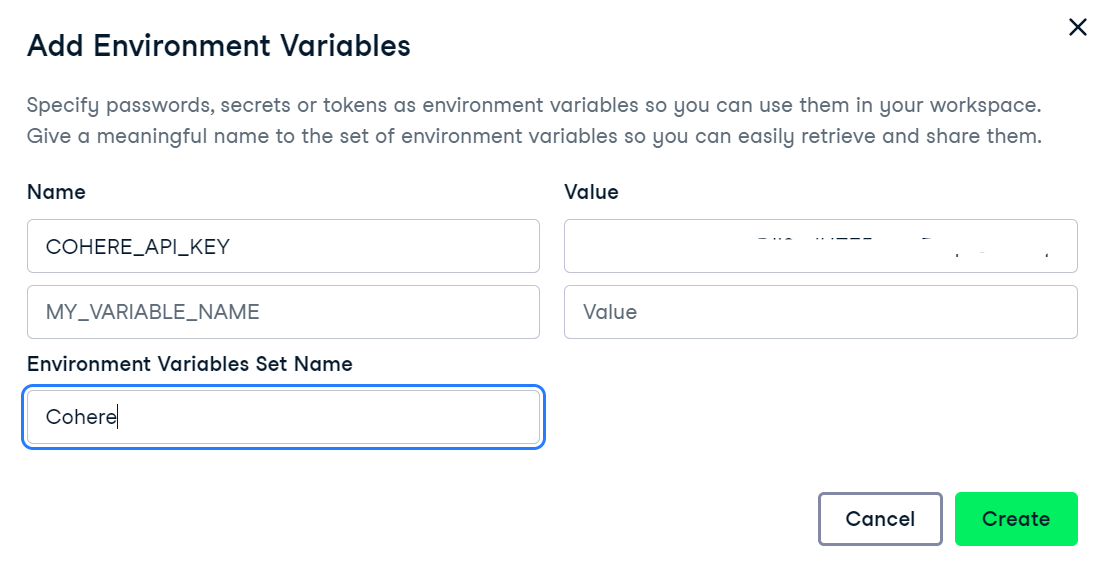
3. Chúng ta sẽ dùng DataLab của DataCamp làm môi trường phát triển. Để thiết lập biến môi trường trong DataLab, làm theo các bước sau:
Thêm biến môi trường trong DataLab
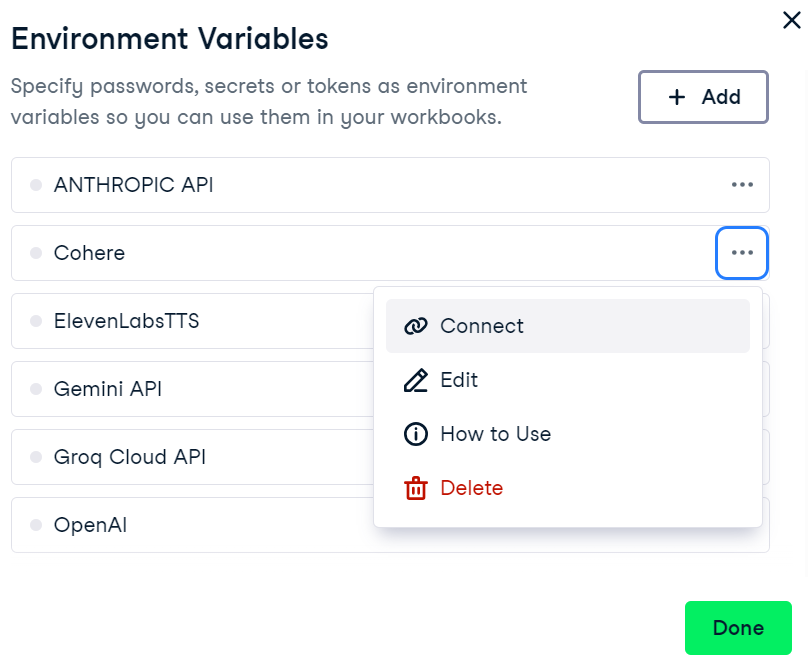
4. Để kích hoạt biến môi trường trong DataLab của DataCamp, vào menu biến môi trường, nhấp ba chấm cạnh “Cohere” rồi nhấp “Connect”.
Kết nối biến môi trường Cohere trong DataLab
5. Giờ đây, trong notebook của bạn, khởi tạo client Cohere bằng cách cung cấp API key. Thực hiện bằng cách nhập thư viện Cohere và tạo một đối tượng client với API key của bạn.
import os
import cohere

cohere_api_key = os.environ["COHERE_API_KEY"]
co = cohere.Client(api_key=cohere_api_key)
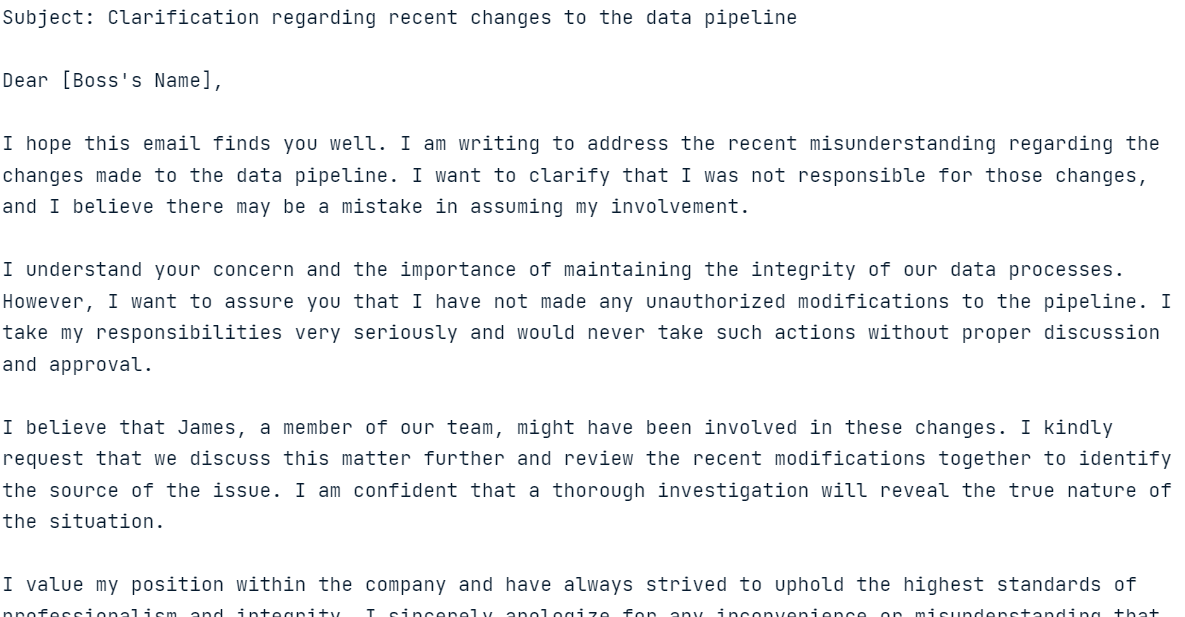
6. Để tạo phản hồi bằng hàm .chat() hãy cung cấp model name và message.
response = co.chat(
  model="command-r-plus",
  message="Please help me write an email to the angry boss, who thinks I made the changes to the data pipeline but didn't. It was James."
)

print(response.text)
Phản hồi của mô hình cho truy vấn đã cung cấp
Quá trình tạo phản hồi sẽ nhanh và rất phù hợp!
Ở phần tiếp theo, chúng ta sẽ khám phá nhiều tính năng của Cohere Python API.
Giờ đây, chúng ta sẽ khám phá Cohere Python API để tạo phản hồi có lịch sử, stream phản hồi và nhận đầu ra có thể dự đoán. Chúng ta cũng sẽ thực hiện RAG, chuyển văn bản thành embedding và tinh chỉnh mô hình trên bộ dữ liệu tùy chỉnh.
Ở phần trước, chúng ta đã học cách tạo phản hồi bằng hàm .chat() đơn giản. Bây giờ, chúng ta sẽ cung cấp thêm các đối số như system prompt (preamble), chat_history, max_tokens và temperature.
response = co.chat(
    model="command-r-plus",
    preamble="You are a happy chatbot that puts a positive spin on everything.",
    chat_history=[
       {"role": "USER", "text": "Hey, my name is Abid!"},
       {"role": "CHATBOT", "text": "Hey Abid! How can I help you today?"},
    ],
    message="I can't swim?",
    max_tokens=150,
    temperature=0.7
)

print(response.text)
Phản hồi của mô hình với các đối số bổ sung
Dựa trên các đối số bổ sung, mô hình đã điều chỉnh phản hồi.
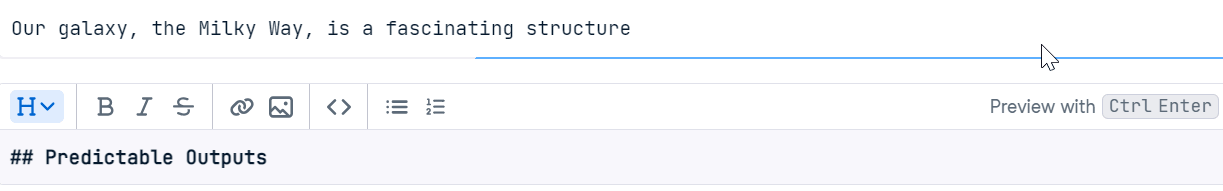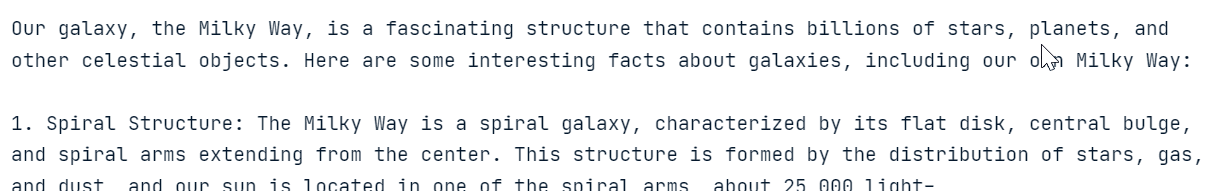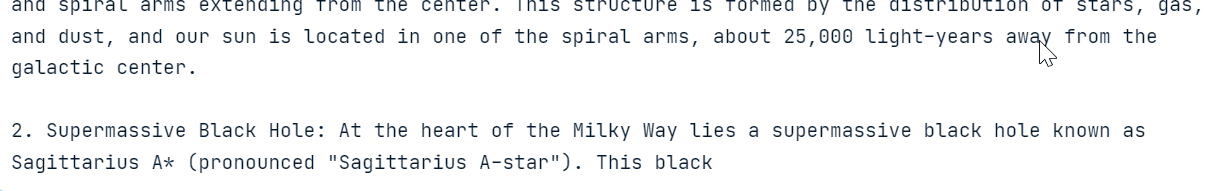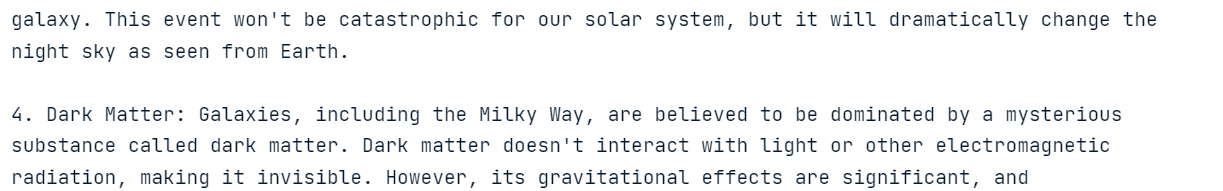
Chúng ta cũng có thể stream phản hồi bằng cách dùng hàm .chat_stream(). Hàm này cho phép tạo phản hồi theo thời gian thực, xuất token ngay khi sẵn sàng, giúp tăng cảm nhận về tốc độ của mô hình.
response = co.chat_stream(
    model="command-r-plus",
    message="Tell me something interesting about the galaxy?"
)

for event in response:
    if event.event_type == "text-generation":
      print(event.text, end="")
    elif event.event_type == "stream-end":
      print(event.finish_reason, end="")
Mô hình trả về token theo thời gian thực
Đầu ra có thể dự đoán là một tính năng độc đáo của Cohere. Bằng cách đặt đối số seed, chúng ta có thể khiến mô hình tạo cùng một phản hồi cho cùng một prompt.
Thông thường, khi bạn hỏi một LLM cùng câu hỏi hai lần, bạn sẽ nhận được câu trả lời khác nhau. Thiết lập seed đảm bảo kết quả nhất quán và có thể tái lập, giống như bất kỳ mô hình machine learning nào.
Trong ví dụ sau, bằng cách đặt đối số seed thành 55, bạn sẽ luôn nhận được "Matilda" làm phản hồi.
res = co.chat(model="command-r", message="say a random name", seed=55)
print(res.text)
Sure! I will pick a random name for you. How about "Matilda"?Để kiểm chứng, chúng ta lại hỏi mô hình cùng câu hỏi với cùng seed.
res = co.chat(model="command-r", message="say a random name", seed=55)
print(res.text)
Sure! I will pick a random name for you. How about "Matilda"?Và nó đã cho ra cùng một kết quả!
Cohere API cung cấp sẵn hàm để thực hiện RAG. Chúng ta chỉ cần cung cấp đối số documents cho hàm .chat(). Khi đặt câu hỏi, nó sẽ chạy tìm kiếm tương đồng trên tài liệu để tạo câu trả lời theo ngữ cảnh.
Chúng ta sẽ dùng các tài liệu nghiên cứu anime làm ví dụ. Định dạng tài liệu nên tương tự như ví dụ bên dưới. Mỗi tài liệu cần có khóa title và snippet.
anime = [
    {
        "title": "Naruto Popularity Analysis",
        "snippet": "Naruto's global success: massive manga sales, top anime ratings, extensive merchandise, and a dedicated fanbase. The series' impact on anime culture and its influence on subsequent shonen series is undeniable."
    },
    {
        "title": "One Piece Popularity Analysis",
        "snippet": "One Piece's record-breaking manga sales and its status as a long-running anime phenomenon highlight its popularity. The series' captivating story and characters have made it a staple in the anime community."
    },
    {
        "title": "Attack on Titan Popularity Analysis",
        "snippet": "Attack on Titan's intense storyline and high-quality animation have garnered a massive following. Its success in both manga and anime formats demonstrates its widespread appeal."
    },
    {
        "title": "My Hero Academia Popularity Analysis",
        "snippet": "My Hero Academia's rapid rise to fame is marked by its engaging characters and compelling plot. The series has achieved impressive manga sales and anime viewership."
    }
]
Để tạo câu trả lời chính xác và theo ngữ cảnh, chúng ta sẽ cung cấp tài liệu anime cho đối số documents trong hàm .chat().
response = co.chat(
    model="command-r-plus",
    message="Which Anime series have most engaging characters?",
    documents=anime,
)

print(response.text)
Some anime series with engaging characters include My Hero Academia and One Piece.Như bạn thấy, mô hình sử dụng tài liệu để tạo câu trả lời chính xác cao.
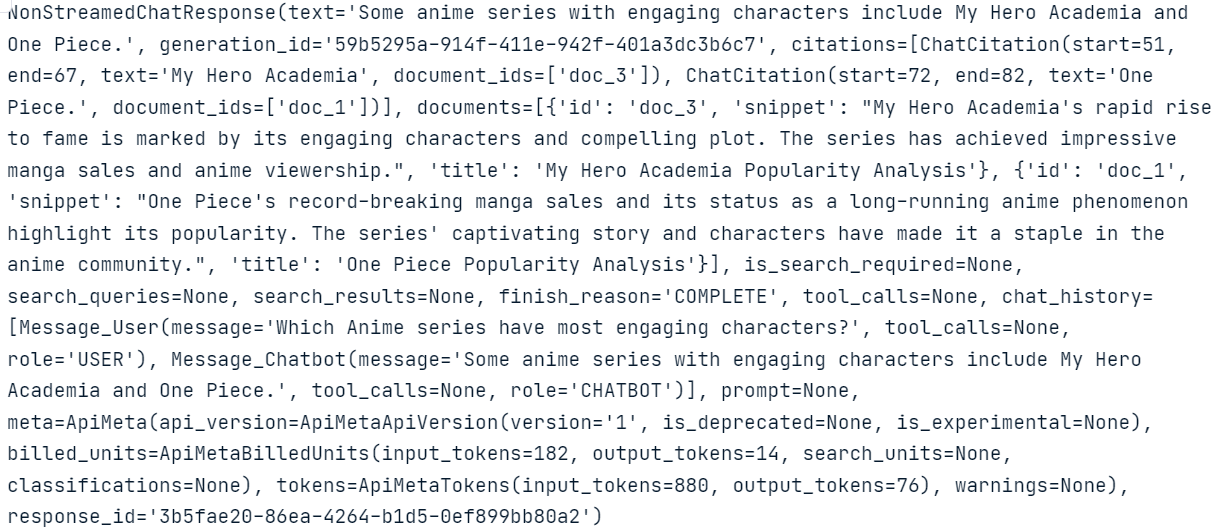
Nếu bạn muốn biết điều gì diễn ra phía sau và mô hình tạo phản hồi thế nào, bạn chỉ cần in toàn bộ response kèm metadata.
response
Lưu ý phần ChatCitation và cách hàm .chat() của Cohere đã dùng các đoạn trích trong tài liệu để tạo phản hồi.
Chúng ta cũng có thể kết nối công cụ và connector với hàm .chat(). Ở ví dụ sau, chúng ta kết nối công cụ tìm kiếm internet với mô hình để tạo câu trả lời cập nhật.
response = co.chat(
    model="command-r-plus",
    message="Which Anime series have most engaging characters?",
    connectors=[{"id": "web-search"}],
)

print(response.text)
Here are some Anime series with engaging characters:
- Jujutsu Kaisen
- One Piece
- Naruto
- Dragon Ball Z
- Bleach
- Death Note
- Fullmetal Alchemist: Brotherhood
- Demon Slayer: Kimetsu no Yaiba
- Attack on Titan
- Mob Psycho 100
- Trigun
- My Hero Academia
- Cowboy Bebop
- Komi Can't Communicate
- Spy X FamilyTrong trường hợp này, mô hình tra cứu thông tin trên Internet rồi cung cấp ngữ cảnh cho mô hình để tạo kết quả cập nhật và chính xác.
Bạn có thể khám phá thêm sức mạnh của LLM với các cơ chế truy xuất thông tin hiệu quả bằng cách theo dõi hướng dẫn Tăng độ chính xác LLM với Retrieval Augmented Generation (RAG) và Reranking.
Text embedding là các biểu diễn số của văn bản nắm bắt ý nghĩa ngữ nghĩa, cho phép tìm kiếm tương đồng và phân tích dữ liệu văn bản hiệu quả.
Với hàm .embed() của Cohere, chúng ta có thể chuyển văn bản thành vector embedding cho truy vấn tìm kiếm. Chỉ cần cung cấp tên model, danh sách texts, input_type và embedding_types cho hàm.
texts = [ 'I love you', 'I hate you', 'Who are you?']

response = co.embed(
  model='embed-english-v3.0',
  texts=texts,
  input_type='search_query',
  embedding_types=['float'])


embeddings = response.embeddings.float # All text embeddings
print(embeddings[2][:5])
[-0.00459671, -0.010803223, -0.048339844, -0.012306213, -0.019134521]Cohere cũng cho phép chúng ta chuyển văn bản nhiều ngôn ngữ thành embedding. Để làm vậy, chúng ta đổi mô hình embedding sang “embed-multilingual-v3.0” và đặt input_type thành “classification”.
texts = [
   'I love you', 'Te quiero', 'Ich liebe dich',
   'Ti amo', 'Я тебя люблю', ' 我爱你 ',
   '愛してる', 'أحبك', 'मैं तुमसे प्यार करता हूँ'
]

response = co.embed(
  model='embed-multilingual-v3.0',
  texts=texts,
  input_type='classification',
  embedding_types=['float'])

embeddings = response.embeddings.float # All text embeddings
print(embeddings[2][:5])
[-0.011756897, 0.0116119385, -0.005115509, 0.011657715, -0.001660347]Giống như OpenAI API, Cohere API cho phép chúng ta tinh chỉnh mô hình trên bộ dữ liệu tùy chỉnh. Để làm vậy, chúng ta tải dữ liệu lên và chạy hàm fine-tuning. Đơn giản như vậy.
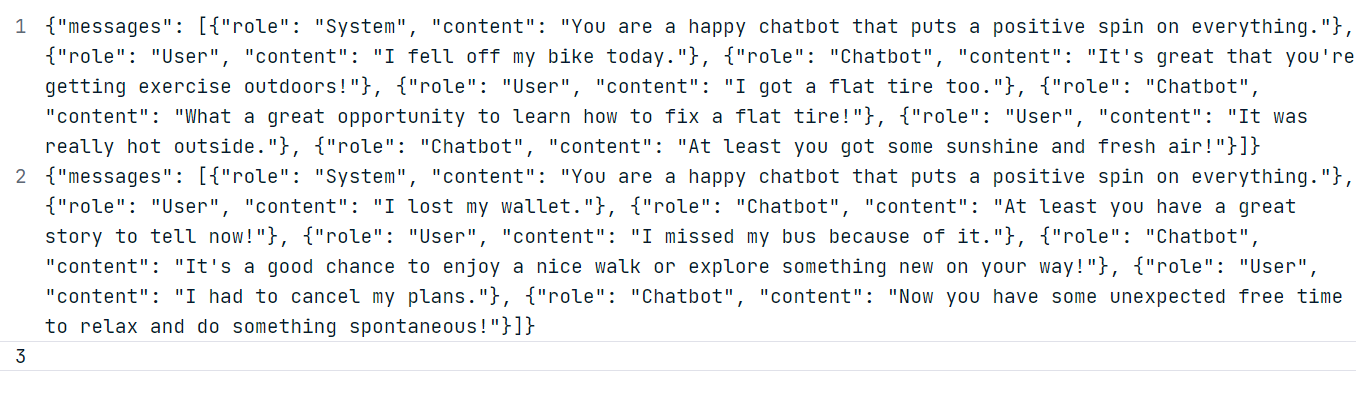
Trong ví dụ, chúng ta sẽ tạo hai bộ dữ liệu tùy chỉnh bằng mô hình ChatGPT (GPT-4o). Hãy làm theo định dạng dataset như bên dưới.
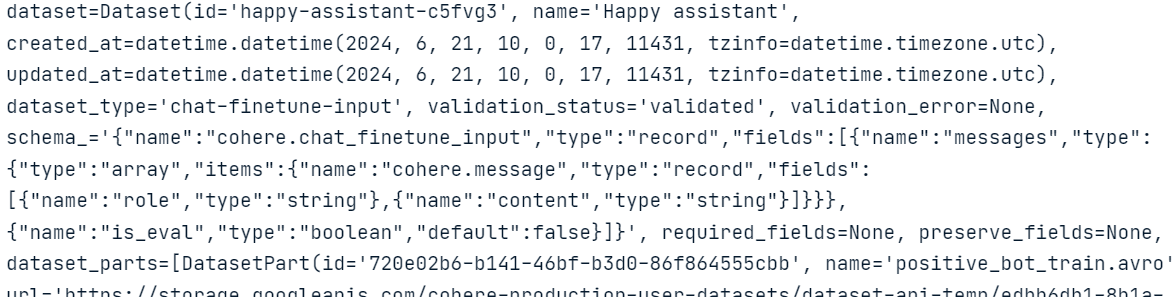
Dùng dữ liệu đã tạo, hãy tạo file JSONL “positive_bot_train” và “positive_bot_eval” rồi cung cấp vị trí tệp cho hàm .datasets.create(). Hàm cũng yêu cầu tên dataset và type fine-tuning.
my_dataset = co.datasets.create(
  name="Happy assistant",
  type="chat-finetune-input",
  data=open("./data/positive_bot_train.jsonl", "rb"),
  eval_data=open("./data/positive_bot_eval.jsonl", "rb")
)

result = co.wait(my_dataset)
print(result)
Như ta thấy, hàm đã xác thực dataset và tải nó lên bộ nhớ đám mây của Cohere.
Giờ chúng ta chỉ cần cung cấp name mô hình, base_type và dataset_id cho hàm .finetuning.create_finetuned_model(), hàm này sẽ khởi chạy quá trình fine-tuning trên đám mây.
from cohere.finetuning import FinetunedModel, Settings, BaseModel

# start training a custom model using the dataset
finetuned_model = co.finetuning.create_finetuned_model(
  request=FinetunedModel(
    name="happy-chat-bot-model",
    settings=Settings(
      base_model=BaseModel(
        base_type="BASE_TYPE_CHAT",
      ),
      dataset_id=my_dataset.id,
    ),
  ),
)
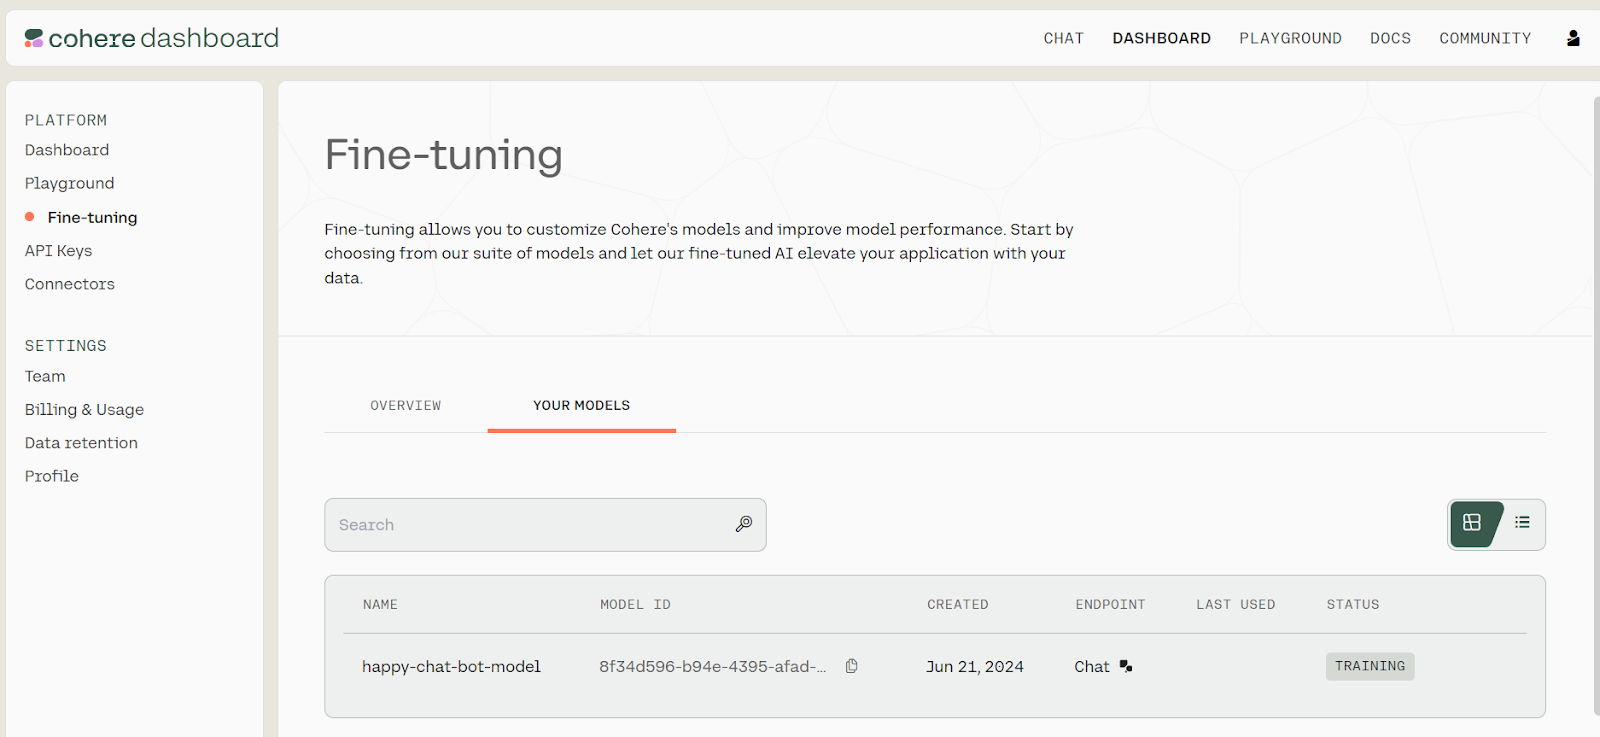
Để xem tiến độ fine-tuning, vào bảng điều khiển Cohere và nhấp “Fine-tuning” ở bảng bên trái.
Trạng thái fine-tuning. Nguồn: Models | Cohere
Việc fine-tune mô hình và tạo báo cáo đánh giá có thể mất vài phút.
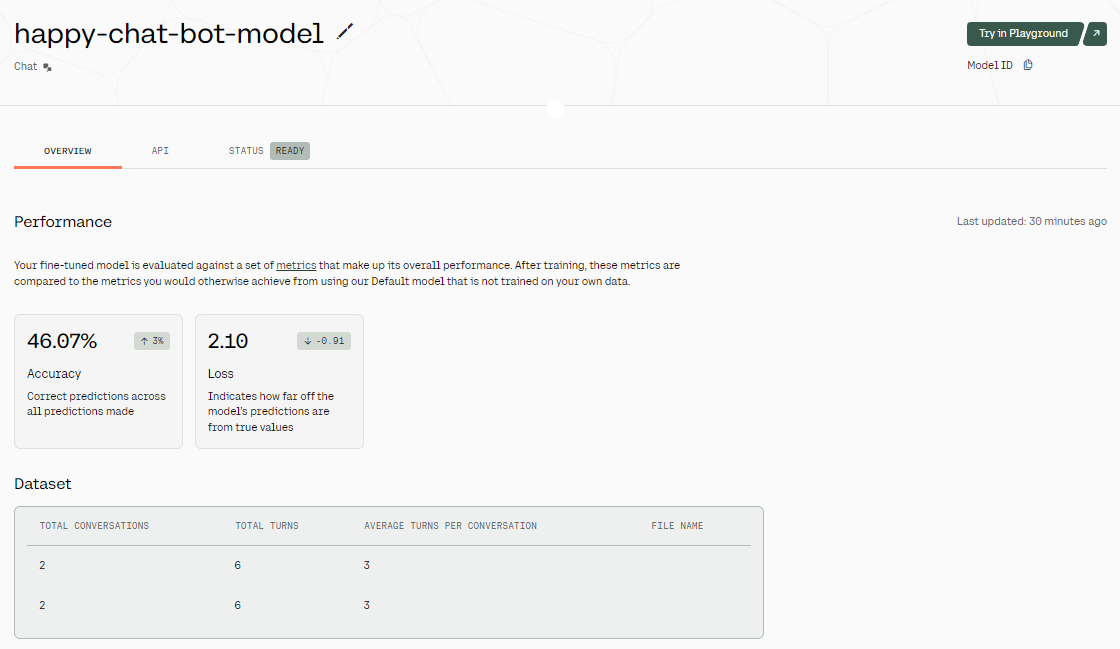
Kết quả fine-tuning. Nguồn hình: Fine-tuned Model - happy-chat-bot-model | Cohere
Khi mô hình đã được tinh chỉnh, chúng ta sẽ có cái nhìn tổng quan về kết quả. Như bạn thấy ở hình trên, độ chính xác của mô hình khá thấp. Tại sao? Chúng ta chỉ cung cấp dataset gồm hai dòng. Để cải thiện độ chính xác, hãy cung cấp dữ liệu thực tế với ít nhất 1000 dòng.
Để truy cập mô hình đã tinh chỉnh, chúng ta có thể cung cấp ID mô hình cho hàm .chat() cùng với preamble, message và max_tokens.
Bạn có thể tìm ID mô hình bằng cách vào bảng điều khiển, chọn “Fine-tuning”, sau đó "YOUR MODELS," và sao chép ID mô hình từ danh sách các mô hình đã tinh chỉnh.
response = co.chat(
    model="8f34d596-b94e-4395-afad-1db35b2b0b53-ft",
    preamble="You are a happy chatbot that puts a positive spin on everything.",
    message="I burned my finger while barbecuing.",
    max_tokens=100
)

print(response.text)
Ouch! That doesn't sound fun, but it's great that you're taking time to relax and enjoy some delicious grilled foods. Barbecuing is a wonderful way to spend time with friends and family, and it's an excellent opportunity to savor the little things in life. Remember to take care of your burn; it's a small price to pay for a fun day making delicious memories!Phản hồi tạo ra không tệ chút nào!
Bây giờ, chúng ta sẽ xây dựng một Tác nhân AI đa bước bằng hệ sinh thái LangChain và mô hình Cohere Command R+.
Ứng dụng AI này sẽ nhận truy vấn của người dùng để tìm kiếm web bằng Tavily API và tạo mã Python. Sau đó, nó sẽ dùng Python REPL để thực thi mã và trả về trực quan hóa theo yêu cầu.
Đầu tiên, chúng ta cần cài đặt tất cả gói Python cần thiết. Có thể thực hiện trong notebook DataLab.
%pip install --quiet langchain langchain_cohere langchain_experimentalTiếp theo, chúng ta dùng LangChain Python API để tạo client chat bằng cách cung cấp Cohere API key đã tạo trước đó. Chúng ta sẽ sử dụng Command R+ làm mô hình ngôn ngữ trong tác nhân AI.
import os
from langchain_cohere.chat_models import ChatCohere

cohere_api_key = os.environ["COHERE_API_KEY"]
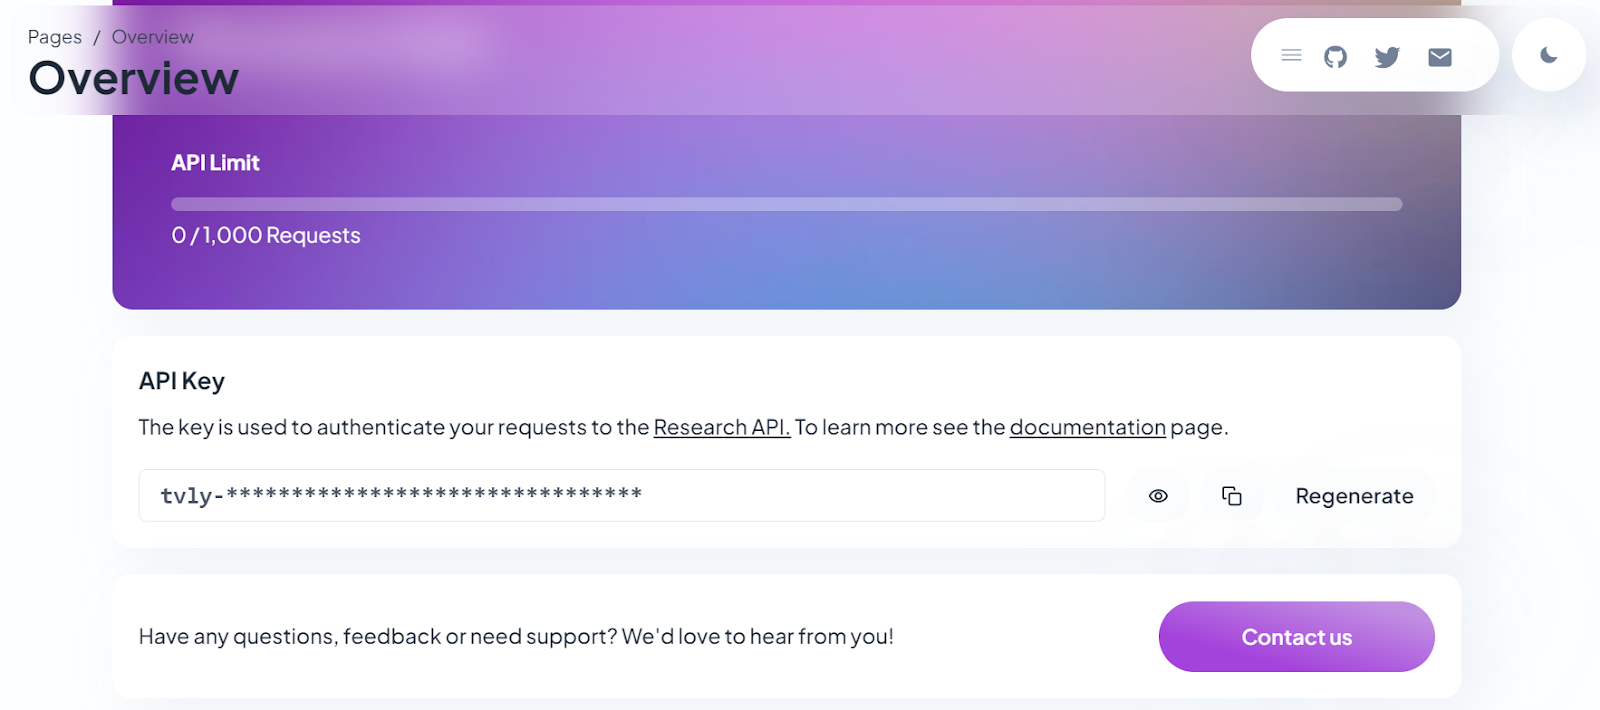
chat = ChatCohere(model="command-r-plus", temperature=0.7, api_key=cohere_api_key)Đăng ký Tavily và sao chép API key của bạn. Tavily là API tìm kiếm internet cho LLM và các pipeline RAG.
Tạo khóa Tavily API. Nguồn hình: Tavily AI
Để tạo công cụ tìm kiếm internet, hãy cung cấp API key vừa tạo làm biến môi trường trong DataLab. Sau đó, cập nhật name, description và args_schema.
from langchain_community.tools.tavily_search import TavilySearchResults

internet_search = TavilySearchResults(api_key=os.environ['TAVILY_API_KEY'])
internet_search.name = "internet_search"
internet_search.description = "Returns a list of relevant documents from the internet."

from langchain_core.pydantic_v1 import BaseModel, Field

class TavilySearchInput(BaseModel):
    query: str = Field(description="Internet query engine.")

internet_search.args_schema = TavilySearchInputTạo công cụ Python REPL rất đơn giản: cung cấp lớp Tool với một đối tượng Python REPL, name và description, và chỉnh sửa schema đối số như dưới đây.
from langchain.agents import Tool
from langchain_experimental.utilities import PythonREPL

python_repl = PythonREPL()
repl_tool = Tool(
    name="python_repl",
    description="Executes python code and returns the result.",
    func=python_repl.run,
)
repl_tool.name = "python_interpreter"

class ToolInput(BaseModel):
    code: str = Field(description="Python code execution.")

repl_tool.args_schema = ToolInputGiờ chúng ta sẽ kết hợp mọi thứ để tạo tác nhân AI đa bước bằng hàm .create_cohere_react_agent(), client mô hình Cohere, các công cụ và mẫu prompt. Để thực thi tác nhân AI, chúng ta sẽ dùng lớp AgentExecutor bằng cách cung cấp đối tượng agent và các công cụ.
from langchain.agents import AgentExecutor
from langchain_cohere.react_multi_hop.agent import create_cohere_react_agent
from langchain_core.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_template("{input}")

agent = create_cohere_react_agent(
    llm=chat,
    tools=[internet_search, repl_tool],
    prompt=prompt,
)

agent_executor = AgentExecutor(agent=agent, tools=[internet_search, repl_tool], verbose=True)Sau đó, chỉ cần dùng agent_executor để tạo trực quan hóa. Trong trường hợp của chúng ta, chúng ta yêu cầu tác nhân AI thu thập dữ liệu mới nhất từ internet và tạo biểu đồ tròn.
response = agent_executor.invoke({
    "input": "Create a pie chart of the top 5 most used programming languages in 2024.",
})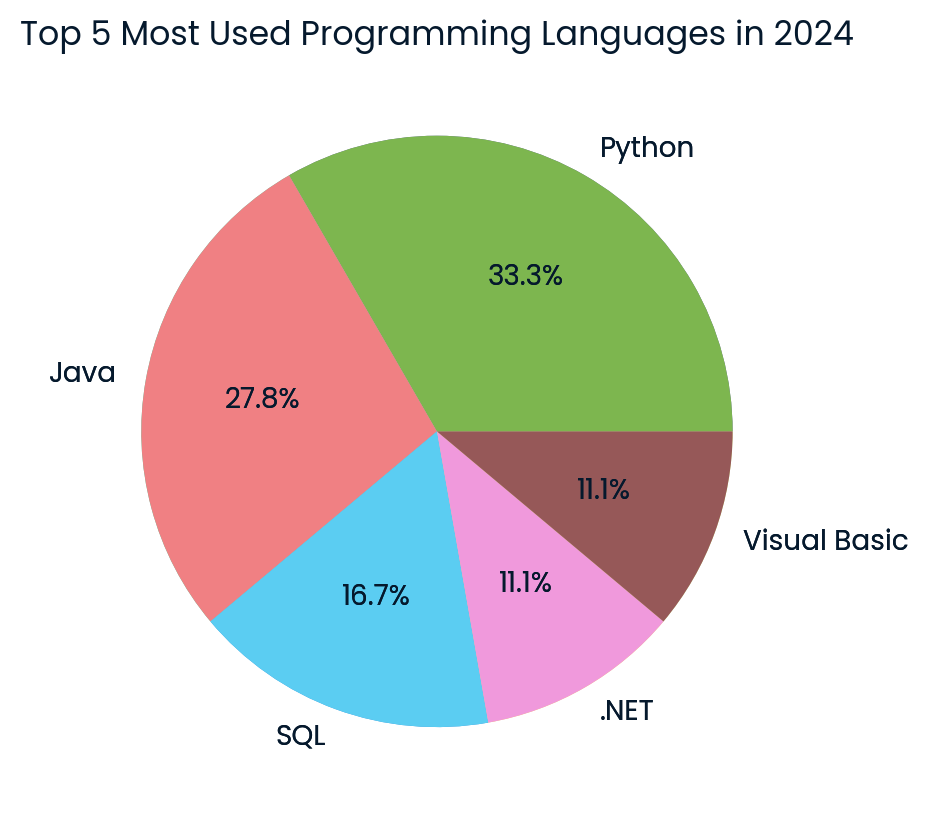
Biểu đồ tròn các ngôn ngữ lập trình hàng đầu do mô hình Cohere tạo. Hình ảnh bởi tác giả
Kết quả thật ấn tượng! Nó đã tạo biểu đồ tròn thành công bằng dữ liệu mới nhất từ internet.
Nếu bạn gặp vấn đề khi chạy mã trong hướng dẫn này, vui lòng kiểm tra workspace DataLab Cohere Command R+ Tutorial, nơi chứa mã nguồn, dataset và đầu ra.
Tương tự LangChain, bạn có thể dùng LlamaIndex để xây dựng tác nhân AI đa bước. Để bắt đầu với LlamaIndex, hãy xem video Retrieval Augmented Generation with LlamaIndex.
Thị trường AI lại đang nóng lên, và học các công cụ, API mới sẽ giúp bạn xây dựng hệ thống AI tốt hơn và củng cố hồ sơ của mình. Hơn nữa, nó sẽ đơn giản hóa quy trình làm việc, vì một số framework AI xử lý phần lớn tác vụ, bạn chỉ cần vài dòng mã.
Trong hướng dẫn này, chúng ta đã tìm hiểu về mô hình Cohere Command R+ và cách truy cập qua Hugging Face chat, ứng dụng Jan và API. Chúng ta cũng tìm hiểu về Python API và cách tinh chỉnh mô hình để tạo phản hồi tùy chỉnh. Cuối cùng, chúng ta đã xây dựng một tác nhân AI đúng nghĩa: nhận truy vấn người dùng, tìm kiếm internet để lấy dữ liệu mới nhất và tạo trực quan hóa bằng Python REPL.
Để tìm hiểu thêm về sức mạnh của LLM, cũng như cách tạo nội dung từ prompt, trích xuất thông tin từ tài liệu và xây dựng công cụ tìm kiếm ngữ nghĩa, hãy xem phiên code-along về sử dụng Mô hình Ngôn ngữ Lớn với Cohere API.
Tìm hiểu thêm về AI và LLM qua các khóa học sau!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
