

Kurs
Large Language Models (LLMs) Kavramları
2 sa
113.4K
Uygulamalı bir projeyle yapay zeka bilginizi genişletmek mi istiyorsunuz? Bu eğitimde, Cohere Command R+’ı; çevrimiçi ve yerelde nasıl erişileceğini de dahil ederek inceleyeceğiz. Ayrıca Cohere Python API’sinin temel özelliklerine dalacak ve LangChain ile Tavily kullanarak bir yapay zeka projesi geliştireceğiz.
Heyecan verici kısım projeyle başlıyor. Cohere modellerini ve özelliklerini zaten biliyorsanız, doğrudan proje bölümüne geçebilirsiniz. Orada, bir görevi tamamlamak için birden çok aracı sıralı olarak kullanan bir yapay zeka ajanını nasıl oluşturacağınızı öğreneceksiniz.
Yapay zekaya yeniyseniz ve alan hakkında daha fazla bilgi edinmek istiyorsanız Yapay Zeka Temelleri öğrenme yolunu düşünebilirsiniz. ChatGPT, Büyük Dil Modelleri (LLM’ler), üretken yapay zeka ve daha fazlası gibi popüler konularda uygulanabilir bilgi edineceksiniz.
Command R+, Cohere’in en yeni ve son teknoloji LLM modelidir. Model, sohbet etkileşimlerinde ve uzun bağlamlı görevlerde öne çıkar. Özellikle karmaşık Alma Destekli Üretim (RAG) iş akışları ve çok adımlı araç kullanımı için optimize edilmiştir; bu da onu kurumsal ölçekli uygulamalar için güçlü bir araç haline getirir.
Görsel: yazar
Command R+ modelinin en önemli özelliklerinden bazıları şunlardır.
Cohere modellerini daha iyi anlamak için Cohere API Eğitimi: Cohere Modellerine Başlarken yazımızı mutlaka okuyun.
Cohere modellerine erişmenin çoğu ücretsiz olan farklı yolları vardır.
Çevrimiçi LLM oyun alanına erişebilir veya modeli yerel olarak indirip bir sohbet uygulamasıyla kullanabilirsiniz. Ayrıca Cohere API’si üzerinden de erişebilirsiniz. Her bir yöntemi gözden geçirelim.
Cohere Command R+’a çevrimiçi erişmenin en basit yolu HuggingChat web sitesidir. Sınırlaması yoktur ve görüntü oluşturma veya internet araması gibi farklı görevler için mevcut altı araçla bağlayabilirsiniz.
1. https://huggingface.co/chat/ adresine gidin.
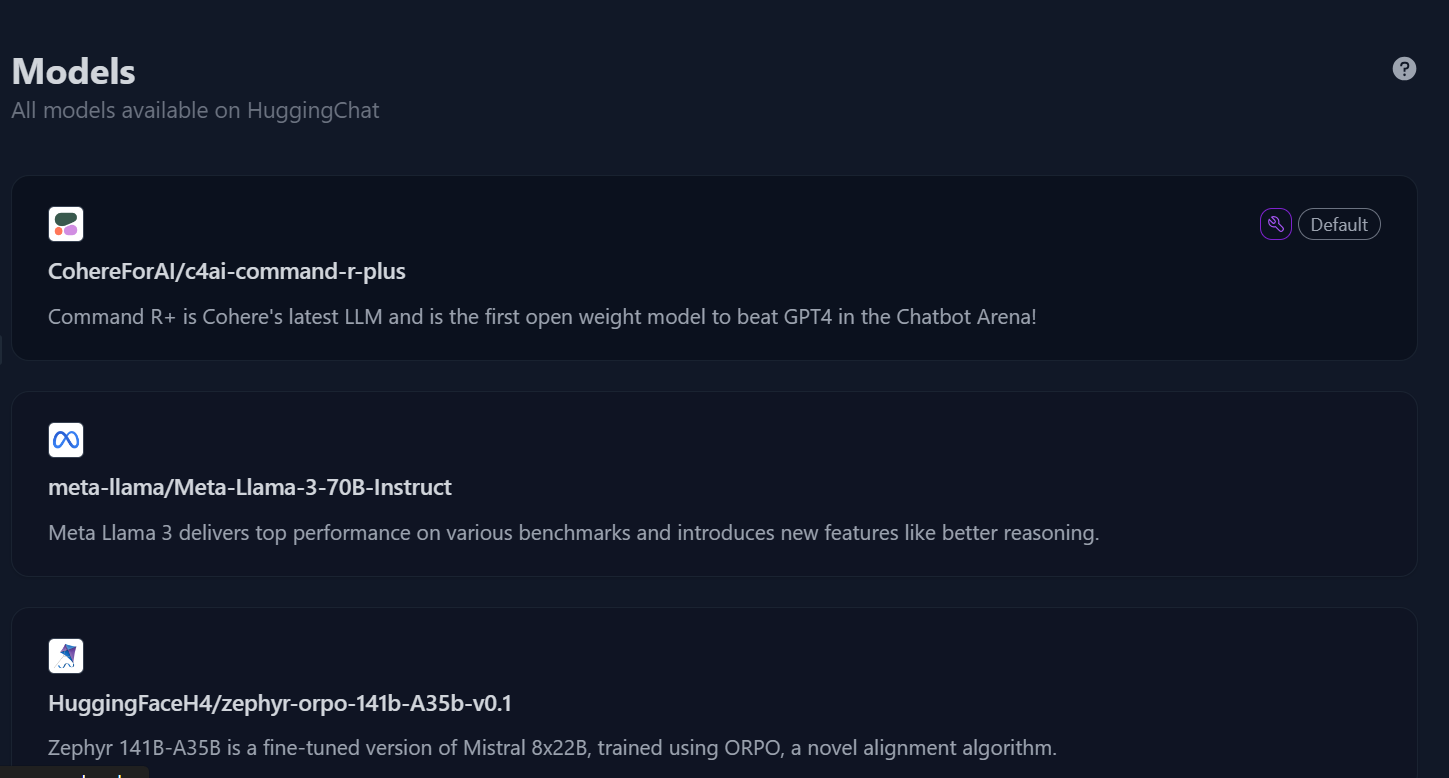
2. Sol panelde, model menüsüne erişmek için “Models” düğmesine tıklayın, ardından “c4ai-command-r-plus” modelini seçin.
Hugging Chat’te model dizini. Görsel kaynağı: HuggingChat
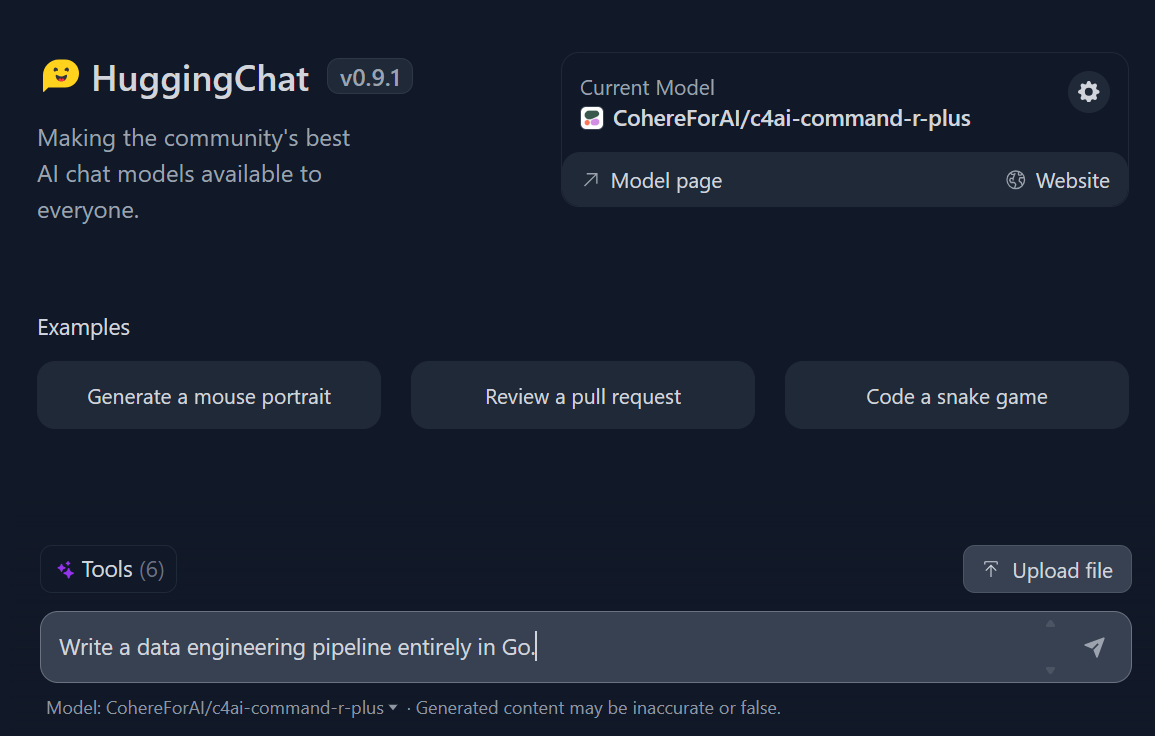
3. Sorgunuzu yazmaya başlayın; hızlı ve oldukça isabetli bir yanıt üretecektir.
Hugging Chat’te istem verme. Görsel kaynağı: HuggingChat
Command R+’ı yerelde iki şekilde kullanabilirsiniz: modeli yerel makinenize indirerek veya Jan sohbet uygulamasına bir API anahtarı sağlayarak.
İkinci seçeneği inceleyelim.
1. Jan’ı https://jan.ai/ adresinden indirin ve kurun.
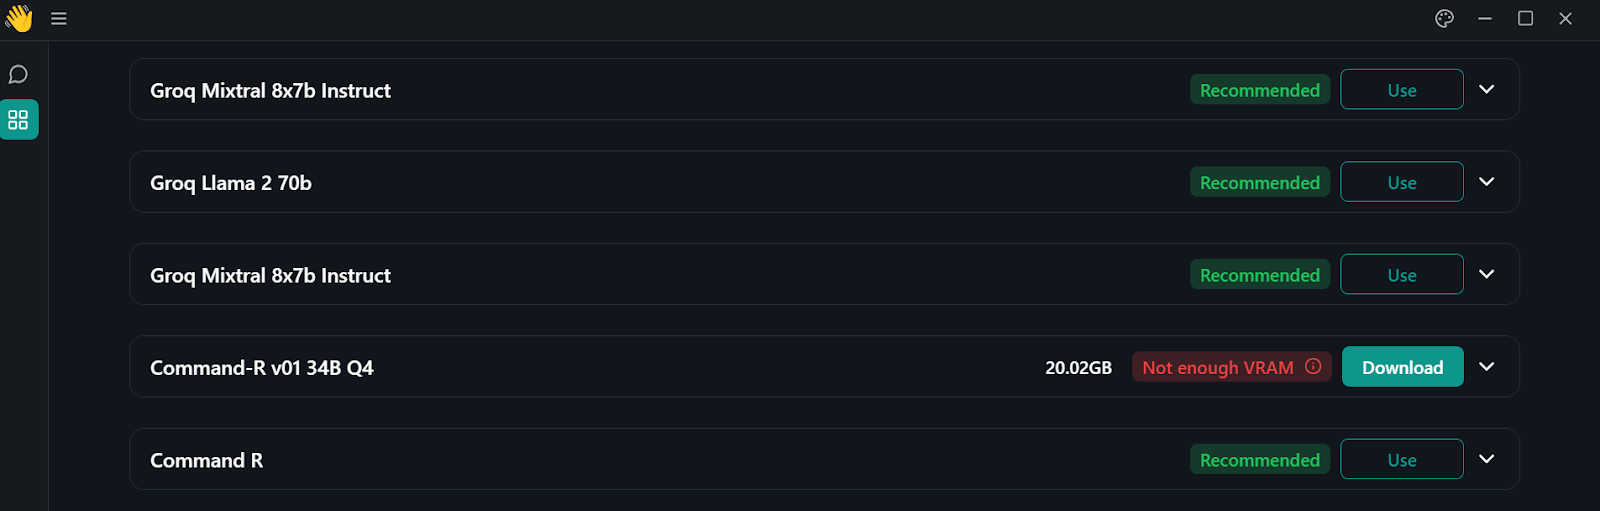
2. Sol paneldeki Windows düğmesine tıklayarak model merkezine gidin.
Jan uygulamasında model dizini
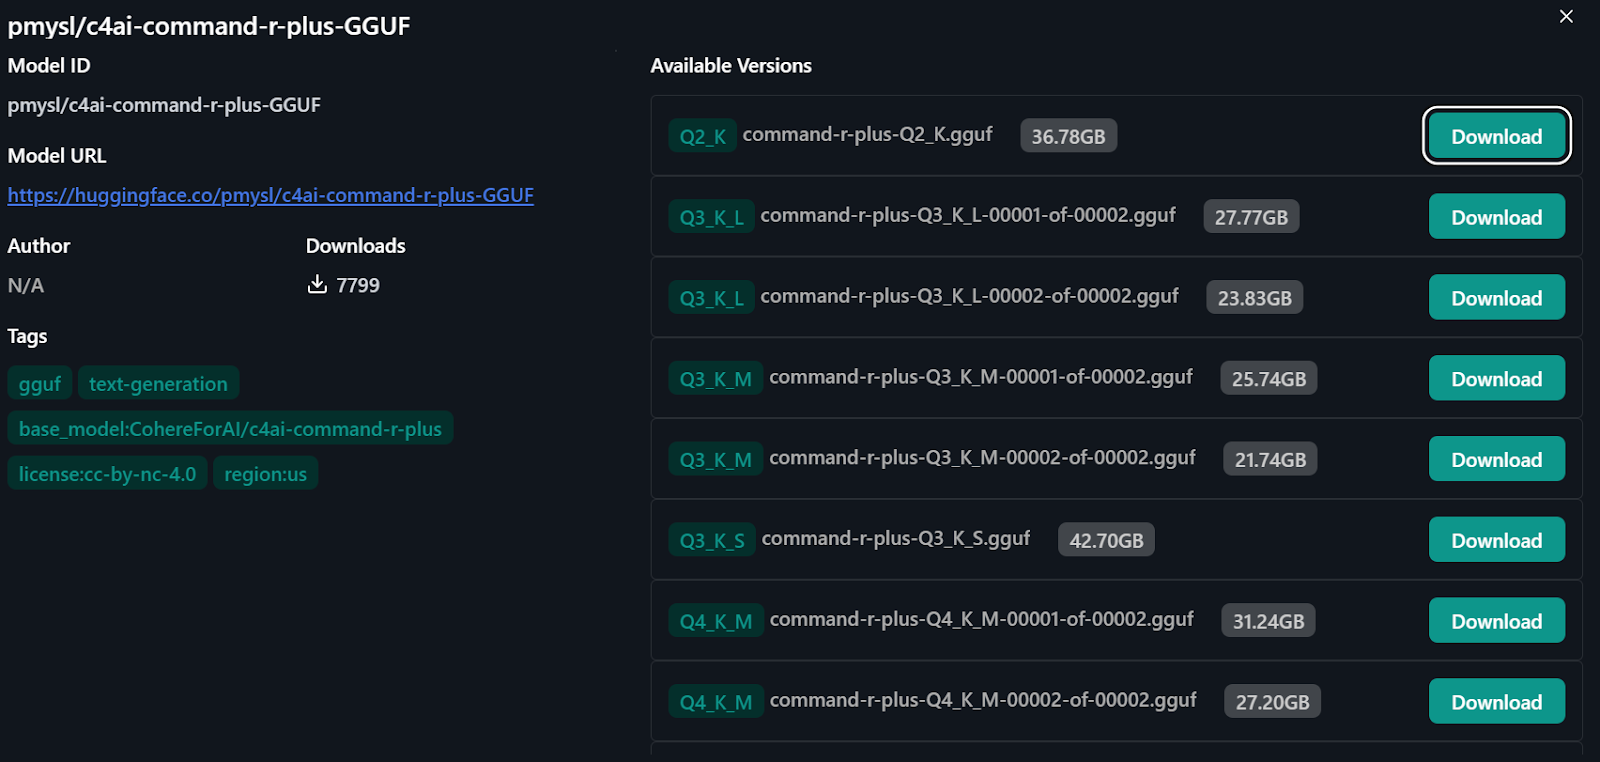
3. Command R+ modeline erişmek için model merkezi arama çubuğuna “pmysl/c4ai-command-r-plus-GGUF” yazın.
4. Yaklaşık 31,24 GB olan modelin “Q4_K_M sürümü”nü indirin ve kullanmaya başlayın.
Modeli Hugging Face’ten içe aktarma
Command R+ modelini yerelde kullanmanın bir başka yolu da Cohere API’sini Jan uygulamasıyla bağlamaktır.
1. https://coral.cohere.com/ adresine gidin ve oturum açın.
2. “Dashboard”a gidin.
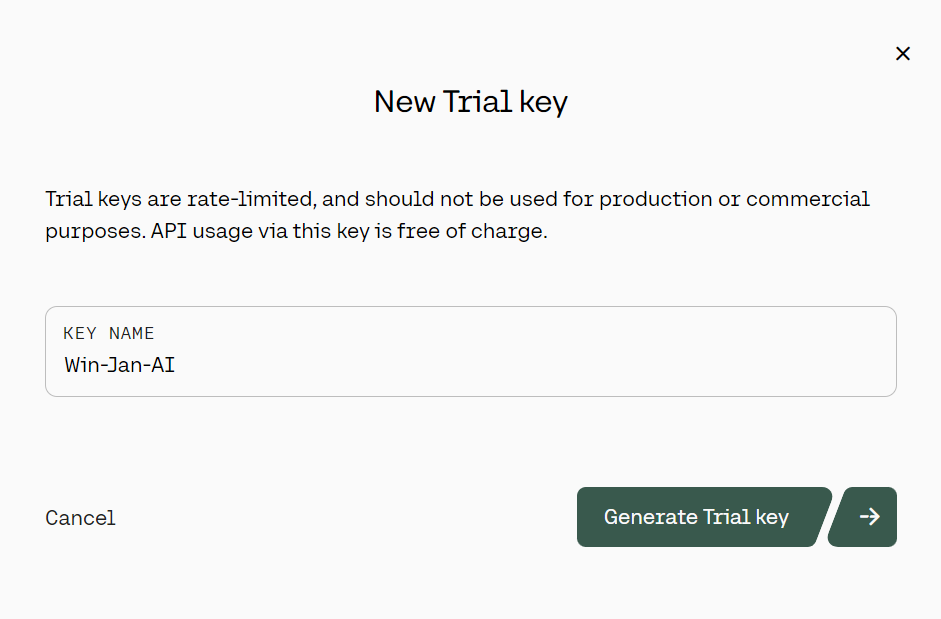
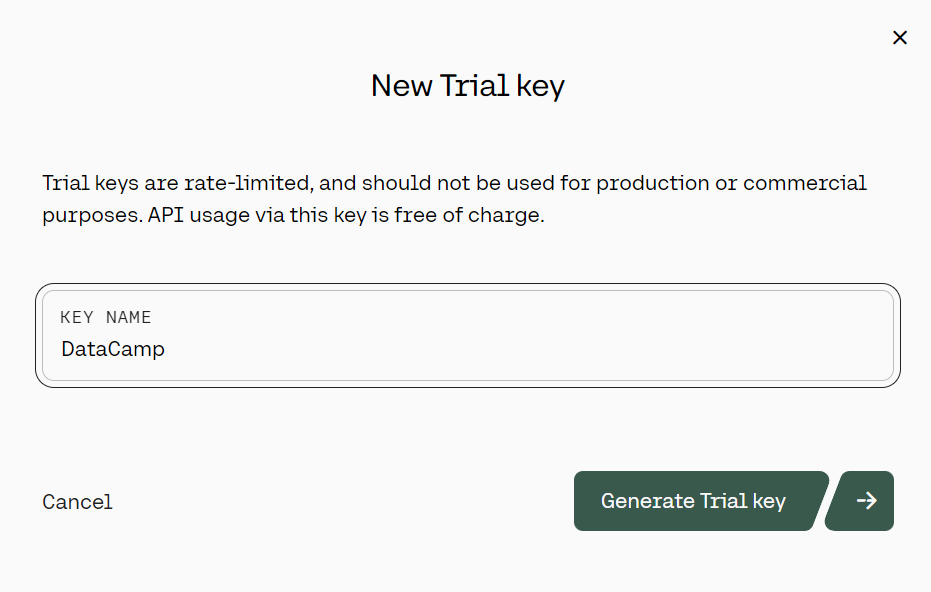
3. Sol panelde “API keys” düğmesine tıklayın, ardından aşağı kaydırıp “+ Create Trail key.” seçeneğine tıklayın.
Cohere deneme API anahtarının oluşturulması. Kaynak: cohere.com
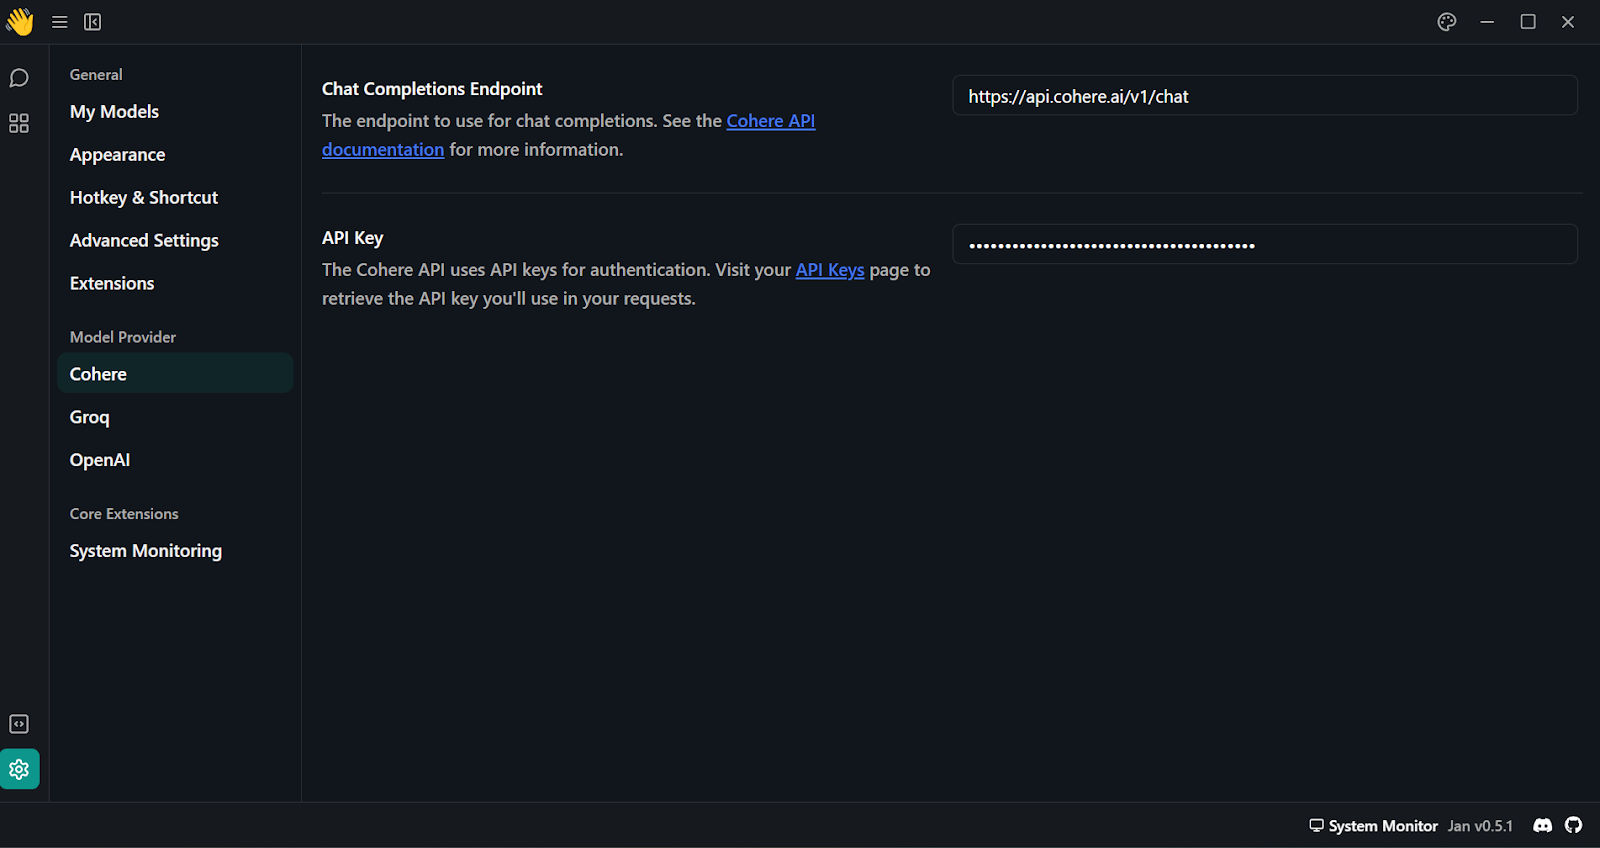
4. Cohere API anahtarını oluşturduktan sonra, “Model Provider” bölümüne yapıştırın. Bu menüye “Settings”e gidip “Cohere”ı bularak erişebilirsiniz.
Jan uygulamasına Cohere API anahtarı ekleme
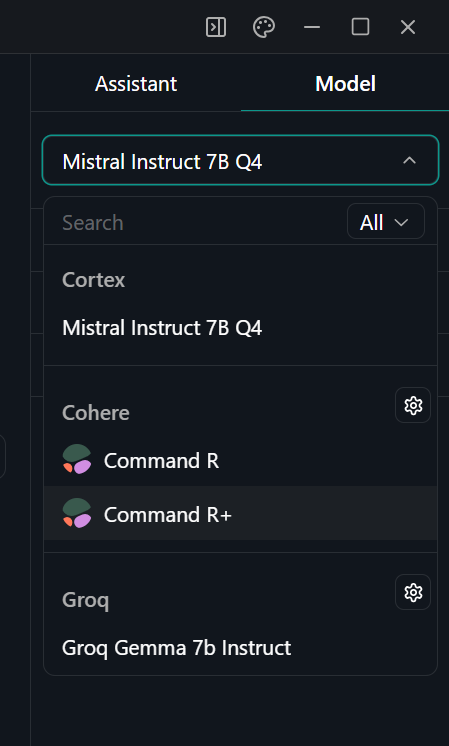
5. “Thread” menüsüne giderek Command R+ modelini seçin ve sağ panelden uygun modeli işaretleyin.
Jan uygulamasında model seçimi
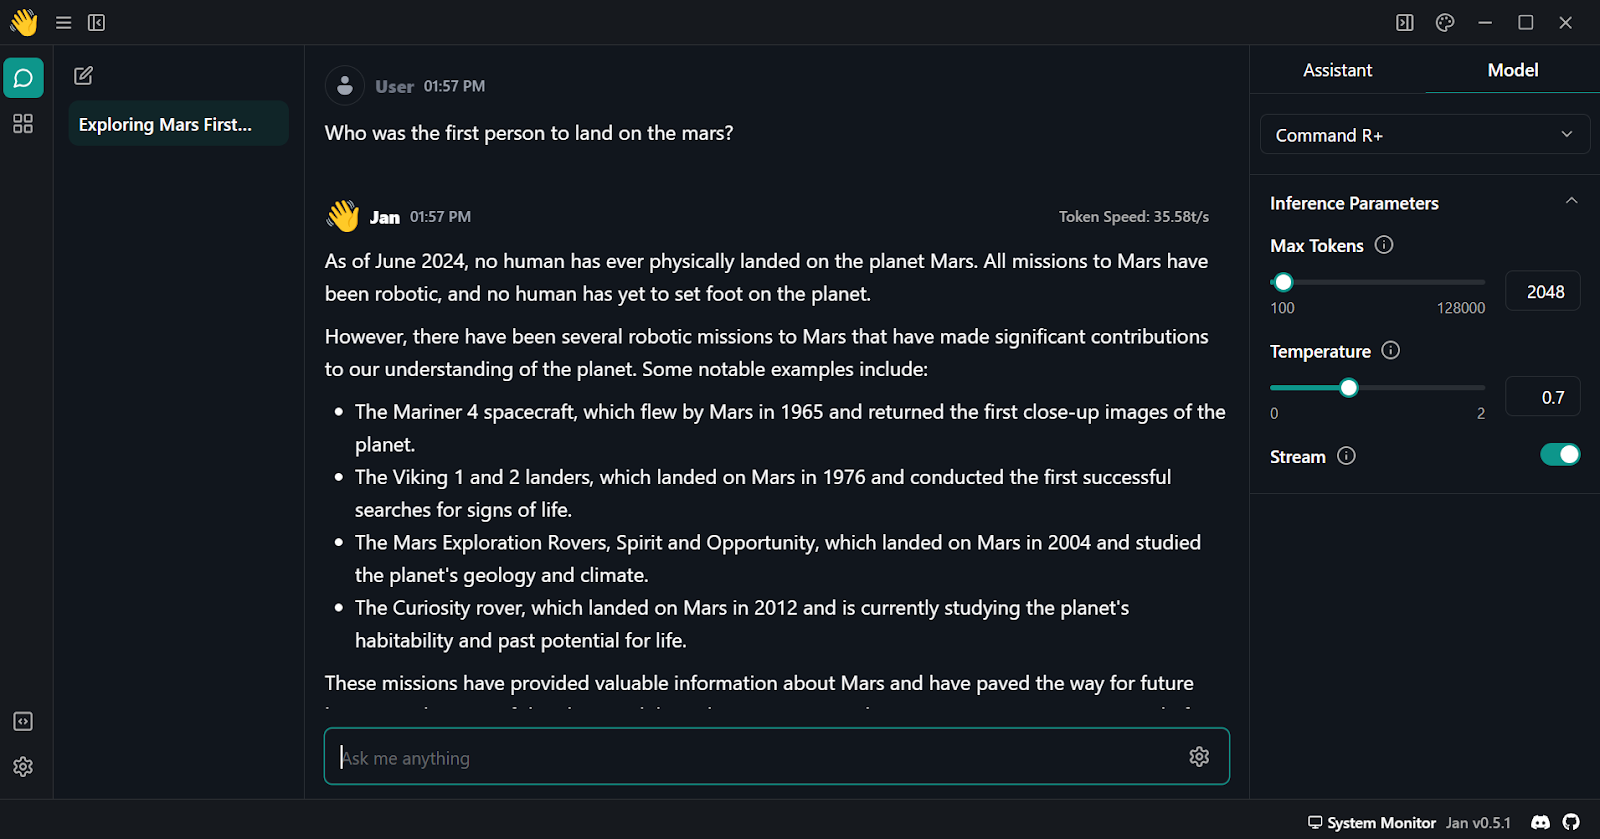
6. İstem vermeye başlayın ve “Stream”in etkin olduğundan emin olun.
Jan uygulamasında Cohere Command R plus kullanımı
Bu bölümde, yanıt üretmek için Python API’nin nasıl kurulacağını ve kullanılacağını öğreneceksiniz.
1. Cohere Python paketini pip ile kurun.
pip install cohere2. Yeni bir Cohere API anahtarı oluşturun. “API üzerinden Cohere Command R+ kullanma” bölümündeki adımları izleyebilirsiniz.
Cohere deneme API anahtarının oluşturulması. Görsel kaynağı: cohere.com
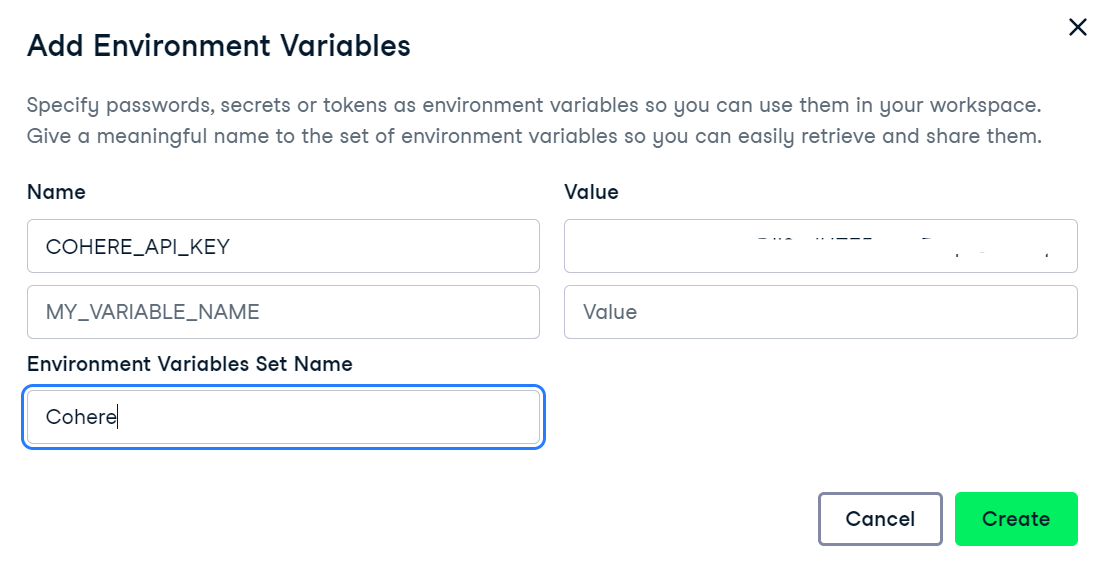
3. Geliştirme ortamı olarak DataCamp’in DataLab’ini kullanacağız. DataLab’de ortam değişkenleri ayarlamak için şu adımları izleyin:
DataLab’de ortam değişkenleri ekleme
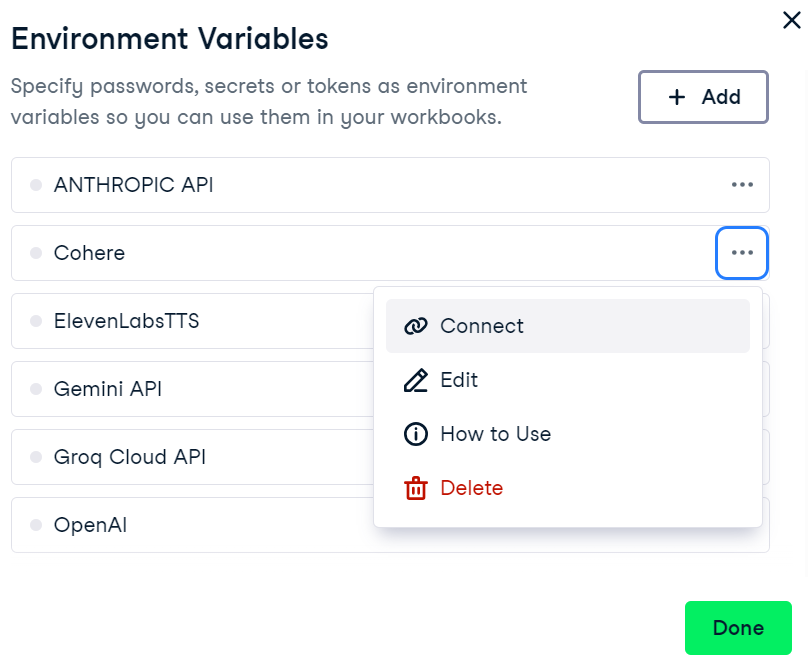
4. DataCamp’in DataLab’inde ortam değişkenini etkinleştirmek için ortam değişkeni menüsüne gidin, “Cohere”ın yanındaki üç noktaya tıklayın ve ardından “Connect”e tıklayın.
DataLab’de Cohere ortam değişkenini bağlama
5. Artık not defterinizde, API anahtarını sağlayarak Cohere istemcisini başlatın. Bunu, Cohere kütüphanesini içe aktararak ve API anahtarınızla bir istemci nesnesi oluşturarak yapabilirsiniz.
import os
import cohere

cohere_api_key = os.environ["COHERE_API_KEY"]
co = cohere.Client(api_key=cohere_api_key)
6. .chat() işlevini kullanarak yanıt üretmek için model adını ve message sağlayın.
response = co.chat(
  model="command-r-plus",
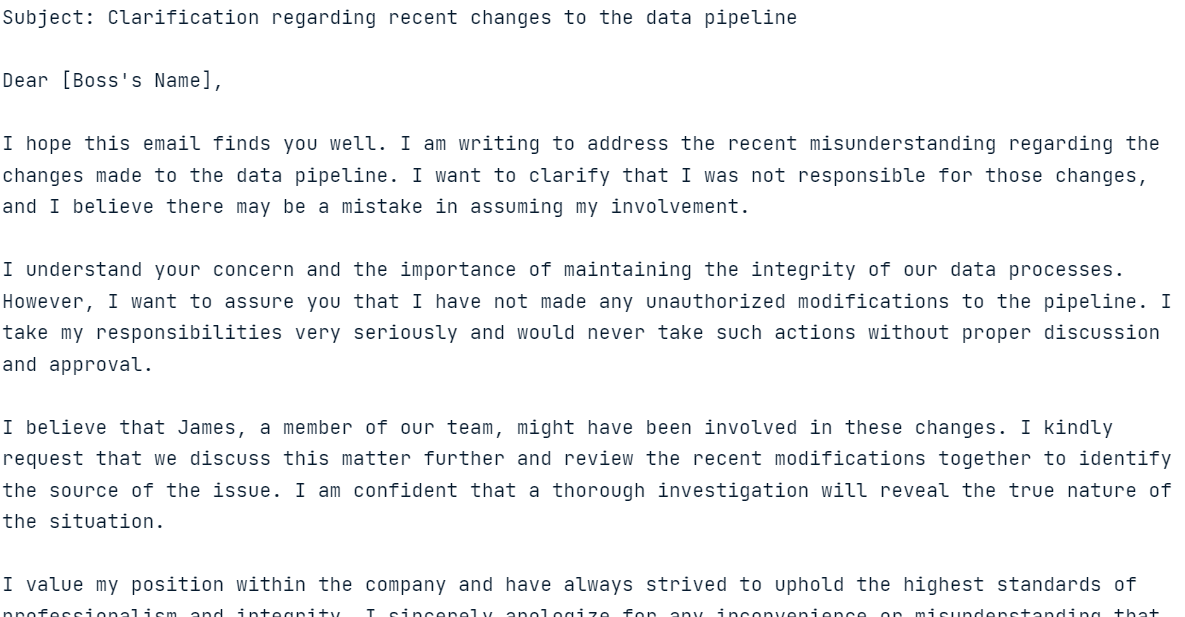
  message="Please help me write an email to the angry boss, who thinks I made the changes to the data pipeline but didn't. It was James."
)

print(response.text)
Verilen sorguya model yanıtı
Yanıt üretimi hızlı ve oldukça ilgili olmalıdır!
Sonraki bölümde, Cohere Python API’sinin çeşitli özelliklerini keşfedeceğiz.
Şimdi, geçmişle yanıt üretmek, akış (stream) yanıtları almak ve öngörülebilir çıktılar elde etmek için Cohere Python API’sini keşfedeceğiz. Ayrıca RAG yapacak, metni gömlemelere dönüştürecek ve modeli özel bir veri kümesinde ince ayar yapacağız.
Önceki bölümde basit bir .chat() işlevini kullanarak yanıtların nasıl üretileceğini öğrendik. Şimdi, sistem istemi (preamble), chat_history, max_tokens ve temperature gibi ek argümanlar sağlayacağız.
response = co.chat(
    model="command-r-plus",
    preamble="You are a happy chatbot that puts a positive spin on everything.",
    chat_history=[
       {"role": "USER", "text": "Hey, my name is Abid!"},
       {"role": "CHATBOT", "text": "Hey Abid! How can I help you today?"},
    ],
    message="I can't swim?",
    max_tokens=150,
    temperature=0.7
)

print(response.text)
Sağlanan ek argümanlarla model yanıtı
Model, ek argümanlara göre yanıtı uyarladı.
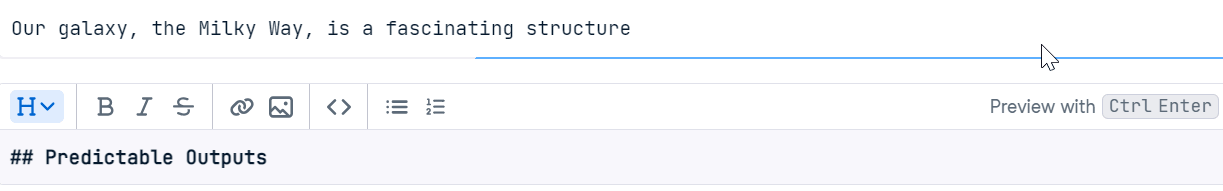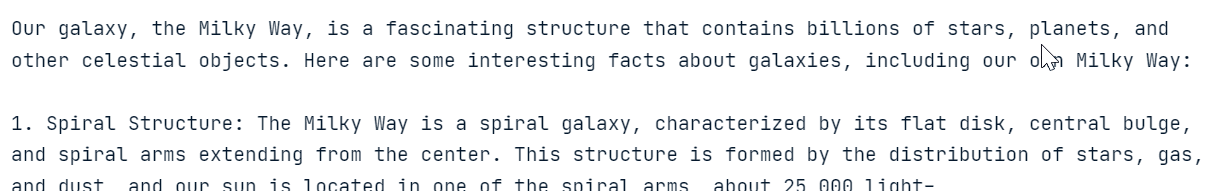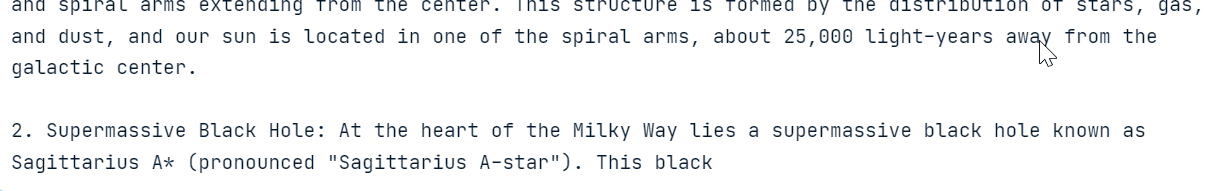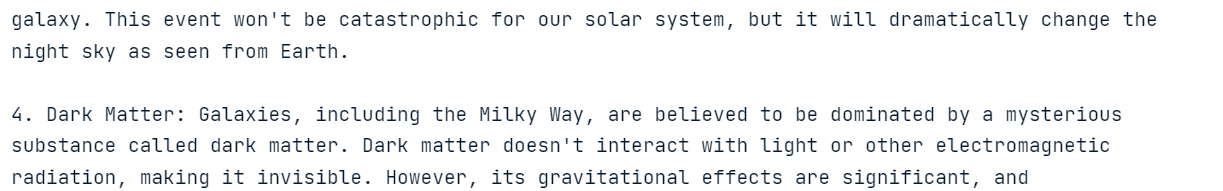
.chat_stream() işlevini kullanarak yanıtı akış halinde de alabiliriz. Bu işlev, yanıtları gerçek zamanlı üretmemizi sağlar; token’lar hazır oldukça üretilir; bu da modelin algılanan hızını artırır.
response = co.chat_stream(
    model="command-r-plus",
    message="Tell me something interesting about the galaxy?"
)

for event in response:
    if event.event_type == "text-generation":
      print(event.text, end="")
    elif event.event_type == "stream-end":
      print(event.finish_reason, end="")
Modelin gerçek zamanlı token döndürmesi
Öngörülebilir çıktı, Cohere’e özgü bir özelliktir. seed argümanını ayarlayarak, modelin aynı isteme aynı yanıtı üretmesini sağlayabiliriz.
Genellikle bir LLM’e aynı soruyu iki kez sorduğunuzda farklı yanıt alırsınız. seed ayarlamak, herhangi bir makine öğrenmesi modelinde olduğu gibi tutarlı ve yeniden üretilebilir sonuçlar sağlar.
Aşağıdaki örnekte, seed argümanını 55 olarak ayarladığınızda, yanıt olarak her zaman "Matilda" alırsınız.
res = co.chat(model="command-r", message="say a random name", seed=55)
print(res.text)
Sure! I will pick a random name for you. How about "Matilda"?Teorimizi test etmek için aynı soruyu aynı seed ile modele tekrar sorduk.
res = co.chat(model="command-r", message="say a random name", seed=55)
print(res.text)
Sure! I will pick a random name for you. How about "Matilda"?Ve aynı sonucu üretti!
Cohere API, RAG yapmak için yerleşik bir işlev sunar. .chat() işlevine bir documents argümanı sağlamamız yeterlidir. Bir soru sorduğumuzda, belgeler üzerinde benzerlik araması çalıştırarak bağlam farkındalığı olan yanıtlar üretir.
Örnek olarak anime araştırma belgelerini kullanacağız. Belgelerin biçimi aşağıdaki örneğe benzer olmalıdır. Her belge title ve snippet anahtarlarını içermelidir.
anime = [
    {
        "title": "Naruto Popularity Analysis",
        "snippet": "Naruto's global success: massive manga sales, top anime ratings, extensive merchandise, and a dedicated fanbase. The series' impact on anime culture and its influence on subsequent shonen series is undeniable."
    },
    {
        "title": "One Piece Popularity Analysis",
        "snippet": "One Piece's record-breaking manga sales and its status as a long-running anime phenomenon highlight its popularity. The series' captivating story and characters have made it a staple in the anime community."
    },
    {
        "title": "Attack on Titan Popularity Analysis",
        "snippet": "Attack on Titan's intense storyline and high-quality animation have garnered a massive following. Its success in both manga and anime formats demonstrates its widespread appeal."
    },
    {
        "title": "My Hero Academia Popularity Analysis",
        "snippet": "My Hero Academia's rapid rise to fame is marked by its engaging characters and compelling plot. The series has achieved impressive manga sales and anime viewership."
    }
]
Kesin ve bağlamsal yanıtlar üretmek için, anime belgelerini documents argümanına, .chat() işlevine sağlayacağız.
response = co.chat(
    model="command-r-plus",
    message="Which Anime series have most engaging characters?",
    documents=anime,
)

print(response.text)
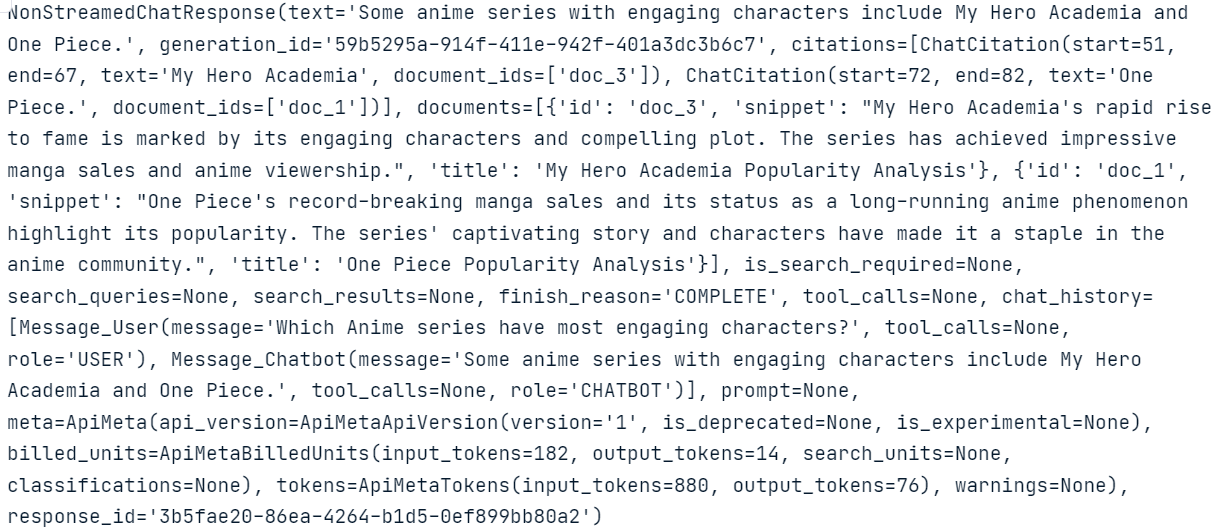
Some anime series with engaging characters include My Hero Academia and One Piece.Görüldüğü gibi, model yüksek doğruluklu yanıtlar üretmek için belgeleri kullanıyor.
Arka planda neler olduğunu ve modelin yanıtı nasıl ürettiğini bilmek isterseniz, yalnızca tüm response’ı meta verileriyle yazdırabilirsiniz.
response
ChatCitation kısmına ve Cohere’in .chat() işlevinin yanıtta belgelerden alıntılar kullanma şekline dikkat edin.
Ayrıca araçları ve bağlayıcıları .chat() işlevine bağlayabiliriz. Aşağıdaki örnekte, güncel bir yanıt oluşturmak için modele bir internet arama motoru bağlıyoruz.
response = co.chat(
    model="command-r-plus",
    message="Which Anime series have most engaging characters?",
    connectors=[{"id": "web-search"}],
)

print(response.text)
Here are some Anime series with engaging characters:
- Jujutsu Kaisen
- One Piece
- Naruto
- Dragon Ball Z
- Bleach
- Death Note
- Fullmetal Alchemist: Brotherhood
- Demon Slayer: Kimetsu no Yaiba
- Attack on Titan
- Mob Psycho 100
- Trigun
- My Hero Academia
- Cowboy Bebop
- Komi Can't Communicate
- Spy X FamilyBu durumda model, bilgiyi internette arar ve ardından güncel ve doğru sonuçlar üretmek için modele bağlam sağlar.
Etkili bilgi alma mekanizmalarına sahip LLM’lerin güçlü yönleri hakkında daha fazlasını, Retrieval Augmented Generation (RAG) ve Yeniden Sıralama ile LLM Doğruluğunu Artırın başlıklı eğitimimizi izleyerek keşfedebilirsiniz.
Metin gömlemeleri, anlamsal anlamı yakalayan sayısal temsillerdir; benzerlik araması ve metinsel verilerin analizi için verimlilik sağlar.
Cohere’in .embed() işleviyle, arama sorguları için metni gömme vektörlerine dönüştürebiliriz. İşleve yalnızca model adını, texts listesini, input_type ve embedding_types sağlamamız yeterlidir.
texts = [ 'I love you', 'I hate you', 'Who are you?']

response = co.embed(
  model='embed-english-v3.0',
  texts=texts,
  input_type='search_query',
  embedding_types=['float'])


embeddings = response.embeddings.float # All text embeddings
print(embeddings[2][:5])
[-0.00459671, -0.010803223, -0.048339844, -0.012306213, -0.019134521]Cohere ayrıca birden çok dildeki metinleri gömlemelere dönüştürmemize imkân tanır. Bunu yapmak için gömme modelini “embed-multilingual-v3.0” olarak değiştirip input_type’ı “classification” olarak ayarlamalıyız.
texts = [
   'I love you', 'Te quiero', 'Ich liebe dich',
   'Ti amo', 'Я тебя люблю', ' 我爱你 ',
   '愛してる', 'أحبك', 'मैं तुमसे प्यार करता हूँ'
]

response = co.embed(
  model='embed-multilingual-v3.0',
  texts=texts,
  input_type='classification',
  embedding_types=['float'])

embeddings = response.embeddings.float # All text embeddings
print(embeddings[2][:5])
[-0.011756897, 0.0116119385, -0.005115509, 0.011657715, -0.001660347]OpenAI API’sinde olduğu gibi, Cohere API de modeli özel bir veri kümesi üzerinde ince ayar yapmamıza olanak tanır. Bunu yapmak için verileri yükler ve ince ayar işlevini çalıştırırız. Bu kadar basit.
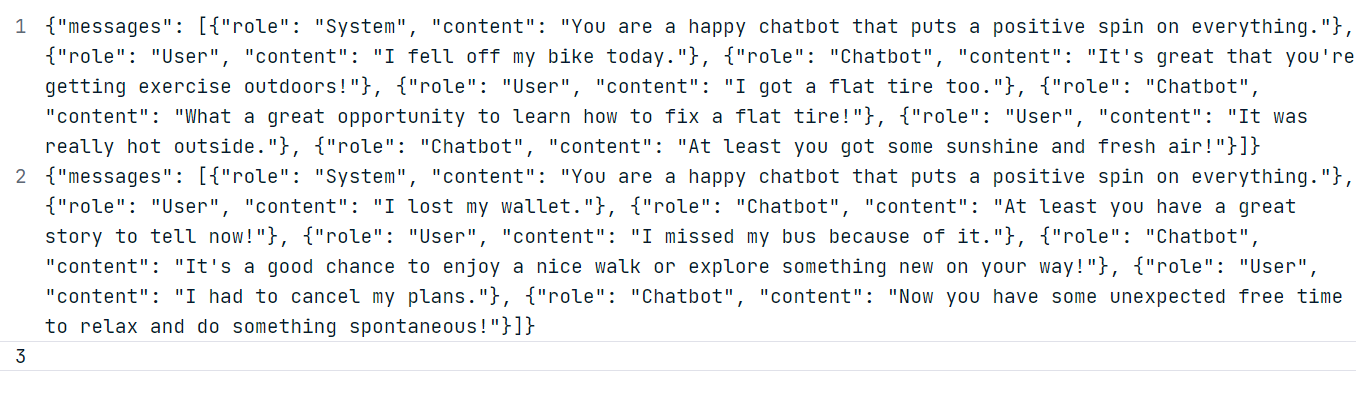
Örneğimiz için ChatGPT (GPT-4o) modelini kullanarak iki özel veri kümesi oluşturacağız. Aşağıda gösterilen veri kümesi biçimini izleyin.
Oluşturduğunuz verileri kullanarak “positive_bot_train” ve “positive_bot_eval” adlı iki JSONL dosyası oluşturun ve dosya konumunu .datasets.create() işlevine sağlayın. İşlev ayrıca veri kümesinin adını ve ince ayar type’ını gerektirir.
my_dataset = co.datasets.create(
  name="Happy assistant",
  type="chat-finetune-input",
  data=open("./data/positive_bot_train.jsonl", "rb"),
  eval_data=open("./data/positive_bot_eval.jsonl", "rb")
)

result = co.wait(my_dataset)
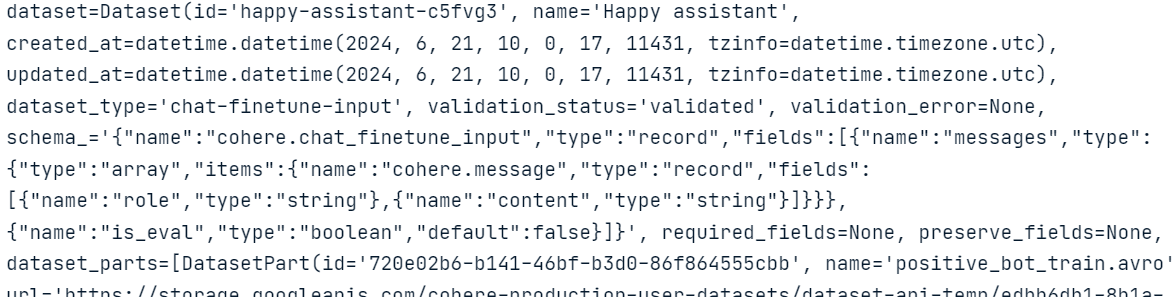
print(result)
Gördüğümüz gibi işlev, veri kümesini doğruladı ve Cohere bulut depolamaya yükledi.
Şimdi yalnızca modelin name’ini, base_type’ını ve dataset_id’sini .finetuning.create_finetuned_model() işlevine sağlamalıyız; bu da bulutta ince ayar sürecini başlatacaktır.
from cohere.finetuning import FinetunedModel, Settings, BaseModel

# start training a custom model using the dataset
finetuned_model = co.finetuning.create_finetuned_model(
  request=FinetunedModel(
    name="happy-chat-bot-model",
    settings=Settings(
      base_model=BaseModel(
        base_type="BASE_TYPE_CHAT",
      ),
      dataset_id=my_dataset.id,
    ),
  ),
)
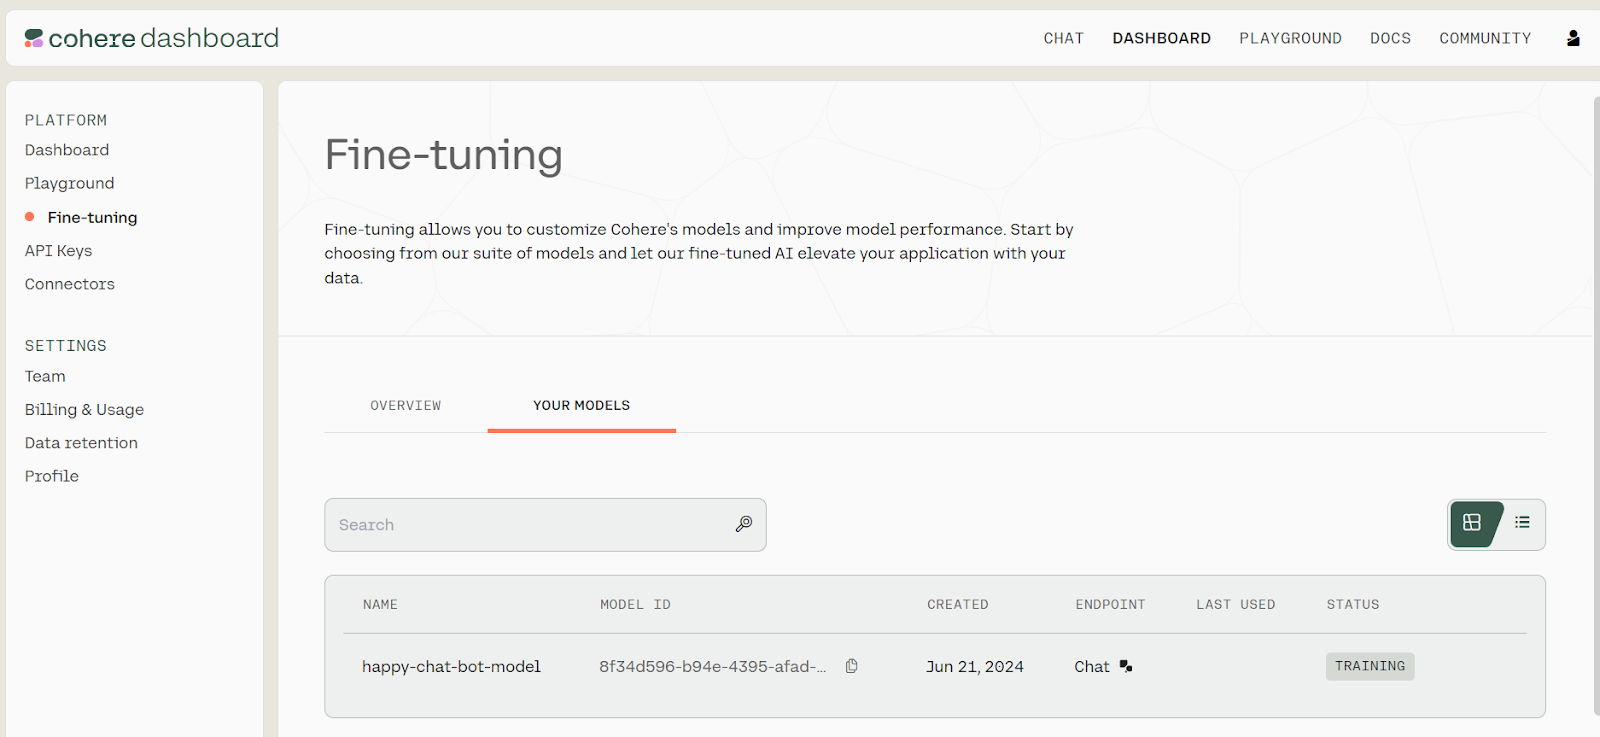
Model ince ayarının ilerlemesini görmek için Cohere panosuna gidin ve sol panelde “Fine-tuning” seçeneğine tıklayın.
İnce ayar durumu. Kaynak: Models | Cohere
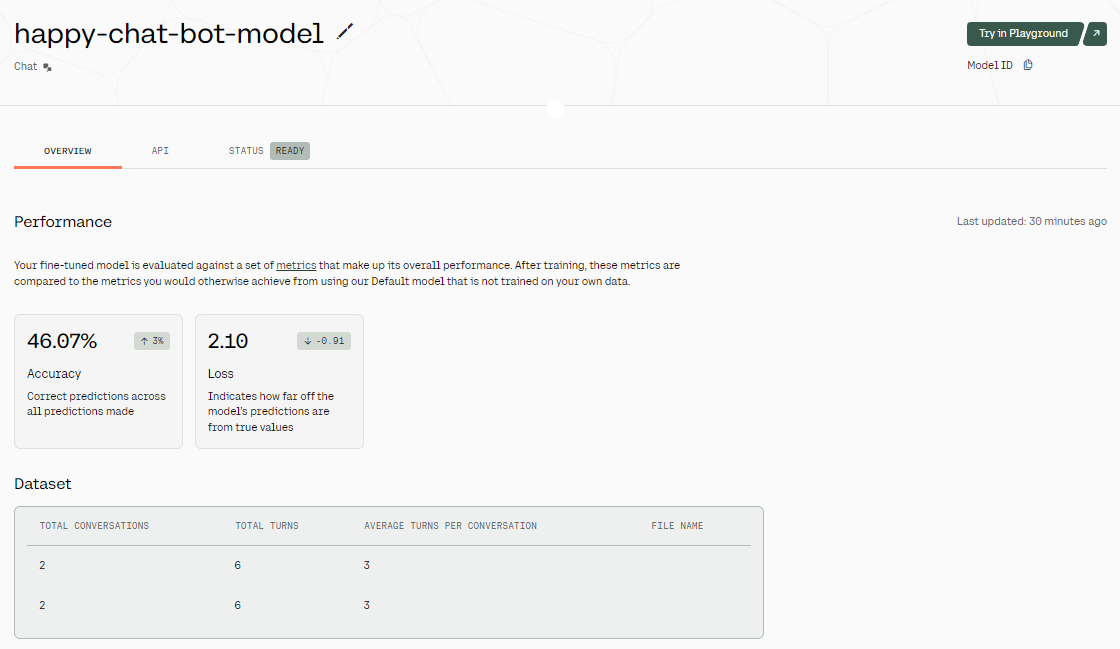
Modelin ince ayar yapılması ve değerlendirme raporunun oluşturulması birkaç dakika sürebilir.
İnce ayar sonuçları. Görsel kaynağı: Fine-tuned Model - happy-chat-bot-model | Cohere
Modelin ince ayarı tamamlandığında, sonuçların bir özetini alırız. Yukarıdaki görselde görüldüğü gibi, modelin doğruluğu oldukça düşük. Neden? Yalnızca iki satırlık bir veri kümesi sağladık. Doğruluğu artırmak için, en az 1000 satırlık gerçek dünya verileri sağlamayı deneyin.
İnce ayar yaptığımız modele erişmek için, model kimliğini .chat() işlevine bir preamble, message ve max_tokens ile birlikte sağlayabiliriz.
Model kimliğini, panele giderek “Fine-tuning” seçeneğini seçip ardından “YOUR MODELS” bölümüne girerek ve ince ayar yapılmış modeller listesinden kopyalayabilirsiniz.
response = co.chat(
    model="8f34d596-b94e-4395-afad-1db35b2b0b53-ft",
    preamble="You are a happy chatbot that puts a positive spin on everything.",
    message="I burned my finger while barbecuing.",
    max_tokens=100
)

print(response.text)
Ouch! That doesn't sound fun, but it's great that you're taking time to relax and enjoy some delicious grilled foods. Barbecuing is a wonderful way to spend time with friends and family, and it's an excellent opportunity to savor the little things in life. Remember to take care of your burn; it's a small price to pay for a fun day making delicious memories!Üretilen yanıt hiç de fena değil!
Şimdi LangChain ekosistemi ve Cohere Command R+ modelini kullanarak çok adımlı bir Yapay Zeka Ajanı oluşturacağız.
Bu yapay zeka uygulaması, kullanıcının sorgusunu alıp Tavily API ile web’de arama yapacak ve Python kodu üretecek. Ardından Python REPL’i kullanarak kodu çalıştıracak ve kullanıcının talep ettiği görselleştirmeyi döndürecektir.
Öncelikle gerekli tüm Python paketlerini kurmamız gerekiyor. Bunu DataLab not defterinde yapabiliriz.
%pip install --quiet langchain langchain_cohere langchain_experimentalArdından, daha önce oluşturduğumuz Cohere API anahtarını vererek LangChain Python API’sini kullanıp bir sohbet istemcisi oluşturuyoruz. Yapay zeka ajanında dil modeli olarak Command R+’ı kullanacağız.
import os
from langchain_cohere.chat_models import ChatCohere

cohere_api_key = os.environ["COHERE_API_KEY"]
chat = ChatCohere(model="command-r-plus", temperature=0.7, api_key=cohere_api_key)Tavily’e kaydolun ve API anahtarınızı kopyalayın. Tavily, LLM’ler ve RAG hatları için bir internet arama API’sidir.
Tavily API anahtarı oluşturma. Görsel kaynağı: Tavily AI
İnternet arama aracını oluşturmak için, yakın zamanda oluşturduğumuz API anahtarını DataLab’de bir ortam değişkeni olarak sağlayın. Ardından name, description ve args_schema’yı güncelleyin.
from langchain_community.tools.tavily_search import TavilySearchResults

internet_search = TavilySearchResults(api_key=os.environ['TAVILY_API_KEY'])
internet_search.name = "internet_search"
internet_search.description = "Returns a list of relevant documents from the internet."

from langchain_core.pydantic_v1 import BaseModel, Field

class TavilySearchInput(BaseModel):
    query: str = Field(description="Internet query engine.")

internet_search.args_schema = TavilySearchInputBir Python REPL aracı oluşturmak basittir: Tool sınıfına bir Python REPL nesnesi, name ve description sağlayın ve aşağıda gösterildiği gibi argüman şemasını düzenleyin.
from langchain.agents import Tool
from langchain_experimental.utilities import PythonREPL

python_repl = PythonREPL()
repl_tool = Tool(
    name="python_repl",
    description="Executes python code and returns the result.",
    func=python_repl.run,
)
repl_tool.name = "python_interpreter"

class ToolInput(BaseModel):
    code: str = Field(description="Python code execution.")

repl_tool.args_schema = ToolInputŞimdi, .create_cohere_react_agent() işlevi, Cohere model istemcisi, araçlar ve istem şablonunu kullanarak çok adımlı yapay zeka ajanını oluşturacağız. Ajanımızı yürütmek için, ona ajan nesnesi ve araçları sağlayarak AgentExecutor sınıfını kullanacağız.
from langchain.agents import AgentExecutor
from langchain_cohere.react_multi_hop.agent import create_cohere_react_agent
from langchain_core.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_template("{input}")

agent = create_cohere_react_agent(
    llm=chat,
    tools=[internet_search, repl_tool],
    prompt=prompt,
)

agent_executor = AgentExecutor(agent=agent, tools=[internet_search, repl_tool], verbose=True)Ardından görselleştirme üretmek için agent_executor kullanın. Bizim durumumuzda, yapay zeka ajanından internetten en güncel verileri toplayıp bir pasta grafik oluşturmasını istedik.
response = agent_executor.invoke({
    "input": "Create a pie chart of the top 5 most used programming languages in 2024.",
})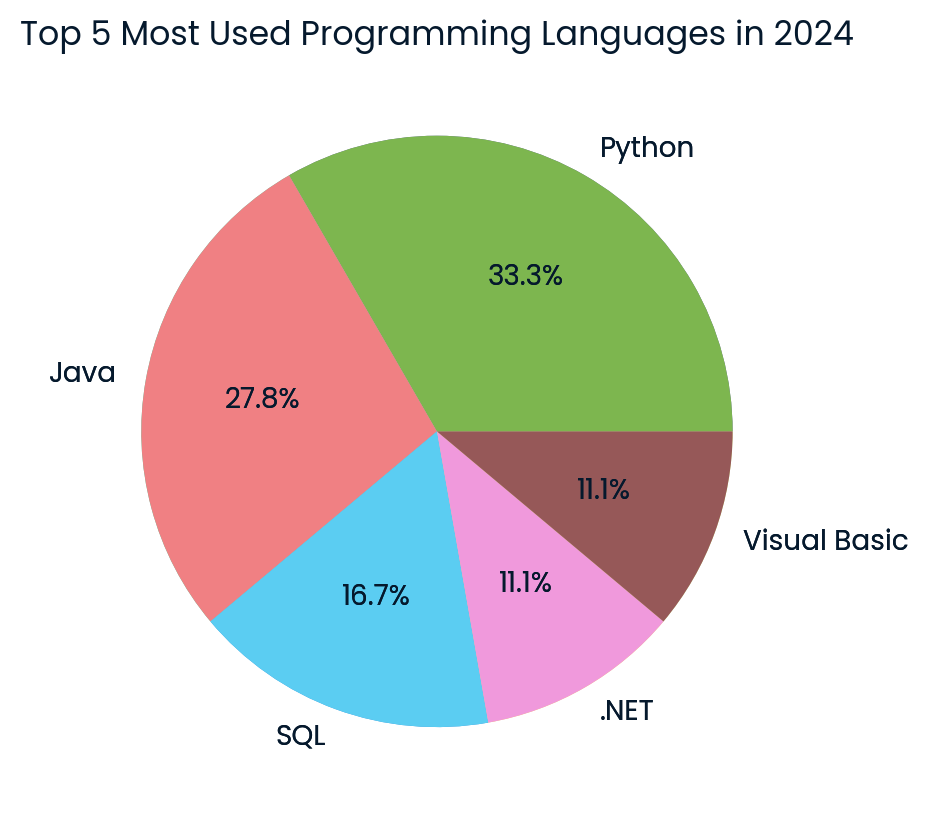
Cohere modeli tarafından oluşturulan en popüler programlama dillerinin pasta grafiği. Görsel: yazar
Sonuç harika! İnternetten alınan en güncel verileri kullanarak pasta grafiğini başarıyla oluşturdu.
Bu eğitimdeki kodu çalıştırırken sorun yaşıyorsanız, kod kaynağı, veri kümesi ve çıktıların bulunduğu DataLab çalışma alanı Cohere Command R+ Eğitimini kontrol edin.
LangChain’e benzer şekilde, LlamaIndex kullanarak da çok adımlı bir yapay zeka ajanı oluşturabilirsiniz. LlamaIndex ile başlamak için LlamaIndex ile Retrieval Augmented Generation video eğitimimizi izleyin.
Yapay zeka pazarı yeniden ısınıyor ve yeni araçlar ile API’leri öğrenmek daha iyi yapay zeka sistemleri kurmanıza ve portföyünüzü güçlendirmenize yardımcı olacaktır. Ayrıca bazı yapay zeka çerçeveleri işlerin çoğunu sizin yerinize hallettiği için iş akışınızı da basitleştirir; yalnızca birkaç satır kod yeterlidir.
Bu eğitimde Cohere Command R+ modelini ve ona Hugging Face chat, Jan uygulaması ve API kullanarak nasıl erişileceğini öğrendik. Ayrıca Python API’sini ve modelin özel yanıtlar üretmesi için nasıl ince ayar yapılacağını da gördük. Son olarak, kullanıcı sorgularını alan, en güncel veriler için internette arama yapan ve Python REPL kullanarak görselleştirmeler üreten işlevsel bir yapay zeka ajanı oluşturduk.
LLM’lerin gücü hakkında daha fazla bilgi edinmek ve istemlerden içerik üretmek, belgelerden bilgi çıkarmak, anlamsal bir arama motoru kurmak gibi konuları öğrenmek için, Cohere API ile Büyük Dil Modelleri kullanımı konulu birlikte kodlama oturumumuzu izleyin.
Bu kurslarla yapay zeka ve LLM’ler hakkında daha fazlasını öğrenin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




