
Kursus
Konsep Large Language Models (LLM)
2 jam
113.6K
Artikel ini adalah tutorial komprehensif tentang fine-tuning model bahasa berukuran besar menggunakan teknik lanjutan. Kita akan membahas contoh dengan memanfaatkan Tensor Processing Units, teknik bernama LoRA, dan komputasi terdistribusi—semuanya untuk mempercepat kinerja dan efisiensi. Untuk mengilustrasikan teknik-teknik ini, kita akan mengakses dan melakukan fine-tuning model Gemma, keluarga baru LLM ringan mutakhir yang dibuat oleh Google.
Di akhir tutorial, Anda akan memiliki keterampilan untuk melakukan fine-tune dan menjalankan inference pada model bahasa berukuran besar mana pun menggunakan TPU yang tersedia di Google Cloud. Untuk mencapainya, kita akan membahas topik-topik berikut secara berurutan:
Menggunakan Gemma dengan TPU: Kita akan mempelajari cara menyiapkan lingkungan Kaggle untuk menggunakan TPU.
Penyiapan Model dan Inference: Kita akan menjalankan Gemma menggunakan pustaka Keras di Python.
Fine-Tuning: Kita akan melakukan fine-tune model Gemma dengan teknik bernama LoRA.
Pelatihan Terdistribusi: Kita akan melakukan fine-tuning terdistribusi untuk efisiensi pelatihan.
Jika Anda baru dalam AI dan LLM, pertimbangkan untuk mengikuti jalur keterampilan AI Fundamentals untuk membiasakan diri dengan istilah yang digunakan dalam tutorial ini.
Mari mulai!
 Logo Google Gemma
Model Gemma milik Google merupakan bagian dari keluarga model bahasa besar sumber terbuka dan ringan yang dikembangkan Google dan diperkenalkan pada 2024. Gemma dibuat menggunakan riset dan teknologi yang sama seperti model Google Gemini, dan—mirip dengan Gemini—Gemma kompatibel dengan kerangka kerja machine learning utama seperti Keras dan Pytorch. Model ini tersedia dalam dua ukuran, dengan 2B atau 7B parameter.
Sementara Gemini terutama ditujukan untuk pengguna akhir melalui aplikasi dan API langsung, Gemma bersifat open source untuk memungkinkan modifikasi luas dan integrasi oleh pengembang. Model Gemma juga lebih kecil, sehingga lebih portabel dan hemat biaya.
 Gambar CPU, GPU, TPU oleh Freepik dan Flaticon
Mari bandingkan berbagai opsi perangkat keras untuk machine learning sebagai konteks. Perangkat keras dikategorikan ke dalam tipe yang berbeda, masing-masing dirancang untuk peran khusus dalam pemrosesan dan komputasi.
Central Processing Units: CPU menjalankan sistem operasi di hampir semua perangkat komputasi. CPU dikenal memproses tugas secara berurutan.
Graphics Processing Units: GPU memproses banyak tugas secara bersamaan, sehingga ideal untuk rendering grafis.
Tensor Processing Units: TPU adalah prosesor khusus yang dikembangkan oleh Google untuk digunakan dalam machine learning. TPU dirancang untuk melakukan perhitungan matriks secara cepat—kritis dalam pelatihan dan menjalankan neural network.
Kategori terakhir, TPU, penting untuk tutorial ini. TPU lebih cepat daripada GPU dalam pelatihan dan inference deep neural network; TPU juga mengonsumsi daya lebih sedikit. Kekurangannya, ekosistem TPU masih kurang matang, dengan lebih sedikit alat dan kerangka kerja yang tersedia. Kerangka kerja yang tersedia mencakup Google Cloud Platform, Colab, dan Kaggle.
Komponen | Kegunaan Utama | Aplikasi ML | Keunggulan | Ketersediaan |
CPU | Tugas umum | Model sederhana | Lebih murah, konsumsi daya rendah | Tersedia luas |
GPU | Rendering grafis | Deep learning, pemrosesan data besar | Cepat untuk perhitungan kompleks | Tersedia secara komersial |
TPU | Machine learning | Deep neural network, operasi matriks kecepatan tinggi | Paling cepat untuk ML, hemat daya | Tidak tersedia kecuali di Google Cloud, Colab, dan Kaggle |
Tabel perbandingan perangkat keras machine learning
Model Gemma dirancang sangat skalabel dan efisien saat digunakan dengan pengaturan komputasi terdistribusi, yang dapat secara signifikan meningkatkan kinerja dan kecepatan, terutama saat menangani volume data besar dan arsitektur model yang kompleks.
Pustaka Keras cocok digunakan di sini karena mendukung pelatihan terdistribusi untuk model Gemma, memanfaatkan implementasi multi-backend yang mencakup TensorFlow dan PyTorch.
Pada bagian ini, kita akan mengonfigurasi notebook Kaggle agar mendukung TPU, memastikan semua pustaka dan dependensi yang diperlukan terpasang untuk operasi yang mulus. Kita kemudian akan memuat model Gemma 2B atau 7B menggunakan paket keras-nlp. Terakhir, kita akan menerapkan model untuk menjalankan tugas, memanfaatkan kemampuan komputasi kuat TPU untuk memproses dan menghasilkan respons secara efisien.
Untuk menyiapkan lingkungan, kita perlu mengintegrasikan versi Keras dari model Gemma dan mengganti akselerator komputasi ke TPU untuk kinerja yang lebih baik. Kita akan memasang paket-paket esensial seperti keras-nlp, mengonfigurasi Keras agar menggunakan TensorFlow sebagai backend, dan mengoptimalkan alokasi memori TPU untuk memastikan pelatihan dan eksekusi model berjalan lancar.
Untuk menyiapkan lingkungan, kita perlu menambahkan implementasi Keras ke model Gemma. Secara khusus, ini berarti kita perlu memasukkan versi Gemma yang kompatibel dengan Keras agar terintegrasi mulus dengan API TensorFlow.
Untuk menambahkan implementasi Keras, ikuti langkah-langkah berikut:
Buat notebook baru di Kaggle.
Buka bagian "Input" di panel kanan.
Klik “+ Add Input” untuk menambahkan implementasi Keras dari model Gemma.
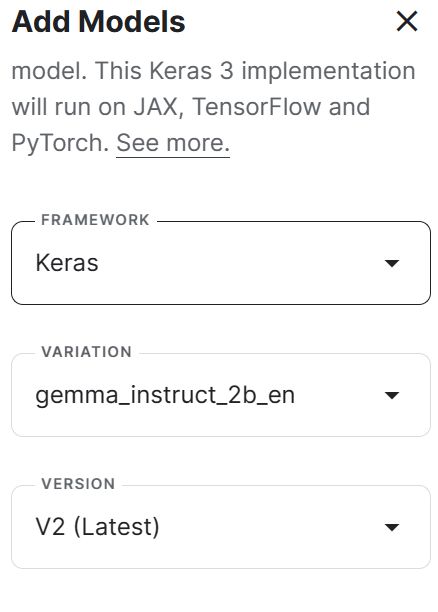 Menambahkan implementasi Keras ke model Gemma
Selanjutnya, kita perlu mengubah akselerator ke TPU, yang berarti kita akan mengganti akselerator komputasi di pengaturan notebook menjadi TPU untuk memanfaatkan daya pemrosesannya saat pelatihan dan inference.
Untuk mengubah akselerator, ikuti langkah-langkah berikut. Wajar jika lingkungan memerlukan beberapa menit untuk memuat ulang.
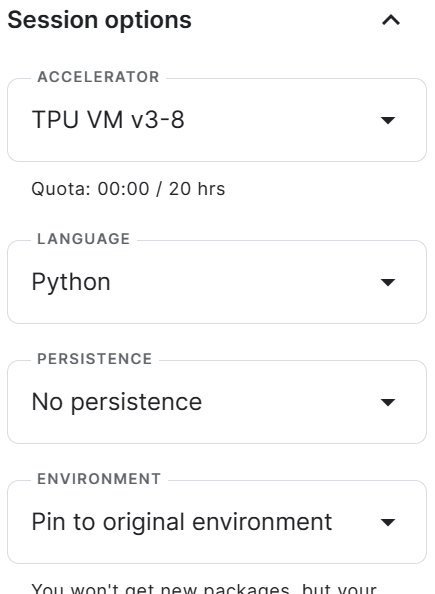 Menyiapkan TPU sebagai akselerator
Sekarang kita memasang paket Python terbaru yang akan digunakan untuk fine-tuning dan inference, termasuk TensorFlow dan keras-nlp.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1Kita mengatur backend Keras dengan JAX untuk akses mulus ke TPU. Anda juga bisa mencoba TensorFlow atau PyTorch.
Terakhir, kita melakukan pra-alokasi memori TPU untuk mengoptimalkan kinerja dan mencegah masalah runtime selama eksekusi model. Di sini kita mengalokasikan 100% dari total memori TPU untuk menghindari fragmentasi memori pada backend JAX.
import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"]="1.00"Kita memuat paket Python yang diperlukan untuk inference model.
import kerasimport keras_nlpLalu kita memuat model dan menampilkan ringkasan model.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_instruct_2b_en")gemma_lm.summary()Kita berhasil memuat tokenizer dan model hanya dengan satu perintah. Ini luar biasa karena bahkan model Gemma terkecil memiliki 2,5 miliar parameter dan ukuran 9,34 GB.
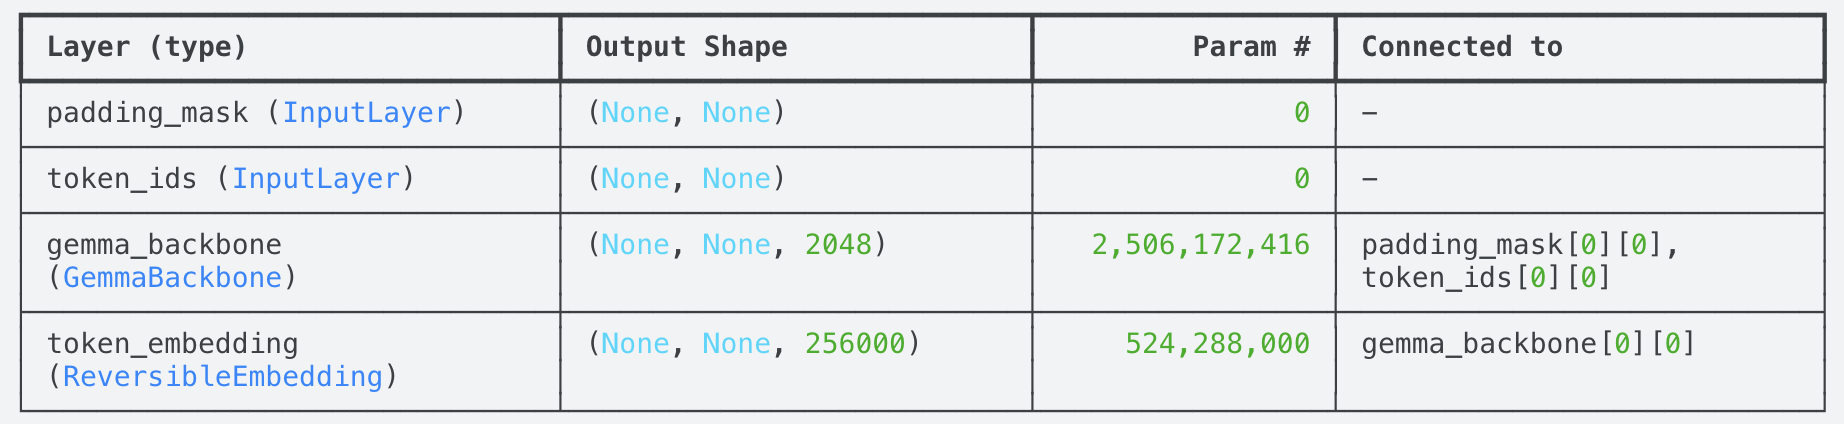 Ringkasan model Gemma
Anda mungkin harus menunggu beberapa menit untuk menjalankan notebook dan merasakan kinerja super cepat. Ini karena permintaan terhadap TPU sangat tinggi. Jika Anda menjalankan notebook pada malam hari, Anda mungkin tidak perlu menunggu.
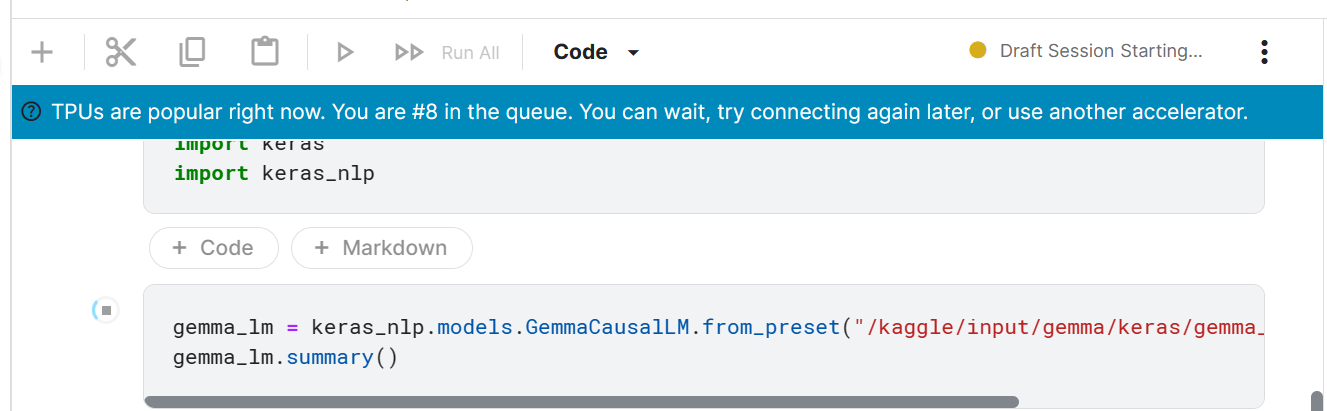 Mengantre untuk akses TPU
Menjalankan inference mengacu pada proses menggunakan model untuk menghasilkan keluaran berdasarkan masukan baru yang belum pernah dilihat. Dalam konteks kita, masukan diberikan sebagai teks menggunakan fungsi .generate(). Respons akan langsung diterima.
print(gemma_lm.generate("What is DataCamp?", max_length=30))What is DataCamp?DataCamp is a leading online data science education platform that empowers individuals and organizations to build data-driven careers. TheyKita juga dapat mencoba batch inference, artinya kita memberikan beberapa prompt untuk menghasilkan beberapa respons. Keluaran berupa sebuah daftar.
print(gemma_lm.generate(["How far is the Sun from earth", "What is the Sun made of?"], max_length=30))['How far is the Sun from earth?\n\nThe Sun is about 149.6 million kilometers (93 million miles) away from', 'What is the Sun made of?\n\nThe Sun is primarily composed of hydrogen and helium. Hydrogen makes up about 73.4% of']Selanjutnya, kita akan mencoba membuat templat dengan instruksi dan respons untuk memandu model. Anda dapat menambahkan system prompt atau perintah awal tambahan apa pun untuk memodifikasi respons yang dihasilkan.
Kita akan menggunakan fungsi .format() untuk mengisi teks templat dengan argumen pengguna. Hasilnya, kita memperoleh daftar langkah yang dapat diambil untuk belajar Python.
template = "Instruction:\n{instruction}\n\nResponse:\n{response}"prompt = template.format( instruction="How do I start learning Python?", response="",)print(gemma_lm.generate(prompt, max_length=250))Instruction:How do I start learning Python?Response:**Step 1: Choose a learning path*** **Online Courses:** * DataCamp * Codecademy * Coursera * edX * Udemy* **Books:** * "Automate the Boring Stuff with Python" by Al Sweigart * "Python Crash Course" by Eric Matthes * "Head First Python" by Kathy Sierra and Bert Bates* **Video Tutorials.........Jika Anda mengalami kesulitan memuat model dan menghasilkan respons menggunakan TPU, Anda dapat merujuk notebook Kaggle ini: Accessing Gemma-instruct-2b-en using TPUs.
Jika Anda mulai nyaman menggunakan Gemma, pelajari lebih lanjut cara meningkatkan Gemma dengan instruksi yang disesuaikan melalui tutorial kami Fine Tuning Google Gemma: Enhancing LLMs with Customized Instructions.
Sekarang mari pelajari cara melakukan fine-tune model Gemma menggunakan dataset publik bernama OpenHermes. Dataset OpenHermes memiliki 242.000 baris dengan dua kolom, satu untuk instruksi dan satu untuk respons, semuanya dihasilkan menggunakan model GPT-4.
Seperti yang akan kita lihat, melakukan fine-tune dataset ini akan memakan waktu lama, bahkan dengan TPU. Untuk membantu proses, kita akan menggunakan teknik bernama LoRA.
LoRA, atau Low-Rank Adaptation, dirancang untuk meningkatkan fine-tuning model bahasa besar dengan membuat prosesnya lebih efisien dan mudah diakses. Teknik ini mengatasi tantangan yang terkait dengan metode fine-tuning tradisional yang sering kali mahal secara komputasi dan intensif sumber daya.
Secara teknis, LoRA bekerja dengan membekukan bobot pralatih model dan memperkenalkan matriks berpangkat rendah yang memodifikasi bagian tertentu dari arsitektur model. Dengan memusatkan perhatian pada matriks berpangkat rendah ini, LoRA meminimalkan sumber daya komputasi yang dibutuhkan, sehingga memungkinkan fine-tuning model besar pada perangkat keras yang kurang bertenaga.
Serupa dengan penyiapan lingkungan model sebelumnya, kita akan mengatur backend Keras dan pra-alokasi memori. Kita juga dapat menggunakan fungsi jax. devices() untuk memeriksa ketersediaan perangkat TPU.
import osimport jaxos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"jax.devices()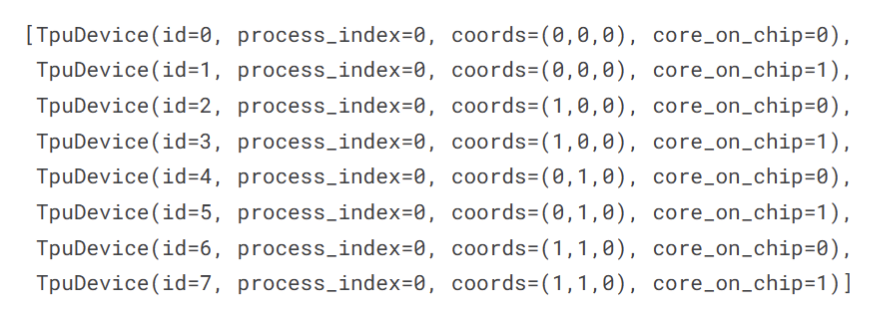
Jumlah perangkat komputasi
Kita memuat model dan menampilkan ringkasan model. Kita memiliki 2,5B parameter yang dapat dilatih.
import kerasimport keras_nlpgemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_2b_en")gemma_lm.summary()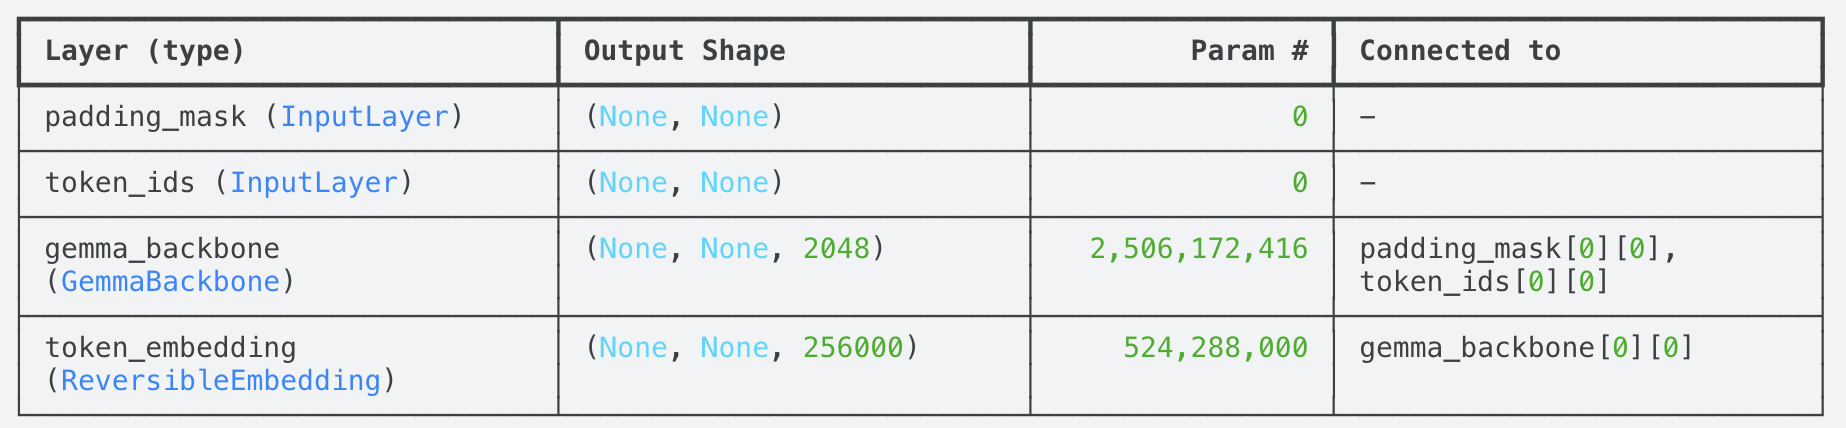 Ringkasan model Gemma
Selanjutnya, kita memuat dataset ke dalam notebook. Prosesnya mirip dengan menambahkan model. Ikuti langkah-langkah berikut:
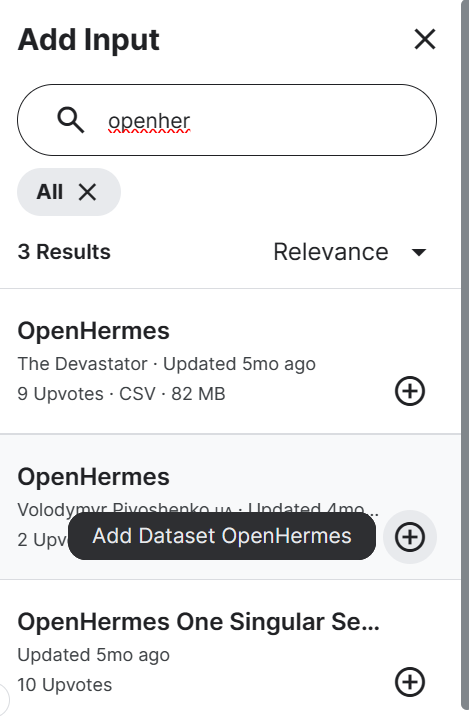
Menambahkan dataset OpenHermes
Sekarang kita menggunakan pustaka pandas untuk membaca dataset dan menampilkan 5 baris teratas. Terlihat ada 2 kolom, satu untuk instruction dan satu untuk output.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')df.head()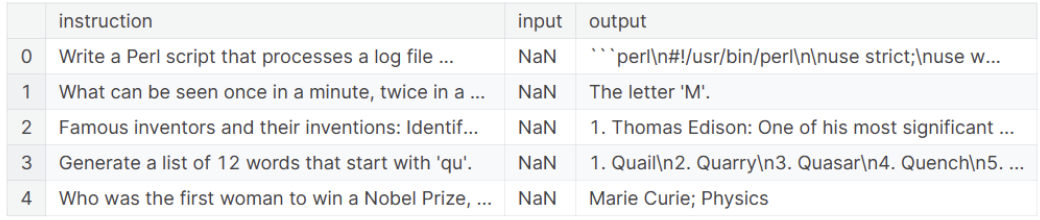
Dataset OpenHermes
Sekarang setelah kita memuat model dan dataset, kita perlu meneruskan dataset ke model. Untuk itu, kita harus mengonversi dataset menjadi daftar string dengan format instruction dan response.
Ternyata, melatih seluruh dataset akan memakan waktu hampir 23 jam, bahkan dengan TPU. Karena itu, kita hanya akan memilih 1.000 sampel teratas dari daftar untuk mengurangi waktu pelatihan.
template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]data = data[:1000]print(data[0])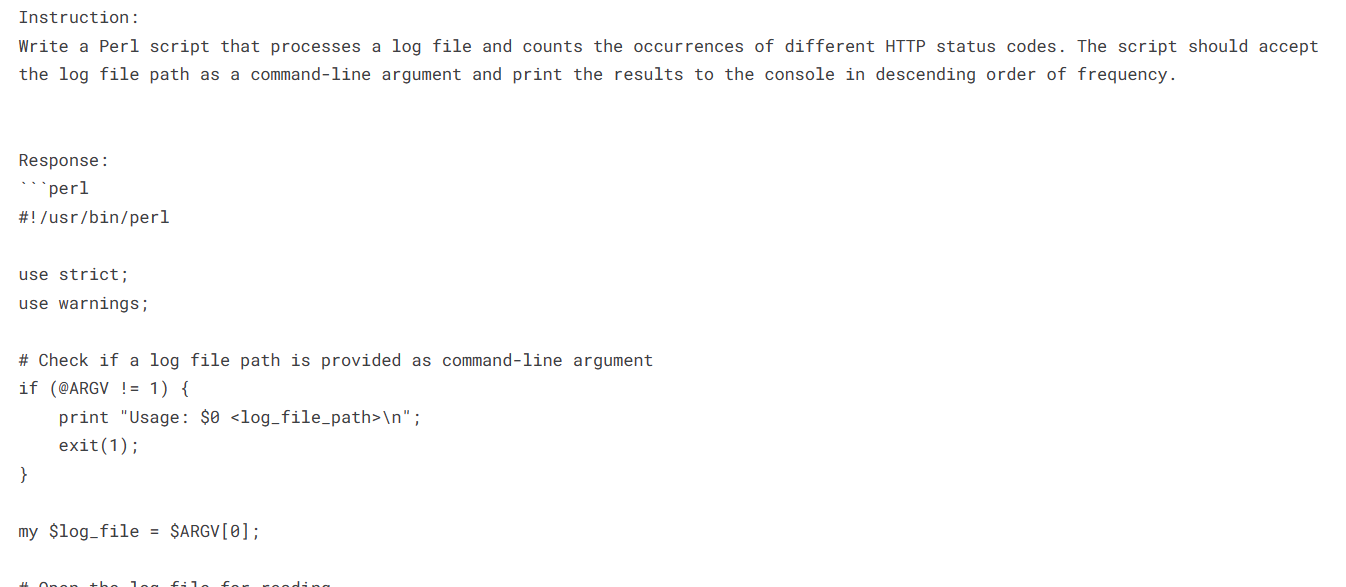
Sampel pertama dataset OpenHermes
Pertama-tama mari buat baseline untuk membandingkan keberhasilan penggunaan LoRA. Untuk itu, kita akan menghasilkan respons menggunakan fungsi template.format().
Jika diperhatikan, keluaran berikut menunjukkan bahwa respons baseline tidak terlalu mendetail. Gemma bahkan mulai mengulang setelah akhir respons pertama. Hasil ini kurang baik, tetapi menjadi ilustrasi yang bagus tentang perlunya melakukan fine-tune agar model memberikan jawaban yang lebih baik.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-daySekarang mari tingkatkan model dengan LoRA, yang mengurangi jumlah parameter yang dapat dilatih untuk tugas hilir.
Dalam contoh ini, kita akan melakukan fine-tune model dengan LoRA rank 4, yaitu peringkat paling kecil yang efisien secara komputasi. LoRA rank 8 atau 16 bisa dipilih jika Anda ingin meningkatkan kinerja model. Baca panduan Fine-Tuning LLaMA 2 untuk mempelajari lebih lanjut tentang LoRA dan kuantisasi.
Selanjutnya, kita tentukan optimizer, fungsi loss, dan metrik akurasi yang digunakan.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()Parameter yang dapat dilatih turun drastis dari 2,5 miliar menjadi 1,3 juta. Dan ukuran lapisan adaptor hanya 5,2 MB.
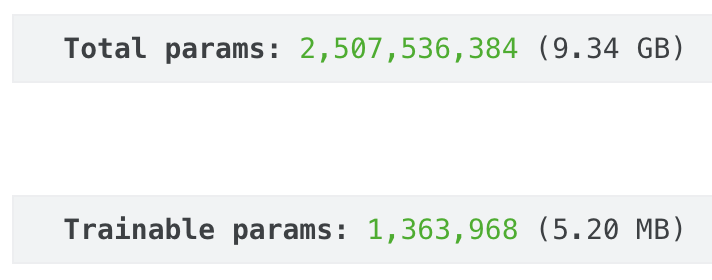
Model Gemma: total versus parameter yang dapat dilatih
Sekarang kita akan memasangkan data ke model. Di sini kita memilih 1 epoch dan ukuran batch 1. Anda dapat meningkatkan kinerja model dengan melatih seluruh dataset setidaknya selama 5 epoch.
gemma_lm.fit(data, epochs=1, batch_size=1)Sekarang mari gunakan prompt yang sama seperti pada eksperimen baseline untuk melihat apakah model kita membaik. Kali ini, alih-alih jawaban satu baris dan pengulangan, model kini memberikan rencana perjalanan Bahamas yang terperinci.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1: Arrive in Nassau, BahamasUpon arrival in Nassau, you will be greeted by a local guide who will take you on a tour of the city. Visit the famous Straw Market, where you can shop for souvenirs and local crafts. Enjoy lunch at a local restaurant before heading to the Atlantis Resort for a day of fun and relaxation. Spend the afternoon exploring the resort's world-class amenities, including the Aquaventure Water Park, Dolphin Cay, and the massive marine habitat, The Dig.Day 2: Explore Paradise IslandOn day 2, you will explore Paradise Island, home to the world-famous Atlantis Resort. Visit the famous Atlantis Casino and enjoy a round of blackjack or roulette. Take a stroll along the beach and enjoy the crystal-clear waters of the Atlantic Ocean. Visit the Dolphin Cay, where you can swim with dolphins and other marine animals.Day 3: Snorkel at Cabbage BeachOn day 3, you will head to Cabbage Beach, a secluded beach located on Paradise Island. Snorkel in the crystal-clear waters and explore the coral reefs. Enjoy a delicious lunch at a local restaurant before heading back to Nassau.Anda dapat menyimpan bobot model untuk inference dan menerapkan model ke produksi.
gemma_lm.save_weights('gemma_2b_openhermes.weights.h5')Total ukuran model hasil fine-tune adalah 10,04GB.
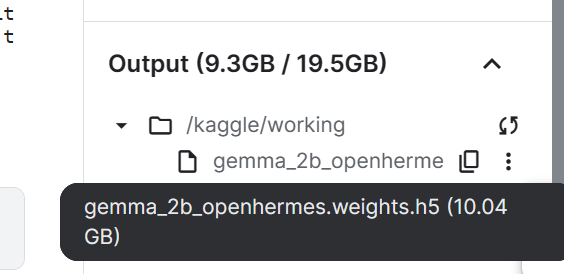 Berkas model Gemma yang telah di-fine-tune dan disimpan
Jika Anda mengalami kesulitan melakukan fine-tuning model, Anda dapat merujuk notebook Kaggle ini sebagai referensi: Finetuning Gemma using TPUs
Sebagai bagian akhir, kita akan menelaah fine-tuning terdistribusi. Fine-tuning terdistribusi dicapai melalui paralelisme model, yang membagi bobot satu model ke beberapa perangkat, memungkinkan penskalaan horizontal, dan mempercepat pelatihan.
Pada bagian ini, kita akan memangkas waktu pelatihan secara signifikan pada model besar. Secara khusus, kita akan menggunakan Keras dengan backend JAX untuk melakukan fine-tune Gemma dengan LoRA dan pelatihan terdistribusi pada TPU.
Di sini kita memulai notebook Kaggle baru dan memasang pustaka yang diperlukan. Lalu kita mengatur backend Keras dan melakukan pra-alokasi memori.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"Pertama, kita akan membuat DeviceMesh untuk membantu memuat bobot dan tensor model yang didistribusikan ke beberapa perangkat TPU. Ini memungkinkan data dan model parallelism, mendukung penskalaan LLM secara efisien pada banyak akselerator.
Buat DeviceMesh dengan bentuk (1, 8), sehingga bobot model dipecah ke seluruh 8 TPU.
import kerasimport keras_nlpdevice_mesh = keras.distribution.DeviceMesh( (1, 8), ["batch", "model"], devices=keras.distribution.list_devices())Selanjutnya, kita akan membuat peta tata letak yang menentukan bagaimana bobot dan tensor harus dipecah atau direplikasi menggunakan RegEx.
Perhatikan hal-hal berikut:
Bobot yang cocok dengan token_embedding/embeddings akan dibagikan.
Gunakan RegEx untuk mencocokkan matriks query, key, dan value di lapisan decoder attention, attention_output, ffw_gating, dan ffw_linear.
Tensor yang cocok akan dipecah menggunakan DeviceMesh, dan sisanya akan direplikasi penuh.
model_dim = "model"layout_map = keras.distribution.LayoutMap(device_mesh)layout_map["token_embedding/embeddings"] = (None, model_dim)layout_map["decoder_block.*attention.*(query|key|value).*kernel"] = ( None, model_dim, None,)layout_map["decoder_block.*attention_output.*kernel"] = (None, None, model_dim)layout_map["decoder_block.*ffw_gating.*kernel"] = (model_dim, None)layout_map["decoder_block.*ffw_linear.*kernel"] = (None, model_dim)Sekarang kita akan mengaktifkan model parallelism menggunakan device_mesh dan layout_map.
model_parallel = keras.distribution.ModelParallel( device_mesh, layout_map, batch_dim_name="batch")keras.distribution.set_distribution(model_parallel)Setelah menyiapkan model parallelism, kita memuat model.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_7b_en")gemma_lm.summary()Kali ini, karena kita menggunakan model Gemma 7B, kita melihat 8,5 miliar parameter yang dapat dilatih.
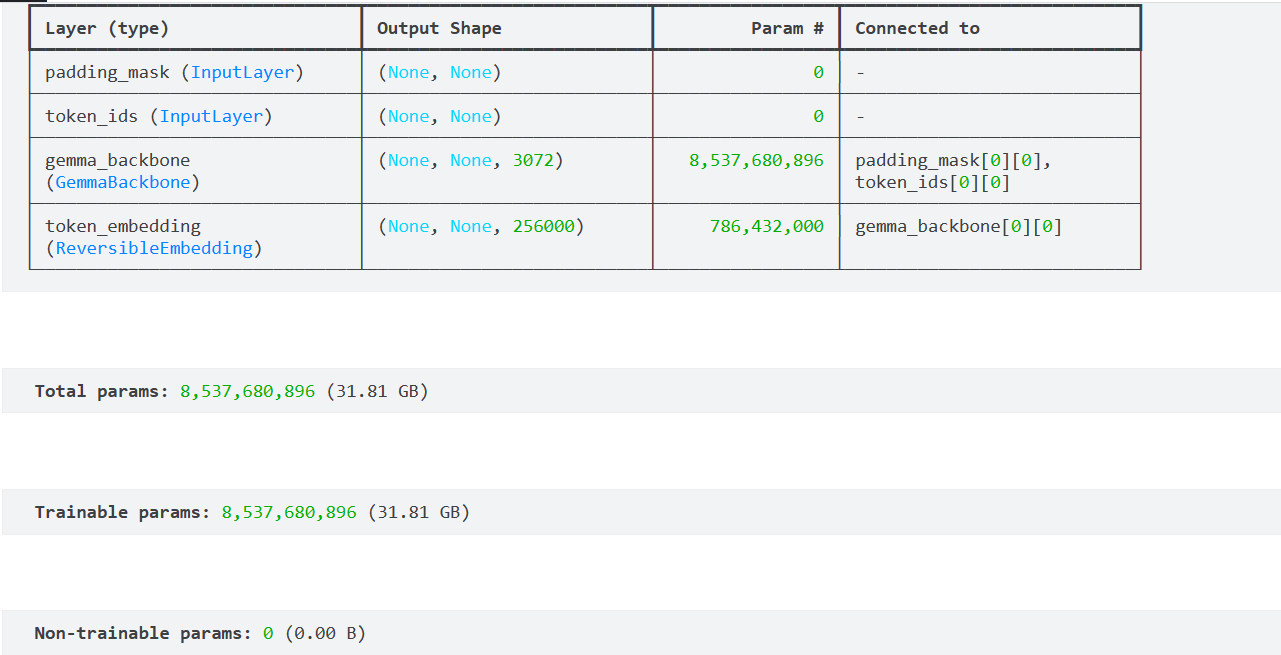 Ringkasan model Gemma 7b
Untuk memverifikasi bahwa model telah dipecah dengan benar, kita akan mencetak path, shape, dan spec dari bobot lapisan decoder_block_1.
decoder_block_1 = gemma_lm.backbone.get_layer('decoder_block_1')print(type(decoder_block_1))for variable in decoder_block_1.weights: print(f'{variable.path:<58} {str(variable.shape):<16} {str(variable.value.sharding.spec)}')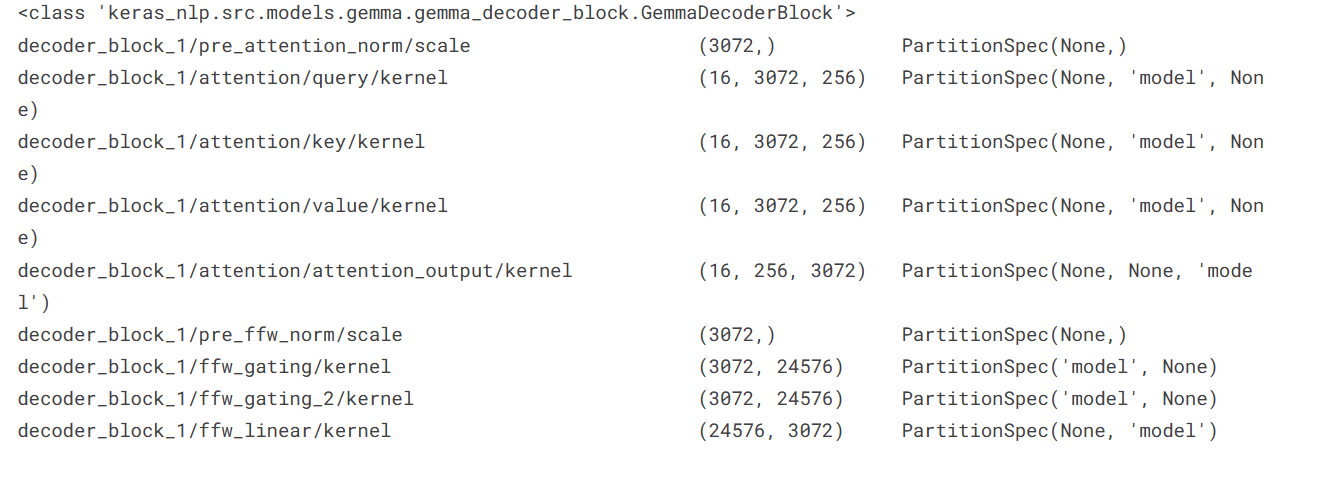
Blok decoder
Mari muat dataset OpenHermes. Sekali lagi, kita mengonversi data frame menjadi daftar string menggunakan templat instruction dan response, dan untuk mempercepat waktu pelatihan, kita hanya memilih 1.000 sampel teratas.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')# Format and convert the dataframe into a list of strings.template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]# Select a subset of the dataset. data = data[:1000]Sekarang kita akan menghasilkan respons untuk baseline dengan memberikan prompt terformat. Menariknya, responsnya bahkan lebih buruk daripada model yang lebih kecil, tetapi mari lanjutkan.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256)) 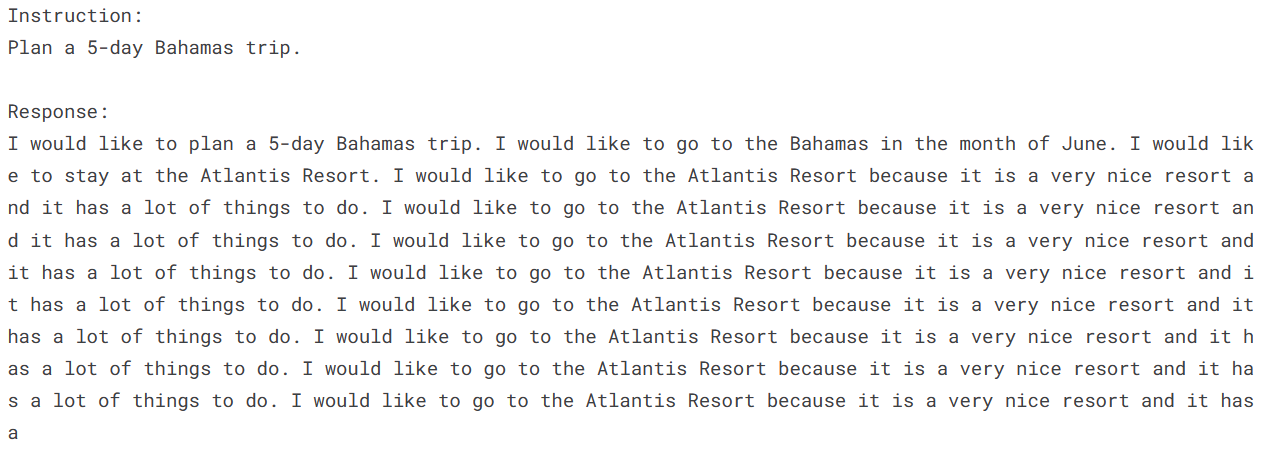 Hasil inference sebelum fine-tuning
Kita akan mengompilasi model dengan konfigurasi model yang sama, LoRA rank, optimizer, fungsi loss, dan metrik akurasi. Sekarang kita memiliki 11 juta parameter yang dapat dilatih dengan ukuran 42,22 MB.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()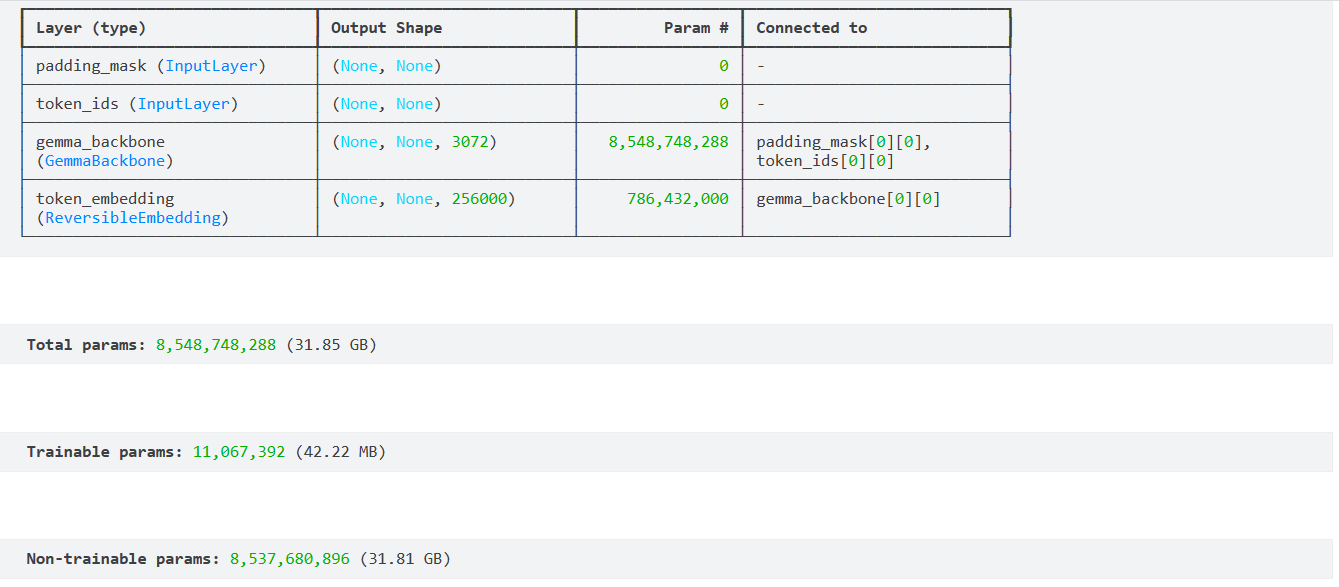 Ringkasan model Gemma 7b LoRA
Kita membutuhkan 305 detik untuk melakukan fine-tune satu epoch, ini sangat baik mengingat ukuran modelnya.
gemma_lm.fit(data, epochs=1, batch_size=1)
Jika Anda merasa fine-tuning menantang, Anda bisa belajar menggunakan API OpenAI dan mengikuti panduan langkah demi langkah untuk melakukan fine-tune GPT-4.
Mari hasilkan respons dan bandingkan dengan hasil baseline.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Model yang telah di-fine-tune sangat baik. Model menghasilkan respons berupa daftar hal yang perlu Anda lakukan untuk menikmati perjalanan lima hari ke Bahamas.
Catatan: Anda dapat mematikan LoRA untuk penyetelan penuh semua parameter yang lebih lambat namun lebih akurat dengan model parallelism.
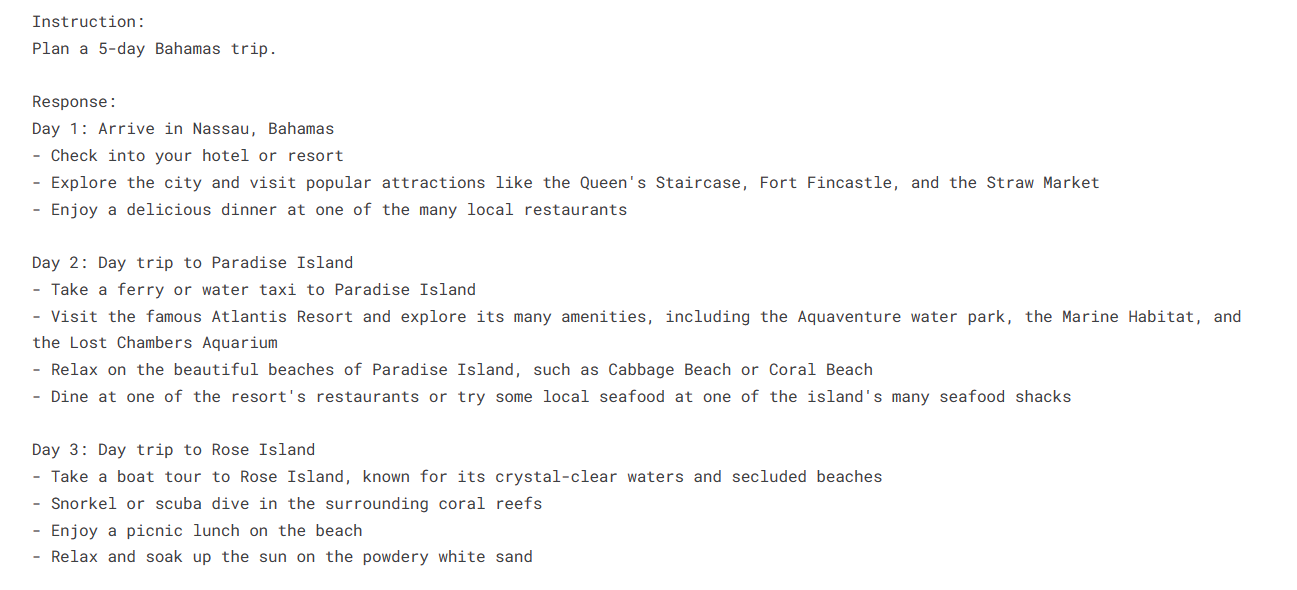 Hasil inference setelah fine-tuning
gemma_lm.save_weights('gemma_7b_openhermes.weights.h5')Sekali lagi, jika Anda mengalami kesulitan dengan fine-tuning terdistribusi, Anda dapat merujuk notebook Kaggle ini sebagai sumber tambahan: Accessing Gemma-instruct-2b-en using TPUs.
Dalam tutorial ini, kita telah mempelajari TPU dan cara menggunakannya untuk mempercepat pembuatan respons LLM. Selain itu, kita telah mempelajari cara melakukan fine-tune model Gemma pada dataset OpenHermes menggunakan TPU dan pelatihan terdistribusi.
Melakukan fine-tune LLM pada TPU dan menggunakan model parallelism untuk pembelajaran terdistribusi merupakan cara penting untuk mempercepat waktu pelatihan. Dengan pembelajaran terdistribusi, Anda bisa melakukan fine-tune bahkan pada model yang sangat besar seperti Gemma 7B. Dengan memanfaatkan TPU—yang dirancang khusus untuk tugas machine learning berkinerja tinggi—Anda bisa mencapai peningkatan kecepatan yang signifikan pada fase pelatihan dan inference.
Jika Anda menikmati tutorial ini dan ingin mempelajari lebih lanjut tentang dunia model bahasa besar, ikuti kursus Master Large Language Models (LLMs) Concepts untuk menemukan potensi penuh aplikasi LLM, metodologi pelatihan, pertimbangan etika, dan riset terbaru. Jika Anda tertarik pada model bahasa besar lain yang bersaing dengan Gemma, lihat tutorial Memulai Mixtral 8X22B untuk mempelajari lebih lanjut tentang model baru Mistral AI dan arsitektur sparse mixture of experts (SMoE)-nya.
Pelajari Lebih Lanjut tentang Large Language Models
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt



