
Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.3K
Bài viết này là một hướng dẫn toàn diện về tinh chỉnh các mô hình ngôn ngữ lớn bằng những kỹ thuật nâng cao. Chúng ta sẽ đi qua các ví dụ sử dụng Bộ Xử Lý Tensor (TPU), một kỹ thuật gọi là LoRA, và điện toán phân tán — tất cả nhằm tăng tốc độ và hiệu suất. Để minh họa các kỹ thuật, chúng ta sẽ truy cập và tinh chỉnh các mô hình Gemma, một họ LLM nhẹ, tiên tiến do Google tạo ra.
Kết thúc hướng dẫn, bạn sẽ có kỹ năng tinh chỉnh và chạy suy luận trên bất kỳ mô hình ngôn ngữ lớn nào bằng các TPU sẵn có trên Google Cloud. Để đạt được điều đó, chúng ta sẽ lần lượt đi qua các chủ đề sau:
Sử dụng Gemma với TPU: Thiết lập môi trường Kaggle để dùng TPU.
Thiết lập mô hình và suy luận: Chạy Gemma bằng thư viện Keras trong Python.
Tinh chỉnh: Tinh chỉnh mô hình Gemma với kỹ thuật LoRA.
Huấn luyện phân tán: Thực hiện tinh chỉnh phân tán để tăng hiệu quả huấn luyện.
Nếu bạn mới làm quen với AI và LLM, hãy cân nhắc học lộ trình kỹ năng toàn diện AI Fundamentals để quen với các thuật ngữ dùng trong hướng dẫn này.
Hãy bắt đầu!
 Logo Google Gemma
Mô hình Gemma của Google là một thành viên trong họ các mô hình ngôn ngữ lớn mã nguồn mở và gọn nhẹ do Google phát triển và giới thiệu năm 2024. Gemma được tạo ra dựa trên cùng nghiên cứu và công nghệ như các mô hình Google Gemini, và tương tự Gemini, Gemma tương thích với các khung máy học chủ đạo như Keras và Pytorch. Mô hình có hai kích thước, với 2B hoặc 7B tham số.
Trong khi Gemini chủ yếu hướng đến người dùng cuối qua ứng dụng và API trực tiếp, Gemma được mở mã nguồn để cộng đồng nhà phát triển có thể sửa đổi và tích hợp rộng rãi. Các mô hình Gemma cũng nhỏ hơn, giúp tính di động cao và tiết kiệm chi phí.
 Hình ảnh CPU, GPU, TPU bởi Freepik và Flaticon
Hãy so sánh các lựa chọn phần cứng khác nhau cho máy học để có bối cảnh. Phần cứng được phân loại theo các nhóm riêng, mỗi nhóm phục vụ vai trò chuyên biệt trong xử lý và tính toán.
Bộ xử lý trung tâm (CPU): CPU chạy hệ điều hành trong hầu hết thiết bị tính toán. CPU nổi tiếng với việc xử lý tuần tự.
Bộ xử lý đồ họa (GPU): GPU xử lý đồng thời nhiều tác vụ, phù hợp cho kết xuất đồ họa.
Bộ xử lý tensor (TPU): TPU là bộ xử lý chuyên dụng do Google phát triển cho máy học. Chúng được thiết kế để thực hiện nhanh các phép tính ma trận — tối quan trọng trong huấn luyện và vận hành mạng nơ-ron.
Nhóm cuối cùng, TPU, là trọng tâm của hướng dẫn này. TPU nhanh hơn GPU trong huấn luyện và suy luận mạng nơ-ron sâu; chúng cũng tiêu thụ ít điện hơn. Nhược điểm là hệ sinh thái TPU còn kém trưởng thành, ít công cụ và khung hơn. Các khung hiện có gồm Google Cloud Platform, Colab, và Kaggle.
Thành phần | Mục đích chính | Ứng dụng ML | Ưu điểm | Mức độ sẵn có |
CPU | Tác vụ chung | Mô hình đơn giản | Rẻ hơn, ít điện năng | Rất sẵn có |
GPU | Kết xuất đồ họa | Học sâu, xử lý dữ liệu lớn | Nhanh cho tính toán phức tạp | Có bán thương mại |
TPU | Máy học | Mạng nơ-ron sâu, phép toán ma trận tốc độ cao | Nhanh nhất cho ML, tiết kiệm điện | Không sẵn có ngoài Google Cloud, Colab và Kaggle |
Bảng so sánh phần cứng máy học
Các mô hình Gemma được thiết kế để có khả năng mở rộng cao và hiệu quả khi sử dụng với thiết lập điện toán phân tán, có thể cải thiện đáng kể hiệu năng và tốc độ, đặc biệt khi xử lý khối lượng dữ liệu lớn và kiến trúc mô hình phức tạp.
Thư viện Keras hoạt động tốt trong trường hợp này vì hỗ trợ huấn luyện phân tán các mô hình Gemma, tận dụng triển khai đa backend gồm TensorFlow và PyTorch.
Trong phần này, chúng ta sẽ cấu hình sổ tay Kaggle để hỗ trợ TPU, đảm bảo mọi thư viện và phụ thuộc cần thiết được cài đặt để vận hành trơn tru. Sau đó, chúng ta sẽ tải mô hình Gemma 2B hoặc 7B bằng gói keras-nlp. Cuối cùng, chúng ta sẽ triển khai mô hình để thực hiện tác vụ, sử dụng năng lực tính toán mạnh mẽ của TPU để xử lý và tạo phản hồi hiệu quả.
Để chuẩn bị môi trường, chúng ta cần tích hợp phiên bản Gemma cho Keras và chuyển bộ tăng tốc tính toán sang TPU để đạt hiệu năng tốt hơn. Chúng ta sẽ cài đặt các gói thiết yếu như keras-nlp, cấu hình Keras dùng TensorFlow làm backend, và tối ưu phân bổ bộ nhớ TPU để đảm bảo huấn luyện và chạy mô hình mượt mà.
Để chuẩn bị môi trường, chúng ta cần thêm triển khai Keras cho mô hình Gemma. Cụ thể, nghĩa là tích hợp phiên bản mô hình Gemma tương thích Keras để đảm bảo kết nối mượt với API TensorFlow.
Để thêm triển khai Keras, thực hiện các bước sau:
Tạo sổ tay (notebook) mới trong Kaggle.
Đi tới phần "Input" ở bảng bên phải.
Nhấn “+ Add Input” để thêm triển khai Keras của mô hình Gemma.
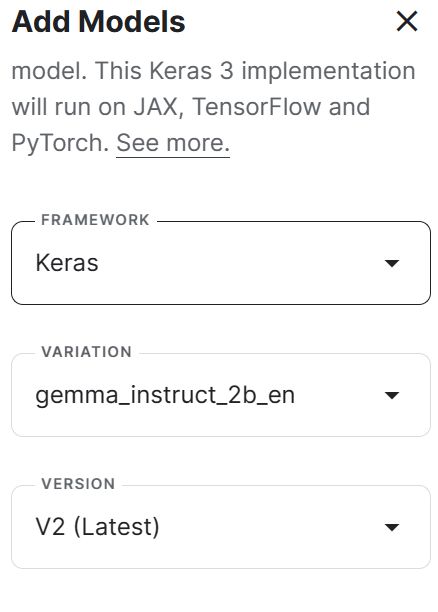 Thêm triển khai Keras cho mô hình Gemma
Tiếp theo, chúng ta sẽ đổi bộ tăng tốc sang TPU, tức là chuyển bộ tăng tốc tính toán trong cài đặt sổ tay sang TPU để tận dụng sức mạnh xử lý cho huấn luyện và suy luận.
Để đổi bộ tăng tốc, làm theo các bước dưới đây. Việc môi trường tải lại mất vài phút là bình thường.
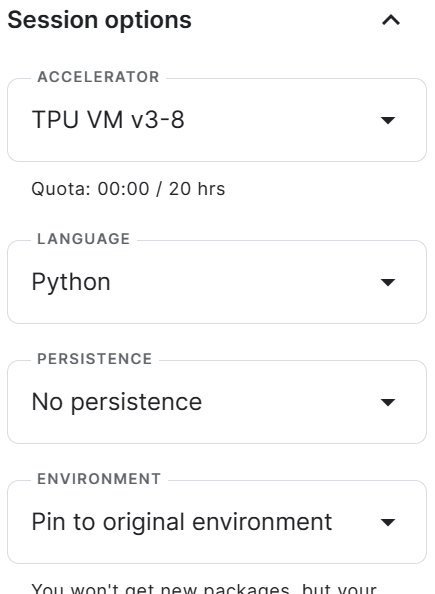 Thiết lập TPU làm bộ tăng tốc
Giờ chúng ta cài đặt các gói Python mới nhất sẽ dùng cho tinh chỉnh và suy luận, bao gồm TensorFlow và keras-nlp.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1Chúng ta đặt backend của Keras là JAX để truy cập TPU liền mạch. Bạn cũng có thể thử TensorFlow hoặc PyTorch.
Cuối cùng, chúng ta cấp phát trước bộ nhớ TPU để tối ưu hiệu năng và tránh lỗi khi chạy mô hình. Ở đây, chúng ta cấp phát 100% tổng bộ nhớ TPU để tránh phân mảnh bộ nhớ trên backend JAX.
import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"]="1.00"Chúng ta tải các gói Python cần thiết cho suy luận mô hình.
import kerasimport keras_nlpSau đó, chúng ta tải mô hình và hiển thị tóm tắt mô hình.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_instruct_2b_en")gemma_lm.summary()Chúng ta đã tải thành công bộ tokenizer và mô hình chỉ với một lệnh. Điều này thật ấn tượng vì ngay cả mô hình Gemma nhỏ nhất cũng có 2,5 tỷ tham số và dung lượng 9,34 GB.
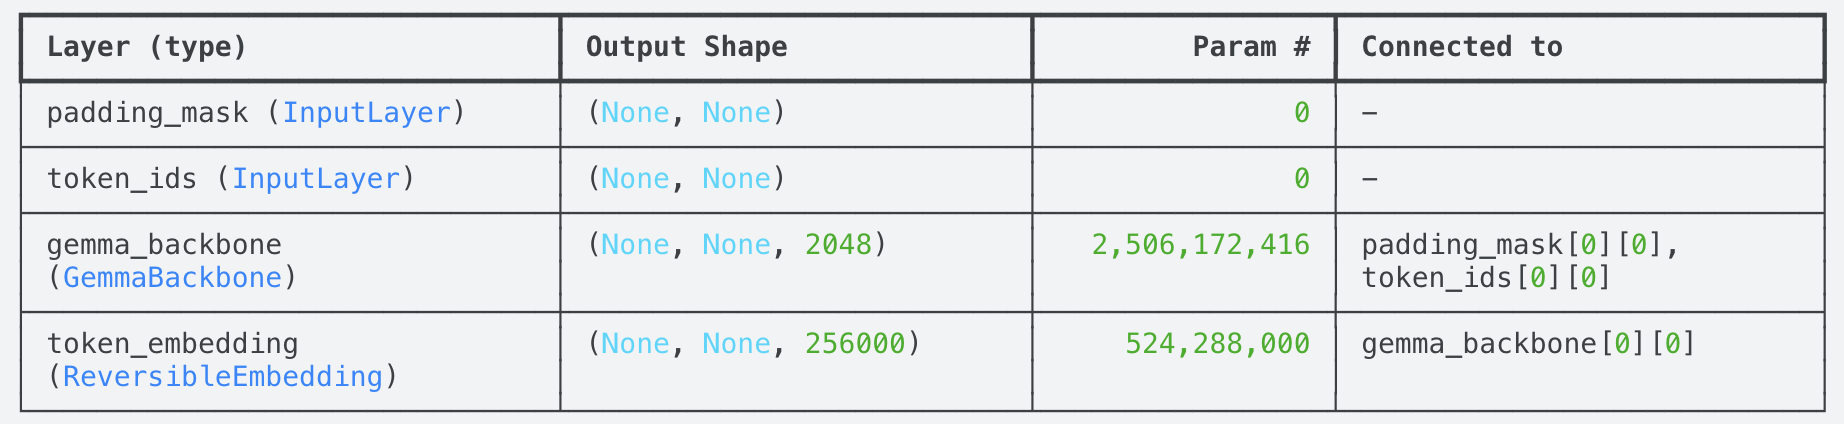 Tóm tắt mô hình Gemma
Bạn có thể phải chờ vài phút để chạy sổ tay và trải nghiệm hiệu năng siêu nhanh. Lý do là TPU đang có nhu cầu cao. Nếu chạy sổ tay vào ban đêm, có thể bạn sẽ không phải chờ.
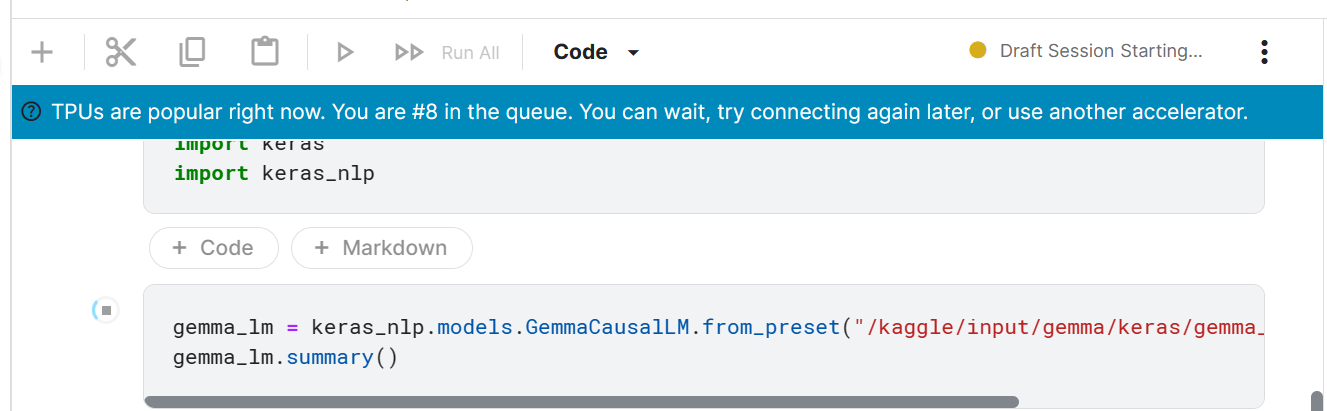 Xếp hàng chờ truy cập TPU
Chạy suy luận là quá trình sử dụng mô hình để tạo đầu ra dựa trên đầu vào mới, chưa từng thấy. Trong ngữ cảnh của chúng ta, ta sẽ cung cấp đầu vào dạng văn bản bằng hàm .generate(). Phản hồi sẽ đến ngay.
print(gemma_lm.generate("What is DataCamp?", max_length=30))What is DataCamp?DataCamp is a leading online data science education platform that empowers individuals and organizations to build data-driven careers. TheyChúng ta cũng có thể thử suy luận theo lô, nghĩa là cung cấp nhiều prompt để tạo nhiều phản hồi. Kết quả là một danh sách.
print(gemma_lm.generate(["How far is the Sun from earth", "What is the Sun made of?"], max_length=30))['How far is the Sun from earth?\n\nThe Sun is about 149.6 million kilometers (93 million miles) away from', 'What is the Sun made of?\n\nThe Sun is primarily composed of hydrogen and helium. Hydrogen makes up about 73.4% of']Tiếp theo, chúng ta sẽ tạo một mẫu có hướng dẫn và phản hồi để dẫn dắt mô hình. Bạn có thể thêm system prompt hoặc lệnh khởi tạo khác để điều chỉnh phản hồi tạo ra.
Chúng ta sẽ dùng hàm .format() để điền văn bản mẫu bằng các đối số của người dùng. Kết quả là danh sách các bước giúp bạn học Python.
template = "Instruction:\n{instruction}\n\nResponse:\n{response}"prompt = template.format( instruction="How do I start learning Python?", response="",)print(gemma_lm.generate(prompt, max_length=250))Instruction:How do I start learning Python?Response:**Step 1: Choose a learning path*** **Online Courses:** * DataCamp * Codecademy * Coursera * edX * Udemy* **Books:** * "Automate the Boring Stuff with Python" by Al Sweigart * "Python Crash Course" by Eric Matthes * "Head First Python" by Kathy Sierra and Bert Bates* **Video Tutorials.........Nếu bạn gặp khó khăn khi tải mô hình và tạo phản hồi bằng TPU, hãy tham khảo sổ tay Kaggle này: Accessing Gemma-instruct-2b-en using TPUs.
Nếu bạn bắt đầu thấy quen với Gemma, hãy tìm hiểu thêm cách nâng cao Gemma bằng hướng dẫn tùy chỉnh qua bài Fine Tuning Google Gemma: Enhancing LLMs with Customized Instructions.
Giờ hãy học cách tinh chỉnh mô hình Gemma bằng bộ dữ liệu công khai tên là OpenHermes. Bộ dữ liệu OpenHermes có 242.000 dòng với hai cột, một cho hướng dẫn và một cho phản hồi, tất cả được tạo bằng mô hình GPT-4.
Như chúng ta sẽ thấy, tinh chỉnh toàn bộ bộ dữ liệu này sẽ mất rất lâu, ngay cả khi dùng TPU. Để hỗ trợ quy trình, chúng ta sẽ áp dụng kỹ thuật LoRA.
LoRA (Low-Rank Adaptation) được thiết kế để cải thiện quá trình tinh chỉnh các mô hình ngôn ngữ lớn bằng cách làm cho quy trình hiệu quả và dễ tiếp cận hơn. Nó giải quyết thách thức của các phương pháp tinh chỉnh truyền thống, vốn thường tốn kém tính toán và tài nguyên.
Về mặt kỹ thuật, LoRA hoạt động bằng cách đóng băng trọng số tiền huấn luyện của mô hình và đưa vào các ma trận hạng thấp để điều chỉnh các phần cụ thể trong kiến trúc mô hình. Bằng cách tập trung vào các ma trận hạng thấp này, LoRA giảm tối đa tài nguyên tính toán cần thiết, khiến việc tinh chỉnh các mô hình lớn trên phần cứng yếu hơn trở nên khả thi.
Tương tự phần thiết lập môi trường mô hình trước đó, chúng ta sẽ đặt backend Keras và cấp phát trước bộ nhớ. Chúng ta cũng có thể dùng hàm jax. devices() để kiểm tra các thiết bị TPU sẵn có.
import osimport jaxos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"jax.devices()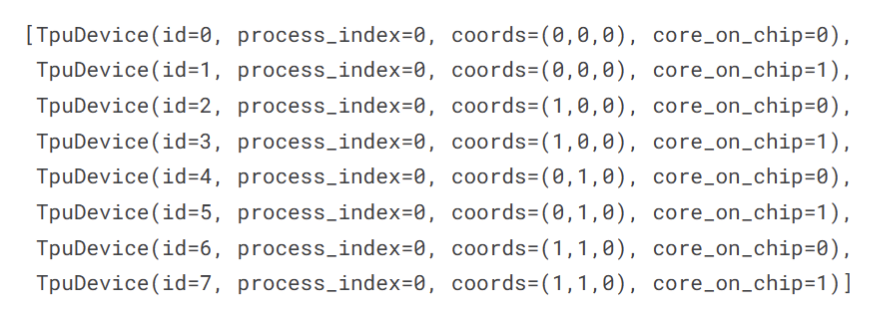
Số lượng thiết bị tính toán
Chúng ta tải mô hình và hiển thị tóm tắt mô hình. Có 2,5B tham số có thể huấn luyện.
import kerasimport keras_nlpgemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_2b_en")gemma_lm.summary()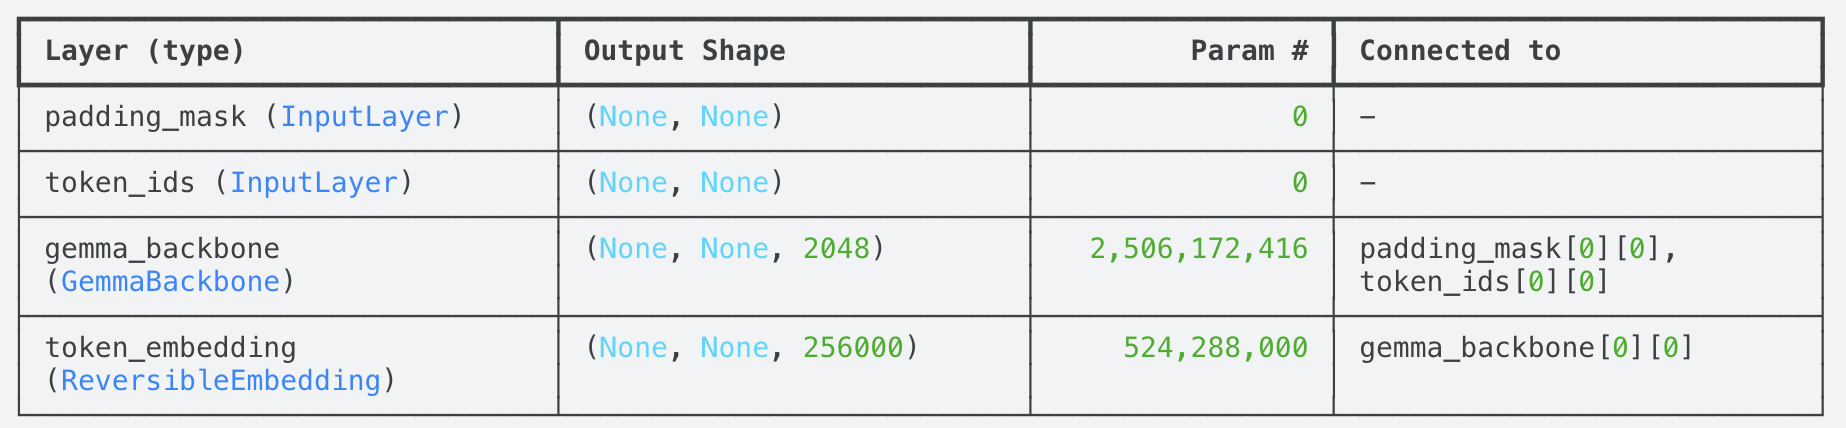 Tóm tắt mô hình Gemma
Tiếp theo, chúng ta tải bộ dữ liệu vào sổ tay. Quy trình tương tự như thêm mô hình. Thực hiện các bước sau:
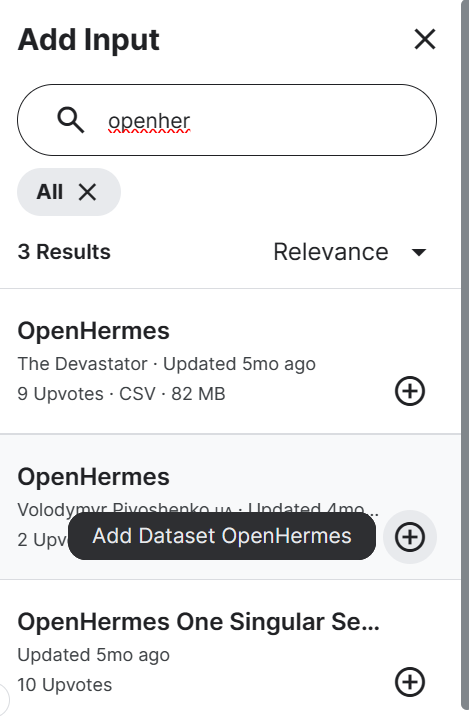
Thêm bộ dữ liệu OpenHermes
Giờ chúng ta dùng thư viện pandas để đọc bộ dữ liệu và hiển thị 5 dòng đầu. Có 2 cột, một cho instruction và một cho output.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')df.head()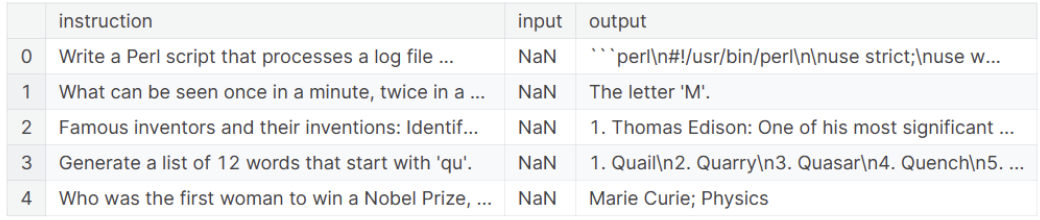
Bộ dữ liệu OpenHermes
Giờ khi đã tải mô hình và bộ dữ liệu, chúng ta cần truyền bộ dữ liệu vào mô hình. Để làm vậy, ta phải chuyển đổi bộ dữ liệu thành danh sách chuỗi theo định dạng instruction và response.
Hóa ra, huấn luyện toàn bộ bộ dữ liệu sẽ mất gần 23 giờ, ngay cả trên TPU. Vì vậy, chúng ta chỉ chọn 1.000 mẫu đầu để rút ngắn thời gian huấn luyện.
template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]data = data[:1000]print(data[0])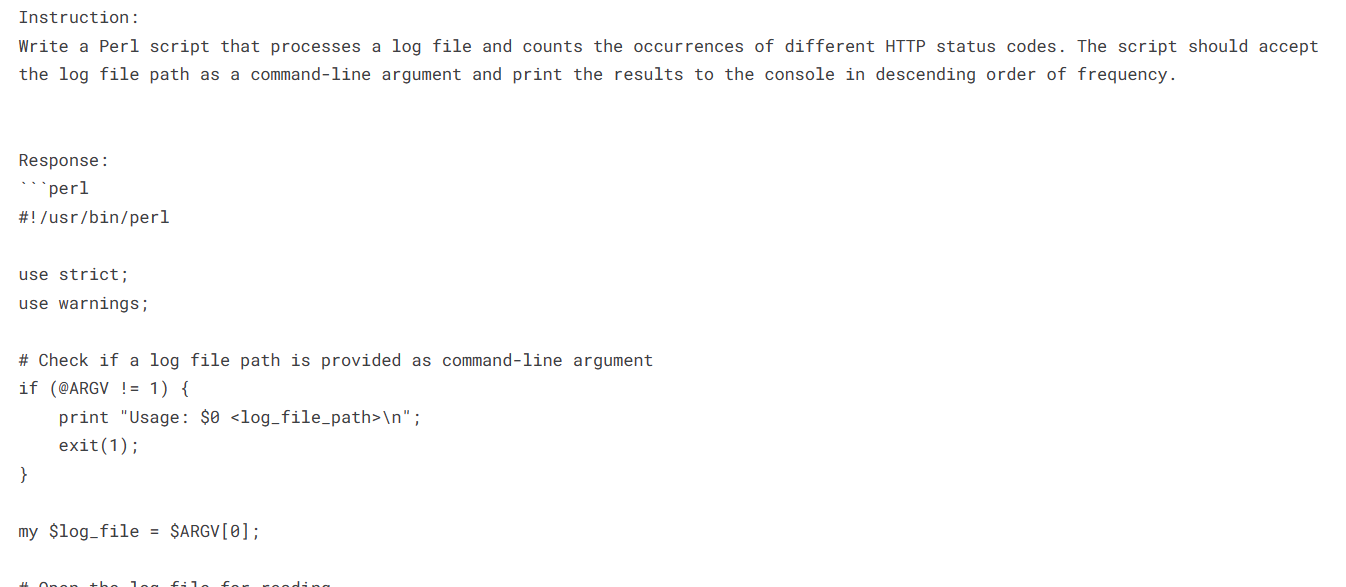
Mẫu đầu tiên của bộ dữ liệu OpenHermes
Hãy tạo một đường cơ sở để so sánh mức độ thành công khi dùng LoRA. Để làm vậy, ta sẽ tạo phản hồi bằng hàm template.format().
Đọc kỹ, đầu ra sau đây cho thấy phản hồi cơ sở không chi tiết. Gemma thậm chí bắt đầu lặp lại sau khi kết thúc phản hồi đầu tiên. Đây không phải kết quả tốt, nhưng là minh họa phù hợp cho nhu cầu tinh chỉnh mô hình để cung cấp câu trả lời tốt hơn.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-dayGiờ hãy cải thiện mô hình với LoRA, giúp giảm số tham số cần huấn luyện cho các tác vụ hạ nguồn.
Trong ví dụ này, chúng ta tinh chỉnh mô hình với LoRA rank 4, là hạng nhỏ nhất hiệu quả về tính toán. Bạn có thể chọn LoRA rank 8 hoặc 16 nếu muốn cải thiện hiệu năng mô hình. Đọc hướng dẫn Fine-Tuning LLaMA 2 để tìm hiểu thêm về LoRA và lượng tử hóa.
Sau đó, chúng ta chỉ định bộ tối ưu, hàm mất mát và chỉ số độ chính xác sẽ dùng.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()Số tham số có thể huấn luyện đã giảm đáng kể từ 2,5 tỷ xuống còn 1,3 triệu. Và kích thước lớp adapter chỉ 5,2 MB.
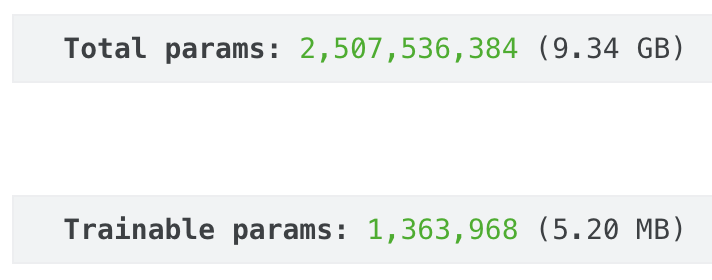
Mô hình Gemma: tổng số tham số so với tham số có thể huấn luyện
Giờ chúng ta sẽ fit dữ liệu vào mô hình. Ở đây, chọn 1 epoch và batch size là 1. Bạn có thể cải thiện hiệu năng bằng cách huấn luyện toàn bộ bộ dữ liệu với ít nhất 5 epoch.
gemma_lm.fit(data, epochs=1, batch_size=1)Hãy thử lại cùng prompt dùng ở thí nghiệm cơ sở để xem mô hình đã cải thiện chưa. Lần này, thay vì câu trả lời một dòng và lặp lại, mô hình đã đưa ra kế hoạch du lịch chi tiết cho Bahamas.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1: Arrive in Nassau, BahamasUpon arrival in Nassau, you will be greeted by a local guide who will take you on a tour of the city. Visit the famous Straw Market, where you can shop for souvenirs and local crafts. Enjoy lunch at a local restaurant before heading to the Atlantis Resort for a day of fun and relaxation. Spend the afternoon exploring the resort's world-class amenities, including the Aquaventure Water Park, Dolphin Cay, and the massive marine habitat, The Dig.Day 2: Explore Paradise IslandOn day 2, you will explore Paradise Island, home to the world-famous Atlantis Resort. Visit the famous Atlantis Casino and enjoy a round of blackjack or roulette. Take a stroll along the beach and enjoy the crystal-clear waters of the Atlantic Ocean. Visit the Dolphin Cay, where you can swim with dolphins and other marine animals.Day 3: Snorkel at Cabbage BeachOn day 3, you will head to Cabbage Beach, a secluded beach located on Paradise Island. Snorkel in the crystal-clear waters and explore the coral reefs. Enjoy a delicious lunch at a local restaurant before heading back to Nassau.Bạn có thể lưu trọng số mô hình để suy luận và triển khai mô hình vào sản xuất.
gemma_lm.save_weights('gemma_2b_openhermes.weights.h5')Tổng dung lượng mô hình đã tinh chỉnh là 10,04 GB.
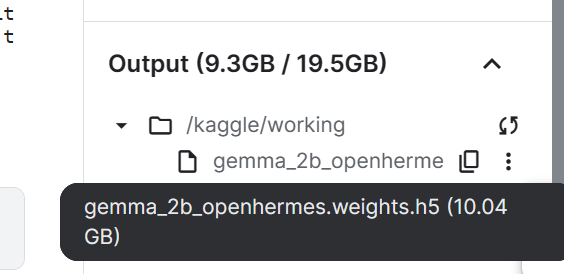 Tệp mô hình Gemma đã tinh chỉnh và lưu
Nếu bạn gặp khó khăn khi tinh chỉnh mô hình, có thể tham khảo sổ tay Kaggle này: Finetuning Gemma using TPUs
Ở phần cuối, chúng ta sẽ xem xét kỹ việc tinh chỉnh phân tán. Tinh chỉnh phân tán đạt được qua song song mô hình, phân bổ trọng số của một mô hình lên nhiều thiết bị, cho phép mở rộng theo chiều ngang và tăng tốc huấn luyện.
Trong phần này, chúng ta sẽ giảm đáng kể thời gian huấn luyện trên một mô hình lớn. Cụ thể, chúng ta dùng Keras với backend JAX để tinh chỉnh Gemma bằng LoRA và huấn luyện phân tán trên TPU.
Ở đây, chúng ta khởi tạo sổ tay Kaggle mới và cài đặt các thư viện cần thiết. Sau đó đặt backend Keras và cấp phát trước bộ nhớ.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"Trước tiên, chúng ta sẽ tạo một DeviceMesh để giúp tải trọng số mô hình và tensor phân tán trên nhiều thiết bị TPU. Nó cho phép song song dữ liệu và mô hình, giúp mở rộng hiệu quả LLM trên nhiều bộ tăng tốc.
Tạo DeviceMesh với hình dạng (1, 8), để trọng số mô hình được chia mảnh trên cả 8 TPU.
import kerasimport keras_nlpdevice_mesh = keras.distribution.DeviceMesh( (1, 8), ["batch", "model"], devices=keras.distribution.list_devices())Tiếp theo, chúng ta sẽ tạo layout map chỉ định cách sharding hoặc nhân bản trọng số và tensor bằng RegEx.
Lưu ý các điểm sau:
Các trọng số khớp với token_embedding/embeddings sẽ được chia sẻ.
Dùng RegEx để khớp các ma trận query, key và value trong lớp decoder attention, attention_output, ffw_gating và ffw_linear.
Các tensor được khớp sẽ được sharding bằng DeviceMesh, phần còn lại sẽ được nhân bản đầy đủ.
model_dim = "model"layout_map = keras.distribution.LayoutMap(device_mesh)layout_map["token_embedding/embeddings"] = (None, model_dim)layout_map["decoder_block.*attention.*(query|key|value).*kernel"] = ( None, model_dim, None,)layout_map["decoder_block.*attention_output.*kernel"] = (None, None, model_dim)layout_map["decoder_block.*ffw_gating.*kernel"] = (model_dim, None)layout_map["decoder_block.*ffw_linear.*kernel"] = (None, model_dim)Giờ chúng ta sẽ kích hoạt song song mô hình bằng device_mesh và layout_map.
model_parallel = keras.distribution.ModelParallel( device_mesh, layout_map, batch_dim_name="batch")keras.distribution.set_distribution(model_parallel)Sau khi thiết lập song song mô hình, chúng ta tải mô hình.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_7b_en")gemma_lm.summary()Lần này, do dùng mô hình Gemma 7B, chúng ta thấy có 8,5 tỷ tham số có thể huấn luyện.
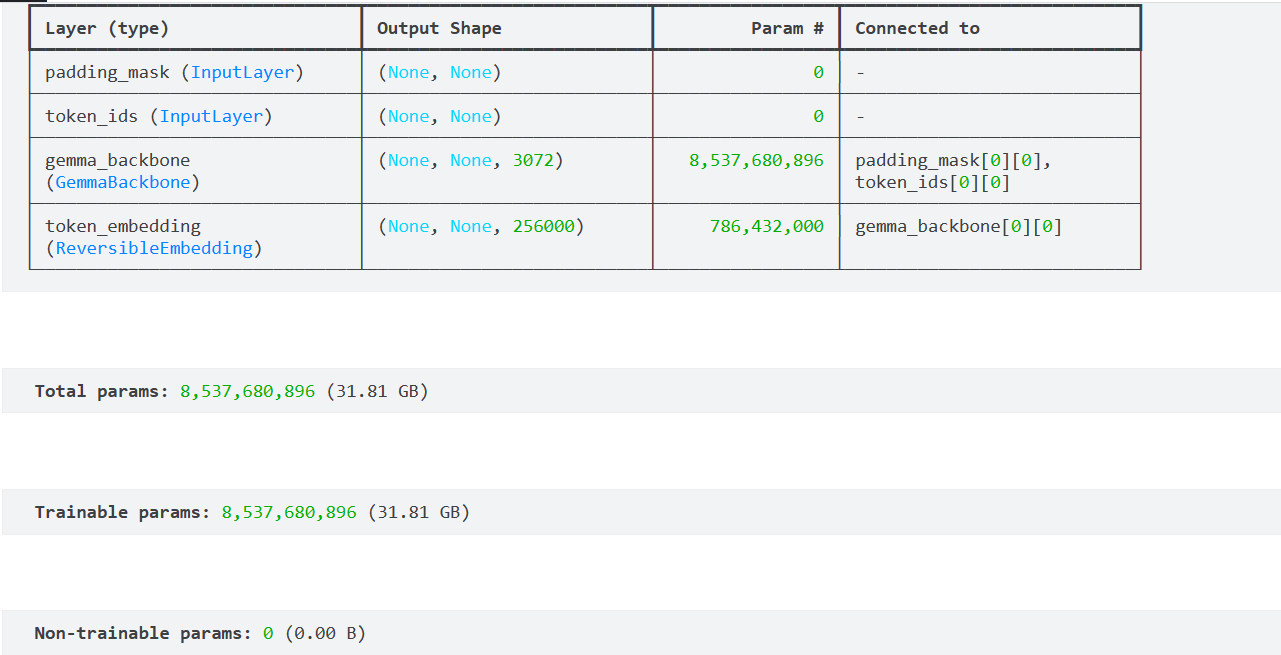 Tóm tắt mô hình Gemma 7B
Để xác minh mô hình đã được chia mảnh đúng, chúng ta sẽ in path, shape và spec của trọng số lớp decoder_block_1.
decoder_block_1 = gemma_lm.backbone.get_layer('decoder_block_1')print(type(decoder_block_1))for variable in decoder_block_1.weights: print(f'{variable.path:<58} {str(variable.shape):<16} {str(variable.value.sharding.spec)}')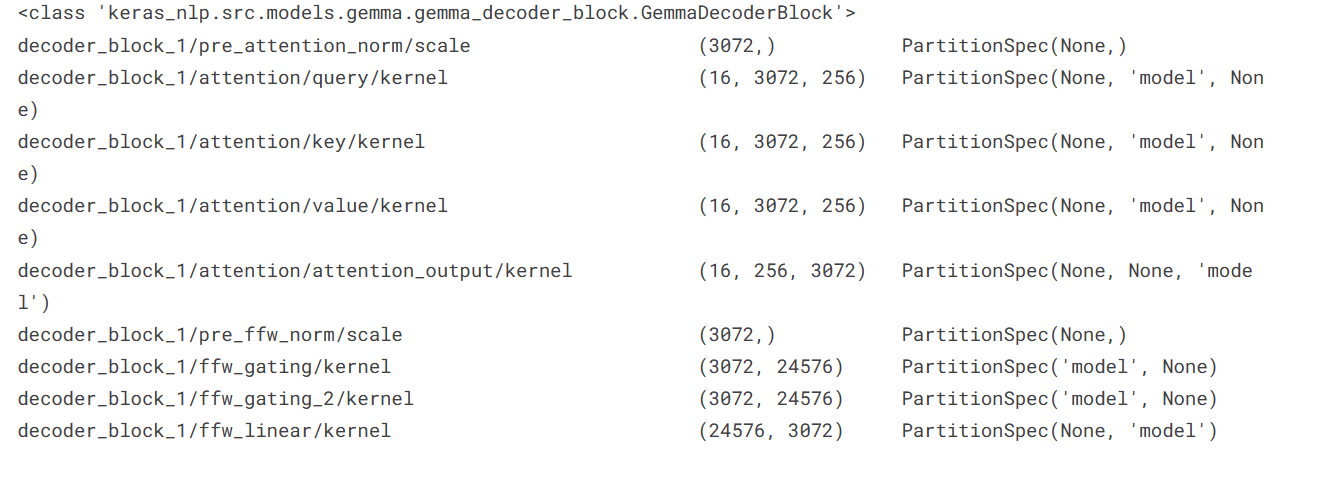
Khối decoder
Hãy tải bộ dữ liệu OpenHermes. Một lần nữa, chúng ta chuyển đổi khung dữ liệu thành danh sách chuỗi theo mẫu instruction và response, và để tăng tốc huấn luyện, chỉ chọn 1.000 mẫu đầu.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')# Format and convert the dataframe into a list of strings.template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]# Select a subset of the dataset. data = data[:1000]Chúng ta sẽ tạo phản hồi cơ sở bằng cách cung cấp prompt đã định dạng. Thú vị là phản hồi còn tệ hơn mô hình nhỏ hơn, nhưng hãy tiếp tục.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256)) 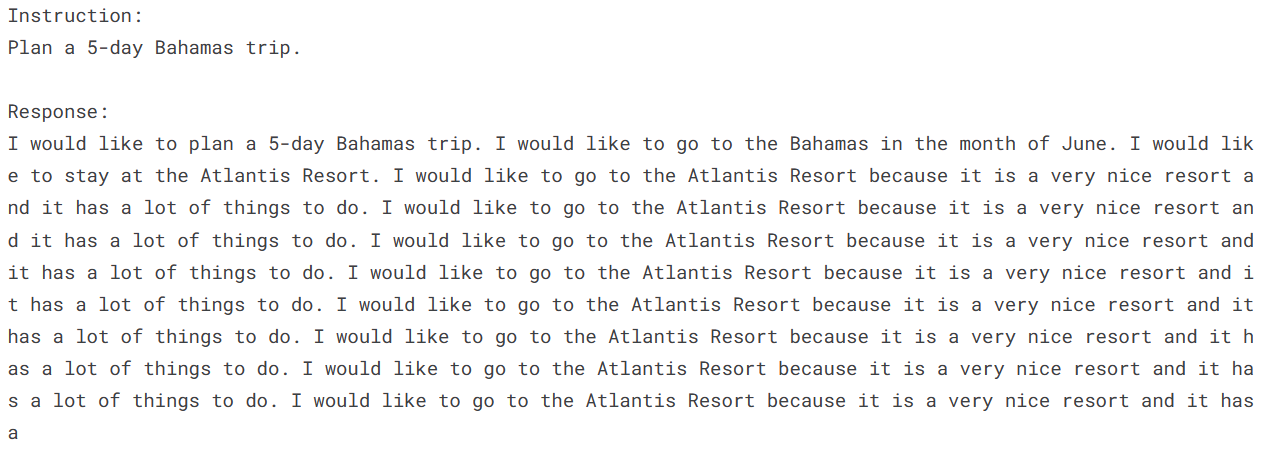 Kết quả suy luận trước khi tinh chỉnh
Chúng ta sẽ biên dịch mô hình với cùng cấu hình, LoRA rank, bộ tối ưu, hàm mất mát và chỉ số độ chính xác. Hiện có 11 triệu tham số có thể huấn luyện với kích thước 42,22 MB.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()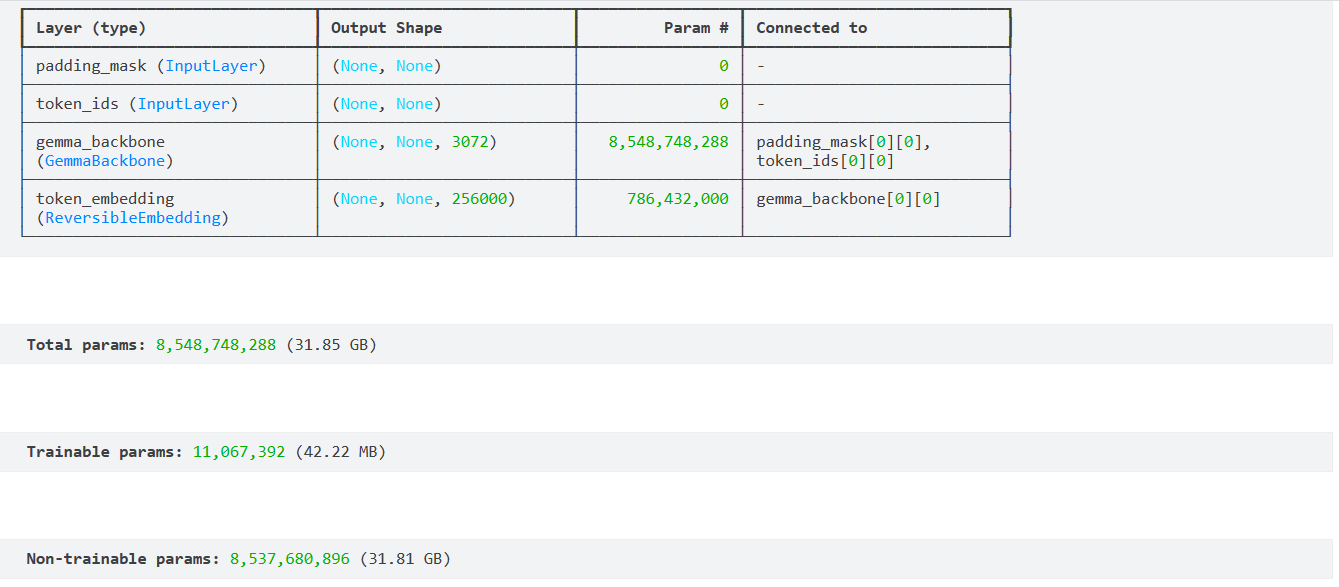 Tóm tắt mô hình Gemma 7B với LoRA
Mất 305 giây để tinh chỉnh một epoch — rất tốt nếu xét kích thước mô hình.
gemma_lm.fit(data, epochs=1, batch_size=1)
Nếu bạn thấy tinh chỉnh quá khó, bạn có thể học cách dùng API của OpenAI và làm theo hướng dẫn từng bước để tinh chỉnh GPT-4.
Hãy tạo phản hồi và so sánh với kết quả cơ sở.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Mô hình đã tinh chỉnh cho kết quả rất tốt. Nó tạo ra danh sách những việc bạn cần làm để tận hưởng chuyến đi Bahamas năm ngày.
Lưu ý: bạn có thể tắt LoRA để thực hiện tinh chỉnh toàn tham số — chậm hơn nhưng chính xác hơn — cùng song song mô hình.
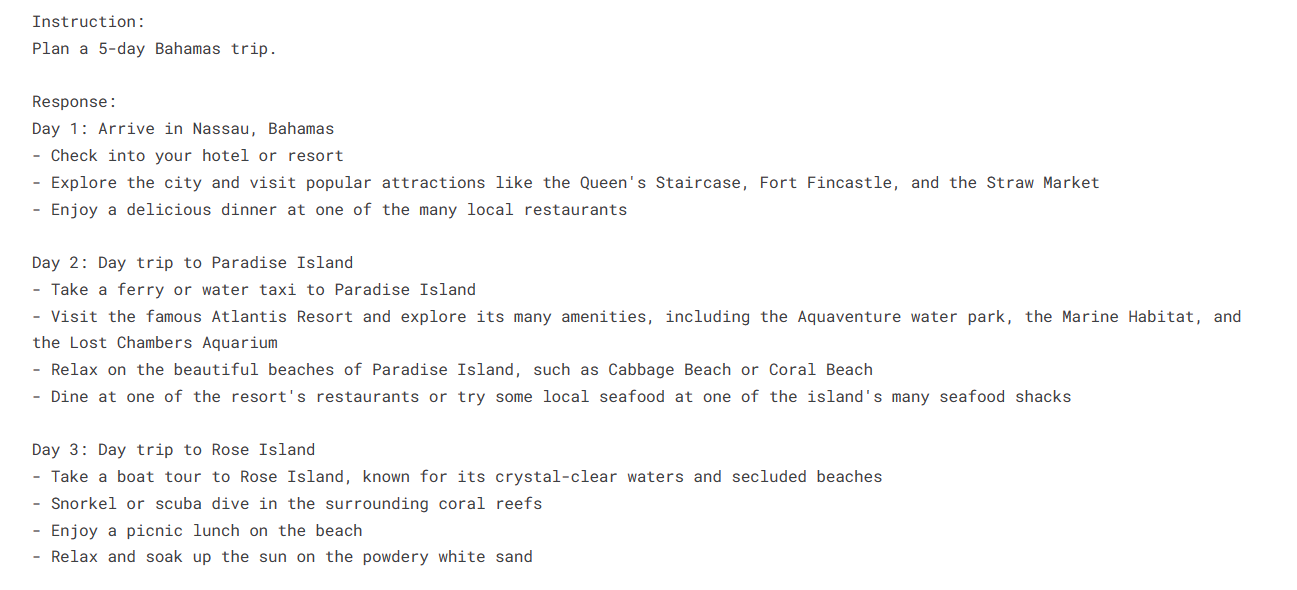 Kết quả suy luận sau khi tinh chỉnh
gemma_lm.save_weights('gemma_7b_openhermes.weights.h5')Một lần nữa, nếu bạn gặp khó khăn với tinh chỉnh phân tán, có thể tham khảo sổ tay Kaggle này như tài nguyên bổ sung: Accessing Gemma-instruct-2b-en using TPUs.
Trong hướng dẫn này, chúng ta đã tìm hiểu về TPU và cách sử dụng chúng để tăng tốc tạo phản hồi của LLM. Hơn nữa, chúng ta đã học cách tinh chỉnh các mô hình Gemma trên bộ dữ liệu OpenHermes bằng TPU và huấn luyện phân tán.
Tinh chỉnh LLM trên TPU và dùng song song mô hình cho học phân tán là những cách quan trọng để rút ngắn thời gian huấn luyện. Nhờ học phân tán, bạn có thể tinh chỉnh cả những mô hình rất lớn như Gemma 7B. Bằng cách tận dụng TPU — vốn được thiết kế riêng cho các tác vụ máy học hiệu năng cao — bạn có thể đạt tăng tốc đáng kể trong cả giai đoạn huấn luyện và suy luận.
Nếu bạn thích hướng dẫn này và muốn tìm hiểu thêm về thế giới LLM, hãy học khóa Master Large Language Models (LLMs) Concepts để khám phá toàn bộ tiềm năng ứng dụng, phương pháp huấn luyện, cân nhắc đạo đức và nghiên cứu mới nhất. Nếu bạn quan tâm đến các LLM khác đang cạnh tranh với Gemma, hãy xem hướng dẫn Bắt đầu với Mixtral 8X22B để tìm hiểu thêm về mô hình mới của Mistral AI và kiến trúc mixture of experts thưa (SMoE).
Tìm hiểu thêm về các mô hình ngôn ngữ lớn
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
