
Curso
Conceitos de Grandes Modelos de Linguagem (LLMs)
2 h
109.8K
Este artigo é um tutorial completo sobre como fazer fine-tuning de grandes modelos de linguagem usando técnicas avançadas. Vamos passar por exemplos com Tensor Processing Units, uma técnica chamada LoRA e computação distribuída — tudo para ganhar velocidade e eficiência. Para ilustrar as técnicas, vamos acessar e ajustar os modelos Gemma, uma nova família de LLMs leves e de última geração criados pelo Google.
Ao final do tutorial, você terá as habilidades para fazer fine-tuning e rodar inferência em qualquer grande modelo de linguagem usando as TPUs disponíveis no Google Cloud. Para chegar lá, vamos cobrir os seguintes tópicos, nesta ordem:
Usando Gemma com TPUs: vamos configurar um ambiente no Kaggle para usar TPUs.
Configuração do modelo e inferência: vamos rodar o Gemma usando a biblioteca Keras em Python.
Fine-tuning: vamos ajustar o modelo Gemma com a técnica LoRA.
Treinamento distribuído: vamos realizar fine-tuning distribuído para ganhar eficiência de treinamento.
Se você está começando em IA e LLMs, vale a pena fazer a trilha de habilidades AI Fundamentals para se familiarizar com os termos usados neste tutorial.
Vamos começar!
 Logotipo do Google Gemma
O modelo Gemma do Google faz parte de uma família de grandes modelos de linguagem open-source e leves, desenvolvidos pelo Google e apresentados em 2024. O Gemma foi criado usando a mesma pesquisa e tecnologia dos modelos Google Gemini e, assim como o Gemini, é compatível com os principais frameworks de machine learning, como Keras e Pytorch. Ele está disponível em dois tamanhos, com 2B ou 7B parâmetros.
Enquanto o Gemini foi pensado principalmente para usuários finais por meio de apps e APIs, o Gemma é open-source para ampla modificação e integração por desenvolvedores. Os modelos Gemma também são menores, o que os torna mais portáteis e econômicos.
 Imagens de CPUs, GPUs e TPUs por Freepik e Flaticon
Vamos comparar as diferentes opções de hardware para machine learning para dar contexto. O hardware é categorizado em tipos distintos, cada um projetado para funções específicas de processamento e computação.
Unidades centrais de processamento: CPUs rodam sistemas operacionais em praticamente todos os dispositivos de computação. São conhecidas por processar tarefas de forma sequencial.
Unidades de processamento gráfico: GPUs processam múltiplas tarefas simultaneamente, ideais para renderização de gráficos.
Unidades de processamento de tensores: TPUs são processadores especializados desenvolvidos pelo Google para uso em machine learning. Foram projetadas para executar rapidamente os cálculos de matrizes críticos no treinamento e na execução de redes neurais.
A última categoria, as TPUs, é importante para este tutorial. TPUs são mais rápidas que GPUs no treinamento e na inferência de redes neurais profundas; elas também consomem menos energia. Por outro lado, o ecossistema de TPU é menos maduro, com menos ferramentas e frameworks disponíveis. Entre os frameworks disponíveis estão a Google Cloud Platform, o Colab e o Kaggle.
Componente | Uso principal | Aplicações em ML | Vantagens | Disponibilidade |
CPUs | Tarefas gerais | Modelos simples | Mais baratas, menor consumo | Amplamente disponíveis |
GPUs | Renderização gráfica | Deep learning, processamento de grandes volumes | Rápidas para cálculos complexos | Disponíveis comercialmente |
TPUs | Machine learning | Redes neurais profundas, operações de matriz em alta velocidade | Mais rápidas para ML, eficientes em energia | Não disponíveis fora de Google Cloud, Colab e Kaggle |
Tabela de comparação de hardware para machine learning
Os modelos Gemma foram projetados para ser altamente escaláveis e eficientes quando usados com configurações de computação distribuída, o que pode melhorar significativamente seu desempenho e velocidade, especialmente ao lidar com grandes volumes de dados e arquiteturas complexas de modelos.
A biblioteca Keras funciona muito bem nesse caso porque oferece suporte a treinamento distribuído de modelos Gemma, aproveitando uma implementação com múltiplos backends que inclui TensorFlow e PyTorch.
Nesta seção, vamos configurar nosso notebook no Kaggle para suportar TPUs, garantindo que todas as bibliotecas e dependências necessárias estejam instaladas para uma operação sem atritos. Em seguida, vamos carregar o modelo Gemma 2B ou 7B usando o pacote keras-nlp. Por fim, vamos colocar o modelo para executar tarefas, usando a capacidade de computação da TPU para processar e gerar respostas com eficiência.
Para preparar nosso ambiente, precisamos integrar a versão em Keras do modelo Gemma e trocar nosso acelerador de computação para TPU para ter melhor desempenho. Vamos instalar pacotes essenciais como keras-nlp, configurar o Keras para usar TensorFlow como backend e otimizar a alocação de memória da TPU para garantir um treinamento e execução fluídos.
Para preparar o ambiente, precisamos adicionar a implementação em Keras ao modelo Gemma. Especificamente, isso significa incorporar a versão compatível com Keras do modelo Gemma para garantir integração perfeita com as APIs do TensorFlow.
Para adicionar a implementação em Keras, siga estes passos:
Crie um novo notebook no Kaggle.
Navegue até a seção "Input" no painel da direita.
Clique em “+ Add Input” para adicionar a implementação em Keras do modelo Gemma.
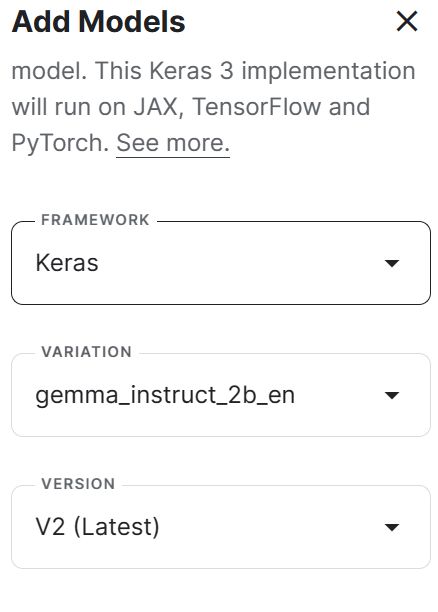 Adicionando a implementação em Keras ao modelo Gemma
Em seguida, vamos trocar o acelerador para TPU, ou seja, alternar nas configurações do notebook para usar a TPU e aproveitar seu poder de processamento para treinamento e inferência.
Para mudar o acelerador, siga estes passos. É normal levar alguns minutos para o ambiente recarregar.
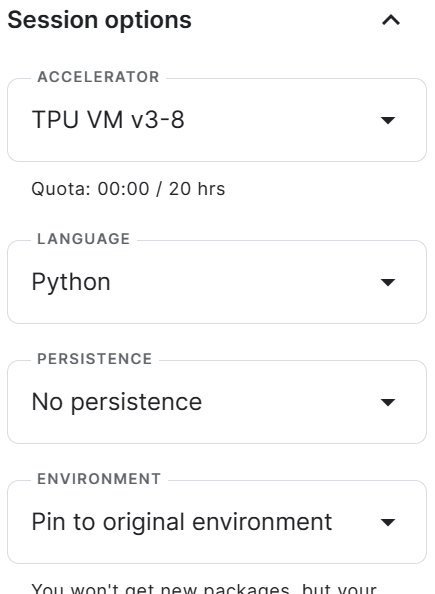 Definindo a TPU como acelerador
Agora vamos instalar os pacotes Python atualizados que usaremos para fine-tuning e inferência, incluindo TensorFlow e keras-nlp.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1Vamos definir o backend do Keras como JAX para acesso direto às TPUs. Você também pode testar com TensorFlow ou PyTorch.
Por fim, vamos pré-alocar a memória da TPU para otimizar o desempenho e evitar problemas de execução durante o uso do modelo. Aqui, pré-alocamos 100% da memória total da TPU para evitar fragmentação de memória no backend JAX.
import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"]="1.00"Vamos carregar os pacotes Python necessários para inferência do modelo.
import kerasimport keras_nlpEm seguida, carregamos nosso modelo e exibimos o resumo do modelo.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_instruct_2b_en")gemma_lm.summary()Conseguimos carregar o tokenizador e o modelo com um único comando. Isso é incrível porque mesmo o menor modelo Gemma tem 2,5 bilhões de parâmetros e um tamanho de 9,34 GB.
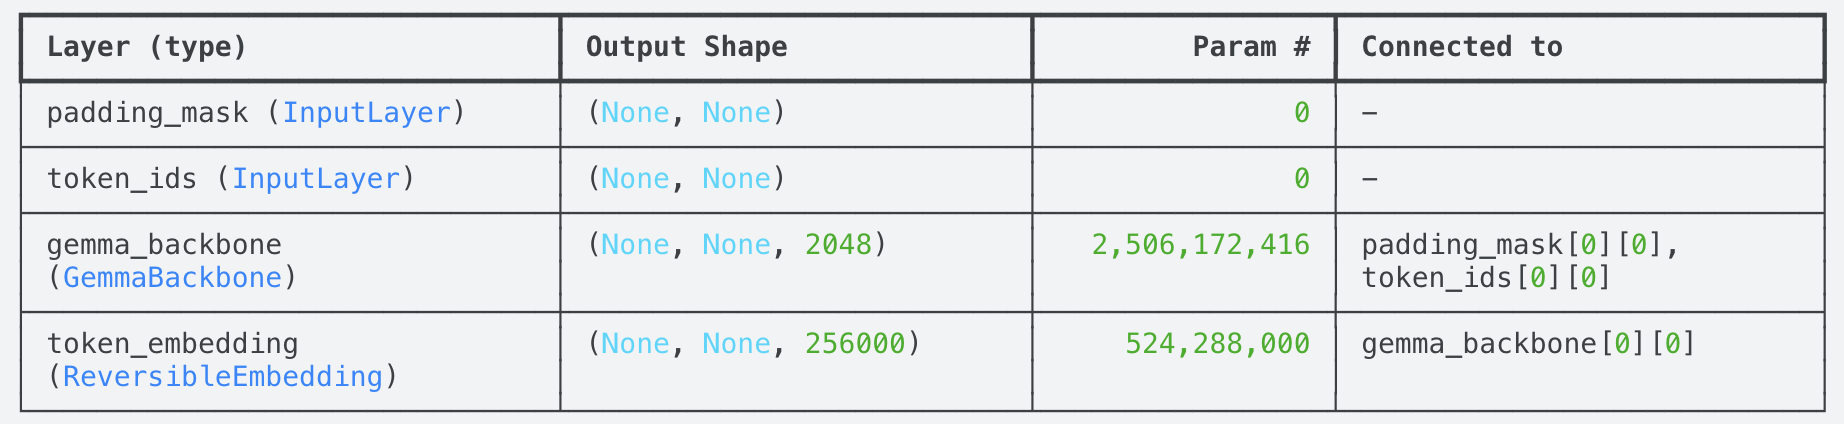 Resumo do modelo Gemma
Talvez você precise aguardar alguns minutos para rodar o notebook e aproveitar a performance super-rápida. As TPUs estão em alta demanda. Se você rodar o notebook à noite, pode ser que nem precise esperar.
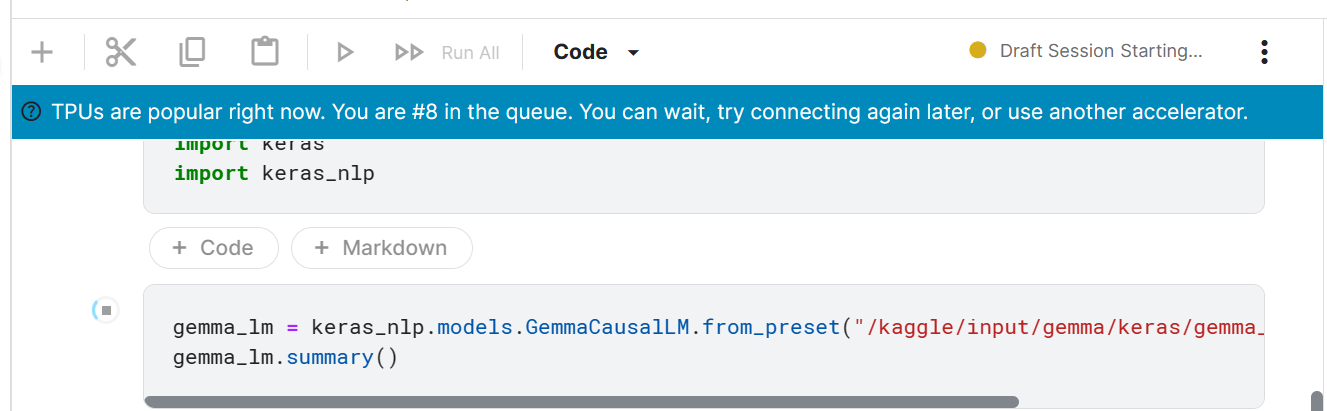 Fila de espera para acesso à TPU
Rodar inferência é o processo de usar nosso modelo para gerar saídas a partir de novas entradas. No nosso caso, vamos fornecer essas entradas como texto usando a função .generate(). A resposta vem na hora.
print(gemma_lm.generate("What is DataCamp?", max_length=30))What is DataCamp?DataCamp is a leading online data science education platform that empowers individuals and organizations to build data-driven careers. TheyTambém podemos testar a inferência em lote, ou seja, fornecer múltiplos prompts para gerar várias respostas. A saída vem em forma de lista.
print(gemma_lm.generate(["How far is the Sun from earth", "What is the Sun made of?"], max_length=30))['How far is the Sun from earth?\n\nThe Sun is about 149.6 million kilometers (93 million miles) away from', 'What is the Sun made of?\n\nThe Sun is primarily composed of hydrogen and helium. Hydrogen makes up about 73.4% of']Agora, vamos criar um template com instruções e respostas para guiar nosso modelo. Você pode adicionar um system prompt ou qualquer comando inicial extra para modificar a resposta gerada.
Vamos usar a função .format() para preencher o texto do template com os argumentos do usuário. Como resultado, teremos uma lista de passos para aprender Python.
template = "Instruction:\n{instruction}\n\nResponse:\n{response}"prompt = template.format( instruction="How do I start learning Python?", response="",)print(gemma_lm.generate(prompt, max_length=250))Instruction:How do I start learning Python?Response:**Step 1: Choose a learning path*** **Online Courses:** * DataCamp * Codecademy * Coursera * edX * Udemy* **Books:** * "Automate the Boring Stuff with Python" by Al Sweigart * "Python Crash Course" by Eric Matthes * "Head First Python" by Kathy Sierra and Bert Bates* **Video Tutorials.........Se estiver com dificuldade para carregar o modelo e gerar respostas usando TPUs, consulte este notebook do Kaggle: Accessing Gemma-instruct-2b-en using TPUs.
Se você já está se sentindo à vontade com o Gemma, aprofunde como aprimorá-lo com instruções personalizadas dando uma olhada no nosso tutorial Fine Tuning Google Gemma: Enhancing LLMs with Customized Instructions.
Agora vamos aprender a fazer fine-tuning do modelo Gemma usando um conjunto de dados público chamado OpenHermes. O dataset OpenHermes tem 242 mil linhas com duas colunas, uma para instruções e outra para respostas, todas geradas com o modelo GPT-4.
Como veremos, ajustar esse dataset todo levaria muito tempo, mesmo usando TPUs. Para ajudar no processo, vamos incorporar uma técnica chamada LoRA.
LoRA, ou Low-Rank Adaptation, foi projetada para tornar o fine-tuning de grandes modelos de linguagem mais eficiente e acessível. Ela enfrenta os desafios dos métodos tradicionais de fine-tuning, que costumam ser caros computacionalmente e exigentes em recursos.
Tecnicamente, o LoRA funciona congelando os pesos pré-treinados do modelo e introduzindo matrizes de baixo posto que modificam partes específicas da arquitetura. Ao focar nessas matrizes, o LoRA reduz os recursos computacionais necessários, viabilizando o fine-tuning de modelos grandes em hardwares menos potentes.
De forma semelhante à configuração do ambiente do modelo que fizemos antes, vamos definir o backend do Keras e a pré-alocação de memória. Também podemos usar a função jax. devices() para verificar a disponibilidade de dispositivos TPU.
import osimport jaxos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"jax.devices()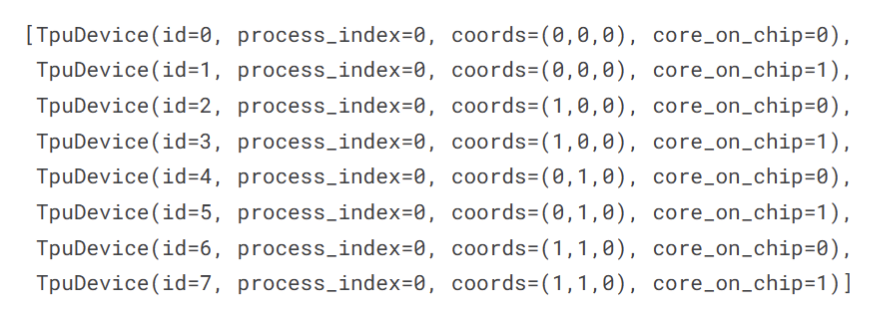
Número de dispositivos de computação
Carregamos o modelo e exibimos seu resumo. Temos 2,5B de parâmetros treináveis.
import kerasimport keras_nlpgemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_2b_en")gemma_lm.summary()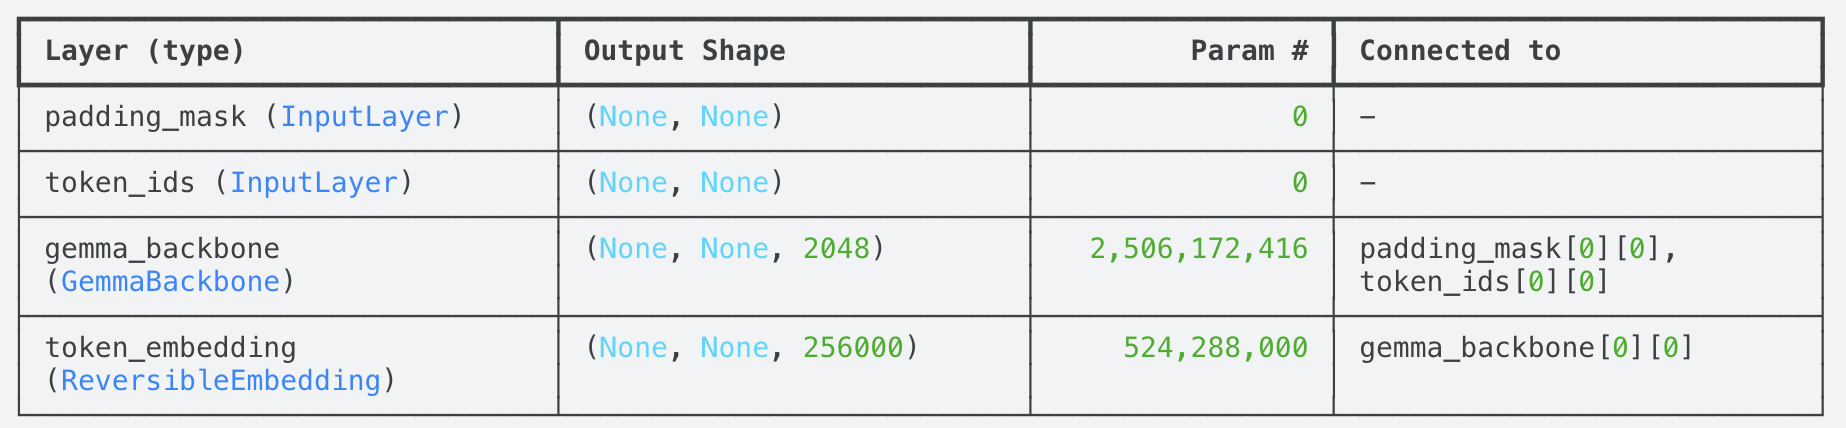 Resumo do modelo Gemma
Em seguida, carregamos o dataset no notebook. O processo é semelhante ao de adicionar o modelo. Siga estes passos:
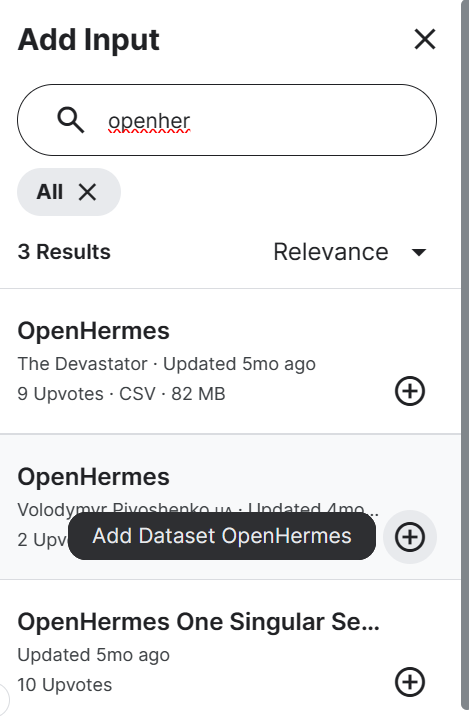
Adicionando o dataset OpenHermes
Agora usamos a biblioteca pandas para ler o dataset e exibir as 5 primeiras linhas. Vemos que temos 2 colunas, uma de instruções e outra de saída.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')df.head()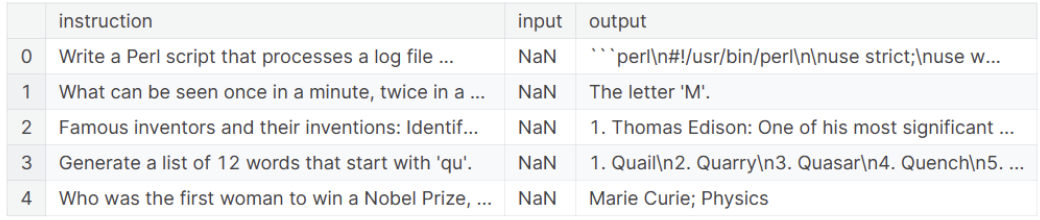
Dataset OpenHermes
Agora que carregamos nosso modelo e nosso dataset, precisamos passar um conjunto de dados para o modelo. Para isso, devemos converter o dataset em uma lista de strings no formato instrução e resposta.
Treinar o dataset completo levará quase 23 horas, mesmo em TPUs. Por isso, vamos selecionar apenas as 1.000 primeiras amostras da lista para reduzir o tempo de treinamento.
template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]data = data[:1000]print(data[0])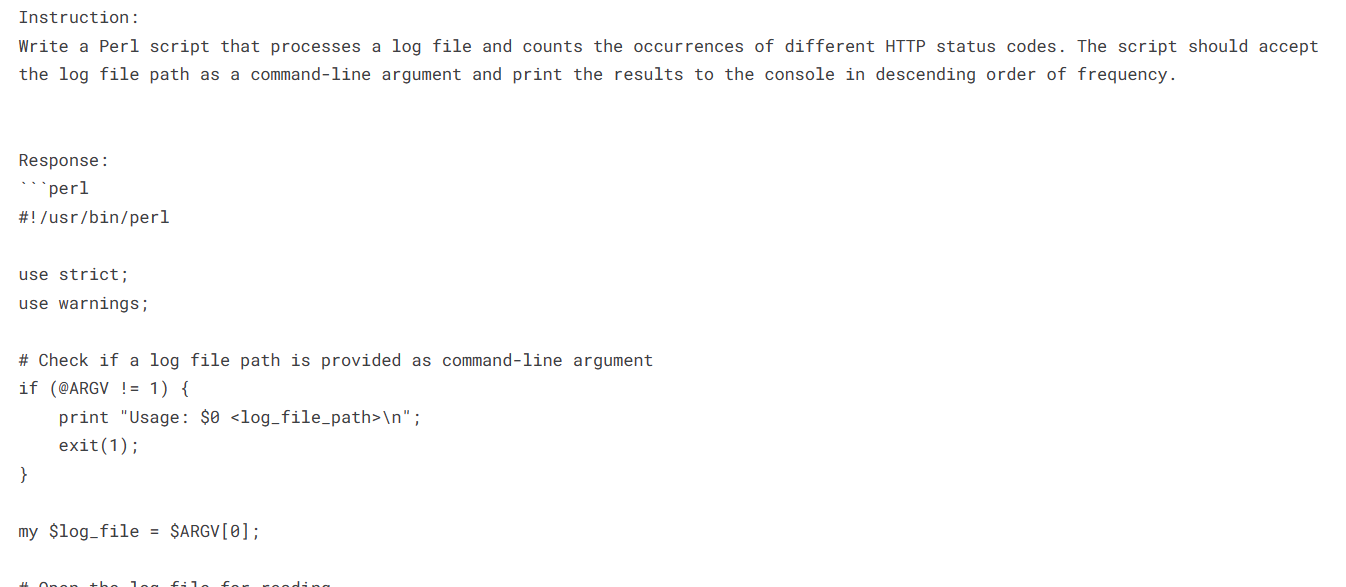
Primeira amostra do dataset OpenHermes
Vamos primeiro criar uma linha de base para comparar o sucesso ao usar LoRA. Para isso, vamos gerar a resposta usando a função template.format().
Olhando de perto, a saída a seguir mostra que a resposta base não é muito detalhada. O Gemma até começa a se repetir após o fim da primeira resposta. Não é um ótimo resultado, mas serve como uma boa ilustração da necessidade de ajustar nosso modelo para fornecer respostas melhores.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-dayAgora vamos melhorar nosso modelo com LoRA, que reduz o número de parâmetros treináveis para tarefas downstream.
No nosso exemplo, faremos o fine-tuning com LoRA rank 4, que é o menor posto computacionalmente eficiente. LoRA rank 8 ou 16 são opções se você quiser melhorar o desempenho do modelo. Leia o guia Fine-Tuning LLaMA 2 para saber mais sobre LoRA e quantização.
Em seguida, vamos especificar o otimizador, a função de perda e a métrica de acurácia a usar.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()Nossos parâmetros treináveis caíram significativamente de 2,5 bilhões para 1,3 milhão. E o tamanho da camada adaptadora é de apenas 5,2 MB.
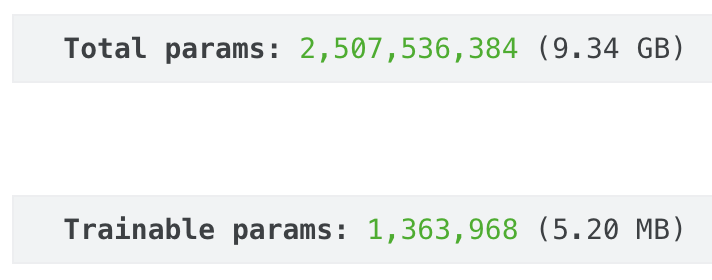
Modelo Gemma: parâmetros totais versus treináveis
Agora vamos ajustar nossos dados ao modelo. Aqui escolhemos 1 época (epoch) e batch size 1. Você pode melhorar o desempenho treinando o dataset completo por pelo menos 5 épocas.
gemma_lm.fit(data, epochs=1, batch_size=1)Vamos testar o mesmo prompt usado no experimento base para ver se nosso modelo melhorou. Desta vez, em vez de respostas de uma linha e repetição, o modelo fornece um roteiro detalhado de viagem para as Bahamas.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1: Arrive in Nassau, BahamasUpon arrival in Nassau, you will be greeted by a local guide who will take you on a tour of the city. Visit the famous Straw Market, where you can shop for souvenirs and local crafts. Enjoy lunch at a local restaurant before heading to the Atlantis Resort for a day of fun and relaxation. Spend the afternoon exploring the resort's world-class amenities, including the Aquaventure Water Park, Dolphin Cay, and the massive marine habitat, The Dig.Day 2: Explore Paradise IslandOn day 2, you will explore Paradise Island, home to the world-famous Atlantis Resort. Visit the famous Atlantis Casino and enjoy a round of blackjack or roulette. Take a stroll along the beach and enjoy the crystal-clear waters of the Atlantic Ocean. Visit the Dolphin Cay, where you can swim with dolphins and other marine animals.Day 3: Snorkel at Cabbage BeachOn day 3, you will head to Cabbage Beach, a secluded beach located on Paradise Island. Snorkel in the crystal-clear waters and explore the coral reefs. Enjoy a delicious lunch at a local restaurant before heading back to Nassau.Você pode salvar os pesos do modelo para inferência e fazer o deploy em produção.
gemma_lm.save_weights('gemma_2b_openhermes.weights.h5')O tamanho total do nosso modelo ajustado é 10,04 GB.
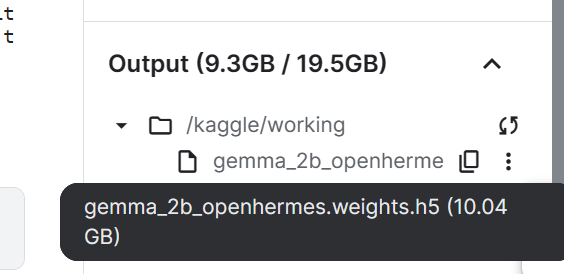 Arquivo do modelo Gemma ajustado e salvo
Se estiver com dificuldade para fazer o fine-tuning, consulte este notebook do Kaggle: Finetuning Gemma using TPUs
Para fechar, vamos observar o fine-tuning distribuído. Ele é obtido por meio de paralelismo de modelo, que distribui os pesos de um único modelo entre vários dispositivos, permite escalabilidade horizontal e acelera o treinamento.
Nesta parte, vamos reduzir significativamente o tempo de treinamento em um modelo grande. Especificamente, vamos usar Keras com backend JAX para ajustar o Gemma com LoRA e treinamento distribuído em TPUs.
Aqui iniciamos um novo notebook no Kaggle e instalamos as bibliotecas necessárias. Depois, definimos o backend do Keras e pré-alocamos memória.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"Primeiro, vamos criar um DeviceMesh para ajudar a carregar pesos e tensores do modelo distribuídos em vários dispositivos TPU. Ele permite paralelismo de dados e de modelo, possibilitando escalar LLMs com eficiência em múltiplos aceleradores.
Crie um DeviceMesh com formato (1, 8), para que os pesos do modelo sejam repartidos entre as 8 TPUs.
import kerasimport keras_nlpdevice_mesh = keras.distribution.DeviceMesh( (1, 8), ["batch", "model"], devices=keras.distribution.list_devices())Em seguida, vamos criar um layout map especificando como os pesos e tensores devem ser fragmentados ou replicados usando RegEx.
Tenha em mente os seguintes pontos:
Pesos que correspondam a token_embedding/embeddings serão compartilhados.
Use RegEx para corresponder às matrizes query, key e value na camada attention do decoder, e às camadas attention_output, ffw_gating e ffw_linear.
Os tensores correspondentes são fragmentados usando o DeviceMesh, e o restante será totalmente replicado.
model_dim = "model"layout_map = keras.distribution.LayoutMap(device_mesh)layout_map["token_embedding/embeddings"] = (None, model_dim)layout_map["decoder_block.*attention.*(query|key|value).*kernel"] = ( None, model_dim, None,)layout_map["decoder_block.*attention_output.*kernel"] = (None, None, model_dim)layout_map["decoder_block.*ffw_gating.*kernel"] = (model_dim, None)layout_map["decoder_block.*ffw_linear.*kernel"] = (None, model_dim)Agora vamos ativar o paralelismo de modelo usando device_mesh e layout_map.
model_parallel = keras.distribution.ModelParallel( device_mesh, layout_map, batch_dim_name="batch")keras.distribution.set_distribution(model_parallel)Depois de configurar o paralelismo de modelo, carregamos nosso modelo.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_7b_en")gemma_lm.summary()Desta vez, como estamos usando o Gemma 7B, vemos 8,5 bilhões de parâmetros treináveis.
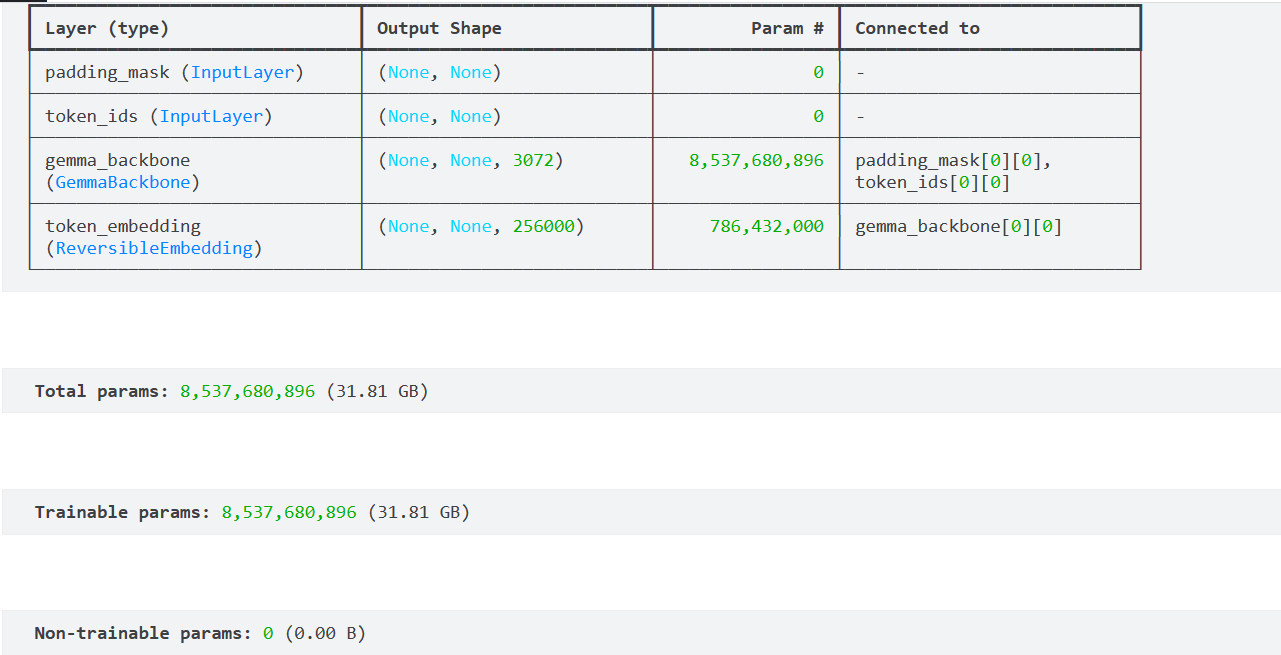 Resumo do modelo Gemma 7B
Para verificar se o modelo foi devidamente fragmentado, vamos imprimir o path, o shape e o spec dos pesos da camada decoder_block_1.
decoder_block_1 = gemma_lm.backbone.get_layer('decoder_block_1')print(type(decoder_block_1))for variable in decoder_block_1.weights: print(f'{variable.path:<58} {str(variable.shape):<16} {str(variable.value.sharding.spec)}')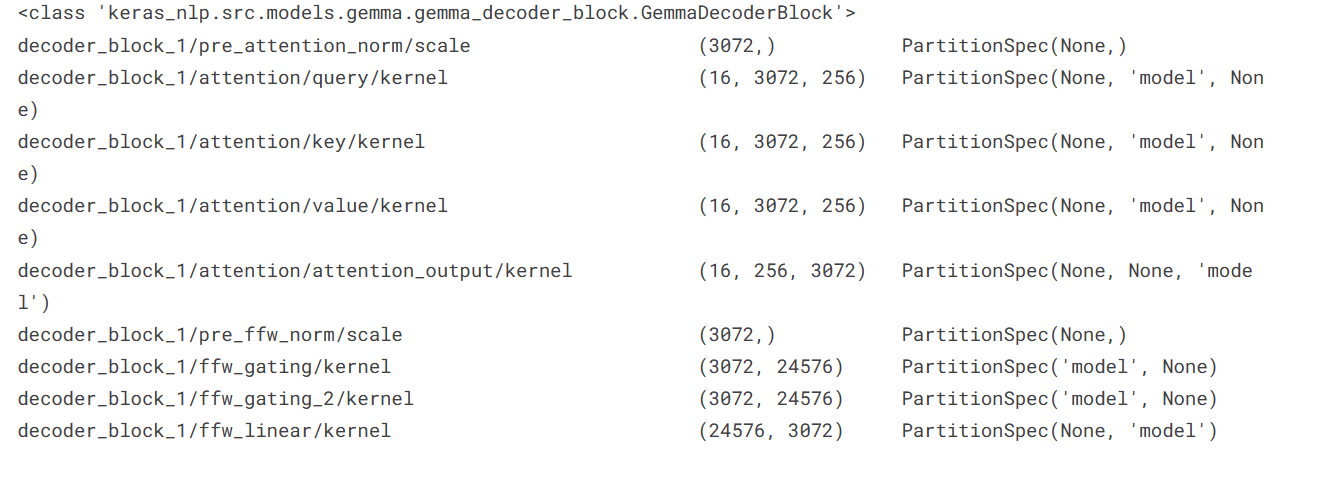
Bloco do decoder
Vamos carregar o dataset OpenHermes. Mais uma vez, convertemos o dataframe em uma lista de strings usando o template de instrução e resposta e, para acelerar o treinamento, selecionamos apenas as 1.000 primeiras amostras.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')# Format and convert the dataframe into a list of strings.template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]# Select a subset of the dataset. data = data[:1000]Agora vamos gerar a resposta da linha de base fornecendo o prompt formatado. Curiosamente, a resposta é ainda pior do que a do modelo menor, mas vamos em frente.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256)) 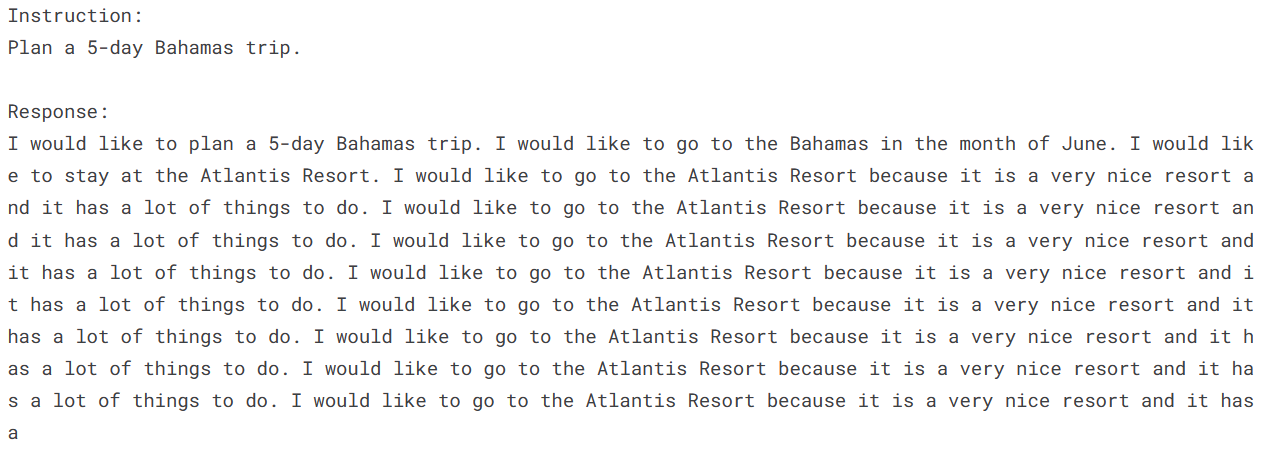 Resultado da inferência antes do fine-tuning
Vamos compilar o modelo usando as mesmas configurações, rank do LoRA, otimizador, função de perda e métrica de acurácia. Agora temos 11 milhões de parâmetros treináveis com tamanho de 42,22 MB.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()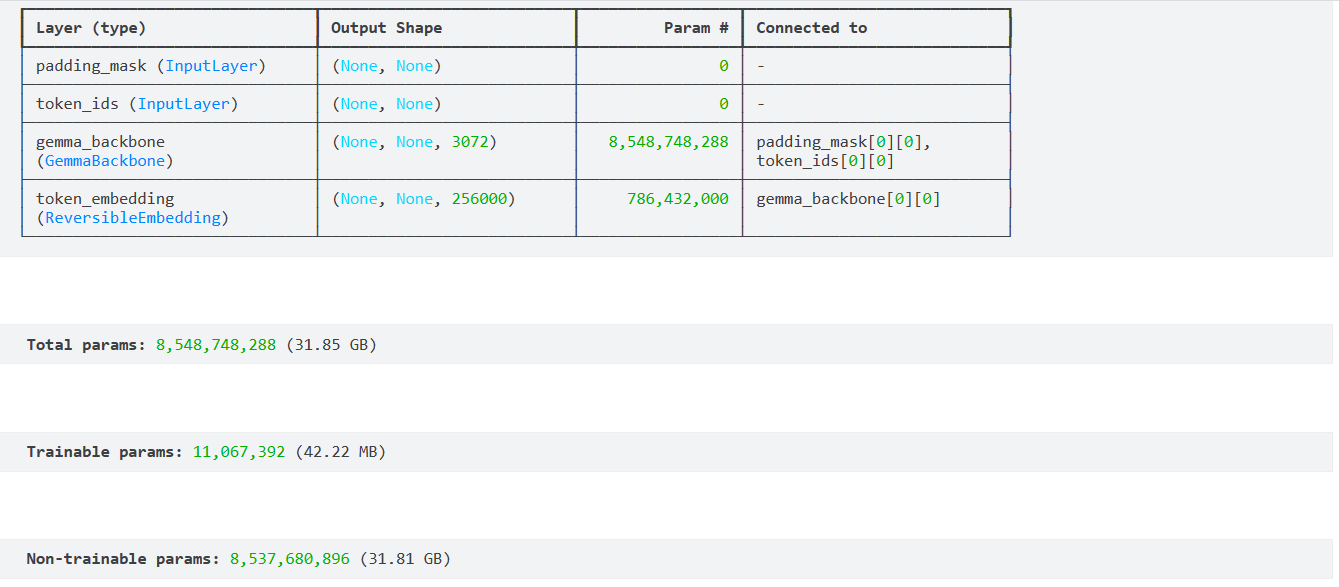 Resumo do modelo Gemma 7B com LoRA
Levamos 305 segundos para fazer o fine-tuning de uma época — um ótimo tempo considerando o tamanho do modelo.
gemma_lm.fit(data, epochs=1, batch_size=1)
Se você acha o fine-tuning desafiador, pode aprender a usar a API da OpenAI e seguir um guia passo a passo para fazer fine-tuning do GPT-4.
Vamos gerar a resposta e comparar com o resultado da linha de base.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))O modelo ajustado ficou excelente. Ele gerou uma resposta com uma lista do que fazer para aproveitar sua viagem de cinco dias às Bahamas.
Observação: você pode desativar o LoRA para um ajuste de todos os parâmetros com paralelismo de modelo — mais lento, porém mais preciso.
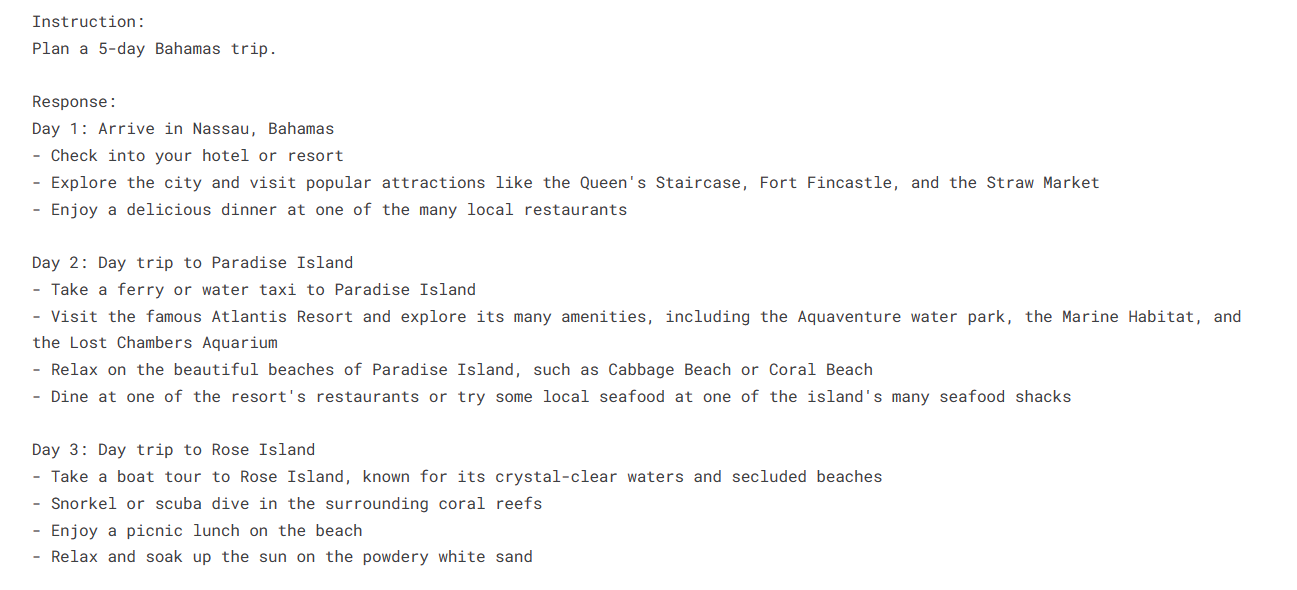 Resultado da inferência após o fine-tuning
gemma_lm.save_weights('gemma_7b_openhermes.weights.h5')Mais uma vez, se você estiver com problemas no fine-tuning distribuído, use este notebook do Kaggle como recurso adicional: Accessing Gemma-instruct-2b-en using TPUs.
Neste tutorial, aprendemos sobre TPUs e como usá-las para acelerar a geração de respostas de LLMs. Além disso, aprendemos a fazer fine-tuning de modelos Gemma no dataset OpenHermes usando TPUs e treinamento distribuído.
Fazer o fine-tuning de LLMs em TPUs e usar paralelismo de modelo para aprendizado distribuído são formas importantes de acelerar o tempo de treinamento. Com aprendizado distribuído, você consegue ajustar até modelos muito grandes, como o Gemma 7B. Ao aproveitar as TPUs, que são projetadas especificamente para tarefas de machine learning de alta performance, é possível obter ganhos significativos tanto nas fases de treinamento quanto de inferência.
Se você curtiu o tutorial e quer aprender mais sobre o universo dos grandes modelos de linguagem, faça o curso Master Large Language Models (LLMs) Concepts para descobrir todo o potencial de aplicações de LLMs, metodologias de treinamento, considerações éticas e as pesquisas mais recentes. Se você tiver interesse em outros grandes modelos que concorrem com o Gemma, confira nosso tutorial Getting Started With Mixtral 8X22B para saber mais sobre o novo modelo da Mistral AI e sua arquitetura SMoE (sparse mixture of experts).
Saiba mais sobre grandes modelos de linguagem
Curso
Curso
Programa
Tutorial
Zoumana Keita
8 min
Tutorial
Josep Ferrer
11 min
Tutorial
Moez Ali
11 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
12 min







