
Cursus
Concepten van Large Language Models (LLMs)
2 uur
113.3K
Dit artikel is een uitgebreide tutorial over het fijnstemmen van large language models met geavanceerde technieken. We lopen voorbeelden door met Tensor Processing Units, een techniek genaamd LoRA en gedistribueerd rekenen — allemaal voor extra snelheid en efficiëntie. Ter illustratie krijgen we toegang tot en stemmen we Gemma-modellen fijn, een nieuwe familie lichtgewicht, state-of-the-art LLM’s van Google.
Aan het eind van de tutorial kun je elk large language model fijnstemmen en inference draaien met de TPU’s die beschikbaar zijn op Google Cloud. We behandelen daarvoor in deze volgorde:
Gemma gebruiken met TPU’s: We richten een Kaggle-omgeving in om TPU’s te gebruiken.
Modelsetup en inference: We draaien Gemma met de Keras-bibliotheek in Python.
Fijnstemmen: We stemmen het Gemma-model fijn met een techniek genaamd LoRA.
Gedistribueerde training: We voeren gedistribueerd fijnstemmen uit voor trainingsefficiëntie.
Als je nieuw bent met AI en LLM’s, overweeg dan de uitgebreide skill track AI Fundamentals om vertrouwd te raken met de termen in deze tutorial.
Laten we beginnen!
 Google Gemma-logo
Google’s Gemma-model maakt deel uit van een familie open-source en lichtgewicht large language models die in 2024 door Google zijn geïntroduceerd. Gemma is gebouwd met hetzelfde onderzoek en dezelfde technologie als Google Gemini-modellen en is, net als Gemini, compatibel met grote machinelearningframeworks zoals Keras en Pytorch. Het is beschikbaar in twee groottes, met 2B of 7B parameters.
Waar Gemini vooral bedoeld was voor eindgebruikers via apps en API’s, is Gemma open source zodat ontwikkelaars het breed kunnen aanpassen en integreren. Gemma-modellen zijn ook kleiner, waardoor ze draagbaarder en kostenefficiënter zijn.
 Afbeeldingen van CPU’s, GPU’s, TPU’s door Freepik en Flaticon
Laten we de verschillende hardware-opties voor machine learning vergelijken voor wat context. De hardware is onderverdeeld in typen die elk zijn ontworpen voor specifieke taken in verwerking en rekenwerk.
Central Processing Units: CPU’s draaien besturingssystemen op vrijwel alle computers. Ze staan bekend om het sequentieel verwerken van taken.
Graphics Processing Units: GPU’s verwerken meerdere taken tegelijk en zijn daardoor ideaal voor graphicsrendering.
Tensor Processing Units: TPU’s zijn gespecialiseerde processors, ontwikkeld door Google voor machine learning. Ze zijn ontworpen om de matrixberekeningen die cruciaal zijn voor het trainen en draaien van neurale netwerken razendsnel uit te voeren.
De laatste categorie, TPU’s, is belangrijk voor deze tutorial. TPU’s zijn sneller dan GPU’s bij training en inference van deep neural networks en verbruiken ook minder stroom. Nadeel is dat het TPU-ecosysteem minder volwassen is, met minder tools en frameworks. Beschikbare opties zijn onder meer Google Cloud Platform, Colab en Kaggle.
Component | Primair gebruik | ML-toepassingen | Voordelen | Beschikbaarheid |
CPU’s | Algemene taken | Eenvoudige modellen | Goedkoper, gebruikt minder stroom | Breed beschikbaar |
GPU’s | Graphicsrendering | Deep learning, grootschalige dataverwerking | Snel bij complexe berekeningen | Commercieel beschikbaar |
TPU’s | Machine learning | Diepe neurale netwerken, snelle matrixbewerkingen | Snelst voor ML, energiezuinig | Niet beschikbaar behalve op Google Cloud, Colab en Kaggle |
Vergelijkingstabel machine-learninghardware
Gemma-modellen zijn ontworpen om zeer schaalbaar en efficiënt te zijn met gedistribueerde omgevingen, wat hun prestaties en snelheid aanzienlijk kan verbeteren, vooral bij grote hoeveelheden data en complexe modelarchitecturen.
De Keras-bibliotheek werkt hier goed omdat die ondersteuning biedt voor gedistribueerde training van Gemma-modellen dankzij een multibackend-implementatie, waaronder TensorFlow en PyTorch.
In deze sectie configureren we ons Kaggle-notebook voor TPU-ondersteuning, zodat alle benodigde libraries en dependencies geïnstalleerd zijn. Vervolgens laden we het Gemma 2B- of 7B-model met het pakket keras-nlp. Tot slot zetten we het model in om taken uit te voeren en benutten we de rekenkracht van de TPU om reacties efficiënt te verwerken en te genereren.
Om onze omgeving klaar te maken, integreren we de Keras-versie van het Gemma-model en schakelen we onze rekenaccelerator naar TPU voor betere prestaties. We installeren essentiële pakketten zoals keras-nlp, configureren Keras om TensorFlow als backend te gebruiken en optimaliseren de TPU-geheugentoewijzing voor soepele training en uitvoering.
Om onze omgeving voor te bereiden, moeten we een Keras-implementatie aan het Gemma-model toevoegen. Concreet betekent dit dat we de Keras-compatibele versie van het Gemma-model opnemen zodat het soepel samenwerkt met TensorFlow-API’s.
Om de Keras-implementatie toe te voegen, volgen we deze stappen:
Maak een nieuw notebook in Kaggle.
Navigeer naar de sectie "Input" in het rechterpaneel.
Klik op “+ Add Input” om de Keras-implementatie van het Gemma-model toe te voegen.
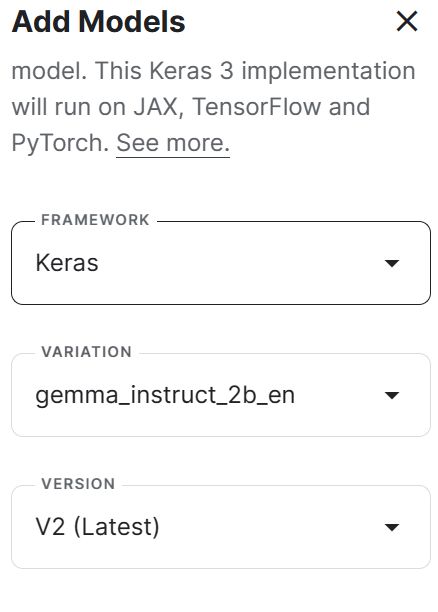 Keras-implementatie toevoegen aan het Gemma-model
Vervolgens moeten we de accelerator wijzigen naar TPU; we schakelen de rekenaccelerator in de notebookinstellingen om naar TPU om de rekenkracht voor training en inference te benutten.
Om de accelerator te wijzigen, volgen we deze stappen. Het is normaal als het een paar minuten duurt voordat de omgeving opnieuw is geladen.
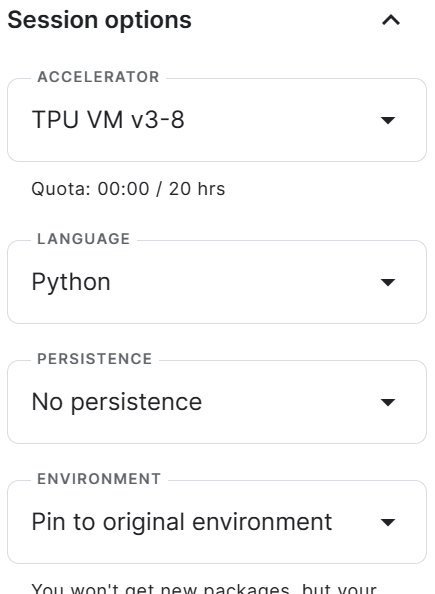 TPU als accelerator instellen
We installeren nu de bijgewerkte Python-pakketten die we gebruiken voor fijnstemmen en inference, waaronder TensorFlow en keras-nlp.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1We stellen de Keras-backend in met JAX voor naadloze toegang tot de TPU’s. Je kunt ook TensorFlow of PyTorch proberen.
Tot slot pre-alloceren we het TPU-geheugen om prestaties te optimaliseren en runtimeproblemen tijdens de uitvoering te voorkomen. Hier reserveren we 100% van het totale TPU-geheugen om geheugenfragmentatie op de JAX-backend te vermijden.
import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"]="1.00"We laden de benodigde Python-pakketten voor modelinference.
import kerasimport keras_nlpVervolgens laden we ons model en tonen we de modeloverzicht.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_instruct_2b_en")gemma_lm.summary()We hebben de tokenizer en het model met één opdracht geladen. Dat is indrukwekkend, want zelfs het kleinste Gemma-model heeft 2,5 miljard parameters en een omvang van 9,34 GB.
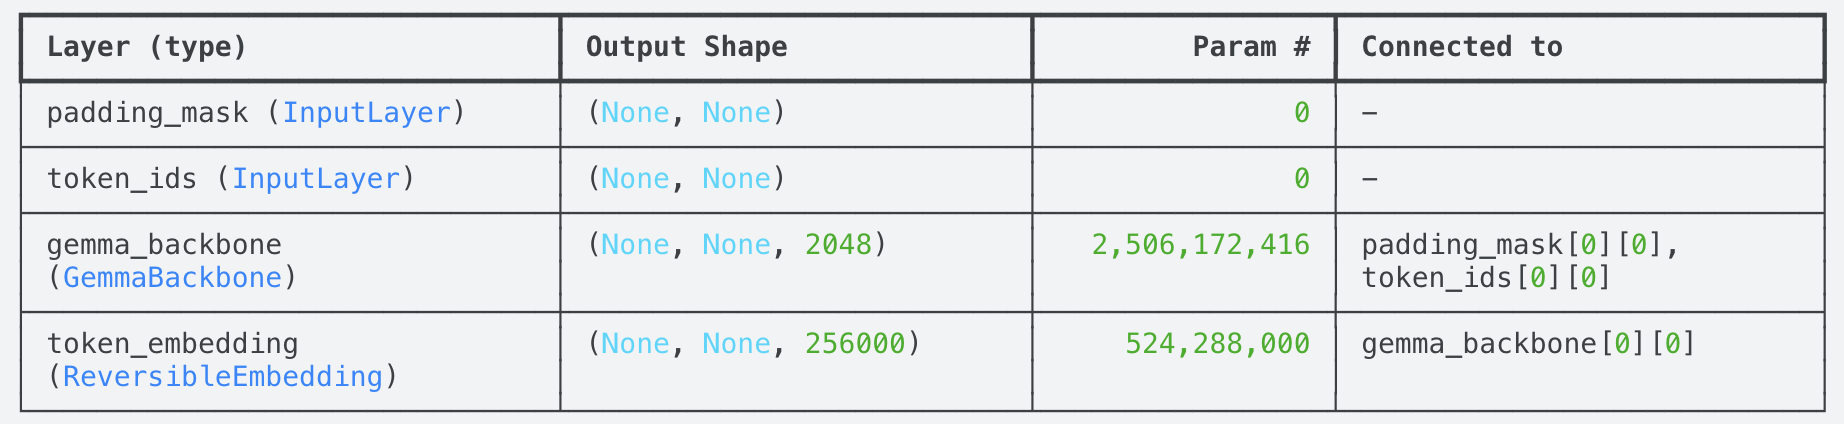 Samenvatting Gemma-model
Het kan een paar minuten duren voordat je het notebook kunt draaien en de supersnelle performance ervaart. TPU’s zijn erg gewild. Als je ’s nachts draait, hoef je mogelijk niet te wachten.
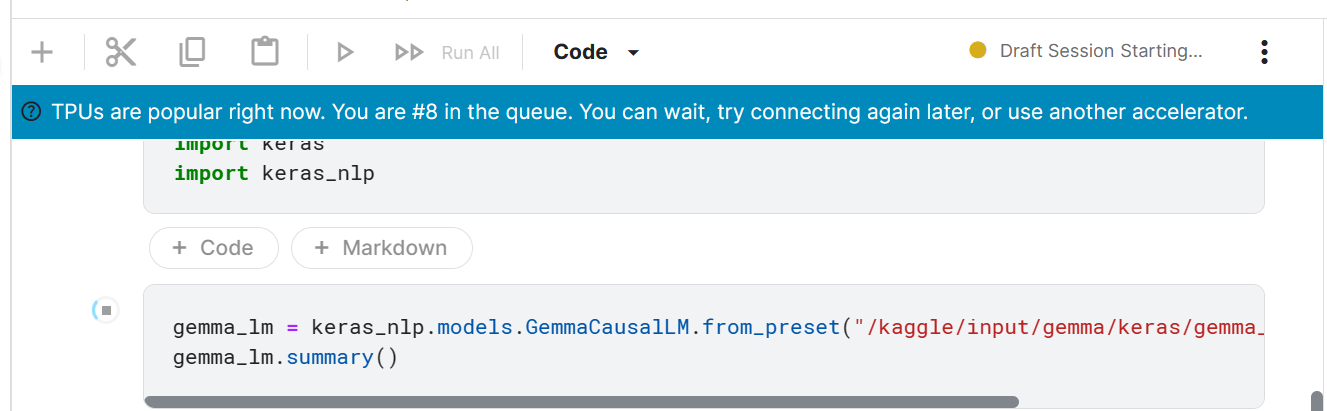 In de wachtrij voor TPU-toegang
Inference draaien betekent ons model gebruiken om outputs te genereren op basis van nieuwe, niet eerder geziene inputs. In onze context geven we deze inputs als tekst via de functie .generate(). De respons verschijnt direct.
print(gemma_lm.generate("What is DataCamp?", max_length=30))What is DataCamp?DataCamp is a leading online data science education platform that empowers individuals and organizations to build data-driven careers. TheyWe kunnen ook batchinference proberen: we geven meerdere prompts om meerdere reacties te genereren. De output komt dan als lijst.
print(gemma_lm.generate(["How far is the Sun from earth", "What is the Sun made of?"], max_length=30))['How far is the Sun from earth?\n\nThe Sun is about 149.6 million kilometers (93 million miles) away from', 'What is the Sun made of?\n\nThe Sun is primarily composed of hydrogen and helium. Hydrogen makes up about 73.4% of']Vervolgens maken we een sjabloon met instructies en reacties om ons model te sturen. Je kunt een systeemprompt of een extra beginopdracht toevoegen om de gegenereerde output te beïnvloeden.
We gebruiken de functie .format() om de sjabloontekst te vullen met gebruikersargumenten. Daarmee krijgen we een lijst met stappen om Python te leren.
template = "Instruction:\n{instruction}\n\nResponse:\n{response}"prompt = template.format( instruction="How do I start learning Python?", response="",)print(gemma_lm.generate(prompt, max_length=250))Instruction:How do I start learning Python?Response:**Step 1: Choose a learning path*** **Online Courses:** * DataCamp * Codecademy * Coursera * edX * Udemy* **Books:** * "Automate the Boring Stuff with Python" by Al Sweigart * "Python Crash Course" by Eric Matthes * "Head First Python" by Kathy Sierra and Bert Bates* **Video Tutorials.........Heb je moeite om het model te laden en een reactie te genereren met TPU’s, bekijk dan dit Kaggle-notebook: Accessing Gemma-instruct-2b-en using TPUs.
Voel je je inmiddels comfortabel met Gemma, leer dan meer over het verbeteren van Gemma met aangepaste instructies in onze tutorial Fine Tuning Google Gemma: Enhancing LLMs with Customized Instructions.
Laten we nu leren hoe we het Gemma-model fijnstemmen met een openbare dataset genaamd OpenHermes. De OpenHermes-dataset heeft 242.000 rijen met twee kolommen: één voor instructies en één voor reacties, allemaal gegenereerd met het GPT-4-model.
Zoals we zullen zien, kost het fijnstemmen van deze dataset veel tijd, zelfs met TPU’s. Daarom gebruiken we een techniek genaamd LoRA.
LoRA, of Low-Rank Adaptation, is ontwikkeld om het fijnstemmen van large language models efficiënter en toegankelijker te maken. Het pakt de uitdagingen aan van traditionele methoden, die vaak veel rekenkracht en middelen vergen.
Technisch gezien bevriest LoRA de voorgetrainde gewichten van een model en introduceert het laag-rangmatrices die specifieke delen van de architectuur aanpassen. Door zich te richten op deze laag-rangmatrices minimaliseert LoRA de benodigde rekenbronnen, waardoor fijnstemmen van grote modellen op minder krachtige hardware haalbaar wordt.
Net als bij de modelsetup eerder, stellen we de Keras-backend en geheugenpre-allocatie in. We kunnen ook de functie jax. devices() gebruiken om de beschikbaarheid van TPU-apparaten te controleren.
import osimport jaxos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"jax.devices()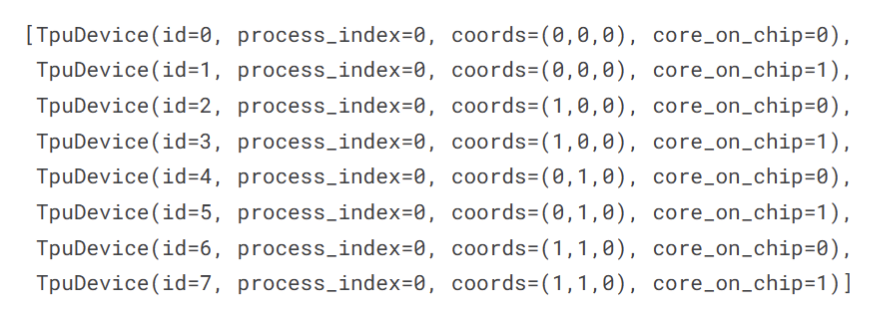
Aantal compute-apparaten
We laden het model en tonen de samenvatting. We hebben 2,5B trainbare parameters.
import kerasimport keras_nlpgemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_2b_en")gemma_lm.summary()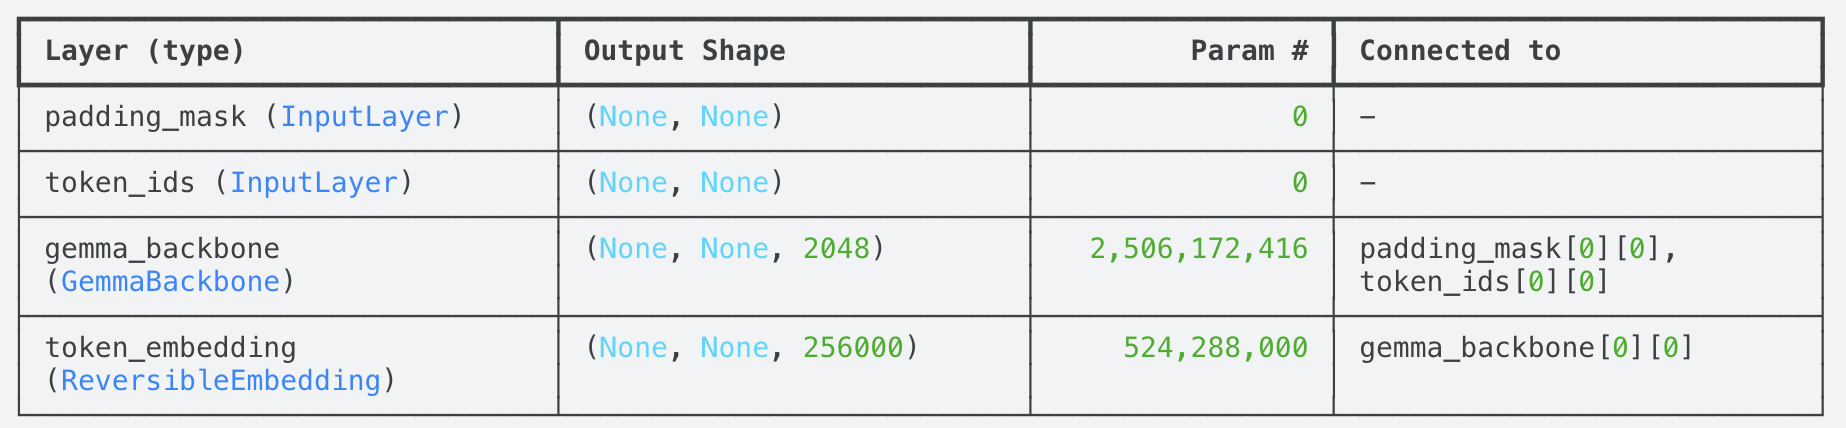 Samenvatting Gemma-model
Vervolgens laden we de dataset in het notebook. Het proces lijkt op het toevoegen van het model. We volgen deze stappen:
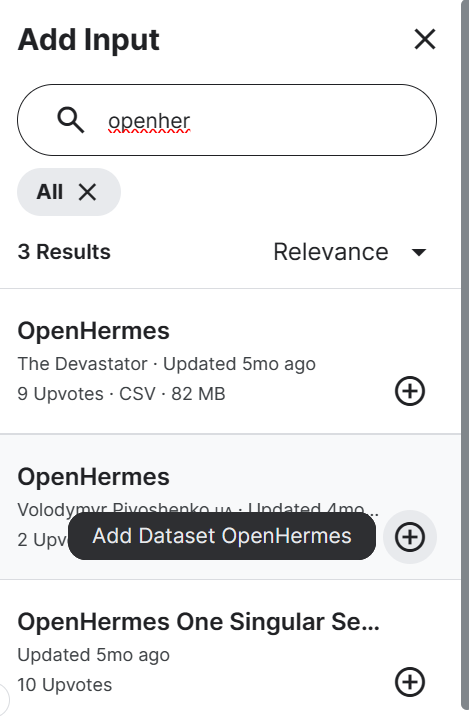
OpenHermes-dataset toevoegen
We gebruiken nu de pandas-bibliotheek om de dataset te lezen en de bovenste 5 rijen te tonen. We zien twee kolommen: één voor instruction en één voor output.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')df.head()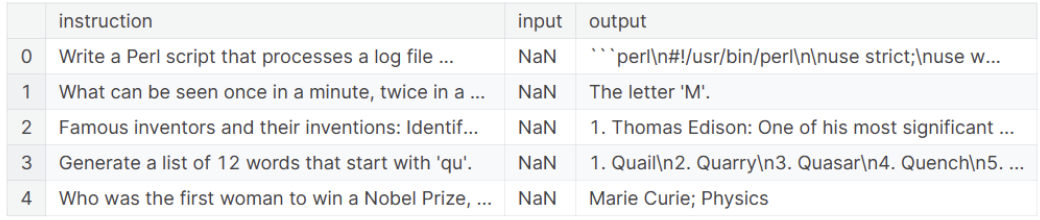
OpenHermes-dataset
Nu we ons model en onze dataset hebben geladen, moeten we een dataset aan ons model doorgeven. Daarvoor converteren we onze dataset naar een lijst met strings in het instruction-en-responseformaat.
Het volledige trainen van de dataset zou bijna 23 uur duren, zelfs op TPU’s. Daarom selecteren we alleen de bovenste 1.000 voorbeelden om de trainingstijd te verkorten.
template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]data = data[:1000]print(data[0])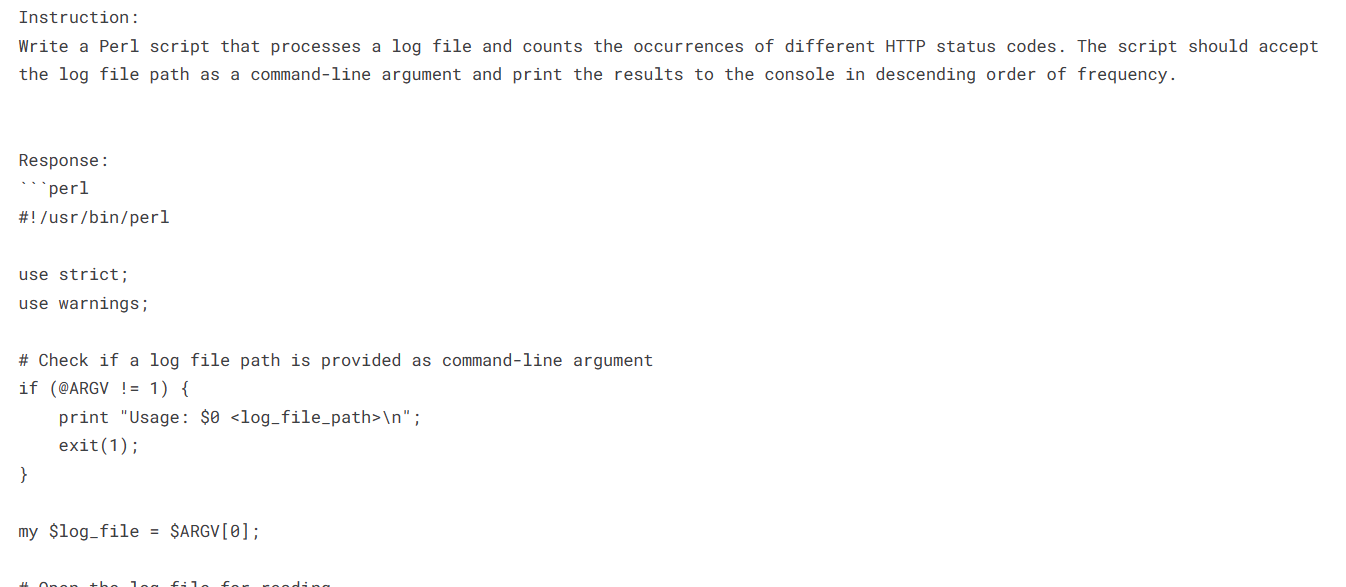
OpenHermes-dataset eerste voorbeeld
Laten we eerst een baseline maken waartegen we het effect van LoRA kunnen vergelijken. Hiervoor genereren we de reactie met de functie template.format().
Als we goed lezen, zie je dat de baseline-reactie niet erg gedetailleerd is. Gemma begint zelfs te herhalen na het einde van de eerste reactie. Dat is geen geweldig resultaat, maar het illustreert wel waarom we het model moeten fijnstemmen voor betere antwoorden.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-dayWe gaan ons model verbeteren met LoRA, dat het aantal trainbare parameters voor downstreamtaken terugbrengt.
In ons voorbeeld stemmen we ons model fijn met LoRA-rank 4, de kleinste rang die nog rekenkundig efficiënt is. LoRA-rank 8 of 16 zijn opties als je de modelprestaties verder wilt verbeteren. Lees de gids Fine-Tuning LLaMA 2 om meer te leren over LoRA en kwantisatie.
Vervolgens specificeren we de optimizer, verliesfunctie en accuracymetriek.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()Onze trainbare parameters zijn sterk gedaald van 2,5 miljard naar 1,3 miljoen. En de grootte van de adapterlaag is slechts 5,2 MB.
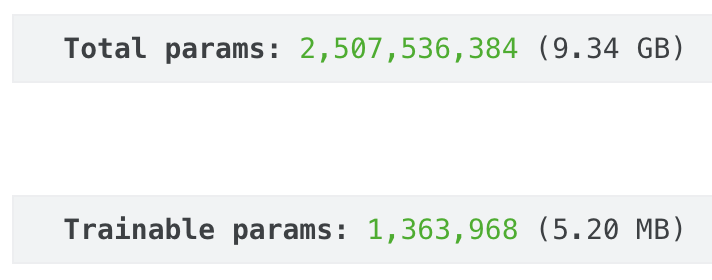
Gemma-model: totaal versus trainbare parameters
We passen nu onze data op het model. Hier kiezen we 1 epoch en een batchgrootte van 1. Je kunt de prestaties verbeteren door de volledige dataset met minstens 5 epochs te trainen.
gemma_lm.fit(data, epochs=1, batch_size=1)We proberen dezelfde prompt als in de baseline om te zien of ons model verbeterd is. Deze keer, in plaats van eenregelige antwoorden en herhaling, geeft ons model een gedetailleerd reisplan voor de Bahama’s.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1: Arrive in Nassau, BahamasUpon arrival in Nassau, you will be greeted by a local guide who will take you on a tour of the city. Visit the famous Straw Market, where you can shop for souvenirs and local crafts. Enjoy lunch at a local restaurant before heading to the Atlantis Resort for a day of fun and relaxation. Spend the afternoon exploring the resort's world-class amenities, including the Aquaventure Water Park, Dolphin Cay, and the massive marine habitat, The Dig.Day 2: Explore Paradise IslandOn day 2, you will explore Paradise Island, home to the world-famous Atlantis Resort. Visit the famous Atlantis Casino and enjoy a round of blackjack or roulette. Take a stroll along the beach and enjoy the crystal-clear waters of the Atlantic Ocean. Visit the Dolphin Cay, where you can swim with dolphins and other marine animals.Day 3: Snorkel at Cabbage BeachOn day 3, you will head to Cabbage Beach, a secluded beach located on Paradise Island. Snorkel in the crystal-clear waters and explore the coral reefs. Enjoy a delicious lunch at a local restaurant before heading back to Nassau.Je kunt de modelgewichten opslaan voor inference en het model in productie inzetten.
gemma_lm.save_weights('gemma_2b_openhermes.weights.h5')De totale grootte van ons fijngetunede model is 10,04 GB.
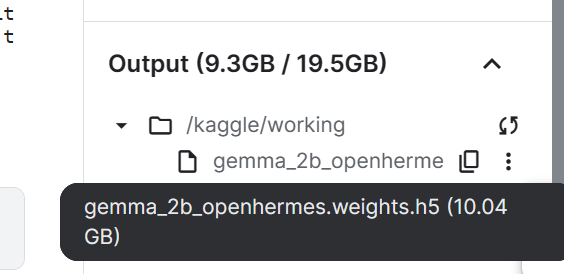 Gemma fijngetuned en opgeslagen modelfile
Heb je moeite met fijnstemmen, raadpleeg dan dit Kaggle-notebook: Finetuning Gemma using TPUs
Als laatste bekijken we gedistribueerd fijnstemmen. Dit bereik je via modelparallelisme: de gewichten van één model worden over meerdere apparaten verdeeld, wat horizontaal schalen mogelijk maakt en de training versnelt.
In dit deel verlagen we de trainingstijd aanzienlijk voor een groot model. We gebruiken Keras met een JAX-backend om Gemma te fijnstemmen met LoRA en gedistribueerde training op TPU’s.
Hier starten we een nieuw Kaggle-notebook en installeren we de benodigde libraries. Vervolgens stellen we de Keras-backend in en pre-alloceren we geheugen.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"We maken eerst een DeviceMesh om modelgewichten en tensors gedistribueerd over meerdere TPU-apparaten te laden. Dit maakt data- en modelparallelisme mogelijk, zodat LLM’s efficiënt op meerdere accelerators kunnen schalen.
Maak een DeviceMesh met de vorm (1, 8), zodat de modelgewichten over alle 8 TPU’s worden geshard.
import kerasimport keras_nlpdevice_mesh = keras.distribution.DeviceMesh( (1, 8), ["batch", "model"], devices=keras.distribution.list_devices())Vervolgens maken we een layout map die aangeeft hoe de gewichten en tensors moeten worden geshard of gerepliceerd met RegEx.
Houd rekening met het volgende:
Gewichten die overeenkomen met token_embedding/embeddings worden geshard.
Gebruik RegEx om de query-, key- en value-matrices in de decoder-attention, attention_output, ffw_gating en ffw_linear-lagen te matchen.
Overeenkomende tensors worden met de DeviceMesh geshard, de rest wordt volledig gerepliceerd.
model_dim = "model"layout_map = keras.distribution.LayoutMap(device_mesh)layout_map["token_embedding/embeddings"] = (None, model_dim)layout_map["decoder_block.*attention.*(query|key|value).*kernel"] = ( None, model_dim, None,)layout_map["decoder_block.*attention_output.*kernel"] = (None, None, model_dim)layout_map["decoder_block.*ffw_gating.*kernel"] = (model_dim, None)layout_map["decoder_block.*ffw_linear.*kernel"] = (None, model_dim)We activeren nu het modelparallelisme met device_mesh en layout_map.
model_parallel = keras.distribution.ModelParallel( device_mesh, layout_map, batch_dim_name="batch")keras.distribution.set_distribution(model_parallel)Na het instellen van modelparallelisme laden we ons model.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_7b_en")gemma_lm.summary()Deze keer, omdat we het Gemma 7B-model gebruiken, zien we 8,5 miljard trainbare parameters.
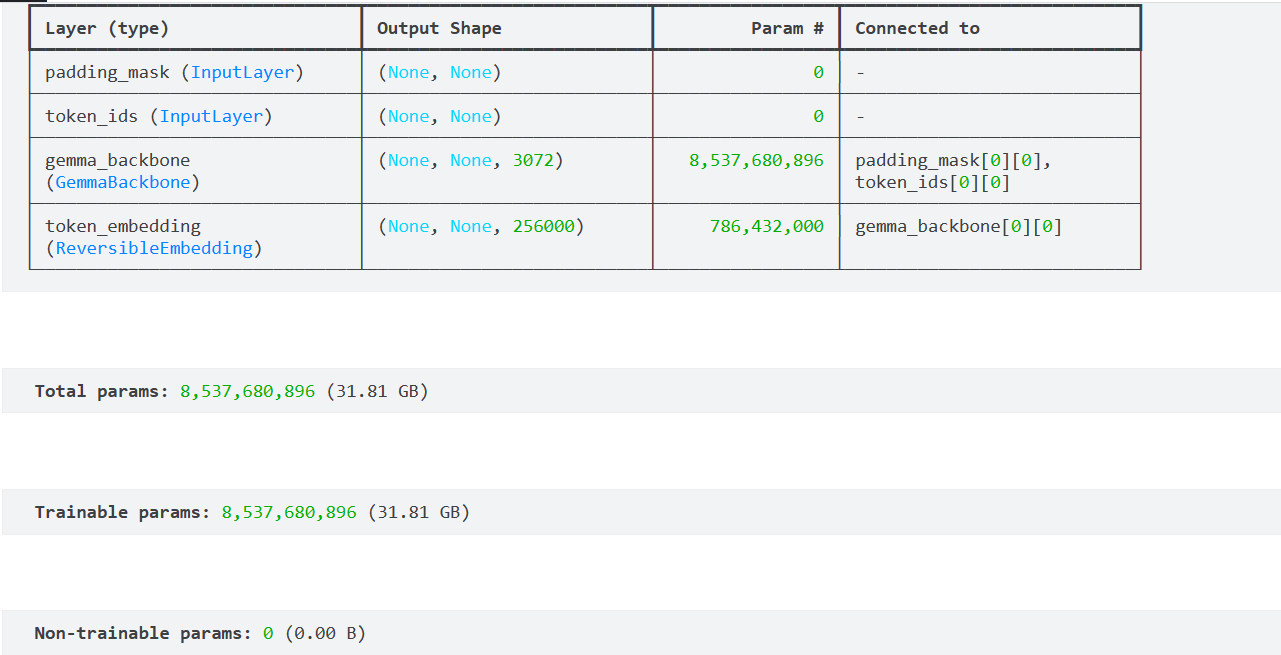 Samenvatting Gemma 7B-model
Om te verifiëren dat het model correct is geshard, printen we het path, de shape en de spec van de gewichten van de laag decoder_block_1.
decoder_block_1 = gemma_lm.backbone.get_layer('decoder_block_1')print(type(decoder_block_1))for variable in decoder_block_1.weights: print(f'{variable.path:<58} {str(variable.shape):<16} {str(variable.value.sharding.spec)}')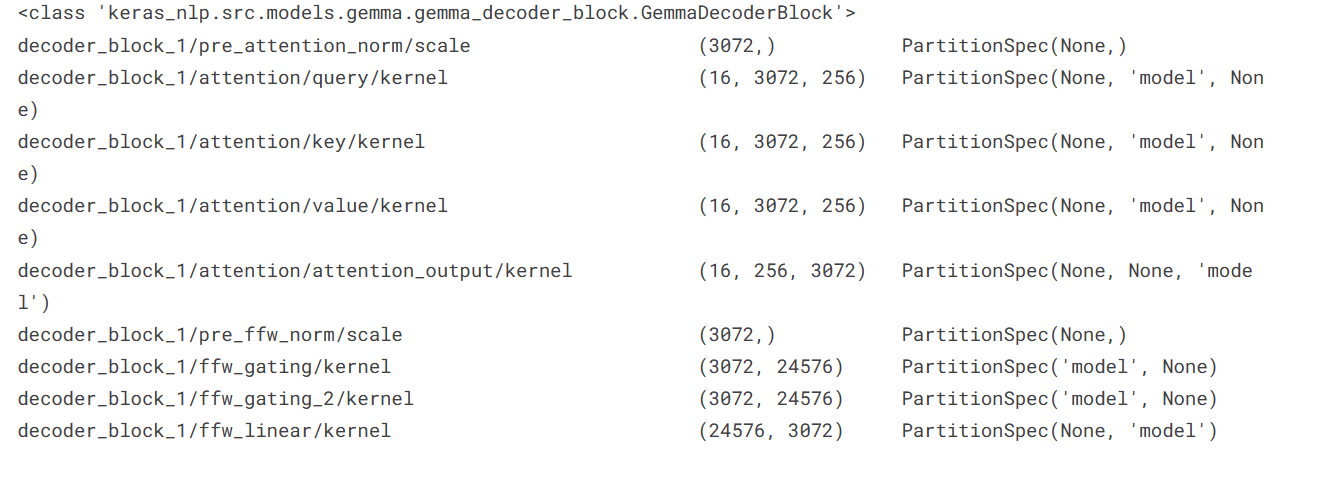
Decoderblok
We laden de OpenHermes-dataset. Opnieuw converteren we het dataframe naar een lijst met strings met het instruction-en-responsesjabloon en, om de training te versnellen, selecteren we alleen de bovenste 1.000 voorbeelden.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')# Format and convert the dataframe into a list of strings.template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]# Select a subset of the dataset. data = data[:1000]We genereren nu de reactie voor de baseline door de geformatteerde prompt te geven. Interessant genoeg is de reactie nog slechter dan bij het kleinere model, maar we gaan door.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256)) 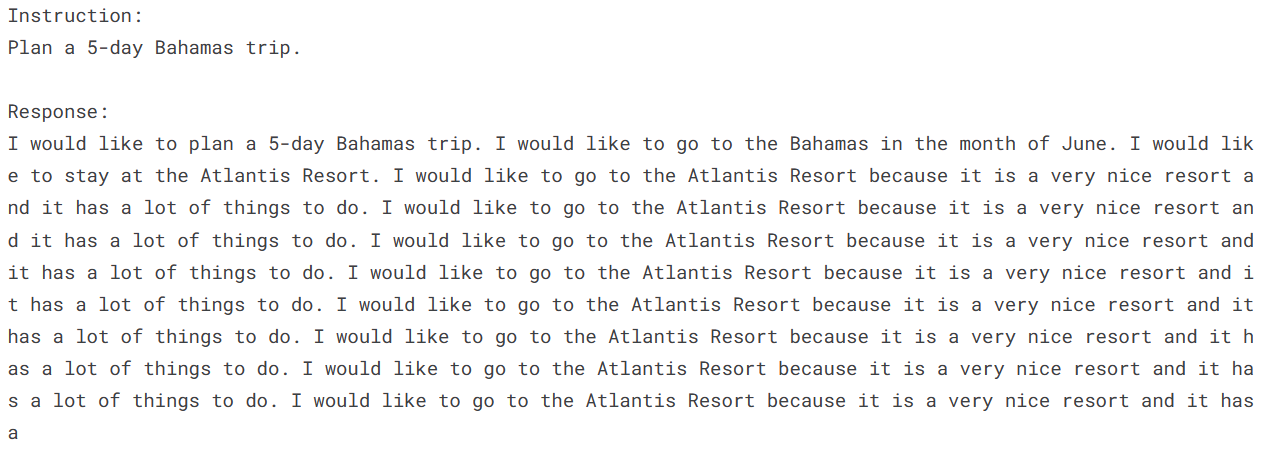 Inference-resultaat vóór fijnstemmen
We compileren het model met dezelfde modelconfiguraties, LoRA-rank, optimizer, verliesfunctie en accuracymetriek. We hebben nu 11 miljoen trainbare parameters met een grootte van 42,22 MB.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()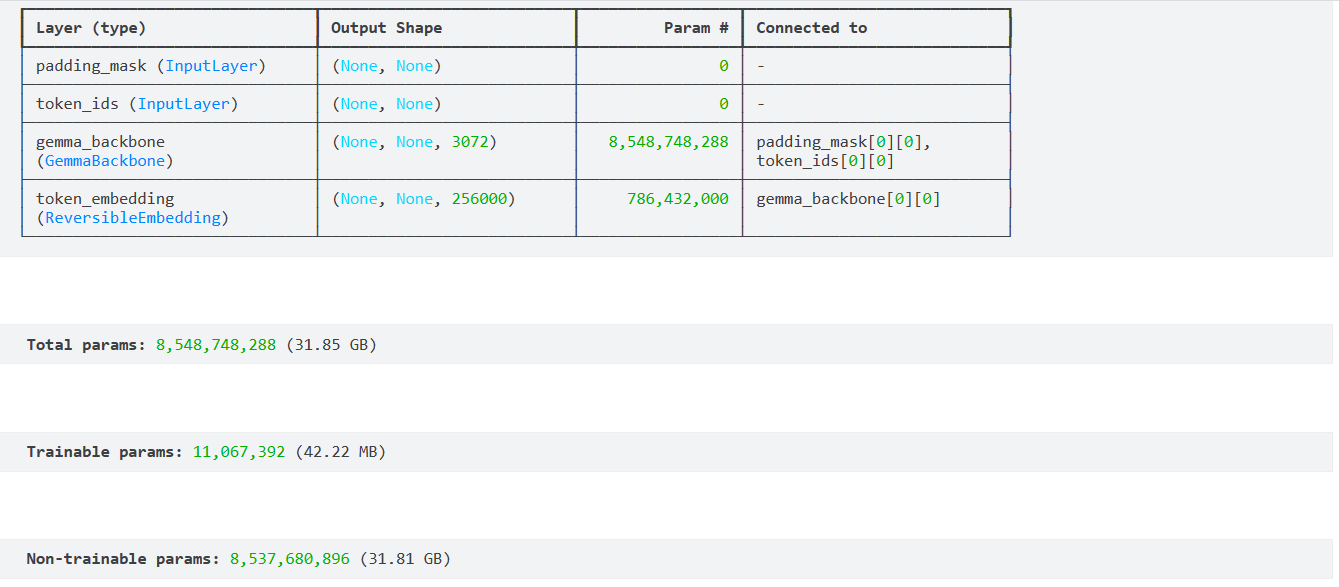 Samenvatting Gemma 7B LoRA-model
Het kostte 305 seconden om één epoch fijn te stemmen, wat gezien de modelgrootte erg goed is.
gemma_lm.fit(data, epochs=1, batch_size=1)
Vind je fijnstemmen lastig, leer dan werken met de API van OpenAI en volg een stap-voor-stapgids om GPT-4 te fijnstemmen.
Laten we de reactie genereren en vergelijken met de baseline.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Het fijngetunede model is uitstekend. Het genereerde een reactie met een lijst van wat je kunt doen om te genieten van je vijfdaagse trip naar de Bahama’s.
Opmerking: je kunt LoRA uitschakelen voor langzamer maar nauwkeuriger full-parameter-tunen met modelparallelisme.
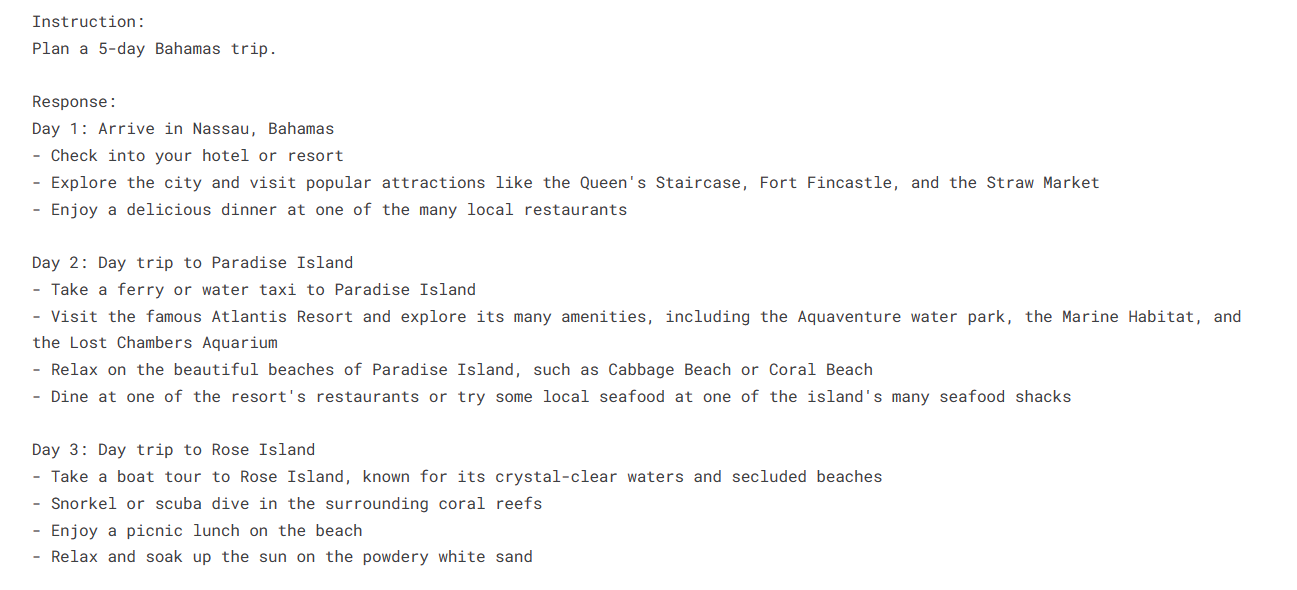 Inference-resultaat na fijnstemmen
gemma_lm.save_weights('gemma_7b_openhermes.weights.h5')Heb je opnieuw moeite met gedistribueerd fijnstemmen, raadpleeg dan dit Kaggle-notebook als extra bron: Accessing Gemma-instruct-2b-en using TPUs.
In deze tutorial hebben we geleerd wat TPU’s zijn en hoe je ze gebruikt om de generatie van reacties door LLM’s te versnellen. We hebben bovendien Gemma-modellen fijngestemd op de OpenHermes-dataset met TPU’s en gedistribueerde training.
LLM’s fijnstemmen op TPU’s en modelparallelisme gebruiken voor gedistribueerd leren zijn belangrijke manieren om de trainingstijd te versnellen. Met gedistribueerd leren kun je zelfs zeer grote modellen zoals Gemma 7B fijnstemmen. Door TPU’s te benutten, die speciaal zijn ontworpen voor high-performance machinelearningtaken, kun je aanzienlijke versnellingen behalen in zowel de trainings- als inferencefase.
Vond je de tutorial interessant en wil je meer leren over de wereld van large language models, volg dan de cursus Master Large Language Models (LLMs) Concepts om het volledige potentieel van LLM-toepassingen, trainingsmethodologieën, ethische overwegingen en het nieuwste onderzoek te ontdekken. Ben je geïnteresseerd in andere large language models die met Gemma concurreren, bekijk dan onze tutorial Aan de slag met Mixtral 8X22B om meer te leren over het nieuwe model van Mistral AI en de sparse mixture of experts (SMoE)-architectuur.
Leer meer over Large Language Models
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

