Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
110K
Dieser Beitrag ist ein umfassendes Tutorial zur Feinabstimmung großer Sprachmodelle mit fortgeschrittenen Techniken. Wir arbeiten mit Tensor Processing Units, einer Methode namens LoRA und verteilter Verarbeitung – alles für maximale Geschwindigkeit und Effizienz. Zur Veranschaulichung greifen wir auf Gemma-Modelle zu und stimmen sie ab – eine neue Familie schlanker, hochmoderner LLMs von Google.
Am Ende des Tutorials kannst du jedes große Sprachmodell mit den auf Google Cloud verfügbaren TPUs feinabstimmen und Inferenz darauf ausführen. Auf dem Weg dorthin behandeln wir in dieser Reihenfolge:
Gemma mit TPUs nutzen: Wir richten eine Kaggle-Umgebung ein, um TPUs zu verwenden.
Modellsetup und Inferenz: Wir führen Gemma mit der Keras-Bibliothek in Python aus.
Feinabstimmung: Wir stimmen das Gemma-Modell mit der Technik LoRA ab.
Verteiltes Training: Wir führen verteilte Feinabstimmung für effizienteres Training durch.
Wenn du neu in KI und LLMs bist, empfiehlt sich der umfassende Skill-Lernpfad AI Fundamentals, um dich mit den im Tutorial verwendeten Begriffen vertraut zu machen.
Los geht's!
 Google Gemma-Logo
Googles Gemma-Modell gehört zu einer Familie quelloffener, leichter Large Language Models, die 2024 von Google vorgestellt wurden. Gemma wurde mit derselben Forschung und Technologie entwickelt wie die Google-Gemini-Modelle und ist ähnlich wie Gemini mit wichtigen Machine-Learning-Frameworks wie Keras und Pytorch kompatibel. Es ist in zwei Größen verfügbar, mit 2B oder 7B Parametern.
Während Gemini vor allem für Endnutzer über Anwendungen und APIs gedacht ist, ist Gemma quelloffen und kann von Entwicklerinnen und Entwicklern umfassend angepasst und integriert werden. Gemma-Modelle sind zudem kleiner, dadurch portabler und kostengünstiger.
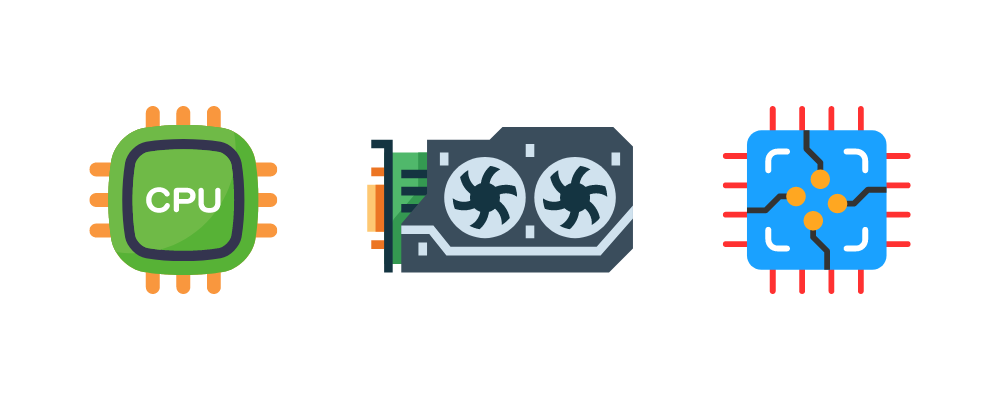 Bilder von CPUs, GPUs, TPUs: Freepik und Flaticon
Zur Einordnung vergleichen wir kurz die Hardware-Optionen fürs Machine Learning. Die Hardware lässt sich in unterschiedliche Typen mit spezifischen Stärken bei Verarbeitung und Berechnung einteilen.
Central Processing Units: CPUs betreiben Betriebssysteme auf nahezu allen Rechnern. Sie sind für sequentielle Verarbeitung bekannt.
Graphics Processing Units: GPUs bearbeiten viele Aufgaben parallel und sind ideal fürs Grafikrendering.
Tensor Processing Units: TPUs sind spezialisierte Prozessoren von Google für Machine Learning. Sie sind darauf ausgelegt, die für das Training und den Betrieb neuronaler Netze kritischen Matrixberechnungen extrem schnell auszuführen.
Für dieses Tutorial sind TPUs entscheidend. TPUs sind beim Training und bei der Inferenz tiefer neuronaler Netze schneller als GPUs und verbrauchen weniger Strom. Nachteil: Das TPU-Ökosystem ist weniger ausgereift, es gibt weniger Tools und Frameworks. Verfügbar sind unter anderem Google Cloud Platform, Colab und Kaggle.
Komponente | Haupteinsatz | ML-Anwendungen | Vorteile | Verfügbarkeit |
CPUs | Allgemeine Aufgaben | Einfache Modelle | Günstig, geringer Stromverbrauch | Weit verbreitet |
GPUs | Grafikrendering | Deep Learning, große Datenverarbeitung | Schnell bei komplexen Berechnungen | Kommerziell verfügbar |
TPUs | Machine Learning | Tiefe Netze, schnelle Matrixoperationen | Am schnellsten für ML, energieeffizient | Nur auf Google Cloud, Colab und Kaggle |
Vergleichstabelle für ML-Hardware
Gemma-Modelle sind für verteilte Umgebungen ausgelegt und skalieren dort sehr effizient. Das steigert Leistung und Geschwindigkeit – besonders bei großen Datenmengen und komplexen Architekturen.
Die Keras-Bibliothek passt hier gut, da sie verteiltes Training für Gemma-Modelle unterstützt und eine Multi-Backend-Implementierung inklusive TensorFlow und PyTorch bietet.
In diesem Abschnitt konfigurieren wir unser Kaggle-Notebook für TPUs, stellen alle nötigen Bibliotheken bereit, laden das Gemma-2B- oder -7B-Modell mit keras-nlp und setzen das Modell für Aufgaben ein – gestützt auf die starke Rechenleistung der TPUs.
Wir integrieren die Keras-Variante des Gemma-Modells und stellen den Beschleuniger auf TPU um. Wir installieren Kernpakete wie keras-nlp, konfigurieren Keras mit TensorFlow als Backend und optimieren die TPU-Speicherzuweisung für reibungsloses Training und Ausführung.
Wir fügen die Keras-Implementation zum Gemma-Modell hinzu, also eine Keras-kompatible Variante, die nahtlos mit den TensorFlow-APIs zusammenspielt.
So gehst du vor:
Erstelle ein neues Notebook in Kaggle.
Wechsle rechts in den Bereich "Input".
Klicke auf „+ Add Input“, um die Keras-Implementation des Gemma-Modells hinzuzufügen.
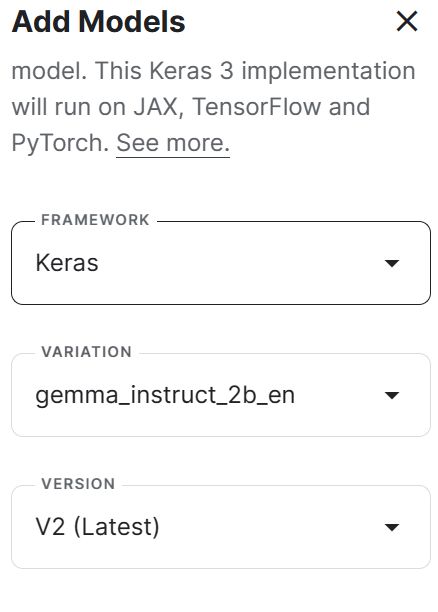 Keras-Implementation zum Gemma-Modell hinzufügen
Als Nächstes stellen wir den Notebook-Beschleuniger auf TPU, um dessen Rechenleistung fürs Training und die Inferenz zu nutzen.
So änderst du den Beschleuniger. Es ist normal, wenn das Neuladen der Umgebung ein paar Minuten dauert.
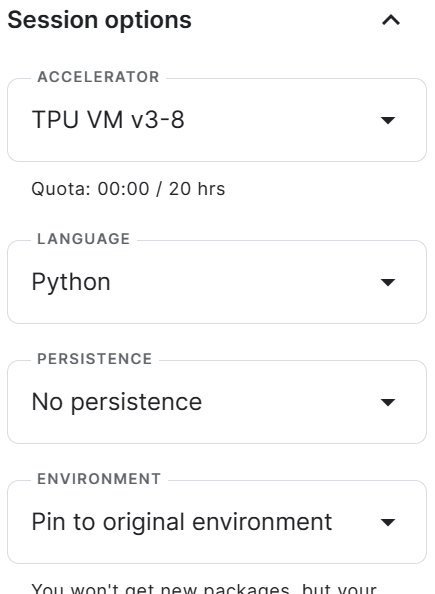 TPU als Beschleuniger einrichten
Jetzt installieren wir die aktualisierten Python-Pakete für Feinabstimmung und Inferenz, darunter TensorFlow und keras-nlp.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1Wir setzen das Keras-Backend auf JAX für nahtlosen TPU-Zugriff. Du kannst auch TensorFlow oder PyTorch ausprobieren.
Zum Schluss weisen wir den TPU-Speicher vorab zu, um Performance zu optimieren und Laufzeitprobleme zu vermeiden. Hier reservieren wir 100% des TPU-Speichers, um Speicherfragmentierung im JAX-Backend zu verhindern.
import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"]="1.00"Wir laden die nötigen Python-Pakete für die Inferenz.
import kerasimport keras_nlpDann laden wir unser Modell und zeigen die Modellzusammenfassung an.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_instruct_2b_en")gemma_lm.summary()Tokenizer und Modell wurden mit einem einzigen Befehl geladen. Das ist bemerkenswert, denn selbst das kleinste Gemma-Modell hat 2,5 Milliarden Parameter und ist 9,34 GB groß.
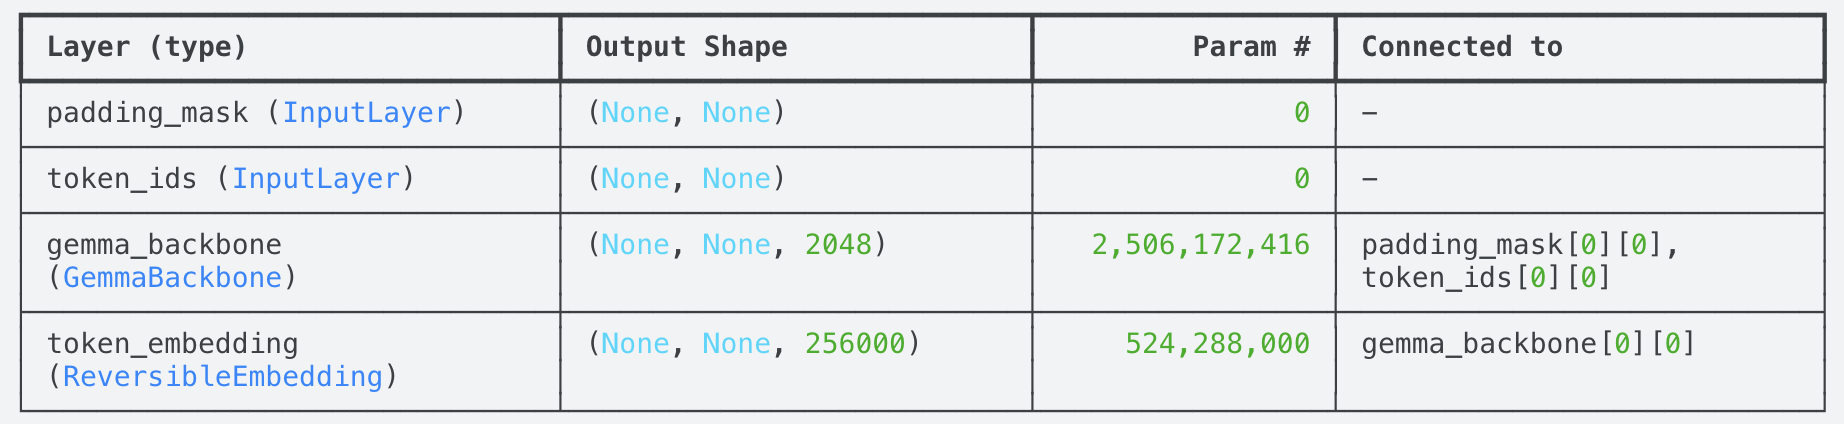 Gemma-Modellzusammenfassung
Bis zur Ausführung des Notebooks und zur sehr schnellen Performance kann es ein paar Minuten dauern, da TPUs stark nachgefragt sind. Nachts hast du oft keine Wartezeit.
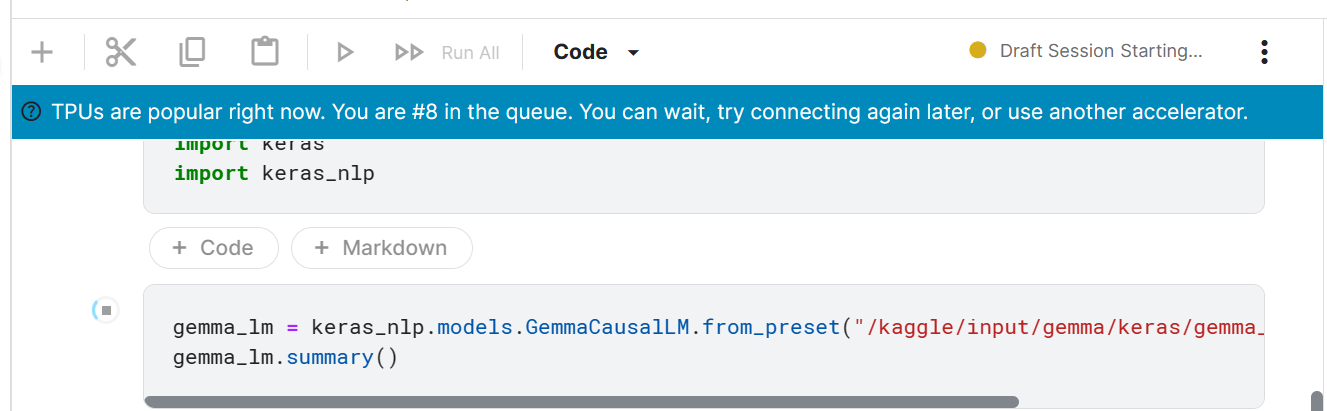 Warteschlange für TPU-Zugriff
Inferenz bedeutet hier, dass wir aus neuen Eingaben Ausgaben generieren. Dazu geben wir Text über die Funktion .generate() vor und erhalten direkt eine Antwort.
print(gemma_lm.generate("What is DataCamp?", max_length=30))What is DataCamp?DataCamp is a leading online data science education platform that empowers individuals and organizations to build data-driven careers. TheyWir können auch Batch-Inferenz ausprobieren, also mehrere Prompts für mehrere Antworten. Die Ausgabe ist eine Liste.
print(gemma_lm.generate(["How far is the Sun from earth", "What is the Sun made of?"], max_length=30))['How far is the Sun from earth?\n\nThe Sun is about 149.6 million kilometers (93 million miles) away from', 'What is the Sun made of?\n\nThe Sun is primarily composed of hydrogen and helium. Hydrogen makes up about 73.4% of']Als Nächstes erstellen wir eine Vorlage mit Anweisungen und Antworten, um das Modell zu steuern. Du kannst einen Systemprompt oder andere Startbefehle ergänzen, um die Ausgabe zu beeinflussen.
Wir nutzen .format(), um die Vorlage mit den Nutzereingaben zu füllen. So entsteht eine Liste mit Schritten, wie man Python lernen kann.
template = "Instruction:\n{instruction}\n\nResponse:\n{response}"prompt = template.format( instruction="How do I start learning Python?", response="",)print(gemma_lm.generate(prompt, max_length=250))Instruction:How do I start learning Python?Response:**Step 1: Choose a learning path*** **Online Courses:** * DataCamp * Codecademy * Coursera * edX * Udemy* **Books:** * "Automate the Boring Stuff with Python" by Al Sweigart * "Python Crash Course" by Eric Matthes * "Head First Python" by Kathy Sierra and Bert Bates* **Video Tutorials.........Wenn das Laden des Modells oder das Generieren mit TPUs hakt, hilft dieses Kaggle-Notebook: Accessing Gemma-instruct-2b-en using TPUs.
Wenn du mit Gemma warm geworden bist, schau dir unser Tutorial Fine Tuning Google Gemma: Enhancing LLMs with Customized Instructions an, um Gemma mit maßgeschneiderten Anweisungen zu verbessern.
Jetzt stimmen wir Gemma mit dem öffentlichen Datensatz OpenHermes ab. OpenHermes enthält 242.000 Zeilen mit zwei Spalten: Instruktionen und Antworten, generiert mit GPT-4.
Wie wir sehen werden, dauert das Feinabstimmen dieses Datensatzes selbst mit TPUs sehr lange. Wir nutzen daher die Technik LoRA.
LoRA (Low-Rank Adaptation) macht die Feinabstimmung großer Sprachmodelle effizienter und zugänglicher. Klassische Methoden sind oft rechen- und ressourcenintensiv.
Technisch friert LoRA die vortrainierten Gewichte ein und fügt Niedrigrang-Matrizen hinzu, die gezielt Teile der Architektur modulieren. Durch die Konzentration auf diese Matrizen sinkt der Rechenaufwand, sodass sich große Modelle auch auf weniger starker Hardware feinabstimmen lassen.
Ähnlich wie zuvor setzen wir Keras-Backend und Speichervorbelegung. Mit jax. devices() prüfen wir zudem, ob TPU-Geräte verfügbar sind.
import osimport jaxos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"jax.devices()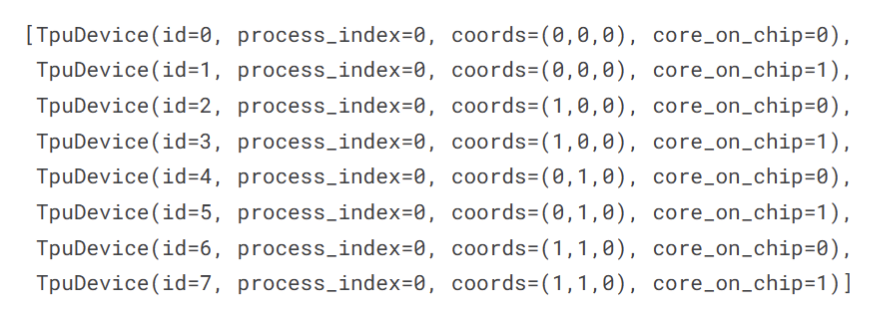
Anzahl der Rechengeräte
Wir laden das Modell und zeigen die Zusammenfassung. Es sind 2,5 Milliarden trainierbare Parameter.
import kerasimport keras_nlpgemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_2b_en")gemma_lm.summary()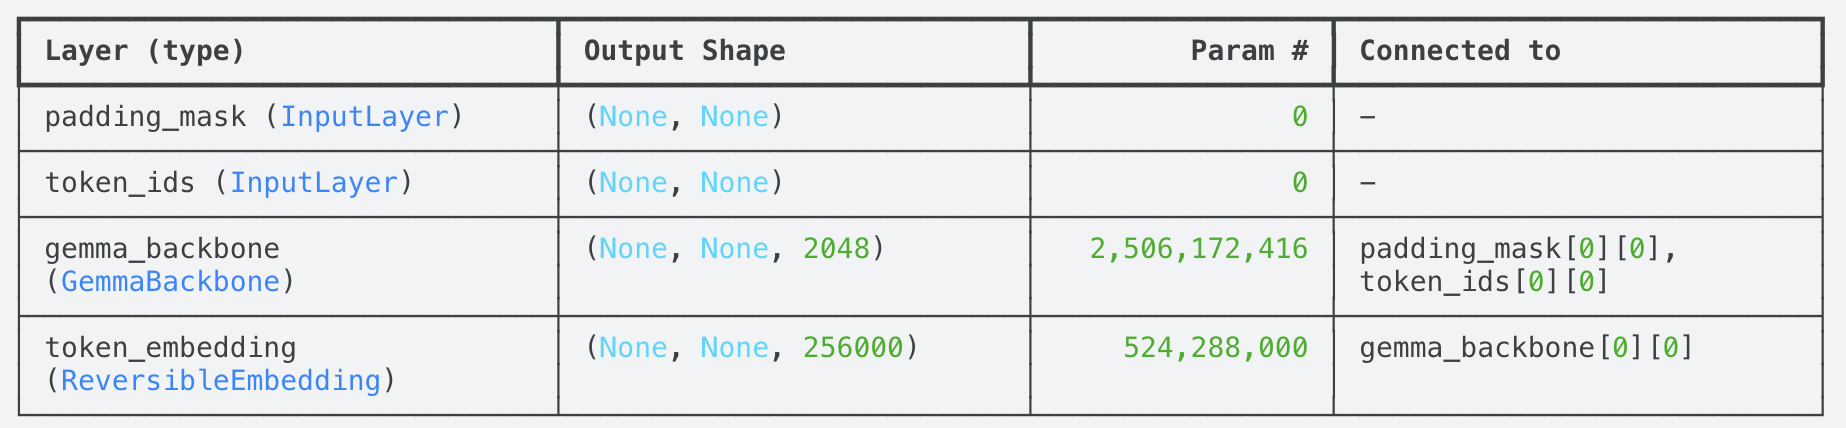 Gemma-Modellzusammenfassung
Als Nächstes laden wir den Datensatz ins Notebook. Der Ablauf ist dem Hinzufügen des Modells ähnlich. Schritte:
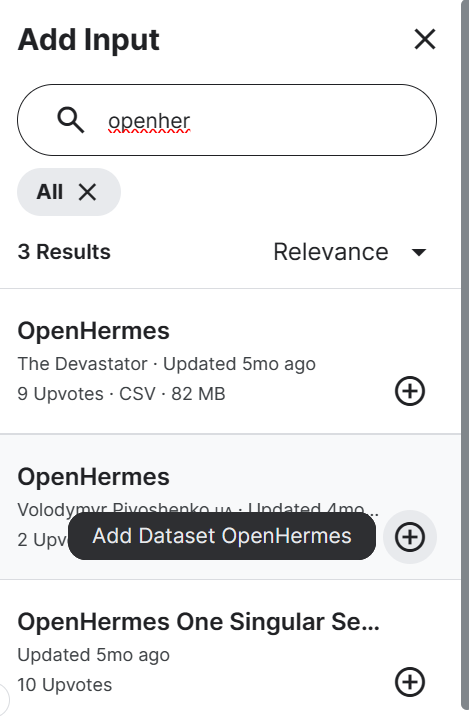
OpenHermes-Datensatz hinzufügen
Mit pandas lesen wir den Datensatz und zeigen die ersten 5 Zeilen. Es gibt 2 Spalten: instruction und output.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')df.head()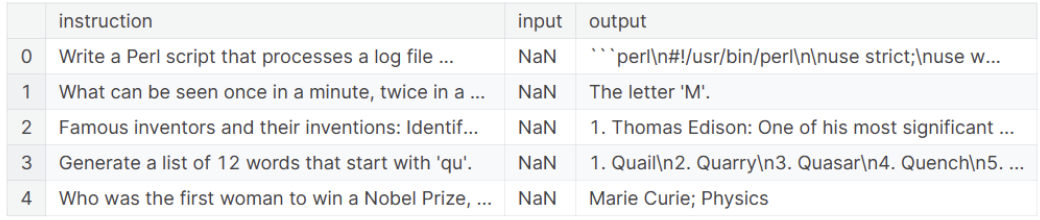
OpenHermes-Datensatz
Jetzt müssen wir den Datensatz in das vom Modell erwartete Format bringen: eine Liste von Strings im Instruktions-/Antwort-Format.
Das vollständige Training würde fast 23 Stunden dauern, selbst auf TPUs. Deshalb wählen wir nur die ersten 1.000 Beispiele.
template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]data = data[:1000]print(data[0])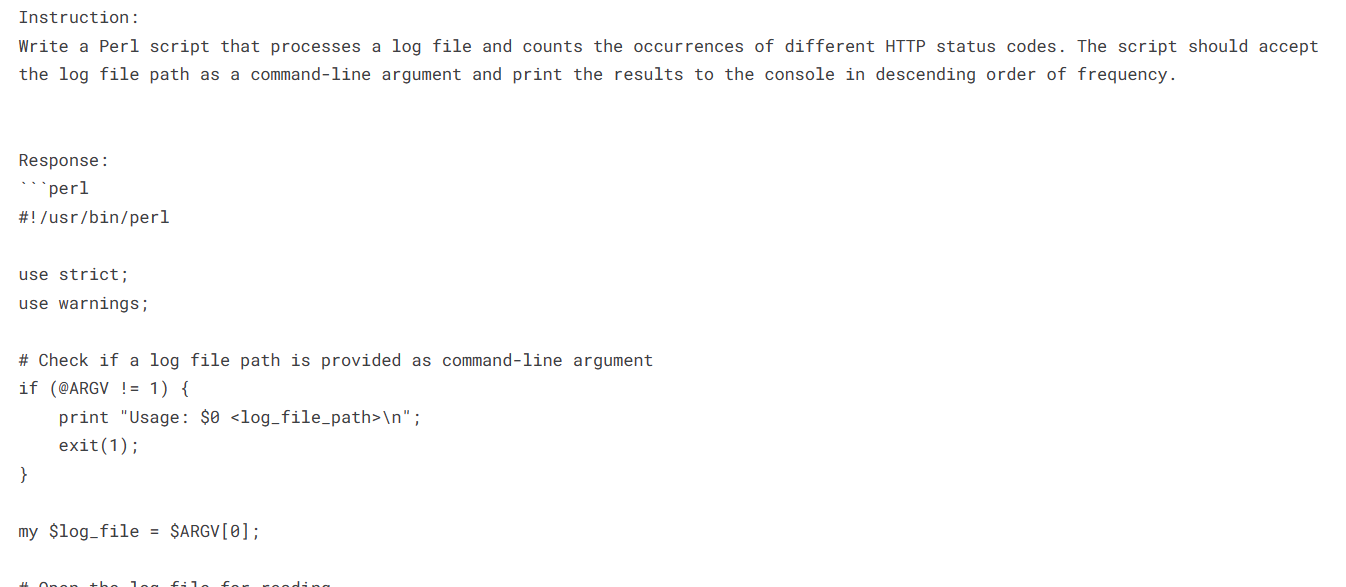
Erster Eintrag aus OpenHermes
Wir legen eine Baseline an, um den Effekt von LoRA zu messen. Dazu generieren wir eine Antwort mit template.format().
Im folgenden Output siehst du, dass die Baseline nicht sehr ausführlich ist. Gemma wiederholt sich sogar nach der ersten Antwort. Kein gutes Ergebnis – aber eine gute Begründung, unser Modell zu feinabstimmen.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-dayJetzt verbessern wir das Modell mit LoRA, wodurch sich die Zahl der trainierbaren Parameter für Downstream-Aufgaben reduziert.
In unserem Beispiel nutzen wir LoRA Rank 4, die kleinste effizient rechenbare Einstellung. Für mehr Performance kannst du Rank 8 oder 16 wählen. Mehr zu LoRA und Quantisierung findest du im Leitfaden Fine-Tuning LLaMA 2.
Anschließend legen wir Optimierer, Loss und Metriken fest.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()Die trainierbaren Parameter sinken deutlich von 2,5 Milliarden auf 1,3 Millionen. Die Adapter-Schicht ist nur 5,2 MB groß.
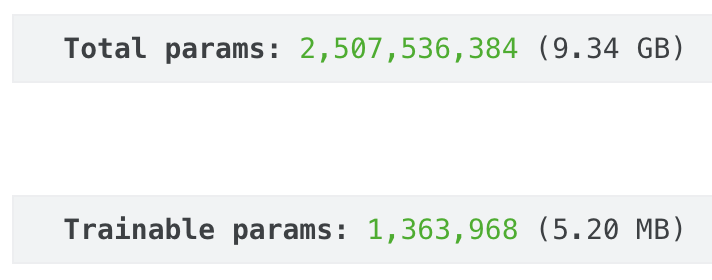
Gemma: Gesamt- vs. trainierbare Parameter
Wir passen die Daten ans Modell an. Hier wählen wir 1 Epoche und Batch-Größe 1. Bessere Ergebnisse erhältst du mit dem vollständigen Datensatz und mindestens 5 Epochen.
gemma_lm.fit(data, epochs=1, batch_size=1)Wir verwenden denselben Prompt wie in der Baseline, um die Verbesserung zu prüfen. Statt Einzeilern und Wiederholungen liefert das Modell nun einen detaillierten Reiseplan für die Bahamas.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1: Arrive in Nassau, BahamasUpon arrival in Nassau, you will be greeted by a local guide who will take you on a tour of the city. Visit the famous Straw Market, where you can shop for souvenirs and local crafts. Enjoy lunch at a local restaurant before heading to the Atlantis Resort for a day of fun and relaxation. Spend the afternoon exploring the resort's world-class amenities, including the Aquaventure Water Park, Dolphin Cay, and the massive marine habitat, The Dig.Day 2: Explore Paradise IslandOn day 2, you will explore Paradise Island, home to the world-famous Atlantis Resort. Visit the famous Atlantis Casino and enjoy a round of blackjack or roulette. Take a stroll along the beach and enjoy the crystal-clear waters of the Atlantic Ocean. Visit the Dolphin Cay, where you can swim with dolphins and other marine animals.Day 3: Snorkel at Cabbage BeachOn day 3, you will head to Cabbage Beach, a secluded beach located on Paradise Island. Snorkel in the crystal-clear waters and explore the coral reefs. Enjoy a delicious lunch at a local restaurant before heading back to Nassau.Du kannst die Modellgewichte für die Inferenz speichern und das Modell in Produktion bringen.
gemma_lm.save_weights('gemma_2b_openhermes.weights.h5')Die Gesamtgröße unseres feinabgestimmten Modells beträgt 10,04 GB.
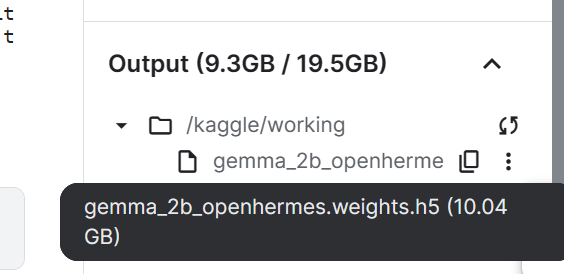 Feinabgestimmtes Gemma – gespeicherte Modelldatei
Wenn die Feinabstimmung Probleme macht, hilft dieses Kaggle-Notebook: Finetuning Gemma using TPUs
Zum Abschluss betrachten wir verteilte Feinabstimmung. Sie wird über Modellparallelität erreicht: Die Gewichte eines einzelnen Modells werden auf mehrere Geräte verteilt, was horizontale Skalierung ermöglicht und das Training beschleunigt.
Wir reduzieren hier die Trainingszeit für ein großes Modell deutlich. Konkret nutzen wir Keras mit JAX-Backend, um Gemma mit LoRA und verteiltem Training auf TPUs zu feinabstimmen.
Wir starten ein neues Kaggle-Notebook, installieren die nötigen Bibliotheken, setzen das Keras-Backend und reservieren Speicher vorab.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"Zuerst erstellen wir ein DeviceMesh, um Modellgewichte und Tensoren über mehrere TPUs verteilt zu laden. So kombinieren wir Daten- und Modellparallelität und skalieren LLMs effizient über mehrere Beschleuniger.
Wir erzeugen ein DeviceMesh mit Form (1, 8), damit die Modellgewichte über alle 8 TPUs geshardet werden.
import kerasimport keras_nlpdevice_mesh = keras.distribution.DeviceMesh( (1, 8), ["batch", "model"], devices=keras.distribution.list_devices())Als Nächstes definieren wir per RegEx eine Layout-Map, die festlegt, welche Gewichte/Tensoren geshardet oder repliziert werden.
Beachte dabei:
Gewichte, die auf token_embedding/embeddings matchen, werden geshardet.
Nutze RegEx, um Query-, Key- und Value-Matrizen im Decoder-attention, attention_output, ffw_gating und ffw_linear-Layer zu treffen.
Gematchte Tensoren werden per DeviceMesh geshardet, der Rest bleibt voll repliziert.
model_dim = "model"layout_map = keras.distribution.LayoutMap(device_mesh)layout_map["token_embedding/embeddings"] = (None, model_dim)layout_map["decoder_block.*attention.*(query|key|value).*kernel"] = ( None, model_dim, None,)layout_map["decoder_block.*attention_output.*kernel"] = (None, None, model_dim)layout_map["decoder_block.*ffw_gating.*kernel"] = (model_dim, None)layout_map["decoder_block.*ffw_linear.*kernel"] = (None, model_dim)Jetzt aktivieren wir die Modellparallelität mit device_mesh und layout_map.
model_parallel = keras.distribution.ModelParallel( device_mesh, layout_map, batch_dim_name="batch")keras.distribution.set_distribution(model_parallel)Nach dem Einrichten der Modellparallelität laden wir das Modell.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_7b_en")gemma_lm.summary()Da wir jetzt Gemma 7B verwenden, sehen wir 8,5 Milliarden trainierbare Parameter.
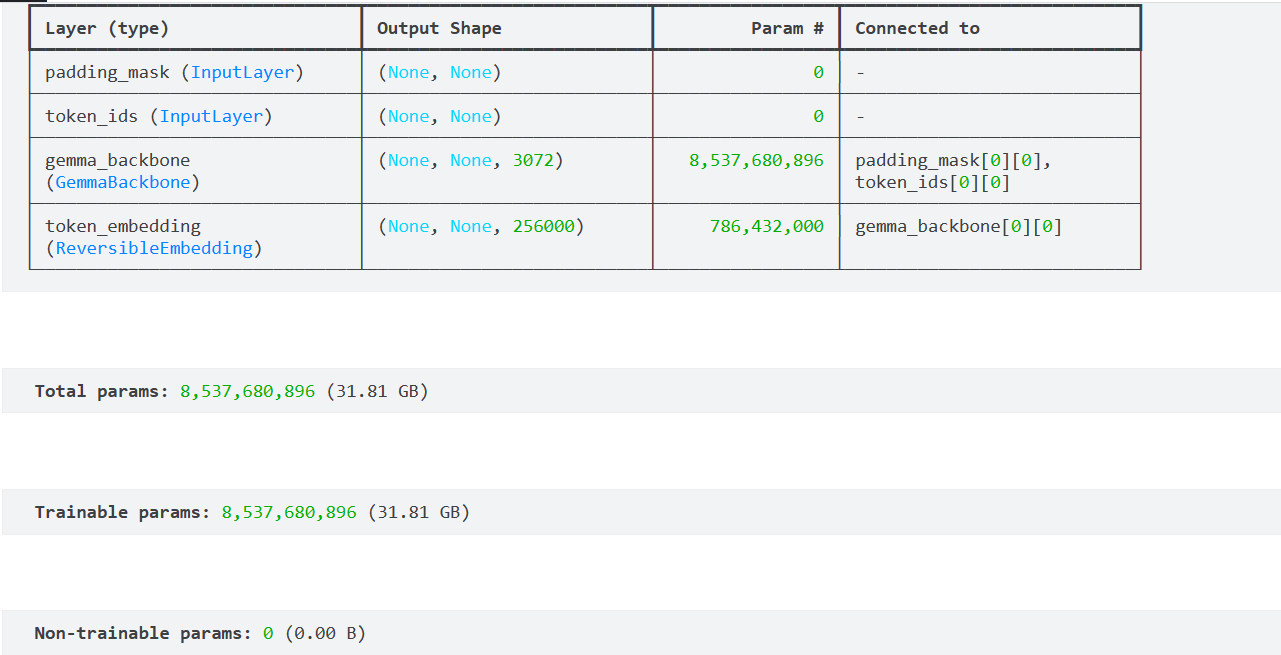 Gemma 7B – Modellzusammenfassung
Zur Prüfung der korrekten Shardings geben wir path, shape und spec der Gewichte in decoder_block_1 aus.
decoder_block_1 = gemma_lm.backbone.get_layer('decoder_block_1')print(type(decoder_block_1))for variable in decoder_block_1.weights: print(f'{variable.path:<58} {str(variable.shape):<16} {str(variable.value.sharding.spec)}')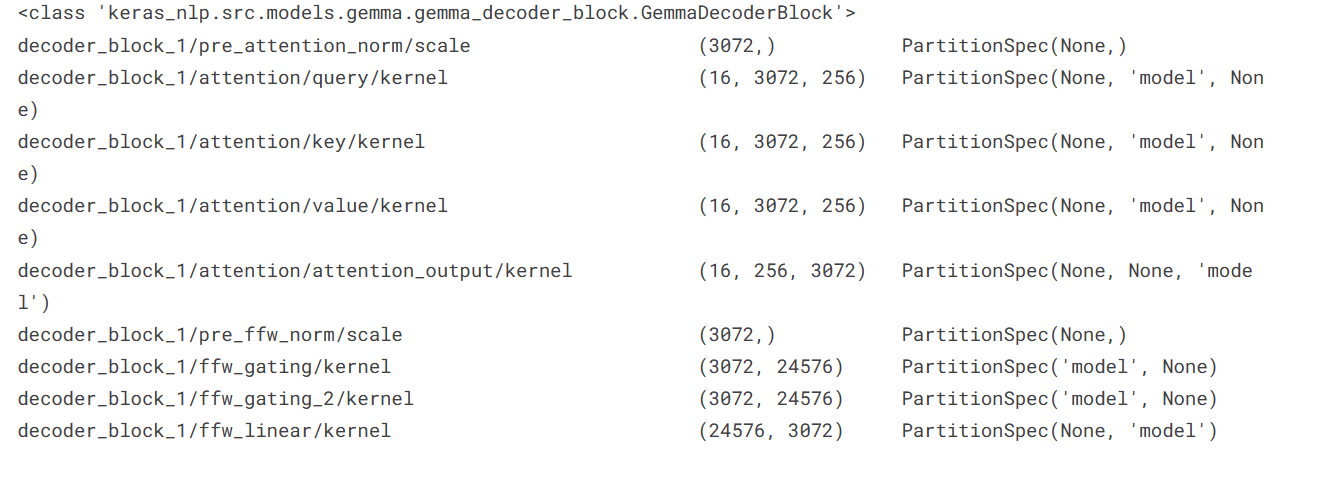
Decoder-Block
Wir laden erneut OpenHermes, formatieren den DataFrame per Instruktions-/Antwortvorlage zu einer Liste von Strings und wählen zur Beschleunigung die ersten 1.000 Beispiele.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')# Format and convert the dataframe into a list of strings.template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]# Select a subset of the dataset. data = data[:1000]Wir generieren die Baseline-Antwort mit dem formatierten Prompt. Interessanterweise ist sie schlechter als beim kleineren Modell, aber wir machen weiter.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256)) 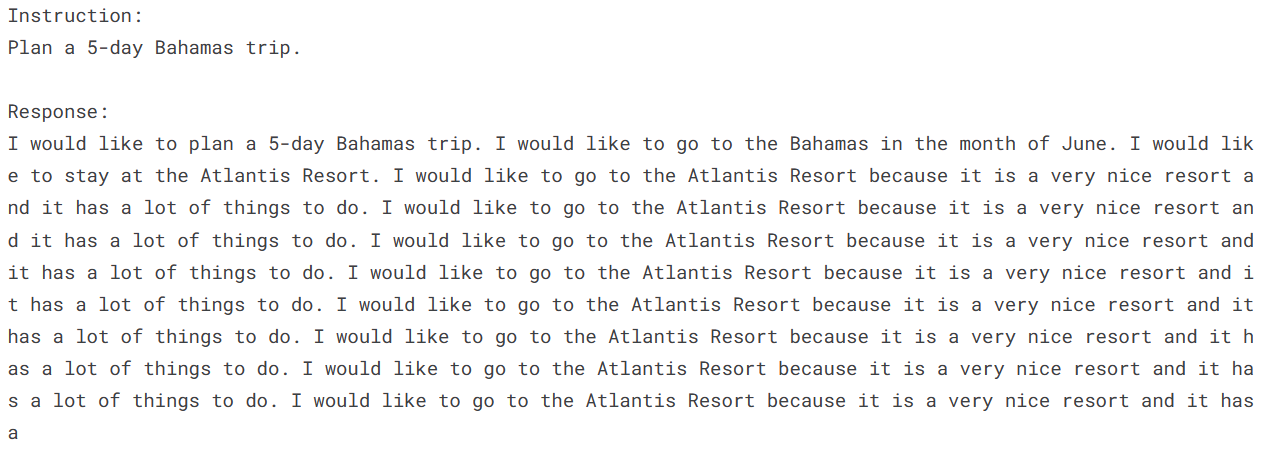 Inferenz vor der Feinabstimmung
Wir kompilieren mit denselben Konfigurationen: LoRA-Rank, Optimierer, Loss und Metrik. Jetzt haben wir 11 Millionen trainierbare Parameter bei 42,22 MB.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()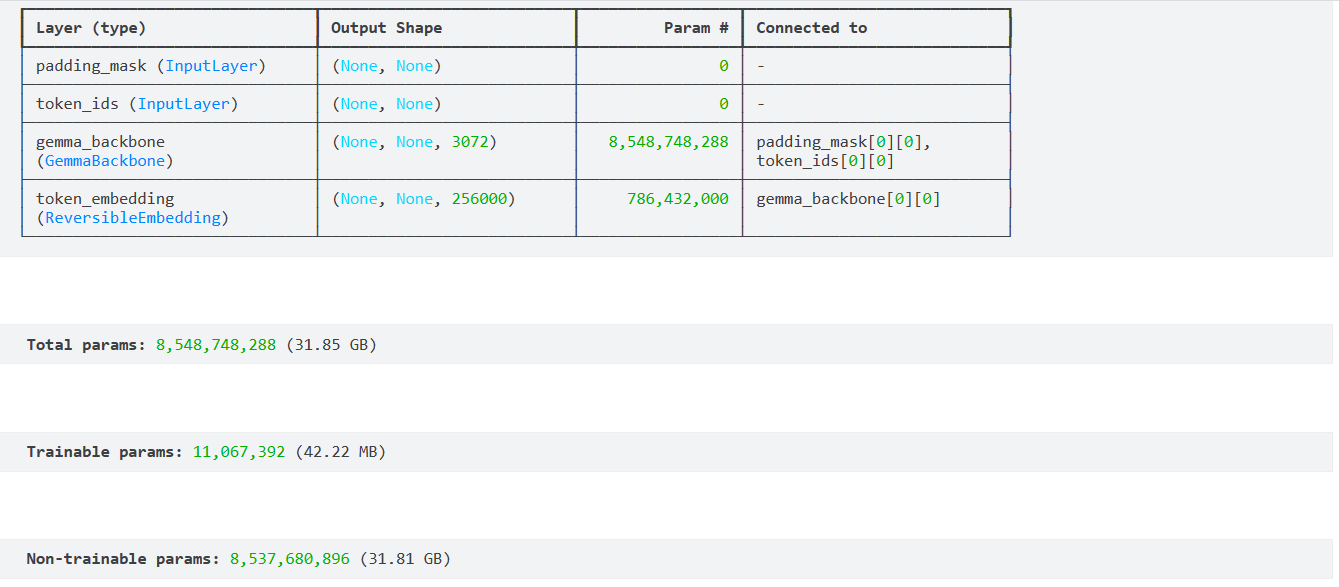 Gemma 7B LoRA – Modellzusammenfassung
Eine Epoche Feinabstimmung dauerte 305 Sekunden – beachtlich für diese Modellgröße.
gemma_lm.fit(data, epochs=1, batch_size=1)
Wenn dir Feinabstimmung noch schwerfällt, lern die OpenAI-API kennen und folge der Schritt-für-Schritt-Anleitung zum Fine-Tuning von GPT-4.
Wir generieren die Antwort und vergleichen sie mit der Baseline.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Das feinabgestimmte Modell liefert eine überzeugende Antwort mit einer Liste an Aktivitäten für die fünftägige Bahamas-Reise.
Hinweis: Du kannst LoRA deaktivieren, um mit Modellparallelität ein langsameres, aber präziseres Full-Parameter-Tuning durchzuführen.
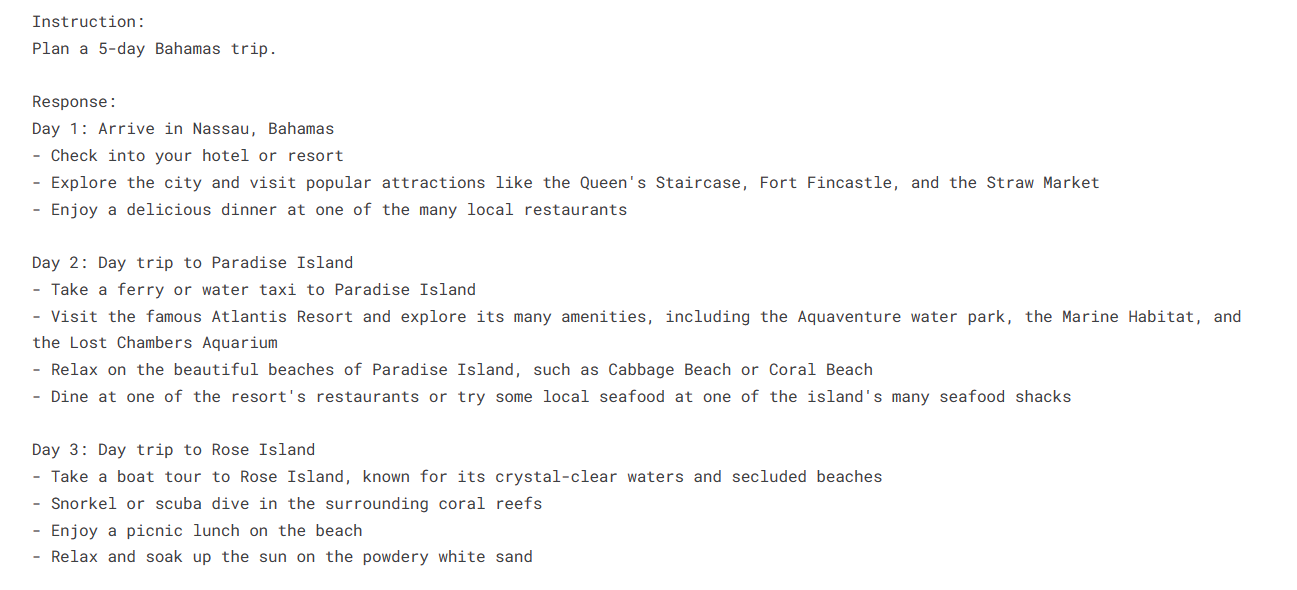 Inferenz nach der Feinabstimmung
gemma_lm.save_weights('gemma_7b_openhermes.weights.h5')Wenn du bei der verteilten Feinabstimmung hängst, hilft dieses Kaggle-Notebook zusätzlich: Accessing Gemma-instruct-2b-en using TPUs.
In diesem Tutorial haben wir TPUs kennengelernt und wie man damit die Antwortgenerierung von LLMs beschleunigt. Außerdem haben wir Gemma-Modelle auf dem OpenHermes-Datensatz mit TPUs und verteiltem Training feinabgestimmt.
LLMs auf TPUs feinabzustimmen und Modellparallelität für verteiltes Lernen zu nutzen, ist ein wichtiger Hebel, um Trainingszeiten zu verkürzen. Mit verteiltem Lernen kannst du selbst sehr große Modelle wie Gemma 7B feinabstimmen. Durch den Einsatz von TPUs, die speziell für leistungsintensive ML-Aufgaben entwickelt wurden, erzielst du deutliche Beschleunigungen im Training und in der Inferenz.
Wenn dir das Tutorial gefallen hat und du tiefer in die Welt der LLMs einsteigen willst, nimm am Kurs Master Large Language Models (LLMs) Concepts teil und entdecke Anwendungen, Trainingsmethoden, Ethikfragen und aktuelle Forschung. Interessieren dich weitere Modelle neben Gemma, schau dir unser Tutorial Getting Started With Mixtral 8X22B an und lerne Mistral AIs neues Modell und seine Sparse Mixture of Experts (SMoE)-Architektur kennen.
Mehr über Large Language Models lernen
Kurs
Kurs
Lernpfad
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Stephen Gruppetta
12 Min.