
Cours
Concepts des grands modèles de langage (LLM)
2 h
110K
Cet article est un tutoriel complet sur l’ajustement fin de grands modèles de langage à l’aide de techniques avancées. Nous passerons par des exemples avec des Tensor Processing Units, une technique appelée LoRA, et l’informatique distribuée — le tout pour gagner en vitesse et en efficacité. Pour illustrer ces techniques, nous accéderons aux modèles Gemma et les ajusterons finement, une nouvelle famille de LLM légers et de pointe créée par Google.
À la fin du tutoriel, vous saurez ajuster finement n’importe quel grand modèle de langage et exécuter l’inférence en vous appuyant sur les TPU disponibles sur Google Cloud. Pour y parvenir, nous aborderons les sujets suivants, dans l’ordre :
Utiliser Gemma avec des TPU : nous verrons comment configurer un environnement Kaggle pour utiliser des TPU.
Configuration du modèle et inférence : nous exécuterons Gemma avec la bibliothèque Keras en Python.
Ajustement fin : nous ajusterons finement le modèle Gemma avec la technique LoRA.
Entraînement distribué : nous réaliserons un ajustement fin distribué pour gagner en efficacité d’entraînement.
Si vous débutez en IA et avec les LLM, pensez à suivre le parcours de compétences complet AI Fundamentals pour vous familiariser avec les notions utilisées dans ce tutoriel.
Commençons !
 Logo Google Gemma
Le modèle Gemma de Google fait partie d’une famille de grands modèles de langage open source et légers, développés par Google et présentés en 2024. Gemma a été créé en s’appuyant sur les mêmes travaux et technologies que les modèles Google Gemini et, comme Gemini, Gemma est compatible avec les principaux frameworks de machine learning comme Keras et Pytorch. Il est proposé en deux tailles, avec 2B ou 7B paramètres.
Alors que Gemini vise avant tout les utilisateurs finaux via des applications et des API, Gemma est open source pour permettre une large modification et intégration par les développeurs. Les modèles Gemma sont aussi plus compacts, donc plus portables et économiques.
 Images des CPU, GPU, TPU par Freepik et Flaticon
Comparons les différentes options matérielles pour le machine learning afin de poser le contexte. Le matériel se répartit en catégories distinctes, chacune conçue pour des usages spécifiques en traitement et calcul.
Central Processing Units : les CPU font tourner les systèmes d’exploitation sur la quasi-totalité des appareils. Ils sont réputés pour traiter les tâches de manière séquentielle.
Graphics Processing Units : les GPU traitent plusieurs tâches simultanément, ce qui les rend idéaux pour le rendu graphique.
Tensor Processing Units : les TPU sont des processeurs spécialisés développés par Google pour le machine learning. Ils sont conçus pour exécuter rapidement les calculs matriciels essentiels à l’entraînement et à l’exécution des réseaux de neurones.
La dernière catégorie, les TPU, est la plus importante pour ce tutoriel. Les TPU sont plus rapides que les GPU à l’entraînement et en inférence pour les réseaux de neurones profonds ; ils consomment aussi moins d’énergie. En contrepartie, l’écosystème TPU est moins mature, avec moins d’outils et de frameworks disponibles. Les frameworks disponibles incluent la Google Cloud Platform, Colab et Kaggle.
Composant | Usage principal | Applications ML | Avantages | Disponibilité |
CPU | Tâches générales | Modèles simples | Moins chers, sobres en énergie | Très répandus |
GPU | Rendu graphique | Deep learning, traitement de gros volumes de données | Rapides pour des calculs complexes | Disponibles commercialement |
TPU | Machine learning | Réseaux neuronaux profonds, opérations matricielles à haute vitesse | Les plus rapides pour le ML, efficaces énergétiquement | Non disponibles hors Google Cloud, Colab et Kaggle |
Tableau comparatif du matériel pour le machine learning
Les modèles Gemma sont conçus pour être hautement scalables et efficaces dans des configurations distribuées, ce qui peut nettement améliorer leurs performances et leur vitesse, en particulier avec de grands volumes de données et des architectures complexes.
La bibliothèque Keras est bien adaptée ici car elle prend en charge l’entraînement distribué des modèles Gemma, en s’appuyant sur une implémentation multi-backend incluant TensorFlow et PyTorch.
Dans cette section, nous allons configurer notre notebook Kaggle pour supporter les TPU, veiller à installer toutes les bibliothèques et dépendances nécessaires, puis charger le modèle Gemma 2B ou 7B via le paquet keras-nlp. Enfin, nous déploierons le modèle pour effectuer des tâches en profitant de la puissance de calcul des TPU pour générer des réponses efficacement.
Pour préparer l’environnement, nous intégrons la version Keras du modèle Gemma et basculons l’accélérateur de calcul sur TPU pour de meilleures performances. Nous installerons les paquets essentiels comme keras-nlp, configurerons Keras pour utiliser TensorFlow comme backend, et optimiserons l’allocation mémoire du TPU pour garantir un entraînement et une exécution fluides.
Pour préparer l’environnement, nous devons ajouter l’implémentation Keras au modèle Gemma. Concrètement, cela signifie incorporer la version compatible Keras du modèle Gemma afin d’assurer une intégration fluide avec les API TensorFlow.
Pour ajouter l’implémentation Keras, procédez ainsi :
Créez un nouveau notebook dans Kaggle.
Allez dans la section « Input » du panneau de droite.
Cliquez sur « + Add Input » pour ajouter l’implémentation Keras du modèle Gemma.
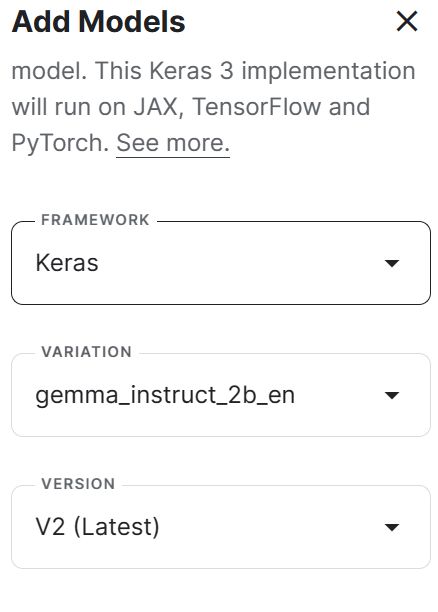 Ajout de l’implémentation Keras au modèle Gemma
Ensuite, nous devons changer l’accélérateur pour TPU, c’est-à-dire basculer l’accélérateur de calcul dans les paramètres du notebook afin de tirer parti de sa puissance pour l’entraînement et l’inférence.
Pour changer l’accélérateur, suivez ces étapes. Il est normal que le rechargement de l’environnement prenne quelques minutes.
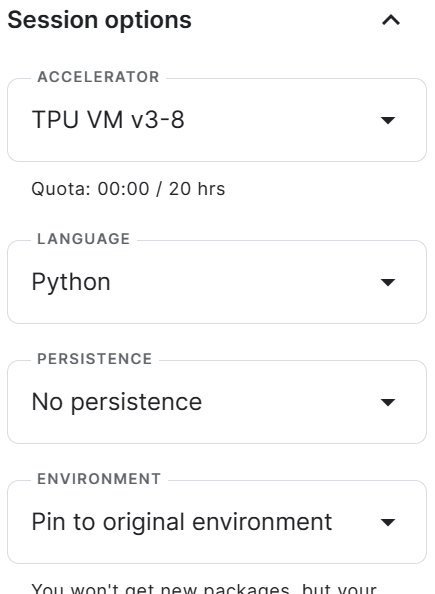 Configurer le TPU comme accélérateur
Nous installons maintenant les versions à jour des paquets Python que nous utiliserons pour l’ajustement fin et l’inférence, notamment TensorFlow et keras-nlp.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1Nous définissons le backend Keras sur JAX pour un accès fluide aux TPU. Vous pouvez aussi essayer TensorFlow ou PyTorch.
Enfin, nous préallouons la mémoire du TPU pour optimiser les performances et éviter les problèmes à l’exécution. Ici, nous allouons 100 % de la mémoire totale du TPU pour éviter la fragmentation mémoire avec le backend JAX.
import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"]="1.00"Nous chargeons les paquets Python nécessaires pour l’inférence du modèle.
import kerasimport keras_nlpNous chargeons ensuite notre modèle et affichons son résumé.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_instruct_2b_en")gemma_lm.summary()Nous avons chargé le tokenizer et le modèle en une seule commande. C’est remarquable, car même le plus petit modèle Gemma compte 2,5 milliards de paramètres et pèse 9,34 Go.
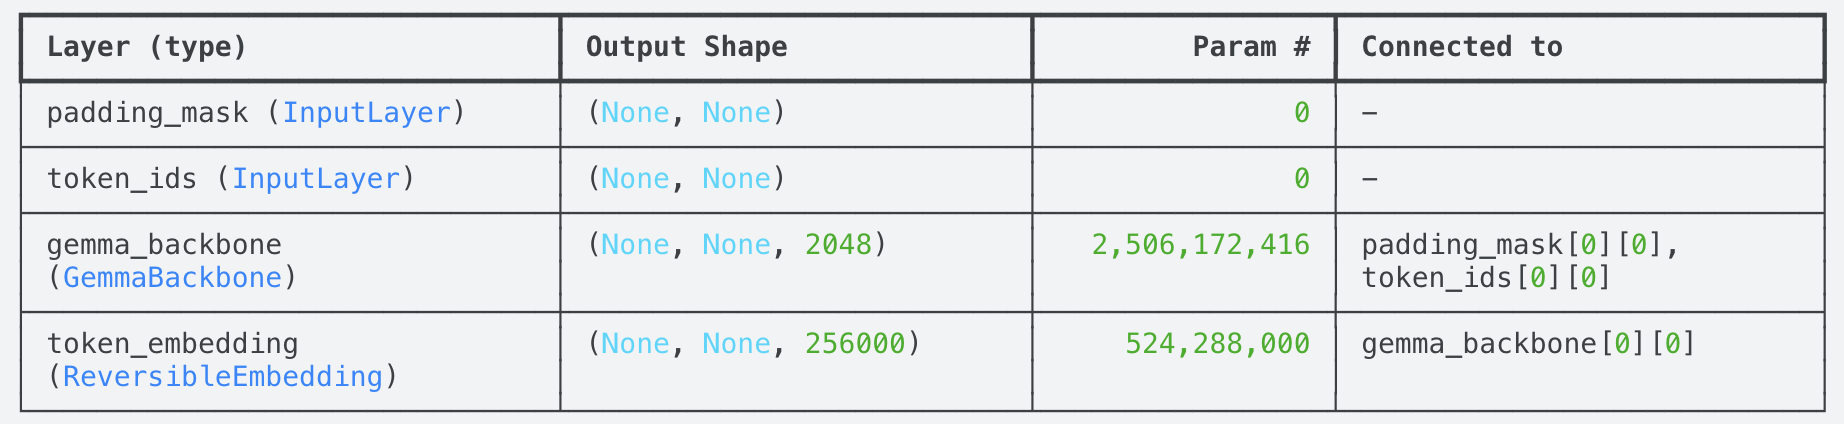 Résumé du modèle Gemma
Vous devrez peut-être patienter quelques minutes avant d’exécuter le notebook et de bénéficier de performances ultra-rapides. Les TPU sont en forte demande. Si vous lancez votre notebook la nuit, l’attente sera sans doute moindre.
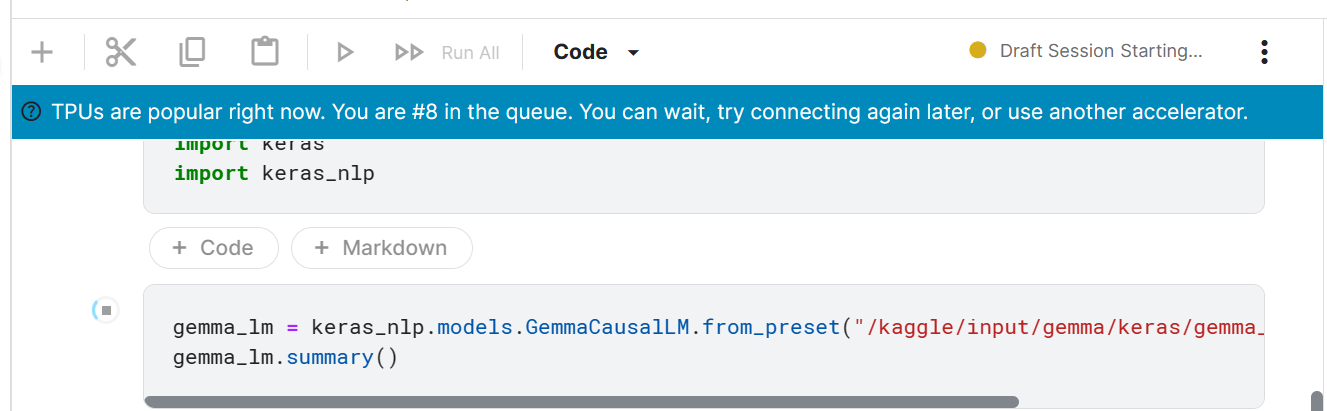 File d’attente pour l’accès aux TPU
Exécuter l’inférence consiste à utiliser notre modèle pour générer des sorties à partir de nouvelles entrées. Ici, nous fournirons ces entrées sous forme de texte via la fonction .generate(). La réponse est renvoyée immédiatement.
print(gemma_lm.generate("What is DataCamp?", max_length=30))What is DataCamp?DataCamp is a leading online data science education platform that empowers individuals and organizations to build data-driven careers. TheyNous pouvons aussi tester l’inférence par lot, c’est-à-dire fournir plusieurs invites pour générer plusieurs réponses. La sortie est une liste.
print(gemma_lm.generate(["How far is the Sun from earth", "What is the Sun made of?"], max_length=30))['How far is the Sun from earth?\n\nThe Sun is about 149.6 million kilometers (93 million miles) away from', 'What is the Sun made of?\n\nThe Sun is primarily composed of hydrogen and helium. Hydrogen makes up about 73.4% of']Nous allons maintenant créer un modèle d’invite avec des instructions et des réponses pour guider le modèle. Vous pouvez ajouter un prompt système ou toute consigne initiale pour influer sur la réponse générée.
Nous utiliserons la fonction .format() pour renseigner le texte du modèle avec les arguments utilisateur. Au final, nous obtenons une liste d’étapes à suivre pour apprendre Python.
template = "Instruction:\n{instruction}\n\nResponse:\n{response}"prompt = template.format( instruction="How do I start learning Python?", response="",)print(gemma_lm.generate(prompt, max_length=250))Instruction:How do I start learning Python?Response:**Step 1: Choose a learning path*** **Online Courses:** * DataCamp * Codecademy * Coursera * edX * Udemy* **Books:** * "Automate the Boring Stuff with Python" by Al Sweigart * "Python Crash Course" by Eric Matthes * "Head First Python" by Kathy Sierra and Bert Bates* **Video Tutorials.........Si vous avez des difficultés à charger le modèle et à générer une réponse avec des TPU, consultez ce notebook Kaggle : Accessing Gemma-instruct-2b-en using TPUs.
Si vous commencez à être à l’aise avec Gemma, découvrez comment l’améliorer avec des consignes personnalisées en lisant notre tutoriel Fine Tuning Google Gemma: Enhancing LLMs with Customized Instructions.
Voyons maintenant comment ajuster finement le modèle Gemma à l’aide d’un jeu de données public appelé OpenHermes. Le jeu de données OpenHermes contient 242 000 lignes avec deux colonnes, l’une pour les instructions, l’autre pour les réponses, toutes générées avec le modèle GPT-4.
Comme nous allons le voir, ajuster finement cet ensemble prendrait longtemps, même avec des TPU. Pour accélérer, nous intégrerons une technique appelée LoRA.
LoRA, pour Low-Rank Adaptation, vise à rendre l’ajustement fin des grands modèles de langage plus efficace et accessible. Elle répond aux défis des méthodes classiques, souvent coûteuses en calcul et en ressources.
Techniquement, LoRA fige les poids pré-entraînés du modèle et introduit des matrices de faible rang qui modifient des parties ciblées de l’architecture. En se concentrant sur ces matrices de faible rang, LoRA réduit les besoins de calcul, rendant possible l’ajustement fin de grands modèles sur un matériel moins puissant.
Comme pour la configuration précédente, nous définissons le backend Keras et la préallocation mémoire. Nous pouvons aussi utiliser la fonction jax. devices() pour vérifier la disponibilité des TPU.
import osimport jaxos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"jax.devices()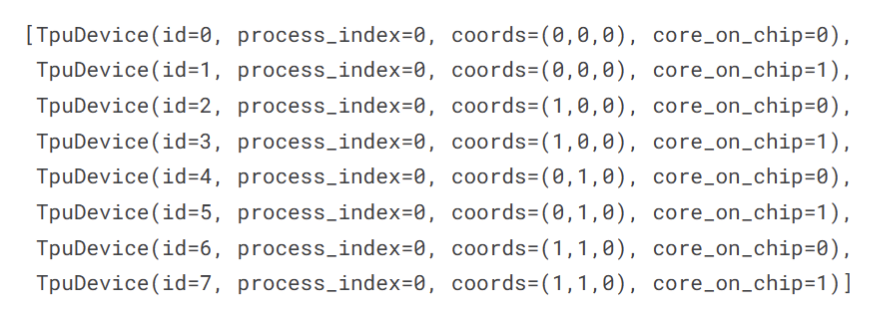
Nombre d’appareils de calcul
Nous chargeons le modèle et affichons le résumé. Nous avons 2,5 milliards de paramètres entraînables.
import kerasimport keras_nlpgemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_2b_en")gemma_lm.summary()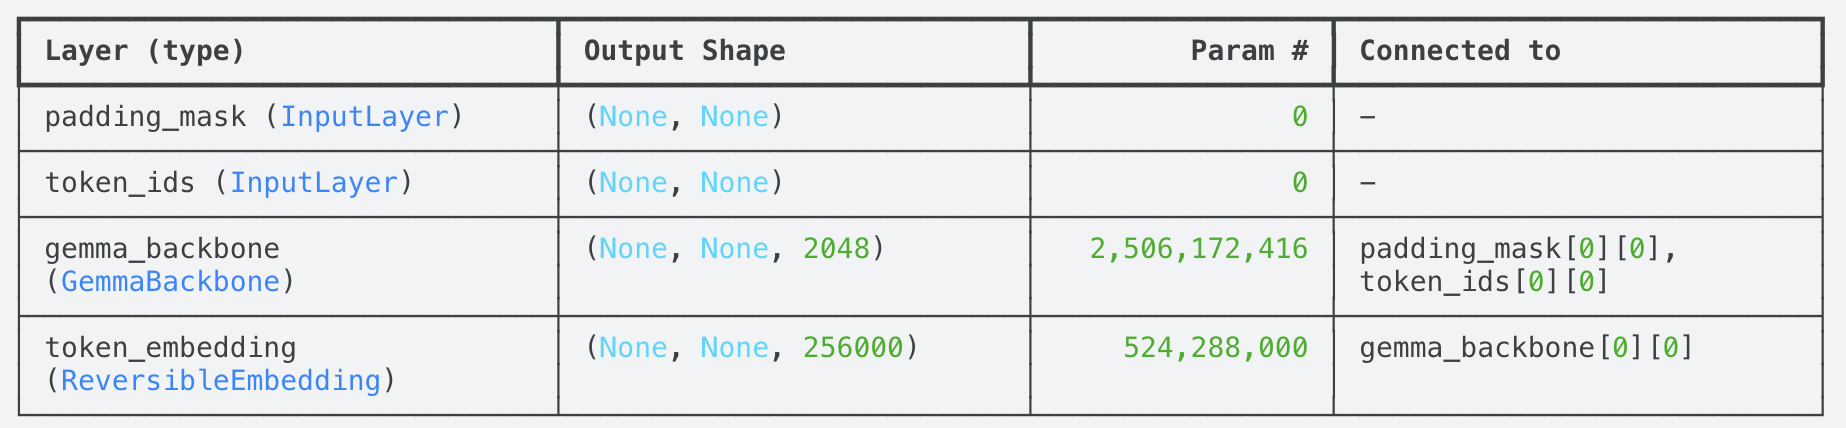 Résumé du modèle Gemma
Nous chargeons ensuite le jeu de données dans le notebook. Le processus est similaire à l’ajout du modèle. Procédez ainsi :
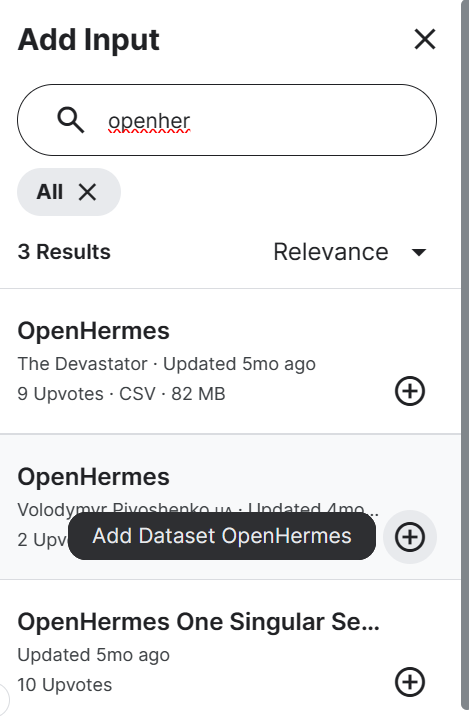
Ajout du jeu de données OpenHermes
Nous utilisons maintenant la bibliothèque pandas pour lire le jeu de données et afficher les 5 premières lignes. On observe 2 colonnes, une pour l’instruction et une pour la sortie.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')df.head()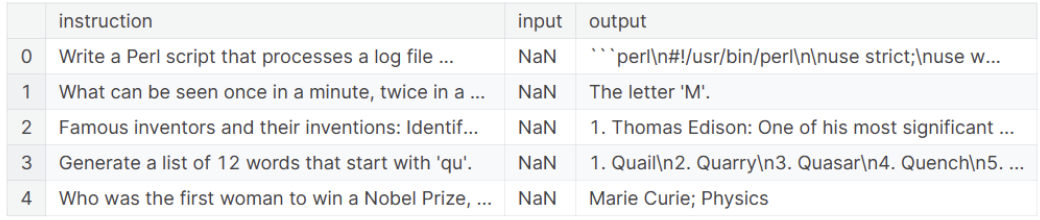
Jeu de données OpenHermes
Maintenant que nous avons chargé le modèle et le jeu de données, nous devons fournir au modèle un jeu de données au bon format. Pour cela, nous convertissons le jeu en une liste de chaînes suivant le format instruction/réponse.
À noter : entraîner l’ensemble complet prendrait près de 23 heures, même sur TPU. Nous ne sélectionnerons donc que les 1 000 premiers exemples pour réduire le temps d’entraînement.
template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]data = data[:1000]print(data[0])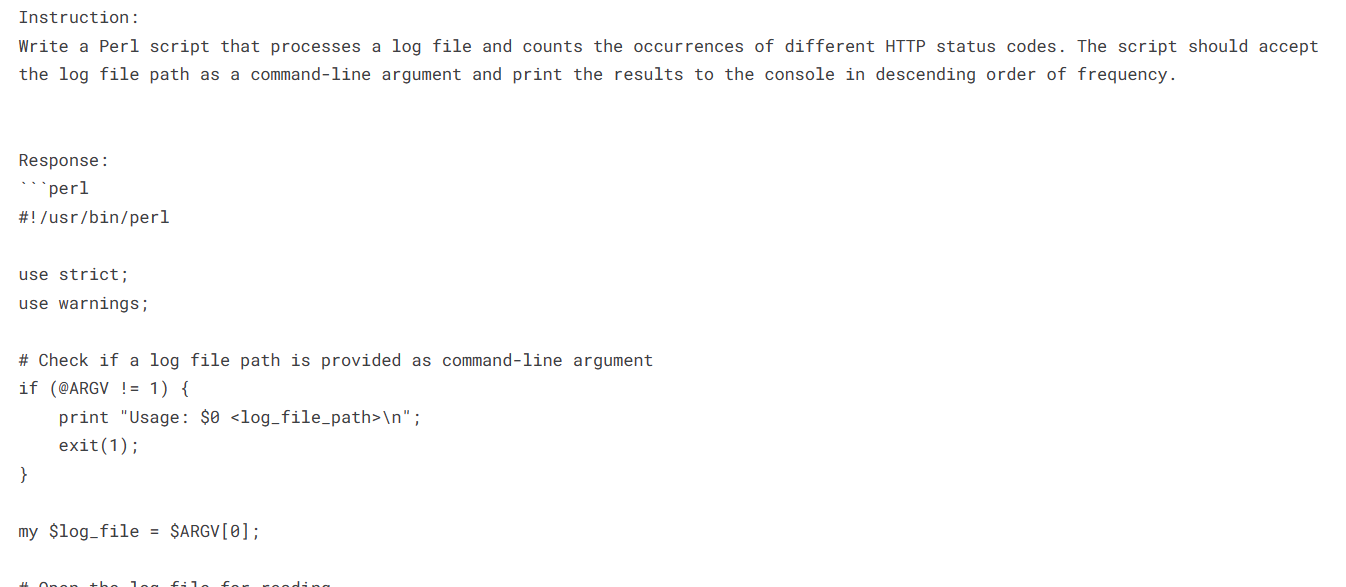
Premier exemple du jeu OpenHermes
Créons d’abord une base de référence à comparer avec les résultats obtenus avec LoRA. Pour cela, nous allons générer une réponse via la fonction template.format().
En lisant attentivement, on constate que la réponse de base est peu détaillée. Gemma commence même à se répéter après la fin de la première réponse. Ce n’est pas idéal, mais cela illustre bien la nécessité d’ajuster finement le modèle pour obtenir de meilleures réponses.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-dayAméliorons maintenant notre modèle avec LoRA, qui réduit le nombre de paramètres entraînables pour les tâches aval.
Dans notre exemple, nous utiliserons un rang LoRA de 4, le plus petit rang efficace. Les rangs 8 ou 16 sont envisageables si vous souhaitez améliorer les performances. Consultez le guide Fine-Tuning LLaMA 2 pour en savoir plus sur LoRA et la quantification.
Nous précisons ensuite l’optimiseur, la fonction de perte et la métrique de précision à utiliser.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()Nos paramètres entraînables ont fortement diminué, passant de 2,5 milliards à 1,3 million. Et la couche d’adaptateur ne pèse que 5,2 Mo.
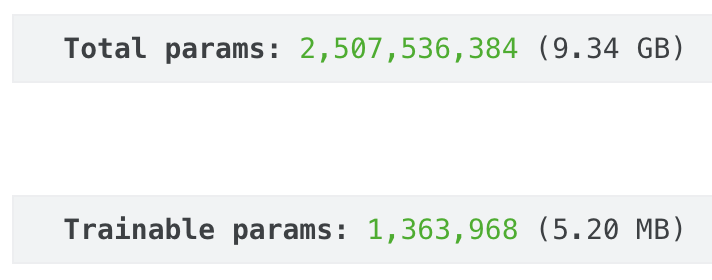
Modèle Gemma : paramètres totaux vs entraînables
Nous allons maintenant ajuster le modèle sur nos données. Ici, nous choisissons 1 epoch et une taille de lot de 1. Vous pouvez améliorer les performances en entraînant l’ensemble complet pendant au moins 5 epochs.
gemma_lm.fit(data, epochs=1, batch_size=1)Testons la même invite que pour la base de référence afin de voir si le modèle a progressé. Cette fois, au lieu de réponses lapidaires et de répétitions, le modèle propose un programme détaillé pour un séjour aux Bahamas.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1: Arrive in Nassau, BahamasUpon arrival in Nassau, you will be greeted by a local guide who will take you on a tour of the city. Visit the famous Straw Market, where you can shop for souvenirs and local crafts. Enjoy lunch at a local restaurant before heading to the Atlantis Resort for a day of fun and relaxation. Spend the afternoon exploring the resort's world-class amenities, including the Aquaventure Water Park, Dolphin Cay, and the massive marine habitat, The Dig.Day 2: Explore Paradise IslandOn day 2, you will explore Paradise Island, home to the world-famous Atlantis Resort. Visit the famous Atlantis Casino and enjoy a round of blackjack or roulette. Take a stroll along the beach and enjoy the crystal-clear waters of the Atlantic Ocean. Visit the Dolphin Cay, where you can swim with dolphins and other marine animals.Day 3: Snorkel at Cabbage BeachOn day 3, you will head to Cabbage Beach, a secluded beach located on Paradise Island. Snorkel in the crystal-clear waters and explore the coral reefs. Enjoy a delicious lunch at a local restaurant before heading back to Nassau.Vous pouvez enregistrer les poids du modèle pour l’inférence et le déployer en production.
gemma_lm.save_weights('gemma_2b_openhermes.weights.h5')La taille totale de notre modèle ajusté finement est de 10,04 Go.
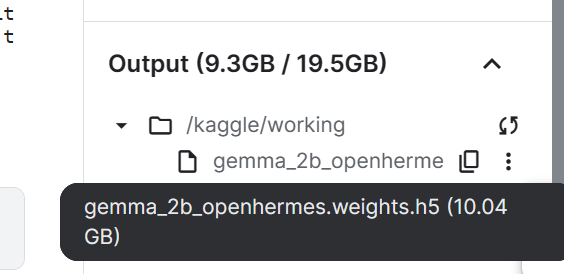 Fichier du modèle Gemma ajusté finement et enregistré
Si vous rencontrez des difficultés lors de l’ajustement fin, vous pouvez consulter ce notebook Kaggle : Finetuning Gemma using TPUs
Pour finir, examinons de près l’ajustement fin distribué. Il est rendu possible par le parallélisme de modèle, qui répartit les poids d’un même modèle sur plusieurs appareils, permet une mise à l’échelle horizontale et accélère l’entraînement.
Dans cette partie, nous réduirons significativement le temps d’entraînement d’un grand modèle. Concrètement, nous utiliserons Keras avec un backend JAX pour ajuster finement Gemma avec LoRA et un entraînement distribué sur TPU.
Nous lançons ici un nouveau notebook Kaggle et installons les bibliothèques nécessaires. Nous définissons ensuite le backend Keras et préallouons la mémoire.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"Nous allons d’abord créer un DeviceMesh pour charger des poids et tenseurs du modèle répartis sur plusieurs TPU. Il permet le parallélisme de données et de modèle, pour faire évoluer efficacement les LLM sur plusieurs accélérateurs.
Créez un DeviceMesh de forme (1, 8), afin de fragmenter les poids du modèle sur les 8 TPU.
import kerasimport keras_nlpdevice_mesh = keras.distribution.DeviceMesh( (1, 8), ["batch", "model"], devices=keras.distribution.list_devices())Ensuite, nous créerons une carte de disposition (layout map) indiquant, via des RegEx, comment fragmenter ou répliquer les poids et tenseurs.
Gardez à l’esprit les points suivants :
Les poids correspondant à token_embedding/embeddings seront partagés.
Utilisez des RegEx pour faire correspondre les matrices requête, clé et valeur dans le decoder attention, attention_output, ffw_gating et ffw_linear.
Les tenseurs correspondants sont fragmentés via le DeviceMesh, le reste est entièrement répliqué.
model_dim = "model"layout_map = keras.distribution.LayoutMap(device_mesh)layout_map["token_embedding/embeddings"] = (None, model_dim)layout_map["decoder_block.*attention.*(query|key|value).*kernel"] = ( None, model_dim, None,)layout_map["decoder_block.*attention_output.*kernel"] = (None, None, model_dim)layout_map["decoder_block.*ffw_gating.*kernel"] = (model_dim, None)layout_map["decoder_block.*ffw_linear.*kernel"] = (None, model_dim)Nous allons maintenant activer le parallélisme de modèle en utilisant device_mesh et layout_map.
model_parallel = keras.distribution.ModelParallel( device_mesh, layout_map, batch_dim_name="batch")keras.distribution.set_distribution(model_parallel)Après avoir configuré le parallélisme de modèle, chargeons notre modèle.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_7b_en")gemma_lm.summary()Cette fois, comme nous utilisons le modèle Gemma 7B, nous observons 8,5 milliards de paramètres entraînables.
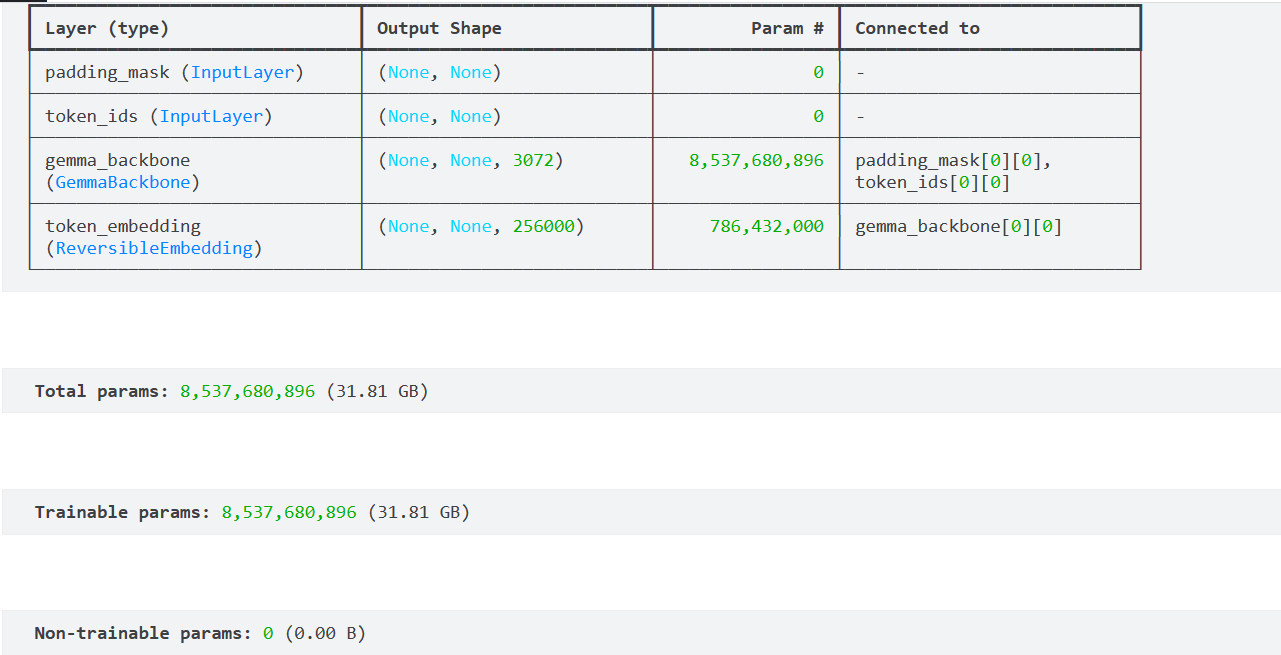 Résumé du modèle Gemma 7B
Pour vérifier que le modèle a bien été fragmenté, nous allons afficher le path, la shape et le spec des poids de la couche decoder_block_1.
decoder_block_1 = gemma_lm.backbone.get_layer('decoder_block_1')print(type(decoder_block_1))for variable in decoder_block_1.weights: print(f'{variable.path:<58} {str(variable.shape):<16} {str(variable.value.sharding.spec)}')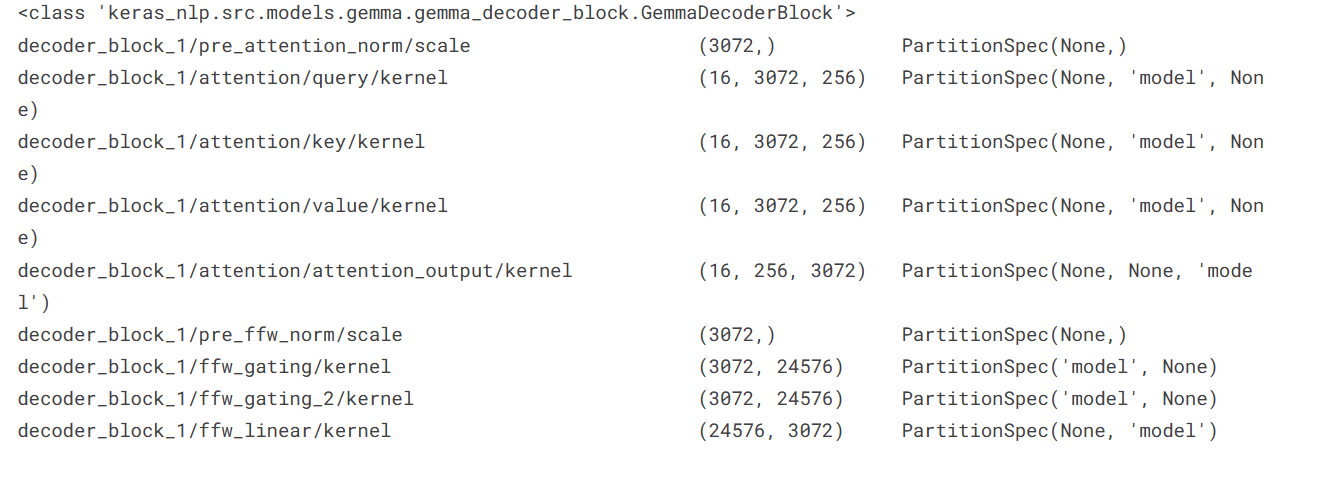
Bloc de décodage
Chargeons le jeu de données OpenHermes. À nouveau, nous convertissons le DataFrame en liste de chaînes avec le modèle instruction/réponse et, pour accélérer l’entraînement, nous ne retenons que les 1 000 premiers exemples.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')# Format and convert the dataframe into a list of strings.template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]# Select a subset of the dataset. data = data[:1000]Nous allons maintenant générer la réponse de référence en fournissant l’invite formatée. Fait intéressant, la réponse est encore moins bonne que celle du modèle plus petit — poursuivons malgré tout.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256)) 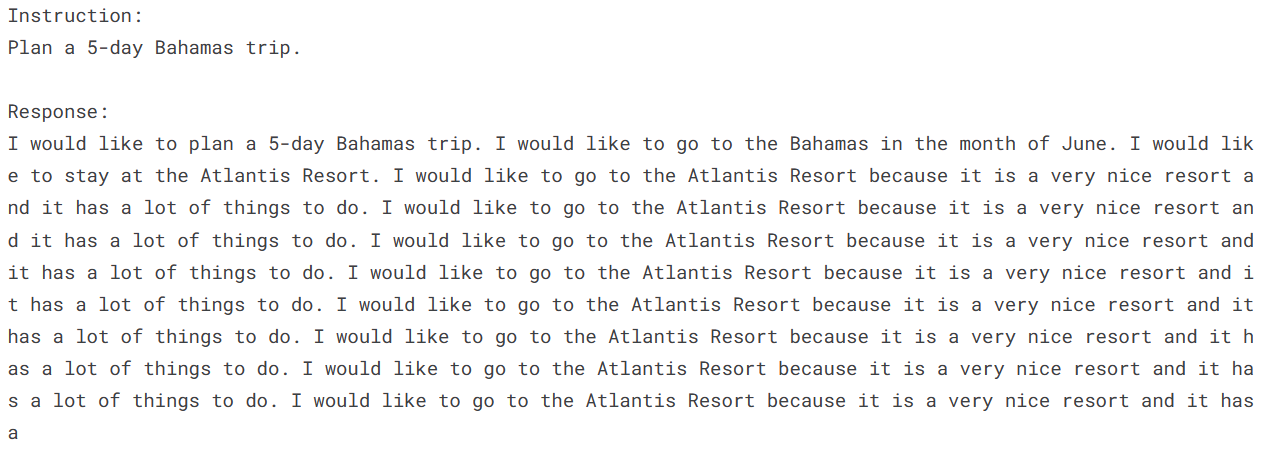 Résultat d’inférence avant l’ajustement fin
Nous allons compiler le modèle avec les mêmes configurations, le même rang LoRA, l’optimiseur, la fonction de perte et la métrique de précision. Nous obtenons désormais 11 millions de paramètres entraînables pour une taille de 42,22 Mo.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()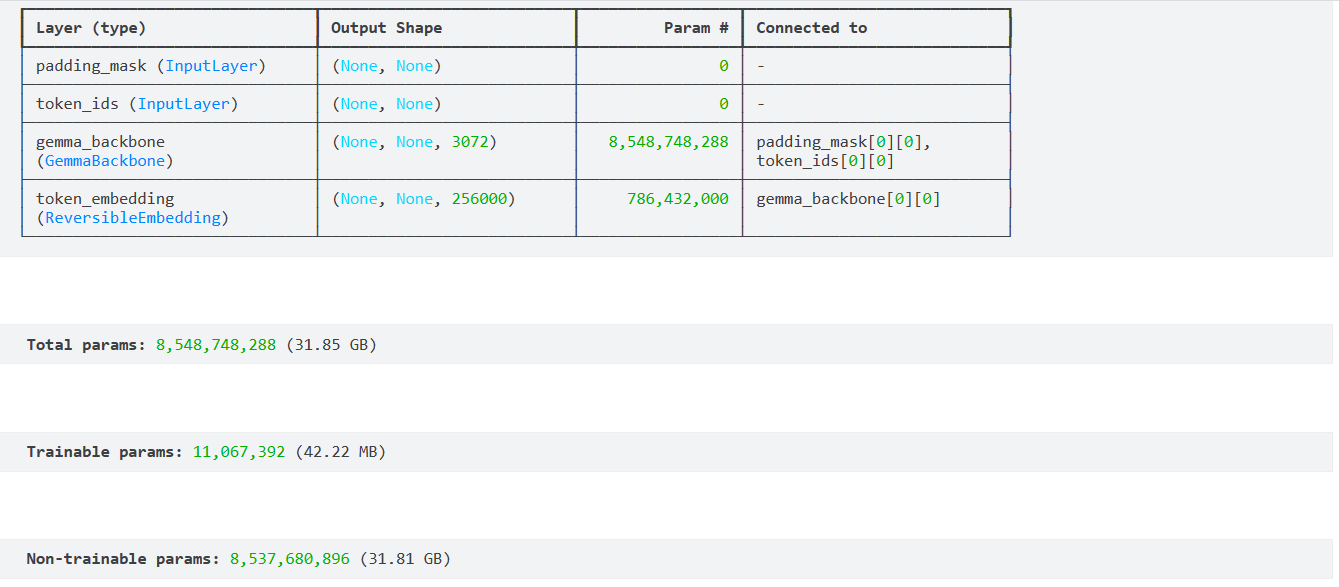 Résumé du modèle Gemma 7B avec LoRA
Il nous a fallu 305 secondes pour ajuster une epoch, ce qui est excellent au vu de la taille du modèle.
gemma_lm.fit(data, epochs=1, batch_size=1)
Si l’ajustement fin vous semble complexe, vous pouvez apprendre à utiliser l’API d’OpenAI et suivre un guide pas à pas pour ajuster GPT-4.
Générons la réponse et comparons-la au résultat de référence.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Le modèle ajusté est excellent. Il a généré une liste d’actions pour profiter au mieux de votre séjour de cinq jours aux Bahamas.
Remarque : vous pouvez désactiver LoRA pour un réglage complet des paramètres, plus lent mais potentiellement plus précis, avec le parallélisme de modèle.
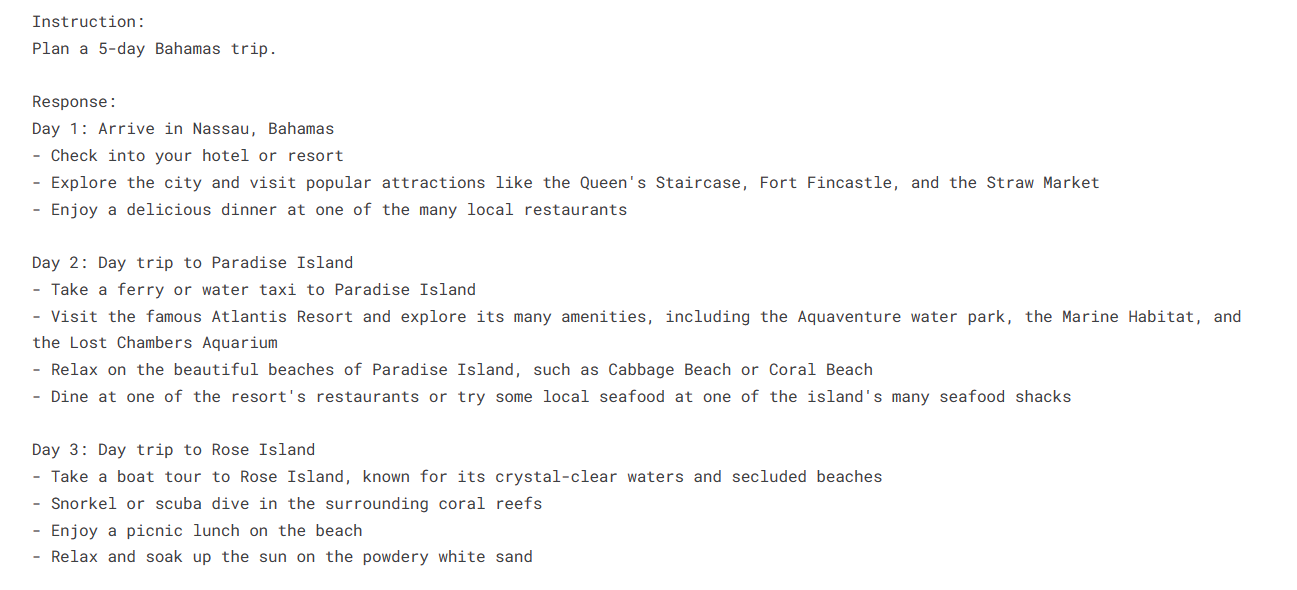 Résultat d’inférence après l’ajustement fin
gemma_lm.save_weights('gemma_7b_openhermes.weights.h5')Encore une fois, si vous avez des difficultés avec l’ajustement fin distribué, vous pouvez consulter ce notebook Kaggle en complément : Accessing Gemma-instruct-2b-en using TPUs.
Dans ce tutoriel, nous avons découvert les TPU et comment les utiliser pour accélérer la génération de réponses des LLM. Nous avons aussi appris à ajuster finement les modèles Gemma sur le jeu de données OpenHermes avec des TPU et un entraînement distribué.
Ajuster finement des LLM sur TPU et utiliser le parallélisme de modèle pour l’apprentissage distribué sont deux leviers clés pour réduire le temps d’entraînement. Grâce à l’apprentissage distribué, vous pouvez ajuster même de très grands modèles comme Gemma 7B. En tirant parti des TPU, spécialement conçus pour des tâches de machine learning haute performance, vous accélérez sensiblement les phases d’entraînement et d’inférence.
Si ce tutoriel vous a plu et que vous souhaitez approfondir l’univers des grands modèles de langage, suivez le cours Master Large Language Models (LLMs) Concepts pour découvrir tout le potentiel des applications des LLM, les méthodes d’entraînement, les enjeux éthiques et les dernières avancées de la recherche. Si vous vous intéressez à d’autres grands modèles concurrents de Gemma, consultez notre tutoriel Getting Started With Mixtral 8X22B pour en savoir plus sur le nouveau modèle de Mistral AI et son architecture SMoE (sparse mixture of experts).
En savoir plus sur les grands modèles de langage
Cours
Cours
Cursus