Kursus
Pengantar Python
4 jam
7.1M
Ekonom Italia Vilfredo Pareto menyatakan bahwa 80% dampak berasal dari 20% penyebab, yang dikenal sebagai aturan 80/20 atau prinsip Pareto. Demikian pula, 80% bisnis perusahaan berasal dari 20% pelanggan. Perusahaan perlu mengidentifikasi pelanggan teratas tersebut dan menjaga hubungan dengan mereka untuk memastikan pendapatan berkelanjutan. Untuk mempertahankan hubungan jangka panjang dengan pelanggan, perusahaan perlu menjadwalkan skema loyalitas seperti diskon, penawaran, kupon, poin bonus, dan hadiah.
Menargetkan pelanggan baru lebih mahal daripada mempertahankan pelanggan yang sudah ada karena Anda tidak perlu mengeluarkan sumber daya, waktu, dan kerja keras untuk mendapatkan pelanggan baru. Anda hanya perlu membuat pelanggan yang sudah ada tetap puas. Analis bisnis menghitung biaya akuisisi pelanggan secara akurat menggunakan CLTV (Customer Lifetime Value). CLTV menunjukkan total pendapatan dari pelanggan selama seluruh hubungan. CLTV membantu perusahaan untuk fokus pada pelanggan potensial yang dapat membawa lebih banyak pendapatan di masa depan.
"Customer Lifetime Value adalah nilai moneter yang mewakili jumlah pendapatan atau laba yang akan diberikan pelanggan kepada perusahaan selama periode hubungan". CLTV menunjukkan implikasi dari memperoleh pelanggan jangka panjang dibandingkan dengan pelanggan jangka pendek. Customer lifetime value (CLV) dapat membantu Anda menjawab pertanyaan terpenting tentang penjualan bagi setiap perusahaan:
Ada banyak pendekatan yang tersedia untuk menghitung CLTV. Setiap orang punya pandangan masing-masing. Untuk menghitung CLTV kita memerlukan data historis pelanggan, tetapi Anda tidak akan bisa menghitung untuk pelanggan baru. Untuk menyelesaikan masalah ini, Analis Bisnis mengembangkan model machine learning untuk memprediksi CLTV pelanggan baru. Mari jelajahi beberapa pendekatan untuk Perhitungan CLTV:
1) Anda dapat menghitungnya dengan menjumlahkan laba/pendapatan dari pelanggan dalam suatu siklus tertentu. Contoh, jika pelanggan telah bersama Anda selama 3 tahun terakhir, Anda dapat menjumlahkan semua laba dalam 3 tahun tersebut. Anda dapat merata-ratakan laba secara tahunan, setengah tahunan, atau bulanan, tetapi dengan pendekatan ini Anda tidak dapat membangun model prediktif untuk pelanggan baru.
2) Bangun model regresi untuk pelanggan yang sudah ada. Ambil data enam bulan terakhir sebagai variabel independen dan total pendapatan selama tiga tahun sebagai variabel dependen lalu bangun model regresi pada data ini.
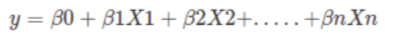
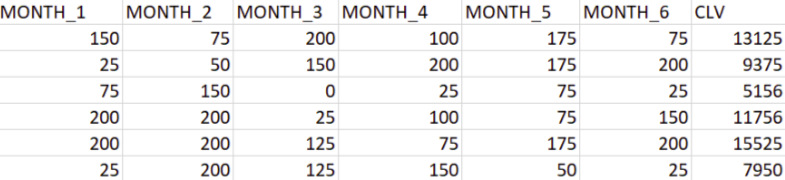
3) CLTV juga dapat diimplementasikan menggunakan nilai RFM (Recency, Frequency, Monetary). Untuk detail lebih lanjut, Anda dapat merujuk ke tutorial saya.
4) Menggunakan persamaan berikut: CLTV = ((Nilai Pesanan Rata-rata x Frekuensi Pembelian)/Churn Rate) x Margin laba.
Customer Value = Average Order Value * Purchase Frequency
Average Order Value (AOV): Nilai pesanan rata-rata adalah rasio antara total pendapatan dan total jumlah pesanan. AOV merepresentasikan jumlah pendapatan rata-rata yang dikeluarkan pelanggan pada satu pesanan.
Average Order Value = Total Revenue / Total Number of Orders
Purchase Frequency (PF): Frekuensi pembelian adalah rasio antara total jumlah pesanan dan total jumlah pelanggan. Ini merepresentasikan jumlah pesanan rata-rata yang dilakukan setiap pelanggan.
Purchase Frequency = Total Number of Orders / Total Number of Customers
Churn Rate: Churn rate adalah persentase pelanggan yang tidak memesan lagi.
Customer Lifetime: Customer lifetime adalah periode waktu ketika pelanggan terus-menerus melakukan pemesanan.
Customer Lifetime=1/Churn Rate
Repeat Rate: Repeat rate dapat didefinisikan sebagai rasio antara jumlah pelanggan dengan lebih dari satu pesanan terhadap jumlah pelanggan unik. Contoh: Jika Anda memiliki 10 pelanggan dalam sebulan dan 4 di antaranya kembali, repeat rate Anda adalah 40%.
Churn Rate= 1-Repeat Rate
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
import numpy as np
Mari terlebih dahulu memuat dataset Online Retail yang diperlukan menggunakan fungsi read CSV dari pandas. Anda dapat mengunduh datanya dari sini.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
| InvoiceNo | StockCode | Description | Quantity | InvoiceDate | UnitPrice | CustomerID | Country | |
|---|---|---|---|---|---|---|---|---|
| 0 | 536365 | 85123A | WHITE HANGING HEART T-LIGHT HOLDER | 6 | 2010-12-01 08:26:00 | 2.55 | 17850.0 | United Kingdom |
| 1 | 536365 | 71053 | WHITE METAL LANTERN | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 2 | 536365 | 84406B | CREAM CUPID HEARTS COAT HANGER | 8 | 2010-12-01 08:26:00 | 2.75 | 17850.0 | United Kingdom |
| 3 | 536365 | 84029G | KNITTED UNION FLAG HOT WATER BOTTLE | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 4 | 536365 | 84029E | RED WOOLLY HOTTIE WHITE HEART. | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
Terkadang Anda mendapatkan dataset yang berantakan. Anda mungkin harus menangani duplikat, yang akan mengacaukan analisis Anda. Di Python, pandas menyediakan fungsi drop_duplicates(), yang menghapus catatan berulang atau duplikat.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fe677a887f0>
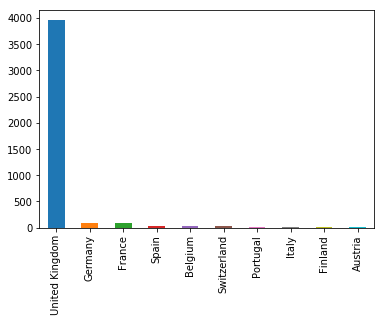
Pada dataset yang diberikan, Anda dapat melihat sebagian besar pelanggan berasal dari "United Kingdom". Jadi, Anda dapat memfilter data untuk pelanggan United Kingdom.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 495478 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      495478 non-null object
StockCode      495478 non-null object
Description    494024 non-null object
Quantity       495478 non-null int64
InvoiceDate    495478 non-null datetime64[ns]
UnitPrice      495478 non-null float64
CustomerID     361878 non-null float64
Country        495478 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 34.0+ MB
Fungsi describe() di pandas memudahkan untuk mendapatkan berbagai statistik ringkasan. Fungsi ini mengembalikan jumlah, mean, standar deviasi, nilai minimum dan maksimum serta kuantil dari data.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 495478.000000 | 495478.000000 | 361878.000000 |
| mean | 8.605486 | 4.532422 | 15547.871368 |
| std | 227.588756 | 99.315438 | 1594.402590 |
| min | -80995.000000 | -11062.060000 | 12346.000000 |
| 25% | 1.000000 | 1.250000 | 14194.000000 |
| 50% | 3.000000 | 2.100000 | 15514.000000 |
| 75% | 10.000000 | 4.130000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Di sini, Anda dapat melihat beberapa pelanggan memesan dalam kuantitas negatif, yang tidak mungkin. Jadi, Anda perlu memfilter Quantity lebih besar dari nol.
uk_data = uk_data[(uk_data['Quantity']>0)]
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 486286 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      486286 non-null object
StockCode      486286 non-null object
Description    485694 non-null object
Quantity       486286 non-null int64
InvoiceDate    486286 non-null datetime64[ns]
UnitPrice      486286 non-null float64
CustomerID     354345 non-null float64
Country        486286 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.4+ MB
Di sini, Anda dapat memfilter kolom yang diperlukan untuk menghitung CLTV. Anda hanya memerlukan lima kolom CustomerID, InvoiceDate, InvoiceNo, Quantity, dan UnitPrice.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
#Calulate total purchase
uk_data['TotalPurchase'] = uk_data['Quantity'] * uk_data['UnitPrice']
Di sini, Anda akan melakukan operasi berikut:
uk_data_group=uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (date.max() - date.min()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'Quantity': lambda quant: quant.sum(),
                                        'TotalPurchase': lambda price: price.sum()})
uk_data_group.head()
| InvoiceDate | InvoiceNo | Quantity | TotalPurchase | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
# Change the name of columns
uk_data_group.columns=['num_days','num_transactions','num_units','spent_money']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
 CLTV = ((Average Order Value x Purchase Frequency)/Churn Rate) x Profit margin.

 Customer Value = Average Order Value * Purchase Frequency
# Average Order Value
uk_data_group['avg_order_value']=uk_data_group['spent_money']/uk_data_group['num_transactions']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | |
|---|---|---|---|---|---|
| CustomerID | |||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 |
purchase_frequency=sum(uk_data_group['num_transactions'])/uk_data_group.shape[0]
# Repeat Rate
repeat_rate=uk_data_group[uk_data_group.num_transactions > 1].shape[0]/uk_data_group.shape[0]
#Churn Rate
churn_rate=1-repeat_rate
purchase_frequency,repeat_rate,churn_rate
(90.37107880642694, 0.9818923743942872, 0.018107625605712774)
Profit margin adalah rasio profitabilitas yang umum digunakan. Ini merepresentasikan berapa persen dari total penjualan yang diperoleh sebagai laba. Misalkan bisnis kita memiliki laba sekitar 5% dari total penjualan.
# Profit Margin
uk_data_group['profit_margin']=uk_data_group['spent_money']*0.05
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 |
# Customer Value
uk_data_group['CLV']=(uk_data_group['avg_order_value']*purchase_frequency)/churn_rate
#Customer Lifetime Value
uk_data_group['cust_lifetime_value']=uk_data_group['CLV']*uk_data_group['profit_margin']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | CLV | cust_lifetime_value | |
|---|---|---|---|---|---|---|---|---|
| CustomerID | ||||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 | 3.852060e+08 | 1.486579e+12 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 | 2.033140e+05 | 4.265538e+07 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 | 3.661610e+04 | 6.173424e+07 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 | 1.025963e+05 | 2.098545e+07 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 | 7.971198e+04 | 3.755789e+06 |
Mari bangun model prediksi CLTV.
Di sini, Anda akan memprediksi CLTV menggunakan Model Regresi Linier.
Mari gunakan terlebih dahulu data yang dimuat dan difilter di atas.
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
Ekstrak bulan dan tahun dari InvoiceDate.
uk_data['month_yr'] = uk_data['InvoiceDate'].apply(lambda x: x.strftime('%b-%Y'))
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
Tabel pivot mengambil kolom sebagai masukan, dan mengelompokkan entri ke dalam tabel dua dimensi sehingga memberikan rangkuman multidimensi dari data.
sale=uk_data.pivot_table(index=['CustomerID'],columns=['month_yr'],values='TotalPurchase',aggfunc='sum',fill_value=0).reset_index()
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 |
Mari jumlahkan seluruh penjualan per bulan.
sale['CLV']=sale.iloc[:,2:].sum(axis=1)
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 | CLV |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 | 4196.01 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 | 32619.36 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 | 4090.88 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 | 942.34 |
Di sini, Anda perlu membagi kolom yang diberikan menjadi dua jenis variabel: variabel dependen (atau variabel target) dan variabel independen (atau variabel fitur). Pilih 6 bulan terakhir sebagai variabel independen.
X=sale[['Dec-2011','Nov-2011', 'Oct-2011','Sep-2011','Aug-2011','Jul-2011']]
y=sale[['CLV']]
Untuk memahami kinerja model, membagi dataset menjadi train set dan test set adalah strategi yang baik.
Mari bagi dataset menggunakan fungsi train_test_split(). Anda perlu memberikan 3 parameter: fitur, target, dan ukuran test_set. Selain itu, Anda dapat menggunakan random_state sebagai nilai seed untuk menjaga reprodusibilitas, yang berarti kapan pun Anda membagi data tidak akan memengaruhi hasil. Juga, jika random_state None, maka generator angka acak menggunakan np.random untuk memilih catatan secara acak. Artinya jika Anda tidak menyetel seed, hasilnya berbeda setiap kali.
#split training set and test set
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y,random_state=0)
Pertama, impor modul Linear Regression dan buat objek Linear Regression. Lalu, latih model Anda pada train set menggunakan fungsi fit() dan lakukan prediksi pada test set menggunakan fungsi predict().
# import model
from sklearn.linear_model import LinearRegression

# instantiate
linreg = LinearRegression()

# fit the model to the training data (learn the coefficients)
linreg.fit(X_train, y_train)

# make predictions on the testing set
y_pred = linreg.predict(X_test)
# print the intercept and coefficients
print(linreg.intercept_)
print(linreg.coef_)
[208.50969617]
[[0.99880551 0.80381254 1.60226829 1.67433228 1.52860813 2.87959449]]
Untuk mengevaluasi kesesuaian keseluruhan model linier, kita menggunakan nilai R-squared. R-squared adalah proporsi varians yang dijelaskan oleh model. Nilai R-squared berada di antara 0 dan 1. Nilai R-squared yang lebih tinggi dianggap lebih baik karena menunjukkan varians yang lebih besar dijelaskan oleh model.
from sklearn import metrics

# compute the R Square for model
print("R-Square:",metrics.r2_score(y_test, y_pred))
R-Square: 0.9666074402817512
Model ini memiliki R-squared yang tinggi (0,96). Model ini memberikan kecocokan yang lebih baik terhadap data.
Untuk masalah regresi, metrik evaluasi berikut digunakan (Ritchie Ng):
# calculate MAE using scikit-learn
print("MAE:",metrics.mean_absolute_error(y_test,y_pred))

#calculate mean squared error
print("MSE",metrics.mean_squared_error(y_test, y_pred))
# compute the RMSE of our predictions
print("RMSE:",np.sqrt(metrics.mean_squared_error(y_test, y_pred)))
MAE: 595.0282284701234
MSE 2114139.8898678957
RMSE: 1454.0082151995896
RMSE lebih populer daripada MSE dan MAE karena RMSE dapat ditafsirkan dengan y karena memiliki satuan yang sama.
CLTV membantu Anda menyusun rencana bisnis yang efektif dan juga memberikan kesempatan untuk menumbuhkan bisnis Anda. CLTV menggambar segmen pelanggan yang bermakna; segmen ini dapat membantu Anda mengidentifikasi kebutuhan dari segmen yang berbeda-beda.
Customer Lifetime Value adalah alat, bukan strategi. CLTV dapat mengetahui pelanggan yang paling menguntungkan, tetapi bagaimana Anda akan mendapatkan laba dari mereka bergantung pada strategi Anda. Secara umum, model CLTV sering membingungkan dan disalahgunakan. Obsesi terhadap CLTV dapat menciptakan pandangan yang sempit. Perusahaan hanya fokus mencari kelompok pelanggan terbaik lalu berfokus pada mereka dan mengulang bisnis, tetapi penting juga untuk memberi perhatian kepada pelanggan lainnya.
Selamat, Anda telah mencapai akhir dari tutorial ini!
Dalam tutorial ini, Anda telah membahas banyak detail tentang Customer Lifetime Value. Anda telah mempelajari apa itu customer lifetime value, pendekatan untuk menghitung CLTV, implementasi CLTV dari nol di Python, model prediksi untuk CLTV, serta Kelebihan dan Kekurangannya. Anda juga membahas beberapa konsep dasar pandas seperti groupby dan pivot table untuk meringkas kolom dan baris data terpilih.
Semoga sekarang Anda dapat memanfaatkan konsep CLTV untuk menganalisis dataset Anda sendiri. Terima kasih telah membaca tutorial ini!
Jika Anda ingin mempelajari lebih lanjut tentang menganalisis data pelanggan di Python, ikuti kursus DataCamp Customer Analytics & A/B Testing in Python.
Kursus Python
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



