Curso
Introducción a Python
4 h
7M
El economista italiano Vilfredo Pareto afirmaba que el 80% del efecto procede del 20% de las causas: es la regla 80/20 o principio de Pareto. Del mismo modo, el 80% del negocio de muchas empresas proviene del 20% de sus clientes. Las compañías deben identificar a esos clientes clave y cultivar su relación para asegurar ingresos constantes. Para mantener una relación a largo plazo con los clientes, conviene planificar programas de fidelización como descuentos, ofertas, cupones, puntos y regalos.
Captar un cliente nuevo suele ser más caro que retener a uno existente: no necesitas invertir tantos recursos, tiempo ni esfuerzo en adquisición; basta con mantener satisfechos a los que ya tienes. Los analistas de negocio calculan con precisión el coste de adquisición de clientes usando el CLTV (Customer Lifetime Value). El CLTV indica los ingresos totales que aporta un cliente durante toda su relación con la empresa. Ayuda a centrarse en aquellos clientes con mayor potencial de ingresos futuros.
«Customer Lifetime Value es un valor monetario que representa la cantidad de ingresos o beneficio que un cliente aportará a la empresa durante el tiempo que dure la relación». El CLTV muestra las implicaciones de captar clientes a largo plazo frente a clientes a corto plazo. El customer lifetime value (CLV) te ayuda a responder las preguntas de ventas más importantes para cualquier empresa:
Existen muchos enfoques para calcular el CLTV. Cada cual tiene su punto de vista. Para calcularlo necesitamos datos históricos de clientes, por lo que no se puede estimar directamente para clientes nuevos. Para resolverlo, los analistas de negocio desarrollan modelos de machine learning que predicen el CLTV de nuevos clientes. Veamos algunos enfoques para calcular el CLTV:
1) Puedes calcularlo sumando el beneficio/ingresos del cliente en un período dado. Por ejemplo, si el cliente lleva contigo 3 años, suma todo el beneficio de esos 3 años. Puedes promediar por año, semestre o mes, pero con este enfoque no podrás construir un modelo predictivo para clientes nuevos.
2) Construye un modelo de regresión para clientes existentes. Usa los últimos seis meses como variables independientes y los ingresos totales de tres años como variable dependiente, y entrena un modelo de regresión con estos datos.
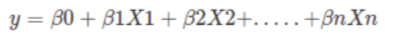
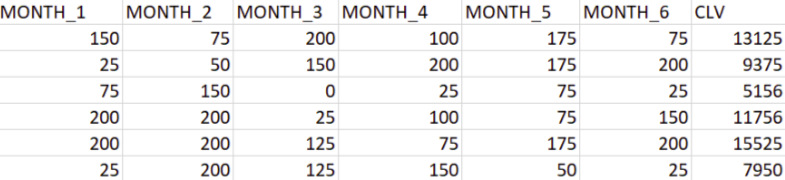
3) El CLTV también puede implementarse usando valores RFM (recencia, frecuencia y valor monetario). Para más detalles, puedes consultar mi tutorial.
4) Usando la siguiente ecuación: CLTV = ((valor medio de pedido × frecuencia de compra)/tasa de abandono) × margen de beneficio.
Customer Value = Average Order Value * Purchase Frequency
Average Order Value (AOV): el valor medio de pedido es el cociente entre los ingresos totales y el número total de pedidos. Representa la cantidad media que gasta un cliente en un pedido.
Average Order Value = Total Revenue / Total Number of Orders
Purchase Frequency (PF): la frecuencia de compra es el cociente entre el número total de pedidos y el número total de clientes. Indica el promedio de pedidos por cliente.
Purchase Frequency = Total Number of Orders / Total Number of Customers
Churn rate: la tasa de abandono es el porcentaje de clientes que no vuelven a realizar un pedido.
Customer lifetime: es el período durante el cual el cliente ha estado realizando pedidos de forma continuada.
Customer Lifetime=1/Churn Rate
Repeat rate: se define como el cociente entre el número de clientes con más de un pedido y el número de clientes únicos. Ejemplo: si tienes 10 clientes en un mes y 4 repiten, tu repeat rate es del 40%.
Churn Rate= 1-Repeat Rate
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
import numpy as np
Primero cargamos el dataset Online Retail usando la función de pandas para leer CSV/Excel. Puedes descargar los datos desde aquí.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
| InvoiceNo | StockCode | Description | Quantity | InvoiceDate | UnitPrice | CustomerID | Country | |
|---|---|---|---|---|---|---|---|---|
| 0 | 536365 | 85123A | WHITE HANGING HEART T-LIGHT HOLDER | 6 | 2010-12-01 08:26:00 | 2.55 | 17850.0 | United Kingdom |
| 1 | 536365 | 71053 | WHITE METAL LANTERN | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 2 | 536365 | 84406B | CREAM CUPID HEARTS COAT HANGER | 8 | 2010-12-01 08:26:00 | 2.75 | 17850.0 | United Kingdom |
| 3 | 536365 | 84029G | KNITTED UNION FLAG HOT WATER BOTTLE | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 4 | 536365 | 84029E | RED WOOLLY HOTTIE WHITE HEART. | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
A veces el dataset llega con ruido. Puede haber duplicados que sesguen tu análisis. En Python, pandas ofrece la función drop_duplicates(), que elimina los registros repetidos.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fe677a887f0>
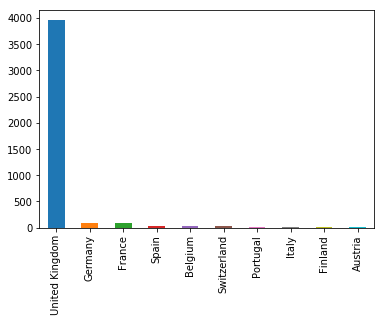
En el dataset, la mayoría de clientes son del «United Kingdom». Así que puedes filtrar los datos para clientes del Reino Unido.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 495478 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      495478 non-null object
StockCode      495478 non-null object
Description    494024 non-null object
Quantity       495478 non-null int64
InvoiceDate    495478 non-null datetime64[ns]
UnitPrice      495478 non-null float64
CustomerID     361878 non-null float64
Country        495478 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 34.0+ MB
La función describe() de pandas es muy útil para obtener estadísticas de resumen: devuelve el recuento, la media, la desviación estándar, los valores mínimo y máximo y los cuartiles.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 495478.000000 | 495478.000000 | 361878.000000 |
| mean | 8.605486 | 4.532422 | 15547.871368 |
| std | 227.588756 | 99.315438 | 1594.402590 |
| min | -80995.000000 | -11062.060000 | 12346.000000 |
| 25% | 1.000000 | 1.250000 | 14194.000000 |
| 50% | 3.000000 | 2.100000 | 15514.000000 |
| 75% | 10.000000 | 4.130000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Aquí se observa que algunos clientes han pedido cantidades negativas, lo cual no es posible. Por tanto, filtra Quantity mayor que cero.
uk_data = uk_data[(uk_data['Quantity']>0)]
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 486286 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      486286 non-null object
StockCode      486286 non-null object
Description    485694 non-null object
Quantity       486286 non-null int64
InvoiceDate    486286 non-null datetime64[ns]
UnitPrice      486286 non-null float64
CustomerID     354345 non-null float64
Country        486286 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.4+ MB
Aquí filtramos las columnas imprescindibles para calcular el CLTV. Solo necesitas cinco: CustomerID, InvoiceDate, InvoiceNo, Quantity y UnitPrice.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
#Calulate total purchase
uk_data['TotalPurchase'] = uk_data['Quantity'] * uk_data['UnitPrice']
Ahora vamos a realizar estas operaciones:
uk_data_group=uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (date.max() - date.min()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'Quantity': lambda quant: quant.sum(),
                                        'TotalPurchase': lambda price: price.sum()})
uk_data_group.head()
| InvoiceDate | InvoiceNo | Quantity | TotalPurchase | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
# Change the name of columns
uk_data_group.columns=['num_days','num_transactions','num_units','spent_money']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
 CLTV = ((Average Order Value x Purchase Frequency)/Churn Rate) x Profit margin.

 Customer Value = Average Order Value * Purchase Frequency
# Average Order Value
uk_data_group['avg_order_value']=uk_data_group['spent_money']/uk_data_group['num_transactions']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | |
|---|---|---|---|---|---|
| CustomerID | |||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 |
purchase_frequency=sum(uk_data_group['num_transactions'])/uk_data_group.shape[0]
# Repeat Rate
repeat_rate=uk_data_group[uk_data_group.num_transactions > 1].shape[0]/uk_data_group.shape[0]
#Churn Rate
churn_rate=1-repeat_rate
purchase_frequency,repeat_rate,churn_rate
(90.37107880642694, 0.9818923743942872, 0.018107625605712774)
El margen de beneficio es un ratio de rentabilidad muy usado. Representa qué porcentaje de las ventas totales se convierte en ganancia. Supongamos que nuestro negocio tiene aproximadamente un 5% de margen sobre la venta total.
# Profit Margin
uk_data_group['profit_margin']=uk_data_group['spent_money']*0.05
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 |
# Customer Value
uk_data_group['CLV']=(uk_data_group['avg_order_value']*purchase_frequency)/churn_rate
#Customer Lifetime Value
uk_data_group['cust_lifetime_value']=uk_data_group['CLV']*uk_data_group['profit_margin']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | CLV | cust_lifetime_value | |
|---|---|---|---|---|---|---|---|---|
| CustomerID | ||||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 | 3.852060e+08 | 1.486579e+12 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 | 2.033140e+05 | 4.265538e+07 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 | 3.661610e+04 | 6.173424e+07 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 | 1.025963e+05 | 2.098545e+07 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 | 7.971198e+04 | 3.755789e+06 |
Vamos a construir un modelo de predicción de CLTV.
Aquí vas a predecir el CLTV con un modelo de regresión lineal.
Primero, usa los datos cargados y filtrados arriba.
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
Extrae mes y año de InvoiceDate.
uk_data['month_yr'] = uk_data['InvoiceDate'].apply(lambda x: x.strftime('%b-%Y'))
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
La tabla dinámica (pivot table) agrupa columnas en una tabla bidimensional para ofrecer un resumen multidimensional de los datos.
sale=uk_data.pivot_table(index=['CustomerID'],columns=['month_yr'],values='TotalPurchase',aggfunc='sum',fill_value=0).reset_index()
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 |
Sumemos las ventas de todos los meses.
sale['CLV']=sale.iloc[:,2:].sum(axis=1)
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 | CLV |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 | 4196.01 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 | 32619.36 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 | 4090.88 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 | 942.34 |
Debes dividir las columnas en variable dependiente (o objetivo) e independientes (o de entrada). Selecciona los últimos 6 meses como variables independientes.
X=sale[['Dec-2011','Nov-2011', 'Oct-2011','Sep-2011','Aug-2011','Jul-2011']]
y=sale[['CLV']]
Para evaluar el rendimiento del modelo, es buena práctica dividir el dataset en entrenamiento y prueba.
Separamos el dataset con train_test_split(). Hay que pasar 3 parámetros: features, target y el tamaño del conjunto de prueba. Además, puedes usar random_state como semilla para garantizar reproducibilidad. Si random_state es None, el generador usa np.random y la partición variará en cada ejecución.
#split training set and test set
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y,random_state=0)
Importa el módulo de regresión lineal y crea el objeto. Ajusta el modelo al conjunto de entrenamiento con fit() y realiza predicciones en test con predict().
# import model
from sklearn.linear_model import LinearRegression

# instantiate
linreg = LinearRegression()

# fit the model to the training data (learn the coefficients)
linreg.fit(X_train, y_train)

# make predictions on the testing set
y_pred = linreg.predict(X_test)
# print the intercept and coefficients
print(linreg.intercept_)
print(linreg.coef_)
[208.50969617]
[[0.99880551 0.80381254 1.60226829 1.67433228 1.52860813 2.87959449]]
Para evaluar el ajuste global del modelo lineal usamos el R-cuadrado. Es la proporción de varianza explicada por el modelo y toma valores entre 0 y 1. Cuanto más alto, mejor, porque indica que el modelo explica mayor varianza.
from sklearn import metrics

# compute the R Square for model
print("R-Square:",metrics.r2_score(y_test, y_pred))
R-Square: 0.9666074402817512
Este modelo tiene un R-cuadrado alto (0,96), por lo que ajusta bien a los datos.
Para problemas de regresión se usan las siguientes métricas (Ritchie Ng):
# calculate MAE using scikit-learn
print("MAE:",metrics.mean_absolute_error(y_test,y_pred))

#calculate mean squared error
print("MSE",metrics.mean_squared_error(y_test, y_pred))
# compute the RMSE of our predictions
print("RMSE:",np.sqrt(metrics.mean_squared_error(y_test, y_pred)))
MAE: 595.0282284701234
MSE 2114139.8898678957
RMSE: 1454.0082151995896
El RMSE es más popular que MSE y MAE porque se interpreta en las mismas unidades que y.
El CLTV te ayuda a diseñar un plan de negocio eficaz y a escalar tu actividad. Permite crear segmentos de clientes con sentido, que a su vez ayudan a identificar las necesidades de cada segmento.
El customer lifetime value es una herramienta, no una estrategia. El CLTV identifica a los clientes más rentables, pero cómo rentabilizarlos depende de tu estrategia. A menudo los modelos de CLTV se confunden o se usan mal. La obsesión por el CLTV puede generar puntos ciegos: las empresas se enfocan solo en el mejor segmento y en repetir negocio con él, pero también es importante atender al resto de clientes.
¡Enhorabuena, has llegado al final del tutorial!
En este recorrido has visto en detalle qué es el customer lifetime value, distintos enfoques para calcular el CLTV, su implementación desde cero en Python, un modelo de predicción y sus pros y contras. También repasaste conceptos básicos de pandas como groupby y pivot table para resumir columnas y filas seleccionadas.
Ojalá ahora puedas aplicar el concepto de CLTV para analizar tus propios datasets. ¡Gracias por leer!
Si quieres seguir aprendiendo a analizar datos de clientes en Python, haz el curso de DataCamp Customer Analytics & A/B Testing in Python.
Cursos de Python
Curso
Curso
Curso
Tutorial
Kevin Babitz
8 min
Tutorial
Karlijn Willems
14 min
Tutorial
Zoumana Keita
15 min
Tutorial
Kurtis Pykes
8 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Avinash Navlani
10 min




