Cursus
Introductie tot Python
4 uur
7.1M
De Italiaanse econoom Vilfredo Pareto stelt dat 80% van het effect voortkomt uit 20% van de oorzaken; dit staat bekend als de 80/20-regel of het Paretoprincipe. Op dezelfde manier komt 80% van de omzet van bedrijven van 20% van de klanten. Bedrijven moeten die topklanten identificeren en de relatie met hen onderhouden om continue inkomsten te garanderen. Om een langdurige relatie met klanten te onderhouden, moeten bedrijven loyaliteitsprogramma's plannen, zoals kortingen, aanbiedingen, coupons, bonuspunten en cadeaus.
Een nieuwe klant targeten is duurder dan bestaande klanten behouden, omdat je geen middelen, tijd en extra inspanning hoeft te besteden om nieuwe klanten te werven. Je hoeft alleen je bestaande klanten tevreden te houden. Business analysts berekenen de klantacquisitiekosten nauwkeurig met CLTV (Customer Lifetime Value). CLTV geeft de totale omzet aan van de klant gedurende de hele relatie. CLTV helpt bedrijven zich te richten op die potentiële klanten die in de toekomst meer omzet kunnen opleveren.
"Customer Lifetime Value is een geldwaarde die het bedrag aan omzet of winst vertegenwoordigt dat een klant het bedrijf zal opleveren gedurende de duur van de relatie". CLTV laat het verschil zien tussen het binnenhalen van langetermijnklanten en kortetermijnklanten. Customer lifetime value (CLV) helpt je de belangrijkste verkoopvragen voor elk bedrijf te beantwoorden:
Er zijn veel benaderingen om CLTV te berekenen. Iedereen heeft er zijn/haar eigen kijk op. Voor het berekenen van CLTV hebben we historische klantdata nodig, maar voor nieuwe klanten kun je die niet bepalen. Om dit op te lossen ontwikkelen business analysts machinelearningmodellen om de CLTV van nieuwe klanten te voorspellen. Laten we enkele benaderingen voor CLTV-berekening verkennen:
1) Je kunt het berekenen door winst/omzet van klanten in een bepaalde periode op te tellen. Bijvoorbeeld: als de klant de afgelopen 3 jaar bij je is, kun je alle winst in die 3 jaar optellen. Je kunt de winst middelen per jaar, halfjaar of maand, maar met deze aanpak kun je geen voorspellend model voor nieuwe klanten bouwen.
2) Bouw een regressiemodel voor bestaande klanten. Neem recente gegevens over zes maanden als onafhankelijke variabelen en de totale omzet over drie jaar als afhankelijke variabele en bouw hierop een regressiemodel.
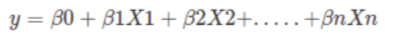
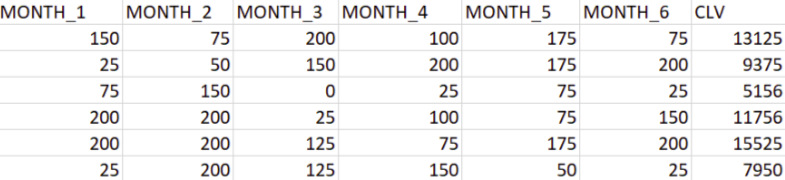
3) CLTV kan ook worden toegepast met behulp van RFM (Recency, Frequency, Monetary)-waarden. Voor meer details kun je verwijzen naar mijn tutorial.
4) Met de volgende vergelijking: CLTV = ((Gemiddelde bestelwaarde × Aanko/frequentie)/Churnrate) × Winstmarge.
Customer Value = Average Order Value * Purchase Frequency
Average Order Value (AOV): De gemiddelde bestelwaarde is de verhouding tussen je totale omzet en het totale aantal bestellingen. AOV vertegenwoordigt het gemiddelde bedrag dat de klant aan een bestelling uitgeeft.
Average Order Value = Total Revenue / Total Number of Orders
Purchase Frequency (PF): Aankoopfrequentie is de verhouding tussen het totale aantal bestellingen en het totale aantal klanten. Het vertegenwoordigt het gemiddelde aantal bestellingen per klant.
Purchase Frequency = Total Number of Orders / Total Number of Customers
Churnrate: Churnrate is het percentage klanten dat niet opnieuw heeft besteld.
Klantlevensduur: Klantlevensduur is de periode waarin de klant continu bestellingen plaatst.
Customer Lifetime=1/Churn Rate
Repeat rate: Repeat rate is de verhouding tussen het aantal klanten met meer dan één bestelling en het aantal unieke klanten. Voorbeeld: als je in een maand 10 klanten hebt van wie er 4 terugkomen, is je repeat rate 40%.
Churn Rate= 1-Repeat Rate
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
import numpy as np
Laten we eerst de vereiste Online Retail-dataset laden met de pandas-functie read CSV. Je kunt de data hier downloaden.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
| InvoiceNo | StockCode | Description | Quantity | InvoiceDate | UnitPrice | CustomerID | Country | |
|---|---|---|---|---|---|---|---|---|
| 0 | 536365 | 85123A | WHITE HANGING HEART T-LIGHT HOLDER | 6 | 2010-12-01 08:26:00 | 2.55 | 17850.0 | United Kingdom |
| 1 | 536365 | 71053 | WHITE METAL LANTERN | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 2 | 536365 | 84406B | CREAM CUPID HEARTS COAT HANGER | 8 | 2010-12-01 08:26:00 | 2.75 | 17850.0 | United Kingdom |
| 3 | 536365 | 84029G | KNITTED UNION FLAG HOT WATER BOTTLE | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 4 | 536365 | 84029E | RED WOOLLY HOTTIE WHITE HEART. | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
Soms krijg je een rommelige dataset. Je kunt dan te maken krijgen met duplicaten, die je analyse vertekenen. In Python biedt pandas de functie drop_duplicates(), die herhaalde of dubbele records verwijdert.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fe677a887f0>
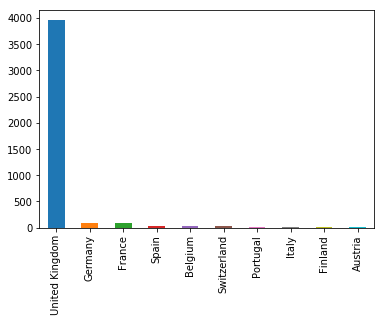
In de gegeven dataset zie je dat de meeste klanten uit "United Kingdom" komen. Je kunt de data dus filteren voor klanten uit het Verenigd Koninkrijk.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 495478 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      495478 non-null object
StockCode      495478 non-null object
Description    494024 non-null object
Quantity       495478 non-null int64
InvoiceDate    495478 non-null datetime64[ns]
UnitPrice      495478 non-null float64
CustomerID     361878 non-null float64
Country        495478 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 34.0+ MB
De functie describe() in pandas is handig voor diverse samenvattende statistieken. Deze functie geeft het aantal waarden, het gemiddelde, de standaardafwijking, de minimum- en maximumwaarden en de kwantielen van de data terug.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 495478.000000 | 495478.000000 | 361878.000000 |
| mean | 8.605486 | 4.532422 | 15547.871368 |
| std | 227.588756 | 99.315438 | 1594.402590 |
| min | -80995.000000 | -11062.060000 | 12346.000000 |
| 25% | 1.000000 | 1.250000 | 14194.000000 |
| 50% | 3.000000 | 2.100000 | 15514.000000 |
| 75% | 10.000000 | 4.130000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Hier zie je dat sommige klanten een negatieve hoeveelheid hebben besteld, wat niet mogelijk is. Je moet Quantity dus filteren op groter dan nul.
uk_data = uk_data[(uk_data['Quantity']>0)]
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 486286 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      486286 non-null object
StockCode      486286 non-null object
Description    485694 non-null object
Quantity       486286 non-null int64
InvoiceDate    486286 non-null datetime64[ns]
UnitPrice      486286 non-null float64
CustomerID     354345 non-null float64
Country        486286 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.4+ MB
Hier kun je de noodzakelijke kolommen filteren voor het berekenen van CLTV. Je hebt slechts vijf kolommen nodig: CustomerID, InvoiceDate, InvoiceNo, Quantity en UnitPrice.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
#Calulate total purchase
uk_data['TotalPurchase'] = uk_data['Quantity'] * uk_data['UnitPrice']
Hier ga je het volgende doen:
uk_data_group=uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (date.max() - date.min()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'Quantity': lambda quant: quant.sum(),
                                        'TotalPurchase': lambda price: price.sum()})
uk_data_group.head()
| InvoiceDate | InvoiceNo | Quantity | TotalPurchase | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
# Change the name of columns
uk_data_group.columns=['num_days','num_transactions','num_units','spent_money']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
 CLTV = ((Average Order Value x Purchase Frequency)/Churn Rate) x Profit margin.

 Customer Value = Average Order Value * Purchase Frequency
# Average Order Value
uk_data_group['avg_order_value']=uk_data_group['spent_money']/uk_data_group['num_transactions']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | |
|---|---|---|---|---|---|
| CustomerID | |||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 |
purchase_frequency=sum(uk_data_group['num_transactions'])/uk_data_group.shape[0]
# Repeat Rate
repeat_rate=uk_data_group[uk_data_group.num_transactions > 1].shape[0]/uk_data_group.shape[0]
#Churn Rate
churn_rate=1-repeat_rate
purchase_frequency,repeat_rate,churn_rate
(90.37107880642694, 0.9818923743942872, 0.018107625605712774)
Winstmarge is de meest gebruikte winstgevendheidsratio. Het geeft aan welk percentage van de totale omzet als winst is behaald. Laten we aannemen dat ons bedrijf ongeveer 5% winst maakt op de totale verkoop.
# Profit Margin
uk_data_group['profit_margin']=uk_data_group['spent_money']*0.05
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 |
# Customer Value
uk_data_group['CLV']=(uk_data_group['avg_order_value']*purchase_frequency)/churn_rate
#Customer Lifetime Value
uk_data_group['cust_lifetime_value']=uk_data_group['CLV']*uk_data_group['profit_margin']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | CLV | cust_lifetime_value | |
|---|---|---|---|---|---|---|---|---|
| CustomerID | ||||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 | 3.852060e+08 | 1.486579e+12 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 | 2.033140e+05 | 4.265538e+07 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 | 3.661610e+04 | 6.173424e+07 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 | 1.025963e+05 | 2.098545e+07 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 | 7.971198e+04 | 3.755789e+06 |
Laten we het CLTV-voorspellingsmodel bouwen.
Hier ga je CLTV voorspellen met een lineair regressiemodel.
Laten we eerst de hierboven geladen en gefilterde data gebruiken.
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
Extraheer maand en jaar uit InvoiceDate.
uk_data['month_yr'] = uk_data['InvoiceDate'].apply(lambda x: x.strftime('%b-%Y'))
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
De draaitabel (pivot table) neemt kolommen als input en groepeert de records in een tweedimensionale tabel die een multidimensionale samenvatting van de data biedt.
sale=uk_data.pivot_table(index=['CustomerID'],columns=['month_yr'],values='TotalPurchase',aggfunc='sum',fill_value=0).reset_index()
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 |
Laten we alle maandverkopen optellen.
sale['CLV']=sale.iloc[:,2:].sum(axis=1)
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 | CLV |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 | 4196.01 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 | 32619.36 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 | 4090.88 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 | 942.34 |
Hier moet je de gegeven kolommen opdelen in twee soorten variabelen: afhankelijke (of doelvariabele) en onafhankelijke variabelen (of featurevariabelen). Selecteer de laatste 6 maanden als onafhankelijke variabelen.
X=sale[['Dec-2011','Nov-2011', 'Oct-2011','Sep-2011','Aug-2011','Jul-2011']]
y=sale[['CLV']]
Om de modelprestaties te begrijpen, is het een goede strategie om de dataset op te splitsen in een trainingsset en een testset.
Laten we de dataset splitsen met de functie train_test_split(). Je moet 3 parameters meegeven: features, target en test_set-grootte. Daarnaast kun je random_state gebruiken als seedwaarde om reproduceerbaarheid te behouden; dit betekent dat elke keer dat je splitst, de resultaten gelijk blijven. Als random_state None is, gebruikt de generator np.random om records willekeurig te selecteren. Dat betekent dat als je geen seed instelt, het elke keer anders is.
#split training set and test set
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y,random_state=0)
Importeer eerst de module Linear Regression en maak een Linear Regression-object. Fit vervolgens je model op de trainingsset met de functie fit() en voorspel op de testset met predict().
# import model
from sklearn.linear_model import LinearRegression

# instantiate
linreg = LinearRegression()

# fit the model to the training data (learn the coefficients)
linreg.fit(X_train, y_train)

# make predictions on the testing set
y_pred = linreg.predict(X_test)
# print the intercept and coefficients
print(linreg.intercept_)
print(linreg.coef_)
[208.50969617]
[[0.99880551 0.80381254 1.60226829 1.67433228 1.52860813 2.87959449]]
Om de algehele fit van het lineaire model te evalueren, gebruiken we de R-kwadraatwaarde. R-kwadraat is het deel van de variantie dat door het model wordt verklaard. De waarde ligt tussen 0 en 1. Een hogere R-kwadraat wordt als beter beschouwd, omdat dit aangeeft dat het model een groter deel van de variantie verklaart.
from sklearn import metrics

# compute the R Square for model
print("R-Square:",metrics.r2_score(y_test, y_pred))
R-Square: 0.9666074402817512
Dit model heeft een hoge R-kwadraat (0,96). Dit model past beter bij de data.
Voor regressieproblemen worden de volgende evaluatiemetrics gebruikt (Ritchie Ng):
# calculate MAE using scikit-learn
print("MAE:",metrics.mean_absolute_error(y_test,y_pred))

#calculate mean squared error
print("MSE",metrics.mean_squared_error(y_test, y_pred))
# compute the RMSE of our predictions
print("RMSE:",np.sqrt(metrics.mean_squared_error(y_test, y_pred)))
MAE: 595.0282284701234
MSE 2114139.8898678957
RMSE: 1454.0082151995896
RMSE is populairder dan MSE en MAE omdat RMSE interpreteerbaar is met y dankzij dezelfde eenheden.
CLTV helpt je een effectief businessplan te ontwerpen en biedt ook de kans om je bedrijf te schalen. CLTV levert betekenisvolle klantsegmenten op; deze segmenten kunnen je helpen de behoeften van verschillende segmenten te identificeren.
Customer Lifetime Value is een tool, geen strategie. CLTV kan de meest winstgevende klanten achterhalen, maar hoe je daar winst mee maakt, hangt af van je strategie. Over het algemeen worden CLTV-modellen vaak verward en misbruikt. Een obsessie met CLTV kan oogkleppen creëren. Bedrijven focussen dan alleen op het vinden van de beste klantgroep en blijven daarop inzetten, maar het is ook belangrijk aandacht te geven aan andere klanten.
Gefeliciteerd, je bent aan het einde van deze tutorial gekomen!
In deze tutorial heb je veel details over Customer Lifetime Value behandeld. Je leerde wat customer lifetime value is, benaderingen voor het berekenen van CLTV, een implementatie van CLTV vanaf nul in Python, een voorspellingsmodel voor CLTV en de voor- en nadelen van CLTV. Ook heb je enkele basisconcepten van pandas behandeld, zoals groupby en draaitabellen, om geselecteerde kolommen en rijen van data samen te vatten.
Hopelijk kun je nu het CLTV-concept gebruiken om je eigen datasets te analyseren. Bedankt voor het lezen van deze tutorial!
Als je meer wilt leren over het analyseren van klantdata in Python, volg dan DataCamp's cursus Customer Analytics & A/B Testing in Python.
Pythoncursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

