Curso
Introdução ao Python
4 h
7M
O economista italiano Vilfredo Pareto afirma que 80% do efeito vem de 20% das causas — a famosa regra 80/20 ou princípio de Pareto. De forma semelhante, 80% da receita das empresas costuma vir de 20% dos clientes. As empresas precisam identificar esses clientes de maior valor e manter um bom relacionamento com eles para garantir receita recorrente. Para construir um relacionamento de longo prazo, é essencial programar ações de fidelização como descontos, ofertas, cupons, pontos de bônus e brindes.
Conquistar um novo cliente é mais caro do que reter quem já compra de você, porque não é preciso investir tantos recursos, tempo e esforço para aquisição. O foco passa a ser manter os clientes atuais satisfeitos. Analistas de negócios calculam com precisão o custo de aquisição de clientes usando o CLTV (Customer Lifetime Value). O CLTV indica a receita total que um cliente gera durante todo o relacionamento. Ele ajuda as empresas a focar nos clientes com maior potencial de trazer mais receita no futuro.
"Customer Lifetime Value é um valor monetário que representa quanto de receita ou lucro um cliente vai gerar para a empresa ao longo do relacionamento". O CLTV evidencia as implicações de adquirir clientes de longo prazo em comparação com clientes de curto prazo. O customer lifetime value (CLV) ajuda a responder as perguntas mais importantes sobre vendas em qualquer empresa:
Existem várias abordagens para calcular o CLTV. Cada profissional pode ter sua visão. Para calcular o CLTV, precisamos de dados históricos dos clientes, o que impede o cálculo para clientes totalmente novos. Para resolver isso, analistas de negócios desenvolvem modelos de machine learning para prever o CLTV de novos clientes. Vamos explorar algumas abordagens para o cálculo do CLTV:
1) Você pode somar o lucro/receita gerado pelo cliente em um determinado período. Por exemplo: se o cliente está com você há 3 anos, some todo o lucro nesses 3 anos. É possível tirar a média anual, semestral ou mensal. Porém, com essa abordagem não dá para criar um modelo preditivo para novos clientes.
2) Construir um modelo de regressão para clientes existentes. Use os dados dos últimos seis meses como variáveis independentes e a receita total de três anos como variável dependente para treinar o modelo.
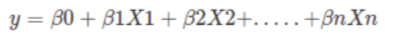
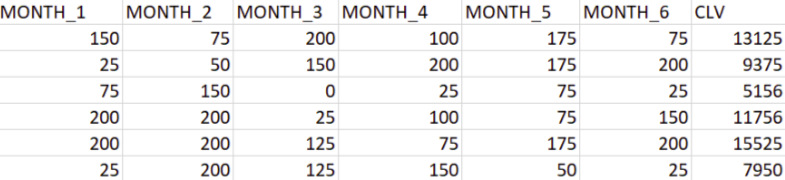
3) O CLTV também pode ser implementado usando os valores RFM (Recency, Frequency, Monetary). Para mais detalhes, confira meu tutorial.
4) Usando a seguinte equação: CLTV = ((valor médio do pedido x frequência de compra)/taxa de churn) x margem de lucro.
Customer Value = Average Order Value * Purchase Frequency
Average Order Value (AOV): o valor médio do pedido é a razão entre a receita total e o número total de pedidos. Representa quanto, em média, o cliente gasta por pedido.
Average Order Value = Total Revenue / Total Number of Orders
Purchase Frequency (PF): a frequência de compra é a razão entre o número total de pedidos e o número total de clientes. Representa a média de pedidos feitos por cliente.
Purchase Frequency = Total Number of Orders / Total Number of Customers
Churn rate (taxa de churn): porcentagem de clientes que não voltaram a realizar pedidos.
Customer lifetime: período durante o qual o cliente segue comprando continuamente.
Customer Lifetime=1/Churn Rate
Repeat rate (taxa de recompra): razão entre o número de clientes com mais de um pedido e o número de clientes únicos. Exemplo: se em um mês você teve 10 clientes e 4 voltaram a comprar, sua taxa de recompra é 40%.
Churn Rate= 1-Repeat Rate
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
import numpy as np
Vamos carregar o dataset de Online Retail com a função read_excel do pandas. Você pode baixar os dados aqui.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
| InvoiceNo | StockCode | Description | Quantity | InvoiceDate | UnitPrice | CustomerID | Country | |
|---|---|---|---|---|---|---|---|---|
| 0 | 536365 | 85123A | WHITE HANGING HEART T-LIGHT HOLDER | 6 | 2010-12-01 08:26:00 | 2.55 | 17850.0 | United Kingdom |
| 1 | 536365 | 71053 | WHITE METAL LANTERN | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 2 | 536365 | 84406B | CREAM CUPID HEARTS COAT HANGER | 8 | 2010-12-01 08:26:00 | 2.75 | 17850.0 | United Kingdom |
| 3 | 536365 | 84029G | KNITTED UNION FLAG HOT WATER BOTTLE | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 4 | 536365 | 84029E | RED WOOLLY HOTTIE WHITE HEART. | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
Nem sempre o dataset vem limpo. Você pode lidar com registros duplicados, que distorcem a análise. Em Python, o pandas oferece a função drop_duplicates(), que remove linhas repetidas.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fe677a887f0>
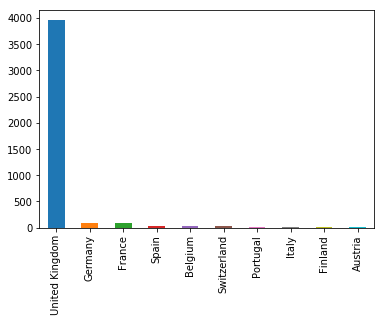
No dataset, dá para ver que a maioria dos clientes é do "United Kingdom". Então, vamos filtrar os dados apenas para clientes do Reino Unido.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 495478 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      495478 non-null object
StockCode      495478 non-null object
Description    494024 non-null object
Quantity       495478 non-null int64
InvoiceDate    495478 non-null datetime64[ns]
UnitPrice      495478 non-null float64
CustomerID     361878 non-null float64
Country        495478 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 34.0+ MB
A função describe() do pandas é prática para obter estatísticas descritivas. Ela retorna contagem, média, desvio padrão, valores mínimo e máximo e quantis dos dados.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 495478.000000 | 495478.000000 | 361878.000000 |
| mean | 8.605486 | 4.532422 | 15547.871368 |
| std | 227.588756 | 99.315438 | 1594.402590 |
| min | -80995.000000 | -11062.060000 | 12346.000000 |
| 25% | 1.000000 | 1.250000 | 14194.000000 |
| 50% | 3.000000 | 2.100000 | 15514.000000 |
| 75% | 10.000000 | 4.130000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Aqui dá para notar que alguns clientes têm pedidos com quantidade negativa, o que não faz sentido. Vamos filtrar Quantity maior que zero.
uk_data = uk_data[(uk_data['Quantity']>0)]
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 486286 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      486286 non-null object
StockCode      486286 non-null object
Description    485694 non-null object
Quantity       486286 non-null int64
InvoiceDate    486286 non-null datetime64[ns]
UnitPrice      486286 non-null float64
CustomerID     354345 non-null float64
Country        486286 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.4+ MB
Aqui você filtra as colunas necessárias para calcular o CLTV. Precisamos de cinco colunas: CustomerID, InvoiceDate, InvoiceNo, Quantity e UnitPrice.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
#Calulate total purchase
uk_data['TotalPurchase'] = uk_data['Quantity'] * uk_data['UnitPrice']
Agora, vamos fazer o seguinte:
uk_data_group=uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (date.max() - date.min()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'Quantity': lambda quant: quant.sum(),
                                        'TotalPurchase': lambda price: price.sum()})
uk_data_group.head()
| InvoiceDate | InvoiceNo | Quantity | TotalPurchase | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
# Change the name of columns
uk_data_group.columns=['num_days','num_transactions','num_units','spent_money']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
 CLTV = ((Average Order Value x Purchase Frequency)/Churn Rate) x Profit margin.

 Customer Value = Average Order Value * Purchase Frequency
# Average Order Value
uk_data_group['avg_order_value']=uk_data_group['spent_money']/uk_data_group['num_transactions']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | |
|---|---|---|---|---|---|
| CustomerID | |||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 |
purchase_frequency=sum(uk_data_group['num_transactions'])/uk_data_group.shape[0]
# Repeat Rate
repeat_rate=uk_data_group[uk_data_group.num_transactions > 1].shape[0]/uk_data_group.shape[0]
#Churn Rate
churn_rate=1-repeat_rate
purchase_frequency,repeat_rate,churn_rate
(90.37107880642694, 0.9818923743942872, 0.018107625605712774)
Margem de lucro é um indicador clássico de rentabilidade. Ele mostra qual percentual das vendas se converte em ganho. Vamos supor que o negócio tenha cerca de 5% de margem sobre as vendas totais.
# Profit Margin
uk_data_group['profit_margin']=uk_data_group['spent_money']*0.05
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 |
# Customer Value
uk_data_group['CLV']=(uk_data_group['avg_order_value']*purchase_frequency)/churn_rate
#Customer Lifetime Value
uk_data_group['cust_lifetime_value']=uk_data_group['CLV']*uk_data_group['profit_margin']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | CLV | cust_lifetime_value | |
|---|---|---|---|---|---|---|---|---|
| CustomerID | ||||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 | 3.852060e+08 | 1.486579e+12 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 | 2.033140e+05 | 4.265538e+07 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 | 3.661610e+04 | 6.173424e+07 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 | 1.025963e+05 | 2.098545e+07 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 | 7.971198e+04 | 3.755789e+06 |
Vamos construir um modelo de previsão de CLTV.
Aqui, vamos prever o CLTV usando um modelo de regressão linear.
Primeiro, use os dados que carregamos e filtramos acima.
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
Extraia mês e ano de InvoiceDate.
uk_data['month_yr'] = uk_data['InvoiceDate'].apply(lambda x: x.strftime('%b-%Y'))
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
A tabela dinâmica (pivot) agrupa colunas em uma tabela bidimensional para oferecer uma visão multidimensional dos dados.
sale=uk_data.pivot_table(index=['CustomerID'],columns=['month_yr'],values='TotalPurchase',aggfunc='sum',fill_value=0).reset_index()
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 |
Vamos somar as vendas de todos os meses.
sale['CLV']=sale.iloc[:,2:].sum(axis=1)
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 | CLV |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 | 4196.01 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 | 32619.36 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 | 4090.88 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 | 942.34 |
Divida as colunas em variáveis independentes (features) e variável dependente (alvo). Selecione os últimos 6 meses como variáveis independentes.
X=sale[['Dec-2011','Nov-2011', 'Oct-2011','Sep-2011','Aug-2011','Jul-2011']]
y=sale[['CLV']]
Para avaliar o desempenho do modelo, é uma boa prática dividir o dataset em treino e teste.
Vamos usar a função train_test_split(). Você precisa passar 3 parâmetros: features, alvo e o tamanho do conjunto de teste. Opcionalmente, use random_state como semente para reprodutibilidade, ou seja, para garantir que divisões repetidas gerem o mesmo resultado. Se random_state for None, o gerador usa np.random para selecionar registros aleatoriamente — sem semente, a divisão muda a cada execução.
#split training set and test set
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y,random_state=0)
Importe o módulo de regressão linear e crie o objeto do modelo. Em seguida, treine com fit() no conjunto de treino e faça previsões no conjunto de teste com predict().
# import model
from sklearn.linear_model import LinearRegression

# instantiate
linreg = LinearRegression()

# fit the model to the training data (learn the coefficients)
linreg.fit(X_train, y_train)

# make predictions on the testing set
y_pred = linreg.predict(X_test)
# print the intercept and coefficients
print(linreg.intercept_)
print(linreg.coef_)
[208.50969617]
[[0.99880551 0.80381254 1.60226829 1.67433228 1.52860813 2.87959449]]
Para avaliar o ajuste geral do modelo linear, usamos o R-quadrado. Ele representa a proporção da variância explicada pelo modelo e varia de 0 a 1. Quanto maior, melhor, pois indica que o modelo explica mais variância.
from sklearn import metrics

# compute the R Square for model
print("R-Square:",metrics.r2_score(y_test, y_pred))
R-Square: 0.9666074402817512
Este modelo apresentou R-quadrado alto (0,96), indicando um bom ajuste aos dados.
Para problemas de regressão, são comuns as seguintes métricas (Ritchie Ng):
# calculate MAE using scikit-learn
print("MAE:",metrics.mean_absolute_error(y_test,y_pred))

#calculate mean squared error
print("MSE",metrics.mean_squared_error(y_test, y_pred))
# compute the RMSE of our predictions
print("RMSE:",np.sqrt(metrics.mean_squared_error(y_test, y_pred)))
MAE: 595.0282284701234
MSE 2114139.8898678957
RMSE: 1454.0082151995896
O RMSE é mais popular que MSE e MAE porque é interpretável na mesma unidade da variável alvo.
O CLTV ajuda você a desenhar um plano de negócios mais eficaz e cria oportunidades para escalar. Ele permite construir segmentos de clientes relevantes, que ajudam a identificar as necessidades de cada grupo.
O Customer Lifetime Value é uma ferramenta, não uma estratégia. Ele aponta os clientes mais lucrativos, mas como extrair valor deles depende da sua estratégia. Em geral, modelos de CLTV podem ser mal compreendidos e mal utilizados. A obsessão por CLTV pode criar pontos cegos: empresas passam a focar apenas no melhor grupo e em repetir vendas, mas também é importante dar atenção aos demais clientes.
Parabéns por chegar até o fim deste tutorial!
Aqui você viu em detalhes o que é Customer Lifetime Value, abordagens para calcular CLTV, a implementação do CLTV do zero em Python, um modelo preditivo e os prós e contras do CLTV. Também revisamos conceitos básicos de pandas, como groupby e pivot table, para resumir colunas e linhas de interesse.
Agora você já pode aplicar o conceito de CLTV para analisar seus próprios datasets. Obrigado por ler!
Se quiser aprender mais sobre análise de clientes em Python, faça o curso Customer Analytics & A/B Testing in Python da DataCamp.
Cursos de Python
Curso
Curso
Curso
Tutorial
Sejal Jaiswal
9 min
Tutorial
Kevin Babitz
8 min
Tutorial
Karlijn Willems
14 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Moez Ali
14 min
Tutorial
DataCamp Team
3 min




