Corso
Introduzione a Python
4 ore
7.1M
L’economista italiano Vilfredo Pareto afferma che l’80% degli effetti deriva dal 20% delle cause: è la cosiddetta regola 80/20 o principio di Pareto. Allo stesso modo, l’80% del business di un’azienda proviene dal 20% dei clienti. Le aziende devono individuare questi clienti top e coltivare il rapporto con loro per garantire entrate continue. Per mantenere una relazione di lungo periodo con i clienti, è necessario pianificare programmi di fidelizzazione come sconti, offerte, coupon, punti bonus e regali.
Acquisire un nuovo cliente costa più che trattenere quelli esistenti, perché non devi spendere risorse, tempo e fatica per convincerli. Devi solo mantenere soddisfatti i clienti attuali. Gli analisti di business calcolano con precisione il costo di acquisizione dei clienti usando il CLTV (Customer Lifetime Value). Il CLTV indica il ricavo totale generato dal cliente durante l’intera relazione. Il CLTV aiuta le aziende a concentrarsi su quei clienti potenziali che possono portare più ricavi in futuro.
"Il Customer Lifetime Value è un valore monetario che rappresenta l’ammontare di ricavi o profitti che un cliente porterà all’azienda nell’arco della relazione". Il CLTV mostra le implicazioni dell’acquisizione di clienti di lungo periodo rispetto a quelli di breve periodo. Il Customer lifetime value (CLV) può aiutarti a rispondere alle domande più importanti sulle vendite per qualsiasi azienda:
Esistono molti approcci per calcolare il CLTV. Ognuno ha la propria visione. Per calcolare il CLTV servono dati storici dei clienti, ma non sarai in grado di calcolarlo per i nuovi clienti. Per risolvere questo problema, gli analisti di business sviluppano modelli di machine learning per prevedere il CLTV dei nuovi clienti. Vediamo alcuni approcci per il calcolo del CLTV:
1) Puoi calcolarlo sommando profitto/ricavo dai clienti in un dato periodo. Per esempio, se il cliente è con te da 3 anni, puoi sommare tutti i profitti in questi 3 anni. Puoi fare la media del profitto su base annuale, semestrale o mensile, ma con questo approccio non puoi costruire un modello predittivo per i nuovi clienti.
2) Costruisci un modello di regressione per i clienti esistenti. Prendi i dati degli ultimi sei mesi come variabili indipendenti e il ricavo totale su tre anni come variabile dipendente e costruisci un modello di regressione su questi dati.
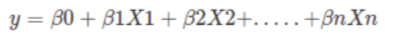
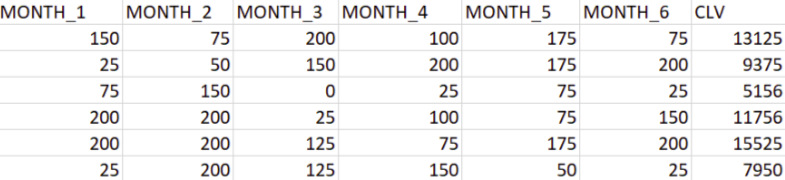
3) Il CLTV può essere implementato anche usando i valori RFM (Recency, Frequency, Monetary). Per maggiori dettagli puoi fare riferimento al mio tutorial.
4) Usando la seguente equazione: CLTV = ((Average Order Value x Purchase Frequency)/Churn Rate) x Profit margin.
Customer Value = Average Order Value * Purchase Frequency
Average Order Value (AOV): L’Average Order Value è il rapporto tra il tuo ricavo totale e il numero totale di ordini. L’AOV rappresenta l’importo medio di ricavo che il cliente spende per un ordine.
Average Order Value = Total Revenue / Total Number of Orders
Purchase Frequency (PF): La Purchase Frequency è il rapporto tra il numero totale di ordini e il numero totale di clienti. Rappresenta il numero medio di ordini effettuati da ciascun cliente.
Purchase Frequency = Total Number of Orders / Total Number of Customers
Churn Rate: La Churn Rate è la percentuale di clienti che non hanno effettuato un nuovo ordine.
Customer Lifetime: Il Customer Lifetime è il periodo di tempo in cui il cliente ha effettuato ordini in modo continuativo.
Customer Lifetime=1/Churn Rate
Repeat Rate: La Repeat Rate è definita come il rapporto tra il numero di clienti con più di un ordine e il numero di clienti unici. Esempio: se in un mese hai 10 clienti, di cui 4 tornano, la tua repeat rate è del 40%.
Churn Rate= 1-Repeat Rate
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
import numpy as np
Per prima cosa carichiamo il dataset Online Retail richiesto usando la funzione read CSV di pandas. Puoi scaricare i dati da qui.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
| InvoiceNo | StockCode | Description | Quantity | InvoiceDate | UnitPrice | CustomerID | Country | |
|---|---|---|---|---|---|---|---|---|
| 0 | 536365 | 85123A | WHITE HANGING HEART T-LIGHT HOLDER | 6 | 2010-12-01 08:26:00 | 2.55 | 17850.0 | United Kingdom |
| 1 | 536365 | 71053 | WHITE METAL LANTERN | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 2 | 536365 | 84406B | CREAM CUPID HEARTS COAT HANGER | 8 | 2010-12-01 08:26:00 | 2.75 | 17850.0 | United Kingdom |
| 3 | 536365 | 84029G | KNITTED UNION FLAG HOT WATER BOTTLE | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 4 | 536365 | 84029E | RED WOOLLY HOTTIE WHITE HEART. | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
A volte il dataset è disordinato. Potresti dover gestire duplicati, che alterano l’analisi. In Python, pandas offre la funzione drop_duplicates(), che elimina i record ripetuti o duplicati.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fe677a887f0>
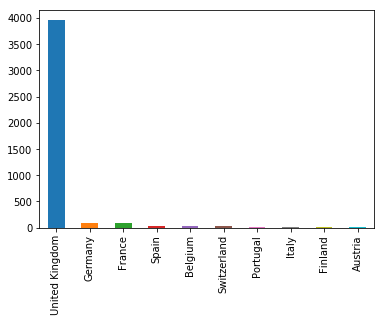
Nel dataset fornito, puoi osservare che la maggior parte dei clienti proviene dal "United Kingdom". Quindi, puoi filtrare i dati per i clienti del Regno Unito.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 495478 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      495478 non-null object
StockCode      495478 non-null object
Description    494024 non-null object
Quantity       495478 non-null int64
InvoiceDate    495478 non-null datetime64[ns]
UnitPrice      495478 non-null float64
CustomerID     361878 non-null float64
Country        495478 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 34.0+ MB
La funzione describe() in pandas è comoda per ottenere varie statistiche di sintesi. Questa funzione restituisce conteggio, media, deviazione standard, valori minimi e massimi e i quantili dei dati.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 495478.000000 | 495478.000000 | 361878.000000 |
| mean | 8.605486 | 4.532422 | 15547.871368 |
| std | 227.588756 | 99.315438 | 1594.402590 |
| min | -80995.000000 | -11062.060000 | 12346.000000 |
| 25% | 1.000000 | 1.250000 | 14194.000000 |
| 50% | 3.000000 | 2.100000 | 15514.000000 |
| 75% | 10.000000 | 4.130000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Qui puoi notare che alcuni clienti hanno ordinato quantità negative, il che non è possibile. Quindi, devi filtrare Quantity maggiore di zero.
uk_data = uk_data[(uk_data['Quantity']>0)]
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 486286 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      486286 non-null object
StockCode      486286 non-null object
Description    485694 non-null object
Quantity       486286 non-null int64
InvoiceDate    486286 non-null datetime64[ns]
UnitPrice      486286 non-null float64
CustomerID     354345 non-null float64
Country        486286 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.4+ MB
Qui puoi filtrare le colonne necessarie per calcolare il CLTV. Ti servono solo cinque colonne: CustomerID, InvoiceDate, InvoiceNo, Quantity e UnitPrice.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
#Calulate total purchase
uk_data['TotalPurchase'] = uk_data['Quantity'] * uk_data['UnitPrice']
Ora eseguirai le seguenti operazioni:
uk_data_group=uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (date.max() - date.min()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'Quantity': lambda quant: quant.sum(),
                                        'TotalPurchase': lambda price: price.sum()})
uk_data_group.head()
| InvoiceDate | InvoiceNo | Quantity | TotalPurchase | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
# Change the name of columns
uk_data_group.columns=['num_days','num_transactions','num_units','spent_money']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
 CLTV = ((Average Order Value x Purchase Frequency)/Churn Rate) x Profit margin.

 Customer Value = Average Order Value * Purchase Frequency
# Average Order Value
uk_data_group['avg_order_value']=uk_data_group['spent_money']/uk_data_group['num_transactions']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | |
|---|---|---|---|---|---|
| CustomerID | |||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 |
purchase_frequency=sum(uk_data_group['num_transactions'])/uk_data_group.shape[0]
# Repeat Rate
repeat_rate=uk_data_group[uk_data_group.num_transactions > 1].shape[0]/uk_data_group.shape[0]
#Churn Rate
churn_rate=1-repeat_rate
purchase_frequency,repeat_rate,churn_rate
(90.37107880642694, 0.9818923743942872, 0.018107625605712774)
Il profit margin è il rapporto di redditività più usato. Indica quale percentuale delle vendite totali è guadagno. Supponiamo che il nostro business abbia circa il 5% di profitto sulle vendite totali.
# Profit Margin
uk_data_group['profit_margin']=uk_data_group['spent_money']*0.05
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 |
# Customer Value
uk_data_group['CLV']=(uk_data_group['avg_order_value']*purchase_frequency)/churn_rate
#Customer Lifetime Value
uk_data_group['cust_lifetime_value']=uk_data_group['CLV']*uk_data_group['profit_margin']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | CLV | cust_lifetime_value | |
|---|---|---|---|---|---|---|---|---|
| CustomerID | ||||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 | 3.852060e+08 | 1.486579e+12 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 | 2.033140e+05 | 4.265538e+07 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 | 3.661610e+04 | 6.173424e+07 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 | 1.025963e+05 | 2.098545e+07 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 | 7.971198e+04 | 3.755789e+06 |
Costruiamo il modello di previsione del CLTV.
Qui prevederai il CLTV usando un modello di regressione lineare.
Per prima cosa usiamo i dati caricati e filtrati sopra.
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
Estrai mese e anno da InvoiceDate.
uk_data['month_yr'] = uk_data['InvoiceDate'].apply(lambda x: x.strftime('%b-%Y'))
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
La pivot table prende le colonne in input e raggruppa le voci in una tabella bidimensionale in modo da fornire una sintesi multidimensionale dei dati.
sale=uk_data.pivot_table(index=['CustomerID'],columns=['month_yr'],values='TotalPurchase',aggfunc='sum',fill_value=0).reset_index()
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 |
Sommiamo le vendite di tutti i mesi.
sale['CLV']=sale.iloc[:,2:].sum(axis=1)
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 | CLV |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 | 4196.01 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 | 32619.36 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 | 4090.88 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 | 942.34 |
Qui devi dividere le colonne fornite in due tipi di variabili: dipendente (o variabile target) e indipendenti (o feature). Seleziona gli ultimi 6 mesi come variabili indipendenti.
X=sale[['Dec-2011','Nov-2011', 'Oct-2011','Sep-2011','Aug-2011','Jul-2011']]
y=sale[['CLV']]
Per capire le prestazioni del modello, dividere il dataset in training set e test set è una buona strategia.
Dividiamo il dataset usando la funzione train_test_split(). Devi passare 3 parametri: feature, target e dimensione del test_set. Inoltre, puoi usare random_state come seed per mantenere la riproducibilità, il che significa che ogni volta che dividi i dati i risultati non cambieranno. Se random_state è None, il generatore di numeri casuali usa np.random per selezionare i record in modo casuale. Significa che se non imposti un seed, la divisione è diversa ogni volta.
#split training set and test set
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y,random_state=0)
Per prima cosa importa il modulo Linear Regression e crea un oggetto Linear Regression. Poi addestra il modello sul training set usando la funzione fit() ed effettua le previsioni sul test set usando predict().
# import model
from sklearn.linear_model import LinearRegression

# instantiate
linreg = LinearRegression()

# fit the model to the training data (learn the coefficients)
linreg.fit(X_train, y_train)

# make predictions on the testing set
y_pred = linreg.predict(X_test)
# print the intercept and coefficients
print(linreg.intercept_)
print(linreg.coef_)
[208.50969617]
[[0.99880551 0.80381254 1.60226829 1.67433228 1.52860813 2.87959449]]
Per valutare l’adattamento complessivo del modello lineare, usiamo il valore R-squared. R-squared è la proporzione di varianza spiegata dal modello. Il valore di R-squared è compreso tra 0 e 1. Un valore più alto di R-squared è considerato migliore perché indica che il modello spiega una porzione maggiore della varianza.
from sklearn import metrics

# compute the R Square for model
print("R-Square:",metrics.r2_score(y_test, y_pred))
R-Square: 0.9666074402817512
Questo modello ha un R-squared elevato (0,96). Fornisce quindi un migliore adattamento ai dati.
Per i problemi di regressione si usano le seguenti metriche di valutazione (Ritchie Ng):
# calculate MAE using scikit-learn
print("MAE:",metrics.mean_absolute_error(y_test,y_pred))

#calculate mean squared error
print("MSE",metrics.mean_squared_error(y_test, y_pred))
# compute the RMSE of our predictions
print("RMSE:",np.sqrt(metrics.mean_squared_error(y_test, y_pred)))
MAE: 595.0282284701234
MSE 2114139.8898678957
RMSE: 1454.0082151995896
L’RMSE è più popolare di MSE e MAE perché è interpretabile rispetto a y, essendo espresso nelle stesse unità.
Il CLTV ti aiuta a progettare un piano di business efficace e offre anche l’opportunità di scalare la tua attività. Il CLTV traccia segmenti di clienti significativi: questi segmenti possono aiutarti a identificare le esigenze dei diversi gruppi.
Il Customer Lifetime Value è uno strumento, non una strategia. Il CLTV può individuare i clienti più redditizi, ma come trarre profitto da loro dipende dalla tua strategia. In generale, i modelli di CLTV sono spesso fraintesi e usati male. L’ossessione per il CLTV può creare paraocchi: le aziende si concentrano solo nel trovare il gruppo di clienti migliore e nel puntare su di esso per ripetere il business, ma è importante dare attenzione anche agli altri clienti.
Congratulazioni, sei arrivato alla fine di questo tutorial!
In questo tutorial, hai approfondito molti dettagli sul Customer Lifetime Value. Hai imparato cos’è il customer lifetime value, gli approcci per calcolare il CLTV, l’implementazione del CLTV da zero in Python, un modello predittivo per il CLTV e i pro e contro del CLTV. Inoltre, hai visto alcuni concetti base di pandas come groupby e pivot table per riassumere colonne e righe selezionate.
Si spera che ora tu possa utilizzare il concetto di CLTV per analizzare i tuoi dataset. Grazie per aver letto questo tutorial!
Se vuoi approfondire l’analisi dei dati dei clienti in Python, segui il corso di DataCamp Customer Analytics & A/B Testing in Python.
Corsi Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



