
Last chance! 50% off DataCamp Premium
Sale ends in
İtalyan ekonomist Vilfredo Pareto, etkinin %80’inin nedenlerin %20’sinden geldiğini söyler; bu, 80/20 kuralı veya Pareto ilkesi olarak bilinir. Benzer şekilde, şirketlerin işlerinin %80’i müşterilerin %20’sinden gelir. Şirketlerin bu en iyi müşterileri belirleyip onlarla ilişkiyi sürdürmesi, düzenli gelir için kritik önemdedir. Müşterilerle uzun vadeli ilişkiyi sürdürmek için indirim, kampanya, kupon, puan ve hediye gibi sadakat programları planlanmalıdır.
Yeni bir müşteriyi hedeflemek, mevcut müşterileri elde tutmaktan daha maliyetlidir; çünkü yeni müşteri kazanımı için kaynak, zaman ve yoğun çaba harcamanız gerekir. Yapmanız gereken, mevcut müşterileri memnun etmektir. İş analistleri, CLTV (Customer Lifetime Value) kullanarak müşteri edinme maliyetini doğru şekilde hesaplar. CLTV, müşteriyle tüm ilişki süresince elde edilen toplam geliri gösterir. CLTV, gelecekte daha fazla gelir getirebilecek potansiyel müşterilere odaklanmaya yardımcı olur.
"Customer Lifetime Value, bir müşterinin ilişki süresi boyunca şirkete sağlayacağı gelir veya kâr miktarını ifade eden parasal bir değerdir". CLTV, kısa vadeli müşterilere kıyasla uzun vadeli müşterilerin kazanımının sonuçlarını ortaya koyar. Müşteri yaşam boyu değeri (CLV), her şirket için satışla ilgili en önemli soruların yanıtlanmasına yardımcı olabilir:
CLTV hesaplamak için pek çok yaklaşım vardır. Herkesin bu konuda kendi görüşü olabilir. CLTV’yi hesaplamak için geçmiş müşteri verilerine ihtiyaç duyarız; ancak yeni müşteriler için hesaplama yapamazsınız. Bu sorunu çözmek için İş Analistleri, yeni müşterilerin CLTV’sini tahmin eden makine öğrenmesi modelleri geliştirir. CLTV hesaplamasına yönelik bazı yaklaşımları inceleyelim:
1) Belirli bir döngüde müşterilerden elde edilen kâr/geliri toplayarak hesaplayabilirsiniz. Örneğin, müşteri son 3 yıldır sizinle ilişkiliyse bu 3 yıldaki toplam kârı toplayabilirsiniz. Kârı yıllık, altı aylık veya aylık ortalama alabilirsiniz; ancak bu yaklaşımda yeni müşteriler için öngörü modeli kuramazsınız.
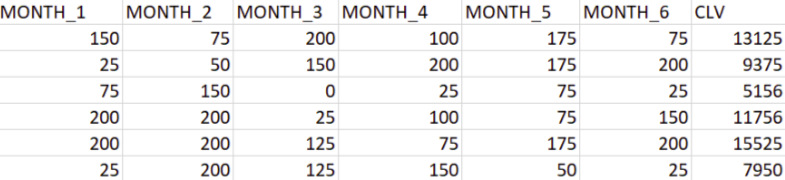
2) Mevcut müşteriler için bir regresyon modeli kurun. Son altı aylık verileri bağımsız değişken, üç yıldaki toplam geliri bağımlı değişken olarak alın ve bu verilerle bir regresyon modeli oluşturun.
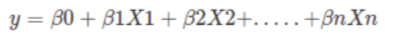
3) CLTV, RFM (Recency, Frequency, Monetary) değerleri kullanılarak da uygulanabilir. Daha fazla bilgi için bu eğitimime bakabilirsiniz.
4) Aşağıdaki denklemi kullanarak: CLTV = ((Ortalama Sipariş Değeri x Satın Alma Sıklığı)/Terk Oranı) x Kâr marjı.
Customer Value = Average Order Value * Purchase Frequency
Average Order Value (AOV): Ortalama Sipariş Değeri, toplam gelirinizin toplam sipariş sayısına oranıdır. AOV, müşterinin bir siparişte harcadığı ortalama gelir tutarını temsil eder.
Average Order Value = Total Revenue / Total Number of Orders
Purchase Frequency (PF): Satın Alma Sıklığı, toplam sipariş sayısının toplam müşteri sayısına oranıdır. Her müşterinin verdiği ortalama sipariş sayısını temsil eder.
Purchase Frequency = Total Number of Orders / Total Number of Customers
Churn Rate: Terk Oranı, tekrar sipariş vermeyen müşterilerin yüzdesidir.
Customer Lifetime: Müşteri Yaşam Süresi, müşterinin kesintisiz olarak sipariş verdiği zaman aralığıdır.
Customer Lifetime=1/Churn Rate
Repeat Rate: Tekrar Oranı, birden fazla siparişi olan müşteri sayısının benzersiz müşteri sayısına oranı olarak tanımlanabilir. Örnek: Bir ayda 10 müşteriniz varsa ve bunlardan 4’ü geri dönerse tekrar oranınız %40’tır.
Churn Rate= 1-Repeat Rate
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
import numpy as np
Önce pandas read CSV işlevini kullanarak gerekli Online Retail veri setini yükleyelim. Veriyi buradan indirebilirsiniz.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
| InvoiceNo | StockCode | Description | Quantity | InvoiceDate | UnitPrice | CustomerID | Country | |
|---|---|---|---|---|---|---|---|---|
| 0 | 536365 | 85123A | WHITE HANGING HEART T-LIGHT HOLDER | 6 | 2010-12-01 08:26:00 | 2.55 | 17850.0 | United Kingdom |
| 1 | 536365 | 71053 | WHITE METAL LANTERN | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 2 | 536365 | 84406B | CREAM CUPID HEARTS COAT HANGER | 8 | 2010-12-01 08:26:00 | 2.75 | 17850.0 | United Kingdom |
| 3 | 536365 | 84029G | KNITTED UNION FLAG HOT WATER BOTTLE | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 4 | 536365 | 84029E | RED WOOLLY HOTTIE WHITE HEART. | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
Bazen karmaşık bir veri kümesiyle karşılaşırsınız. Yinelenen kayıtlarla uğraşmanız gerekebilir; bu da analizinizin sapmasına yol açar. Python’da pandas, tekrarlanan veya yinelenen kayıtları düşüren drop_duplicates() işlevini sunar.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fe677a887f0>
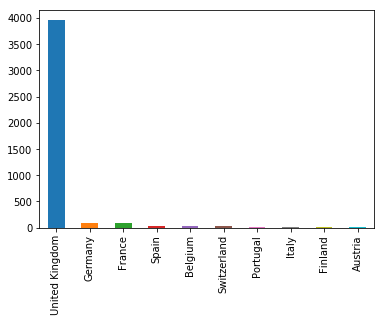
Verilen veri setinde müşterilerin çoğunun "United Kingdom" kaynaklı olduğunu gözlemleyebilirsiniz. Bu nedenle, Birleşik Krallık müşterileri için veriyi filtreleyebilirsiniz.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 495478 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      495478 non-null object
StockCode      495478 non-null object
Description    494024 non-null object
Quantity       495478 non-null int64
InvoiceDate    495478 non-null datetime64[ns]
UnitPrice      495478 non-null float64
CustomerID     361878 non-null float64
Country        495478 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 34.0+ MB
pandas’taki describe() işlevi, çeşitli özet istatistikleri elde etmek için kullanışlıdır. Bu işlev, sayım, ortalama, standart sapma, minimum ve maksimum değerler ile çeyreklikleri döndürür.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 495478.000000 | 495478.000000 | 361878.000000 |
| mean | 8.605486 | 4.532422 | 15547.871368 |
| std | 227.588756 | 99.315438 | 1594.402590 |
| min | -80995.000000 | -11062.060000 | 12346.000000 |
| 25% | 1.000000 | 1.250000 | 14194.000000 |
| 50% | 3.000000 | 2.100000 | 15514.000000 |
| 75% | 10.000000 | 4.130000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Burada, bazı müşterilerin negatif miktarda sipariş verdiğini görebilirsiniz ki bu mümkün değildir. Bu nedenle, Quantity değerini sıfırdan büyük olacak şekilde filtrelemeniz gerekir.
uk_data = uk_data[(uk_data['Quantity']>0)]
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 486286 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      486286 non-null object
StockCode      486286 non-null object
Description    485694 non-null object
Quantity       486286 non-null int64
InvoiceDate    486286 non-null datetime64[ns]
UnitPrice      486286 non-null float64
CustomerID     354345 non-null float64
Country        486286 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.4+ MB
Burada, CLTV hesaplamak için gerekli sütunları filtreleyebilirsiniz. Yalnızca beş sütuna ihtiyacınız var: CustomerID, InvoiceDate, InvoiceNo, Quantity ve UnitPrice.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
#Calulate total purchase
uk_data['TotalPurchase'] = uk_data['Quantity'] * uk_data['UnitPrice']
Burada şu işlemleri yapacaksınız:
uk_data_group=uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (date.max() - date.min()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'Quantity': lambda quant: quant.sum(),
                                        'TotalPurchase': lambda price: price.sum()})
uk_data_group.head()
| InvoiceDate | InvoiceNo | Quantity | TotalPurchase | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
# Change the name of columns
uk_data_group.columns=['num_days','num_transactions','num_units','spent_money']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
 CLTV = ((Average Order Value x Purchase Frequency)/Churn Rate) x Profit margin.

 Customer Value = Average Order Value * Purchase Frequency
# Average Order Value
uk_data_group['avg_order_value']=uk_data_group['spent_money']/uk_data_group['num_transactions']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | |
|---|---|---|---|---|---|
| CustomerID | |||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 |
purchase_frequency=sum(uk_data_group['num_transactions'])/uk_data_group.shape[0]
# Repeat Rate
repeat_rate=uk_data_group[uk_data_group.num_transactions > 1].shape[0]/uk_data_group.shape[0]
#Churn Rate
churn_rate=1-repeat_rate
purchase_frequency,repeat_rate,churn_rate
(90.37107880642694, 0.9818923743942872, 0.018107625605712774)
Kâr marjı, yaygın olarak kullanılan bir kârlılık oranıdır. Toplam satışın yüzde kaçının kâr olarak elde edildiğini gösterir. Toplam satış üzerinden yaklaşık %5 kârımız olduğunu varsayalım.
# Profit Margin
uk_data_group['profit_margin']=uk_data_group['spent_money']*0.05
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 |
# Customer Value
uk_data_group['CLV']=(uk_data_group['avg_order_value']*purchase_frequency)/churn_rate
#Customer Lifetime Value
uk_data_group['cust_lifetime_value']=uk_data_group['CLV']*uk_data_group['profit_margin']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | CLV | cust_lifetime_value | |
|---|---|---|---|---|---|---|---|---|
| CustomerID | ||||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 | 3.852060e+08 | 1.486579e+12 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 | 2.033140e+05 | 4.265538e+07 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 | 3.661610e+04 | 6.173424e+07 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 | 1.025963e+05 | 2.098545e+07 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 | 7.971198e+04 | 3.755789e+06 |
CLTV tahmin modelini oluşturalım.
Burada, Doğrusal Regresyon Modeli kullanarak CLTV’yi tahmin edeceksiniz.
Önce yukarıda yüklenen ve filtrelenen verileri kullanalım.
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
InvoiceDate alanından ay ve yılı çıkarın.
uk_data['month_yr'] = uk_data['InvoiceDate'].apply(lambda x: x.strftime('%b-%Y'))
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
Pivot tablo, sütunları girdi olarak alır ve veriyi iki boyutlu bir tabloda gruplayarak çok boyutlu bir özet sağlar.
sale=uk_data.pivot_table(index=['CustomerID'],columns=['month_yr'],values='TotalPurchase',aggfunc='sum',fill_value=0).reset_index()
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 |
Tüm ayların satışlarını toplayalım.
sale['CLV']=sale.iloc[:,2:].sum(axis=1)
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 | CLV |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 | 4196.01 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 | 32619.36 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 | 4090.88 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 | 942.34 |
Burada, verilen sütunları iki tür değişkene ayırmanız gerekir: bağımlı (veya hedef değişken) ve bağımsız değişkenler (veya özellik değişkenleri). Bağımsız değişken olarak son 6 ayı seçin.
X=sale[['Dec-2011','Nov-2011', 'Oct-2011','Sep-2011','Aug-2011','Jul-2011']]
y=sale[['CLV']]
Model performansını anlamak için veri kümesini eğitim ve test seti olarak bölmek iyi bir stratejidir.
train_test_split() işlevini kullanarak veri kümesini bölelim. Üç parametre geçirmeniz gerekir: özellikler, hedef ve test_set boyutu. Ek olarak, yeniden üretilebilirliği korumak için random_state’i tohum değeri olarak kullanabilirsiniz; bu, veriyi her bölüşünüzde sonuçların etkilenmeyeceği anlamına gelir. Ayrıca, random_state None ise, kayıtları rastgele seçmek için rastgele sayı üreteci np.random’ı kullanır. Yani bir tohum ayarlamazsanız, her seferinde farklıdır.
#split training set and test set
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y,random_state=0)
Önce Doğrusal Regresyon modülünü içe aktarın ve bir Doğrusal Regresyon nesnesi oluşturun. Ardından, fit() işlevini kullanarak modelinizi eğitim setine oturtun ve predict() işlevini kullanarak test seti üzerinde tahmin yapın.
# import model
from sklearn.linear_model import LinearRegression

# instantiate
linreg = LinearRegression()

# fit the model to the training data (learn the coefficients)
linreg.fit(X_train, y_train)

# make predictions on the testing set
y_pred = linreg.predict(X_test)
# print the intercept and coefficients
print(linreg.intercept_)
print(linreg.coef_)
[208.50969617]
[[0.99880551 0.80381254 1.60226829 1.67433228 1.52860813 2.87959449]]
Doğrusal modelin genel uyumunu değerlendirmek için R-kare değerini kullanırız. R-kare, model tarafından açıklanan varyans oranıdır. R-kare değeri 0 ile 1 arasında değişir. Daha yüksek R-kare değeri daha iyidir; çünkü modelin daha büyük bir varyansı açıkladığını gösterir.
from sklearn import metrics

# compute the R Square for model
print("R-Square:",metrics.r2_score(y_test, y_pred))
R-Square: 0.9666074402817512
Bu modelin R-kare değeri yüksektir (0,96). Model, veriye daha iyi uyum sağlamaktadır.
Regresyon problemleri için aşağıdaki değerlendirme metrikleri kullanılır (Ritchie Ng):
# calculate MAE using scikit-learn
print("MAE:",metrics.mean_absolute_error(y_test,y_pred))

#calculate mean squared error
print("MSE",metrics.mean_squared_error(y_test, y_pred))
# compute the RMSE of our predictions
print("RMSE:",np.sqrt(metrics.mean_squared_error(y_test, y_pred)))
MAE: 595.0282284701234
MSE 2114139.8898678957
RMSE: 1454.0082151995896
RMSE, MSE ve MAE’den daha popülerdir; çünkü RMSE’nin birimi y ile aynıdır ve bu nedenle daha yorumlanabilirdir.
CLTV, etkili bir iş planı tasarlamanıza yardımcı olur ve işinizi ölçeklendirme fırsatı da sunar. CLTV, anlamlı müşteri segmentleri çıkarır; bu segmentler, farklı segmentlerin ihtiyaçlarını belirlemenize yardımcı olabilir.
Customer Lifetime Value bir araçtır, strateji değil. CLTV en kârlı müşterileri ortaya çıkarabilir; ancak onlardan nasıl kâr edeceğiniz stratejinize bağlıdır. Genel olarak CLTV modelleri kafa karıştırılabilir ve yanlış kullanılabilir. CLTV’ye aşırı odaklanma körlüğe yol açabilir. Şirketler yalnızca en iyi müşteri grubunu bulmaya, onlara odaklanmaya ve işi tekrarlamaya yönelir; ancak diğer müşterilere de dikkat etmek önemlidir.
Tebrikler, bu eğitimin sonuna ulaştınız!
Bu eğitimde, Customer Lifetime Value hakkında birçok detayı ele aldınız. CLTV’nin ne olduğunu, CLTV hesaplama yaklaşımlarını, Python’da sıfırdan CLTV uygulamasını, CLTV için bir tahmin modelini ve CLTV’nin artıları ile eksilerini öğrendiniz. Ayrıca, seçili sütun ve satırların özetlenmesi için groupby ve pivot tablo gibi bazı temel pandas kavramlarını da gördünüz.
Umarız artık kendi veri kümelerinizi analiz etmek için CLTV kavramını kullanabilirsiniz. Bu eğitimi okuduğunuz için teşekkürler!
Python’da müşteri verilerini analiz etmeyi daha fazla öğrenmek isterseniz, DataCamp’in Customer Analytics & A/B Testing in Python kursunu inceleyin.
Python Kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




