
Last chance! 50% off DataCamp Premium
Sale ends in
इतालवी अर्थशास्त्री विलफ्रेडो पैरेटो के अनुसार 80% प्रभाव 20% कारणों से आता है। इसे 80/20 नियम या पैरेटो सिद्धांत कहा जाता है। इसी तरह, कंपनियों के 80% व्यवसाय 20% ग्राहकों से आते हैं। कंपनियों को उन शीर्ष ग्राहकों की पहचान करनी चाहिए और उनके साथ संबंध बनाए रखने चाहिए ताकि निरंतर राजस्व सुनिश्चित हो सके। ग्राहकों के साथ दीर्घकालिक संबंध बनाए रखने के लिए, कंपनियों को छूट, ऑफ़र, कूपन, बोनस पॉइंट और उपहार जैसे लॉयल्टी कार्यक्रमों की योजना बनानी चाहिए।
नए ग्राहक को लक्षित करना, मौजूदा ग्राहकों को बनाए रखने की तुलना में अधिक महंगा होता है, क्योंकि आपको नए ग्राहकों को हासिल करने के लिए संसाधन, समय और मेहनत खर्च नहीं करनी पड़ती। आपको बस मौजूदा ग्राहकों को संतुष्ट रखना होता है। बिजनेस एनालिस्ट CLTV (Customer Lifetime Value) का उपयोग करके ग्राहक अधिग्रहण लागत को सटीकता से 계산 करते हैं। CLTV संपूर्ण संबंध अवधि के दौरान ग्राहक से प्राप्त कुल राजस्व को दर्शाता है। CLTV कंपनियों को उन संभावित ग्राहकों पर ध्यान केंद्रित करने में मदद करता है जो भविष्य में अधिक राजस्व ला सकते हैं।
"Customer Lifetime Value एक मौद्रिक मान है जो उस राजस्व या लाभ की राशि का प्रतिनिधित्व करता है जो कोई ग्राहक संबंध अवधि के दौरान कंपनी को देगा"। CLTV, अल्पकालिक ग्राहकों की तुलना में दीर्घकालिक ग्राहकों को प्राप्त करने के निहितार्थ दिखाता है। कस्टमर लाइफ़टाइम वैल्यू (CLV) हर कंपनी के लिए बिक्री से जुड़े सबसे महत्वपूर्ण प्रश्नों का उत्तर देने में आपकी मदद कर सकता है:
CLTV की गणना के लिए कई दृष्टिकोण उपलब्ध हैं। हर किसी का इस पर अपना मत है। CLTV की गणना के लिए हमें ग्राहकों का ऐतिहासिक डेटा चाहिए, लेकिन नए ग्राहकों के लिए आप इसकी गणना नहीं कर पाएंगे। इस समस्या को हल करने के लिए बिजनेस एनालिस्ट नए ग्राहकों के CLTV की भविष्यवाणी करने हेतु मशीन लर्निंग मॉडल विकसित करते हैं। आइए CLTV गणना के कुछ दृष्टिकोण देखें:
1) आप किसी दिए गए चक्र में ग्राहकों से होने वाले लाभ/राजस्व को जोड़कर इसे गणना कर सकते हैं। उदाहरण के लिए, यदि ग्राहक पिछले 3 वर्षों से आपके साथ जुड़ा है, तो आप इन 3 वर्षों के सभी लाभों को जोड़ सकते हैं। आप लाभ का औसत वार्षिक, अर्धवार्षिक या मासिक निकाल सकते हैं, लेकिन इस तरीके से आप नए ग्राहकों के लिए प्रेडिक्टिव मॉडल नहीं बना पाएंगे।
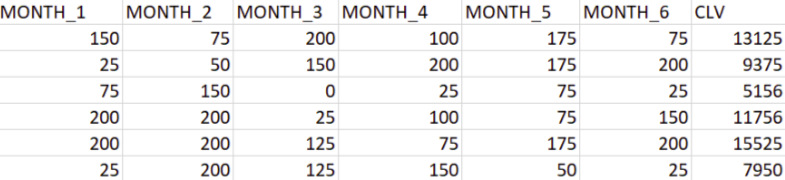
2) मौजूदा ग्राहकों के लिए एक रिग्रेशन मॉडल बनाएं। हाल के छह महीनों के डेटा को स्वतंत्र चर और तीन वर्षों के कुल राजस्व को आश्रित चर के रूप में लें और इस डेटा पर रिग्रेशन मॉडल बनाएं।
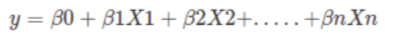
3) CLTV को RFM (Recency, Frequency, Monetary) मानों का उपयोग करके भी लागू किया जा सकता है। अधिक विवरण के लिए आप मेरे ट्यूटोरियल को देखें।
4) निम्नलिखित समीकरण का उपयोग करते हुए: CLTV = ((Average Order Value x Purchase Frequency)/Churn Rate) x Profit margin.
Customer Value = Average Order Value * Purchase Frequency
Average Order Value (AOV): औसत ऑर्डर मूल्य आपके कुल राजस्व और कुल ऑर्डर्स की संख्या का अनुपात है। AOV दर्शाता है कि ग्राहक एक ऑर्डर पर औसतन कितना खर्च करता है।
Average Order Value = Total Revenue / Total Number of Orders
Purchase Frequency (PF): परचेज फ़्रीक्वेंसी कुल ऑर्डर्स की संख्या और कुल ग्राहकों की संख्या का अनुपात है। यह दर्शाता है कि प्रत्येक ग्राहक द्वारा औसतन कितने ऑर्डर दिए गए।
Purchase Frequency = Total Number of Orders / Total Number of Customers
Churn Rate: चर्न रेट उन ग्राहकों का प्रतिशत है जिन्होंने दोबारा ऑर्डर नहीं किया है।
Customer Lifetime: कस्टमर लाइफ़टाइम वह अवधि है जिसके दौरान ग्राहक लगातार ऑर्डर करता रहा है।
Customer Lifetime=1/Churn Rate
Repeat Rate: रिपीट रेट को इस प्रकार परिभाषित किया जा सकता है: एक से अधिक ऑर्डर करने वाले ग्राहकों की संख्या का यूनिक ग्राहकों की संख्या से अनुपात। उदाहरण: यदि किसी महीने में आपके 10 ग्राहक हैं जिनमें से 4 वापस आते हैं, तो आपका रिपीट रेट 40% है।
Churn Rate= 1-Repeat Rate
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
import numpy as np
सबसे पहले pandas की read CSV फंक्शन का उपयोग करके आवश्यक Online Retail डेटासेट लोड करते हैं। आप डेटा यहाँ से डाउनलोड कर सकते हैं।
data = pd.read_excel("Online_Retail.xlsx")
data.head()
| InvoiceNo | StockCode | Description | Quantity | InvoiceDate | UnitPrice | CustomerID | Country | |
|---|---|---|---|---|---|---|---|---|
| 0 | 536365 | 85123A | WHITE HANGING HEART T-LIGHT HOLDER | 6 | 2010-12-01 08:26:00 | 2.55 | 17850.0 | United Kingdom |
| 1 | 536365 | 71053 | WHITE METAL LANTERN | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 2 | 536365 | 84406B | CREAM CUPID HEARTS COAT HANGER | 8 | 2010-12-01 08:26:00 | 2.75 | 17850.0 | United Kingdom |
| 3 | 536365 | 84029G | KNITTED UNION FLAG HOT WATER BOTTLE | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 4 | 536365 | 84029E | RED WOOLLY HOTTIE WHITE HEART. | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
कभी-कभी आपको गंदा डेटासेट मिलता है। आपको डुप्लिकेट्स से निपटना पड़ सकता है, जो आपके विश्लेषण को बिगाड़ देंगे। Python में, pandas drop_duplicates() फंक्शन देता है, जो दोहराए गए या डुप्लिकेट रिकॉर्ड्स को हटा देता है।
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fe677a887f0>
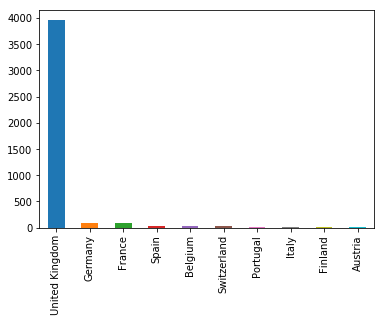
दिए गए डेटासेट में, आप देख सकते हैं कि अधिकतर ग्राहक "United Kingdom" से हैं। इसलिए, आप United Kingdom के ग्राहकों के लिए डेटा फ़िल्टर कर सकते हैं।
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 495478 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      495478 non-null object
StockCode      495478 non-null object
Description    494024 non-null object
Quantity       495478 non-null int64
InvoiceDate    495478 non-null datetime64[ns]
UnitPrice      495478 non-null float64
CustomerID     361878 non-null float64
Country        495478 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 34.0+ MB
pandas में describe() फंक्शन विभिन्न सार-सांख्यिकी प्राप्त करने में सहायक है। यह फंक्शन डेटा की गिनती, माध्य, मानक विचलन, न्यूनतम और अधिकतम मान तथा क्वांटाइल्स लौटाता है।
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 495478.000000 | 495478.000000 | 361878.000000 |
| mean | 8.605486 | 4.532422 | 15547.871368 |
| std | 227.588756 | 99.315438 | 1594.402590 |
| min | -80995.000000 | -11062.060000 | 12346.000000 |
| 25% | 1.000000 | 1.250000 | 14194.000000 |
| 50% | 3.000000 | 2.100000 | 15514.000000 |
| 75% | 10.000000 | 4.130000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
यहाँ, आप देख सकते हैं कि कुछ ग्राहकों ने नकारात्मक मात्रा में ऑर्डर किया है, जो संभव नहीं है। इसलिए, आपको Quantity शून्य से अधिक फ़िल्टर करनी होगी।
uk_data = uk_data[(uk_data['Quantity']>0)]
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 486286 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      486286 non-null object
StockCode      486286 non-null object
Description    485694 non-null object
Quantity       486286 non-null int64
InvoiceDate    486286 non-null datetime64[ns]
UnitPrice      486286 non-null float64
CustomerID     354345 non-null float64
Country        486286 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.4+ MB
यहाँ, आप CLTV की गणना के लिए आवश्यक कॉलम फ़िल्टर कर सकते हैं। आपको केवल पाँच कॉलम चाहिए: CustomerID, InvoiceDate, InvoiceNo, Quantity और UnitPrice।
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
#Calulate total purchase
uk_data['TotalPurchase'] = uk_data['Quantity'] * uk_data['UnitPrice']
यहाँ, आप निम्नलिखित कार्य करने जा रहे हैं:
uk_data_group=uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (date.max() - date.min()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'Quantity': lambda quant: quant.sum(),
                                        'TotalPurchase': lambda price: price.sum()})
uk_data_group.head()
| InvoiceDate | InvoiceNo | Quantity | TotalPurchase | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
# Change the name of columns
uk_data_group.columns=['num_days','num_transactions','num_units','spent_money']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
 CLTV = ((Average Order Value x Purchase Frequency)/Churn Rate) x Profit margin.

 Customer Value = Average Order Value * Purchase Frequency
# Average Order Value
uk_data_group['avg_order_value']=uk_data_group['spent_money']/uk_data_group['num_transactions']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | |
|---|---|---|---|---|---|
| CustomerID | |||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 |
purchase_frequency=sum(uk_data_group['num_transactions'])/uk_data_group.shape[0]
# Repeat Rate
repeat_rate=uk_data_group[uk_data_group.num_transactions > 1].shape[0]/uk_data_group.shape[0]
#Churn Rate
churn_rate=1-repeat_rate
purchase_frequency,repeat_rate,churn_rate
(90.37107880642694, 0.9818923743942872, 0.018107625605712774)
प्रॉफिट मार्जिन आम तौर पर इस्तेमाल किया जाने वाला लाभप्रदता अनुपात है। यह दर्शाता है कि कुल बिक्री का कितना प्रतिशत लाभ के रूप में कमाया गया है। मान लें कि हमारे व्यवसाय में कुल बिक्री पर लगभग 5% लाभ है।
# Profit Margin
uk_data_group['profit_margin']=uk_data_group['spent_money']*0.05
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 |
# Customer Value
uk_data_group['CLV']=(uk_data_group['avg_order_value']*purchase_frequency)/churn_rate
#Customer Lifetime Value
uk_data_group['cust_lifetime_value']=uk_data_group['CLV']*uk_data_group['profit_margin']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | CLV | cust_lifetime_value | |
|---|---|---|---|---|---|---|---|---|
| CustomerID | ||||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 | 3.852060e+08 | 1.486579e+12 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 | 2.033140e+05 | 4.265538e+07 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 | 3.661610e+04 | 6.173424e+07 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 | 1.025963e+05 | 2.098545e+07 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 | 7.971198e+04 | 3.755789e+06 |
आइए CLTV प्रेडिक्शन मॉडल बनाते हैं।
यहाँ, आप Linear Regression मॉडल का उपयोग करके CLTV का पूर्वानुमान लगाने जा रहे हैं।
सबसे पहले ऊपर लोड और फ़िल्टर किए गए डेटा का उपयोग करें।
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
InvoiceDate से महीना और वर्ष निकालें।
uk_data['month_yr'] = uk_data['InvoiceDate'].apply(lambda x: x.strftime('%b-%Y'))
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
पिवट टेबल इनपुट के रूप में कॉलम लेती है और प्रविष्टियों को दो-आयामी टेबल में इस तरह समूहित करती है कि डेटा का बहु-आयामी सार-संक्षेप प्रदान हो सके।
sale=uk_data.pivot_table(index=['CustomerID'],columns=['month_yr'],values='TotalPurchase',aggfunc='sum',fill_value=0).reset_index()
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 |
आइए सभी महीनों की बिक्री को जोड़ें।
sale['CLV']=sale.iloc[:,2:].sum(axis=1)
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 | CLV |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 | 4196.01 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 | 32619.36 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 | 4090.88 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 | 942.34 |
यहाँ, आपको दिए गए कॉलम्स को दो प्रकार के वेरिएबल्स में बाँटना है: आश्रित (या टार्गेट वेरिएबल) और स्वतंत्र (या फ़ीचर वेरिएबल्स)। नवीनतम 6 महीनों को स्वतंत्र वेरिएबल्स के रूप में चुनें।
X=sale[['Dec-2011','Nov-2011', 'Oct-2011','Sep-2011','Aug-2011','Jul-2011']]
y=sale[['CLV']]
मॉडल के प्रदर्शन को समझने के लिए, डेटासेट को ट्रेनिंग सेट और टेस्ट सेट में बाँटना एक अच्छा तरीका है।
आइए train_test_split() फंक्शन का उपयोग करके डेटासेट को विभाजित करें। आपको 3 पैरामीटर पास करने होंगे: फीचर्स, टार्गेट और टेस्ट सेट का आकार। अतिरिक्त रूप से, आप reproducibility बनाए रखने के लिए random_state को एक सीड मान के रूप में उपयोग कर सकते हैं, जिसका अर्थ है कि जब भी आप डेटा को विभाजित करेंगे तो परिणाम प्रभावित नहीं होंगे। साथ ही, यदि random_state None है, तो रैंडम नंबर जेनरेटर रिकॉर्ड्स को रैंडम चुनने के लिए np.random का उपयोग करता है। यानी यदि आप सीड सेट नहीं करते, तो हर बार यह अलग होगा।
#split training set and test set
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y,random_state=0)
पहले Linear Regression मॉड्यूल इम्पोर्ट करें और Linear Regression ऑब्जेक्ट बनाएँ। फिर fit() फंक्शन का उपयोग करके अपने मॉडल को ट्रेन सेट पर फिट करें और predict() फंक्शन का उपयोग करके टेस्ट सेट पर प्रेडिक्शन करें।
# import model
from sklearn.linear_model import LinearRegression

# instantiate
linreg = LinearRegression()

# fit the model to the training data (learn the coefficients)
linreg.fit(X_train, y_train)

# make predictions on the testing set
y_pred = linreg.predict(X_test)
# print the intercept and coefficients
print(linreg.intercept_)
print(linreg.coef_)
[208.50969617]
[[0.99880551 0.80381254 1.60226829 1.67433228 1.52860813 2.87959449]]
लिनियर मॉडल की समग्र फिट का आकलन करने के लिए हम R-squared मान का उपयोग करते हैं। R-squared, मॉडल द्वारा समझाई गई वैरिएंस का अनुपात है। R-squared का मान 0 और 1 के बीच होता है। R-squared का उच्च मान बेहतर माना जाता है क्योंकि यह दर्शाता है कि मॉडल द्वारा अधिक वैरिएंस समझाई गई है।
from sklearn import metrics

# compute the R Square for model
print("R-Square:",metrics.r2_score(y_test, y_pred))
R-Square: 0.9666074402817512
इस मॉडल का R-squared (0.96) उच्च है। यह मॉडल डेटा के लिए बेहतर फिट प्रदान करता है।
रिग्रेशन समस्याओं के लिए निम्न मूल्यांकन मेट्रिक्स का उपयोग किया जाता है (Ritchie Ng):
# calculate MAE using scikit-learn
print("MAE:",metrics.mean_absolute_error(y_test,y_pred))

#calculate mean squared error
print("MSE",metrics.mean_squared_error(y_test, y_pred))
# compute the RMSE of our predictions
print("RMSE:",np.sqrt(metrics.mean_squared_error(y_test, y_pred)))
MAE: 595.0282284701234
MSE 2114139.8898678957
RMSE: 1454.0082151995896
RMSE, MSE और MAE की तुलना में अधिक लोकप्रिय है क्योंकि RMSE y के समान यूनिट्स में होता है, इसलिए इसे समझना आसान है।
CLTV आपको एक प्रभावी बिजनेस प्लान बनाने में मदद करता है और आपके व्यवसाय को स्केल करने का अवसर भी प्रदान करता है। CLTV सार्थक ग्राहक सेगमेंट खींचता है जो विभिन्न सेगमेंट की जरूरतों की पहचान करने में आपकी मदद कर सकते हैं।
Customer Lifetime Value एक उपकरण है, रणनीति नहीं। CLTV सबसे अधिक लाभदायक ग्राहकों का पता लगा सकता है, लेकिन उनसे लाभ कैसे कमाना है, यह आपकी रणनीति पर निर्भर करता है। आम तौर पर, CLTV मॉडलों को लेकर भ्रम होता है और उनका गलत उपयोग होता है। CLTV के प्रति जुनून कई बार नज़रियाहीनता पैदा कर सकता है। कंपनियाँ केवल सर्वश्रेष्ठ ग्राहक समूह को खोजने, उन पर ध्यान केंद्रित करने और व्यवसाय दोहराने पर ध्यान देती हैं, लेकिन अन्य ग्राहकों पर ध्यान देना भी महत्वपूर्ण है।
बधाई हो, आप इस ट्यूटोरियल के अंत तक पहुँच गए हैं!
इस ट्यूटोरियल में, आपने Customer Lifetime Value के बारे में कई विवरण कवर किए। आपने जाना कि कस्टमर लाइफ़टाइम वैल्यू क्या है, CLTV की गणना के तरीके, Python में शुरुआत से CLTV का इम्प्लीमेंटेशन, CLTV के लिए एक प्रेडिक्शन मॉडल, और CLTV के लाभ व सीमाएँ। साथ ही, आपने pandas के कुछ बुनियादी कॉन्सेप्ट्स जैसे groupby और पिवट टेबल को भी कवर किया, जो चयनित कॉलम्स और पंक्तियों का सार-संक्षेप निकालने में उपयोगी हैं।
उम्मीद है, अब आप अपने स्वयं के डेटासेट का विश्लेषण करने के लिए CLTV की अवधारणा का उपयोग कर सकते हैं। इस ट्यूटोरियल को पढ़ने के लिए धन्यवाद!
यदि आप Python में ग्राहक डेटा का विश्लेषण करने के बारे में और सीखना चाहते हैं, तो DataCamp का Customer Analytics & A/B Testing in Python कोर्स करें।
Python कोर्स
कोर्स
कोर्स
कोर्स