Kurs
Einführung in Python
4 Std.
7M
Der italienische Ökonom Vilfredo Pareto stellte fest, dass 80% der Wirkung aus 20% der Ursachen stammen – bekannt als 80/20-Regel oder Pareto-Prinzip. Ähnlich verhält es sich im Business: 80% des Umsatzes kommen oft von 20% der Kundschaft. Unternehmen müssen diese Top-Kundinnen und -Kunden identifizieren und die Beziehung pflegen, um kontinuierliche Einnahmen zu sichern. Um langfristige Kundenbeziehungen aufzubauen, sollten Programme zur Kundenbindung geplant werden, etwa Rabatte, Angebote, Coupons, Bonuspunkte und Geschenke.
Neue Kundschaft zu gewinnen ist teurer, als bestehende zu halten, denn du musst weniger Ressourcen, Zeit und Aufwand investieren. Es gilt vor allem, bestehende Kundinnen und Kunden zufrieden zu stellen. Business-Analysten berechnen die Akquisitionskosten präzise mithilfe des CLTV (Customer Lifetime Value). Der CLTV zeigt den gesamten Umsatz, der während der gesamten Kundenbeziehung erzielt wird. Er hilft Unternehmen, sich auf diejenigen Kundensegmente zu konzentrieren, die künftig den meisten Umsatz bringen können.
"Customer Lifetime Value ist ein Geldwert, der den Umsatz oder Gewinn repräsentiert, den eine Kundin oder ein Kunde dem Unternehmen über die gesamte Dauer der Beziehung bringt." CLTV macht den Unterschied zwischen langfristig und kurzfristig gebundenen Kundinnen und Kunden sichtbar. Der Customer Lifetime Value (CLV) hilft dir, die wichtigsten Vertriebsfragen in jedem Unternehmen zu beantworten:
Es gibt viele Ansätze, um den CLTV zu berechnen. Jede Person hat dazu ihre eigene Sicht. Für die Berechnung benötigen wir historische Kundendaten – für neue Kundinnen und Kunden ist das zunächst nicht möglich. Um dieses Problem zu lösen, entwickeln Business-Analysten Machine-Learning-Modelle, die den CLTV für Neukundschaft vorhersagen. Lass uns ein paar Ansätze anschauen:
1) Du kannst den CLTV berechnen, indem du den Gewinn/Umsatz je Kundin bzw. Kunde über einen definierten Zeitraum aufsummierst. Beispiel: Wenn die Kundin seit 3 Jahren bei dir kauft, summierst du die Gewinne dieser 3 Jahre. Du kannst den Gewinn jährlich, halbjährlich oder monatlich mitteln. Mit diesem Ansatz lässt sich jedoch kein Vorhersagemodell für neue Kundinnen und Kunden bauen.
2) Baue ein Regressionsmodell für bestehende Kundschaft. Nutze die jüngsten sechs Monate als unabhängige Variablen und den Gesamtumsatz über drei Jahre als abhängige Variable und trainiere darauf ein Regressionsmodell.
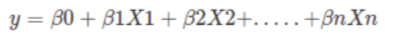
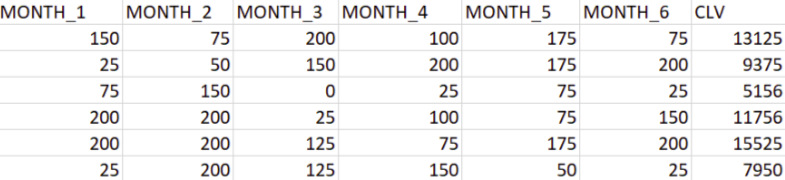
3) CLTV lässt sich auch über RFM-Werte (Recency, Frequency, Monetary) implementieren. Mehr dazu findest du in meinem Tutorial.
4) Über folgende Gleichung: CLTV = ((Durchschnittlicher Bestellwert × Kaufhäufigkeit)/Churn-Rate) × Gewinnmarge.
Customer Value = Average Order Value * Purchase Frequency
Average Order Value (AOV): Der durchschnittliche Bestellwert ist das Verhältnis aus Gesamtumsatz und Gesamtanzahl der Bestellungen. Er zeigt, wie viel Umsatz im Mittel pro Bestellung erzielt wird.
Average Order Value = Total Revenue / Total Number of Orders
Purchase Frequency (PF): Die Kaufhäufigkeit ist das Verhältnis aus Gesamtanzahl der Bestellungen und Gesamtanzahl der Kundinnen und Kunden. Sie zeigt, wie viele Bestellungen eine Person im Schnitt tätigt.
Purchase Frequency = Total Number of Orders / Total Number of Customers
Churn-Rate: Der Anteil der Kundinnen und Kunden, die nicht erneut bestellen.
Kundenlebensdauer: Der Zeitraum, in dem eine Kundin oder ein Kunde kontinuierlich bestellt.
Customer Lifetime=1/Churn Rate
Repeat-Rate: Das Verhältnis aus der Anzahl der Kundinnen und Kunden mit mehr als einer Bestellung zur Zahl der einzigartigen Kundinnen und Kunden. Beispiel: Wenn du in einem Monat 10 Kundinnen/Kunden hast und 4 davon zurückkommen, beträgt deine Repeat-Rate 40%.
Churn Rate= 1-Repeat Rate
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
import numpy as np
Lass uns zuerst den benötigten Online-Retail-Datensatz mit der pandas-Funktion read_csv laden. Du kannst die Daten hier herunterladen.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
| InvoiceNo | StockCode | Description | Quantity | InvoiceDate | UnitPrice | CustomerID | Country | |
|---|---|---|---|---|---|---|---|---|
| 0 | 536365 | 85123A | WHITE HANGING HEART T-LIGHT HOLDER | 6 | 2010-12-01 08:26:00 | 2.55 | 17850.0 | United Kingdom |
| 1 | 536365 | 71053 | WHITE METAL LANTERN | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 2 | 536365 | 84406B | CREAM CUPID HEARTS COAT HANGER | 8 | 2010-12-01 08:26:00 | 2.75 | 17850.0 | United Kingdom |
| 3 | 536365 | 84029G | KNITTED UNION FLAG HOT WATER BOTTLE | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 4 | 536365 | 84029E | RED WOOLLY HOTTIE WHITE HEART. | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
Manchmal sind Datensätze unaufgeräumt. Duplikate können deine Analyse verzerren. In Python bietet pandas die Funktion drop_duplicates(), die doppelte Einträge entfernt.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fe677a887f0>
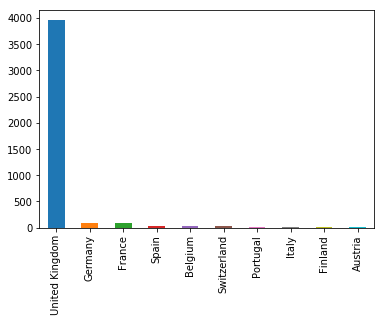
Im gegebenen Datensatz stammen die meisten Kundinnen und Kunden aus dem „United Kingdom“. Du kannst die Daten also auf diese Gruppe filtern.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 495478 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      495478 non-null object
StockCode      495478 non-null object
Description    494024 non-null object
Quantity       495478 non-null int64
InvoiceDate    495478 non-null datetime64[ns]
UnitPrice      495478 non-null float64
CustomerID     361878 non-null float64
Country        495478 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 34.0+ MB
Die describe()-Funktion in pandas liefert bequeme Übersichtsstatistiken. Sie gibt Anzahl, Mittelwert, Standardabweichung, Minimum, Maximum und Perzentile der Daten zurück.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 495478.000000 | 495478.000000 | 361878.000000 |
| mean | 8.605486 | 4.532422 | 15547.871368 |
| std | 227.588756 | 99.315438 | 1594.402590 |
| min | -80995.000000 | -11062.060000 | 12346.000000 |
| 25% | 1.000000 | 1.250000 | 14194.000000 |
| 50% | 3.000000 | 2.100000 | 15514.000000 |
| 75% | 10.000000 | 4.130000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Hier siehst du, dass manche Bestellmengen negativ sind – das ist nicht plausibel. Also filtern wir Quantity > 0.
uk_data = uk_data[(uk_data['Quantity']>0)]
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 486286 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      486286 non-null object
StockCode      486286 non-null object
Description    485694 non-null object
Quantity       486286 non-null int64
InvoiceDate    486286 non-null datetime64[ns]
UnitPrice      486286 non-null float64
CustomerID     354345 non-null float64
Country        486286 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.4+ MB
Hier filterst du die relevanten Spalten für die CLTV-Berechnung. Du brauchst fünf Spalten: CustomerID, InvoiceDate, InvoiceNo, Quantity und UnitPrice.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
#Calulate total purchase
uk_data['TotalPurchase'] = uk_data['Quantity'] * uk_data['UnitPrice']
Als Nächstes führst du Folgendes aus:
uk_data_group=uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (date.max() - date.min()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'Quantity': lambda quant: quant.sum(),
                                        'TotalPurchase': lambda price: price.sum()})
uk_data_group.head()
| InvoiceDate | InvoiceNo | Quantity | TotalPurchase | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
# Change the name of columns
uk_data_group.columns=['num_days','num_transactions','num_units','spent_money']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
 CLTV = ((Average Order Value x Purchase Frequency)/Churn Rate) x Profit margin.

 Customer Value = Average Order Value * Purchase Frequency
# Average Order Value
uk_data_group['avg_order_value']=uk_data_group['spent_money']/uk_data_group['num_transactions']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | |
|---|---|---|---|---|---|
| CustomerID | |||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 |
purchase_frequency=sum(uk_data_group['num_transactions'])/uk_data_group.shape[0]
# Repeat Rate
repeat_rate=uk_data_group[uk_data_group.num_transactions > 1].shape[0]/uk_data_group.shape[0]
#Churn Rate
churn_rate=1-repeat_rate
purchase_frequency,repeat_rate,churn_rate
(90.37107880642694, 0.9818923743942872, 0.018107625605712774)
Die Gewinnmarge ist eine gängige Profitabilitätskennzahl. Sie zeigt, wie viel Prozent des Umsatzes als Gewinn verbleiben. Nehmen wir an, unser Geschäft erzielt ca. 5% Marge auf den Gesamtumsatz.
# Profit Margin
uk_data_group['profit_margin']=uk_data_group['spent_money']*0.05
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 |
# Customer Value
uk_data_group['CLV']=(uk_data_group['avg_order_value']*purchase_frequency)/churn_rate
#Customer Lifetime Value
uk_data_group['cust_lifetime_value']=uk_data_group['CLV']*uk_data_group['profit_margin']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | CLV | cust_lifetime_value | |
|---|---|---|---|---|---|---|---|---|
| CustomerID | ||||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 | 3.852060e+08 | 1.486579e+12 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 | 2.033140e+05 | 4.265538e+07 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 | 3.661610e+04 | 6.173424e+07 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 | 1.025963e+05 | 2.098545e+07 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 | 7.971198e+04 | 3.755789e+06 |
Lass uns ein CLTV-Vorhersagemodell bauen.
Hier sagst du den CLTV mit einem linearen Regressionsmodell voraus.
Wir nutzen die oben geladenen und gefilterten Daten.
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
Extrahiere Monat und Jahr aus InvoiceDate.
uk_data['month_yr'] = uk_data['InvoiceDate'].apply(lambda x: x.strftime('%b-%Y'))
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
Die Pivot-Tabelle gruppiert Spalten zu einer zweidimensionalen Ansicht und ermöglicht eine verdichtete, mehrdimensionale Zusammenfassung der Daten.
sale=uk_data.pivot_table(index=['CustomerID'],columns=['month_yr'],values='TotalPurchase',aggfunc='sum',fill_value=0).reset_index()
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 |
Jetzt summieren wir die Umsätze über alle Monate.
sale['CLV']=sale.iloc[:,2:].sum(axis=1)
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 | CLV |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 | 4196.01 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 | 32619.36 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 | 4090.88 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 | 942.34 |
Teile die Spalten in Zielvariable (dependent) und Feature-Variablen (independent). Wähle die letzten 6 Monate als Features.
X=sale[['Dec-2011','Nov-2011', 'Oct-2011','Sep-2011','Aug-2011','Jul-2011']]
y=sale[['CLV']]
Um die Modellleistung zu beurteilen, ist es sinnvoll, den Datensatz in Trainings- und Testmenge zu teilen.
Wir nutzen train_test_split(). Du übergibst Features, Zielvariable und die Größe des Testsets. Optional sorgt random_state als Seed für Reproduzierbarkeit. Ist random_state None, nutzt der Zufallszahlengenerator np.random – ohne Seed erhältst du bei jedem Split andere Ergebnisse.
#split training set and test set
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y,random_state=0)
Importiere das Modul für lineare Regression und erstelle ein Objekt. Trainiere das Modell mit fit() auf dem Trainingsset und sage mit predict() auf dem Testset voraus.
# import model
from sklearn.linear_model import LinearRegression

# instantiate
linreg = LinearRegression()

# fit the model to the training data (learn the coefficients)
linreg.fit(X_train, y_train)

# make predictions on the testing set
y_pred = linreg.predict(X_test)
# print the intercept and coefficients
print(linreg.intercept_)
print(linreg.coef_)
[208.50969617]
[[0.99880551 0.80381254 1.60226829 1.67433228 1.52860813 2.87959449]]
Zur Bewertung der Gesamtgüte nutzen wir R-Quadrat. Es beschreibt den durch das Modell erklärten Varianzanteil und liegt zwischen 0 und 1. Je höher, desto besser, da mehr Varianz erklärt wird.
from sklearn import metrics

# compute the R Square for model
print("R-Square:",metrics.r2_score(y_test, y_pred))
R-Square: 0.9666074402817512
Dieses Modell erreicht ein hohes R-Quadrat (0,96) und passt die Daten sehr gut.
Für Regressionsprobleme werden folgende Metriken genutzt (Ritchie Ng):
# calculate MAE using scikit-learn
print("MAE:",metrics.mean_absolute_error(y_test,y_pred))

#calculate mean squared error
print("MSE",metrics.mean_squared_error(y_test, y_pred))
# compute the RMSE of our predictions
print("RMSE:",np.sqrt(metrics.mean_squared_error(y_test, y_pred)))
MAE: 595.0282284701234
MSE 2114139.8898678957
RMSE: 1454.0082151995896
RMSE ist beliebter als MSE und MAE, weil die Einheit der Zielvariable entspricht und dadurch intuitiver interpretierbar ist.
CLTV hilft dir, einen wirksamen Geschäftsplan zu entwickeln und bietet Ansatzpunkte zum Skalieren. Zudem ermöglicht CLTV sinnvolle Kundensegmente, mit denen du die Bedürfnisse verschiedener Gruppen erkennst.
Customer Lifetime Value ist ein Werkzeug, keine Strategie. CLTV identifiziert die profitabelsten Kundinnen und Kunden – wie du daraus Profit schlägst, hängt von deiner Strategie ab. Häufig werden CLTV-Modelle missverstanden oder falsch verwendet. Eine zu starke Fixierung auf CLTV kann Scheuklappen erzeugen: Unternehmen fokussieren sich nur auf die vermeintlich besten Gruppen und wiederholen das Geschäft dort. Es ist jedoch ebenso wichtig, auch andere Kundinnen und Kunden im Blick zu behalten.
Glückwunsch, du hast das Ende dieses Tutorials erreicht!
In diesem Tutorial hast du den Customer Lifetime Value im Detail kennengelernt: Definition, Ansätze zur Berechnung, eine Umsetzung in Python von Grund auf, ein Vorhersagemodell sowie die Vor- und Nachteile. Außerdem hast du grundlegende pandas-Konzepte wie groupby und Pivot-Tabellen genutzt, um ausgewählte Spalten und Zeilen zusammenzufassen.
Hoffentlich kannst du das CLTV-Konzept jetzt auf deine eigenen Datensätze anwenden. Danke fürs Lesen!
Wenn du mehr darüber lernen möchtest, Kundendaten in Python zu analysieren, schau dir den DataCamp-Kurs Customer Analytics & A/B Testing in Python an.
Python-Kurse
Kurs
Kurs
Kurs