Cours
Introduction à Python
4 h
7M
L’économiste italien Vilfredo Pareto énonce que 80 % des effets proviennent de 20 % des causes : c’est la règle du 80/20, ou principe de Pareto. De la même façon, 80 % du chiffre d’affaires de nombreuses entreprises proviennent de 20 % de leurs clients. Les entreprises doivent donc identifier ces clients clés et entretenir la relation avec eux pour sécuriser des revenus récurrents. Pour bâtir une relation durable, elles peuvent mettre en place des programmes de fidélité comme des remises, offres, coupons, points bonus et cadeaux.
Cibler un nouveau client coûte plus cher que fidéliser un client existant, car vous n’avez pas à consacrer autant de ressources, de temps et d’efforts pour l’acquérir. Il s’agit surtout de conserver la satisfaction des clients actuels. Les analystes mesurent précisément le coût d’acquisition client via la CLTV (Customer Lifetime Value). La CLTV indique le revenu total généré par un client sur l’ensemble de la relation. Elle aide les entreprises à se concentrer sur les clients à fort potentiel, susceptibles de générer davantage de revenus à l’avenir.
« La Customer Lifetime Value est une valeur monétaire représentant le revenu ou le profit qu’un client apportera à l’entreprise sur toute la durée de la relation ». La CLTV met en lumière les avantages d’acquérir des clients sur le long terme plutôt que des clients à court terme. La customer lifetime value (CLV) permet de répondre aux questions commerciales essentielles pour toute entreprise :
Il existe de nombreuses approches pour calculer la CLTV. Chacun peut avoir sa vision. Pour la calculer, il faut des données historiques client, ce qui ne permet pas d’estimer la valeur de nouveaux clients. Pour contourner ce problème, les analystes conçoivent des modèles de machine learning afin de prédire la CLTV des nouveaux clients. Voici quelques approches de calcul de la CLTV :
1) Additionner les profits/recettes par client sur une période donnée. Par exemple, si un client est avec vous depuis 3 ans, vous pouvez sommer tous les profits sur ces 3 ans. Vous pouvez ensuite en calculer la moyenne annuelle, semestrielle ou mensuelle. En revanche, cette méthode ne permet pas de créer un modèle prédictif pour de nouveaux clients.
2) Construire un modèle de régression pour les clients existants. Utilisez les données des six derniers mois comme variables explicatives et le revenu total sur trois ans comme variable cible, puis entraînez un modèle de régression.
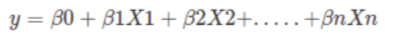
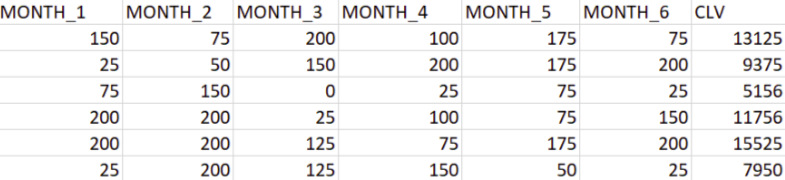
3) La CLTV peut aussi être estimée avec les valeurs RFM (Récence, Fréquence, Montant). Pour plus de détails, consultez mon tutoriel.
4) À l’aide de l’équation suivante : CLTV = ((valeur moyenne de commande × fréquence d’achat)/taux d’attrition) × marge bénéficiaire.
Customer Value = Average Order Value * Purchase Frequency
Valeur moyenne de commande (AOV) : c’est le ratio entre le revenu total et le nombre total de commandes. Elle représente le montant moyen dépensé par commande.
Average Order Value = Total Revenue / Total Number of Orders
Fréquence d’achat (PF) : c’est le ratio entre le nombre total de commandes et le nombre total de clients. Elle représente le nombre moyen de commandes par client.
Purchase Frequency = Total Number of Orders / Total Number of Customers
Taux d’attrition (churn rate) : pourcentage de clients qui n’ont pas repassé commande.
Durée de vie client : période pendant laquelle le client passe des commandes de manière continue.
Customer Lifetime=1/Churn Rate
Taux de réachat (repeat rate) : ratio entre le nombre de clients ayant passé plus d’une commande et le nombre total de clients uniques. Exemple : si vous avez 10 clients sur un mois et que 4 reviennent, le taux de réachat est de 40 %.
Churn Rate= 1-Repeat Rate
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
import numpy as np
Commençons par charger le jeu de données Online Retail avec la fonction de lecture CSV de pandas. Vous pouvez télécharger les données ici.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
| InvoiceNo | StockCode | Description | Quantity | InvoiceDate | UnitPrice | CustomerID | Country | |
|---|---|---|---|---|---|---|---|---|
| 0 | 536365 | 85123A | WHITE HANGING HEART T-LIGHT HOLDER | 6 | 2010-12-01 08:26:00 | 2.55 | 17850.0 | United Kingdom |
| 1 | 536365 | 71053 | WHITE METAL LANTERN | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 2 | 536365 | 84406B | CREAM CUPID HEARTS COAT HANGER | 8 | 2010-12-01 08:26:00 | 2.75 | 17850.0 | United Kingdom |
| 3 | 536365 | 84029G | KNITTED UNION FLAG HOT WATER BOTTLE | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
| 4 | 536365 | 84029E | RED WOOLLY HOTTIE WHITE HEART. | 6 | 2010-12-01 08:26:00 | 3.39 | 17850.0 | United Kingdom |
Il arrive que le jeu de données soit « bruité ». Vous pouvez avoir des doublons qui faussent l’analyse. En Python, pandas propose la fonction drop_duplicates(), qui supprime les enregistrements répétés.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fe677a887f0>
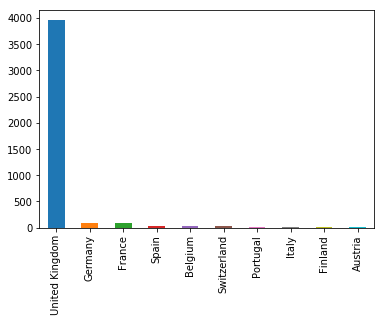
Dans ce jeu de données, on observe que la majorité des clients viennent du « United Kingdom ». Vous pouvez donc filtrer les clients du Royaume-Uni.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 495478 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      495478 non-null object
StockCode      495478 non-null object
Description    494024 non-null object
Quantity       495478 non-null int64
InvoiceDate    495478 non-null datetime64[ns]
UnitPrice      495478 non-null float64
CustomerID     361878 non-null float64
Country        495478 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 34.0+ MB
La fonction describe() de pandas est très pratique pour obtenir des statistiques descriptives. Elle renvoie le nombre d’observations, la moyenne, l’écart type, les valeurs minimale et maximale, ainsi que les quartiles.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 495478.000000 | 495478.000000 | 361878.000000 |
| mean | 8.605486 | 4.532422 | 15547.871368 |
| std | 227.588756 | 99.315438 | 1594.402590 |
| min | -80995.000000 | -11062.060000 | 12346.000000 |
| 25% | 1.000000 | 1.250000 | 14194.000000 |
| 50% | 3.000000 | 2.100000 | 15514.000000 |
| 75% | 10.000000 | 4.130000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Ici, on remarque que certains clients ont des quantités négatives, ce qui est impossible. Filtrons donc les lignes avec une quantité strictement positive.
uk_data = uk_data[(uk_data['Quantity']>0)]
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 486286 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      486286 non-null object
StockCode      486286 non-null object
Description    485694 non-null object
Quantity       486286 non-null int64
InvoiceDate    486286 non-null datetime64[ns]
UnitPrice      486286 non-null float64
CustomerID     354345 non-null float64
Country        486286 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.4+ MB
Ici, nous sélectionnons les colonnes utiles au calcul de la CLTV. Cinq colonnes suffisent : CustomerID, InvoiceDate, InvoiceNo, Quantity et UnitPrice.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
#Calulate total purchase
uk_data['TotalPurchase'] = uk_data['Quantity'] * uk_data['UnitPrice']
Nous allons effectuer les opérations suivantes :
uk_data_group=uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (date.max() - date.min()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'Quantity': lambda quant: quant.sum(),
                                        'TotalPurchase': lambda price: price.sum()})
uk_data_group.head()
| InvoiceDate | InvoiceNo | Quantity | TotalPurchase | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
# Change the name of columns
uk_data_group.columns=['num_days','num_transactions','num_units','spent_money']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | |
|---|---|---|---|---|
| CustomerID | ||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 |
| 12820.0 | 323 | 59 | 722 | 942.34 |
 CLTV = ((Average Order Value x Purchase Frequency)/Churn Rate) x Profit margin.

 Customer Value = Average Order Value * Purchase Frequency
# Average Order Value
uk_data_group['avg_order_value']=uk_data_group['spent_money']/uk_data_group['num_transactions']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | |
|---|---|---|---|---|---|
| CustomerID | |||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 |
purchase_frequency=sum(uk_data_group['num_transactions'])/uk_data_group.shape[0]
# Repeat Rate
repeat_rate=uk_data_group[uk_data_group.num_transactions > 1].shape[0]/uk_data_group.shape[0]
#Churn Rate
churn_rate=1-repeat_rate
purchase_frequency,repeat_rate,churn_rate
(90.37107880642694, 0.9818923743942872, 0.018107625605712774)
La marge est le ratio de rentabilité le plus courant. Elle indique la part du chiffre d’affaires conservée en gain. Supposons ici une marge d’environ 5 % sur les ventes.
# Profit Margin
uk_data_group['profit_margin']=uk_data_group['spent_money']*0.05
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 |
# Customer Value
uk_data_group['CLV']=(uk_data_group['avg_order_value']*purchase_frequency)/churn_rate
#Customer Lifetime Value
uk_data_group['cust_lifetime_value']=uk_data_group['CLV']*uk_data_group['profit_margin']
uk_data_group.head()
| num_days | num_transactions | num_units | spent_money | avg_order_value | profit_margin | CLV | cust_lifetime_value | |
|---|---|---|---|---|---|---|---|---|
| CustomerID | ||||||||
| 12346.0 | 0 | 1 | 74215 | 77183.60 | 77183.600000 | 3859.1800 | 3.852060e+08 | 1.486579e+12 |
| 12747.0 | 366 | 103 | 1275 | 4196.01 | 40.737961 | 209.8005 | 2.033140e+05 | 4.265538e+07 |
| 12748.0 | 372 | 4596 | 25748 | 33719.73 | 7.336756 | 1685.9865 | 3.661610e+04 | 6.173424e+07 |
| 12749.0 | 209 | 199 | 1471 | 4090.88 | 20.557186 | 204.5440 | 1.025963e+05 | 2.098545e+07 |
| 12820.0 | 323 | 59 | 722 | 942.34 | 15.971864 | 47.1170 | 7.971198e+04 | 3.755789e+06 |
Construisons un modèle de prédiction de la CLTV.
Ici, nous allons prédire la CLTV avec une régression linéaire.
Repartons des données chargées et filtrées ci-dessus.
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
Extraire le mois et l’année depuis InvoiceDate.
uk_data['month_yr'] = uk_data['InvoiceDate'].apply(lambda x: x.strftime('%b-%Y'))
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPurchase | month_yr | |
|---|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 | Dec-2010 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 | Dec-2010 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 | Dec-2010 |
Le tableau croisé dynamique agrège des colonnes en une table bidimensionnelle offrant une synthèse multidimensionnelle des données.
sale=uk_data.pivot_table(index=['CustomerID'],columns=['month_yr'],values='TotalPurchase',aggfunc='sum',fill_value=0).reset_index()
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 |
Faisons la somme des ventes sur l’ensemble des mois.
sale['CLV']=sale.iloc[:,2:].sum(axis=1)
sale.head()
| month_yr | CustomerID | Apr-2011 | Aug-2011 | Dec-2010 | Dec-2011 | Feb-2011 | Jan-2011 | Jul-2011 | Jun-2011 | Mar-2011 | May-2011 | Nov-2011 | Oct-2011 | Sep-2011 | CLV |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 12346.0 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 77183.60 |
| 1 | 12747.0 | 0.00 | 301.70 | 706.27 | 438.50 | 0.00 | 303.04 | 0.00 | 376.30 | 310.78 | 771.31 | 312.73 | 675.38 | 0.00 | 4196.01 |
| 2 | 12748.0 | 1100.37 | 898.24 | 4228.13 | 1070.27 | 389.64 | 418.77 | 1113.27 | 2006.26 | 1179.37 | 2234.50 | 10639.23 | 2292.84 | 6148.84 | 32619.36 |
| 3 | 12749.0 | 0.00 | 1896.13 | 0.00 | 763.06 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 859.10 | 572.59 | 0.00 | 0.00 | 4090.88 |
| 4 | 12820.0 | 0.00 | 0.00 | 0.00 | 210.35 | 0.00 | 170.46 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 343.76 | 217.77 | 942.34 |
Divisez les colonnes en deux types : variable cible (dépendante) et variables explicatives (features). Sélectionnez les 6 derniers mois comme variables explicatives.
X=sale[['Dec-2011','Nov-2011', 'Oct-2011','Sep-2011','Aug-2011','Jul-2011']]
y=sale[['CLV']]
Pour évaluer les performances du modèle, il est recommandé de diviser le jeu de données en ensemble d’entraînement et de test.
Scindons le jeu de données avec la fonction train_test_split(). Vous devez passer 3 paramètres : les features, la cible et la taille du test set. Vous pouvez aussi utiliser random_state comme graine pour la reproductibilité : chaque découpage donnera les mêmes résultats. Si random_state est None, le générateur aléatoire utilise np.random pour sélectionner les enregistrements, et le découpage variera à chaque exécution si vous ne fixez pas de graine.
#split training set and test set
from sklearn.cross_validation import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y,random_state=0)
Importez d’abord le module de régression linéaire et créez un objet Linear Regression. Ajustez ensuite le modèle sur le jeu d’entraînement avec fit(), puis réalisez des prédictions sur le jeu de test avec predict().
# import model
from sklearn.linear_model import LinearRegression

# instantiate
linreg = LinearRegression()

# fit the model to the training data (learn the coefficients)
linreg.fit(X_train, y_train)

# make predictions on the testing set
y_pred = linreg.predict(X_test)
# print the intercept and coefficients
print(linreg.intercept_)
print(linreg.coef_)
[208.50969617]
[[0.99880551 0.80381254 1.60226829 1.67433228 1.52860813 2.87959449]]
Pour évaluer l’ajustement global du modèle linéaire, on utilise le R². Le R² est la proportion de la variance expliquée par le modèle. Sa valeur est comprise entre 0 et 1. Plus le R² est élevé, mieux c’est, car le modèle explique une plus grande part de la variance.
from sklearn import metrics

# compute the R Square for model
print("R-Square:",metrics.r2_score(y_test, y_pred))
R-Square: 0.9666074402817512
Ce modèle affiche un R² élevé (0,96) et s’ajuste donc bien aux données.
Pour les problèmes de régression, on utilise généralement les métriques suivantes (Ritchie Ng) :
# calculate MAE using scikit-learn
print("MAE:",metrics.mean_absolute_error(y_test,y_pred))

#calculate mean squared error
print("MSE",metrics.mean_squared_error(y_test, y_pred))
# compute the RMSE of our predictions
print("RMSE:",np.sqrt(metrics.mean_squared_error(y_test, y_pred)))
MAE: 595.0282284701234
MSE 2114139.8898678957
RMSE: 1454.0082151995896
La RMSE est souvent préférée au MSE et au MAE car elle s’exprime dans les mêmes unités que la variable cible y, ce qui la rend plus interprétable.
La CLTV vous aide à concevoir un plan d’affaires efficace et ouvre des perspectives de montée en échelle. Elle permet de dégager des segments clients pertinents, utiles pour identifier les besoins propres à chaque segment.
La Customer Lifetime Value est un outil, pas une stratégie. La CLTV aide à repérer les clients les plus rentables, mais la manière d’en tirer profit relève de votre stratégie. Les modèles de CLTV sont parfois mal compris ou mal utilisés. Une obsession pour la CLTV peut créer des œillères : l’entreprise se focalise sur un segment « premium » et cherche à répéter les ventes, alors qu’il est aussi important d’adresser les autres clients.
Félicitations, vous êtes arrivé au bout de ce tutoriel !
Vous avez passé en revue de nombreux aspects de la Customer Lifetime Value : définition, méthodes de calcul, implémentation from scratch en Python, modèle de prédiction, ainsi que ses avantages et ses limites. Vous avez également revu des notions de base de pandas comme groupby et les tableaux croisés pour synthétiser des colonnes et lignes de données.
Nous espérons que vous pourrez désormais mobiliser la CLTV pour analyser vos propres jeux de données. Merci de votre lecture !
Pour aller plus loin sur l’analyse client en Python, suivez le cours Customer Analytics & A/B Testing in Python de DataCamp.
Cours Python
Cours
Cours
Cours